

Gemini 4 Hydrogen coûte deux fois plus cher par token que le tarif de lancement de Gemini 3.8 Flash : 1,50 $ par million de tokens en entrée et 7,50 $ par million de tokens en sortie, contre 0,75 $ et 3,75 $. Selon les mesures en direct d’Artificial Analysis, Hydrogen accomplit une tâche d’index pour 1,87 $ ; Gemini 3.8 Flash coûte 7,77 $. Le prix par token a doublé, mais le coût par tâche accomplie a baissé d’environ trois quarts.
C’est ce qui rend cette mise à niveau inhabituelle. Google recommande Hydrogen comme évolution de Gemini 3.8 Flash et des anciens modèles Gemini 3 et 2.5, mais ce n’est pas une nouvelle version de Flash. La fiche du modèle l’indique clairement : « Gemini 4 Hydrogen est adapté de Gemini 4 Carbon. » Il hérite de la fenêtre de contexte de Gemini 4, de son parcours de décodage long et d’un nouveau niveau de réflexion, xhigh, tout en conservant une fonction typique de Flash : une exécution rapide à grand volume.
On obtient ainsi un modèle plus facile à justifier au budget par tâche qu’au prix par token. Voici ce qui a changé, ce que montrent les mesures, où s’arrête l’intérêt de la mise à niveau et comment l’utiliser via AIHubMix.
Qu’est-ce que Hydrogen ?
Hydrogen est généralement disponible depuis le 2026-11-12, selon le journal des modifications de l’API Gemini ; sa fiche de modèle est datée du même jour. Dans son article de lancement, Google le présente comme « notre modèle de référence au quotidien pour les workflows agentiques » et décrit Carbon et Argon comme des modèles « conçus pour un raisonnement approfondi sur de longues séquences ». Hydrogen, lui, est « conçu pour une exécution rapide dans divers workflows agentiques », selon sa fiche de modèle, et peut fonctionner seul ou en tant que sous-agent aux côtés des modèles de pointe.
Trois faits concernant son lancement intéressent les utilisateurs de l’API. C’est le seul modèle Gemini 4 disponible dans l’offre gratuite : Google indique qu’il est accessible « dans les offres gratuite et payante de Google AI Studio et de l’API Gemini ». C’est aussi le seul modèle Gemini 4 doté du niveau de réflexion xhigh. Enfin, selon le journal des modifications, c’est le modèle par défaut de l’agent Antigravity dans Gemini Managed Agents.
Une réserve importante mérite d’être mentionnée d’emblée. La documentation destinée aux entreprises de Google qualifie Hydrogen de « version à disponibilité générale (GA) à court terme, soumise à un préavis de retrait minimum de 45 jours ». La page sur les dépréciations n’indique aucune date de fin de service, mais toute équipe qui prévoit une dépendance à long terme devrait y voir un avertissement : mieux vaut garder la chaîne du modèle configurable.
Ce qui change par rapport à Gemini 3.8 Flash
Les deux modèles ont davantage en commun que ne le laisse penser leur catégorie tarifaire. Sur l’API de Google, ils prennent tous deux en charge une fenêtre de contexte de 1,048,576 tokens, acceptent tous deux les entrées texte, image, audio et vidéo, et sont tous deux disponibles dans une offre gratuite. La page du modèle d’AIHubMix indique que Hydrogen accepte les entrées texte, image, audio, vidéo et PDF, et génère du texte ; la page entreprise de Google mentionne aussi les formats Office et OpenDocument, contrairement à celle de la passerelle. Les différences portent sur la capacité de sortie, les paramètres de réflexion par défaut et la forme de l’API.
| Élément | Gemini 4 Hydrogen | Gemini 3.8 Flash |
|---|---|---|
| Fenêtre de contexte | 1,048,576 tokens | 1,048,576 tokens |
| Sortie maximale | 1,048,576 tokens via le décodage long | 65,536 tokens |
| Sortie synchrone | 65,536 tokens par étape, avec ou sans streaming | 65,536 tokens |
| Niveaux de réflexion | low, medium, high (par défaut), xhigh | low, medium (par défaut), high |
| Modalités d’entrée | texte, image, audio, vidéo, PDF, Office | texte, image, audio, vidéo, PDF |
| Offre gratuite | Oui | Oui |
| Mise en cache | implicite uniquement, minimum de 4,096 tokens | implicite et explicite |
Hydrogen ajoute un quatrième niveau, xhigh, et fait passer le paramètre par défaut de medium à high. Il permet aussi une étape synchrone de 65,536 tokens en mode streaming comme sans streaming ; Carbon et Argon n’autorisent 65,536 tokens qu’en streaming, et 32,768 autrement. Pour les longues sorties, Hydrogen utilise le même parcours d’arrière-plan ou de continuation de tokens que le reste de la famille Gemini 4 et peut atteindre 1,048,576 tokens moins le nombre de tokens d’entrée.
Le coût par tour découle du paramètre par défaut. Hydrogen consomme plus de tokens de réflexion par tour qu’un modèle réglé par défaut sur medium, et les tokens de sortie incluent ceux de réflexion. Une migration de charge de travail sans réglage du niveau entraînera généralement un coût supérieur par tour à celui de 3.8 Flash, avant même de tenir compte de la différence de prix par token.
Une mise à niveau mesurée : 20 points d’index pour un coût par tâche inférieur
Artificial Analysis a évalué Hydrogen au niveau high à 51 sur l’Intelligence Index, soit le rang #21 sur 78. Gemini 3.8 Flash, également au niveau high, a obtenu 31, soit le rang #54. La facture par tâche évolue en sens inverse : 1,87 $ contre 7,77 $.
| Modèle / niveau de réflexion | Rang AA | Index AA | $/tâche | Min/tâche | Premier token de réponse |
|---|---|---|---|---|---|
| Hydrogen high | 21 | 51 | 1.87 | 8.3 | 18.89 s |
| Hydrogen xhigh | 16 | 54 | 3.16 | 13.5 | 37.77 s |
| Gemini 3.8 Flash high | 54 | 31 | 7.77 | 14.7 | 17.53 s |
Ces chiffres correspondent aux mesures en direct d’Artificial Analysis, consultées le 2026-11-13T02:40Z, sur l’Intelligence Index v5.0.1 qui classe 78 modèles. Elles utilisent les tarifs catalogue standard et ne correspondent pas aux factures d’AIHubMix. Les deux lignes présentent des résultats au niveau high, ce qui permet une comparaison à niveau égal ; à noter que high est le paramètre par défaut de Hydrogen, mais pas celui de Flash. Au niveau medium par défaut, Flash obtient 30 pour 6,26 $ par tâche : une comparaison entre paramètres par défaut modifie les chiffres, mais pas la tendance.
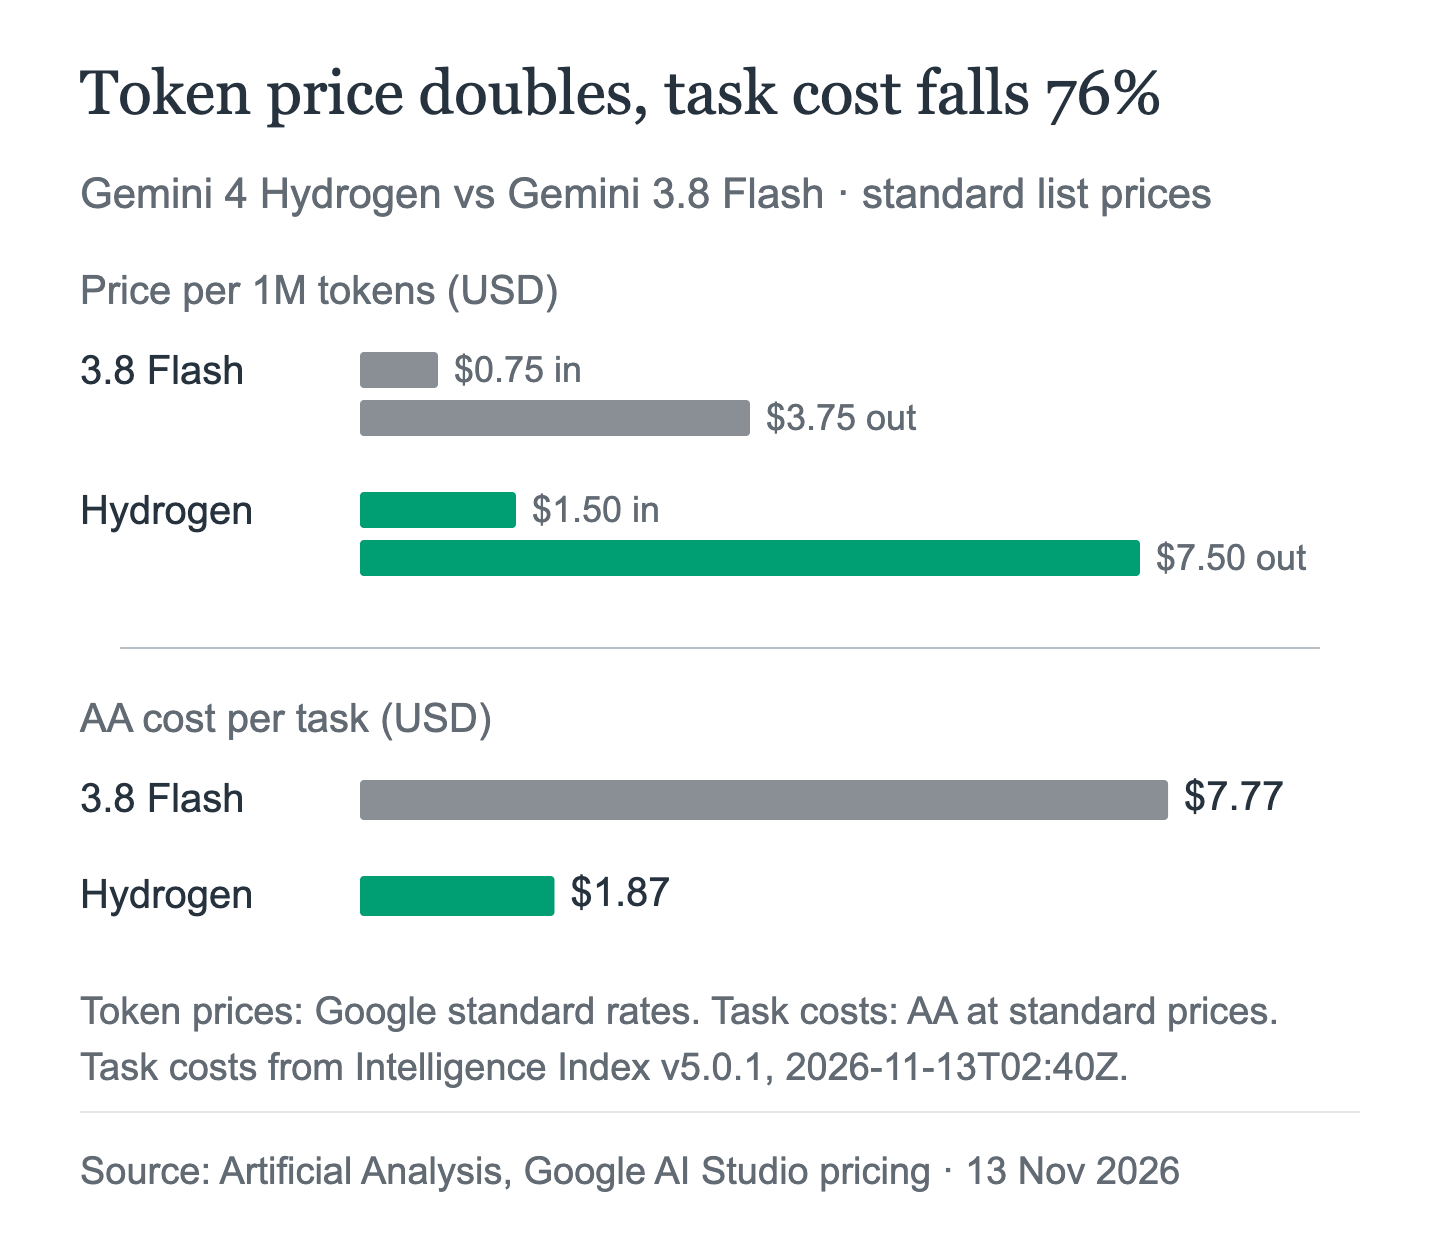
C’est le résultat par tâche qu’il faut retenir. Le prix par token de Hydrogen est le double du tarif de lancement de Flash, mais son coût mesuré par tâche est inférieur de 75.9%. L’écart s’explique par le nombre de tokens consommés par chaque modèle pour accomplir le même travail, ce qu’un prix par token ne révèle pas. Le premier token de réponse de Hydrogen arrive au bout de 18.89 secondes, soit environ 1,4 seconde de plus que les 17.53 secondes de Flash, et le modèle termine la tâche en 8,3 minutes contre 14,7.
Au niveau xhigh, Hydrogen obtient 54 pour 3,16 $ par tâche et 13,5 minutes ; le premier token arrive au bout de 37.77 secondes. C’est quatre points de plus que Gemini 4 Argon au niveau high (50) et six de moins que Carbon au niveau high (60) dans le même instantané. Les quatre niveaux sont traités séparément dans cette série ; en bref, high est le réglage offrant le meilleur rapport qualité-prix, tandis que xhigh est réservé aux tâches difficiles.
Le tableau de benchmarks de Google et les trois lignes où Hydrogen est devancé
La fiche de modèle de Google est un document du fournisseur : les résultats sont déclarés par Google, publiés le 2026-11-12, et comparés à deux concurrents plutôt qu’au modèle Gemini précédent. Hydrogen arrive en tête dans 7 des 10 comparaisons présentées. Les trois défaites sont les plus instructives.
| Benchmark | Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|
| SWE-sweep | 13.5% | 3.1% | 5.8% |
| Terminal-Bench 4.1 | 57.0% | 63.9% | — |
| Agents' Last Exam v1.1 | 71.6% | 60.4% | 69.8% |
| AutomationBench-AA | 76.1% | 71.8% | 60.2% |
| Vending-Bench 2 | $14,549 | $11,165 | $9,107 |
| OSWorld-2.1 | 77.6% | 83.9% | 74.2% |
| MKA | 53.4% | 52.0% | 43.8% |
| Chartography | 66.6% | 61.6% | 63.2% |
| Terminal-Bench-Science 0.1 | 51.4% | 59.9% | 58.3% |
| HLE-Diamond | 58.8% | 53.3% | 47.3% |
La fiche de modèle précise que Terminal-Bench 4.1 est « ajusté pour tenir compte de la triche ». Sonnet 5.5 l’emporte sur Terminal-Bench 4.1 (63.9 contre 57.0), OSWorld-2.1 (83.9 contre 77.6) et Terminal-Bench-Science 0.1 (59.9 contre 51.4). Ce sont les benchmarks pour lesquels un modèle plus cher apporte encore un avantage. Selon la grille tarifaire d’Anthropic, Sonnet 5.5 coûte 2 $ en entrée et 10 $ en sortie : Hydrogen est donc 25% moins cher par token et domine dans la plupart des tests de la fiche, mais perd sur les trois benchmarks les plus agentiques ou scientifiques.
Ne comparez pas directement les résultats de Carbon avec ce tableau. Sa fiche de modèle indique un score de 65.2 à Terminal-Bench 4.0 ; celle de Hydrogen donne 57.0 à Terminal-Bench 4.1. Les versions des benchmarks et les ensembles de comparaison diffèrent : ces scores ne peuvent pas être mis dans la même colonne.
L’article de lancement de Google ajoute des affirmations absentes de la fiche de modèle : Hydrogen termine les tâches « 2,5 fois plus vite, avec son réglage par défaut high » que Gemini 3.8 Flash et réduit les affirmations inventées de « plus de 5x ». Google lui attribue également la #5e place sur Agent Arena, la première place au Vals Tax Agent Bench (52.3%) et une première place ex æquo au Vals Legal Research Bench (55.8%). Il s’agit de résultats communiqués par le fournisseur et non reproduits ici par une source indépendante.
Prix : le tarif par token double, mais le coût par tâche baisse
Le tarif standard de Hydrogen est de 1,50 $ en entrée, 7,50 $ en sortie et 0,075 $ pour les tokens d’entrée mis en cache. Batch et Flex coûtent moitié moins, tandis que Priority coûte 2,70 $ et 13,50 $. Le tarif reste fixe sur toute la fenêtre de contexte.
| Modèle / offre | Entrée | Entrée mise en cache | Sortie | Période |
|---|---|---|---|---|
| Hydrogen Standard | $1.50 | $0.075 | $7.50 | Actuellement |
| Hydrogen Batch / Flex | $0.75 | $0.0375 | $3.75 | Actuellement |
| Hydrogen Priority | $2.70 | $0.135 | $13.50 | Actuellement |
| Gemini 3.8 Flash Standard | $0.75 | $0.075 | $3.75 | Jusqu’au 2026-12-31 |
| Gemini 3.8 Flash Standard | $1.50 | $0.15 | $7.50 | À partir du 2027-01-01 |
| Gemini 4 Carbon / Argon | $2.00 | $0.10 | $10.00 | Jusqu’au 2026-11-30 |
| Gemini 4 Carbon / Argon | $4.00 | $0.20 | $20.00 | À partir du 2026-12-01 |
Tarifs officiels en USD par million de tokens, tirés de la page des tarifs de Google et consultés le 2026-11-13. Aucun changement futur n’a été annoncé pour Hydrogen.
Le tableau permet deux comparaisons. Les tarifs d’entrée et de sortie de Hydrogen sont exactement ceux de Gemini 3.8 Flash Standard à partir du 2027-01-01 : l’écart du « doublement du prix » disparaît donc le jour du Nouvel An. Par rapport à Carbon et Argon, Hydrogen coûte 25% de moins par token jusqu’au 30 novembre, puis 62.5% de moins après le doublement de leurs tarifs le 1er décembre.
AIHubMix affiche Hydrogen à 1,50 $, 7,50 $ et 0,075 $, soit les mêmes tarifs standard que Google. L’offre gratuite est celle de Google, pas celle de la passerelle : AIHubMix est une route payante.
Quand Hydrogen ne constitue pas une mise à niveau
La prise en charge des protocoles est plus limitée. Les entrées de schéma de Carbon et Argon répertorient Chat Completions, Responses, Anthropic Messages et Gemini natif. Hydrogen ne figure dans aucune entrée de schéma de l’instantané de l’index des modèles du 2026-11-11, et seul POST /v1/chat/completions est documenté. Les clients Responses de type Codex et les clients Anthropic de type Claude Code ne devraient pas présumer qu’Hydrogen fonctionne sans vérification.
Il s’agit d’une version GA à court terme. La politique de préavis de retrait de 45 jours impose une contrainte de planification, mais ne justifie pas à elle seule d’éviter le modèle. Elle justifie en revanche de stocker l’ID du modèle dans la configuration plutôt que dans le code.
Certaines fonctionnalités de la plateforme sont absentes. Sur la page entreprise de Google, Gemini Live API, RAG Engine, Tuning et le quota fixe sont indiqués comme non pris en charge pour Hydrogen ; l’inférence Batch est prise en charge.
Le profil de sécurité est contrasté. La fiche de modèle indique que la sécurité textuelle est meilleure que celle de Gemini 3.8 Flash (+0.80pp en texte-à-texte, +1.10pp en multilingue), mais que les refus injustifiés sont supérieurs de 5.57 points de pourcentage, particulièrement pour les prompts multimodaux, et que le ton est moins bon de 0.65 point. Il s’agit d’évaluations automatisées, pas d’exercices de red team.
Carbon reste le plafond de qualité. Hydrogen high obtient 51, contre 60 pour Carbon high, et Hydrogen xhigh reste à six points derrière avec 54. Pour le débogage difficile, l'architecture, les travaux scientifiques et l'analyse de sécurité, le raisonnement supplémentaire de Carbon fait toute la différence.
Les niveaux inférieurs ne préservent pas la qualité gratuitement. Hydrogen medium obtient 41 et low 27 sur AA. Une migration qui conserve en pratique l'ancien comportement par défaut en passant à medium fera perdre bien plus en qualité que l'économie réalisée sur le prix des tokens.
Comment l'appeler via AIHubMix
La méthode documentée utilise l'endpoint de chat-completions compatible avec OpenAI. La page du modèle répertorie deux fournisseurs, VertexAI et Google AI Studio, avec une nouvelle tentative automatique.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "Summarise this incident report and list the follow-ups."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
L'endpoint est POST /v1/chat/completions. AIHubMix indique que Hydrogen accepte les entrées texte, image, audio, vidéo et PDF, avec une sortie texte ; la plateforme ne publie pas d'indicateurs de capacité pour le raisonnement, l'utilisation d'outils ou la sortie structurée, et son guide Gemini traite des contrôles de réflexion de l'ère Gemini 2.5, et non des niveaux Gemini 4. Ne partez pas du principe que le paramètre thinking_level de Google, ni la nouvelle valeur xhigh, sont pris en charge par la passerelle. Gardez max_tokens sous la limite synchrone de 65,536, sauf si la génération longue est confirmée pour votre route. Aucun test en direct n'a été effectué pour cet article : l'exemple montre donc la forme de la requête, et non une réponse vérifiée.
Qui devrait passer à Hydrogen dès maintenant ?
Passez dès maintenant si vous utilisez Gemini 3.8 Flash et payez à l'usage par token : Artificial Analysis mesure un coût par tâche terminée inférieur de 76%, avec un indice supérieur de 20 points, et l'offre gratuite vous permet de vérifier gratuitement la qualité avec vos propres prompts. Passez-y si votre charge de travail est volumineuse et peut fonctionner avec Chat Completions et une sortie texte, ou si vous cherchez un modèle d'exécution moins cher à utiliser aux côtés de Carbon dans une boucle multi-modèle.
Attendez si votre client dépend du protocole Responses ou Anthropic Messages ; si vos tâches concernent les cas les plus difficiles de débogage, d'architecture ou de sécurité, où le plafond de Carbon reste important ; ou si un préavis de retrait de 45 jours est incompatible avec votre cycle de publication.
Faites d'abord un test si vous hésitez. Exécutez 20 à 50 requêtes réelles sur Hydrogen high et Gemini 3.8 Flash avec ses paramètres par défaut, puis comparez le coût par tâche terminée plutôt que le coût par token. La page de comparaison d'AIHubMix peut vous aider à évaluer Carbon.
FAQ
Hydrogen est-il moins cher que Gemini 3.8 Flash ?
Par token, non : $1.50/$7.50 contre les tarifs de lancement de $0.75/$3.75. Par tâche terminée, Artificial Analysis mesure $1.87 contre $7.77, soit environ 76% de moins. Le coût par tâche dépend du nombre de tokens utilisés, et pas uniquement de la grille tarifaire.
Hydrogen est-il Gemini 3.8 Flash sous un nouveau nom ?
Non. Selon la fiche modèle de Google, Hydrogen est adapté de Gemini 4 Carbon, et Google le recommande comme une mise à niveau depuis 3.8 Flash. Il dispose d'une autre fenêtre de contexte, d'un quatrième niveau de réflexion et d'un paramètre par défaut différent.
Hydrogen accepte-t-il les images ?
Oui. La plateforme de Google accepte le texte, les images, l'audio, la vidéo, les PDF et les fichiers Office. La page du modèle d'AIHubMix indique des entrées texte, image, audio, vidéo et PDF, avec une sortie texte ; les formats Office et OpenDocument n'y sont pas répertoriés.
L'offre gratuite est-elle disponible sur AIHubMix ?
Non. L'offre gratuite est proposée par Google dans AI Studio et l'API Gemini. AIHubMix est une route payante à $1.50/$7.50.
Quel est le niveau de réflexion par défaut ?
high. Le niveau par défaut de Gemini 3.8 Flash était medium ; Hydrogen ajoute xhigh au-dessus de high.
Hydrogen est-il meilleur que Carbon ?
Non. Carbon high obtient 60 à l'indice AA, contre 51 pour Hydrogen high et 54 pour xhigh, et coûte davantage par tâche. Hydrogen est le modèle d'exécution le moins cher, pas le modèle de pointe.
Puis-je définir le niveau de réflexion via AIHubMix ?
La documentation ne le précise pas. AIHubMix ne publie aucun indicateur de capacité de raisonnement pour Hydrogen, et son guide Gemini ne couvre pas les niveaux Gemini 4. Vérifiez ce point avant de vous y fier.
À lire ensuite : la série Gemini 4 Hydrogen
- Si vous voulez savoir quel niveau de réflexion utiliser, le prochain article mesure les quatre niveaux avec le même indice et montre à partir de quand gravir les échelons ne vaut plus le coût : Niveaux de réflexion de Gemini 4 Hydrogen : low, medium, high, xhigh.
- Si vous vous demandez s'il faut utiliser Hydrogen aux côtés de Carbon ou d'Argon, le troisième article compare les trois modèles avec leurs tarifs, leur latence et un tableau des charges de travail : Gemini 4 Carbon vs Hydrogen vs Argon : quel modèle pour quelle tâche ?.
Sources
- Google, Présentation de Gemini 4 Hydrogen
- Google AI Studio, Gemini 4 Hydrogen : les nouveautés
- Google DeepMind, Fiche modèle de Gemini 4 Hydrogen
- AIHubMix, Gemini 4 Hydrogen
- Artificial Analysis, Gemini 4 Hydrogen — instantané en direct du 2026-11-13T02:40Z, Intelligence Index v5.0.1


