Gemini 4 Carbon n’est pas une nouvelle famille de modèles. C’est Gemini 4 Argon avec davantage de réflexion à chaque tour, vendu au même prix par token : 2 $ par million de tokens d’entrée et 10 $ par million de tokens de sortie aux tarifs de lancement jusqu’au 30 novembre 2026, puis 4 $ et 20 $ à partir du 1er décembre. La question n’est pas de savoir quel modèle coûte le moins cher par token. Leur prix est identique. Il s’agit de déterminer si la réflexion supplémentaire permet d’accomplir chaque tâche à un coût suffisamment bas pour justifier une première réponse plus lente.
Les données en direct d’Artificial Analysis donnent une réponse claire pour un type de travail, et un avertissement tout aussi clair pour un autre. Carbon High se classe n° 4 sur 104 à l’AA Intelligence Index, avec un score de 60.03, contre 50.41 pour Argon High. Il coûte 7.76 $ par tâche, contre 9.95 $, et termine en 25.6 minutes, contre 29.0. Mais le délai avant le premier token de réponse est de 67.1 secondes, contre 40.1 pour Argon. Carbon est le meilleur modèle pour une file d’attente. Argon est le meilleur modèle pour une conversation.
Cette distinction est au cœur de cet article. Au programme : ce qui a changé, ce que montrent les mesures, ce qu’ajoute la fiche modèle de Google, l’évolution des prix au 1er décembre et les charges de travail qui devraient rester sur Argon.
Ce qui a changé depuis Argon
La fiche modèle de Google décrit clairement leur relation : « Gemini 4 Carbon est basé sur Gemini 4 Argon. » L’ID du modèle est gemini-4-carbon, comme sur AIHubMix. Google indique une fenêtre de contexte de 1,048,576 tokens. Les niveaux de réflexion sont faible, moyen et élevé, le niveau moyen étant celui par défaut. La sortie standard est de 65,536 tokens ; le chemin natif de génération longue de Google peut atteindre jusqu’à 1,048,576 tokens moins le nombre de tokens d’entrée, avec 131,072 et 262,144 comme exemples. AIHubMix ne documente actuellement que Chat Completions ; limitez donc les requêtes de la passerelle à 65,536 tokens maximum tant qu’un chemin de génération plus long n’est pas documenté. La date limite des connaissances est mars 2026. Google ne propose pas ce modèle dans son offre gratuite.
Le changement est décrit dans les notes de Google AI Studio : « Carbon consacre davantage de tokens de réflexion à chaque tour pour explorer en profondeur et vérifier son travail, ce qui augmente le nombre de tokens utilisés par tour et la latence par rapport à Argon. » Cette phrase explique presque toutes les différences présentées dans la suite. Une réflexion plus poussée relève le plafond de performance sur les tâches difficiles, augmente la facture par tour et allonge l’attente avant le premier token.
La migration est volontairement simple. « La mise à niveau depuis Argon ne nécessite aucune modification du schéma de requête. » Il suffit de remplacer le nom du modèle au niveau de l’API. Google conseille, sur le plan opérationnel, de « garder thinking_level sur medium (valeur par défaut), sauf si une charge de travail nécessite high, et de vérifier que max_output_tokens et les délais d’expiration HTTP permettent des phases de raisonnement plus longues. »
Le compromis mesuré : plus de réflexion, moins cher par tâche
Les chiffres ci-dessous proviennent des mesures en direct d’Artificial Analysis, consultées le 2026-11-11T05:23Z (pages des modèles vérifiées à nouveau à 06:01Z, sans changement), aux tarifs standards de 4 $ par million de tokens d’entrée et 20 $ par million de tokens de sortie.
La comparaison utile porte sur la qualité par rapport au coût des tâches terminées : Carbon permet-il d’obtenir un indice plus élevé pour une facture moindre ? Le graphique distingue les quatre configurations de modèle.
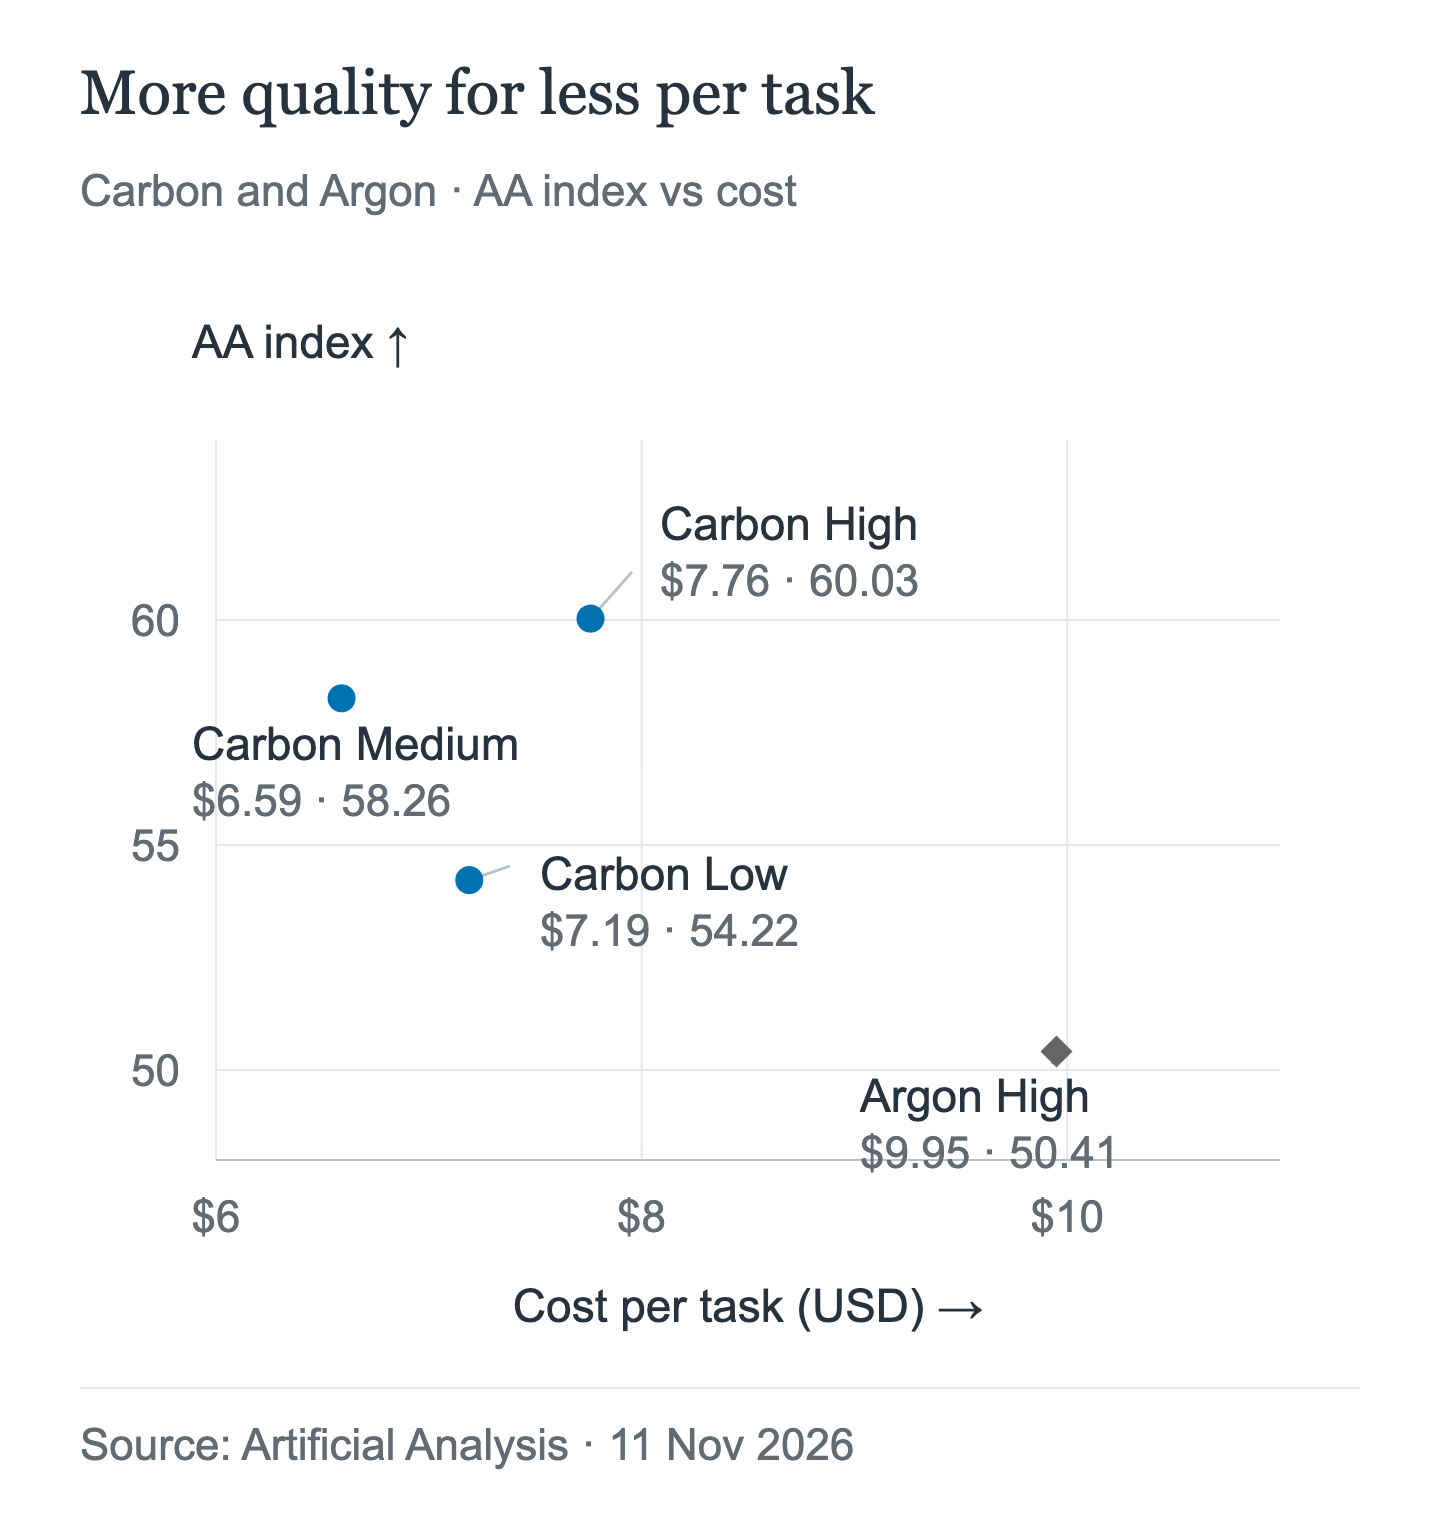
Carbon High se situe au-dessus et à gauche d’Argon High. Dans cette série, Medium est le réglage Carbon le moins coûteux ; Low privilégie la latence, pas le coût minimal. Il s’agit des coûts par tâche d’AA aux tarifs standards, et non des factures des requêtes AIHubMix.
| Modèle | Indice AA | $/tâche | Min/tâche | Premier token | Tokens de sortie/s |
|---|---|---|---|---|---|
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s | 80.1 |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s | 73.7 |
| Carbon Low | 54.22 | 7.19 | 22.6 | 12.9 s | 63.5 |
| Argon High | 50.41 | 9.95 | 29.0 | 40.1 s | 66.8 |
Carbon High, Medium et Low se classent respectivement n° 4, n° 6 et n° 14 sur 104 ; Argon High est derrière eux. Les trois modèles qui devancent Carbon High sont tous des configurations de Claude Fable 5.2. « Premier token » désigne le délai avant le premier token de réponse. Comparaison entre Carbon High et Argon High : +9.62 points d’indice, 22.0% moins cher par tâche, 25.6 contre 29.0 minutes, mais 67.1 contre 40.1 secondes avant le premier token de réponse.
L’écart d’indice est assez important pour modifier une place au classement. L’écart de latence suffit à changer la façon dont une personne vit l’attente. Ces deux constats viennent de la même ligne du tableau.
Artificial Analysis qualifie Carbon de « particulièrement lent par tâche et très verbeux », et indique qu’il a généré 205 millions de tokens pour calculer l’indice, contre 113 millions pour Argon et une médiane de 72.8 millions pour l’ensemble des modèles évalués. Dans cette série d’AA, le coût par tâche est plus bas malgré un volume de sortie bien supérieur : même tarif catalogue, beaucoup plus de tokens et coût total des tâches inférieur.
Une anomalie mérite d’être signalée à part. Carbon Low coûte 7.19 $ par tâche, soit plus que Medium à 6.59 $, malgré une réflexion moins poussée. Quelle qu’en soit la cause, Low se comporte comme un réglage privilégiant la latence plutôt que comme un réglage économique ; mesurez donc le coût par tâche avant de lui confier un grand volume.
Le point de vue des agents de programmation
L’Intelligence Index établit une moyenne sur de nombreuses tâches. Le Coding Agent Index v2 se rapproche davantage de ce qu’utilise un client d’API : un agent de programmation avec des outils, évalué de bout en bout sur le même banc de test. Carbon High se classe n° 4 ; Argon High, n° 11.
| Rang | Agent + modèle | Indice | $/tâche | Min/tâche | Hit de cache |
|---|---|---|---|---|---|
| 4 | Antigravity CLI + Carbon High | 59.4 | 7.74 | 29.8 | 0.95 |
| 11 | Antigravity CLI + Argon High | 53.2 | 11.73 | 34.7 | 0.87 |
Même agent, même banc de test, modèle différent : la comparaison isole donc le modèle plutôt que l’infrastructure. Carbon coûte 34.0% moins cher par tâche, gagne +6.2 points d’indice, termine 4.9 minutes plus vite et produit presque autant de tokens par tâche : 109,031 contre 109,236. Son taux de hit de cache est supérieur, à 0.95 contre 0.87, et il utilise moins de tokens d’entrée : 12.44 millions contre 13.76 millions.
Deux réserves. Carbon occupe la 4e place de cet indice : Claude Code avec Opus 5.5 Max mène avec 61.7, suivi de Devin Fusion CLI et GitHub Copilot Fusion. Et Fable 5.2 ne figure pas du tout dans l’indice ; ce tableau ne permet donc pas de trancher la comparaison entre Carbon et Fable.
Ce qu’ajoute la fiche modèle de Google, et ce qu’elle n’apporte pas
La fiche modèle de Google est un document du fournisseur : les résultats datent d’octobre 2026, sont déclarés par Google et proviennent d’un instantané différent des données en direct présentées plus haut. Pour les mesures ci-dessous, le score de Carbon est systématiquement supérieur.
| Benchmark | Carbon | Argon |
|---|---|---|
| AA Index v5.0 (fournisseur) | 59 | 50 |
| Terminal-Bench 4.0 | 65.2 | 57.1 |
| FrontierSWE 2 | 61.2 | 55.0 |
| OSWorld-2.1 | 81.5 | 74.7 |
| Agents' Last Exam | 77.4 | 69.0 |
La ligne AA reprend le score arrondi de Google, 59, et non le score en direct de 60.03 du tableau précédent ; ces deux valeurs proviennent d’instantanés différents et ne doivent pas être mélangées. La comparaison externe de la fiche porte sur Fable 5.1, et non Fable 5.2.
L’intérêt réside dans la cohérence : le gain ne se limite pas à un seul benchmark. La limite est tout aussi évidente. Une fiche publiée par un fournisseur ne donne ni le coût d’une tâche, ni la latence avant le premier token, ni le nombre de tours effectués par votre agent. Elle étaye l’affirmation « Carbon est le meilleur modèle en moyenne ». Elle ne permet pas d’affirmer « Carbon est le meilleur modèle pour votre boucle ».
Prix : le même tarif, avec le même changement au 1er décembre
Les tarifs de Carbon et d’Argon sont identiques sur toute la grille. Tous deux bénéficient des tarifs de lancement jusqu’au 30 novembre 2026, puis leurs tarifs doublent le 1er décembre.
| Modèle | Entrée | Sortie | Lecture en cache |
|---|---|---|---|
| Carbon, lancement (jusqu’au 30 nov.) | $2.00 | $10.00 | $0.10 |
| Carbon, à partir du 1er déc. | $4.00 | $20.00 | $0.20 |
| Argon, lancement (jusqu’au 30 nov.) | $2.00 | $10.00 | $0.10 |
| Argon, à partir du 1er déc. | $4.00 | $20.00 | $0.20 |
| Gemini 3.1 Pro Preview (≤200k) | $2.00 | $12.00 | $0.20 |
| Fable 5.2 | $8.00 | $40.00 | $0.20 |
Tarifs officiels en USD par million de tokens, au 11 novembre 2026. Gemini 3.1 Pro Preview coûte 4 $/18 $/0.40 $ au-delà de 200k tokens de prompt, auxquels s’ajoutent 4.50 $ par million de tokens et par heure de stockage. Les écritures dans le cache de Fable 5.2 coûtent 10 $ pour cinq minutes ou 16 $ pour une heure ; le traitement par lots bénéficie d’une réduction de 50%. Les tarifs de lancement de Carbon et Argon prennent fin le 30 novembre ; tous les tarifs de Carbon et Argon doublent le 1er décembre.
AIHubMix affiche Carbon à 2 $/10 $/0.10 $, conformément aux tarifs de lancement de Google. Cet article ne présume pas des tarifs appliqués par la passerelle après le 30 novembre ; consultez la page du modèle pour connaître le tarif en vigueur.
En recalculant les volumes de tokens mesurés par Artificial Analysis aux tarifs de lancement, on obtient des estimations approximatives du coût par tâche de 3.88 $ pour Carbon High, 3.30 $ pour Medium, 3.60 $ pour Low et 4.98 $ pour Argon High. Ce sont des estimations calculées, et non des mesures d’AA : le calcul conserve la même répartition des tokens pour chaque tâche, tandis que vos prompts et votre taux de hit de cache modifieront le résultat.
Par token, Fable 5.2 coûte deux fois plus cher que Carbon aux tarifs standards, et quatre fois plus cher aux tarifs de lancement. Il s’agit d’un écart de prix, pas d’un jugement sur la qualité ; le troisième article de cette série compare les deux modèles.
Quand Carbon n’est pas le meilleur choix
L’argument contre Carbon n’est pas qu’il est moins performant. C’est que ce qu’il apporte — davantage de réflexion par tour — est précisément ce qu’un produit interactif ne peut pas se permettre.
Le premier token tarde à arriver. Avec Carbon High, le premier token de réponse arrive après 67.1 secondes ; avec Argon High, après 40.1 secondes. Medium ramène l’attente à 23.2 secondes et Low à 12.9, mais tous deux perdent des points d’indice. Une interface de chat qui marque une pause d’une minute a déjà perdu le tour, quel que soit l’aspect de la réponse à son arrivée.
Google recommande de garder Argon pour la vitesse. Argon est présenté comme le modèle offrant « des réponses plus rapides et une consommation de tokens plus faible par tour » pour le « développement interactif, le travail quotidien sur les fonctionnalités et les cycles de production rapides ». La consigne des notes de migration est sans détour : « Gardez Argon là où la vitesse compte. » L’article d’annonce de Google le répète : « Argon reste le choix idéal pour la majorité des tâches d’ingénierie logicielle et de gestion des connaissances. »
La dépense par tour est plus élevée, même si le coût par tâche est inférieur. Le prix par token est identique, mais Carbon utilise davantage de tokens de réflexion par tour. Pour une équipe qui surveille sa consommation de tokens par tour ou rationne son quota de tokens, Carbon revient plus cher. Les 205 millions de tokens utilisés pour l’indice, contre 113 millions pour Argon, illustrent ce phénomène à l’extrême.
Low n’est pas l’option économique. À 7.19 $ par tâche, Carbon Low coûte plus cher que Medium, à 6.59 $. Si le critère de routage est le coût par tâche terminée, Low ne le respecte pas.
Les victoires aux benchmarks ne font pas gagner du temps. OSWorld-2.1 et FrontierSWE 2 donnent tous deux l’avantage à Carbon dans le tableau de Google, mais ces résultats sont déclarés par le fournisseur et aucun ne réduit l’attente avant le premier token. Les benchmarks mesurent le résultat final ; les utilisateurs, eux, vivent le début.
Qui devrait passer à Carbon maintenant, et qui devrait rester sur Argon
Passez à Carbon dès maintenant si vous exécutez des traitements par lots natifs du fournisseur ou des tâches d’agent en arrière-plan (ces modes ne sont pas documentés pour Carbon sur AIHubMix), si un échec de qualité coûte plus cher que le temps d’exécution, si vos requêtes peuvent tolérer des délais d’expiration plus longs et un budget de sortie plus important, ou si vous payez déjà des tentatives supplémentaires que Carbon pourrait éviter.
Restez sur Argon si vous développez un chat, une autocomplétion ou toute boucle impliquant un humain en attente ; si votre budget ou quota est calculé par tour ; ou si le produit doit respecter une latence inférieure à environ 30 secondes.
Faites d’abord un test si vous êtes entre les deux. Envoyez les mêmes 20 à 50 requêtes réelles aux deux modèles, mesurez le délai avant le premier token et le coût par tâche achevée, puis faites votre choix en fonction de ces mesures plutôt que de l’index. La page de comparaison d’AIHubMix présente les pages des deux modèles côte à côte.
Comment l’appeler via AIHubMix
Carbon utilise le même format d’ID de modèle sur AIHubMix et le même endpoint de chat completions documenté.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Summarise this incident report and list the follow-ups."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
L’endpoint est POST /v1/chat/completions ; c’est la seule route documentée par AIHubMix pour ce modèle. Le texte est la modalité d’entrée indiquée. L’entrée d’images et de PDF, l’API Responses, Anthropic Messages et l’endpoint Gemini natif ne sont pas documentés pour Carbon sur AIHubMix : considérez-les donc comme non confirmés. Il en va de même pour le mappage de reasoning_effort : ne supposez pas que la passerelle transmet un paramètre de niveau de réflexion. Veillez à ce que max_tokens ne dépasse pas la limite de sortie standard de 65,536 ; les limites supérieures nécessitent le mode d’arrière-plan de Google et ne sont pas confirmées sur AIHubMix. Aucun test en direct n’a été effectué pour cet article ; l’exemple illustre donc la forme de la requête, et non une réponse vérifiée.
FAQ
Carbon coûte-t-il le même prix qu’Argon ?
Oui. Les tarifs officiels de Google sont identiques : $2 par million de tokens en entrée et $10 par million de tokens en sortie jusqu’au 30 novembre 2026, puis $4 et $20. Les lectures depuis le cache coûtent $0.10, puis $0.20.
Carbon est-il meilleur qu’Argon ?
En matière de qualité et de coût par tâche achevée, oui, selon les mesures d’Artificial Analysis : 60.03 contre 50.41 à l’Intelligence Index, et $7.76 contre $9.95 par tâche. En matière de réactivité, non : le premier token de réponse arrive en 67.1 secondes, contre 40.1.
Pourquoi Carbon est-il plus lent s’il termine les tâches plus vite ?
Il attend plus longtemps avant de répondre, puis termine la tâche entière plus rapidement : 25.6 minutes contre 29.0. Le délai avant le premier token et le temps total de la tâche sont deux mesures différentes, et elles vont dans des directions opposées.
Faut-il modifier les requêtes ?
Non. Selon Google, la migration depuis Argon ne nécessite aucune modification du schéma ; il suffit de remplacer le nom du modèle par gemini-4-carbon. Augmentez la limite de sortie et le délai d’expiration HTTP pour tenir compte d’une réflexion plus longue.
Pourquoi Carbon Low coûte-t-il plus cher par tâche que Medium ?
Artificial Analysis a mesuré un coût de $7.19 pour Low, contre $6.59 pour Medium. Considérez Low comme un réglage de latence, et non comme un réglage de réduction du coût, et mesurez le coût par tâche avant de lui envoyer un volume important de requêtes.
Quel est le classement de Carbon sur Artificial Analysis ?
Il occupe la place #4 à l’Intelligence Index, derrière trois configurations de Claude Fable 5.2. La fiche modèle de Google affiche un score arrondi de 59 pour le même index ; le chiffre actuel est 60.03. Il ne faut pas confondre les deux.
Carbon est-il disponible dans l’offre gratuite ?
Non. Google ne propose pas Gemini 4 Carbon dans l’offre gratuite ; l’accès se fait donc via une API payante ou une passerelle telle qu’AIHubMix.
Poursuivez votre lecture : la série Gemini 4 Carbon
- Si cet article vous a convaincu d’essayer Carbon, mais que votre première requête a échoué, le guide de migration aborde les erreurs 400, les paramètres de délai d’expiration et les limites de sortie qui changent avec des phases de réflexion plus longues : Migration de l’API Gemini 4 Carbon : erreurs 400, délais d’expiration et limites de sortie.
- Si vous vous demandez encore si Carbon est assez performant pour le codage agentique, ou si la version premium de Fable 5.2 apporte vraiment quelque chose, le troisième article compare les mêmes chiffres mesurés à ceux de Fable 5.2 : Gemini 4 Carbon vs Fable 5.2 : lequel choisir pour le codage agentique ?.
Sources
- Google AI Studio, Gemini 4 Carbon : nouveautés
- Google DeepMind, fiche modèle Gemini 4 Carbon
- Google AI Studio, tarifs de l’API Gemini
- Artificial Analysis, Gemini 4 Carbon
- AIHubMix, Gemini 4 Carbon