Les trois modèles Gemini 4 partagent une fenêtre de contexte de 1M tokens, une architecture de décodage long et, sur l’API de Google, un même schéma de requête. Pour passer de l’un à l’autre sur cette API, il suffit de changer la chaîne du modèle. Ce qui diffère, c’est l’équilibre entre qualité, coût et latence, et Hydrogen vient de devenir le choix par défaut dans cet éventail.
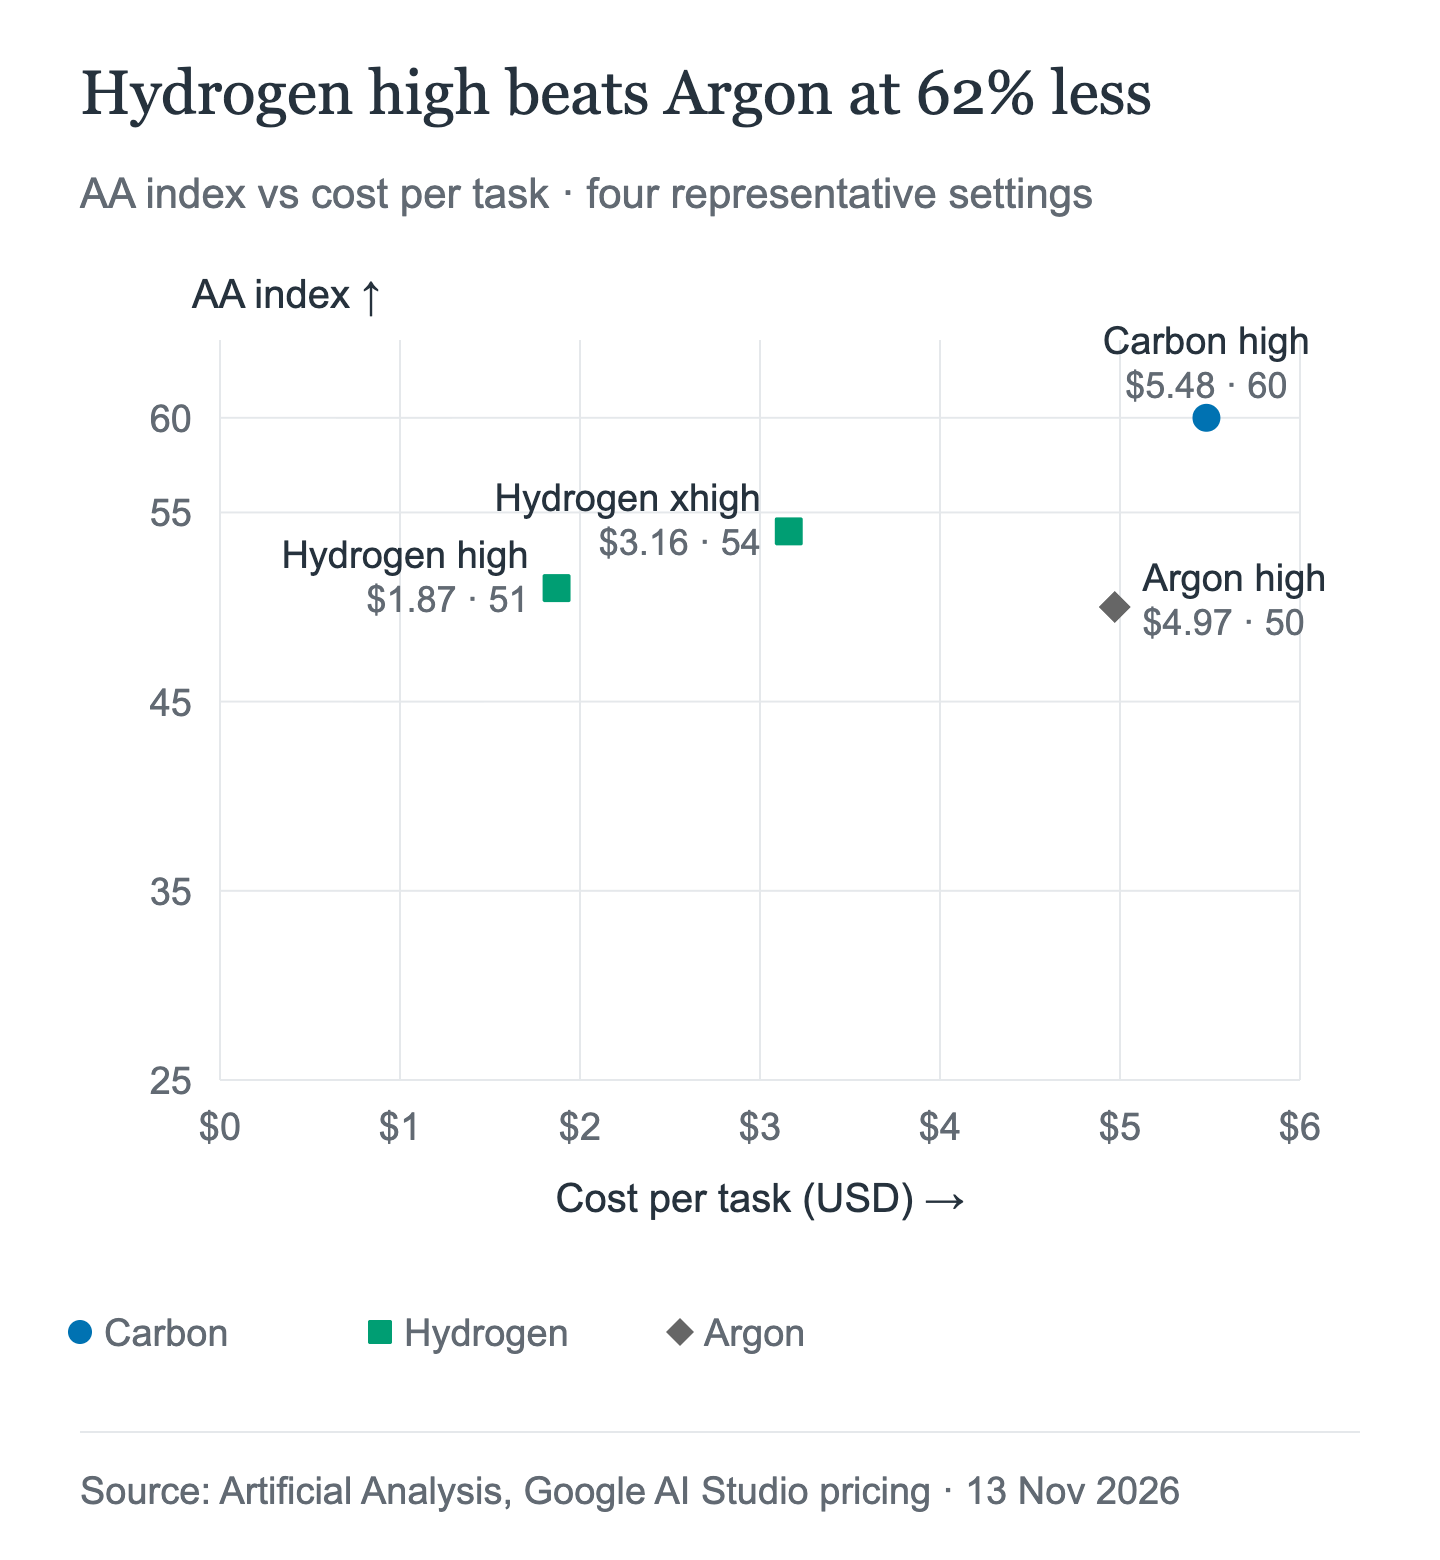
Avec le réglage high par défaut, Hydrogen obtient un score de 51 à l’Intelligence Index d’Artificial Analysis, pour 1,87 $ par tâche et 8,3 minutes. Argon en mode high obtient 50, pour 4,97 $ et 30,6 minutes. Hydrogen a un point d’avance tout en coûtant 62% de moins par tâche. Carbon en mode high reste le meilleur avec un score de 60, mais coûte 5,48 $ par tâche et attend 63,37 secondes avant le premier token de réponse.
Voilà toute la décision en un paragraphe : Carbon pour les tâches les plus difficiles, Hydrogen pour l’exécution, Argon dans les cas où sa prise en charge des protocoles ou son positionnement pour les tâches à long horizon comptent. Le reste de cet article détaille les éléments à l’appui et les exceptions.
Trois modèles, une même structure
Les trois modèles — Carbon, Hydrogen et Argon — disposent d’une fenêtre unifiée de 1,048,576 tokens, qui englobe l’entrée, la réflexion et la sortie. Ils prennent tous en charge le décodage long jusqu’à la taille de cette fenêtre moins l’entrée, utilisent uniquement la mise en cache implicite avec un minimum de 4,096 tokens et, sur l’API de Google, ne nécessitent aucune modification du schéma lorsqu’on change l’ID du modèle.
Les différences se situent dans les réglages par défaut et les cas limites.
| Élément | Carbon | Hydrogen | Argon |
|---|---|---|---|
| Sortie par étape | 65,536 / 32,768 | 65,536 / 65,536 | 65,536 / 32,768 |
| Entrée AIHubMix | multimodale pour tous | multimodale pour tous | multimodale pour tous |
| Protocoles AIHubMix | les quatre | chat uniquement | les quatre |
| Tarif jusqu’au 30 nov. | $2 / $10 / $0.10 | 1.50 / 7.50 / 0.075 | $2 / $10 / $0.10 |
| Tarif à partir du 1er déc. | $4 / $20 / $0.20 | inchangé | $4 / $20 / $0.20 |
Les prix sont en USD par million de tokens d’entrée, de sortie et d’entrée mise en cache. La sortie par étape correspond au nombre maximal de tokens de sortie par étape synchrone, en streaming ou hors streaming. Sur AIHubMix, les trois modèles acceptent en entrée du texte, des images, de l’audio, de la vidéo et des PDF ; Carbon et Argon documentent Chat Completions, Responses, Anthropic Messages et l’API Gemini native, tandis que Hydrogen ne documente que les complétions de chat. Hydrogen ajoute xhigh ; Carbon et Argon s’arrêtent à high et utilisent medium par défaut. Sources : pages des modèles et page des tarifs de Google ; pages des modèles et index des modèles d’AIHubMix.
Les cas d’usage présentés par Google
Google ne présente pas ces modèles comme trois tailles d’un même produit. Dans les notes de version de Gemini 4 Hydrogen, l’entreprise décrit Carbon comme « notre modèle frontier le plus puissant », conçu pour les tâches qui mobilisent davantage de tokens de réflexion sur des problèmes complexes d’architecture, de débogage, de science et de sécurité. Argon peut « gérer la majorité des tâches avancées à long horizon en utilisant moins de tokens que Carbon ». Hydrogen est « rapide et efficace pour gérer des workflows agentiques complexes » et constitue la mise à niveau recommandée depuis Gemini 3.8 Flash.
La fiche du modèle ajoute la distinction importante pour le routage : Carbon et Argon sont « conçus pour un raisonnement approfondi à long horizon », tandis que Hydrogen est « conçu pour une exécution rapide dans divers workflows agentiques » et peut fonctionner « comme sous-agent orchestré aux côtés de modèles frontier ».
Il s’agit d’une répartition du travail, pas d’un classement. Les mesures ci-dessous montrent où cette répartition se vérifie et où le modèle le moins cher a rattrapé son retard.
Le compromis mesuré
L’instantané d’Artificial Analysis, consulté le 2026-11-13T02:40Z, couvre huit configurations. Il s’agit de l’Intelligence Index v5.0.1, qui classe 78 modèles, aux tarifs standard. Les coûts sont ceux des tâches d’AA, et non les factures d’AIHubMix.
| Modèle / effort | Classement AA | Indice AA | $/tâche | Min/tâche | Premier token de réponse |
|---|---|---|---|---|---|
| Carbon high | 4 | 60 | 5.48 | 28.1 | 63.37 s |
| Carbon medium | 6 | 58 | 4.68 | 24.3 | 21.82 s |
| Carbon low | 14 | 54 | 5.22 | 24.7 | 13.61 s |
| Hydrogen xhigh | 16 | 54 | 3.16 | 13.5 | 37.77 s |
| Hydrogen high | 21 | 51 | 1.87 | 8.3 | 18.89 s |
| Hydrogen medium | 39 | 41 | 0.80 | 3.7 | 11.80 s |
| Hydrogen low | 60 | 27 | 0.29 | 1.3 | 5.71 s |
| Argon high | 22 | 50 | 4.97 | 30.6 | 41.30 s |
Trois comparaisons résument l’essentiel.
Carbon high face à Hydrogen xhigh. Carbon a six points d’indice d’avance, coûte 2,32 $ de plus par tâche (73,4% de plus), prend 28,1 minutes contre 13,5 et attend 63,37 secondes avant le premier token, contre 37,77. Carbon atteint le sommet, tandis que Hydrogen en offre l’essentiel à moindre coût et plus rapidement. La page de comparaison présente les deux modèles côte à côte.
Hydrogen high face à Argon high. Hydrogen a un point d’avance, coûte 3,10 $ de moins par tâche (62,4% de moins) et termine en 8,3 minutes contre 30,6. Il attend aussi moins de la moitié du temps avant le premier token : 18,89 secondes contre 41,30. Sur cet indice dominé par le texte, un modèle moins cher surpasse Argon high ; la page de comparaison permet de vérifier les coûts.
Carbon high face à Argon high. Carbon a dix points d’avance pour seulement 0,51 $ de plus par tâche (10,3% de plus) et termine légèrement plus vite, en 28,1 minutes contre 30,6, malgré un premier token plus tardif. La réflexion supplémentaire apporte un réel bénéfice par tâche, même si elle coûte plus cher par tour.
Deux anomalies méritent d’être gardées à l’esprit. Carbon low égale Hydrogen xhigh avec un score de 54, mais coûte 5,22 $ par tâche contre 3,16 $ et prend 24,7 minutes contre 13,5 ; le réglage low de Carbon n’est pas l’option économique. Et les scores de Hydrogen medium et low chutent fortement, à 41 et 27, ce qui montre que l’écart entre Hydrogen et ses modèles frères dépend beaucoup du niveau utilisé.
Évolution des prix au 1er décembre
Le prix de Hydrogen reste constant sur toute la fenêtre de contexte : 1,50 $ pour l’entrée, 7,50 $ pour la sortie et 0,075 $ pour l’entrée mise en cache. Jusqu’au 30 novembre, Carbon et Argon coûtent 2 $, 10 $ et 0,10 $, puis leurs prix doublent le 1er décembre pour atteindre 4 $, 20 $ et 0,20 $. Aucun changement n’a été annoncé pour Hydrogen.
| Modèle | Entrée | Entrée mise en cache | Sortie | Quand |
|---|---|---|---|---|
| Hydrogen | $1.50 | $0.075 | $7.50 | Actuellement, tarif fixe sur 1M |
| Carbon / Argon | $2.00 | $0.10 | $10.00 | Jusqu’au 2026-11-30 |
| Carbon / Argon | $4.00 | $0.20 | $20.00 | À partir du 2026-12-01 |
| Hydrogen Batch / Flex | $0.75 | $0.0375 | $3.75 | Actuellement |
| Carbon / Argon Batch / Flex | $1.00 | $0.05 | $5.00 | Jusqu’au 2026-11-30 |
| Carbon / Argon Batch / Flex | $2.00 | $0.10 | $10.00 | À partir du 2026-12-01 |
Tarifs officiels en USD par million de tokens. L’écart actuel est de 25% par token ; après le 1er décembre, il passera à 62,5% pour l’entrée et la sortie. Si les tarifs de Carbon et Argon doublent tandis que ceux de Hydrogen restent stables, leurs coûts par tâche AA doubleraient eux aussi environ, à mix de tokens identique : environ 10,96 $ pour Carbon high et 9,94 $ pour Argon high. Il s’agit d’une estimation calculée, et non d’une mesure d’AA ni d’une facture d’AIHubMix.
AIHubMix propose les trois modèles aux tarifs actuels de Google. L’offre gratuite est uniquement celle de Google ; l’accès via la passerelle est payant.
Stratégie de routage de Google : Carbon planifie, Hydrogen exécute
Google ne recommande pas de choisir un seul modèle. Les notes de version indiquent : « La planification est confiée à gemini-4-carbon et l’exécution à gemini-4-hydrogen. »
Le nouvel Orchestrator d’Antigravity met cette idée en œuvre sous la forme d’un produit. Il utilise « une approche dynamique et bidirectionnelle entre Carbon et Gemini 4 Hydrogen au fil de l’évolution d’une trajectoire unique ». Carbon explore les dépendances, lève les ambiguïtés et planifie ; Hydrogen s’occupe des modifications, des mises à jour de packages et des tests ; si Hydrogen est bloqué, le travail revient à Carbon, qui répare le plan. Google annonce « des taux de réussite aux tâches proches de Carbon », tout en consommant en moyenne 24% de quota en moins et en terminant 19% plus vite. L’annonce du lancement nomme le benchmark Terminal-Bench 4.0, tandis que l’article d’Antigravity indique 4.1 : la version reste donc incertaine.
C’est une affirmation d’un fournisseur au sujet de son propre produit, et Orchestrator n’est pas disponible via AIHubMix. Mais le principe est transposable : utiliser Carbon pour les tours qui déterminent quoi faire, et Hydrogen pour ceux qui le font. Les mesures ci-dessus confirment cette répartition : Hydrogen high est assez rapide et peu coûteux pour prendre en charge de nombreux tours d’exécution, tandis que Carbon high permet d’obtenir les six derniers points d’indice.
Quel modèle pour quelle tâche
| Tâche | Modèle conseillé et raison |
|---|---|
| Traitement de texte à grand volume | Hydrogen medium ; 0,80 $ par tâche, indice de 41 |
| Exécution d’agents, boucles d’appels d’outils | Hydrogen high ; indice de 51 pour 1,87 $, 8,3 minutes |
| Codage interactif, travail sur l’interface utilisateur | Hydrogen high ; le mode medium d’AA obtient 41 |
| Débogage complexe, architecture | Carbon high ; indice de 60, le meilleur score |
| Images, audio, vidéo, PDF | N’importe lequel des trois ; tous acceptent les mêmes types d’entrée |
| Clients Responses / Anthropic | Carbon ou Argon ; tous deux prennent en charge quatre protocoles |
| Prototypage avec l’offre gratuite | Hydrogen ; le seul des trois à la proposer |
| Planification à long horizon et exécution | Carbon avec Hydrogen ; la stratégie de routage conseillée par Google |
Deux réserves à propos de ce tableau. « Débogage complexe » n’est pas un seuil précis ; le vrai test consiste à déterminer si Hydrogen high ou xhigh réussit votre évaluation, et non si la tâche semble difficile. Et l’offre gratuite est celle de Google, pas celle d’AIHubMix.
Les domaines où Argon et Carbon gardent l’avantage
Argon n’est pas obsolète. Sur l’indice AA dominé par le texte, Hydrogen high le dépasse en qualité, en coût et en durée. Mais Argon conserve un avantage dont Hydrogen ne dispose pas sur AIHubMix : quatre protocoles. Google présente également Argon comme capable de « gérer la majorité des tâches avancées à long horizon », un type de charge différent de la suite de tâches fixe d’AA. Si votre agent utilise un client Responses ou Anthropic Messages, ou fonctionne pendant des heures avec différents outils pour des tâches à long horizon, les résultats d’AA ne suffisent pas à trancher.
Carbon reste le meilleur modèle. Hydrogen xhigh n’est qu’à six points d’indice derrière, pour un coût par tâche inférieur de 42%. Mais ces six points tout en haut de l’indice peuvent décider de la réussite d’une tâche complexe de débogage ou d’architecture. Carbon high termine aussi plus vite par tâche qu’Argon high (28,1 contre 30,6 minutes), même si son premier token arrive plus tard.
Hydrogen est désormais le choix par défaut pour l’exécution. C’est le moins cher par token, le plus rapide par tâche en mode high, le seul à proposer une offre gratuite et le seul à disposer du mode xhigh. Pour les boucles d’exécution avec sortie textuelle, c’est le modèle à battre.
Réserves
- Les chiffres d’AA proviennent d’un seul instantané en direct (v5.0.1, 78 modèles, 2026-11-13T02:40Z). Ils évoluent ; vérifiez-les à nouveau avant de router du trafic en production.
- Les coûts par tâche d’AA sont calculés aux tarifs standard, et non d’après les factures d’AIHubMix.
- Les benchmarks des fournisseurs sont autodéclarés. La fiche de Hydrogen indique Terminal-Bench 4.1 ; celle de Carbon indique Terminal-Bench 4.0. Ne comparez pas directement les deux résultats.
- La prise en charge des protocoles d’AIHubMix varie selon le modèle. Les trois acceptent des entrées multimodales ; Hydrogen ne documente que les complétions de chat.
- Hydrogen est une « version à disponibilité générale (GA) de courte durée, soumise à une politique de préavis de retrait d’au moins 45 jours ». Aucune date de fermeture n’est indiquée pour Carbon ou Argon.
- Aucun test en direct n’a été effectué pour cet article.
FAQ
Quel modèle Gemini 4 est le meilleur ?
Il n’y en a pas un seul. Carbon offre la qualité la plus élevée (60 sur AA), Hydrogen le coût par tâche le plus bas et l’exécution la plus rapide en mode high (51 pour $1.87), et Argon conserve quatre protocoles ainsi que le positionnement de Google pour les tâches à long horizon sur AIHubMix.
Hydrogen est-il meilleur qu’Argon ?
Sur l’indice d’Artificial Analysis axé sur le texte, oui en mode high : 51 contre 50, pour un coût par tâche inférieur de 62%. Argon reste préférable si vous avez besoin d’un endpoint Responses ou Anthropic Messages sur AIHubMix, ou pour des tâches à long horizon, domaine auquel Google le destine.
Lequel est le moins cher ?
Hydrogen est le moins cher par token ($1.50/$7.50) et généralement aussi par tâche sur AA. Mais Hydrogen en modes medium et low est nettement moins performant (41 et 27) : le réglage le moins cher n’est donc pas forcément le réglage le moins cher qui donne des résultats suffisants.
AIHubMix propose-t-il les trois modèles ?
Oui, les trois sont répertoriés. Ils prennent tous en entrée du texte, des images, de l’audio, de la vidéo et des PDF ; Carbon et Argon documentent quatre protocoles, tandis que Hydrogen ne documente que les chat completions.
Puis-je les combiner dans une même application ?
Oui, avec l’API de Google. Le schéma de la requête ne change pas : il suffit de changer la chaîne du modèle. Sur AIHubMix, Hydrogen est documenté uniquement pour les chat completions. Google recommande d’envoyer les étapes de planification à Carbon et celles d’exécution à Hydrogen. Orchestrator automatise cette répartition dans Antigravity, mais pas via AIHubMix.
Que se passe-t-il le 1er décembre ?
Les tarifs de Carbon et Argon doublent, passant de $2/$10 à $4/$20 par million de tokens d’entrée/sortie. Le prix d’Hydrogen ne change pas, et l’écart passe donc de 25% à 62.5%.
Lequel dois-je utiliser pour coder ?
Hydrogen high pour l’exécution et le travail interactif ; Carbon high pour le débogage complexe, l’architecture et la sécurité. Testez Hydrogen xhigh avant de payer pour Carbon pour une tâche simplement longue, mais pas difficile.
À lire ensuite : la série Gemini 4 Hydrogen
- Si vous vous demandez s’il faut quitter Gemini 3.8 Flash, le premier article présente le lancement, le changement de prix et les compromis entre les benchmarks : Gemini 4 Hydrogen vs Gemini 3.8 Flash : la mise à niveau en vaut-elle la peine ?.
- Si vous voulez connaître le coût et la latence de chaque niveau de réflexion avant de faire votre choix, le deuxième article les mesure tous les quatre : Niveaux de réflexion de Gemini 4 Hydrogen : low, medium, high, xhigh.
Sources
- Google AI Studio, Gemini 4 Hydrogen : nouveautés
- Google, Page du modèle Gemini 4 Carbon
- Google, Page du modèle Gemini 4 Argon
- Google Antigravity, Gemini 4 Hydrogen et Orchestrator
- Artificial Analysis, Gemini 4 Hydrogen — instantané en direct 2026-11-13T02:40Z, Intelligence Index v5.0.1