Anthropic a lancé Claude Fable 5.2 le 9 novembre 2026. Google a rendu Gemini 4 Carbon généralement disponible un jour plus tard. Le tableau des benchmarks de lancement d’Anthropic comprend une colonne Carbon, ce qui permet de comparer utilement les deux modèles sur la même charge de travail de codage à long horizon.
Les deux modèles sont proposés pour la même tâche : le codage agentique à long horizon. L’agent lit un dépôt, modifie plusieurs fichiers, exécute des commandes, consulte les résultats des tests et continue pendant 15 à 45 minutes sans intervention humaine. C’est cette tâche qui est évaluée ici. Le chat, la complétion automatique et les scripts courts relèvent d’un autre test.
En bref
Fable 5.2 mène dans les benchmarks de codage difficiles présentés et est plus rapide à effort égal, occupant les trois premières places AA devant Carbon High, classé n° 4. Carbon obtient de meilleurs scores sur les lignes Terminal-Bench 4.0 et AutomationBench-AA présentées, et coûte moins cher par tâche avec un effort élevé jusqu’à la fin du tarif promotionnel de Google, le 30 novembre. Avec un effort moyen, Fable est moins cher et beaucoup plus rapide, tandis que Carbon obtient un meilleur score à l’indice AA.
Choisissez Fable pour le raisonnement sur du code difficile, Carbon pour l’exécution dans un terminal et l’automatisation ; vérifiez les limites d’entrée, de conservation des données et de sortie avant d’utiliser l’un ou l’autre.
Ce que montre un même banc d’essai
Artificial Analysis évalue tous les modèles sur le même banc d’essai et les mêmes tâches ; ses pages Carbon et Fable présentent les résultats de chaque évaluation. Les chiffres proviennent de sa capture du 11 novembre 2026 ; AA utilise les tarifs publics standard, et non le tarif promotionnel de Google.
| Modèle | Indice AA | $/tâche | Min/tâche | Premier token |
|---|---|---|---|---|
| Fable 5.2 Max | 64.56 | 26.54 | 45.2 | 233.9 s |
| Fable 5.2 Xhigh | 62.22 | 14.83 | 26.1 | 69.3 s |
| Fable 5.2 High | 61.82 | 9.08 | 17.3 | 30.4 s |
| Fable 5.2 Medium | 56.41 | 3.80 | 7.8 | 12.8 s |
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s |
| Opus 5.5 Max | 59.11 | 10.04 | 25.0 | 356.4 s |
Remarque : indice Intelligence d’AA et coût par tâche aux tarifs standard, capture 2026-11-11T05:23Z. Fable Max, Xhigh et High occupent les places n° 1 à 3 ; Carbon High est n° 4 ; Opus 5.5 Max est n° 5 ; Carbon Medium est n° 6. « Premier token » désigne le délai avant le premier token de réponse.
Avec un effort élevé, Fable a une avance de 1.79 point, coûte 17.0% de plus par tâche ($9.08 contre $7.76), termine en 17.3 minutes plutôt qu’en 25.6 et renvoie son premier token en 30.4 secondes plutôt qu’en 67.1. Max coûte $26.54 par tâche, soit 3.4 fois le prix de Carbon High, et son délai d’attente est de 233.9 secondes.
Avec un effort moyen, le classement change : Fable obtient 56.41 contre 58.26 pour Carbon, soit 1.85 point de moins, mais coûte $3.80 contre $6.59 et prend 7.8 minutes contre 23.3. Le tarif inférieur de Carbon par token ne le rend pas moins cher par tâche ici : il consomme davantage de tokens.
| Benchmark | Carbon High | Fable High | Fable Max | Opus 5.5 Max |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.15 | 59.6 | 59.6 | 59.6 |
| FrontierCode 2.0 | 40.56 | 49.13 | 48.76 | 46.44 |
| AutomationBench-AA | 77.82 | 71.36 | 76.42 | 69.54 |
| HLE-Diamond | 69.1 | 73.8 | 80.2 | 67.9 |
| % sans hallucination | 88.58 | 42.02 | 40.73 | 49.66 |
| % de précision | 58.27 | 77.23 | 79.13 | 65.5 |
| Elo Briefcase | 1610.6 | 1677.4 | 1785.3 | 1800.6 |
Remarque : Artificial Analysis, même banc d’essai et même capture. Le taux d’absence d’hallucinations correspond à la part des réponses Omniscience sans affirmation inventée ; la précision est un score distinct. Un score plus élevé est préférable sur chaque ligne. Fable Xhigh est omis pour alléger le tableau ; son score FrontierCode 2.0 est de 47.58.
Quel modèle est en tête de chaque test avec un effort élevé ? L’écart signé ci-dessous soustrait le score de Fable à celui de Carbon ; il indique le sens de l’écart, tandis que le tableau ci-dessus présente les scores absolus.
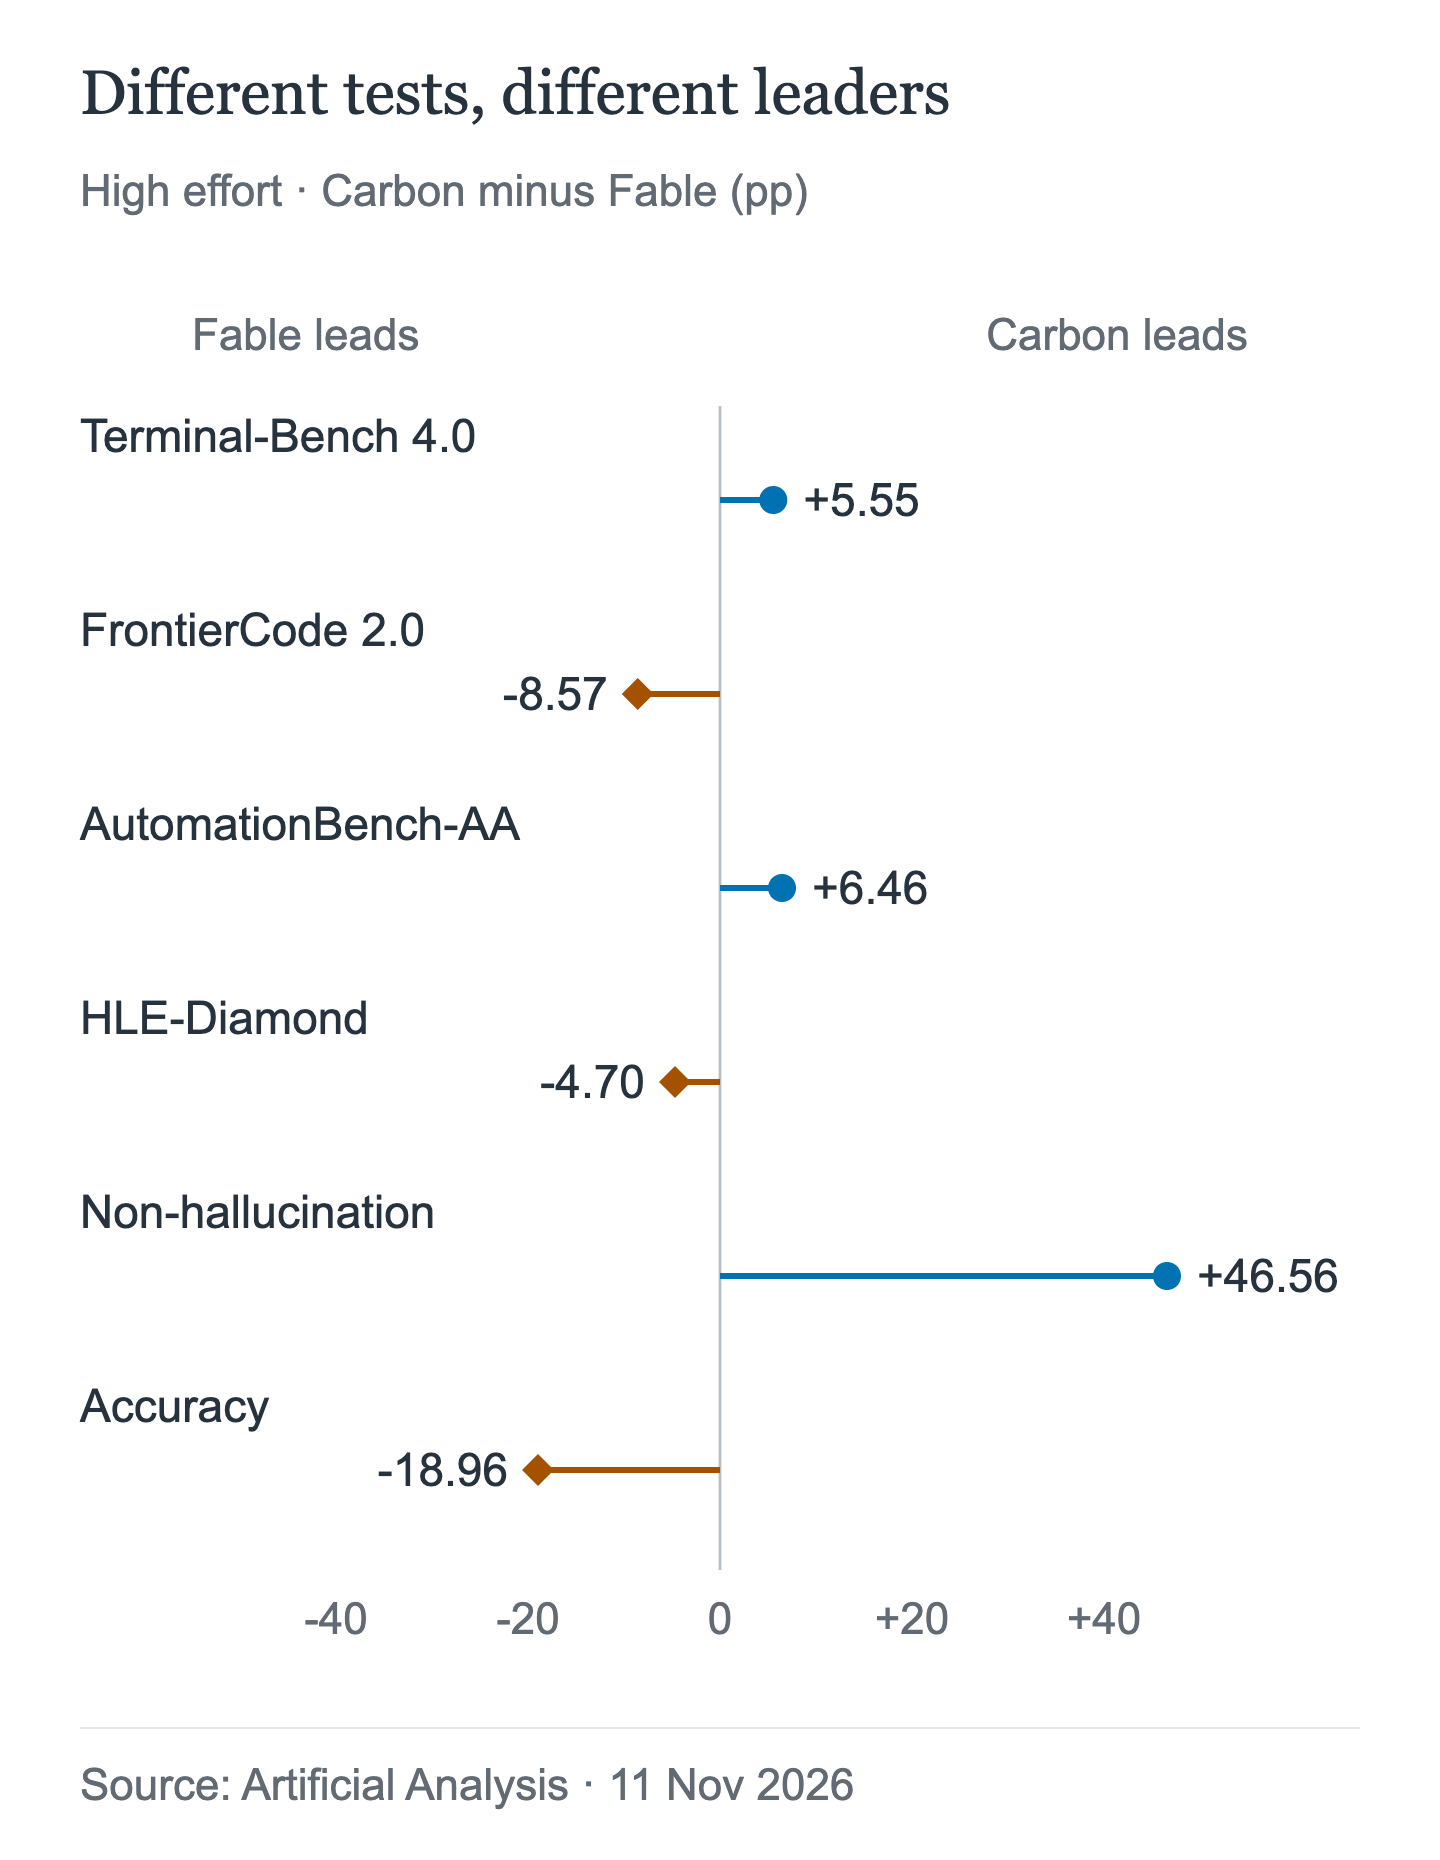
Il s’agit d’écarts en points de pourcentage sur des tests indépendants, et non d’un score de qualité combiné. Un écart plus important sur un benchmark ne signifie pas une amélioration plus importante des capacités générales. En particulier, l’absence d’hallucinations et la précision mesurent des résultats différents.
Fable devance Carbon de 8.57 points sur FrontierCode 2.0 avec un effort élevé et de 4.7 points sur HLE-Diamond ; son Elo Briefcase est de 1677.4 contre 1610.6. FrontierCode est le benchmark qui se rapproche le plus des modifications difficiles portant sur plusieurs fichiers. Carbon devance Fable de 5.55 points sur Terminal-Bench 4.0 et de 6.46 points sur AutomationBench, deux tests qui valorisent l’exécution en ligne de commande, la récupération après erreur et l’automatisation.
L’écart d’absence d’hallucinations est le plus important du tableau : 88.58% pour Carbon contre 42.02% pour Fable avec un effort élevé. La précision donne le résultat inverse : 58.27% contre 77.23%. Carbon est moins susceptible d’inventer des éléments, mais aussi moins susceptible de répondre correctement. Pour un agent qui ne doit pas inventer une API, cela peut être un avantage ; pour un agent qui doit fournir une réponse, la précision de Fable est un meilleur indicateur.
Un effort plus élevé n’est pas toujours préférable : le score FrontierCode de Fable Max, 48.76, est légèrement inférieur à celui de High, 49.13, et Terminal-Bench reste à 59.6.
Le tableau d’Anthropic
La page de lancement d’Anthropic publie un tableau comparatif entre fournisseurs qui inclut Carbon. Les paramètres diffèrent de ceux d’AA : Fable fonctionne en mode Xhigh, son niveau d’effort le plus élevé publié, et Carbon en mode Medium. N’interprétez ce tableau qu’en le comparant à lui-même.
| Benchmark | Fable 5.2 | Carbon |
|---|---|---|
| FrontierCode 2.0 | 49.1 | 41.1 |
| FrontierSWE v2 | 69.9 | 61.2 |
| AutomationBench | 51.4 | 53.9 |
| TB-Science 0.1 | 74.6 | 64.8 |
| OSWorld 2.1 | 89.3 | 81.5 |
| Elo Briefcase | 1785 | 1611 |
| Chartography | 73.4 | 72.5 |
Remarque : chiffres déclarés par Anthropic. Fable en mode Xhigh, son niveau d’effort disponible le plus élevé ; Carbon en mode Medium. L’échelle AutomationBench d’Anthropic diffère de celle d’AA (51.4/53.9 contre 71.36/77.82) ; comparez donc les résultats au sein de ce tableau. Le score 41.1 de Carbon sur FrontierCode correspond à une exécution en mode Medium ; le score 40.56 d’AA correspond à une exécution en mode High sur un autre banc d’essai.
La tendance est la même que chez AA : Fable mène sur FrontierCode, FrontierSWE, OSWorld et TB-Science ; Carbon devance Fable de 2.5 points sur AutomationBench, un écart inférieur aux 6.5 points d’AA, mais qui va dans le même sens. Le tableau étaye l’affirmation « Carbon est compétitif en automatisation », pas « Carbon est le meilleur modèle pour le codage difficile ».
La recommandation d’Anthropic elle-même nuance l’idée que « Fable est la mise à niveau » : « Pour la plupart des tâches de codage et de connaissance, nous recommandons aux utilisateurs de commencer par Claude Opus 5.5. » Selon Anthropic, avec un effort élevé, Fable obtient un score à peu près égal au meilleur résultat d’Opus 5.5 (45.3% contre 45.5%) pour environ la moitié du coût par tâche.
Le coût des tokens
| Modèle | Entrée | Sortie | Lecture du cache |
|---|---|---|---|
| Carbon, jusqu’au 30 novembre | $2 | $10 | $0.10 |
| Carbon, à partir du 1er décembre | $4 | $20 | $0.20 |
| Fable 5.2 | $8 | $40 | $0.20 |
| Opus 5.5 | $4 | $20 | $0.20 |
Remarque : USD par 1M tokens, tarifs officiels. Écritures dans le cache de Fable : $10 (5 min) ou $16 (1 heure) ; Batch bénéficie d’une réduction de 50%. Le tarif affiché pour Carbon dans le cache correspond à une lecture ; le tarif officiel de lecture du cache d’Opus 5.5 est de $0.20.
Le prix au token de Fable est deux fois supérieur au tarif standard de Carbon et quatre fois supérieur à son tarif de lancement. Le rapport est simple ; le coût par tâche, lui, ne l’est pas. AA a mesuré un coût de $7.76 pour Carbon High à $4/$20, contre $9.08 pour Fable High, soit un écart de 17.0%. Au tarif de Google de $2/$10, la même utilisation coûte environ $3.88, selon une estimation calculée. Jusqu’au 30 novembre, Fable High coûte environ 2.3 fois plus cher par tâche ; à partir du 1er décembre, l’écart revient à 17.0%.
Aux tarifs standard, Fable Medium coûte $3.80 contre $6.59 pour Carbon, soit 42% de moins malgré un prix au token deux fois plus élevé. Carbon met 23.3 minutes et consomme davantage de tokens ; Fable met 7.8 minutes. Au tarif de lancement, Carbon Medium revient à environ $3.30, selon le même calcul, soit un coût proche de celui de Fable ; cet avantage disparaît le 1er décembre.
Par tâche, Max coûte 3.4 fois plus cher que Carbon High ($26.54) et prend 45.2 minutes. Dépenser davantage ne garantit pas un agent de codage uniformément meilleur : le score FrontierCode de Max est légèrement inférieur à celui de High.
AIHubMix propose Carbon au tarif de lancement de Google. Les chiffres de Fable présentés ici correspondent aux tarifs officiels d’Anthropic.
Différences de comportement qui influencent les déploiements
| Critère | Carbon | Fable 5.2 |
|---|---|---|
| Sortie maximale | 65,536 ; jusqu’à 1,048,576−input* en natif | 128,000 |
| Contexte | 1,048,576 (natif chez Google) | 1M |
| Réflexion | low / medium / high ; medium par défaut | adaptative ; high par défaut |
| Outils imposés | auto documenté* | any / tool renvoie 400 |
| Échantillonnage | ignoré ; à supprimer | certaines valeurs renvoient 400 |
| Conservation des données | aucune limite indiquée | 30 jours ; pas de ZDR |
| Entrée | texte sur AIHubMix | texte, image, PDF† |
| Date limite des connaissances | mars 2026 | juin 2026 |
Remarque : *Les plafonds supérieurs de Carbon relèvent des capacités Google natives de décodage long ; AIHubMix documente actuellement uniquement les entrées textuelles et Chat Completions ; la prise en charge par la passerelle n’est pas confirmée. †Les modalités d’entrée de Fable proviennent de l’index des modèles d’AIHubMix. *AIHubMix documente tool_choice="auto", mais la prise en charge spécifique à Carbon n’est pas confirmée. La limite de sortie documentée pour le modèle Fable est de 128,000. ZDR signifie « zero data retention », soit l’absence de conservation des données.
L’utilisation forcée d’outils constitue un blocage majeur avec Fable : « L’utilisation forcée d’outils (les types any et tool de tool_choice) renvoie une erreur 400. » Un agent qui doit appeler un outil spécifique à chaque tour ne peut pas utiliser Fable tel quel. Le guide Carbon de Google recommande des tours d’exécution séquentiels des outils ; AIHubMix documente tool_choice="auto" dans son guide Gemini, mais la prise en charge des outils par Carbon sur la passerelle n’est pas confirmée.
La conservation des données constitue un obstacle lié aux politiques pour Fable, dont la page de présentation indique qu’il « exige une conservation des données de 30 jours et n’est pas disponible avec une politique de conservation nulle, sauf autorisation expresse d’Anthropic ». La documentation de Carbon, telle qu’elle a été consultée ici, ne mentionne aucune contrainte de ce type ; cela ne constitue pas une garantie. Les équipes soumises à une réglementation devraient confirmer les politiques des deux modèles avant leur déploiement.
La limite standard de 65,536 tokens de Carbon couvre la plupart des modifications ; la génération de fichiers entiers peut la dépasser. Le mode d’arrière-plan natif de Google peut atteindre jusqu’à 1,048,576 moins le nombre de tokens d’entrée, facture les segments intermédiaires et peut renvoyer incomplete avec un texte vide tout en facturant l’opération. AIHubMix n’a pas documenté cette fonctionnalité. Fable renvoie ses 128,000 tokens en une seule réponse.
Aucun des deux modèles ne permet de désactiver la réflexion. Carbon propose les niveaux low, medium et high, utilise medium par défaut et ignore les paramètres d’échantillonnage. La « réflexion adaptative de Fable est toujours activée et ne peut pas être désactivée » ; le niveau high est utilisé par défaut et certaines valeurs d’échantillonnage renvoient une erreur 400.
Google a mis Carbon à la disposition des défenseurs dans le cadre de son programme Fairwind avant sa disponibilité générale. Les classificateurs de Fable bloquent les demandes de test d’intrusion et d’exploitation de vulnérabilités, et redirigent les tâches liées à la cybersécurité et à la biologie vers d’autres modèles. Pour les tests de sécurité, le comportement face aux refus compte davantage qu’une ligne de benchmark.
Opus 5.5 comme référence
Opus 5.5 n’est pas le concurrent, mais c’est la référence d’Anthropic. Au tarif de $4/$20, il obtient 59.11 sur AA, coûte $10.04 par tâche, prend 25.0 minutes et met 356.4 secondes à renvoyer son premier token, le délai le plus long du tableau (la ligne AA correspond au niveau d’effort Max ; le niveau par défaut est medium). Il domine le classement Elo Briefcase avec 1800.6, mais reste derrière Fable High sur FrontierCode et Carbon High sur Terminal-Bench. Anthropic recommande malgré tout de commencer par Opus 5.5 pour la plupart des tâches de codage.
Quel modèle choisir ?
Choisissez Fable 5.2 si les modifications difficiles de code sont votre priorité et que vous recherchez les meilleurs résultats mesurés sur FrontierCode et HLE. Avec un effort moyen, il est moins cher et plus rapide — $3.80 et 7.8 minutes contre $6.59 et 23.3 pour Carbon — tandis que Carbon obtient un score plus élevé à l’indice AA. Choisissez-le si vous avez besoin d’entrées image, d’une date limite des connaissances fixée à juin 2026, ou si une conservation des données de 30 jours et l’absence d’appels d’outils forcés vous conviennent.
Choisissez Carbon si le travail dans le terminal domine : cycles de test et correction, automatisation shell, opérations en plusieurs étapes. Il obtient de meilleurs résultats dans les lignes Terminal-Bench 4.0 et AutomationBench-AA présentées, et coûte moins cher avec un effort High jusqu’au 30 novembre. Son contexte natif Google et ses limites de sortie longue ne sont pas confirmés via AIHubMix ; déployez-le en mode texte uniquement avec tool_choice="auto" après avoir confirmé la prise en charge des outils par Carbon. Son score de non-hallucination est supérieur, mais sa précision est inférieure.
Choisissez Opus 5.5 pour suivre le point de départ recommandé par Anthropic et bénéficier d’un profil équilibré ; acceptez le délai avant le premier token en mode d’effort Max.
Ne choisissez ni l’un ni l’autre si la latence interactive est essentielle : le premier token en mode d’effort High prend 30.4 secondes avec Fable et 67.1 avec Carbon, et les 23.2 secondes de Carbon en mode Medium restent très loin de la vitesse d’une conversation.
Exécutez les deux via AIHubMix
AIHubMix propose les deux modèles avec une seule clé et un endpoint commun de chat completions. L’ID de Carbon est gemini-4-carbon ; la page du modèle documente les chat completions, l’entrée texte et le tarif de lancement de Google. L’ID de Fable 5.2 est claude-fable-5-2 ; AIHubMix répertorie Chat Completions, Responses et Anthropic Messages, avec un contexte de 1M et une sortie maximale de 128K. La surface documentée de Carbon est plus limitée : les chat completions, et non l’API Gemini native. La passerelle réessaie également avec le fournisseur suivant le mieux classé ; le comportement peut donc différer de celui d’un déploiement chez un seul fournisseur.
Le guide de démarrage rapide présente l’authentification et l’URL de base. Un test rapide permet de vérifier si les deux ID fonctionnent avec la même clé ; aucun test en direct n’a été effectué pour cette version préliminaire :
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

for model in ("gemini-4-carbon", "claude-fable-5-2"):
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Reply with OK."}],
        max_tokens=4096,
    )
    print(model, response.choices[0].message.content)
Ce test vérifie le routage, pas les capacités : aucun outil ni sortie longue. Pour une véritable comparaison, exécutez la même trace d’agent avec les deux ID et consignez la durée des tâches, l’utilisation des tokens et les échecs. La page de comparaison présente côte à côte le contexte, les protocoles et les tarifs.
FAQ
Gemini 4 Carbon est-il meilleur que Fable 5.2 pour le codage agentique ?
Aucun ne l’emporte sur tous les aspects du travail. Fable 5.2 est en tête de FrontierCode 2.0 et de l’indice global avec un effort High ; Carbon domine Terminal-Bench 4.0 et AutomationBench. Choisissez en fonction des tâches réellement exécutées par l’agent.
Pourquoi Fable 5.2 coûte-t-il quatre fois plus cher que Carbon ?
Aux tarifs officiels, Fable coûte $8/$40 par million de tokens, contre le tarif de lancement de Carbon à $2/$10, soit quatre fois plus cher pour l’entrée comme pour la sortie. Par rapport au tarif standard de Carbon, $4/$20 à partir du 1er décembre, Fable coûte deux fois plus cher.
Fable 5.2 coûte-t-il vraiment moins cher par tâche en mode Medium ?
Aux tarifs standard, oui : $3.80 contre $6.59 pour Carbon en mode Medium, et 7.8 minutes contre 23.3. Le tarif de lancement des tokens de Carbon réduit l’écart ; la comparaison aux tarifs standard est la plus pérenne.
Fable 5.2 peut-il imposer un appel d’outil ?
Non. Anthropic indique que les valeurs any et tool de tool_choice renvoient une erreur 400. Les agents qui ont besoin d’imposer un appel doivent utiliser une autre boucle ou un autre modèle.
Carbon est-il moins susceptible d’halluciner que Fable 5.2 ?
Selon la mesure de non-hallucination Omniscience d’AA, oui : 88.58% contre 42.02% avec un effort High. Sa précision est toutefois inférieure, à 58.27% contre 77.23% ; il est donc aussi moins susceptible de fournir la bonne réponse.
Les deux modèles peuvent-ils être utilisés via AIHubMix avec une seule clé ?
Oui. Utilisez gemini-4-carbon et claude-fable-5-2 avec la même clé et la même URL de base. AIHubMix documente les chat completions pour Carbon, et les chat completions, Responses et Messages pour Fable.
Poursuivez votre lecture : la gamme Gemini 4 Carbon
- Avant de choisir un modèle concurrent, répondez d’abord à la question des modèles de la même gamme : Gemini 4 Carbon vs Argon: Same Price, When Is Carbon Worth It?
- Une fois Carbon intégré à votre flux, les premières erreurs 400 et les délais d’expiration sont généralement dus à la configuration, pas au modèle : Gemini 4 Carbon API Migration: 400 Errors, Timeouts and Output Limits
Sources
- Gemini 4 Carbon now available — Google, 10 novembre 2026.
- Claude Fable 5.2 — Anthropic, 9 novembre 2026.
- Claude Fable 5.2 overview — documentation Anthropic.
- Gemini 4 Carbon et Claude Fable 5.2 — Artificial Analysis, instantané du 11 novembre 2026.
- Gemini 4 Carbon on AIHubMix — page du modèle et tarifs.