

El 2026-11-03/04, la suite APB Full se ejecutó con DeepSeek V4.1 Flash 1017 en cinco proveedores a través de AIHubMix. Se usaron las mismas preguntas, parámetros y scripts de solicitud para todos los proveedores; las cinco entradas de proveedor están en la página de modelos. Este perfil APB cubre únicamente el canal oficial de DeepSeek. Se accede a él a través de la ruta del proveedor oficial de DeepSeek de AIHubMix, no mediante una conexión directa a la API de DeepSeek.
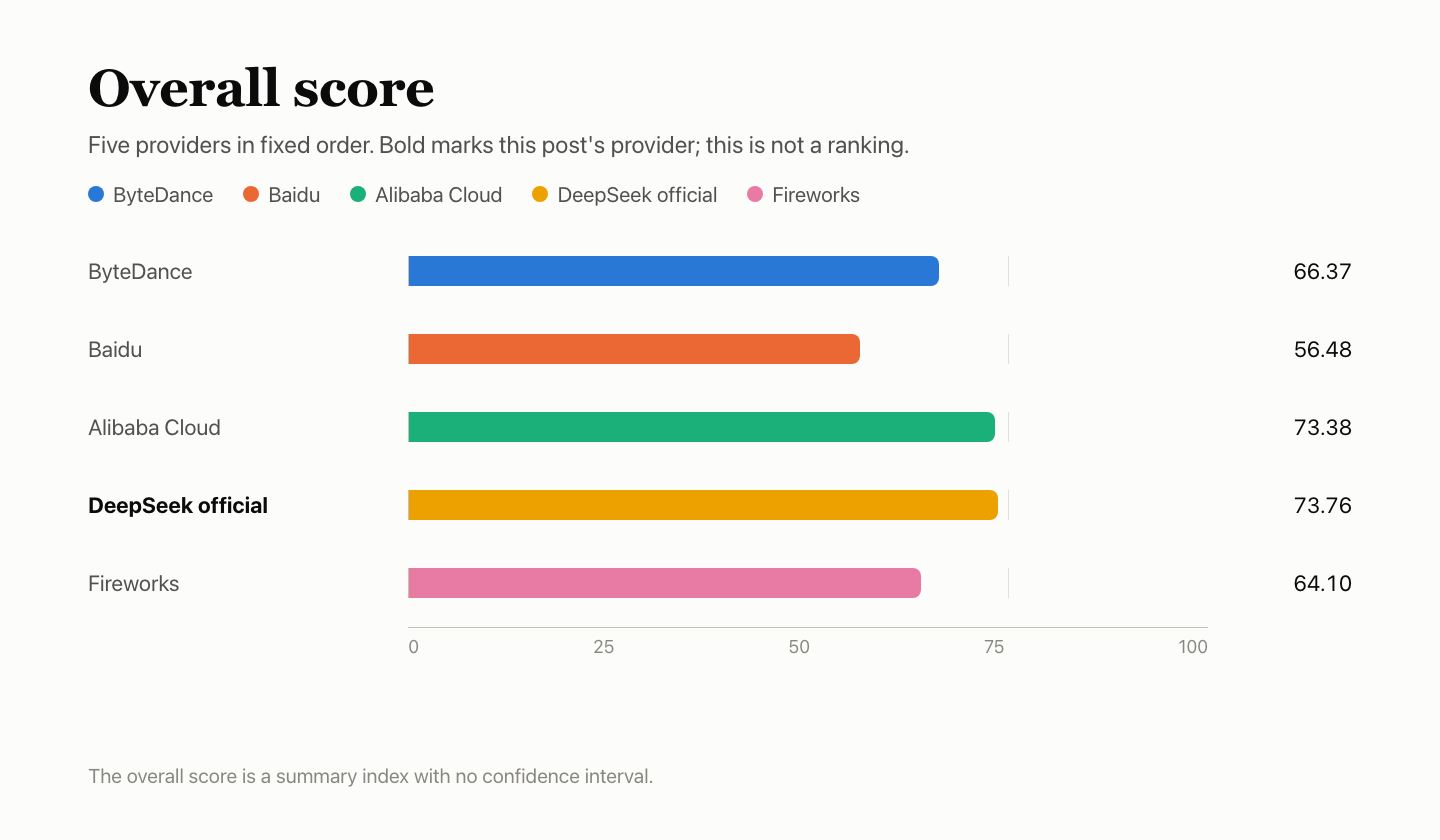
Esta publicación informa solo de puntuaciones, sin clasificar a los proveedores ni recomendar ninguno: Q 42.45, F 94.00, P 86.14, K 98.38 y R 100. Q, F, P y R son las puntuaciones de las cuatro secciones; K es una subpuntuación de P. La puntuación global, 73.76, es un índice resumido, no una certificación, y no tiene intervalo de confianza. El estándar de puntuación es AIHubMix Provider Benchmark Standard v2.0.
Puntuaciones de cinco proveedores
La negrita identifica al proveedor de esta publicación. El orden de los proveedores es fijo y no representa una clasificación. K es una subpuntuación de P con un peso del 20% y se muestra por separado como referencia. La puntuación global es un índice resumido sin intervalo de confianza. El canal oficial de DeepSeek y Alibaba Cloud difieren en 0.37 puntos en la puntuación global, una diferencia que no permite distinguirlos.
De un vistazo
- Calidad de respuesta: Q 42.45. BFCL 86.13%, HLE 15.06%, AA-LCR 53.20%. Siete respuestas de HLE se truncaron al alcanzar el límite de max_tokens y se contabilizaron como incorrectas. Este canal es la referencia de Q para los otros cuatro.
- Compatibilidad con funciones: F 94.00. Se aprobaron 137 de las 147 comprobaciones contabilizadas. Otras 27 comprobaciones que dependen del recuento exacto de tokens se declararon no válidas y se excluyeron del denominador.
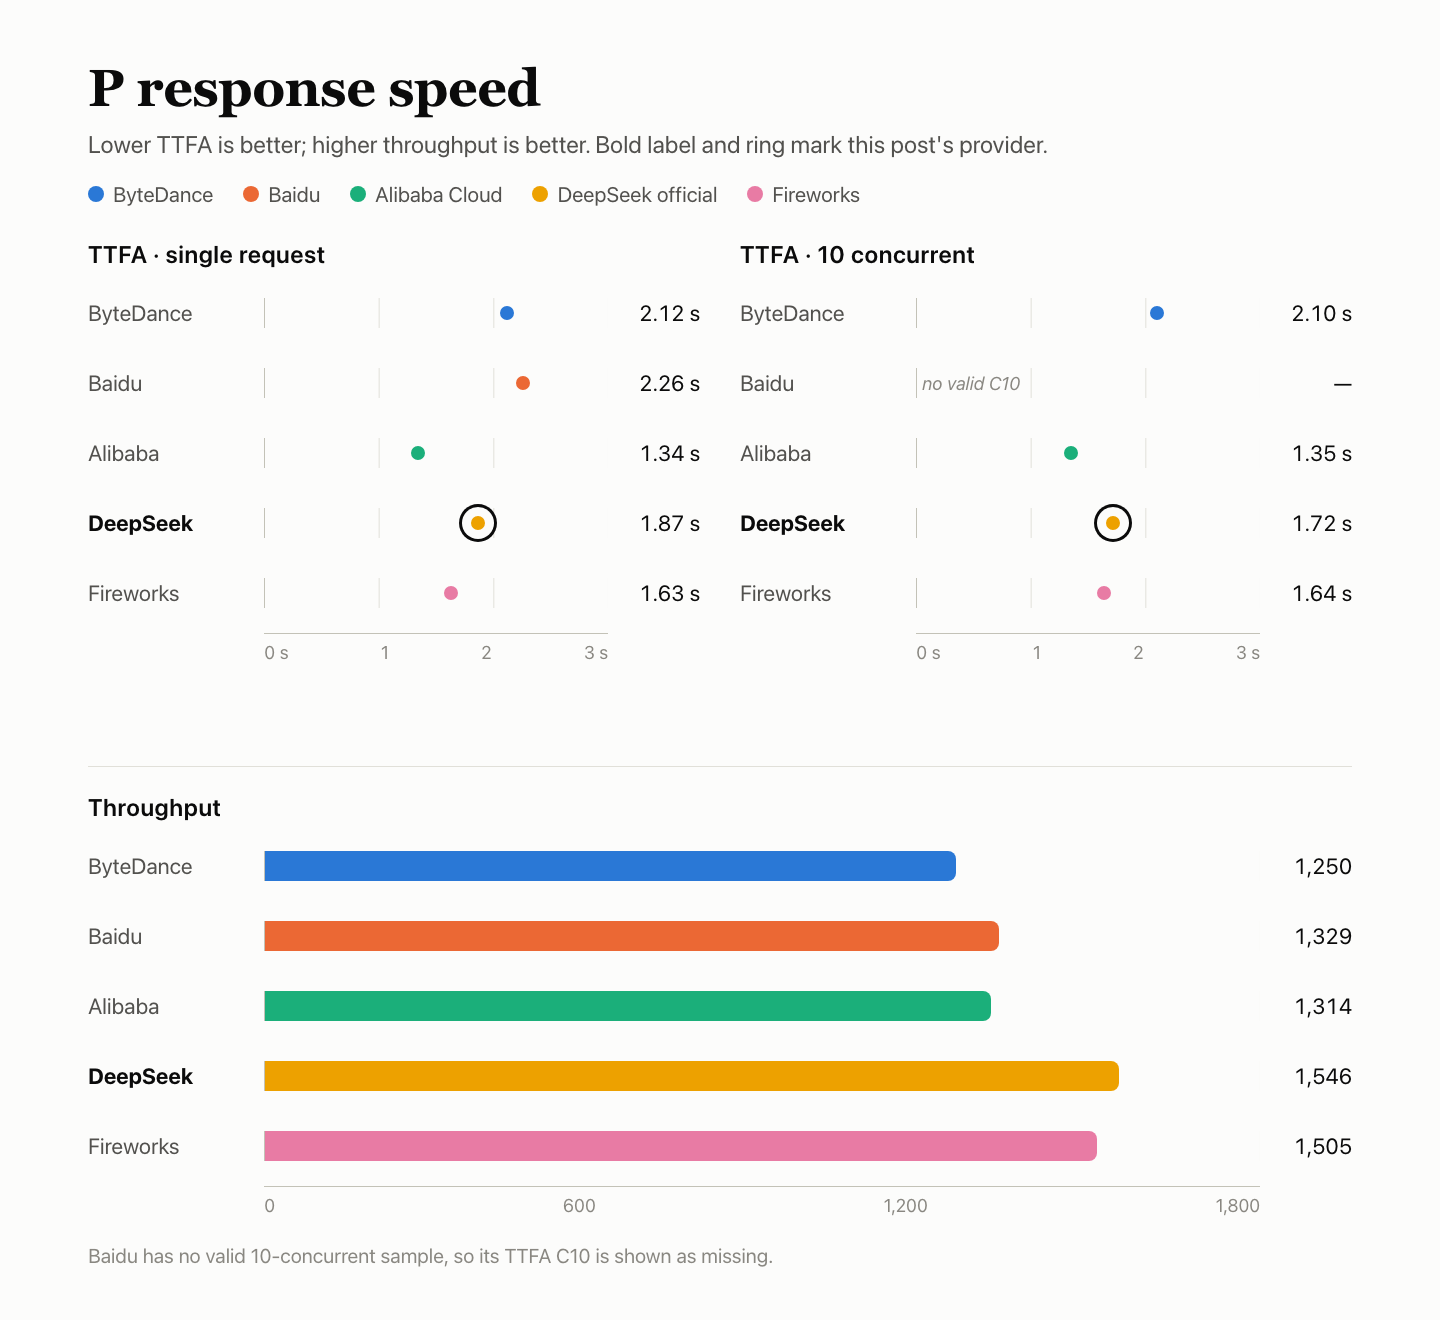
- Velocidad de respuesta: P 86.14. En la primera ventana de concurrencia única hubo 15 solicitudes no válidas de 30 (12 × 503, 2 × tiempo límite, 1 × tiempo de espera de lectura), contabilizadas como infinitas; mediana del tiempo hasta el primer token: 1.87 s (1.72 s solo para solicitudes válidas); 1.72 s con concurrencia de 10; TPOT: 2.84 ms.
- Caché: K 98.38. Las 18 solicitudes con prefijo en caché de 8k y 32k acertaron; los controles sin caché no leyeron ninguna caché.
- Estabilidad del servicio: R 100. Las 300 solicitudes dedicadas se completaron correctamente al primer intento.
Configuración de la prueba
Las solicitudes pasaron por AIHubMix al seleccionar la ruta del proveedor oficial de DeepSeek; la guía de inicio rápido explica cómo configurar el acceso.
| Elemento | Detalle |
|---|---|
| Modelo | DeepSeek V4.1 Flash 1017 |
| ID del modelo solicitado | deepseek-flash |
| Nombre del modelo devuelto | deepseek-flash |
| Ruta de acceso | Ruta del proveedor oficial de DeepSeek de AIHubMix; no es una conexión directa a la API de DeepSeek |
| Parámetros | Modo sin pensamiento, temperatura 1.0, max_tokens 16,384, tiempo de espera 300 s, sin reintentos automáticos |
| Pensamiento desactivado | Todas las solicitudes usaron reasoning_effort=none |
| Fecha y hora | 2026-11-03 18:07 – 11-04 16:33 UTC+8; los cinco proveedores compartieron un Mac mini, una red y una cuenta |
| Muestras | Calidad de respuesta: 4,250 intentos (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10); casos de funciones: 60 × 3 ventanas; velocidad: 90 con concurrencia única y 90 con concurrencia de 10; estabilidad: 300; caché: 30 (tres grupos por cada prefijo de 8k y 32k) |
Q — calidad de respuesta: 42.45
La suite combina BFCL 500 preguntas × 3 ejecuciones, HLE 250 × 10 y AA-LCR 25 × 10. BFCL se evalúa con reglas automáticas; HLE y AA-LCR se evalúan con el modelo juez deepseek-flash. Los cinco proveedores respondieron las mismas preguntas. Diez respuestas no se pudieron evaluar y se eliminaron, por lo que quedaron 4,240 intentos puntuados.
| Benchmark | Preguntas | Correctas | Precisión | Fallos |
|---|---|---|---|---|
| Llamadas a herramientas de BFCL | 500 × 3 | 1,292/1,500 | 86.13% | 0 |
| Preguntas y respuestas difíciles de HLE | 250 × 10 | 375/2,490 | 15.06% | 7 |
| Razonamiento sobre documentos largos de AA-LCR | 25 × 10 | 133/250 | 53.20% | 0 |
| Total · IC del 95%: 40.08%–44.73% | 4,240 puntuadas | 1,800/4,240 | 42.45% | 7 |
Los fallos del servicio —una solicitud fallida o una respuesta truncada— permanecen en el denominador y se cuentan como incorrectos. En este caso, se trata de siete respuestas de HLE que alcanzaron el límite de max_tokens. BFCL se puntúa automáticamente; HLE y AA-LCR se evalúan con un modelo juez.
Los denominadores de BFCL son totales de tres ejecuciones.
| Categoría de BFCL | Aprobadas | Tasa de aprobación |
|---|---|---|
| simple_python — una función, llamada y argumentos correctos | 334/360 | 92.78% |
| multiple — elegir la función correcta entre varias | 268/300 | 89.33% |
| parallel — llamar varias veces en paralelo a la misma función | 271/300 | 90.33% |
| parallel_multiple — llamar en paralelo a varias funciones diferentes | 207/240 | 86.25% |
| irrelevance — ninguna función es pertinente, no se debe llamar a ninguna | 113/150 | 75.33% |
| ahm_multi_turn — cadena de herramientas de tres etapas | 99/150 | 66.00% |
Comparación con los otros cuatro
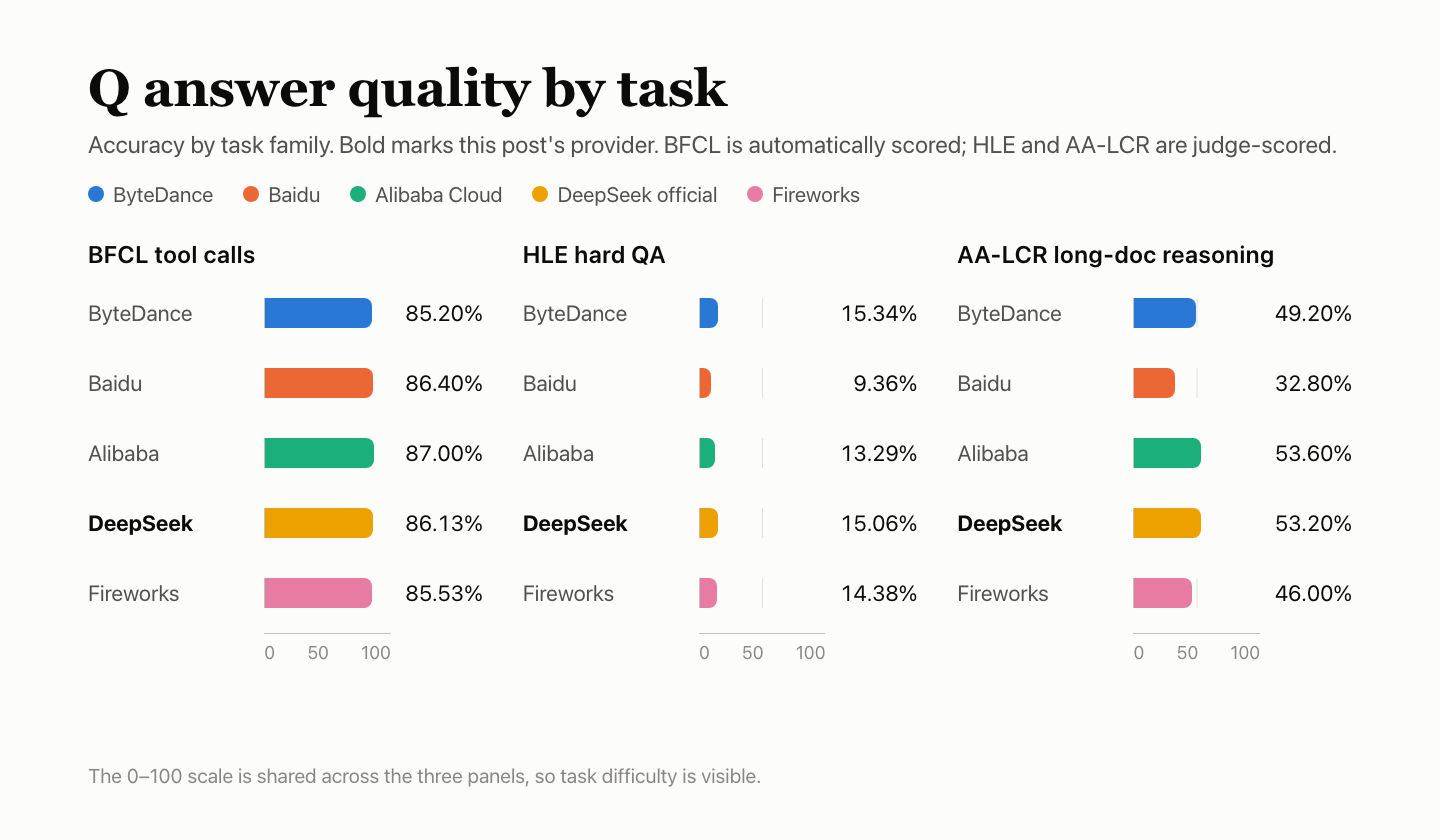
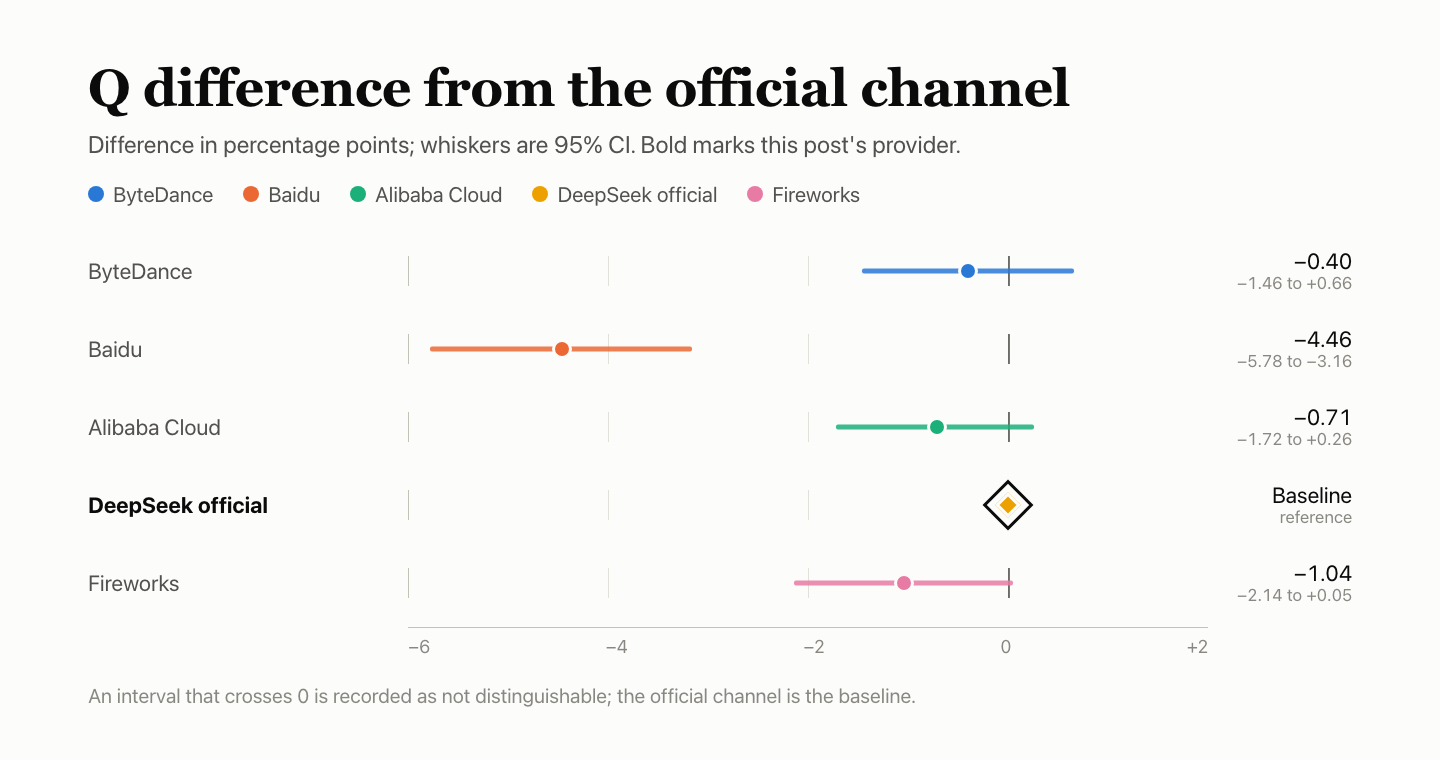
Cada diferencia se expresa en puntos porcentuales con respecto a esta referencia, y los bigotes muestran un intervalo del 95%; si el intervalo cruza el 0, no se puede distinguir la diferencia. El modelo juez pertenece a la misma familia DeepSeek que el modelo evaluado y no se calibró, por lo que la evaluación de HLE y AA-LCR podría ser indulgente.
F — compatibilidad con funciones: 94.00
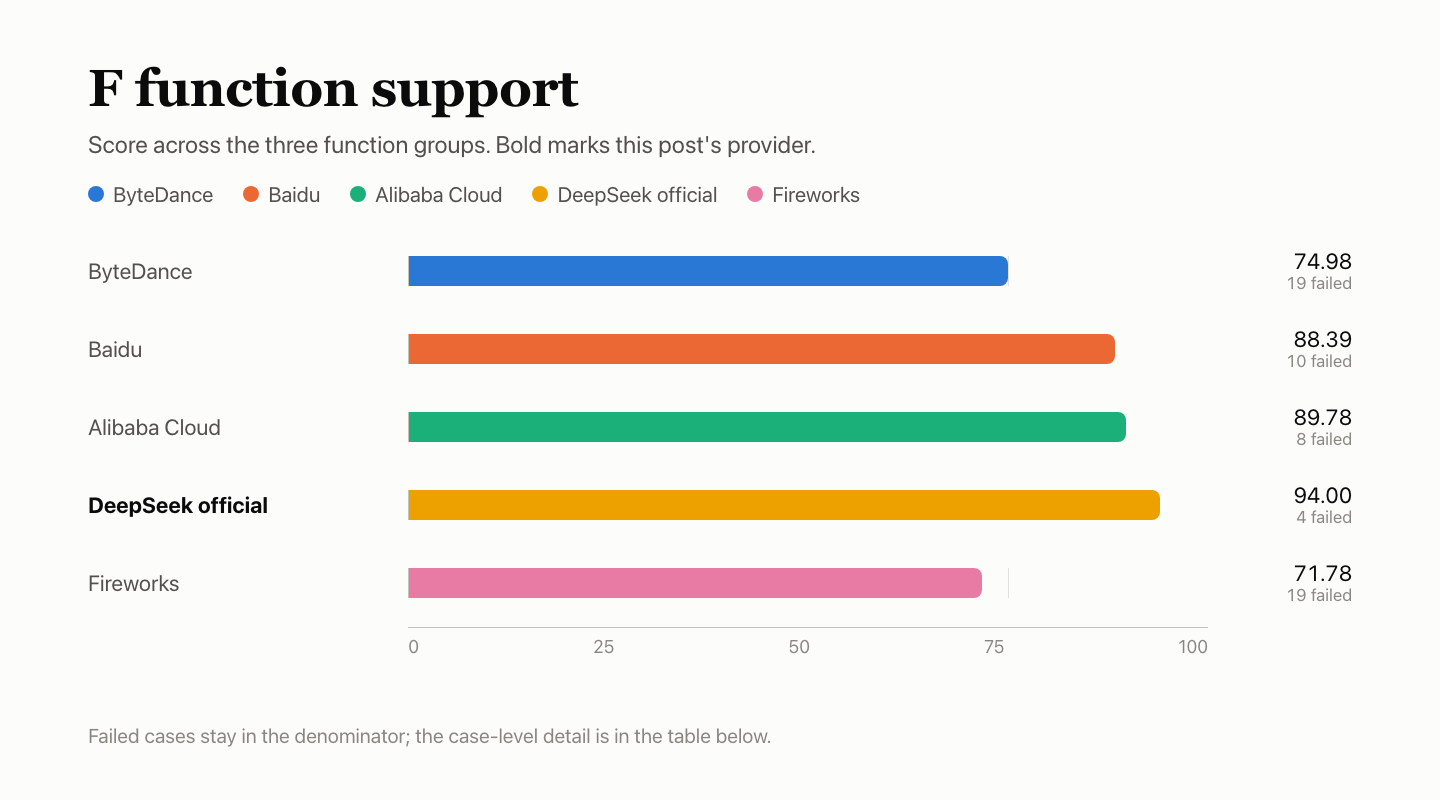
Los casos de funciones evalúan el comportamiento del protocolo, no la calidad de respuesta. En cada una de tres ventanas se ejecutaron 60 casos de seis grupos —180 comprobaciones—, evaluados según el formato que especifica la documentación de cada proveedor. Las comprobaciones no aplicables, no válidas y no observadas se excluyen del denominador. Este canal aprobó 137 de las 147 comprobaciones contabilizadas, con una puntuación ponderada de 94.00; la puntuación ponderada no es un simple 137/147.
| Grupo | Peso | Aprobadas | Excluidas | Puntuación del grupo |
|---|---|---|---|---|
| Streaming y protocolo de mensajes | 20% | 27/27 | 3 | 100.00 |
| Interfaz de herramientas | 20% | 30/30 | — | 100.00 |
| Restricciones de salida y parámetros | 20% | 30/30 | — | 100.00 |
| Contexto y estado | 15% | 14/15 | 15 | 93.33 |
| Errores y recuperación | 15% | 24/30 | — | 80.00 |
| Medición de uso y protocolo de caché | 10% | 12/15 | 15 | 80.00 |
| Total · ponderado | — | 137/147 | 33 | 94.00 |
La puntuación ponderada sigue los pesos de los grupos; no es el número de comprobaciones aprobadas dividido por 147.
| Caso fallido | Ventanas con fallos | Motivo |
|---|---|---|
| Mensajes mal formados (Errores y recuperación) | 3/3 | Se devolvió 400, pero el cuerpo estaba vacío y no incluía una descripción estructurada del error |
| stream_options mal formado (Errores y recuperación) | 3/3 | Se devolvió 400, pero el cuerpo estaba vacío y no incluía una descripción estructurada del error |
| Medición de tokens de pensamiento (Medición de uso y protocolo de caché) | 3/3 | No se devolvió el recuento de tokens de pensamiento |
| Aislamiento de solicitudes (Contexto y estado) | 1/3 | El primer paso no respondió únicamente STORED como se requería, por lo que no se pudo continuar con la comprobación de aislamiento |
Las comprobaciones excluidas no cuentan ni como aprobadas ni como fallidas.
| Estado | Caso | Cantidad | Motivo |
|---|---|---|---|
| No observada | Secuencia de detención de streaming | 3 | La solicitud de este paso no se envió después del paso anterior, por lo que no se pudo evaluar |
| No válida | Entrada larga de 10k; dentro del límite de contexto; entrada larga de 32k; entrada larga de 100k; excede el contexto; recuento de entrada nativo; definiciones de herramientas contabilizadas en la entrada; recuento de entrada coherente antes y después de la caché; coherencia de entrada entre streaming y sin streaming | 27 | La plantilla de recuento nativo fijada en las pruebas no coincidía con el uso informado por este canal, así que las comprobaciones que dependían de recuentos exactos se declararon no válidas y se excluyeron del denominador |
| No aplicable | cache_control explícito | 3 | Registrado de antemano como no compatible con esta interfaz |
Las 27 comprobaciones no válidas son los casos de entrada larga, límite de contexto, recuento nativo y coherencia de caché de la lista. Como la plantilla fijada no coincidía con el uso informado por este canal, todas las comprobaciones que dependían de un recuento exacto se excluyeron en lugar de puntuarse.
Dos casos fallaron en los cinco proveedores: messages y stream_options mal formados. Ambos devolvieron un 400 con el cuerpo vacío, por lo que el cliente no recibió una descripción estructurada del error. Este patrón compartido apunta más a la capa de pasarela de AIHubMix, que requiere una investigación aparte. La medición de tokens de pensamiento también falló en los cinco, aunque por motivos distintos: ByteDance y Fireworks siguieron informando de tokens de pensamiento después de desactivar el pensamiento, mientras que los otros tres no devolvieron el recuento de tokens de pensamiento.
Comparación con los otros cuatro
P — velocidad de respuesta: 86.14
Cada solicitud incluía unos 10,000 tokens de entrada y pedía unos 1,100 tokens de salida. En cada una de las tres ventanas se enviaron 30 solicitudes con concurrencia única y 30 con concurrencia de 10, para un total de 180.
| Métrica | Valor |
|---|---|
| TTFA hasta el primer token | Concurrencia única: mediana de 1.87 s (mediana de 1.72 s para solicitudes válidas). Concurrencia de 10: mediana de 1.72 s |
| TPOT | Concurrencia única: 2.84 ms/token. Concurrencia de 10: 2.67 ms/token |
| Rendimiento válido (goodput) | Concurrencia de 10: 1,546.0 token/s |
| Solicitudes válidas | Concurrencia única: 75/90 (ventana 1: 15/30); concurrencia de 10: 90/90. No válidas: 12 × 503 service_unavailable_error, 2 × se alcanzó el tiempo límite, 1 × tiempo de espera de lectura |
| Puntuaciones de los componentes | TTFA 51.65, TPOT 100.00, rendimiento 100.00; TTFA y TPOT toman el valor inferior de los dos niveles, ponderados en 35% / 35% / 30%; puntuación de respuesta 83.08 |
| Composición de P | Puntuación de respuesta 83.08 con un peso del 80%, caché K 98.38 con un peso del 20%; P 86.14 |
Las 15 solicitudes no válidas se concentraron en la primera ventana de concurrencia única: 12 devolvieron 503, 2 alcanzaron el tiempo límite y 1 sufrió un tiempo de espera de lectura. Las solicitudes no válidas se contabilizan como infinitas, por lo que la mediana informada es de 1.87 s. Si solo se consideran las solicitudes válidas, la mediana es de 1.72 s. Con concurrencia de 10, la mediana también es de 1.72 s. El TPOT es de 2.84 ms/token con concurrencia única y de 2.67 ms/token con concurrencia de 10.
Comparación con los otros cuatro
Los cinco proveedores compartieron un Mac mini, una red y una cuenta. Las tres ventanas se programaron proveedor por proveedor, así que los periodos de recopilación no coinciden por completo; no conviene sobreinterpretar las pequeñas diferencias.
K — caché: 98.38
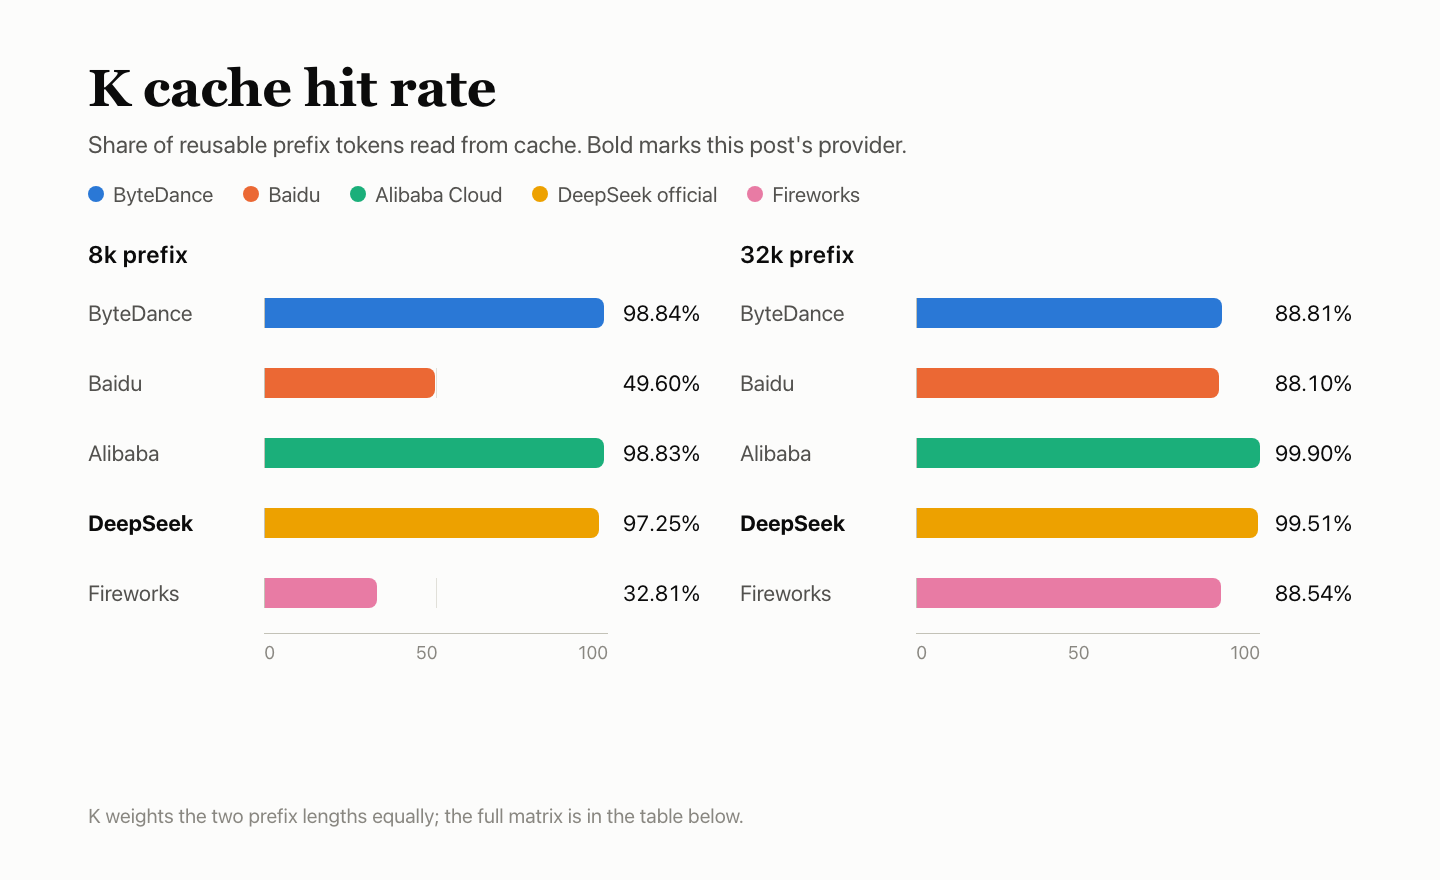
Cada grupo envía cinco solicitudes. La primera establece un prefijo fijo de 8k o 32k. Las solicitudes dos a cuatro conservan el prefijo y solo cambian la pregunta final, a los 5, 30 y 120 segundos. La quinta usa un prefijo nuevo como control sin caché. Tres ventanas × dos longitudes dan 30 solicitudes. K divide los tokens leídos de la caché en las solicitudes con prefijo en caché por los tokens que deberían poder reutilizarse; cada longitud representa la mitad. K supone el 20% de P. La documentación de la API de DeepSeek explica el almacenamiento en caché del contexto.
| Prefijo | Ventana | Inicialización | +5 s | +30 s | +120 s | Control sin caché |
|---|---|---|---|---|---|---|
| 8k | Ventana 1 | 0 | 7,808 | 7,808 | 7,808 | 0 |
| 8k | Ventana 2 | 0 | 7,808 | 7,808 | 7,808 | 0 |
| 8k | Ventana 3 | 0 | 7,808 | 7,808 | 7,808 | 0 |
| 32k | Ventana 1 | 0 | 31,872 | 31,872 | 31,872 | 0 |
| 32k | Ventana 2 | 0 | 31,872 | 31,872 | 31,872 | 0 |
| 32k | Ventana 3 | 0 | 31,872 | 31,872 | 31,872 | 0 |
Las 9 de 9 solicitudes con prefijo en caché de 8k acertaron y leyeron 7,808 tokens cada una: 70,272 leídos frente a 72,261 reutilizables, 97.25. Las 9 de 9 solicitudes con prefijo en caché de 32k acertaron y leyeron 31,872 tokens cada una: 286,848 frente a 288,270, 99.51. Los controles sin caché no leyeron ninguna caché. K es 98.38 en las dos longitudes.
Comparación con los otros cuatro
R — estabilidad del servicio: 100
Las 300 solicitudes abarcan texto corto, entrada larga de 10k, llamadas a herramientas e historial de varios turnos, y se enviaron con concurrencia única en tres ventanas. Solo se comprueban la validez y la integridad al primer intento —no la corrección de las respuestas— y no hay reintentos. Los fallos de calidad de respuesta y velocidad se contabilizan en Q y P, no de nuevo en R.
| Tipo de solicitud | Éxito al primer intento |
|---|---|
| Texto corto | 120/120 |
| Entrada larga de 10k | 90/90 |
| Llamadas a herramientas | 60/60 |
| Historial de varios turnos | 30/30 |
| Total · IC del 95%: 98.78%–100% | 300/300 |
Las 300 solicitudes devolvieron una respuesta válida y completa en el primer intento. R 100 solo abarca estas 300 solicitudes específicas; no significa que toda la ruta estuviera libre de fallos. Con 300 éxitos, el límite inferior del intervalo del 95% es del 98.78%, por lo que los datos indican que la tasa de fallos probablemente sea inferior al 1.22%.
En comparación con los otros cuatro
R solo abarca las 300 solicitudes específicas; los fallos en la calidad de las respuestas y la velocidad se registran en Q y P, y no vuelven a contarse en R.
| Proveedor | Éxito en el primer intento | IC del 95% |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek oficial | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Preguntas frecuentes
¿Es una conexión directa a la API de DeepSeek?
No. Las solicitudes pasan por la ruta del proveedor oficial de DeepSeek de AIHubMix; no se envían directamente a la API de DeepSeek.
¿Por qué el canal oficial de DeepSeek es la referencia de Q?
Es el canal oficial de DeepSeek para el mismo modelo, por lo que los resultados de calidad de respuesta de los otros cuatro proveedores se expresan como diferencias respecto a él. Su función como referencia no implica una clasificación de la calidad de las respuestas.
¿Qué ocurrió en la primera ventana de velocidad con concurrencia única?
Quince de las 30 solicitudes fueron inválidas: 12 devolvieron 503, 2 llegaron al límite de tiempo y 1 agotó el tiempo de espera de lectura. Se contabilizan como infinitas, por lo que la mediana es de 1.87 s; si solo se cuentan las solicitudes válidas, es de 1.72 s.
¿Qué son las 27 comprobaciones de funciones no válidas?
Dependen de recuentos exactos de tokens: entradas largas, límites de contexto, recuentos de entrada nativos y coherencia de la entrada en caché. La plantilla de recuento nativo fijada en las pruebas no coincidía con el uso que informó este canal, así que las comprobaciones se excluyeron del denominador en lugar de contabilizarse como fallos.
¿Por qué R 100 no garantiza que la ruta esté libre de fallos?
R solo abarca las 300 solicitudes específicas de estabilidad. Los fallos durante las pruebas de calidad de respuesta y velocidad se registran en Q y P. Con 300 éxitos de 300 intentos, el límite inferior del intervalo del 95% es del 98.78%, por lo que la tasa de fallos probablemente sea inferior al 1.22%, aunque no se ha demostrado que sea cero.
¿Cómo separa la prueba de caché las lecturas en caliente de las lecturas en frío?
Cada grupo precarga un prefijo de 8k o 32k, repite el prefijo a los 5, 30 y 120 segundos con una nueva pregunta final y, después, envía un prefijo nuevo como control en frío. En ambas longitudes se obtuvieron aciertos en caché en 9 de 9 solicitudes en caliente, y cada lectura de control en frío tuvo cero tokens en caché.
Sigue leyendo: la serie DeepSeek V4.1 Flash
- La Q de ByteDance está a 0.40 puntos de esta referencia, mientras que sus resultados de compatibilidad con funciones y caché son distintos: DeepSeek V4.1 Flash en ByteDance: las llamadas a herramientas coinciden, la medición no.
- Baidu perdió solicitudes por
no_available_channel, un problema que aparece tanto en Q como en P: DeepSeek V4.1 Flash en Baidu: no hay canales disponibles y afecta a Q y P. - Alibaba Cloud difiere en 0.37 puntos en total y no presenta una diferencia estadísticamente distinguible: DeepSeek V4.1 Flash en Alibaba Cloud: primer token en 1.34s, caché al 99.37.
- Fireworks obtuvo aciertos en 3 de 9 solicitudes en caliente de 8k, frente a 9 de 9 en este caso: DeepSeek V4.1 Flash en Fireworks: respuestas stop vacías, 3/9 aciertos de caché.


