

El 2026-11-03/04, DeepSeek V4.1 Flash 1017 se probó con la suite APB Full en cinco proveedores, todos a través de AIHubMix y con las mismas preguntas, parámetros y scripts de solicitud. Este perfil APB cubre solo Fireworks. El modelo aparece como DeepSeek V4.1 Flash 1017.
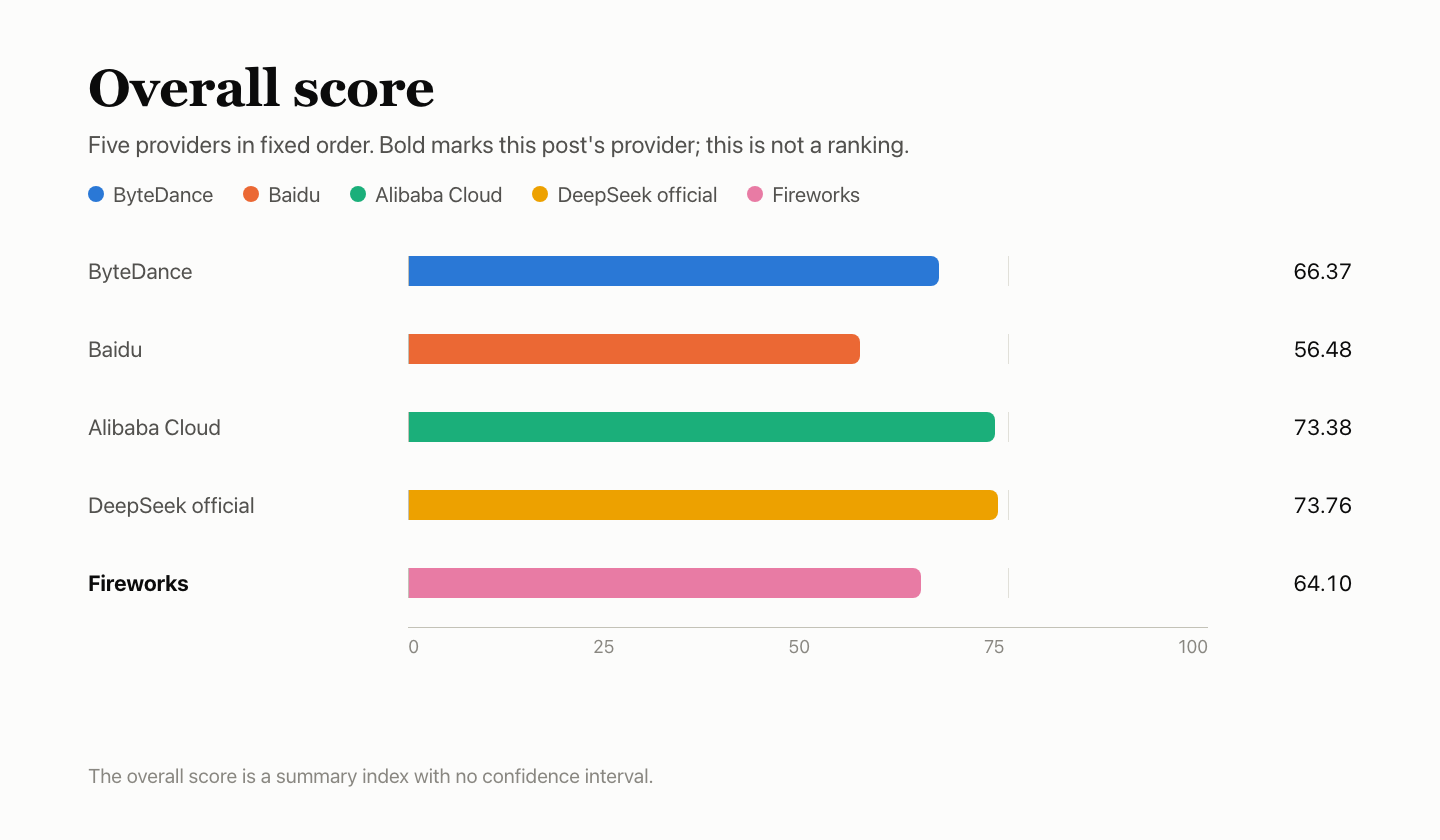
Las puntuaciones son Q 41.42, F 71.78, P 79.51, K 60.68 y R 100; el índice global es 64.10. Esta publicación informa solo de puntuaciones, sin clasificación ni recomendaciones sobre proveedores. Q, F, P, K y R se presentan primero; el índice global es un valor resumido sin intervalo de confianza. El estándar es AIHubMix Provider Benchmark Standard v2.0.
Puntuaciones de cinco proveedores
La negrita identifica al proveedor de esta publicación. El orden de los proveedores es fijo, no es una clasificación. K es una subpuntuación de P con un peso del 20%. El índice global es un valor resumido sin intervalo de confianza. La diferencia entre DeepSeek official channel y Alibaba Cloud es de 0.37 y no es estadísticamente distinguible.
Resumen
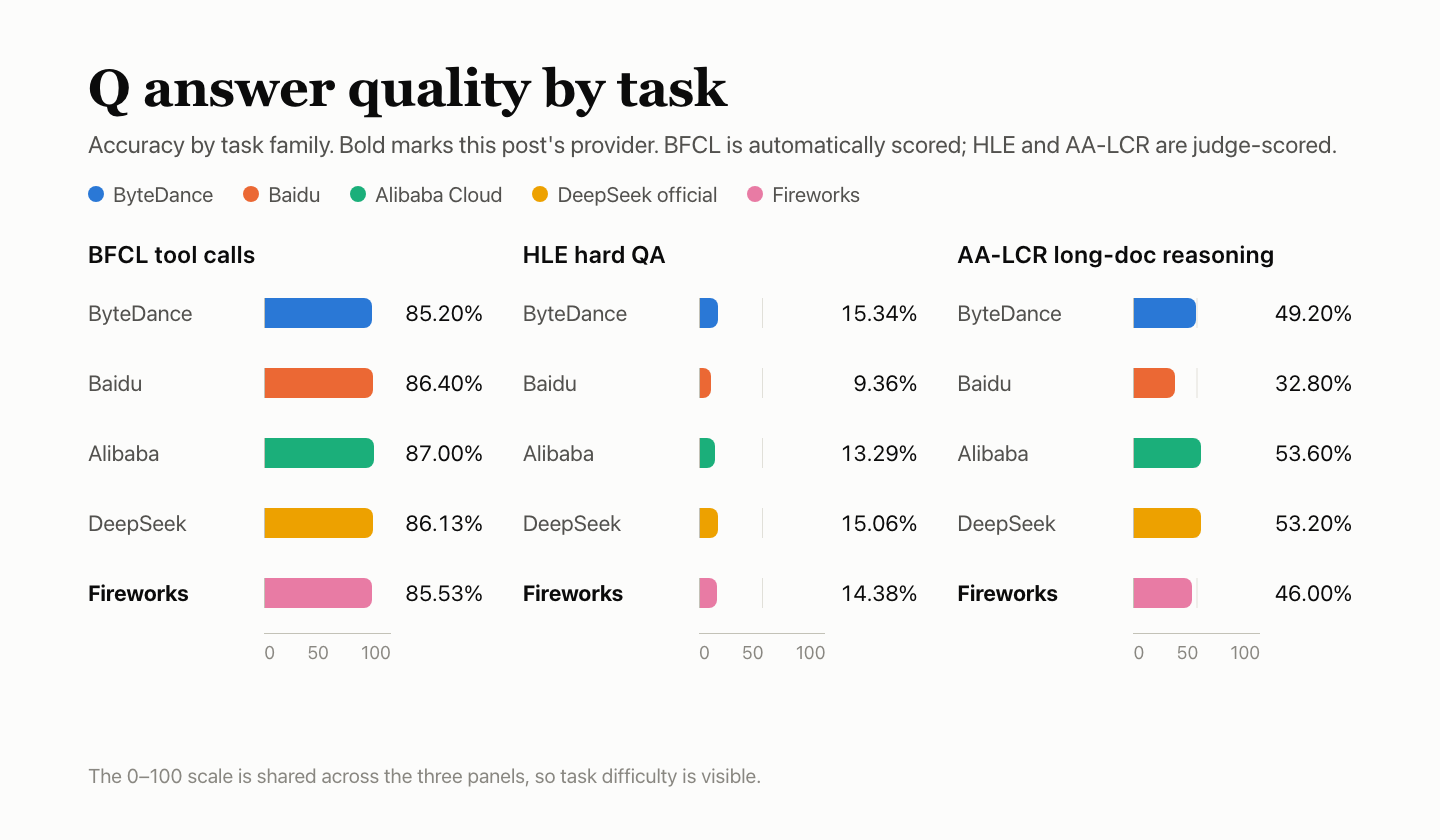
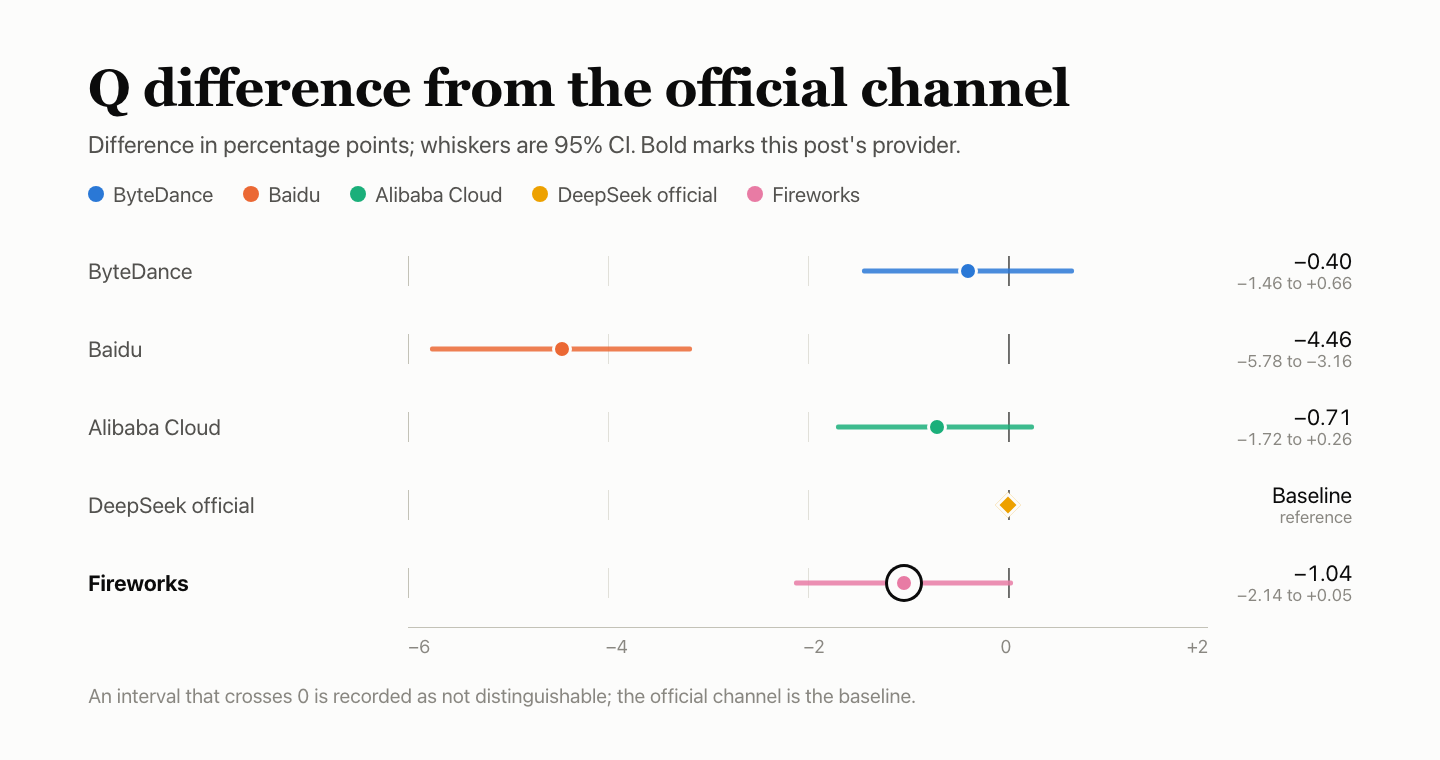
- Q — calidad de las respuestas: 41.42. BFCL 85.53%, HLE 14.38%, AA-LCR 46.00%. Frente al canal oficial: −1.04 puntos porcentuales, IC del 95% de −2.14 a +0.05, diferencia no distinguible. Los 34 errores de AA-LCR se produjeron en la ventana 2 y se contabilizaron como incorrectos.
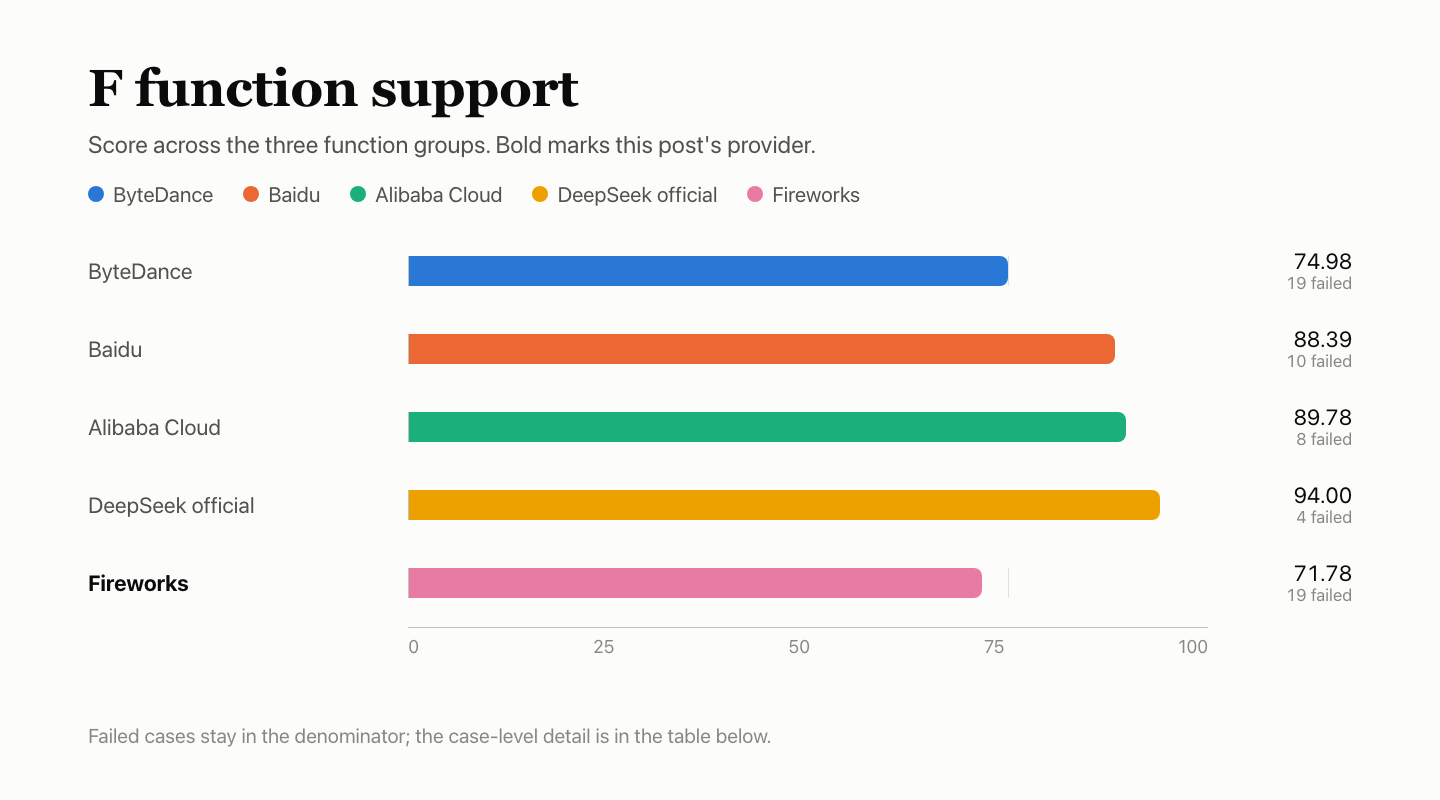
- F — compatibilidad funcional: 71.78. Se aprobaron 122/177 comprobaciones contabilizadas. Los dos casos con stop devolvieron un cuerpo vacío;
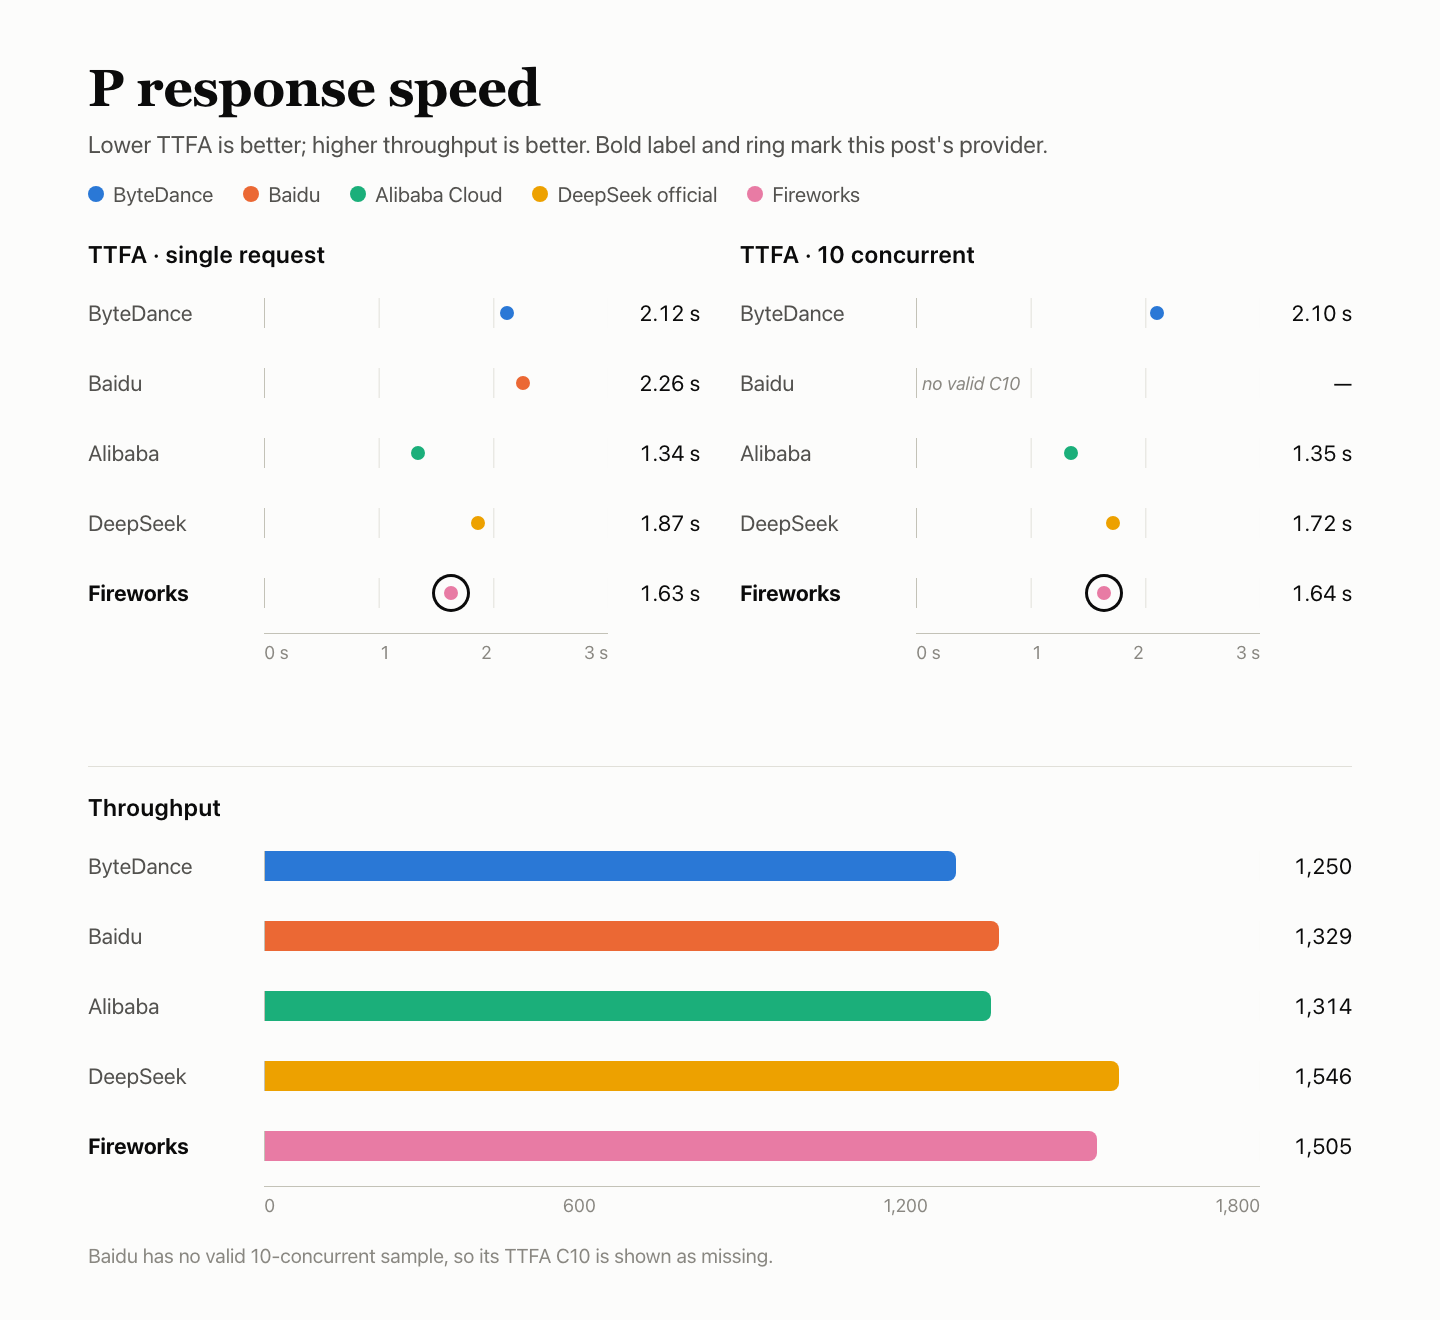
reasoning_effort=noneno desactivó el pensamiento; una entrada de 10k se informó como 10,026 tokens frente a un recuento nativo de 10,000. - P — velocidad de respuesta: 79.51. Puntuación de respuesta: 84.22; K de caché con un peso del 20%. Mediana de TTFA: 1.63 s con concurrencia individual y 1.64 s con 10 solicitudes concurrentes; TPOT: 3.29 ms. 1 de 180 resultados fue un solo token y se marcó como no válido.
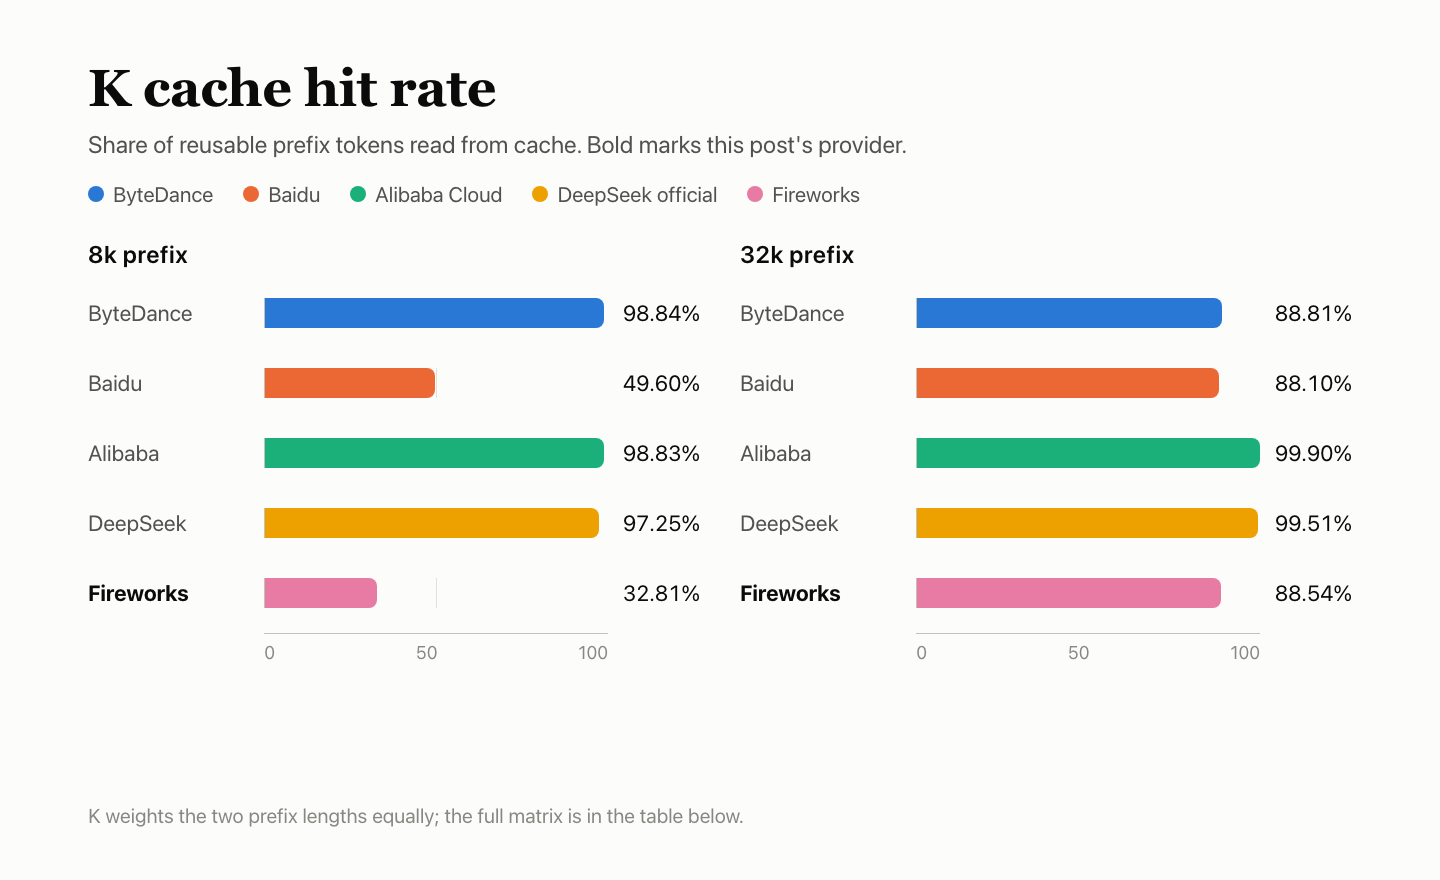
- K — caché: 60.68. Las pruebas de K utilizaron la afinidad de sesión documentada. Caché caliente de 32k: 8/9; caché caliente de 8k: 3/9.
- R — estabilidad del servicio: 100. Las 300/300 solicitudes dedicadas se completaron correctamente al primer intento.
Configuración de la prueba
| Elemento | Configuración |
|---|---|
| Modelo | DeepSeek V4.1 Flash 1017 |
| ID del modelo solicitado | fireworks-deepseek-v4.1-flash-1017 |
| Nombre del modelo devuelto | accounts/fireworks/models/deepseek-v4p1-flash-1017 |
| Ruta de acceso | ID del modelo del proveedor en AIHubMix, no la cuenta propia del proveedor |
| Parámetros | Sin pensamiento, temperatura 1.0, max_tokens 16,384, tiempo de espera 300 s, sin reintentos |
| Pensamiento desactivado | Parámetro nativo thinking.type=disabled; reasoning_effort=none no desactiva el pensamiento. Los casos funcionales mantuvieron reasoning_effort=none. |
| Fecha y hora | 2026-11-03 18:07 – 11-04 16:33 UTC+8. Un Mac mini, una red y una cuenta para los cinco proveedores. |
| Muestras | Q 4,250 (BFCL 500×3, HLE 250×10, AA-LCR 25×10); F 60×3; P 90+90; R 300; K 30 |
| Configuración adicional | Las pruebas de K incluyeron el campo de usuario documentado y el encabezado x-session-affinity para mantener la afinidad con la réplica. |
Las solicitudes utilizaron la guía de inicio rápido de AIHubMix; los ID de modelo están en la página de modelos. Para desactivar el pensamiento, se utilizó el parámetro nativo thinking.type=disabled de la documentación de la API del modelo.
Q — calidad de las respuestas: 41.42
La suite ejecutó 500 preguntas de BFCL × 3 rondas, 250 de HLE × 10 y 25 de AA-LCR × 10. BFCL se puntuó automáticamente; las respuestas de HLE y AA-LCR fueron evaluadas por deepseek-flash. Los cinco recibieron las mismas preguntas. Se eliminaron diez respuestas imposibles de puntuar, por lo que quedaron 4,240 instancias puntuadas.
| Tarea | Preguntas | Correctas | Precisión | Errores |
|---|---|---|---|---|
| Llamadas a herramientas de BFCL | 500 × 3 | 1,283/1,500 | 85.53% | 2 |
| Preguntas y respuestas difíciles de HLE | 250 × 10 | 358/2,490 | 14.38% | 5 |
| Razonamiento sobre documentos largos de AA-LCR | 25 × 10 | 115/250 | 46.00% | 34 |
| Total · IC del 95%: 39.13%–43.59% | — | 1,756/4,240 | 41.42% | 41 |
Los errores permanecen en el denominador y se cuentan como incorrectos: 2 en BFCL (ventanas 2 y 3), 5 en HLE truncadas al alcanzar max_tokens y 34 en AA-LCR, todas en la ventana 2.
| Categoría de BFCL | Aprobadas | Tasa de aprobación |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 268/300 | 89.33% |
| parallel | 270/300 | 90.00% |
| parallel_multiple | 206/240 | 85.83% |
| irrelevance | 111/150 | 74.00% |
| ahm_multi_turn | 95/150 | 63.33% |
simple_python aprobó 333/360 (92.50%), parallel 270/300 (90.00%), ahm_multi_turn 95/150 (63.33%) e irrelevance 111/150 (74.00%).
Comparación con los otros cuatro
Diferencia en puntos porcentuales frente al canal oficial; el intervalo del 95% se muestra como barras de error. Si cruza el 0, la diferencia no es distinguible. El evaluador deepseek-flash pertenece a la misma familia y no está calibrado, por lo que podría ser indulgente.
F — compatibilidad funcional: 71.78
Los 60 casos se dividen en seis grupos y cada uno se ejecuta en tres ventanas: 180 comprobaciones evaluadas según el formato documentado por el proveedor. Las comprobaciones no aplicables, no válidas y no observadas se excluyen del denominador. Se aprobaron 122 de las 177 comprobaciones contabilizadas; la ponderación por grupo da una puntuación de 71.78.
| Grupo de casos | Peso | Aprobadas | Excluidas | Puntuación del grupo |
|---|---|---|---|---|
| Streaming y mensajería | 20% | 24/30 | — | 80.00 |
| Interfaz de herramientas | 20% | 29/30 | — | 96.67 |
| Restricciones de salida | 20% | 21/30 | — | 70.00 |
| Contexto y estado | 15% | 15/30 | — | 50.00 |
| Errores y recuperación | 15% | 21/30 | — | 70.00 |
| Medición de uso y caché | 10% | 12/27 | 3 | 44.44 |
| Total · ponderado | — | 122/177 | 3 | 71.78 |
«Ventanas fallidas» cuenta las tres ventanas en las que el caso no se aprobó.
| Caso fallido | Ventanas fallidas | Motivo |
|---|---|---|
| Stop en streaming | 3/3 | Cuerpo vacío con stop; funciona sin stop. |
| Razonamiento en el cuerpo | 3/3 | reasoning_effort=none siguió devolviendo razonamiento. |
| Secuencia de stop | 3/3 | Cuerpo vacío con stop; funciona sin stop. |
| Configuración de pensamiento | 3/3 | reasoning_effort=none siguió devolviendo razonamiento. |
| Diversidad de muestreo | 3/3 | Temp 0/1 demasiado similares |
| Entrada larga de 10k | 3/3 | Se informaron 10,026; el recuento nativo es 10,000. |
| Dentro del límite de contexto | 3/3 | Se informaron 10,026; el recuento nativo es 10,000. |
| Entrada larga de 32k | 3/3 | Se informaron 10,026; el recuento nativo es 10,000. |
| Entrada larga de 100k | 3/3 | Se informaron 10,026; el recuento nativo es 10,000. |
| Más allá del contexto | 3/3 | Debería producir un error de parámetro; devolvió 200. |
| Mensajes malformados | 3/3 | 400, cuerpo vacío |
| Resultado de herramienta sin llamada previa | 3/3 | Debería producir un error de parámetro; devolvió 200. |
| stream_options malformado | 3/3 | 400, cuerpo vacío |
| Medición de tokens de pensamiento | 3/3 | Se informaron tokens de pensamiento después de desactivarlo. |
| Recuento nativo de entrada | 3/3 | Se informaron 34; el recuento nativo es 8. |
| Definiciones de herramientas en la entrada | 3/3 | El control sin herramientas ya presentaba discrepancias. |
| Recuento de entrada en la caché | 3/3 | El recuento del prefijo repetido no coincidió con el nativo. |
| Concordancia de entrada en streaming | 3/3 | Se informaron 34; el recuento nativo es 8 |
| Una herramienta a la vez | 1/3 | Error 500 del proveedor ascendente. |
Los dos casos con stop devolvieron un cuerpo vacío, mientras que la misma entrada funcionó sin stop, en las tres ventanas. reasoning_effort=none siguió devolviendo razonamiento en ambos casos de pensamiento.
Las comprobaciones excluidas no cuentan ni como aprobadas ni como fallidas.
| Estado | Caso | Cantidad | Motivo |
|---|---|---|---|
| No aplicable | cache_control explícito | 3 | Registrado de antemano como no compatible con esta interfaz |
Los messages y stream_options malformados fallaron en los cinco proveedores: devolvieron 400 con el cuerpo vacío y sin un error estructurado. Es más probable que el resultado compartido se origine en la capa de pasarela de AIHubMix, que requiere una investigación aparte. La medición de tokens de pensamiento también falló en los cinco, pero ByteDance y Fireworks informaron de tokens de pensamiento tras desactivarlo, mientras que los otros tres no devolvieron ningún recuento de pensamiento.
Comparación con los otros cuatro
P — velocidad de respuesta: 79.51
Cada solicitud llevaba aproximadamente 10,000 tokens de entrada y pedía unos 1,100 tokens de salida. En cada una de las tres ventanas, se enviaron 30 solicitudes con concurrencia individual y 30 con 10 solicitudes concurrentes, para un total de 180.
| Métrica | Resultado |
|---|---|
| TTFA | 1.63 s con concurrencia individual; 1.64 s con 10 solicitudes concurrentes |
| TPOT | 3.24 ms con concurrencia individual; 3.29 ms con 10 |
| Rendimiento útil | 1,504.5 tokens/s con 10 solicitudes concurrentes |
| Válidas | 90/90 con concurrencia individual; 89/90 con 10 (29/30 en la ventana 3), un resultado de un solo token |
| Componentes | TTFA 54.91, TPOT 100.00, rendimiento útil 100.00; pesos 35/35/30 |
| Composición de P | 84.22 × 80% + 60.68 × 20% = 79.51 |
179 de 180 fueron válidas; la solicitud no válida devolvió un token y cuenta como infinito en las medianas, por lo que estas pueden ser superiores a las calculadas solo con solicitudes válidas. El TPOT se obtiene de los fragmentos de streaming; el rendimiento útil son los tokens de salida válidos con 10 solicitudes concurrentes divididos por el tiempo de pared del lote.
Una máquina, una red y una cuenta; los proveedores programaron las ventanas.
K — caché: 60.68
Cada grupo consta de cinco solicitudes: se prepara un prefijo de 8k o 32k y, luego, se envía el mismo prefijo con una nueva pregunta final a los 5 s, 30 s y 120 s; por último, se usa un prefijo nuevo como control de caché fría. Tres ventanas × dos longitudes = 30. K es la cantidad de tokens leídos de la caché caliente dividida por los tokens reutilizables, con el mismo peso para ambas longitudes; K representa el 20% de P.
| Prefijo | Ventana | Preparación | +5 s | +30 s | +120 s | Control de caché fría |
|---|---|---|---|---|---|---|
| 8k | Ventana 1 | 0 | 7,900 | 0 | 7,900 | 0 |
| 8k | Ventana 2 | 0 | 7,906 | 0 | 0 | 0 |
| 8k | Ventana 3 | 0 | 0 | 0 | 0 | 0 |
| 32k | Ventana 1 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | Ventana 2 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | Ventana 3 | 0 | 31,900 | 31,900 | 0 | 0 |
El prefijo de 8k acertó en 3 de 9 solicitudes recientes y leyó 23,706 de 72,252 tokens reutilizables, un 32.81. El prefijo de 32k acertó en 8 de 9 y leyó 255,212 de 288,261, un 88.54. K es 60.68 al ponderar por igual las dos longitudes. Los controles en frío leyeron 0. Por lo tanto, las dos longitudes de prefijo se comportaron de manera distinta con el mismo diseño. Las pruebas K llevaban el campo user y el encabezado x-session-affinity documentados.
R — estabilidad del servicio: 100
Se realizaron 300 solicitudes de texto breve, entradas largas, llamadas a herramientas e historial de varios turnos, con concurrencia única a lo largo de tres ventanas. Solo se comprobaron la validez y la integridad de la primera respuesta; no se evaluaron las respuestas ni se reintentó ninguna solicitud. Aquí no se vuelven a contabilizar los errores Q y P.
| Tipo de solicitud | Éxito al primer intento |
|---|---|
| Texto breve | 120/120 |
| Entrada larga de 10k | 90/90 |
| Llamada a herramienta | 60/60 |
| Historial de varios turnos | 30/30 |
| Total · IC del 95%: 98.78%–100% | 300/300 |
Las 300 solicitudes devolvieron una respuesta válida y completa al primer intento. Con 300 éxitos, el límite inferior del 95% es 98.78%, por lo que los datos solo respaldan que la tasa de errores es inferior al 1.22%. R 100 abarca estas 300 solicitudes, no la ruta completa.
| Proveedor | Éxito al primer intento | Intervalo del 95% |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek oficial | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Preguntas frecuentes
¿Qué abarca Q 41.42?
BFCL, HLE y AA-LCR en 4,240 instancias evaluadas: 1,756 correctas, 41.42%, IC del 95% de 39.13%–43.59%; la diferencia con el canal oficial no es estadísticamente distinguible.
¿Por qué fallaron ambos casos con stop?
Una solicitud con stop devolvió un cuerpo vacío en las tres ventanas, mientras que la misma entrada sin stop funcionó. Esto ocurre tanto en los casos de streaming como en los que no son de streaming.
¿reasoning_effort=none desactiva el pensamiento?
No. Devolvió contenido de razonamiento en las tres ventanas; las demás solicitudes usaron thinking.type=disabled de forma nativa.
¿Por qué se informa que una entrada de 10k tiene 10,026 tokens?
El caso de 10k informó 10,026 frente a un valor nativo de 10,000. Los casos de 32k y 100k informaron el mismo valor de 10,026, y un control sin herramientas ya presentaba una discrepancia.
¿Por qué 8k acertó en 3/9 y 32k en 8/9?
Ambos usaron el mismo diseño y la configuración de afinidad documentada. La diferencia está en las lecturas informadas por el servidor: 8k acertó en las ventanas 1 y 2; 32k, en las tres.
¿Qué abarca R 100?
300 solicitudes específicas, todas válidas al primer intento; el límite inferior del 95% es 98.78%. Los errores Q y P no se contabilizan en R.
Sigue leyendo: la serie DeepSeek V4.1 Flash
- ByteDance informó tokens de pensamiento después de desactivarlo, igual que Fireworks: DeepSeek V4.1 Flash en ByteDance: las llamadas a herramientas coinciden, la medición no
- Baidu registró Q 38.00 y P 37.77: DeepSeek V4.1 Flash en Baidu: ningún canal disponible alcanza Q y P
- Alibaba Cloud registró un primer token de 1.34 s y un caché de 99.37: DeepSeek V4.1 Flash en Alibaba Cloud: primer token en 1.34s, caché de 99.37
- El canal oficial es la referencia de Q, con F 94.00: DeepSeek V4.1 Flash en el canal oficial: F 94.00, 15 pruebas no válidas


