

El 2026-11-03/04, se probó DeepSeek V4.1 Flash 1017 en cinco proveedores a través de AIHubMix con la suite APB Full: las mismas preguntas, parámetros y scripts de solicitud en cada ocasión. Este perfil APB cubre únicamente la prueba en Baidu, sección por sección.
Las cifras siguientes son solo puntuaciones, no una clasificación ni una recomendación de proveedor. Q 38.00, F 88.39, P 37.77, K 68.85 y R 100 aparecen primero; el total, 56.48, es un índice resumido sin intervalo de confianza. Las reglas de puntuación son las del AIHubMix Provider Benchmark Standard v2.0.
Puntuaciones de cinco proveedores
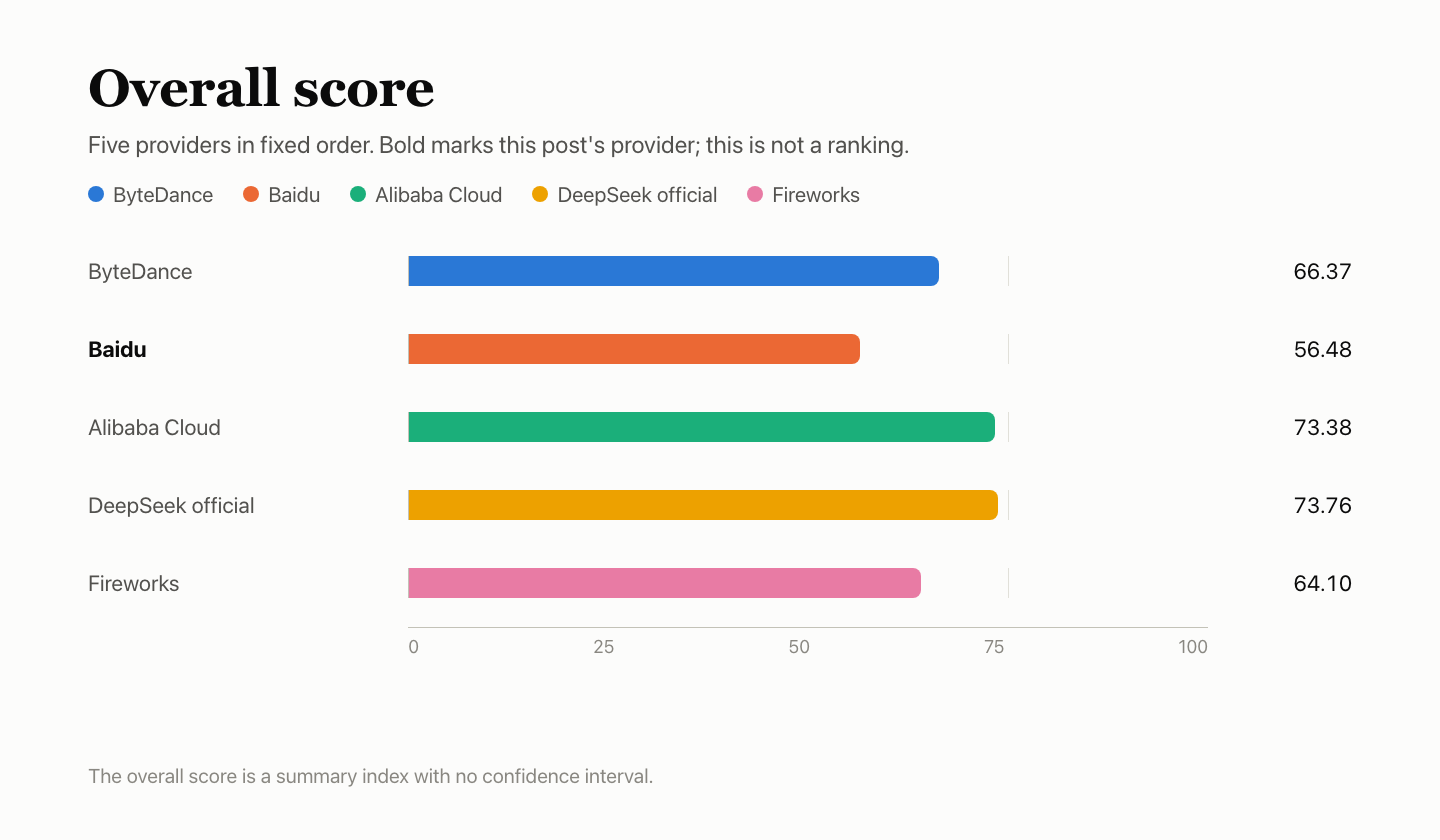
La negrita señala el proveedor de esta publicación. Los proveedores aparecen en un orden fijo, no en una clasificación. K es una subpuntuación de P con un peso del 20%. El total es un índice resumido sin intervalo de confianza. La diferencia entre el canal oficial y Alibaba Cloud es de 0.37, y no es estadísticamente distinguible.
De un vistazo
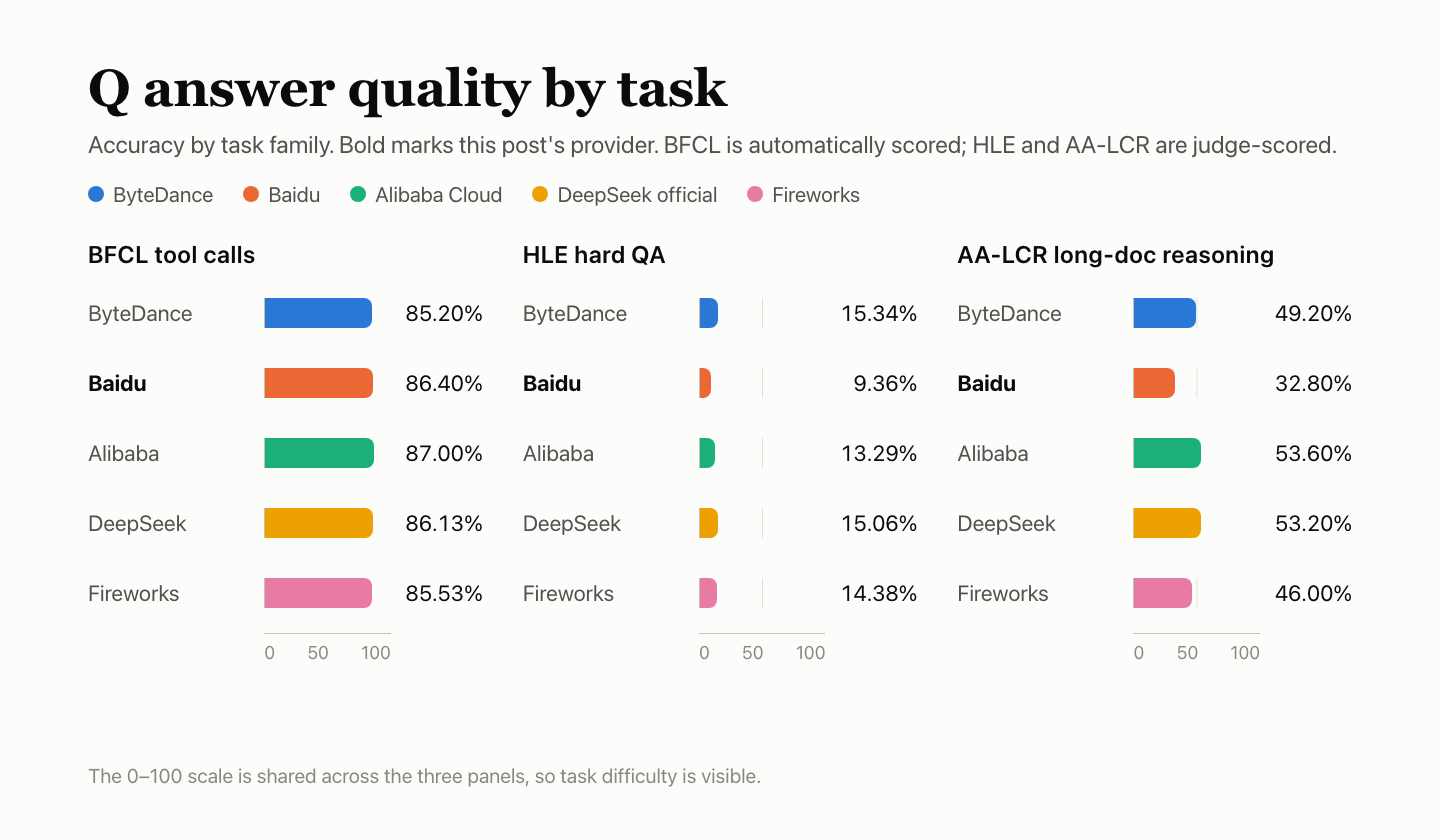
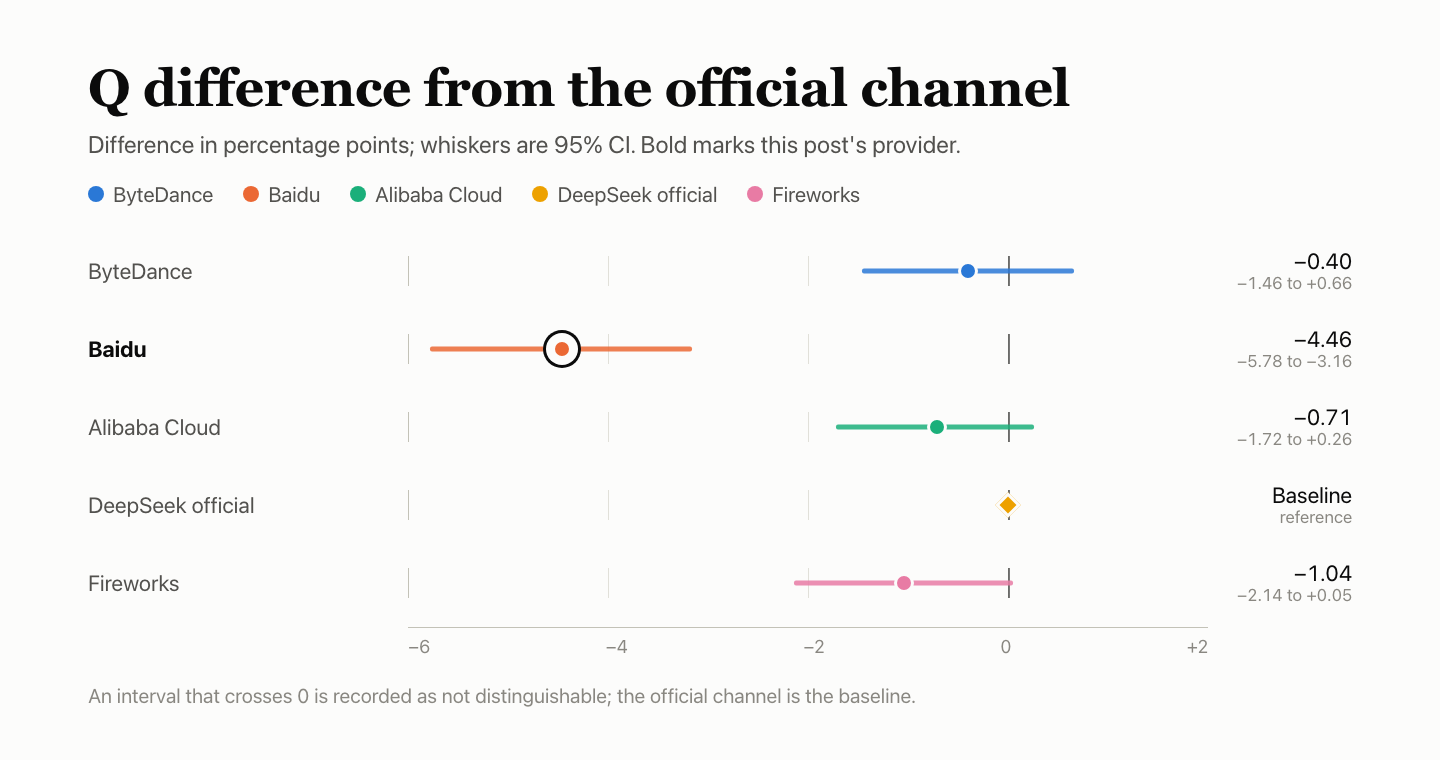
- Q: 38.00. BFCL 86.40%, HLE 9.36%, AA-LCR 32.80%. El resultado combinado queda 4.46 puntos por debajo del canal oficial, con un intervalo del 95% de −5.78 a −3.16 que excluye el 0. HLE registró 864 solicitudes fallidas y AA-LCR 100, casi todas en la primera ventana; se contabilizaron como respuestas incorrectas.
- F: 88.39. Se superaron 148 de las 174 comprobaciones contabilizadas. No se devolvieron el campo de lectura de caché ni el recuento de tokens de pensamiento; los casos de contexto excedido y resultado de herramienta huérfano devolvieron 200.
- P: 37.77. 50 de las 90 pruebas con 10 solicitudes concurrentes devolvieron
no_available_channel, por lo que más de la mitad no fueron válidas y TTFA y TPOT se puntuaron con sus valores de penalización. Las pruebas con concurrencia única fueron válidas 78 de las 90 veces. - K: 68.85. Las solicitudes activas de 8k acertaron 5 de 9 veces, con 3 solicitudes fallidas; el prefijo de 32k acertó 8 de 9 veces. Los aciertos se indican en bloques de 1,024 tokens: 7,168 tokens para 8k y 31,744 para 32k.
- R: 100. Las 300 solicitudes dedicadas se completaron correctamente en el primer intento. Los fallos de canal durante las pruebas de respuesta y velocidad se contabilizan en Q y P.
Configuración de la prueba
Las solicitudes usaron la ruta de inicio rápido de AIHubMix con un ID específico del proveedor, y los parámetros siguen la documentación de la API de DeepSeek; los ID de otros proveedores aparecen en la página de modelos. No se trata de una conexión directa a una cuenta propia de Baidu.
| Campo | Valor |
|---|---|
| Modelo | DeepSeek V4.1 Flash 1017 |
| ID del modelo solicitado | baidu-deepseek-v4.1-flash-1017 |
| Nombre del modelo devuelto | deepseek-v4.1-flash-1017 |
| Ruta de acceso | A través de AIHubMix con el ID del modelo específico del proveedor; no es una conexión directa a una cuenta propia del proveedor |
| Parámetros | Modo sin pensamiento, temperature 1.0, max_tokens 16,384, tiempo de espera 300 s, sin reintentos automáticos |
| Pensamiento desactivado | Todas las solicitudes usaron reasoning_effort=none |
| Hora | 2026-11-03 18:07 – 11-04 16:33 UTC+8; los cinco proveedores compartieron un Mac mini, la red y la cuenta |
| Muestras | 4,250 intentos de respuesta (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10); 60 casos de función × 3 ventanas; 90 pruebas de velocidad con concurrencia única y 90 con 10 solicitudes concurrentes; 300 solicitudes de estabilidad; 30 pruebas de caché (tres grupos para cada prefijo de 8k y 32k) |
Q — calidad de respuesta: 38.00
La calidad de respuesta se evalúa con tres tipos de tareas: 500 tareas BFCL respondidas tres veces cada una, 250 tareas HLE respondidas diez veces cada una y 25 tareas AA-LCR respondidas diez veces cada una. BFCL se puntúa mediante reglas automáticas; el modelo juez deepseek-flash determina si las respuestas de HLE y AA-LCR son correctas o incorrectas. Los cinco proveedores recibieron el mismo conjunto de tareas, y los tres tipos se combinan en una sola cifra de precisión. Se eliminaron diez respuestas porque no fue posible evaluarlas, lo que dejó 4,240 intentos puntuados.
| Tarea | Elementos | Correctos | Precisión | Fallos |
|---|---|---|---|---|
| Llamadas a herramientas de BFCL | 500 × 3 | 1,296/1,500 | 86.40% | 0 |
| Preguntas difíciles de HLE, puntuadas por el juez | 250 × 10 | 233/2,490 | 9.36% | 875 |
| Razonamiento sobre documentos extensos de AA-LCR | 25 × 10 | 82/250 | 32.80% | 100 |
| Combinado · intervalo del 95%: 36.23%–39.58% | — | 1,611/4,240 | 38.00% | 975 |
Los fallos del servicio, ya sean solicitudes fallidas o salidas truncadas, se mantienen en el denominador y cuentan como respuestas incorrectas. HLE tuvo 864 solicitudes fallidas (863 en la primera ventana y 1 en la segunda) y 11 salidas truncadas al alcanzar el límite de max_tokens. AA-LCR tuvo 100 solicitudes fallidas, todas en la primera ventana.
Cada tarea BFCL se responde tres veces; la tabla muestra el resultado combinado de las tres rondas.
| Categoría de BFCL | Superadas | Tasa de aprobados |
|---|---|---|
| simple_python: una función, llamada y argumentos correctos | 336/360 | 93.33% |
| multiple: elegir la función correcta entre varias | 269/300 | 89.67% |
| parallel: llamar a una función varias veces en paralelo | 268/300 | 89.33% |
| parallel_multiple: llamar a varias funciones distintas en paralelo | 206/240 | 85.83% |
| irrelevance: no corresponde ninguna función, no llamar a ninguna | 113/150 | 75.33% |
| ahm_multi_turn: cadena de herramientas de tres etapas | 104/150 | 69.33% |
En comparación con los otros cuatro
La diferencia se expresa en puntos porcentuales respecto al canal oficial, y el intervalo del 95% se muestra como barras de error. Si un intervalo cruza el 0, la diferencia se considera indistinguible. El juez de HLE y AA-LCR, deepseek-flash, pertenece a la misma familia DeepSeek que el modelo probado y no fue calibrado, por lo que sus evaluaciones podrían ser indulgentes.
F — compatibilidad con funciones: 88.39
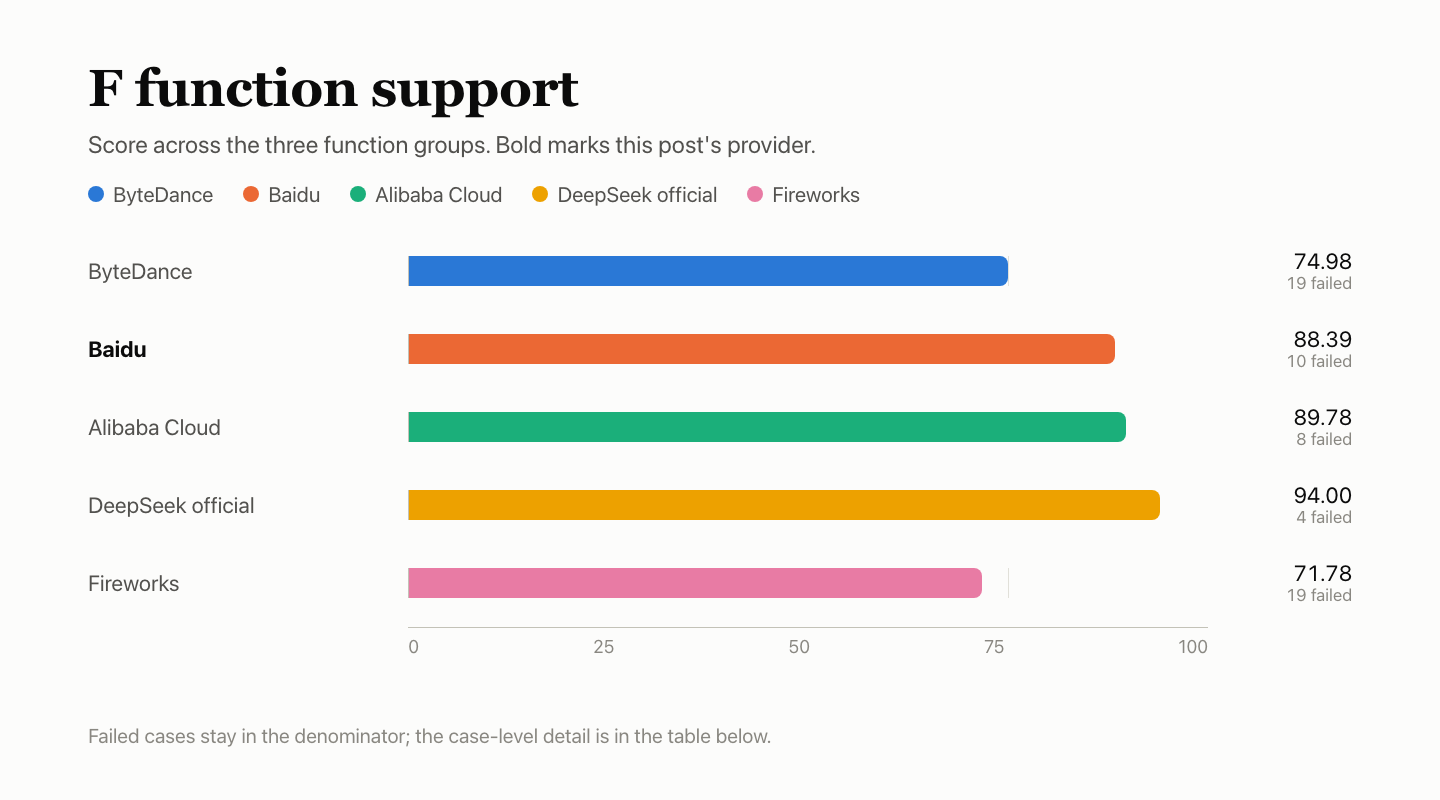
Los casos de función evalúan si la interfaz se comporta según lo especificado en el protocolo, no si el modelo responde bien. Se ejecutaron una vez en cada una de tres ventanas 60 casos de seis grupos, para un total de 180 comprobaciones, evaluadas según el formato documentado por el proveedor. Las comprobaciones no aplicables, no válidas o no observadas se excluyen del denominador. Baidu contabilizó 174 comprobaciones y superó 148, para una puntuación ponderada de 88.39.
La puntuación de cada grupo se pondera según su proporción, no se calcula simplemente como 148/174.
| Grupo de casos | Peso | Superadas | Excluidas | Puntuación del grupo |
|---|---|---|---|---|
| Streaming y protocolo de mensajes | 20% | 27/27 | 3 | 100.00 |
| Interfaz de herramientas | 20% | 30/30 | — | 100.00 |
| Restricciones de salida y parámetros | 20% | 29/30 | — | 96.67 |
| Contexto y estado | 15% | 26/30 | — | 86.67 |
| Error y recuperación | 15% | 21/30 | — | 70.00 |
| Medición de uso y protocolo de caché | 10% | 15/27 | 3 | 55.56 |
| Total, ponderado | 100% | 148/174 | 6 | 88.39 |
| Caso fallido | Ventanas con fallos | Motivo |
|---|---|---|
| Contexto excedido (contexto y estado) | 3/3 | Debería devolver un error de parámetro; devolvió 200 |
| Mensajes con formato incorrecto (error y recuperación) | 3/3 | Devolvió 400 con el cuerpo vacío, sin error estructurado |
| Resultado de herramienta huérfano (error y recuperación) | 3/3 | Debería devolver un error de parámetro; devolvió 200 |
| stream_options con formato incorrecto (error y recuperación) | 3/3 | Devolvió 400 con el cuerpo vacío, sin error estructurado |
| Campo de lectura de caché (medición de uso y protocolo de caché) | 3/3 | No se devolvió ningún campo de lectura de caché; no es posible confirmar la lectura |
| Medición de tokens de pensamiento (medición de uso y protocolo de caché) | 3/3 | No se devolvió el recuento de tokens de pensamiento |
| Definiciones de herramientas contabilizadas como entrada (medición de uso y protocolo de caché) | 3/3 | Con las definiciones de herramientas, los tokens de entrada declarados no fueron más que sin ellas |
| Recuento de entrada coherente antes y después de la caché (medición de uso y protocolo de caché) | 3/3 | No se devolvió ningún campo de lectura de caché; no es posible confirmar la lectura |
| Diversidad del muestreo (restricciones de salida y parámetros) | 1/3 | Las salidas repetidas con temperature 0 y 1 diferían demasiado poco, por debajo del estándar prerregistrado |
| Aislamiento entre solicitudes (contexto y estado) | 1/3 | El primer paso no respondió únicamente STORED, como se requería, por lo que no fue posible continuar con la comprobación de aislamiento |
Estas comprobaciones se excluyen del denominador: no se consideran ni superadas ni fallidas.
| Estado | Caso | Cantidad | Motivo |
|---|---|---|---|
| No observado | Secuencia de detención de streaming | 3 | La solicitud para este paso no se envió después del paso anterior, por lo que no se puede evaluar |
| No aplicable | cache_control explícito | 3 | Registrado de antemano como no compatible con esta interfaz |
Los messages con formato incorrecto y stream_options con formato incorrecto fallaron en los cinco proveedores: ambos devolvieron 400 con el cuerpo vacío, sin proporcionar un error estructurado al cliente. Es más probable que un fallo compartido por los cinco se origine en la capa de pasarela de AIHubMix y requiere una investigación aparte. La medición de tokens de pensamiento también falló en los cinco, aunque por motivos distintos: ByteDance y Fireworks informaron de tokens de pensamiento incluso con el pensamiento desactivado, mientras que los otros tres no devolvieron ningún recuento de tokens de pensamiento.
En comparación con los otros cuatro
P — velocidad de respuesta: 37.77
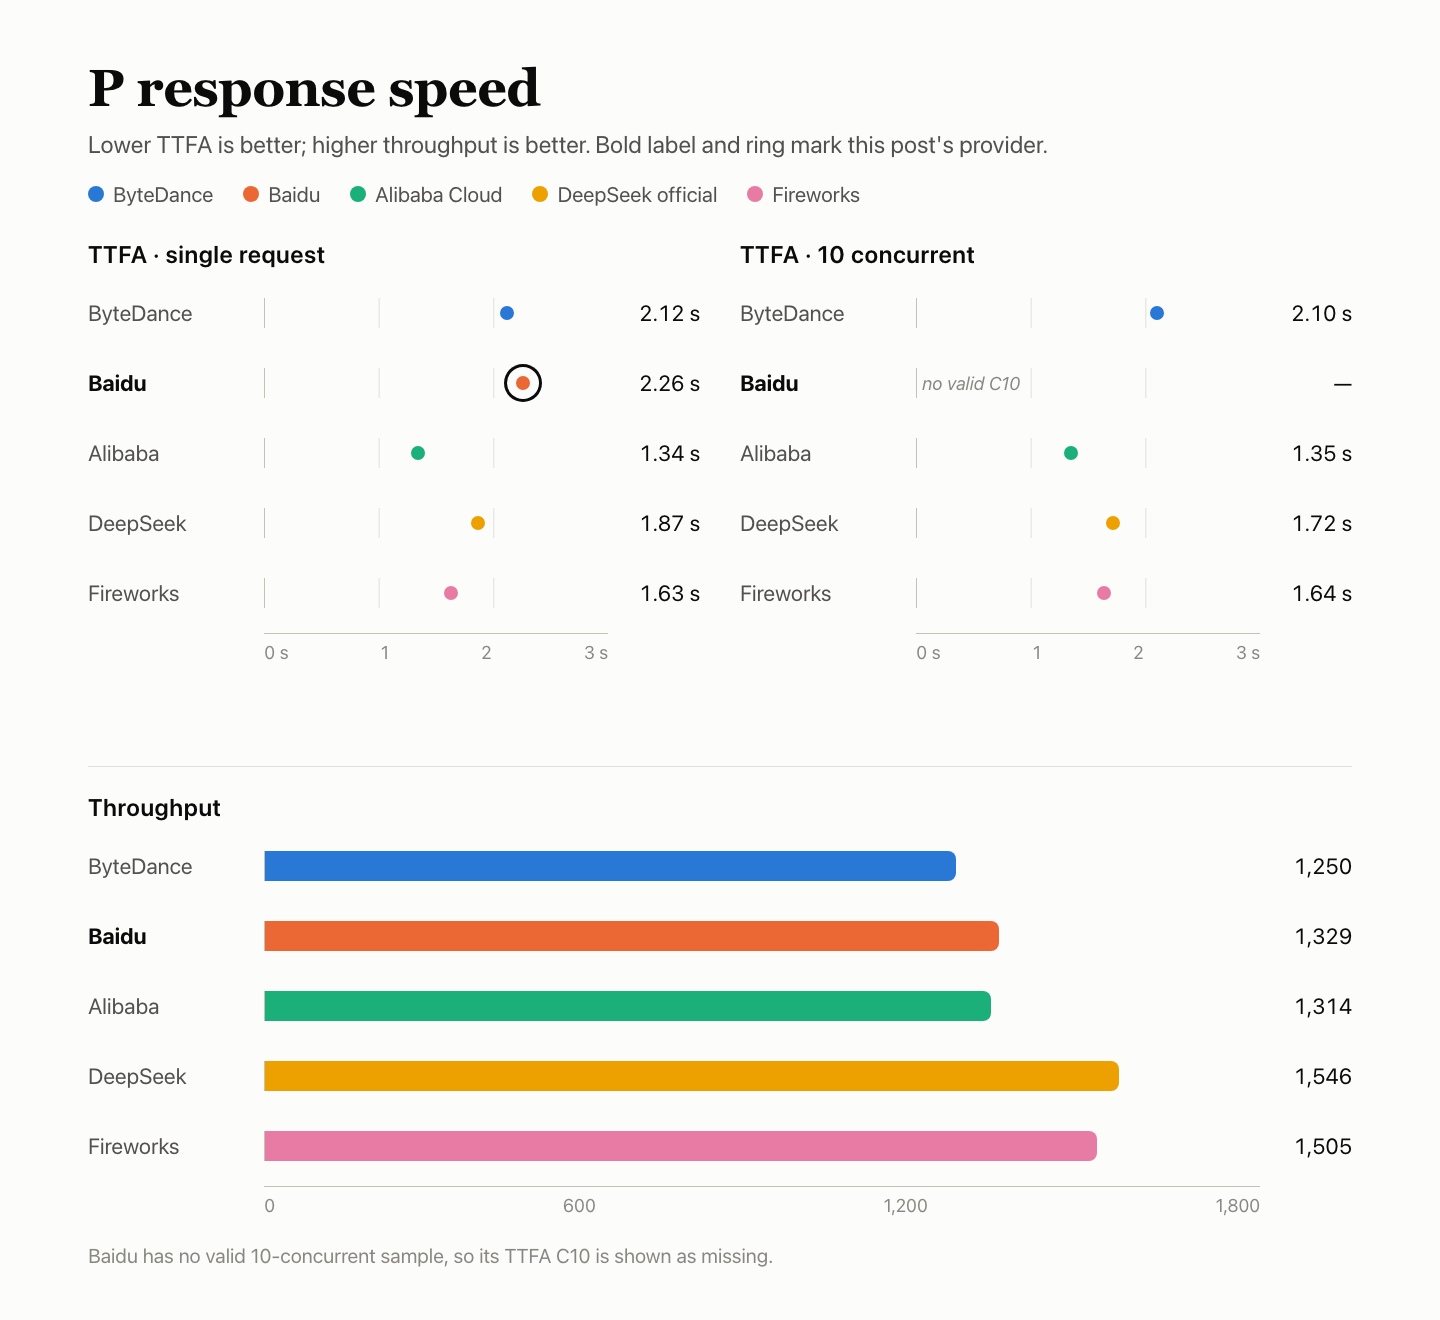
Cada solicitud incluía unos 10,000 tokens de entrada y pedía una respuesta de unos 1,100 tokens de salida. En cada una de las tres ventanas se enviaron 30 pruebas con concurrencia única y 30 con 10 solicitudes concurrentes, para un total de 180 solicitudes.
| Métrica | Resultado |
|---|---|
| TTFA del primer token | Mediana con concurrencia única: 2.26 s (mediana de las solicitudes válidas: 2.05 s); con 10 solicitudes concurrentes, más de la mitad no fueron válidas, por lo que la mediana contabilizada es infinito (mediana de las solicitudes válidas: 1.86 s) |
| Velocidad de generación TPOT | Concurrencia única: 3.48 ms/token; 10 solicitudes concurrentes: 50.00 ms/token (más de la mitad no fueron válidas; valor de penalización) |
| Goodput (rendimiento válido) | 1,329.2 token/s con 10 solicitudes concurrentes |
| Solicitudes válidas | Concurrencia única: 78/90 (primera ventana 18/30); 10 solicitudes concurrentes: 40/90 (primera ventana 0/30, tercera ventana 10/30) |
| Motivo de invalidez | 62 pruebas devolvieron 400 no_available_channel |
| Puntuación del componente | TTFA 0.00, TPOT 0.00, rendimiento 100.00; puntuación de respuesta 30.00 |
| Composición de P | Puntuación de respuesta 30.00 con un peso del 80%, caché K 68.85 con un peso del 20%, total 37.77 |
TPOT se estima a partir de fragmentos transmitidos, no se mide por token en el hardware. El goodput se calcula dividiendo los tokens de salida válidos con una carga de 10 solicitudes concurrentes por el tiempo de pared del lote.
En el nivel de 10 solicitudes concurrentes, 50 de las 90 pruebas devolvieron no_available_channel. Al no ser válidas más de la mitad, el tiempo mediano hasta el primer token se considera infinito y TTFA y TPOT reciben sus valores de penalización. El nivel de concurrencia única fue válido en 78 de las 90 pruebas.
Los cinco proveedores compartieron una máquina, una red y una cuenta. Las tres ventanas se programaron proveedor por proveedor, por lo que los periodos de recopilación no se solapan por completo; no conviene dar demasiada importancia a las pequeñas diferencias.
K — caché: 68.85
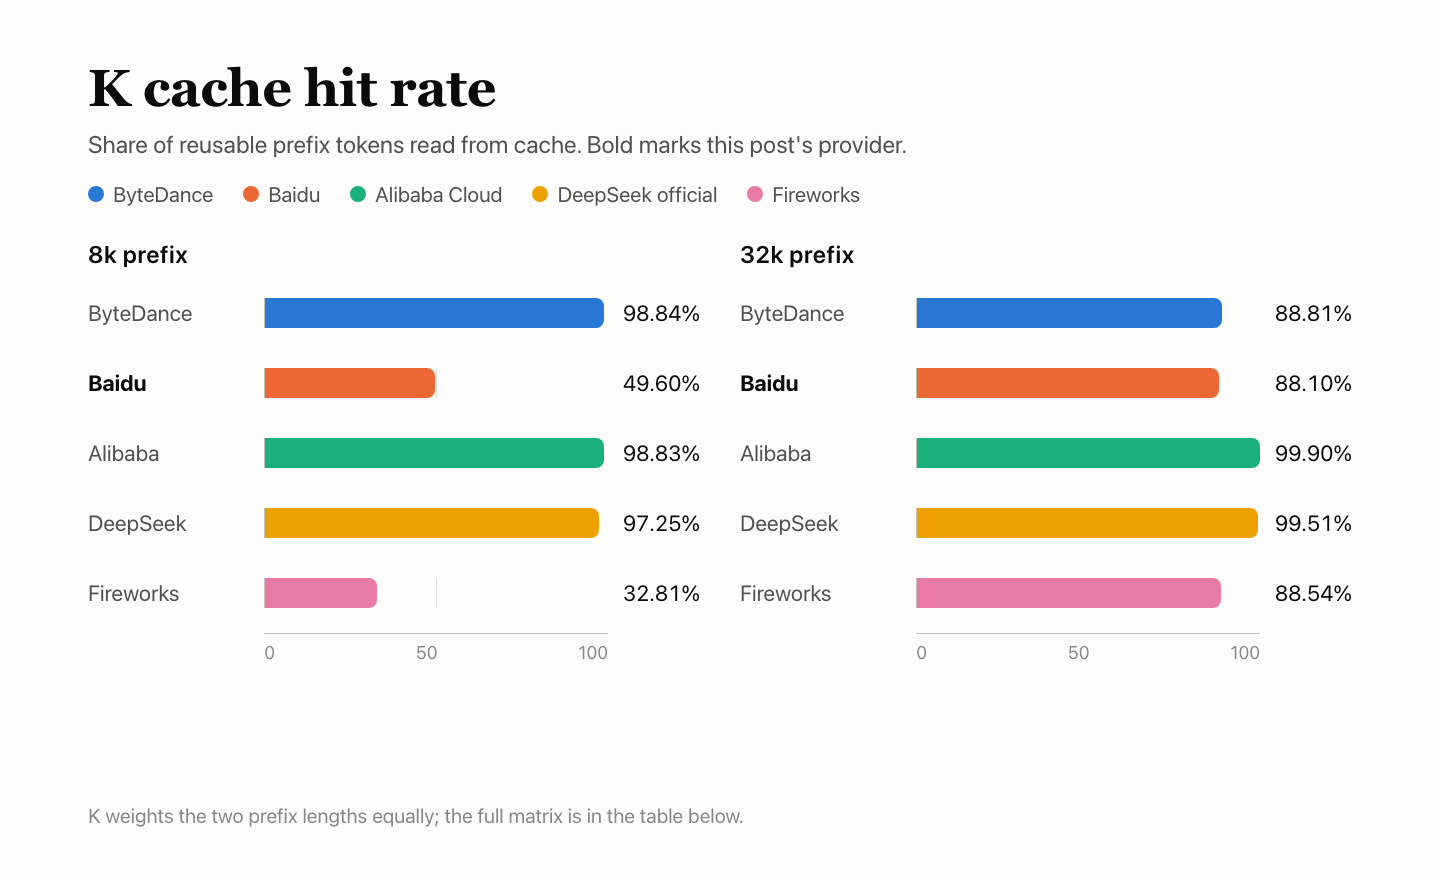
Cada grupo envía cinco solicitudes. La primera incluye un prefijo fijo de unos 8k o 32k tokens y llena la caché. Las solicitudes 2–4 mantienen el prefijo y solo cambian la pregunta final, con intervalos de 5 s, 30 s y 120 s. La quinta usa un prefijo nuevo como control en frío. Tres ventanas × dos longitudes suman 30 solicitudes. K es el número de tokens leídos de la caché por las solicitudes activas dividido por los tokens que deberían poder reutilizarse según las reglas, con el mismo peso para cada longitud. K representa el 20% de P.
La tabla muestra el recuento de tokens leídos de la caché que informó el servidor; «no devuelto» significa que el campo no estaba presente en la respuesta.
| Prefijo | Ventana | Carga inicial | +5 s | +30 s | +120 s | Control en frío |
|---|---|---|---|---|---|---|
| 8k | 1 | Fallido | Fallido | Fallido | No devuelto | No devuelto |
| 8k | 2 | No devuelto | 7,168 | 7,168 | Fallido | Fallido |
| 8k | 3 | No devuelto | 7,168 | 7,168 | 7,168 | No devuelto |
| 32k | 1 | No devuelto | No devuelto | 31,744 | 31,744 | No devuelto |
| 32k | 2 | No devuelto | 31,744 | 31,744 | 31,744 | No devuelto |
| 32k | 3 | No devuelto | 31,744 | 31,744 | 31,744 | No devuelto |
El prefijo de 8k acertó en 5 de las 9 solicitudes frecuentes y leyó 35,840 de los 72,252 tokens que deberían haberse podido reutilizar, para un 49.60. El prefijo de 32k acertó en 8 de las 9 y leyó 253,952 de 288,261, para un 88.10. K es 68.85 al ponderar por igual ambas longitudes. Cinco solicitudes de 8k fallaron en total: las solicitudes de semilla, de 5 s y de 30 s de la ventana 1, y las solicitudes de 120 s y de control en frío de la ventana 2; todas con no_available_channel. Así, quedan tres solicitudes frecuentes fallidas en el nivel de 8k.
En un acierto, la lectura registrada se cuenta en bloques de 1,024 tokens: 7,168 tokens para el prefijo de 8k y 31,744 para el prefijo de 32k. En un fallo, el bloque de uso omite prompt_tokens_details; la tabla indica «no devuelto» y el valor se cuenta como 0.
En comparación con los otros cuatro
R — estabilidad del servicio: 100
Las 300 solicitudes se dividen en cuatro tipos: texto breve, entrada larga, llamada a herramienta e historial de varios turnos. Se enviaron con una concurrencia de uno en tres ventanas. Solo se comprueba si la primera respuesta es válida y completa; las respuestas no se califican y no se reintenta ninguna solicitud. Los fallos durante las pruebas de respuestas y velocidad se contabilizan en Q y P, no nuevamente en R.
| Tipo de solicitud | Éxito al primer intento |
|---|---|
| Texto breve | 120/120 |
| Entrada larga de 10k | 90/90 |
| Llamada a herramienta | 60/60 |
| Historial de varios turnos | 30/30 |
| Total | 300/300, IC del 95%: 98.78%–100% |
Las 300 solicitudes devolvieron una respuesta válida y completa al primer intento. R 100 abarca solo estas 300 solicitudes específicas; no significa que no hubiera fallos en toda la ruta. Con 300 éxitos de 300 solicitudes, el límite inferior del intervalo del 95% es 98.78%, por lo que es probable que la tasa de fallos sea inferior al 1.22%.
En comparación con los otros cuatro
R abarca solo estas 300 solicitudes específicas; los fallos durante las pruebas de respuestas y velocidad se registran en Q y P, no nuevamente en R.
| Proveedor | Éxito al primer intento | Intervalo del 95% |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek oficial | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Preguntas frecuentes
¿Qué representa la puntuación general?
Es un índice resumido sin intervalo de confianza, no una certificación. Esta publicación presenta Q, F, P, K y R, y no recomienda ningún proveedor.
¿Por qué falló la mitad de las pruebas con diez solicitudes concurrentes?
50 de las 90 devolvieron no_available_channel. Como más de la mitad fueron inválidas, el tiempo mediano hasta el primer token se considera infinito, y TTFA y TPOT reciben las puntuaciones de penalización.
¿R 100 significa que no hubo fallos de canal?
No. R abarca 300 solicitudes específicas, todas exitosas al primer intento. Las 62 respuestas no_available_channel de la prueba de velocidad y los fallos de la prueba de respuestas se contabilizan en P y Q.
¿Por qué K es 68.85 si el prefijo de 32k acertó en 8 de 9?
Ambas longitudes tienen el mismo peso. El prefijo de 8k acertó en 5 de las 9 solicitudes frecuentes y obtuvo 49.60, mientras que el de 32k acertó en 8 de 9 y obtuvo 88.10; el promedio es 68.85.
¿Se puede distinguir la calidad de las respuestas de Baidu de la del canal oficial?
Sí. La diferencia combinada de Q es de −4.46 puntos porcentuales, con un intervalo del 95% de −5.78 a −3.16 que excluye el 0. Es el único resultado de un proveedor por debajo del canal oficial cuyo intervalo excluye el 0.
¿Qué comprobaciones se excluyeron de F?
Seis: tres comprobaciones de secuencias de parada de streaming que nunca se observaron porque no se envió la solicitud del paso anterior, y tres comprobaciones explícitas de cache_control registradas de antemano como no compatibles con esta interfaz.
Sigue leyendo: la serie DeepSeek V4.1 Flash
- La precisión de Baidu en BFCL fue cercana a la del canal oficial; la publicación sobre ByteDance sigue la misma batería de pruebas y analiza las llamadas a herramientas y los resultados de medición del uso: DeepSeek V4.1 Flash en ByteDance: las llamadas a herramientas coinciden, la medición del uso no
- El TTFA de Baidu con concurrencia de uno, de 2.26 s, contrasta con una prueba que llegó a 1.34 s: DeepSeek V4.1 Flash en Alibaba Cloud: primer token en 1.34s, caché 99.37
- El F de Baidu, de 88.39, contrasta con una prueba de referencia de 94.00 y 15 pruebas inválidas: DeepSeek V4.1 Flash en el canal oficial: F de 94.00, 15 pruebas inválidas
- Los aciertos de caché de 5/9 de Baidu en 8k se comparan con una prueba de 3/9 y respuestas de parada vacías: DeepSeek V4.1 Flash en Fireworks: respuestas de parada vacías, 3/9 aciertos de caché


