

El 2026-11-03/04, la suite APB Full se ejecutó con DeepSeek V4.1 Flash 1017 en cinco proveedores a través de AIHubMix. Se utilizaron el mismo modelo, las mismas preguntas y parámetros, y los mismos scripts de solicitud para todos los proveedores; el modelo aparece en la página del modelo de AIHubMix, y las cinco entradas de proveedores están en la página de modelos. Este perfil APB cubre únicamente Alibaba Cloud: qué midió cada sección y cuáles fueron los resultados.
Esta publicación informa de las puntuaciones sin clasificar a los proveedores ni recomendar ninguno. Primero se presentan Q, F, P, K y R; K es una subpuntuación de P. La puntuación global es un índice de resumen, no una certificación, y no tiene intervalo de confianza. Las reglas de puntuación se definen en AIHubMix Provider Benchmark Standard v2.0.
Puntuaciones de cinco proveedores
La negrita señala el proveedor de esta publicación. Los proveedores aparecen en un orden fijo, no en forma de clasificación. K es una subpuntuación de P que representa el 20%; se muestra por separado como referencia. La puntuación global es un índice de resumen sin intervalo de confianza. La diferencia global entre el canal oficial de DeepSeek y Alibaba Cloud es de 0.37, y no se pueden distinguir.
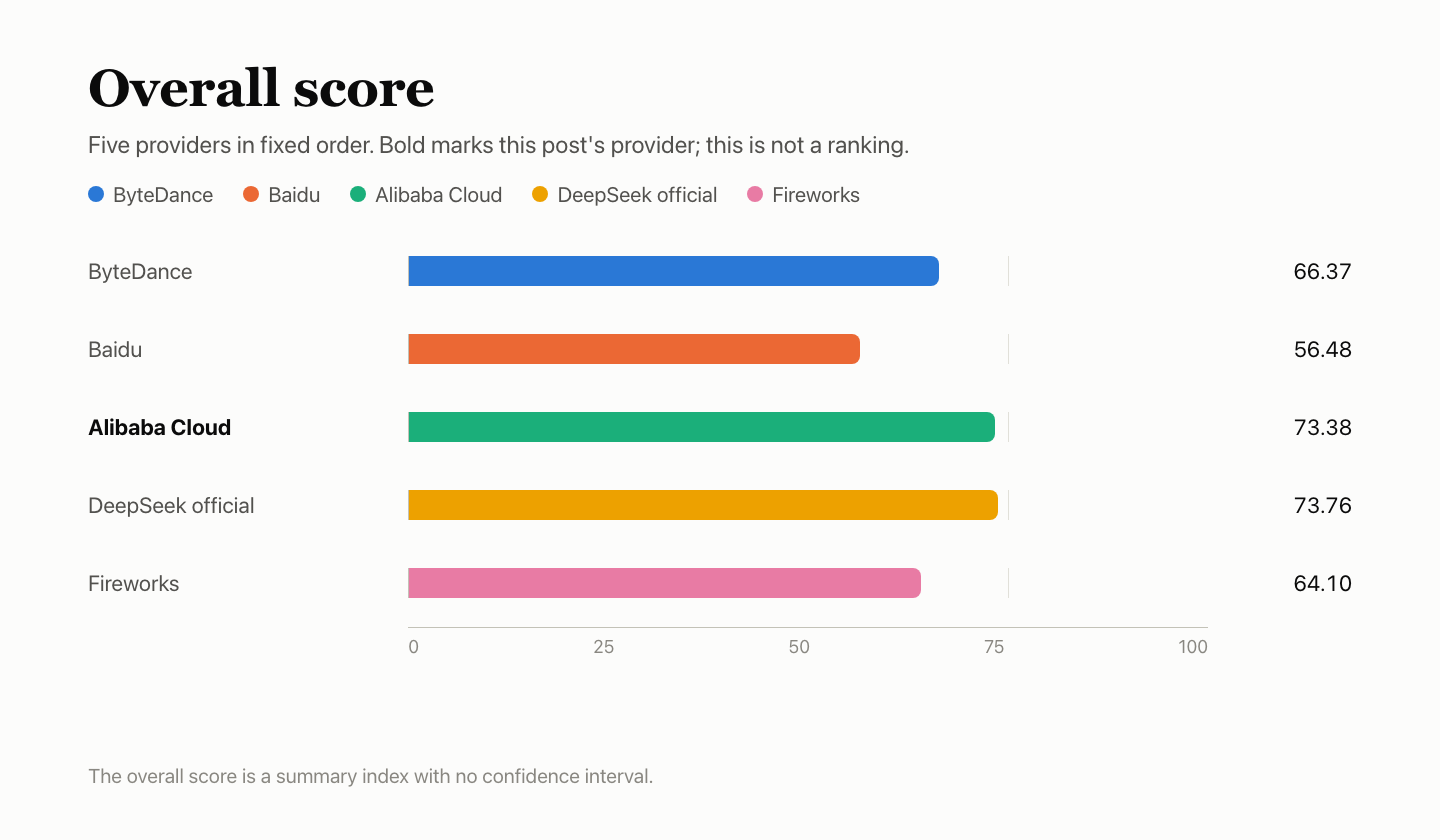
Resumen
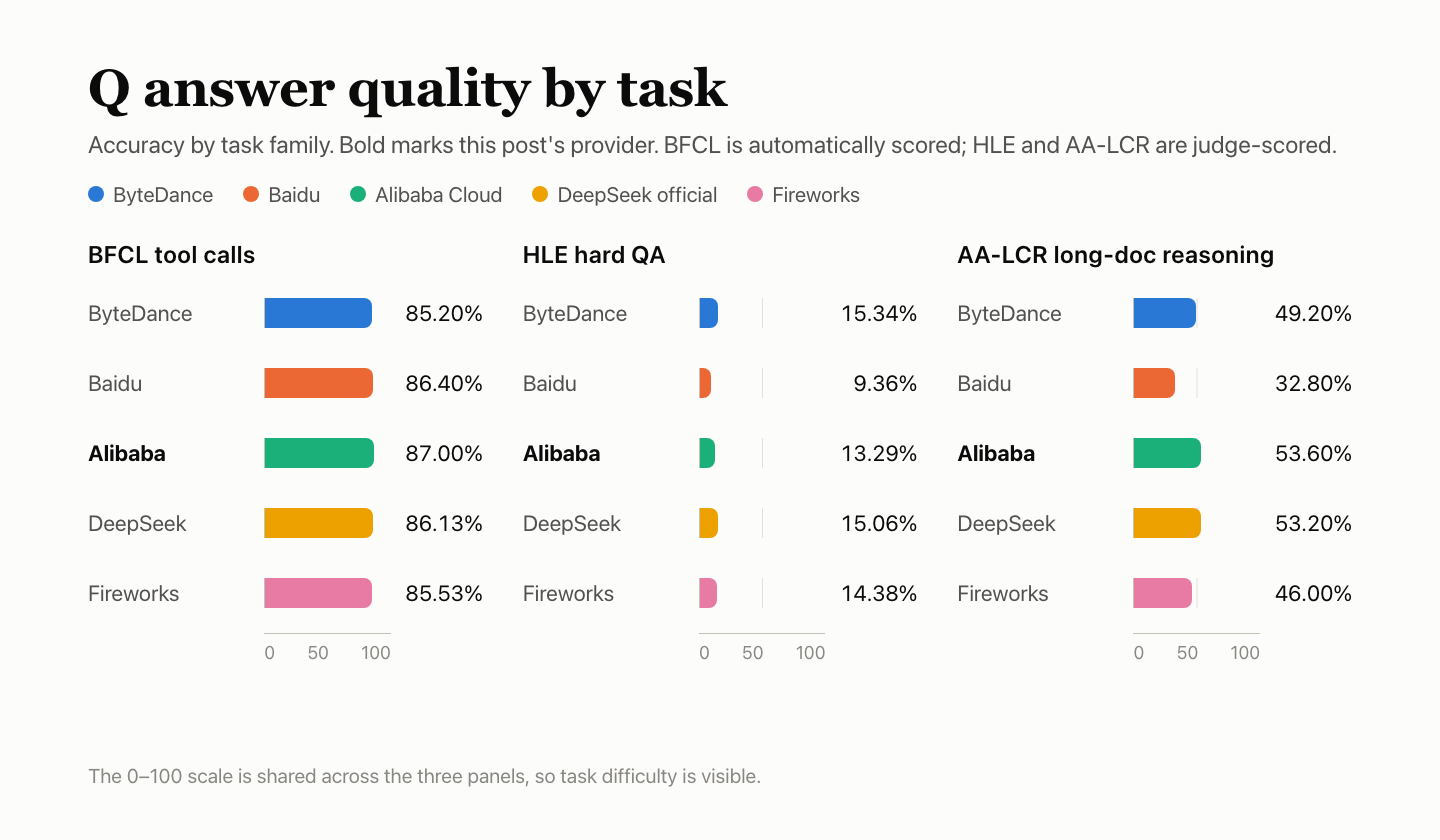
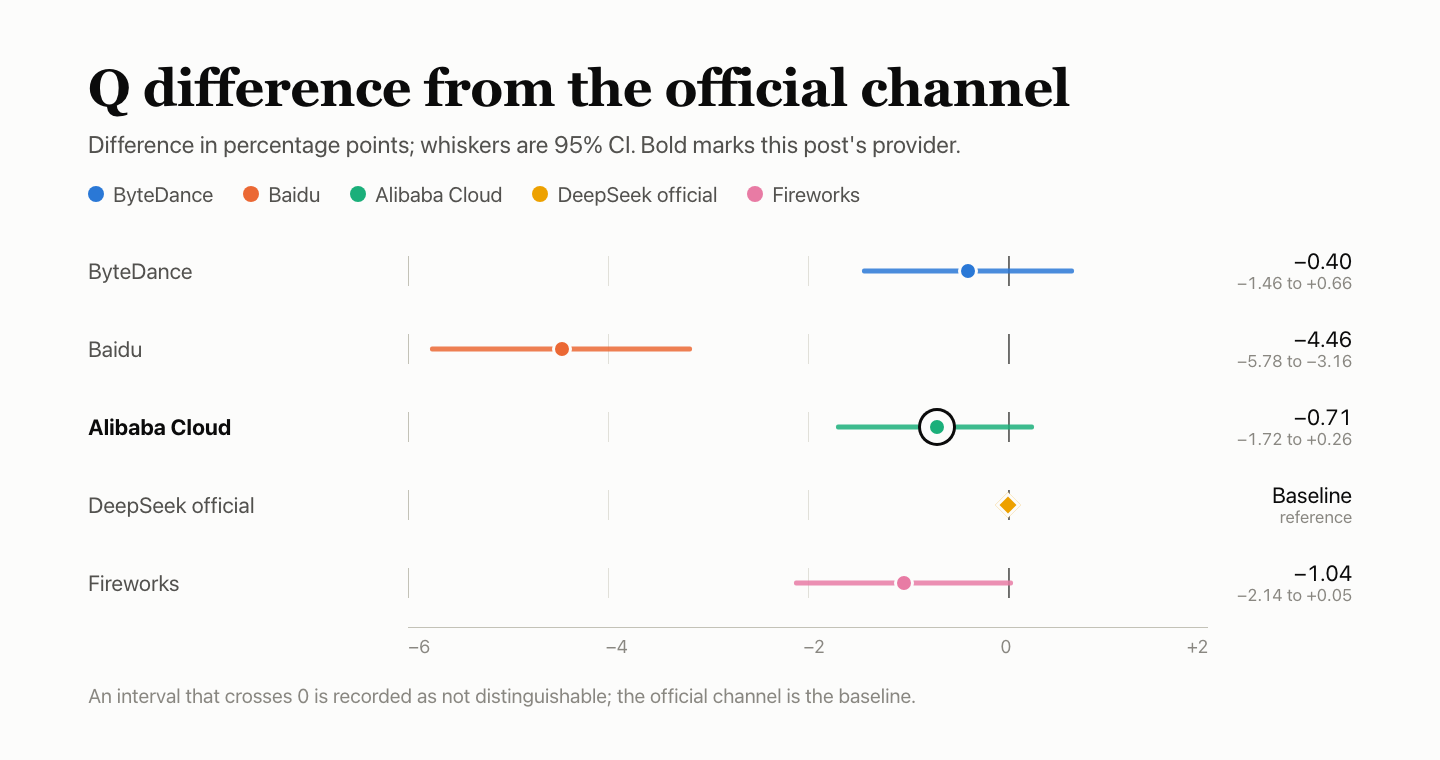
- Calidad de las respuestas: Q 41.75. BFCL 87.00%, HLE 13.29%, AA-LCR 53.60%. La diferencia respecto al canal oficial es de −0.71 puntos porcentuales, con un intervalo del 95% de −1.72 a +0.26, por lo que no se pueden distinguir.
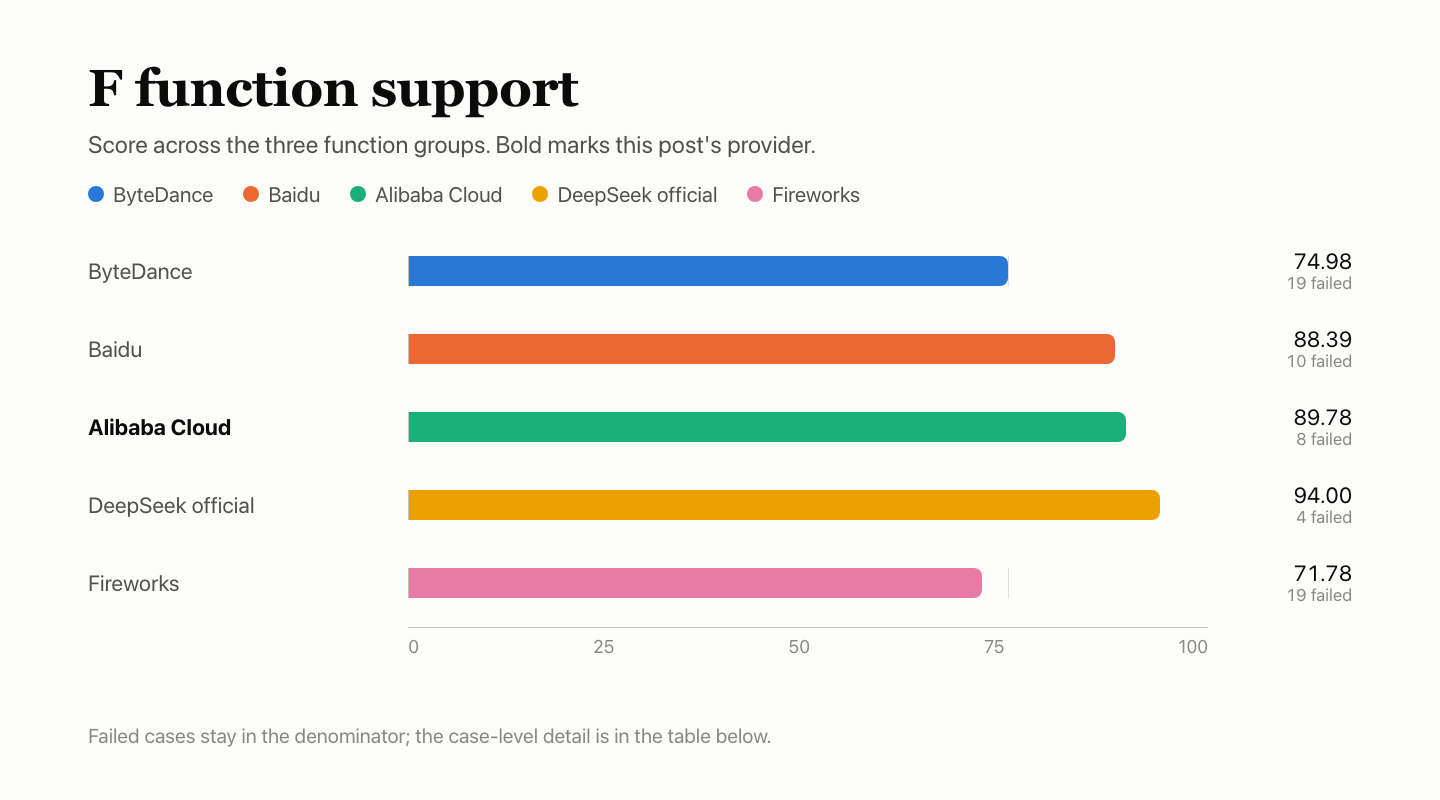
- Compatibilidad con funciones: F 89.78. Se superaron 155 de las 177 comprobaciones del denominador. Un esquema de herramienta no válido devolvió 503 en vez de un error de parámetros, el desbordamiento de contexto no devolvió el tipo de error documentado y un resultado de herramienta aislado devolvió 200.
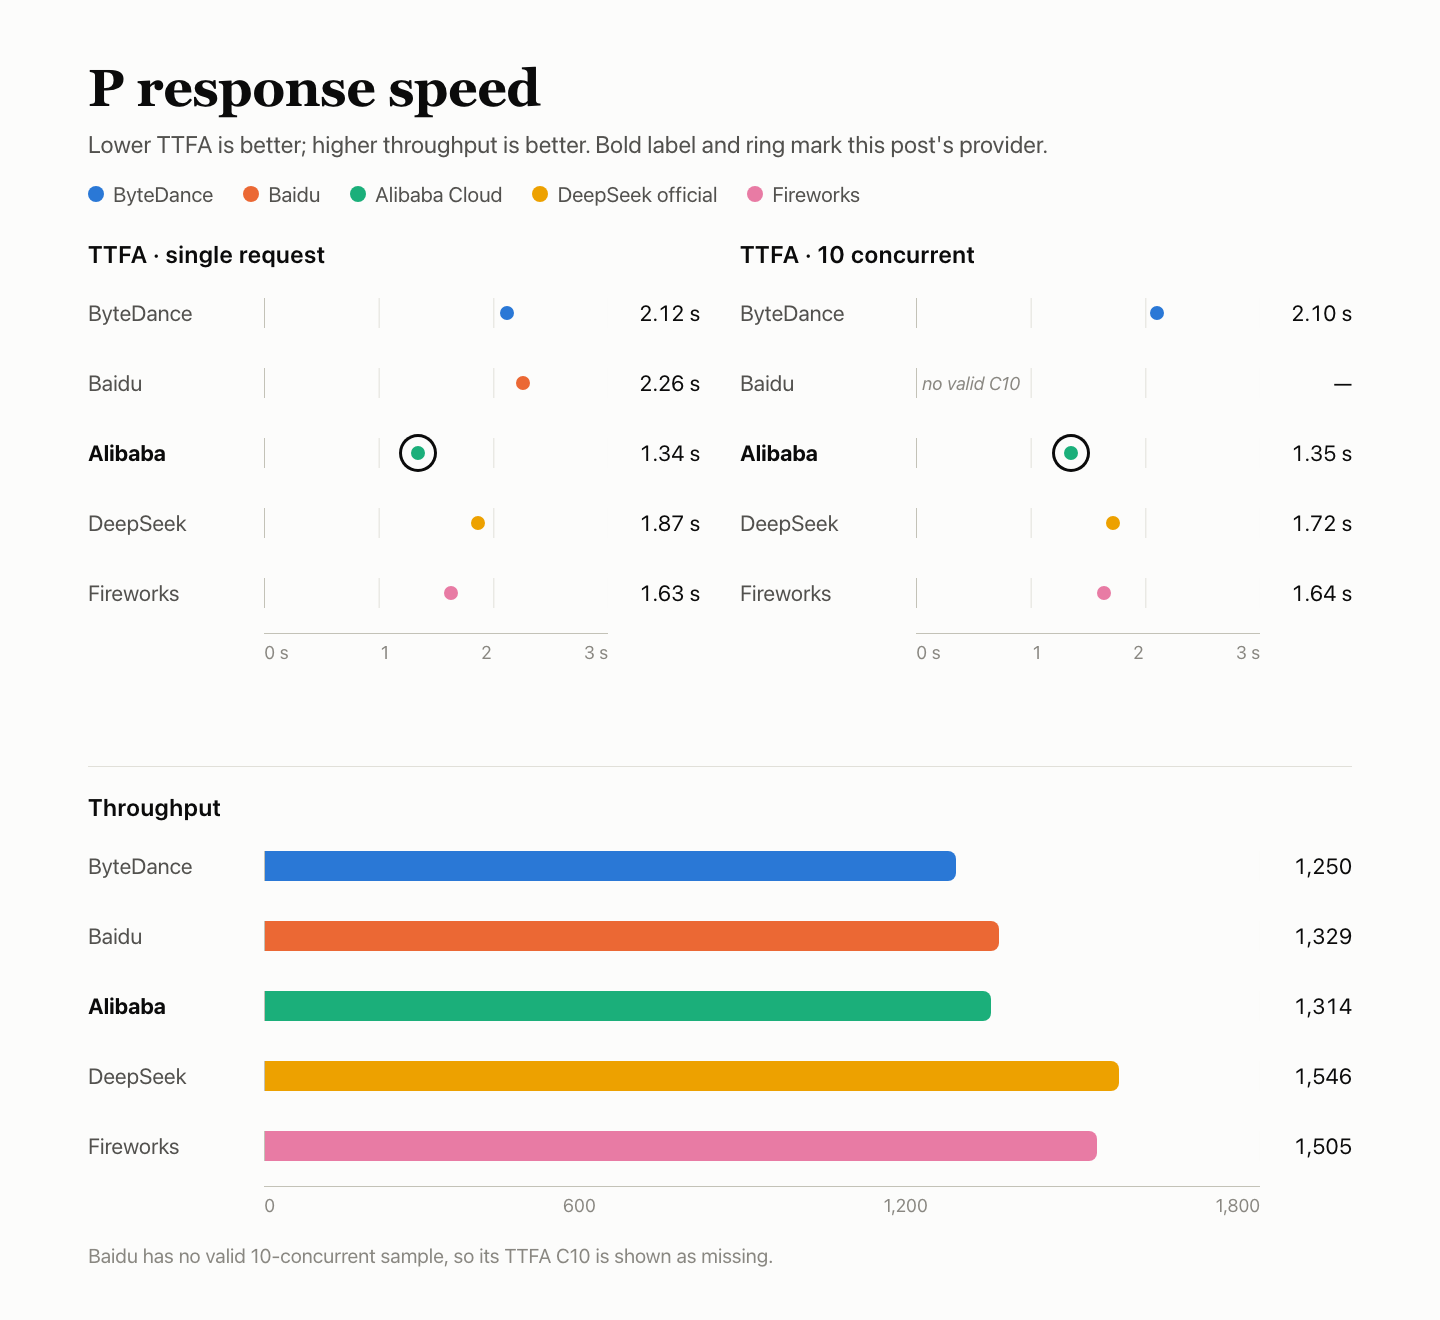
- Velocidad de respuesta: P 88.58. La mediana del tiempo hasta el primer token de contenido fue de 1.34 s con concurrencia 1 y de 1.35 s con concurrencia 10; TPOT fue de 4.69 ms, y las 180 solicitudes de velocidad fueron válidas.
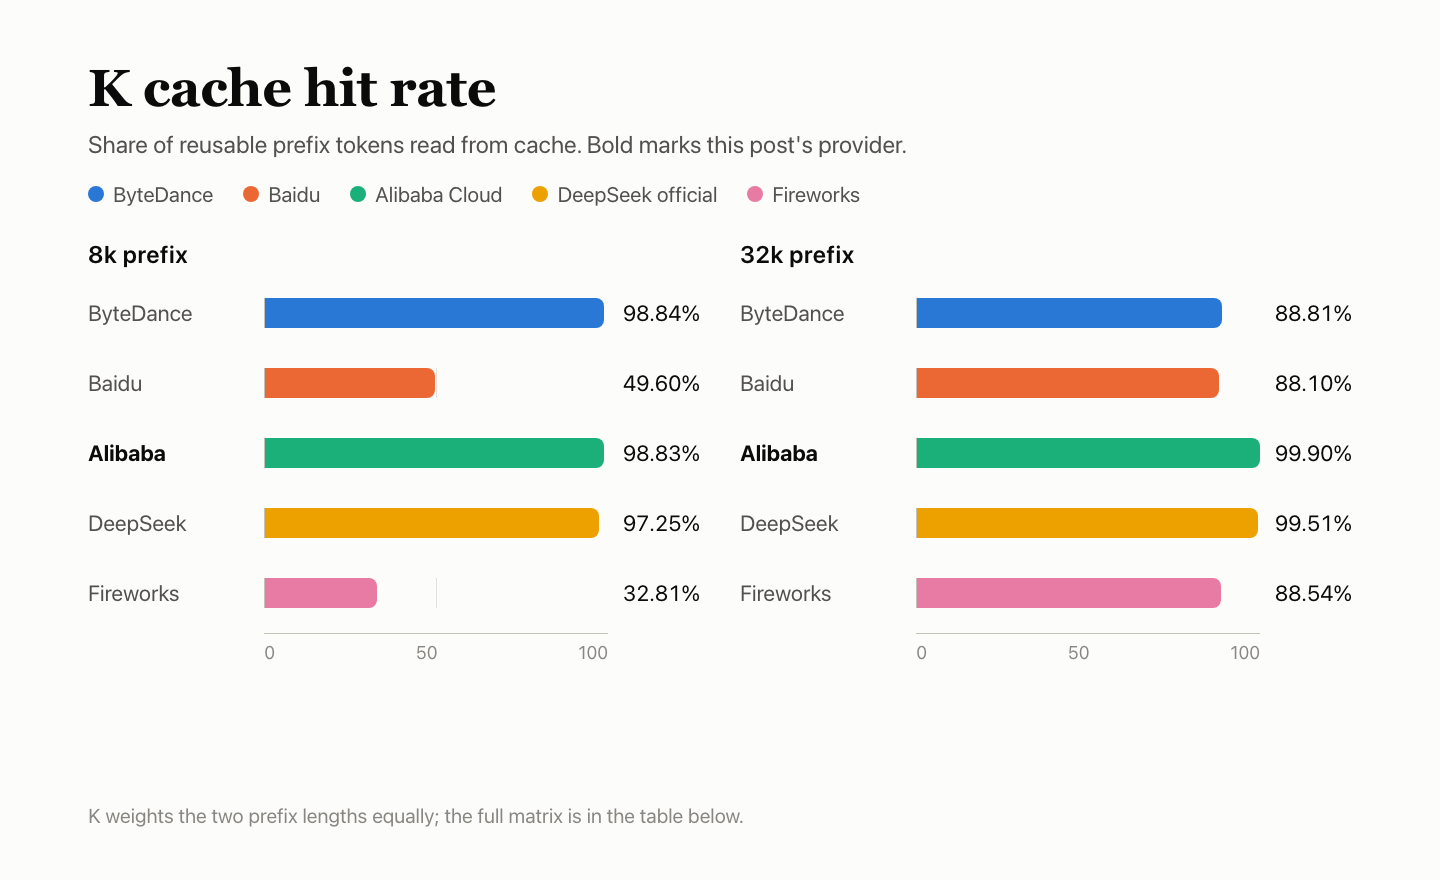
- Caché: K 99.37. Las 18 solicitudes rápidas con prefijos de 8k y 32k acertaron, y ningún control en frío leyó la caché.
- Estabilidad del servicio: R 100. Las 300 solicitudes dedicadas se completaron correctamente al primer intento.
Configuración de las pruebas
La ejecución se realizó a través de AIHubMix seleccionando el ID del modelo del proveedor; la guía de inicio rápido documenta la ruta. La página de precios de DeepSeek indica las tarifas publicadas del modelo.
| Elemento | Detalle |
|---|---|
| Modelo | DeepSeek V4.1 Flash 1017 |
| ID del modelo solicitado | alicloud-deepseek-v4.1-flash-1017 |
| Nombre del modelo devuelto | deepseek-v4.1-flash-1017 |
| Ruta de acceso | A través de AIHubMix, seleccionando el ID del modelo del proveedor, no conectándose a la cuenta propia del proveedor |
| Parámetros | Modo sin pensamiento, temperature 1.0, max_tokens 16,384, timeout 300 s, sin reintentos automáticos |
| Modo de pensamiento desactivado | Todas las solicitudes usaron reasoning_effort=none |
| Hora | 2026-11-03 18:07 – 11-04 16:33 UTC+8. Los cinco proveedores compartieron un Mac mini, la red y la cuenta. |
| Muestras | Calidad de las respuestas: 4,250 ejecuciones de preguntas (BFCL 500 × 3 rondas, HLE 250 × 10, AA-LCR 25 × 10); casos de funciones: 60 × 3 ventanas; velocidad: 90 con concurrencia 1 y 90 con concurrencia 10; estabilidad: 300; caché: 30 (prefijos de 8k y 32k, 3 grupos cada uno) |
Q — calidad de las respuestas: 41.75
La calidad de las respuestas se evaluó con tres conjuntos de preguntas: 500 preguntas BFCL en 3 rondas cada una, 250 preguntas HLE en 10 rondas cada una y 25 preguntas AA-LCR en 10 rondas cada una. BFCL se puntuó mediante reglas automáticas; HLE y AA-LCR fueron evaluadas por el modelo juez deepseek-flash. Los cinco proveedores respondieron las mismas preguntas y los tres conjuntos se combinaron en una sola tasa de acierto. Se eliminaron diez respuestas porque no se podían puntuar las preguntas, con lo que quedaron 4,240 ejecuciones de preguntas puntuadas.
| Tarea | Preguntas | Correctas | Tasa de acierto | Fallos |
|---|---|---|---|---|
| Llamadas a herramientas BFCL | 500 × 3 | 1,305/1,500 | 87.00% | 0 |
| Preguntas y respuestas difíciles HLE | 250 × 10 | 331/2,490 | 13.29% | 8 |
| Razonamiento con documentos largos AA-LCR | 25 × 10 | 134/250 | 53.60% | 0 |
| Combinado · intervalo del 95%: 39.56%–43.85% | — | 1,770/4,240 | 41.75% | 8 |
Los fallos del servicio (solicitudes fallidas o respuestas truncadas) se mantienen en el denominador y cuentan como incorrectos; no se eliminan. En Alibaba Cloud, la salida de HLE alcanzó el límite de max_tokens y se truncó 8 veces.
Cada pregunta BFCL se responde en 3 rondas; la tabla muestra las 3 rondas combinadas.
| Categoría BFCL | Superadas | Tasa de aprobación |
|---|---|---|
| simple_python: una función, llamada y argumentos correctos | 332/360 | 92.22% |
| multiple: elegir la función adecuada entre varias | 270/300 | 90.00% |
| parallel: llamar a la misma función varias veces en paralelo | 273/300 | 91.00% |
| parallel_multiple: llamar a varias funciones distintas en paralelo | 212/240 | 88.33% |
| irrelevance: ninguna función es pertinente; no se debe llamar a ninguna | 113/150 | 75.33% |
| ahm_multi_turn: cadena de herramientas en tres etapas | 105/150 | 70.00% |
Comparación con los otros cuatro
Respecto al canal oficial: diferencia en puntos porcentuales en la precisión, con el intervalo del 95% indicado mediante barras; si el intervalo cruza el 0, se considera que no hay diferencia. El juez deepseek-flash de HLE y AA-LCR pertenece a la misma familia DeepSeek que el modelo evaluado y no se calibró, por lo que su puntuación podría ser indulgente.
F — compatibilidad con funciones: 89.78
Los casos de funciones comprueban si el comportamiento de la interfaz sigue el protocolo, no si el modelo responde bien. Los 60 casos se dividen en seis grupos y cada uno se ejecuta en tres ventanas, para un total de 180 comprobaciones, evaluadas según el formato documentado por cada proveedor. Las comprobaciones no aplicables, no válidas o no observadas se excluyen del denominador. Alibaba Cloud superó 155 de las 177 comprobaciones del denominador; la ponderación de los grupos da una puntuación de 89.78.
La puntuación ponderada se calcula a partir de los pesos de los grupos, no como un simple recuento de aprobaciones sobre 177.
| Grupo | Peso | Superadas | Excluidas | Puntuación del grupo |
|---|---|---|---|---|
| Streaming y protocolo de mensajes | 20% | 30/30 | — | 100.00 |
| Interfaz de herramientas | 20% | 30/30 | — | 100.00 |
| Restricciones de salida y parámetros | 20% | 30/30 | — | 100.00 |
| Contexto y estado | 15% | 26/30 | — | 86.67 |
| Errores y recuperación | 15% | 18/30 | — | 60.00 |
| Protocolo de medición y caché | 10% | 21/27 | 3 | 77.78 |
| Total · puntuación ponderada | — | 155/177 | 3 | 89.78 |
Un recuento de ventanas de 3/3 significa que el caso falló en las tres ventanas.
| Caso fallido | Ventanas con fallos | Motivo |
|---|---|---|
| Desbordamiento de contexto (contexto y estado) | 3/3 | Devolvió un error, pero no el error de longitud de contexto documentado |
| Error de formato de messages (errores y recuperación) | 3/3 | Devolvió 400 con el cuerpo de respuesta vacío, sin descripción estructurada del error |
| Esquema de herramienta no válido (errores y recuperación) | 3/3 | Debería devolver un error de parámetros; devolvió 503 |
| Resultado de herramienta aislado (errores y recuperación) | 3/3 | Debería devolver un error de parámetros; devolvió 200 |
| Error de formato de stream_options (errores y recuperación) | 3/3 | Devolvió 400 con el cuerpo de respuesta vacío, sin descripción estructurada del error |
| Medición de tokens de razonamiento (protocolo de medición y caché) | 3/3 | No se devolvió el recuento de tokens de razonamiento |
| Definiciones de herramientas contabilizadas como entrada (protocolo de medición y caché) | 3/3 | Con definiciones de herramientas, los tokens de entrada informados no fueron superiores a los de la solicitud sin ellas |
| Aislamiento de solicitudes (contexto y estado) | 1/3 | El primer paso no respondió únicamente STORED como se requería, por lo que no se pudo continuar con la comprobación de aislamiento |
Estas comprobaciones se excluyen del denominador y no cuentan ni como aprobadas ni como fallidas.
| Estado | Caso | Recuento | Motivo |
|---|---|---|---|
| No aplicable | Explicit cache_control | 3 | Registrado previamente como no compatible con esta interfaz |
Los casos de error de formato de messages y de error de formato de stream_options fallaron en los cinco proveedores: todos devolvieron 400 con el cuerpo vacío, por lo que el cliente no recibió una descripción estructurada del error. Como los cinco presentan el mismo comportamiento, es más probable que el problema se encuentre en la capa de pasarela de AIHubMix y requiere una investigación aparte. La medición de tokens de razonamiento también falló en los cinco, pero por motivos distintos: ByteDance y Fireworks informaron de tokens de razonamiento incluso con el modo de pensamiento desactivado, mientras que los otros tres no devolvieron un recuento de tokens de razonamiento.
Comparación con los otros cuatro
P — velocidad de respuesta: 88.58
Cada solicitud incluía unos 10,000 tokens de entrada y pedía unos 1,100 tokens de salida. En tres ventanas se enviaron 30 solicitudes con concurrencia 1 y 30 con concurrencia 10, para un total de 180. El tiempo de espera hasta el primer token de contenido (TTFA) se mide para cada solicitud válida, y la tabla muestra las medianas. TPOT se estima a partir de los tiempos de los fragmentos de streaming, no del tiempo por token del hardware; el rendimiento es el total de tokens de salida válidos con concurrencia 10 dividido por el tiempo de reloj de pared del lote.
| Métrica | Resultado |
|---|---|
| TTFA del primer token de contenido | Mediana con concurrencia 1: 1.34 s; mediana con concurrencia 10: 1.35 s |
| Velocidad de generación TPOT | Concurrencia 1: 4.63 ms/token; concurrencia 10: 4.69 ms/token |
| Rendimiento efectivo (goodput) | Concurrencia 10: 1,313.6 token/s |
| Solicitudes válidas | Concurrencia 1: 90/90; concurrencia 10: 90/90 |
| Puntuaciones de los componentes | TTFA 59.65, TPOT 100.00, rendimiento 100.00; para TTFA y TPOT se toma el valor más bajo de los dos niveles, con ponderaciones del 35% / 35% / 30%; puntuación de respuesta: 85.88 |
| Puntuación P | Puntuación de respuesta 85.88 con un peso del 80%, caché K 99.37 con un peso del 20%, total 88.58 |
Comparación con los otros cuatro
Los cinco proveedores compartieron la misma máquina, red y cuenta. Las tres ventanas se programaron proveedor por proveedor, por lo que los periodos de recopilación no se superponen por completo y no conviene sobreinterpretar las pequeñas diferencias.
K — caché: 99.37
Cada grupo consta de cinco solicitudes: la primera lleva un prefijo fijo de unos 8k o 32k tokens y llena la caché; las solicitudes 2–4 mantienen el prefijo y cambian únicamente la pregunta final, a los 5, 30 y 120 segundos; la quinta usa un prefijo nuevo como control en frío. Tres ventanas × dos longitudes suman 30 solicitudes. K es el número de tokens almacenados en caché leídos en las solicitudes rápidas dividido por los tokens que deberían poder reutilizarse según la regla, con cada longitud ponderada por igual; K representa el 20% de P. La matriz muestra las lecturas de tokens almacenados en caché informadas por el servidor.
| Prefijo | Ventana | Solicitud inicial (solicitud 1) | Rápida a los 5 s | Rápida a los 30 s | Rápida a los 120 s | Control en frío (solicitud 5) |
|---|---|---|---|---|---|---|
| 8k | Ventana 1 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Ventana 2 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Ventana 3 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 32k | Ventana 1 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Ventana 2 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Ventana 3 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| Prefijo | Aciertos rápidos | Tokens leídos | Deberían poder reutilizarse | Puntuación |
|---|---|---|---|---|
| 8k | 9/9 | 71,424 | 72,270 | 98.83 |
| 32k | 9/9 | 288,000 | 288,279 | 99.90 |
| K (8k y 32k, mitad cada uno) | 99.37 |
Las 9 solicitudes rápidas con prefijo de 8k acertaron y leyeron 7,936 tokens cada una; las 9 solicitudes rápidas con prefijo de 32k acertaron y leyeron 32,000 tokens cada una. La solicitud inicial y el control en frío no leyeron la caché, así que las solicitudes rápidas y en frío se distinguen claramente.
Comparación con los otros cuatro
R — estabilidad del servicio: 100
Las 300 solicitudes abarcaron cuatro tipos —texto corto, entrada larga de 10k, llamadas a herramientas e historial de varios turnos— y se enviaron con concurrencia 1 en tres ventanas. Solo se comprobó la primera respuesta, en cuanto a validez e integridad; no se verificó la corrección de las respuestas y no se hicieron reintentos. Los fallos de las secciones de calidad de las respuestas y velocidad se contabilizan en Q y P, respectivamente, no de nuevo en R.
| Tipo de solicitud | Éxito al primer intento |
|---|---|
| Texto corto | 120/120 |
| Entrada larga de 10k | 90/90 |
| Llamadas a herramientas | 60/60 |
| Historial de varios turnos | 30/30 |
| Total · intervalo del 95%: 98.78%–100% | 300/300 |
Las 300 solicitudes devolvieron una respuesta válida y completa al primer intento. R 100 abarca únicamente estas 300 solicitudes específicas y no significa que no hubiera fallos en toda la cadena. El límite inferior del intervalo del 95% es del 98.78%: incluso con 300/300, es probable que la tasa de fallos sea inferior al 1.22%.
En comparación con los otros cuatro
R abarca únicamente estas 300 solicitudes específicas; los fallos en la calidad y la velocidad de las respuestas se registran en Q y P, y no se vuelven a contar en R.
| Proveedor | Éxito al primer intento | Intervalo del 95% |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek oficial | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Preguntas frecuentes
¿Es significativa la diferencia global de 0.37 entre Alibaba Cloud y el canal oficial?
No. En esta ejecución no se puede distinguir uno del otro: la diferencia de Q es de −0.71 puntos porcentuales, con un intervalo del 95% de −1.72 a +0.26, que incluye el 0, y la puntuación global es un índice resumido sin intervalo de confianza.
¿Qué combina la puntuación Q?
Tres conjuntos: 500 preguntas de BFCL × 3 rondas, puntuadas automáticamente; 250 de HLE × 10 y 25 de AA-LCR × 10, puntuadas por el modelo juez deepseek-flash. La precisión combinada es del 41.75% en 4,240 ejecuciones puntuadas de preguntas.
¿Por qué F es 89.78 si se superaron 155 de 177 comprobaciones?
La puntuación se pondera por grupo; no es una simple proporción de aprobados. Errores y recuperación obtuvo 60.00, y medición y protocolo de caché, 77.78, mientras que los tres grupos de protocolo obtuvieron 100.00.
¿Por qué R indica 100 si hubo solicitudes fallidas en otras secciones?
R abarca únicamente las 300 solicitudes específicas de estabilidad. Los fallos en la calidad y la velocidad de las respuestas se registran en Q y P, y no se vuelven a contar en R.
¿K 99.37 es una tasa de aciertos de caché?
Es la proporción entre los tokens leídos de la caché en solicitudes repetidas y los tokens que deberían poder reutilizarse, con una ponderación del 50% para cada uno de los prefijos de 8k y 32k. El prefijo de 8k obtuvo 98.83 y el de 32k, 99.90.
¿El primer token en 1.34 s significa que la respuesta completa llega en 1.34 s?
No. Es el tiempo de espera hasta el primer token de contenido. Cada solicitud pidió unos 1,100 tokens de salida y el TPOT con 10 solicitudes concurrentes fue de 4.69 ms por token.
Sigue leyendo: la serie DeepSeek V4.1 Flash
- La puntuación Q combinada de Alibaba Cloud difiere de la referencia oficial en 0.71 puntos porcentuales, dentro de un intervalo que incluye el 0; el perfil de ByteDance aplica la misma comparación a la medición de llamadas a herramientas: DeepSeek V4.1 Flash en ByteDance: las llamadas a herramientas coinciden, la medición no.
- Alibaba Cloud devolvió respuestas válidas en las 180 solicitudes de velocidad; el perfil de Baidu aplica el mismo entorno de pruebas, en el que ningún canal disponible afectó a Q ni a P: DeepSeek V4.1 Flash en Baidu: ningún canal disponible afecta a Q y P.
- El canal oficial es la referencia para comparar la calidad de las respuestas en este artículo; su propio perfil abarca F 94.00 y 15 pruebas no válidas con concurrencia 1: DeepSeek V4.1 Flash en el canal oficial: F 94.00, 15 pruebas no válidas.
- Alibaba Cloud acertó en 9/9 solicitudes repetidas con ambas longitudes de prefijo; el perfil de Fireworks abarca respuestas vacías al detenerse y 3/9 aciertos de caché con 8k: DeepSeek V4.1 Flash en Fireworks: respuestas vacías al detenerse, 3/9 aciertos de caché.


