
El 2026-11-05/06, DeepSeek V4.1 Flash 1017 se sometió a la suite completa del AIHubMix Provider Benchmark (APB) en Pareto. Las puntuaciones son Q 48.40, F 93.42, P 57.69, K 27.58 y R 100; el índice general es 73.09. Este perfil APB abarca únicamente Pareto. El modelo aparece como DeepSeek V4.1 Flash 1017.
Esta publicación informa únicamente de las puntuaciones, sin clasificaciones ni recomendaciones de proveedores. Q, F, P, K y R se presentan primero; el índice general es una cifra resumida sin intervalo de confianza. El estándar es AIHubMix Provider Benchmark Standard v2.0.
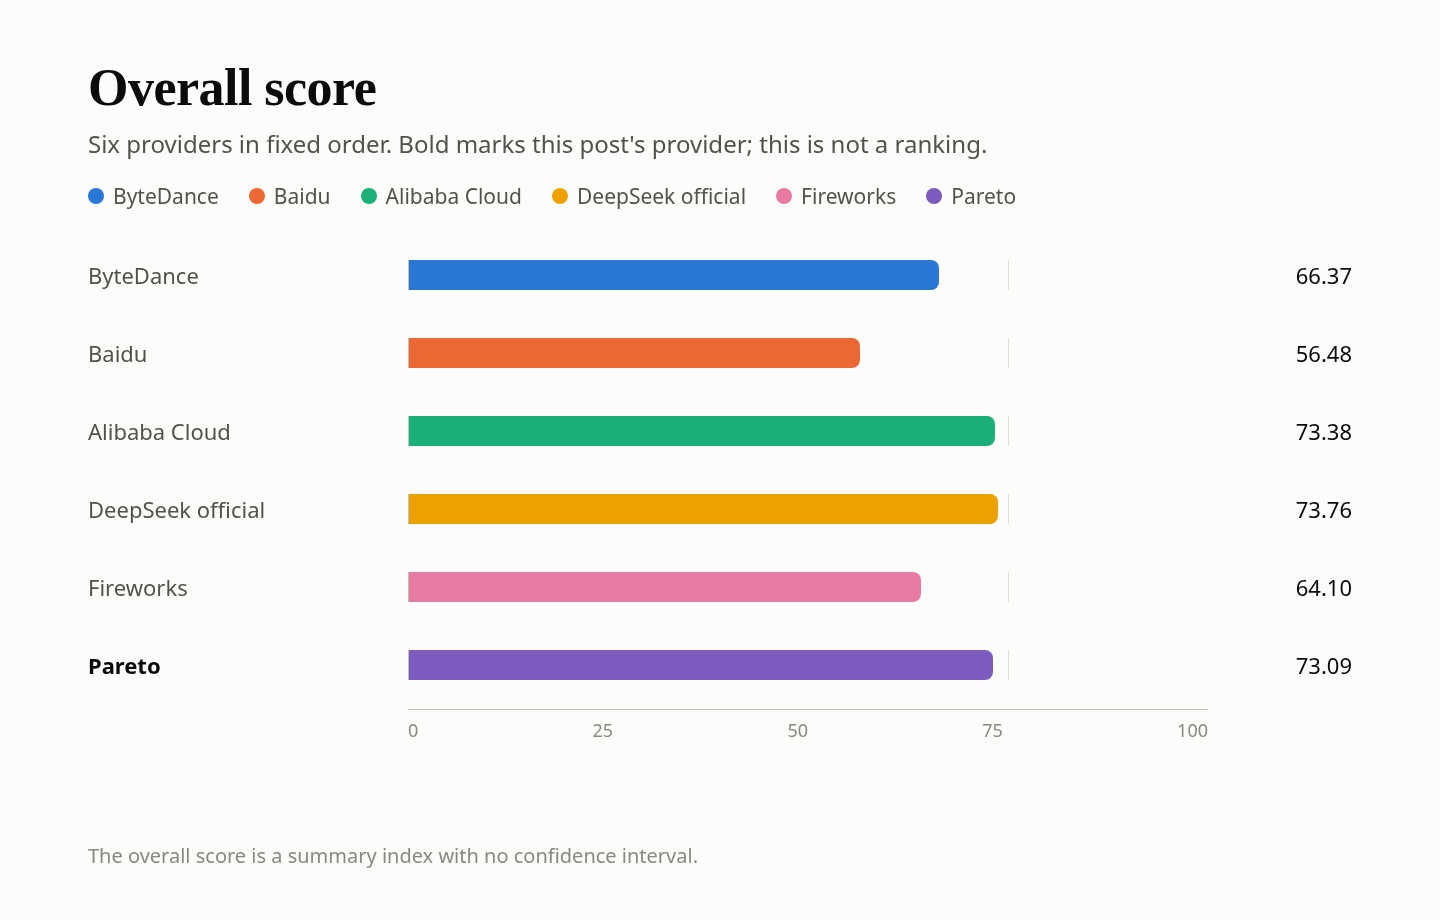
Puntuaciones de seis proveedores
La negrita señala el proveedor de esta publicación. Orden fijo de proveedores, no es una clasificación. K es una subpuntuación de P y representa el 20%. El índice general es una cifra resumida sin intervalo de confianza. DeepSeek official channel y Alibaba Cloud difieren en 0.37 y no se pueden distinguir.
Resumen
- Q — calidad de las respuestas: 48.40. BFCL 85.07%, HLE 23.21%, AA-LCR 79.20%. Frente al canal oficial: +5.94 puntos porcentuales, IC del 95% de +3.54 a +8.36. HLE tuvo 996 errores de servicio, la mayoría truncados porque el pensamiento consumió el presupuesto de longitud de salida; se contabilizan como incorrectos.
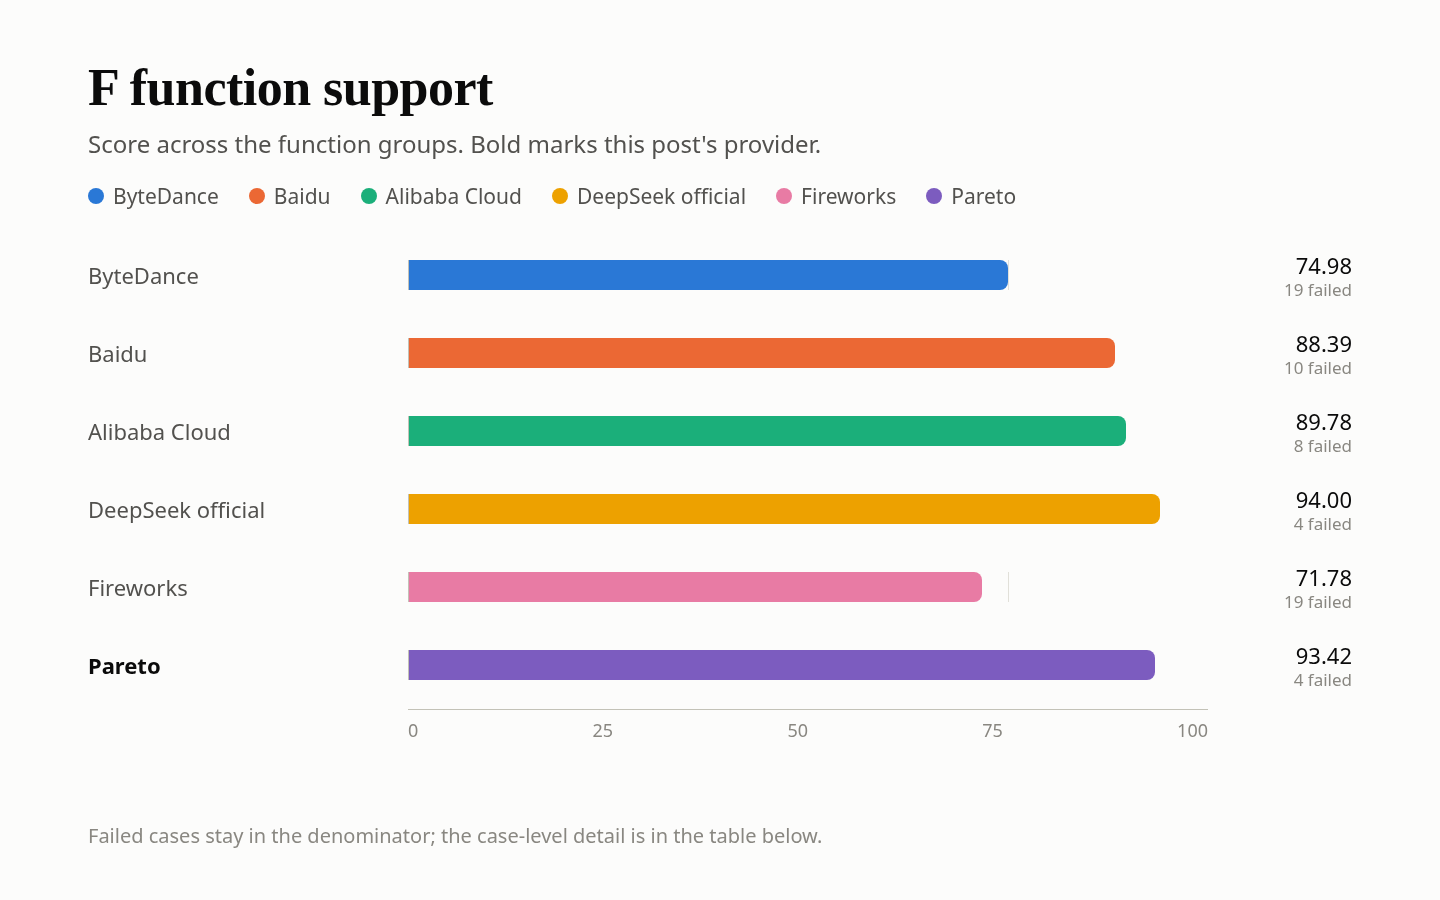
- F — compatibilidad con funciones: 93.42. Se aprobaron 29 de 33 comprobaciones contabilizadas (streaming 23/27, errores 3/3, medición 3/3). 147 comprobaciones quedaron fuera del denominador. De los 4 fallos, 3 fueron cuerpos vacíos en solicitudes con secuencias de detención y 1 fue una discrepancia exacta con el caso de prueba de texto en streaming.
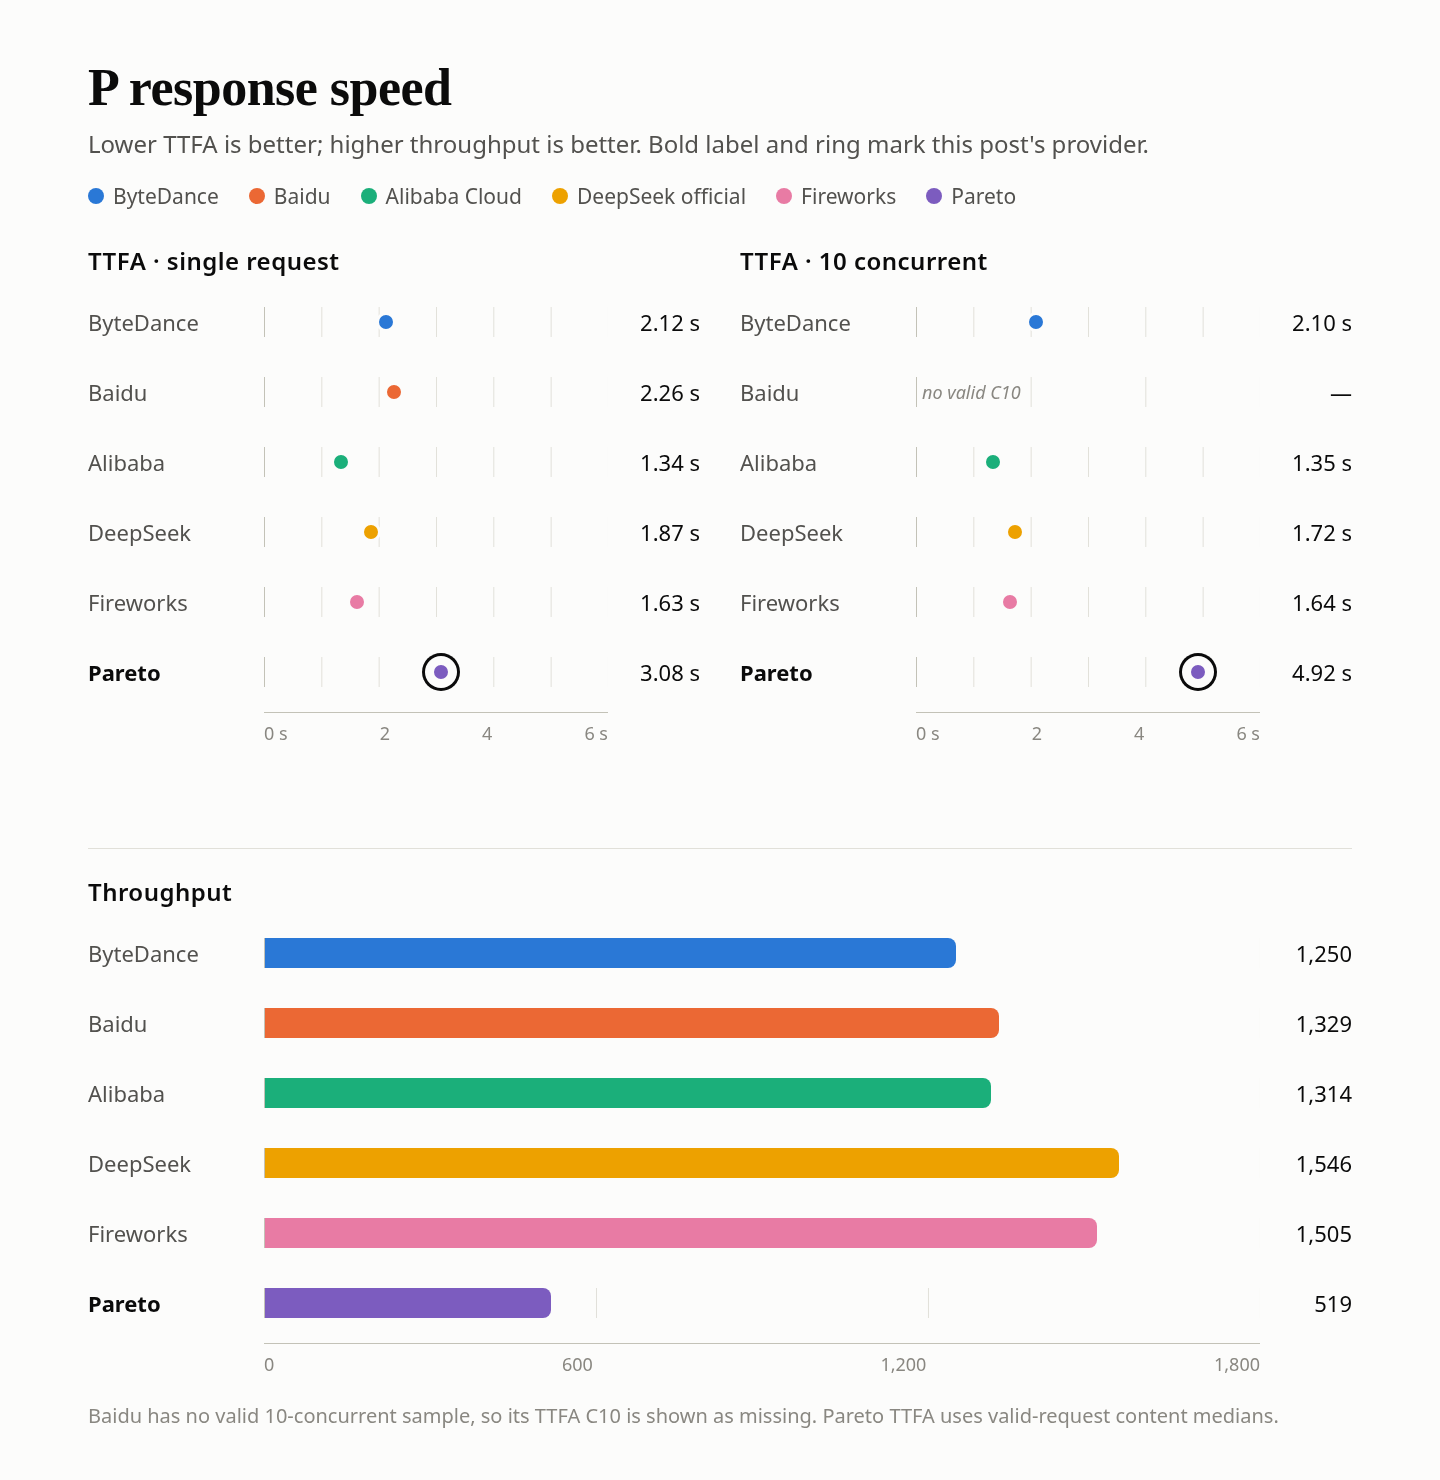
- P — velocidad de respuesta: 57.69. Puntuación de respuesta 65.22, caché K al 20%. Medianas de TTFA de solicitudes válidas: 3.08 s con concurrencia simple y 4.92 s con 10 solicitudes concurrentes; medianas de puntuación, incluidas las solicitudes no válidas: 5.85 s y 6.13 s. 110 de las 180 pruebas fueron válidas; 70 no fueron válidas porque el pensamiento consumió el presupuesto de salida de la prueba de velocidad.
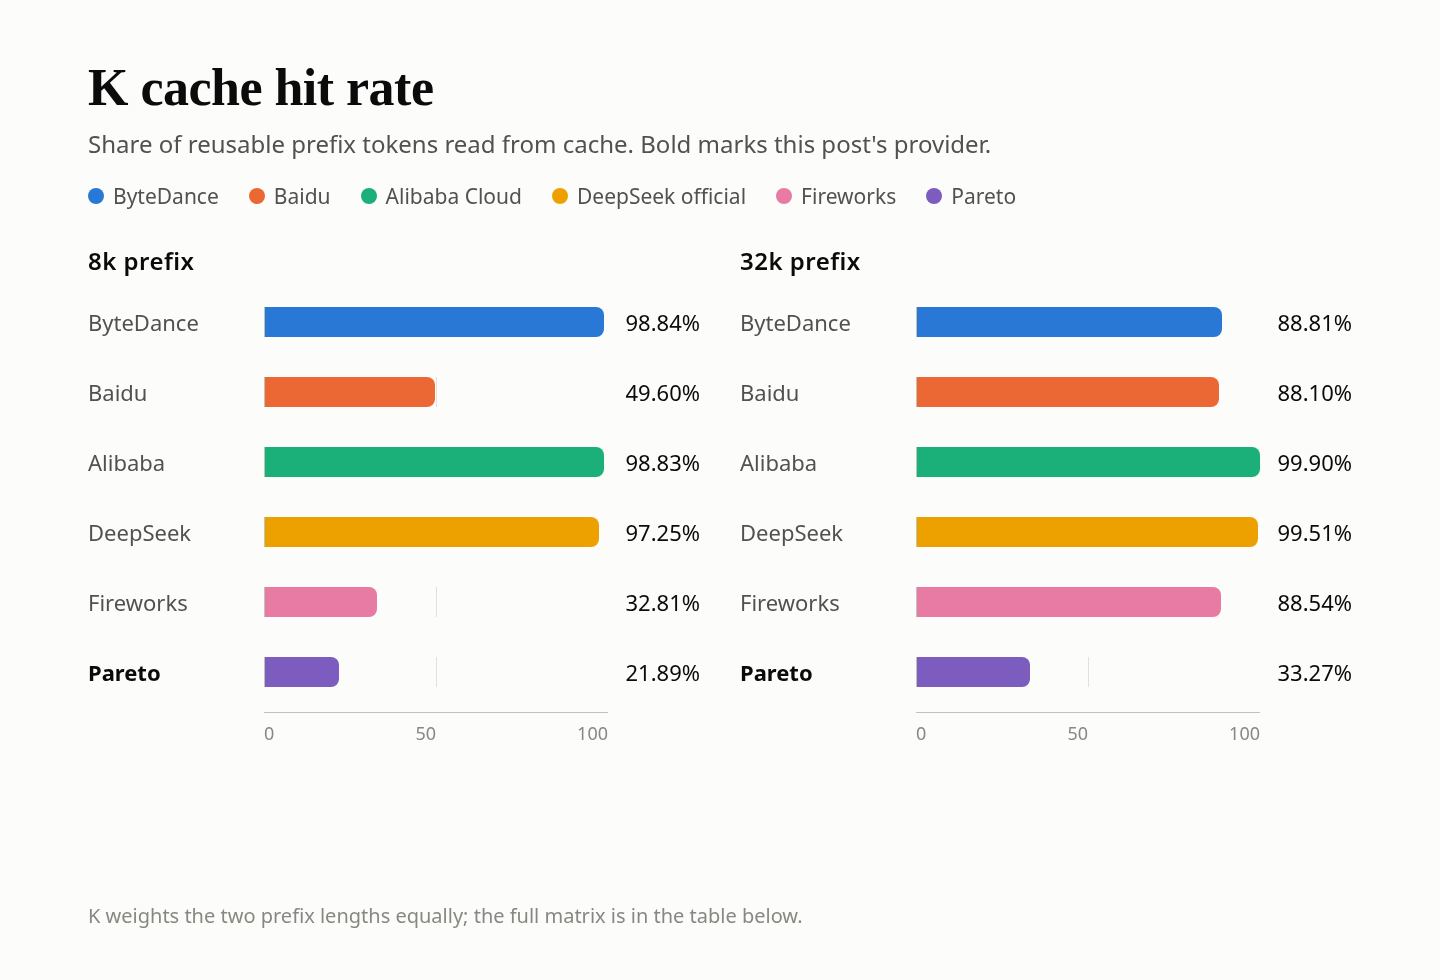
- K — caché: 27.58. 8k en caliente 2/9 (leídos 15,872 / reutilizables 72,504); 32k en caliente 3/9 (leídos 96,000 / reutilizables 288,513). Puntuación con la configuración predeterminada.
- R — estabilidad del servicio: 100. Las 300/300 solicitudes dedicadas se completaron correctamente en el primer intento.
Configuración de la prueba
| Elemento | Configuración |
|---|---|
| Modelo | DeepSeek V4.1 Flash 1017 |
| ID del modelo solicitado | deepseek/deepseek-v4.1-flash |
| Ruta de acceso | Pareto, con el ID del modelo indicado arriba |
| Parámetros | temperature 1.0, max_tokens 16,384, timeout 300 s; solo solicitudes en streaming |
| Pensamiento | Pensamiento de alta intensidad activado |
| Fecha | 2026-11-05/06 UTC+8; la caché corresponde a una nueva prueba con la configuración predeterminada del 2026-11-06 |
| Muestras | Q 4,250 (BFCL 500×3, HLE 250×10, AA-LCR 25×10); F 60×3; P 90+90; R 300; K 30 |
| Notas | En esta ejecución se usó pensamiento de alta intensidad; los otros cinco proveedores de la serie no usaron ninguno. La compatibilidad con funciones se puntúa sobre el subconjunto disponible en streaming; la caché usa la configuración predeterminada. |
Las solicitudes usaron la guía de inicio rápido de AIHubMix; los ID de los modelos están en la página de modelos.
Q — calidad de las respuestas: 48.40
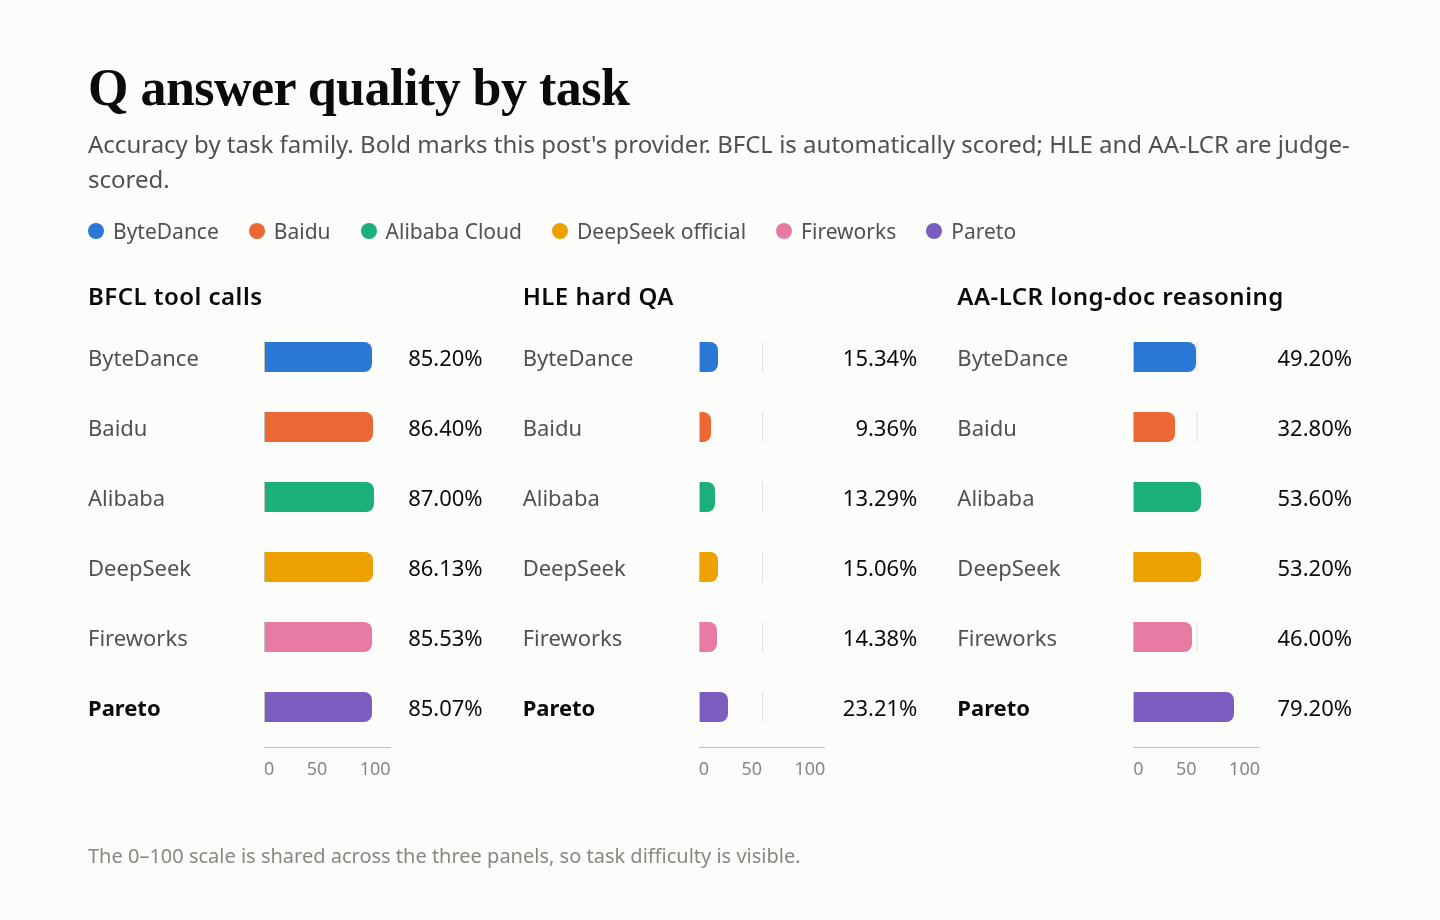
La suite ejecutó 500 preguntas de BFCL × 3 rondas, 250 de HLE × 10 y 25 de AA-LCR × 10. BFCL se puntuó automáticamente; HLE y AA-LCR fueron evaluados por deepseek-flash. Las tres familias usan los mismos elementos que los demás proveedores. Se eliminaron diez respuestas imposibles de puntuar, con lo que quedaron 4,240 instancias puntuadas.
| Tarea | Preguntas | Correctas | Precisión | Fallos |
|---|---|---|---|---|
| Llamadas a herramientas de BFCL | 500 × 3 | 1,276/1,500 | 85.07% | 0 |
| Preguntas y respuestas difíciles de HLE | 250 × 10 | 578/2,490 | 23.21% | 996 |
| Razonamiento sobre documentos largos de AA-LCR | 25 × 10 | 198/250 | 79.20% | 0 |
| Total · IC del 95%: 45.39%–51.26% | — | 2,052/4,240 | 48.40% | 996 |
Los fallos permanecen en el denominador como respuestas incorrectas: 996 de HLE se truncaron cuando el pensamiento consumió el presupuesto de longitud de salida. De los 1,494 intentos de HLE que devolvieron una respuesta completa, 578 fueron correctos (aproximadamente el 38.7%).
| Categoría de BFCL | Aprobados | Tasa de aprobación |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 269/300 | 89.67% |
| parallel | 265/300 | 88.33% |
| parallel_multiple | 203/240 | 84.58% |
| irrelevance | 104/150 | 69.33% |
| ahm_multi_turn | 102/150 | 68.00% |
simple_python aprobó 333/360 (92.50%), multiple 269/300 (89.67%), ahm_multi_turn 102/150 (68.00%) e irrelevance 104/150 (69.33%).
Comparación con los otros cinco
Diferencia en puntos porcentuales frente al canal oficial; el intervalo del 95% se muestra como barras de error. Si cruza el 0, no se puede distinguir. El evaluador deepseek-flash pertenece a la misma familia y no está calibrado, por lo que podría ser indulgente.
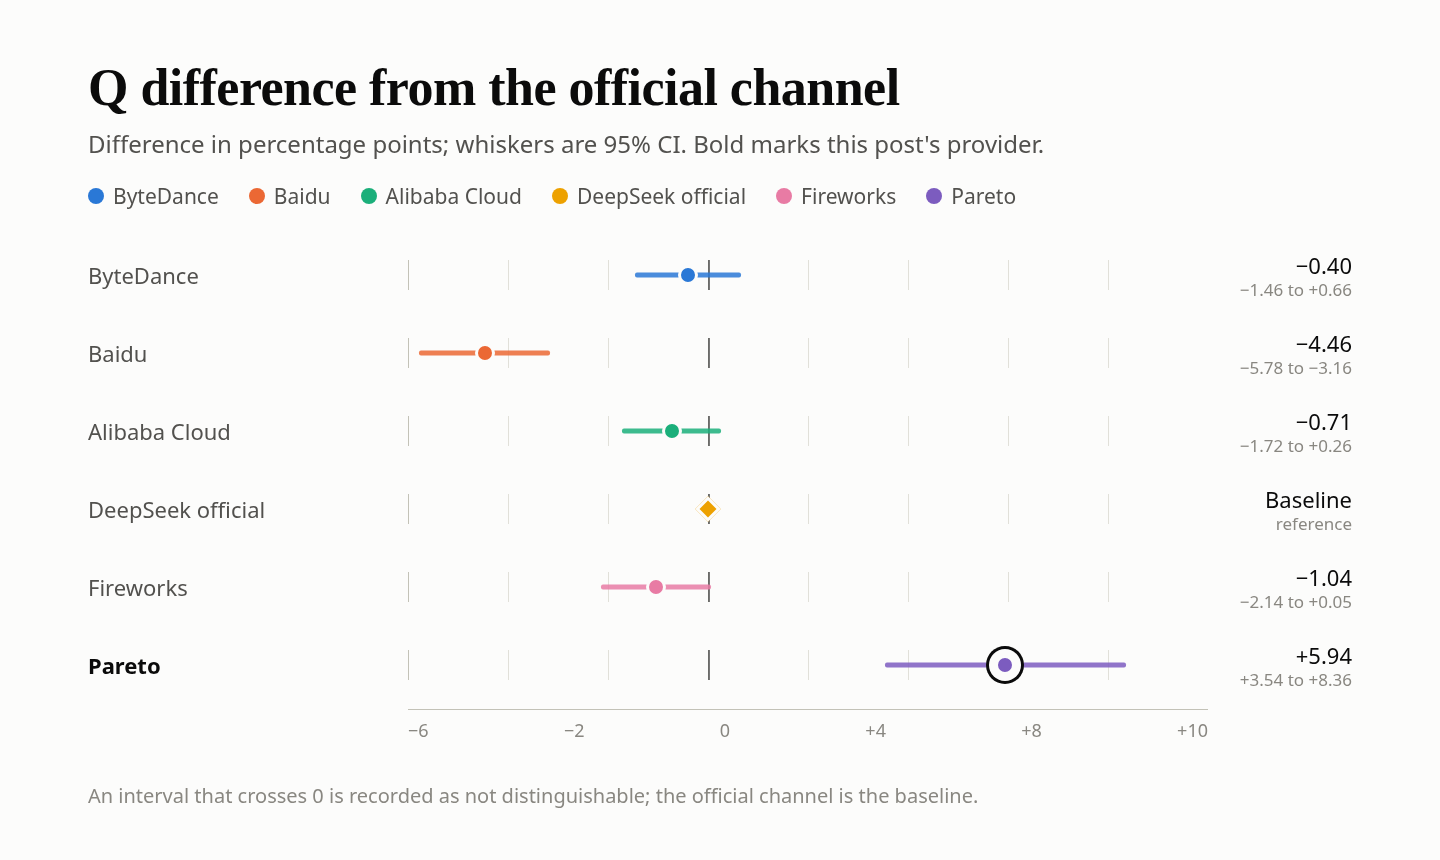
Frente al canal oficial, la diferencia numérica es +5.94 (+3.54 a +8.36).
F — compatibilidad con funciones: 93.42
33 comprobaciones contabilizadas, 29 aprobadas; 147 no contabilizadas. La cifra 93.42 normaliza de nuevo las ponderaciones originales de los grupos según los grupos observados (streaming 20%, errores 15%, medición 10%; total 45%). La tasa simple de aprobación, 29/33, es del 87.88%. Las herramientas, las restricciones y el contexto no se contabilizaron en absoluto.
| Grupo de casos | Peso | Aprobados | Excluidos | Puntuación del grupo |
|---|---|---|---|---|
| Streaming y mensajería | 20% | 23/27 | 3 | 85.19 |
| Interfaz de herramientas | 20% | — | 30 | — |
| Restricciones de salida | 20% | — | 30 | — |
| Contexto y estado | 15% | — | 30 | — |
| Errores y recuperación | 15% | 3/3 | 27 | 100.00 |
| Medición y caché | 10% | 3/3 | 27 | 100.00 |
| Observado / ponderado | — | 29/33 | 147 | 93.42 |
«Ventanas fallidas» cuenta las tres ventanas en las que el caso no se aprobó.
| Caso fallido | Ventanas fallidas | Motivo |
|---|---|---|
| Detención en streaming | 3/3 | Cuerpo vacío al detenerse |
| Texto en streaming | 1/3 | Punto adicional al final del cuerpo respecto al caso de prueba |
Comparación con los otros cinco
P — velocidad de respuesta: 57.69
La puntuación usa el tiempo hasta el primer token de contenido, no el tiempo hasta el primer token de cualquier tipo. Con el pensamiento activado, el modelo genera contenido de pensamiento antes del texto de respuesta visible, por lo que la espera hasta el contenido es mayor que la espera hasta el primer paquete. En cada una de las tres ventanas, se enviaron 30 solicitudes con concurrencia simple y 30 con concurrencia de 10, para un total de 180.
| Métrica | Resultado |
|---|---|
| TTFA de contenido | Medianas para la puntuación: 5.85 s (c=1) y 6.13 s (c=10); medianas de solicitudes válidas: 3.08 s y 4.92 s |
| Primer token de cualquier tipo | Medianas de solicitudes válidas: 1.46 s y 1.76 s |
| TPOT | Banda de puntuación más lenta: 4.87 ms/token |
| Rendimiento útil | 519 token/s con concurrencia de 10 |
| Válidas | 53/90 con c=1 y 57/90 con c=10, total 110/180; 70 no fueron válidas porque el pensamiento consumió el presupuesto de salida de la prueba de velocidad (~2,048 tokens) |
| Componentes | TTFA 24.59, TPOT 100.00, rendimiento útil 72.05; puntuación de respuesta 65.22 |
| Composición de P | 65.22 × 80% + 27.58 × 20% = 57.69 |
Los tokens de pensamiento se excluyen del numerador del rendimiento útil.
K — caché: 27.58
Lecturas agregadas de la nueva prueba del 2026-11-06 con la configuración predeterminada. No se incluyen las matrices de caché por solicitud (los rastros sin procesar no se migraron). K pondera por igual las dos longitudes de prefijo; K representa el 20% de P.
| Prefijo | Aciertos en caliente | Leído / reutilizable | Segmento |
|---|---|---|---|
| 8k | 2/9 | 15,872 / 72,504 | 21.89 |
| 32k | 3/9 | 96,000 / 288,513 | 33.27 |
| K (ponderación igual) | 27.58 |
Los controles en frío se aprobaron en 6/6 en cada longitud.
R — estabilidad del servicio: 100
Las 300 solicitudes abarcaron texto corto, entrada larga, llamadas a herramientas e historial de varios turnos, con concurrencia simple. Solo se comprobaron la validez y la integridad de la primera respuesta; no se evaluaron las respuestas ni se reintentó ninguna solicitud. Los fallos de Q y P no se vuelven a contabilizar aquí.
| Tipo de solicitud | Éxito en el primer intento |
|---|---|
| Texto corto | 120/120 |
| Entrada larga de 10k | 90/90 |
| Llamadas a herramientas | 60/60 |
| Historial de varios turnos | 30/30 |
| Total · IC del 95%: 98.78%–100% | 300/300 |
Preguntas frecuentes
¿Qué abarca Q 48.40?
BFCL, HLE y AA-LCR en 4,240 instancias puntuadas: 2,052 correctas, 48.40%, IC del 95% de 45.39%–51.26%. Frente al canal oficial, la diferencia numérica es +5.94 (+3.54 a +8.36).
¿Por qué hubo 996 errores de servicio en HLE?
La mayoría se truncaron porque el pensamiento consumió el presupuesto de longitud de salida; se mantienen en el denominador como incorrectos.
¿Por qué F es 93.42 si se excluyeron 147 comprobaciones?
Solo se contabiliza el subconjunto disponible en streaming. Las ponderaciones de los grupos se normalizan de nuevo según los grupos observados; las herramientas, las restricciones y el contexto no se contabilizan en absoluto.
¿Por qué fallaron los casos de detención?
Las solicitudes con una secuencia de detención devolvieron un cuerpo vacío en las tres ventanas.
¿Por qué 70 de las 180 pruebas de velocidad no fueron válidas?
El pensamiento consumió el presupuesto de salida de la prueba de velocidad (unos 2,048 tokens).
¿Qué abarca R 100?
300 solicitudes dedicadas, todas válidas en el primer intento; el límite inferior del 95% es 98.78%. Los fallos de Q y P no se cuentan en R.
Sigue leyendo: la serie DeepSeek V4.1 Flash
- ByteDance informó de tokens de pensamiento después de desactivar el pensamiento: DeepSeek V4.1 Flash en ByteDance: las llamadas a herramientas coinciden, la medición no
- Baidu obtuvo Q 38.00 y P 37.77: DeepSeek V4.1 Flash en Baidu: ningún canal disponible alcanza Q y P
- Alibaba Cloud registró un primer token en 1.34 s y una caché de 99.37: DeepSeek V4.1 Flash en Alibaba Cloud: primer token en 1.34s, caché 99.37
- El canal oficial es la referencia de Q, con F 94.00: DeepSeek V4.1 Flash en el canal oficial: F 94.00, 15 pruebas no válidas
- Fireworks devolvió respuestas vacías al detenerse y registró 3/9 aciertos de caché en 8k: DeepSeek V4.1 Flash en Fireworks: respuestas vacías al detenerse, 3/9 aciertos de caché


