

En la ejecución APB Full del 2026-11-03/04, las cuatro puntuaciones de Pareto son Q 44.58, F 93.42, P 57.69 y R 100, con una puntuación general de 68.72. Las solicitudes en caliente de 8k tuvieron 2 aciertos de 9 y las de 32k, 3 de 9.
El 2026-11-03/04, se probó DeepSeek V4.1 Flash 1017 con seis proveedores a través de AIHubMix y la suite APB Full, utilizando las mismas preguntas, parámetros y scripts de solicitudes para cada uno. Este perfil APB cubre únicamente Pareto: qué midió cada sección y cuáles fueron los resultados.
Las cifras que aparecen a continuación son puntuaciones, no una clasificación ni una recomendación de proveedor. Primero se presentan las cuatro puntuaciones, Q, F, P y R; la puntuación general es un índice de resumen, no una certificación, y no tiene intervalo de confianza. Las reglas de puntuación se definen en AIHubMix Provider Benchmark Standard v2.0.
Puntuaciones de seis proveedores
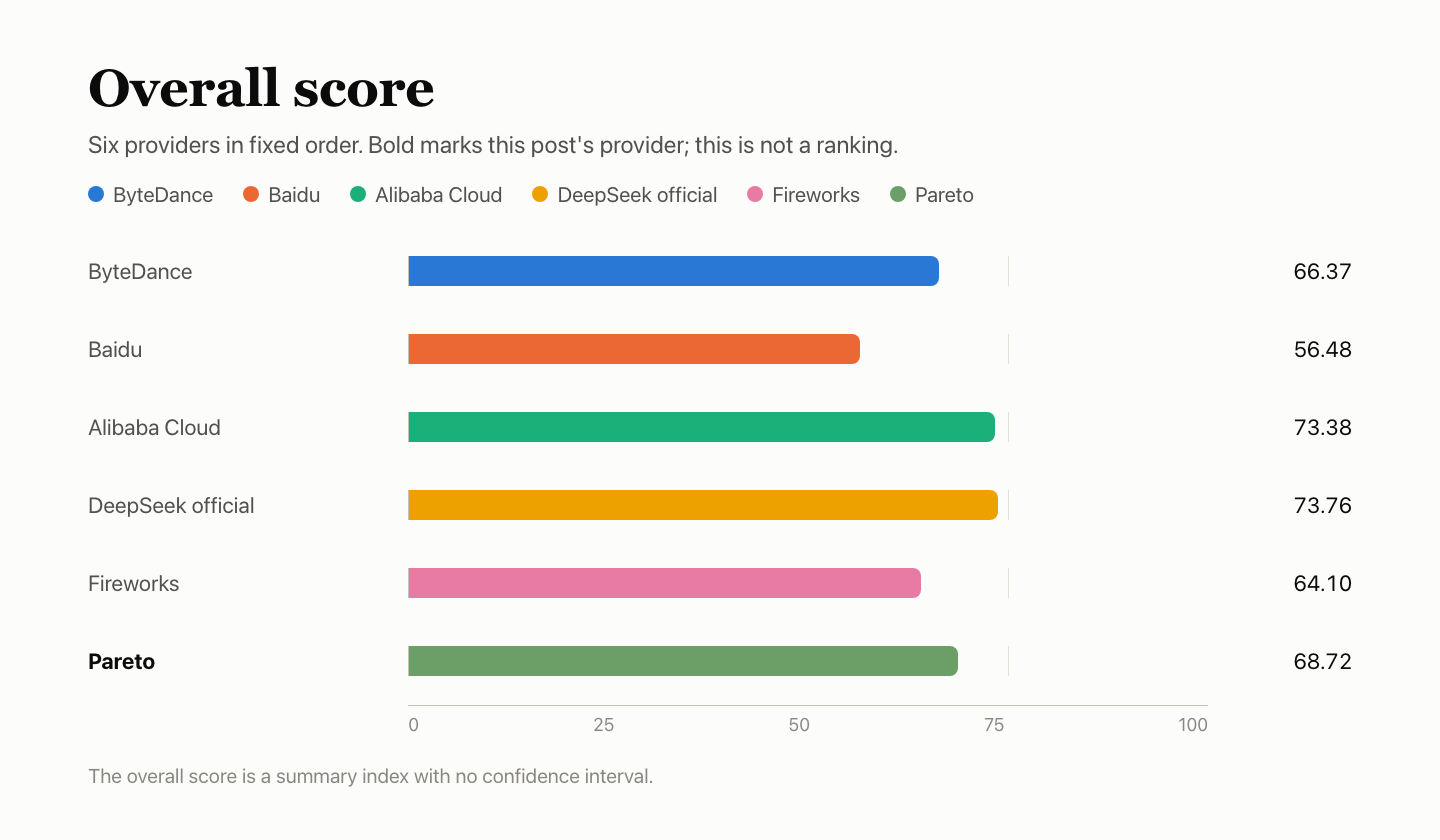
| Proveedor | Calidad Q | Función F | Velocidad P | Caché K | Estabilidad R | General |
|---|---|---|---|---|---|---|
| ByteDance | 42.05 | 74.98 | 84.37 | 93.83 | 100 | 66.37 |
| Baidu | 38.00 | 88.39 | 37.77 | 68.85 | 100 | 56.48 |
| Alibaba Cloud | 41.75 | 89.78 | 88.58 | 99.37 | 100 | 73.38 |
| Canal oficial de DeepSeek | 42.45 | 94.00 | 86.14 | 98.38 | 100 | 73.76 |
| Fireworks | 41.42 | 71.78 | 79.51 | 60.68 | 100 | 64.10 |
| Pareto (esta publicación) | 44.58 | 93.42 | 57.69 | 27.58 | 100 | 68.72 |
Los proveedores aparecen en un orden fijo, no en una clasificación. K es una subpuntuación de P, representa el 20% de esta y se muestra por separado como referencia. La puntuación general se calcula según las reglas de composición de AIHubMix Provider Benchmark Standard, que también tienen en cuenta la comparación con el canal oficial y la integridad de las pruebas; no es una ponderación directa de las cuatro puntuaciones de la tabla. Es un índice de resumen sin intervalo de confianza. La diferencia entre el canal oficial de DeepSeek y Alibaba Cloud es de solo 0.37 en la puntuación general, por lo que no es una diferencia distinguible.
Resumen
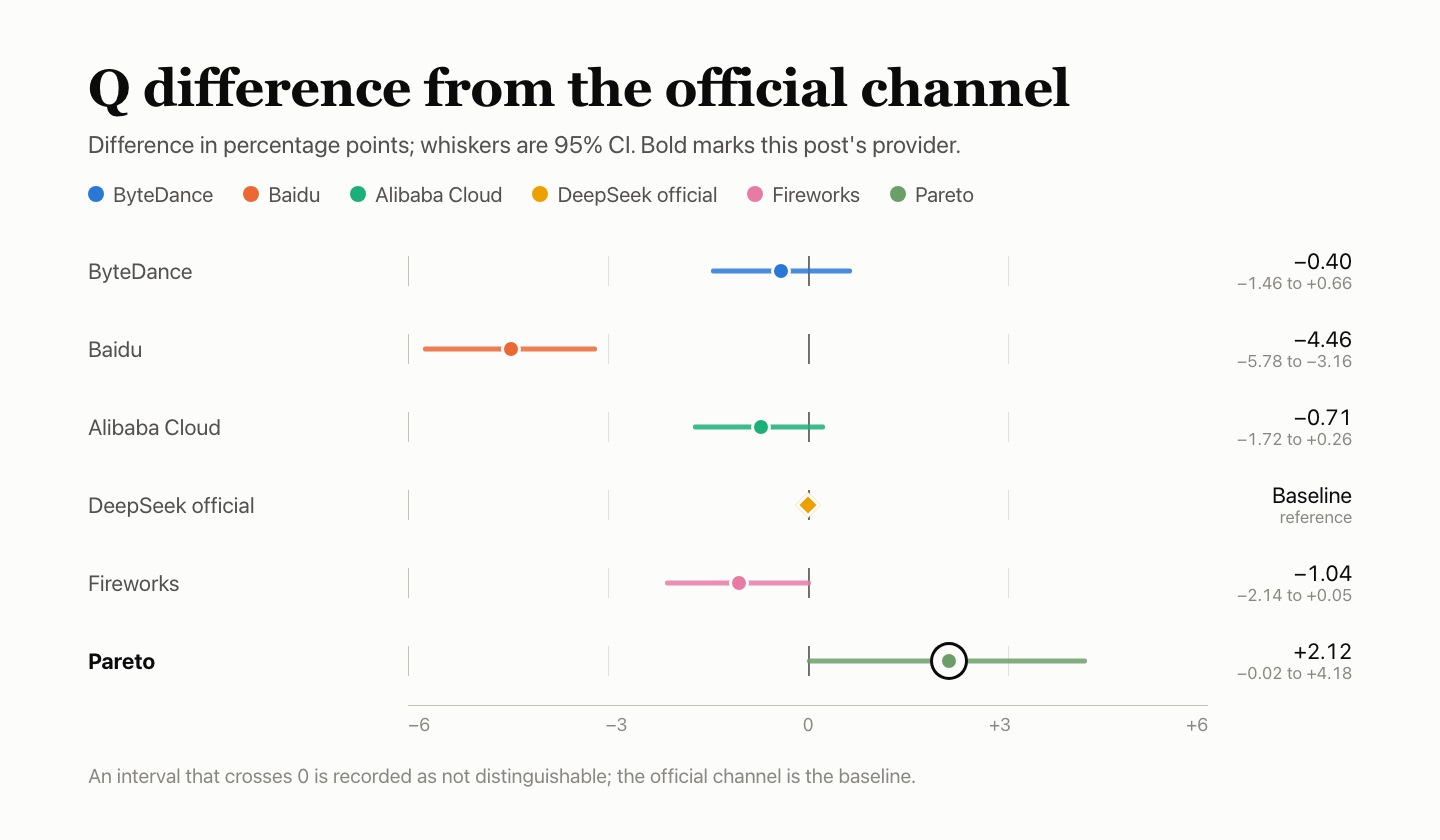
- Calidad de las respuestas: Q 44.58, con BFCL 85.27%, HLE 19.32% y AA-LCR 52.00%. La diferencia con el canal oficial es de +2.12 puntos porcentuales, con un intervalo del 95% de −0.02 a +4.18: no es distinguible.
- Compatibilidad con funciones: F 93.42, con 29/33 comprobaciones puntuadas originales superadas. Las llamadas a herramientas y el recorrido de ida y vuelta de los resultados de herramientas, las llamadas paralelas y con nombre, el modo JSON y el historial de conversación tienen registros adicionales satisfactorios en streaming; las puntuaciones conservan sus valores originales.
- Velocidad de respuesta: P 57.69. La mediana hasta el primer token del cuerpo fue de 5.85 s con concurrencia individual y de 6.13 s con concurrencia de 10, y el TPOT fue de 4.63 ms; 110 de las 180 solicitudes de velocidad fueron válidas.
- Caché: K 27.58. Las solicitudes en caliente de 8k tuvieron 2 aciertos de 9 y las de 32k, 3 de 9; ninguna solicitud de control en frío leyó de la caché.
- Estabilidad del servicio: R 100. Las 300 solicitudes específicas se completaron correctamente en el primer intento.
Configuración de la prueba
| Elemento | Detalle |
|---|---|
| Modelo | DeepSeek V4.1 Flash 1017 |
| ID del modelo solicitado | deepseek/deepseek-v4.1-flash |
| Nombre del modelo devuelto | deepseek/deepseek-v4.1-flash |
| Ruta de acceso | A través de AIHubMix con un ID de modelo específico del proveedor; no mediante una conexión directa a la cuenta del proveedor |
| Parámetros | Perfil de solicitud APB v2 fijo, temperatura 1.0, max_tokens 16,384, tiempo de espera de 300 s, sin reintentos automáticos |
| Periodo | 2026-11-03 18:07 – 11-04 16:33; solicitudes de caché: 11-05 19:31 – 11-06 10:35; todo en UTC+8. Los seis proveedores compartieron un Mac mini, una red y una cuenta. |
| Muestras | Q: 4,250 instancias de preguntas; F: 180 comprobaciones; P: 180 solicitudes; R: 300; K: 30 |
Las solicitudes utilizaron la ruta de inicio rápido de AIHubMix con un ID de modelo específico del proveedor; los ID de los demás proveedores figuran en la página de modelos. Los parámetros propios del modelo se describen en la documentación de la API de DeepSeek.
Q — calidad de las respuestas: 44.58
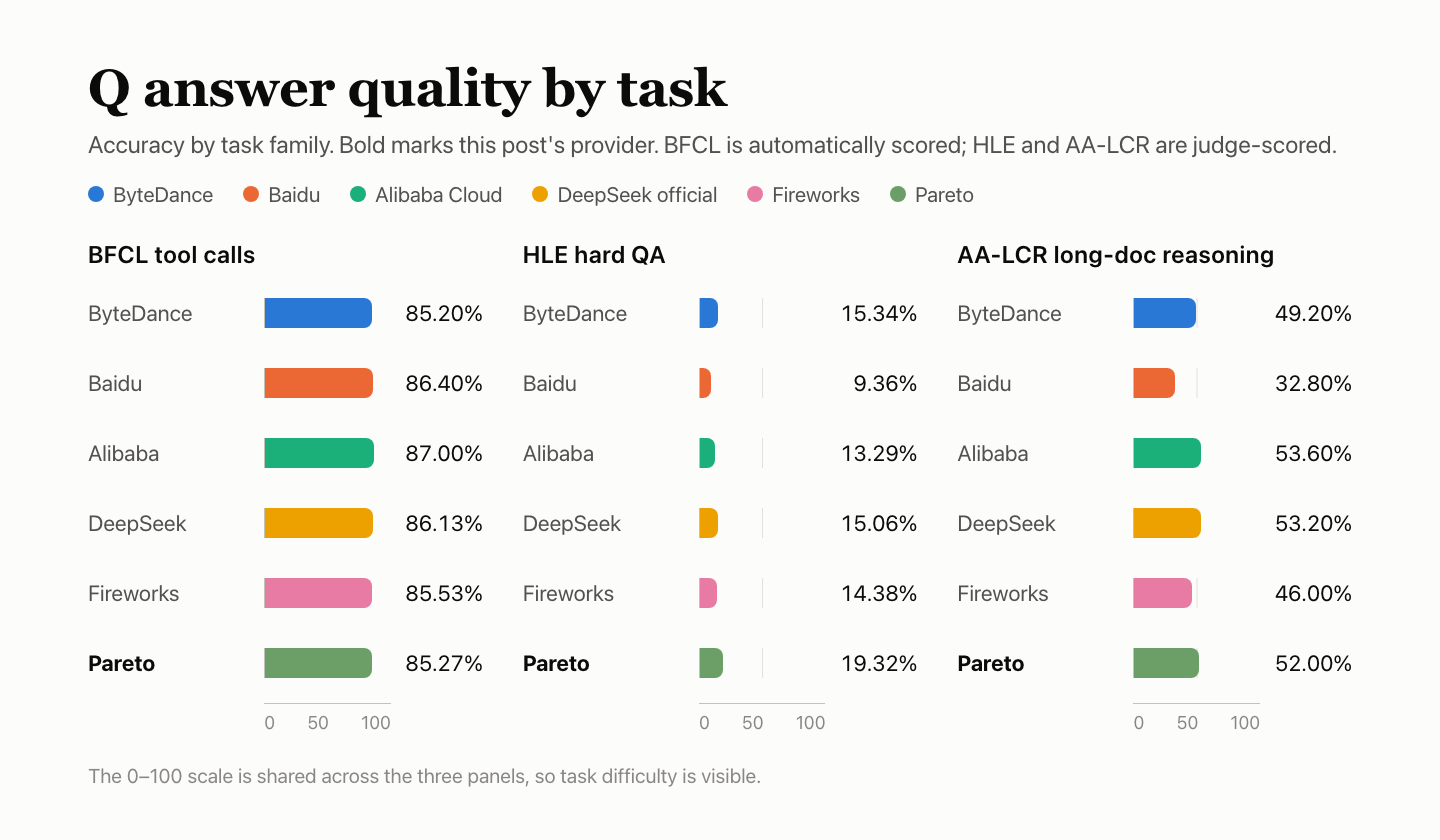
La calidad de las respuestas se evalúa con tres suites: 500 preguntas BFCL respondidas 3 veces cada una, 250 preguntas HLE respondidas 10 veces cada una y 25 preguntas AA-LCR respondidas 10 veces cada una. BFCL se puntúa mediante reglas automáticas; las respuestas de HLE y AA-LCR se juzgan como correctas o incorrectas con el modelo juez deepseek-flash. Los seis proveedores recibieron las mismas preguntas y los resultados de las tres suites se combinaron en una sola precisión. Se eliminaron diez respuestas porque no se podía puntuar la pregunta, de modo que quedaron 4,240 instancias de preguntas puntuadas.
| Suite | Preguntas × rondas | Correctas | Precisión | Fallos del servicio |
|---|---|---|---|---|
| Llamadas a herramientas BFCL, puntuación automática | 500 × 3 | 1,279/1,500 | 85.27% | 0 |
| Preguntas difíciles HLE, puntuación del juez | 250 × 10 | 481/2,490 | 19.32% | 0 |
| Razonamiento sobre documentos extensos AA-LCR, puntuación del juez | 25 × 10 | 130/250 | 52.00% | 0 |
| Total · intervalo del 95%: 41.57%–47.49% | — | 1,890/4,240 | 44.58% | 0 |
Todas las instancias de preguntas recibieron una respuesta completa; no hubo fallos del servicio.
| Categoría BFCL | Superadas | Tasa de aprobación |
|---|---|---|
| simple_python: una función, llamada y argumentos correctos | 333/360 | 92.50% |
| multiple: elegir la función correcta entre varias | 269/300 | 89.67% |
| parallel: llamar varias veces a una función a la vez | 265/300 | 88.33% |
| parallel_multiple: llamar a varias funciones a la vez | 203/240 | 84.58% |
| irrelevance: ninguna función pertinente, así que no se realiza ninguna llamada | 109/150 | 72.67% |
| ahm_multi_turn: cadena de herramientas en tres etapas | 100/150 | 66.67% |
Cada pregunta BFCL se respondió 3 veces; la tabla suma las 3 rondas.
Comparación con los otros cinco
| Proveedor | BFCL | HLE | AA-LCR | Combinada | Frente al oficial |
|---|---|---|---|---|---|
| ByteDance | 85.20% | 15.34% | 49.20% | 42.05% | −0.40 (−1.46 a +0.66), no distinguible |
| Baidu | 86.40% | 9.36% | 32.80% | 38.00% | −4.46 (−5.78 a −3.16), por debajo del oficial |
| Alibaba Cloud | 87.00% | 13.29% | 53.60% | 41.75% | −0.71 (−1.72 a +0.26), no distinguible |
| Canal oficial de DeepSeek | 86.13% | 15.06% | 53.20% | 42.45% | Referencia |
| Fireworks | 85.53% | 14.38% | 46.00% | 41.42% | −1.04 (−2.14 a +0.05), no distinguible |
| Pareto (esta publicación) | 85.27% | 19.32% | 52.00% | 44.58% | +2.12 (−0.02 a +4.18), no distinguible |
Frente al oficial: diferencia de precisión en puntos porcentuales, con el intervalo del 95% entre corchetes; si el intervalo cruza el 0, se registra como no distinguible. El modelo juez de HLE y AA-LCR, deepseek-flash, pertenece a la misma familia DeepSeek que el modelo evaluado y no se calibró, por lo que sus juicios podrían ser indulgentes.
F — compatibilidad con funciones: 93.42
Los casos de funciones comprueban si el comportamiento de la interfaz se ajusta al protocolo. F 93.42 se calcula a partir de las 33 comprobaciones contabilizadas (29 superadas), tras renormalizar los pesos de los grupos observados; las otras 147 comprobaciones previstas de la suite original se excluyeron de la puntuación.
| Grupo de casos | Peso | Observaciones superadas / de streaming | Excluidas | Puntuación del grupo |
|---|---|---|---|---|
| Streaming y protocolo de mensajes | 20% | 23/27 | 3 | 85.19 |
| Interfaz de herramientas Llamadas a herramientas, recorrido de ida y vuelta de resultados de herramientas, llamadas paralelas y con nombre | 20% | Se observaron pruebas de streaming superadas* | 30 | — |
| Restricciones de salida y parámetros Modo JSON y pensamiento desactivado | 20% | Se observaron pruebas de streaming superadas* | 30 | — |
| Contexto y estado Historial de conversación e instrucciones del sistema | 15% | Se observaron pruebas de streaming superadas* | 30 | — |
| Errores y recuperación | 15% | 3/3 | 27 | 100.00 |
| Protocolo de medición y caché | 10% | 3/3 | 27 | 100.00 |
| Total · puntuación ponderada | 29/33 | 147 | 93.42 | |
- Las funciones indicadas cuentan con registros satisfactorios en streaming; esto no otorga la puntuación máxima a todo el grupo. No se añadieron comprobaciones a la puntuación. F 93.42 y la puntuación general de 68.72 conservan sus valores originales.
| Caso fallido | Ventanas | Motivo |
|---|---|---|
| Secuencia de detención de streaming Streaming y protocolo de mensajes | 3/3 | Cuerpo vacío con una secuencia de detención; la misma entrada funcionó sin la secuencia de detención |
| Salida de texto exacta Streaming y protocolo de mensajes | 1/3 | Un punto adicional al final hizo que no coincidiera el texto exacto |
«Ventanas» indica cuántas de las 3 ventanas no superaron la comprobación.
Los casos de mensajes mal formados y opciones de streaming mal formadas devolvieron un 400 con el cuerpo de respuesta vacío en varios proveedores. La medición de tokens de razonamiento varió entre proveedores.
Comparación con los otros cinco
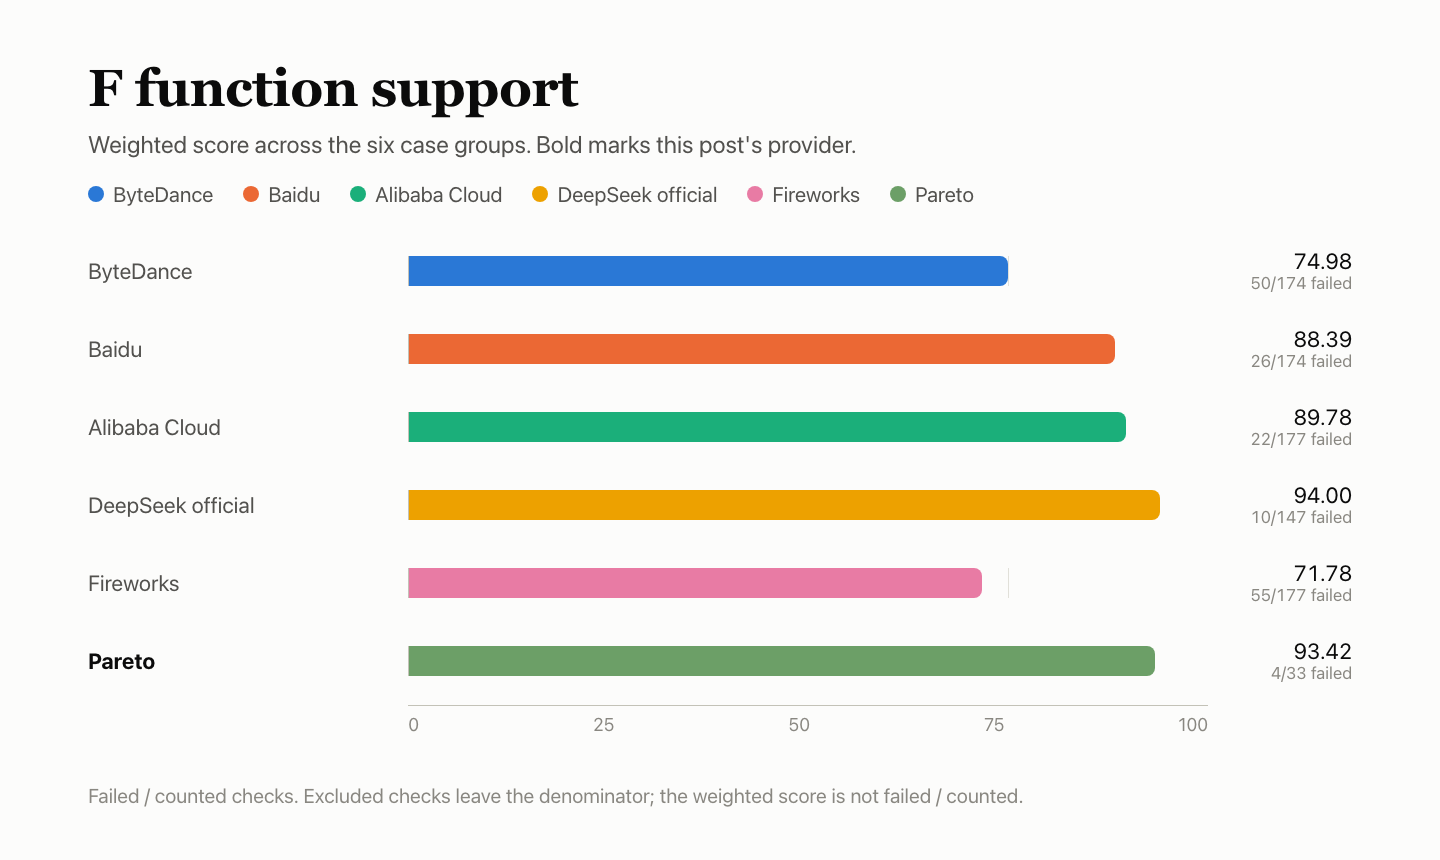
| Proveedor | Superadas | Fallidas | Excluidas | Puntuación ponderada |
|---|---|---|---|---|
| ByteDance | 124 | 50 | 6 | 74.98 |
| Baidu | 148 | 26 | 6 | 88.39 |
| Alibaba Cloud | 155 | 22 | 3 | 89.78 |
| Canal oficial de DeepSeek | 137 | 10 | 33 | 94.00 |
| Fireworks | 122 | 55 | 3 | 71.78 |
| Pareto (esta publicación) | 29 | 4 | 147 | 93.42 |
P — velocidad de respuesta: 57.69
Cada solicitud llevaba aproximadamente 10,000 tokens de entrada y pedía unos 1,100 tokens de texto en el cuerpo de salida. En cada una de las tres ventanas, se ejecutaron 30 solicitudes con concurrencia individual y 30 con concurrencia de 10: 180 solicitudes en total.
| Elemento | Detalle |
|---|---|
| Primer token del cuerpo (TTFA) | Mediana de 5.85 s con concurrencia individual (3.08 s solo entre las válidas) y 6.13 s con concurrencia de 10 (4.92 s solo entre las válidas) |
| Velocidad de generación (TPOT) | 4.42 ms/token con concurrencia individual, 4.63 ms/token con concurrencia de 10 |
| Rendimiento efectivo | 519.4 token/s con concurrencia de 10 |
| Solicitudes válidas | 53/90 con concurrencia individual (ventanas 1–3: 15/30, 18/30, 20/30), 57/90 con concurrencia de 10 (23/30, 16/30, 18/30); no válidas: 70 devolvieron 200 con None |
| Subpuntuaciones | TTFA 24.59, TPOT 100.00, rendimiento 72.05; TTFA y TPOT usan el nivel inferior, ponderados en un 35% / 35% / 30%: puntuación de respuesta 65.22 |
| Puntuación P | Puntuación de respuesta 65.22 × 80% + caché K 27.58 × 20% = 57.69 |
Las solicitudes no válidas se puntúan como infinitas, por lo que las medianas de la tabla pueden ser superiores a las medianas calculadas solo con solicitudes válidas. El TPOT se estima a partir de fragmentos transmitidos en streaming; no se mide por token en el hardware. El rendimiento se calcula dividiendo los tokens de salida válidos con concurrencia de 10 entre el tiempo de pared del lote.
Comparación con los otros cinco
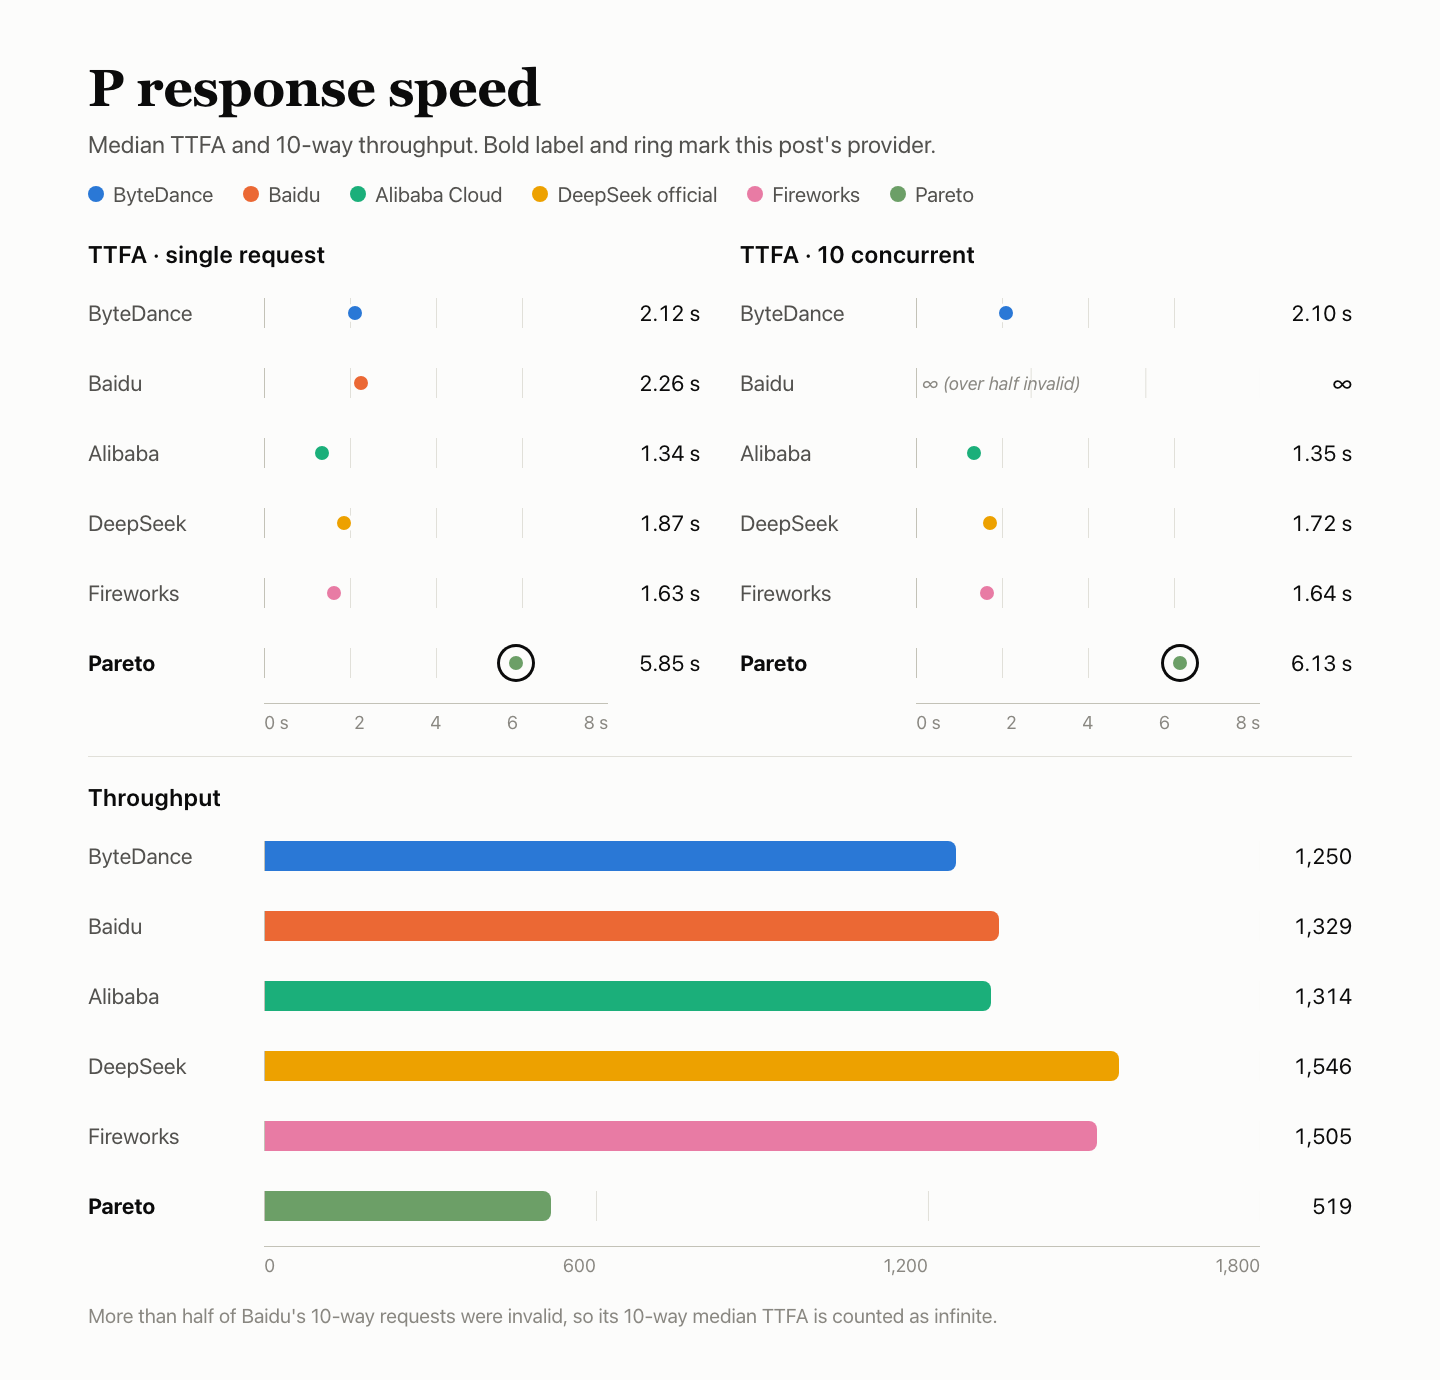
| Proveedor | Solicitudes válidas | TTFA con concurrencia individual | TTFA con concurrencia de 10 | TPOT (más lento) | Rendimiento tok/s | Respuesta |
|---|---|---|---|---|---|---|
| ByteDance | 180/180 | 2.12 s | 2.10 s | 3.43 ms | 1,250 | 82.00 |
| Baidu | 118/180 | 2.26 s | ∞ | 50.00 ms | 1,329 | 30.00 |
| Alibaba Cloud | 180/180 | 1.34 s | 1.35 s | 4.69 ms | 1,314 | 85.88 |
| Canal oficial de DeepSeek | 165/180 | 1.87 s | 1.72 s | 2.84 ms | 1,546 | 83.08 |
| Fireworks | 179/180 | 1.63 s | 1.64 s | 3.29 ms | 1,505 | 84.22 |
| Pareto (esta publicación) | 110/180 | 5.85 s | 6.13 s | 4.63 ms | 519 | 65.22 |
Los seis compartieron la misma máquina, red y cuenta. Las tres ventanas se programaron proveedor por proveedor, por lo que los periodos de recopilación no coinciden por completo; no conviene sobreinterpretar las pequeñas diferencias. ∞ significa que más de la mitad de las solicitudes no eran válidas, por lo que la mediana cuenta como infinita.
K — caché: 27.58
Cada grupo envía cinco solicitudes. La primera incluye un prefijo fijo de unos 8k o 32k tokens y llena la caché. Las solicitudes 2–4 conservan el prefijo y solo cambian la pregunta final, con intervalos de 5 s, 30 s y 120 s. La quinta usa un prefijo nuevo como control en frío. Tres ventanas × dos longitudes suman 30 solicitudes. K es la cantidad de tokens de caché leídos por las solicitudes en caliente dividida por los tokens que deberían poder reutilizarse según las reglas, con ambas longitudes ponderadas por igual; K representa el 20% de P.
| Ventana | 1 · inicial | 2 · +5 s | 3 · +30 s | 4 · +120 s | 5 · en frío |
|---|---|---|---|---|---|
| Prefijo de 8k · aciertos en caliente 2/9 · se leyeron 15,872 de 72,504 reutilizables · 21.89 | — | — | — | — | — |
| Ventana 1 | 0 | 0 | 7,936 | 0 | 0 |
| Ventana 2 | 0 | 0 | 0 | 0 | 0 |
| Ventana 3 | 0 | 0 | 7,936 | 0 | 0 |
| Prefijo de 32k · aciertos en caliente 3/9 · se leyeron 96,000 de 288,513 reutilizables · 33.27 | — | — | — | — | — |
| Ventana 1 | 0 | 0 | 32,000 | 0 | 0 |
| Ventana 2 | 0 | 0 | 0 | 0 | 0 |
| Ventana 3 | 0 | 0 | 0 | 32,000 | 0 |
| K (8k y 32k ponderados por igual) | — | — | — | — | 27.58 |
Los valores son tokens leídos de la caché según informa el servidor; «No devuelto» significa que el campo no estaba presente en la respuesta.
Las solicitudes en caliente de 8k acertaron 2 de 9, y cada acierto leyó 7,936 tokens; las solicitudes en caliente de 32k acertaron 3 de 9, y cada acierto leyó 32,000 tokens. Las solicitudes en frío no leyeron nada de la caché, por lo que las solicitudes en caliente y en frío quedan claramente diferenciadas.
Comparación con los otros cinco
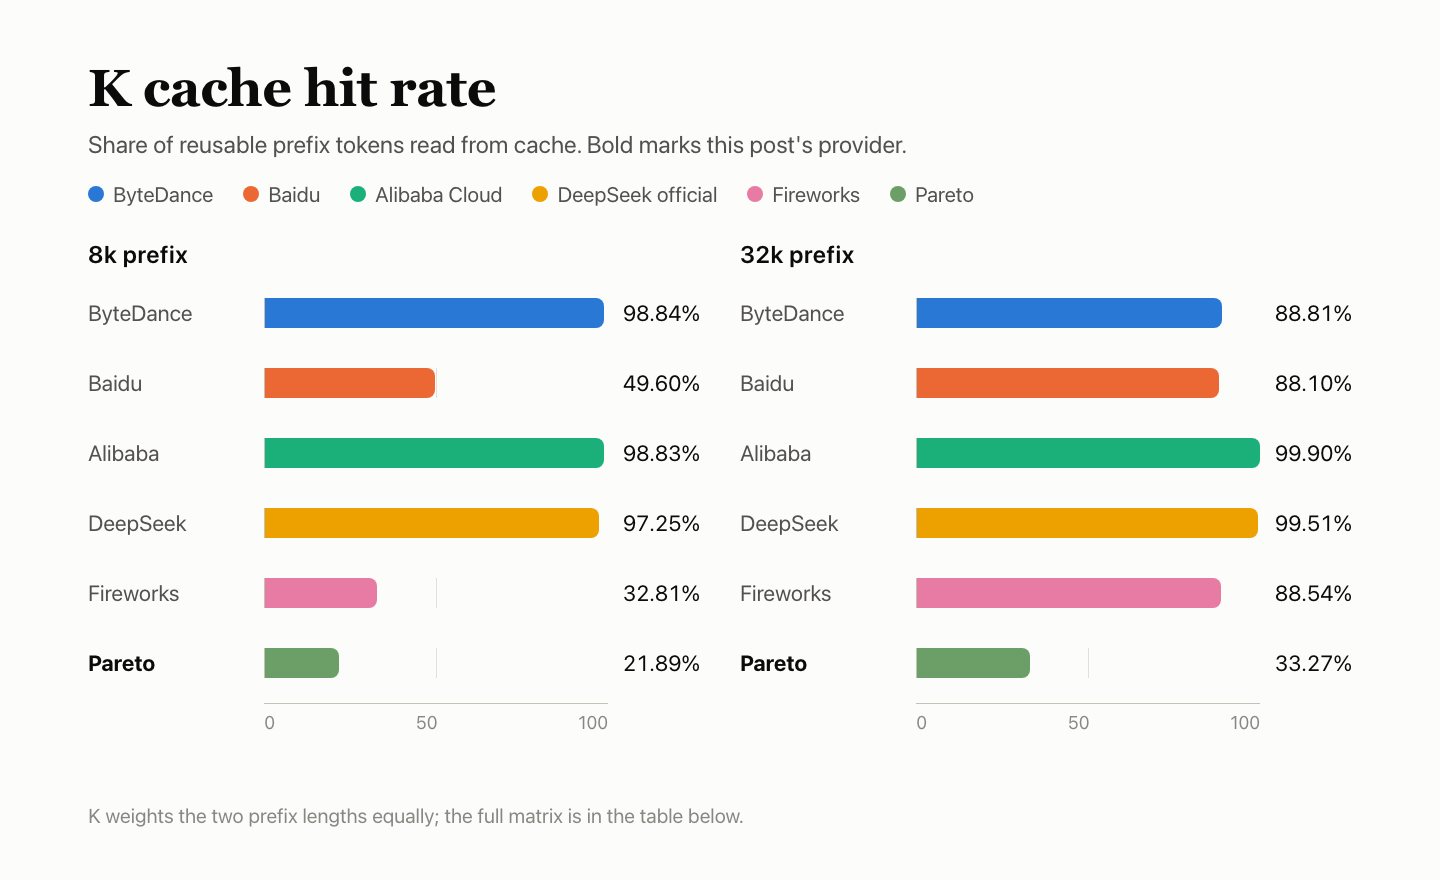
| Proveedor | Aciertos de 8k | 8k | Aciertos de 32k | 32k | K |
|---|---|---|---|---|---|
| ByteDance | 9/9 | 98.84 | 8/9 | 88.81 | 93.83 |
| Baidu | 5/9 | 49.60 | 8/9 | 88.10 | 68.85 |
| Alibaba Cloud | 9/9 | 98.83 | 9/9 | 99.90 | 99.37 |
| Canal oficial de DeepSeek | 9/9 | 97.25 | 9/9 | 99.51 | 98.38 |
| Fireworks | 3/9 | 32.81 | 8/9 | 88.54 | 60.68 |
| Pareto (esta publicación) | 2/9 | 21.89 | 3/9 | 33.27 | 27.58 |
R — estabilidad del servicio: 100
Las 300 solicitudes se dividen en cuatro tipos: texto breve, entrada larga, llamadas a herramientas e historial de varios turnos. Se ejecutaron con concurrencia de uno en tres ventanas. Solo se comprueba si el primer intento devolvió una respuesta válida y completa; las respuestas no se evalúan ni se vuelve a intentar. Los errores de las secciones sobre calidad de las respuestas y velocidad se contabilizan en Q y P, no de nuevo en R.
| Tipo de solicitud | Éxito al primer intento |
|---|---|
| Texto breve | 120/120 |
| Entrada larga de 10k | 90/90 |
| Llamadas a herramientas | 60/60 |
| Historial de varios turnos | 30/30 |
| Total · intervalo del 95%: 98.78%–100% | 300/300 |
Las 300 solicitudes devolvieron una respuesta válida y completa al primer intento. R = 100 describe únicamente estas 300 solicitudes específicas; no significa que toda la cadena estuviera libre de errores. El límite inferior del intervalo del 95% es 98.78%: 300 éxitos de 300 solo permiten afirmar que es probable que la tasa de errores sea inferior al 1.22%.
Comparación con los otros cinco
| Proveedor | Éxito al primer intento | Intervalo del 95% |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| Canal oficial de DeepSeek | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
| Pareto (esta publicación) | 300/300 | 98.78%–100% |
R abarca únicamente estas 300 solicitudes específicas; los errores de las secciones sobre calidad de las respuestas y velocidad se registran en Q y P, y no se vuelven a contabilizar en R.
Preguntas frecuentes
¿Por qué F es 93.42 si solo se contabilizaron 33 comprobaciones?
Las comprobaciones contabilizadas originalmente dieron 29 de 33, lo que produjo F 93.42 tras renormalizar las ponderaciones observadas de los grupos; los otros 147 casos de comprobación previstos se excluyeron de la puntuación. Los registros de streaming describen funciones concretas que funcionan y no añaden comprobaciones puntuadas. La puntuación general mostrada sigue siendo 68.72.
¿Por qué P es 57.69 si TPOT obtuvo 100.00?
Solo 110 de las 180 solicitudes de velocidad eran válidas; 70 devolvieron 200 con None. Las solicitudes no válidas cuentan como infinitas, por lo que la mediana del tiempo hasta el primer token del cuerpo es de 5.85 s con concurrencia de uno y de 6.13 s con concurrencia de 10 (3.08 s y 4.92 s solo para las válidas). TTFA obtuvo 24.59 y el rendimiento, 72.05, para una puntuación de respuesta de 65.22; con K de caché en 27.58 y un peso del 20%, P es 57.69.
¿Por qué K es solo 27.58?
Las solicitudes en caliente acertaron 2 de 9 con 8k (21.89) y 3 de 9 con 32k (33.27), y ambas longitudes tienen el mismo peso. Cuando hubo un acierto, se leyeron 7,936 o 32,000 tokens, y ningún control en frío leyó la caché.
¿La calidad de las respuestas de Pareto es superior a la del canal oficial?
No se puede distinguir. La precisión combinada es del 44.58% frente al 42.45%, una diferencia de +2.12 puntos, pero el intervalo del 95% va de −0.02 a +4.18 y abarca el 0. El evaluador de HLE y AA-LCR, deepseek-flash, no se calibró y podría ser demasiado indulgente.
¿Qué casos de F fallaron?
Dos. La secuencia de parada de streaming devolvió un cuerpo vacío en las tres ventanas, mientras que la misma entrada sin parada funcionó. La salida de texto exacto tuvo un punto final adicional en una de las tres ventanas.
Sigue leyendo: la serie DeepSeek V4.1 Flash
- La diferencia de Q de Pareto, de +2.12, se mide respecto al canal oficial; la ejecución de referencia está en Reseña de DeepSeek V4.1 Flash del canal oficial de DeepSeek: referencia de comparación, 15 solicitudes no válidas con concurrencia de uno.
- Fireworks también devolvió cuerpos vacíos en las solicitudes de parada y acertó 3 de 9 con 8k: Reseña de DeepSeek V4.1 Flash de Fireworks: las solicitudes de parada devuelven un cuerpo vacío, aciertos en caliente de caché de 8k en 3 de 9 solicitudes.
- Las solicitudes en caliente de Alibaba Cloud acertaron 18 de 18, frente a las 5 de 18 de Pareto: Reseña de DeepSeek V4.1 Flash de Alibaba Cloud: 1.34s hasta el primer token del cuerpo, las 18 solicitudes en caliente acertaron la caché, respuestas indistinguibles de las oficiales.
- Todas las solicitudes de velocidad de ByteDance eran válidas, con 2.12 s hasta el primer token del cuerpo: Reseña de DeepSeek V4.1 Flash de ByteDance: respuestas indistinguibles de las oficiales, los recuentos de entrada no coinciden.
- Baidu también perdió muchas solicitudes de velocidad por no_available_channel: Reseña de DeepSeek V4.1 Flash de Baidu: uso de herramientas a la par del canal oficial, los frecuentes no_available_channel reducen la calidad de las respuestas y la velocidad.
Fuentes
- Página del modelo DeepSeek V4.1 Flash 1017 (AIHubMix)
- Estándar de benchmark de proveedores de AIHubMix v2.0 (documentación de AIHubMix)
- Guía de inicio rápido (documentación de AIHubMix)
- Modelos (AIHubMix)
- Documentación de la API de DeepSeek (DeepSeek)


