

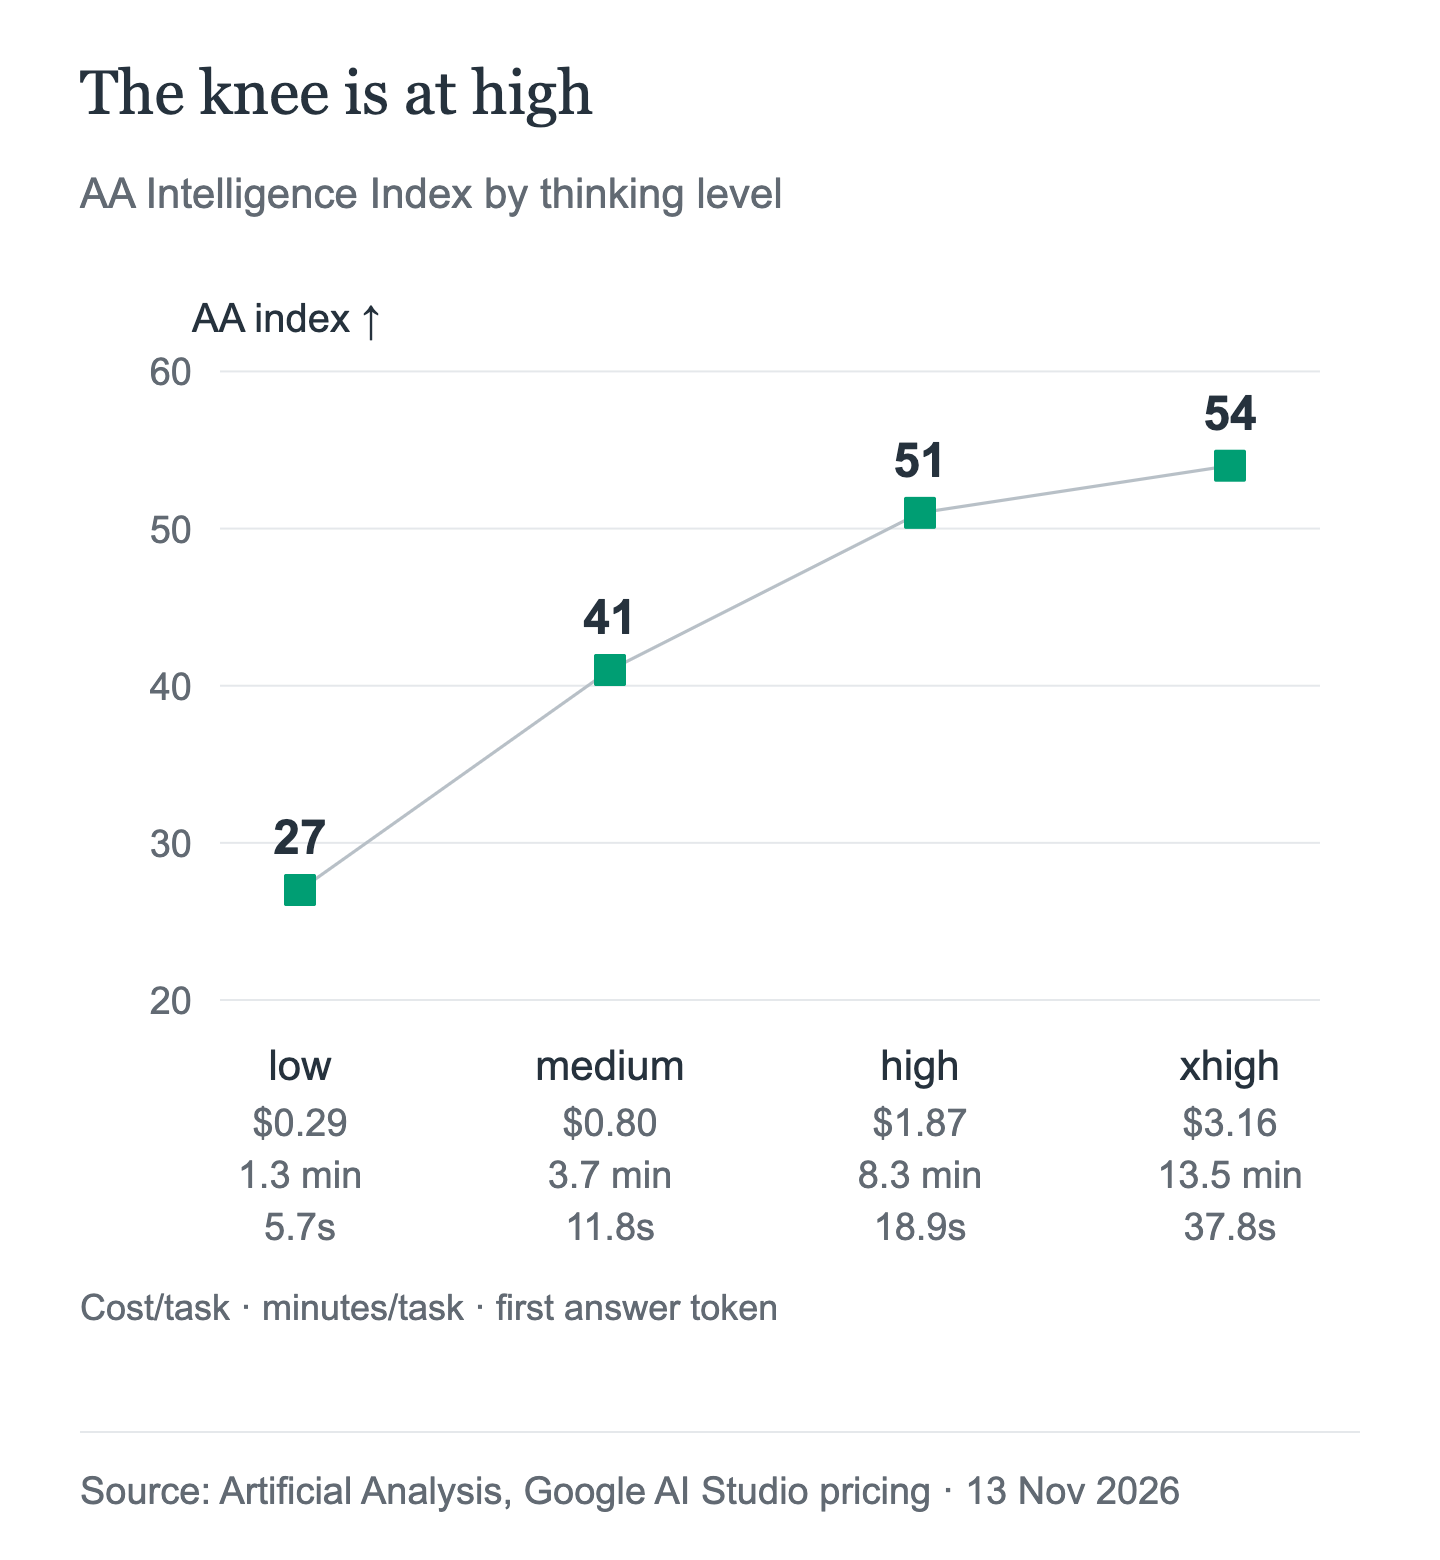
Gemini 4 Hydrogen має чотири рівні мислення, і працюють вони так, ніби це чотири різні моделі. За поточними вимірюваннями Artificial Analysis, та сама модель набирає 27 балів на low, 41 — на medium, 51 — на high і 54 — на xhigh. Рівень за замовчуванням — high, а xhigh — новинка в сімействі Gemini 4: Carbon і Argon обмежуються рівнем high.
Різниця значна: одна й та сама модель охоплює діапазон у 27 пунктів індексу від low до xhigh. Перехід від medium до high дає 10 пунктів індексу приблизно за $1.07 додатково за завдання. Перехід від high до xhigh дає 3 пункти за $1.29 і майже вдвічі збільшує очікування до першого токена відповіді. Практична порада: починайте з high, залиште xhigh для складних багатокрокових завдань, а low і medium сприймайте як налаштування затримки, які потребують окремої перевірки якості.
Нижче розглянемо, для чого призначений кожен рівень, скільки він коштує, що змінюється в API та що AIHubMix документує, а що ні.
Чотири рівні та зміни
Gemini 4 Hydrogen підтримує low, medium, high і xhigh. У примітках до випуску Google сказано прямо: «За замовчуванням модель працює на рівні high, а також з’явився рівень xhigh». Це дві зміни порівняно з Gemini 3.8 Flash, у якого за замовчуванням встановлено medium, а найвищий рівень — high.
Інші моделі сімейства не змінилися. Carbon і Argon підтримують low, medium і high, причому за замовчуванням встановлено medium. Hydrogen — єдина модель Gemini 4 із налаштуванням вище за high.
| Модель | Рівні | За замовчуванням |
|---|---|---|
| Gemini 4 Hydrogen | low, medium, high, xhigh | high |
| Gemini 4 Carbon | low, medium, high | medium |
| Gemini 4 Argon | low, medium, high | medium |
MINIMAL не входить до переліку. У документації Gemini 4 щодо мислення зазначено, що MINIMAL «не підтримується моделями Gemini 4», а в примітках до випуску Hydrogen Google повідомляє, що модель «відхиляє minimal з помилкою». Для цієї моделі не задокументовано вимкнення мислення.
Що рекомендує Google
Рекомендації Google — цілком слушна відправна точка, але їх опубліковано до наведених нижче вимірювань. Зокрема, рекомендація використовувати medium для інтерактивного програмування передбачає рівень якості, якого Artificial Analysis на medium не виявляє.
| Рівень | Опис Google і рекомендоване застосування |
|---|---|
| low | «Найменше токенів, найнижча затримка» — швидкі чати, великі обсяги |
| medium | «Менше токенів, швидші відповіді» — інтерактивне програмування, прототипи інтерфейсів |
| high | «Баланс між інтелектом і швидкістю» — за замовчуванням для більшості завдань |
| xhigh | «Найбільше токенів, найглибше міркування» — складне багатокрокове програмування |
До таблиці додаються два застереження. «Використання xhigh збільшує затримку та кількість токенів і може призвести до надмірних роздумів над простішими промптами», — зазначає Google. Також чітко сформульовано рекомендацію щодо оцінювання: «Проведіть оцінювання на всіх чотирьох рівнях із великим значенням max_output_tokens».
Виміряна драбина рівнів
Artificial Analysis виміряла всі чотири рівні. У вимірюванні використано Intelligence Index v5.0.1; 78 моделей у рейтингу; дані отримано 2026-11-13T02:40Z; ціни — стандартні роздрібні. Це вартість завдань за методикою AA, а не рахунки AIHubMix.
| Рівень | Місце в рейтингу AA | Індекс AA | $/завдання | Хвилин/завдання | Перший токен відповіді |
|---|---|---|---|---|---|
| low | 60 | 27 | 0.29 | 1.3 | 5.71 s |
| medium | 39 | 41 | 0.80 | 3.7 | 11.80 s |
| high | 21 | 51 | 1.87 | 8.3 | 18.89 s |
| xhigh | 16 | 54 | 3.16 | 13.5 | 37.77 s |
Найважливіше — розмір кроків:
low→medium: +14 пунктів індексу, +$0.51 за завдання, +2.4 хвилини, +6.1 секунди до першого токена.medium→high: +10 пунктів індексу, +$1.07 за завдання, +4.6 хвилини, +7.1 секунди до першого токена.high→xhigh: +3 пункти індексу, +$1.29 за завдання, +5.2 хвилини, +18.9 секунди до першого токена.
high — переломний рівень. Це останній крок, на якому приріст якості значний порівняно з додатковими витратами; перехід на xhigh майже вдвічі збільшує очікування на перший токен за невеликого приросту індексу. Це не означає, що xhigh — погане налаштування. Воно потрібне для завдань, із якими не справляється high, — саме так його описує Google.
Для порівняння: у тому самому знімку Carbon high набирає 60 балів за $5.48 за завдання та 28.1 хвилини, Carbon medium — 58 за $4.68, Carbon low — 54 за $5.22, а Argon high — 50 за $4.97 і 30.6 хвилини. Hydrogen на xhigh набирає стільки ж, як Carbon low, — 54 бали, але вартість завдання на 39.5% нижча ($3.16 проти $5.22), хоча перший токен надходить за 37.77 секунди проти 13.61. Hydrogen на high випереджає Argon high на один пункт індексу за вартості завдання на 62.4% нижчої.
Де драбина дає збій
low — це не просто незначне погіршення. Із результатом 27 цей рівень відстає від high на 24 пункти індексу. Якщо перейти з high на low, щоб заощаджувати $1.58 за завдання, ви не отримаєте той самий продукт із меншим обсягом мислення — ви отримаєте значно слабшу модель. Для класифікації, маршрутизації чи короткого вилучення даних це може бути прийнятно. Для програмування чи роботи з агентами — ні, якщо попередньо не провести оцінювання на конкретних завданнях.
medium — це налаштування затримки, а не якості. Воно набирає 41 бал, на 10 менше за high, а коштує $0.80 проти $1.87. Економія відчутна — 57% на завдання, — але розрив у якості більший, ніж можна припустити за різницею в ціні. Google рекомендує medium для інтерактивного програмування; оцінка AA підказує перевірити цю рекомендацію на власних завданнях, перш ніж запроваджувати її.
xhigh може надмірно заглиблюватися в роздуми. Google прямо про це попереджає. Показники вартості й часу від AA демонструють наслідки: $3.16 за завдання, 13.5 хвилини та 37.77 секунди очікування на перший токен. Для простого промпту це чимала затримка за незначний приріст. Для складного багатокрокового завдання з програмування, із яким не справляється high, це єдиний рівень, що йде далі.
Багатослівність теж впливає на рахунок. Artificial Analysis описує Hydrogen як «дуже багатослівну» модель: під час запуску на xhigh для обчислення індексу було згенеровано 304 мільйони вихідних токенів — 76-те місце з 77, тоді як медіана становила 72.8 мільйона. До вихідних токенів належать і токени мислення, а за вихідні токени стягується $7.50 за мільйон. Вищий рівень не просто змушує модель довше міркувати — він генерує більше токенів, за які виставляється рахунок.
Вартість: як мислення перетворюється на токени
Тарифна сітка проста. Hydrogen коштує $1.50 за мільйон вхідних токенів, $7.50 за мільйон вихідних токенів і $0.075 за мільйон вхідних токенів із кешу. До вихідних токенів належать токени мислення. Саме тому рівень важливіший за тариф: оплата нараховується за згенеровані моделлю токени міркування, а не за назву рівня.
Легко не помітити три правила оплати.
Змінився рівень за замовчуванням. У Gemini 3.8 Flash за замовчуванням використовувався medium, а Hydrogen працює на high. Після міграції обсяг вихідних токенів за кожен хід зросте, якщо робочий процес не задавав рівень вручну, навіть якщо ціна за токен залишиться незмінною. Це зміна бюджету, замаскована під заміну моделі.
Кешування підтримується лише в неявному режимі. Hydrogen підтримує неявне кешування з мінімумом у 4,096 токенів і знижкою 95% за влучення в кеш; явне кешування не підтримується. На корпоративній сторінці Google також зазначено: «За замовчуванням за запис у кеш стягується плата, що дорівнює 1.25x стандартної ціни вхідних токенів». Це формулювання щодо тарифікації Google; правила тарифікації кешу в AIHubMix для цієї моделі не задокументовано.
Для довгого виводу діє обмеження на один етап. Синхронний запит генерує до 65,536 токенів за один етап — із потоковою передачею чи без неї. Для довшого виводу потрібне фонове виконання або продовження через токени, а max_output_tokens обмежує сумарну кількість токенів мислення та виводу. Якщо задати background=true, не вказавши max_output_tokens, сервер зупиниться після 65,536 токенів. Google рекомендує для довгого декодування встановлювати ліміти 131,072 або 262,144, а максимум — 1,048,576 мінус довжина вхідних даних.
Що приймає API, а що відхиляє
Параметр називається thinking_level (snake_case). У прикладі для Python від Google його вказано всередині thinking_config; у прикладі для Node він міститься в thinkingConfig (camelCase). На сторінці моделі наведено значення LOW, MEDIUM, HIGH і XHIGH; у примітках до випуску вони написані малими літерами. Використовуйте enum вашого SDK або задокументований рядок, а не вводьте вручну варіант із довільним регістром.
Три варіанти запиту завершуються помилкою:
thinking_budgetдля будь-якої моделі Gemini 4 повертає400: INVALID_ARGUMENT. Одночасне встановленняthinking_levelіthinking_budgetтакож спричиняє помилку.thinking_level="MINIMAL"не підтримується; Hydrogen його відхиляє.- Власні значення
temperature,top_pіtop_kігноруються. Фіксовані значення за замовчуванням: temperature 1.0, topP 0.95 і topK 64.
На платформі Google Hydrogen також підтримує виклик функцій, виконання коду, контекст URL і використання комп’ютера. В API Interactions використовуйте previous_interaction_id для багатокрокових сеансів і сеансів із викликами інструментів.
Що документує AIHubMix, а що ні
Задокументований AIHubMix маршрут для Hydrogen — POST https://aihubmix.com/v1/chat/completions із model="gemini-4-hydrogen". На сторінці моделі зазначено, що вона приймає текст, зображення, аудіо, відео й PDF, а виводить текст; у llms.txt досі є застарілий рядок про підтримку лише тексту, тож орієнтуйтеся на новішу сторінку. Можливості використання інструментів, структурованого виводу та міркування позначені як «не опубліковані». Моделі немає в індексі моделей, створеному 2026-11-11, а схему протоколу не опубліковано.
Для цієї статті це важливо, адже AIHubMix не документує спосіб встановлення рівня мислення для жодної моделі Gemini 4. У посібнику з Gemini розглядається reasoning_effort для моделей епохи Gemini 2.5, але не thinking_level чи xhigh для Gemini 4. Не припускайте, що будь-який із цих параметрів проходить через шлюз, і не вважайте, що рівень за замовчуванням, який спостерігається в API Google, буде таким самим в AIHubMix.
Безпечний формат запиту — той, який документує AIHubMix:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "List the failure modes in this retry design."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
Якщо керування рівнем є обов’язковою вимогою, зверніться безпосередньо до API Google або перевірте роботу шлюзу невеликим запитом, перш ніж спрямовувати через нього виробничий трафік. Сторінка порівняння AIHubMix допоможе оцінити витрати, поки ви ухвалюєте рішення. Для цієї статті тестування в реальному часі не проводилося.
З чого почати залежно від робочого навантаження
| Робоче навантаження | З чого почати й чому |
|---|---|
| Швидкий чат, маршрутизація, класифікація | medium; спробуйте low; показник low — 27 |
| Інтерактивне програмування, прототипування інтерфейсів | high; у AA показник medium — 41 |
| Виконання агентом, цикли викликів інструментів | high; xhigh — лише якщо застрягли |
| Складне налагодження, архітектура, планування | xhigh або Carbon; на 3 пункти більше за додаткові 69% вартості |
| Високооб’ємна пакетна обробка після оцінювання | low або medium; найдешевші, але індекси — 27/41 |
| Суворий ліміт затримки — до 15 секунд | medium або low; high очікує 18.89 с |
Це відправні точки, а не правила маршрутизації. Правильний рівень — найнижчий із тих, що проходить ваше оцінювання; Google радить проводити його на всіх чотирьох рівнях.
Поширені запитання
Які рівні мислення має Gemini 4 Hydrogen?
Чотири: low, medium, high і xhigh. За замовчуванням використовується high.
Що змінилося порівняно з Gemini 3.8 Flash?
Рівень за замовчуванням змінився з medium на high, а над high додали xhigh. Carbon і Argon, як і раніше, за замовчуванням використовують medium, а їхній найвищий рівень — high.
Чи вартий xhigh своїх витрат?
Так, для складних багатокрокових завдань, з якими не справляється high: він додає 3 пункти до індексу. Водночас кожне завдання коштує на 69% більше, ніж із high, а очікування першого токена майже подвоюється, тож для простих промптів це невдалий рівень за замовчуванням.
Чому low настільки відстає?
За оцінкою Artificial Analysis, його показник в індексі — 27, що на 24 пункти нижче за high. Ціна становить $0.29 за завдання проти $1.87, але розрив у якості значно більший за різницю в ціні. Використовуйте цей рівень лише тоді, коли оцінювання конкретного завдання підтверджує, що його достатньо.
Чи підтримує AIHubMix thinking_level або xhigh?
Згідно з документацією — ні. AIHubMix не публікує для Hydrogen прапорець підтримки міркувань і не має посібника щодо рівнів мислення Gemini 4. Перевірте це, перш ніж покладатися на будь-яку з цих можливостей.
Що станеться, якщо надіслати thinking_budget?
Gemini 4 поверне 400: INVALID_ARGUMENT. Якщо задати і thinking_budget, і thinking_level, також буде повернуто помилку.
Чи можна вимкнути мислення?
Документованого перемикача вимкнення немає. Gemini 4 не підтримує MINIMAL, і Hydrogen повертає помилку, якщо його задати.
Читайте далі: серія про Gemini 4 Hydrogen
- Якщо ви ще вирішуєте, чи варто переходити на Hydrogen із Gemini 3.8 Flash, у першій статті розглянуто запуск, зміну ціни та компроміси за результатами бенчмарків: Gemini 4 Hydrogen проти Gemini 3.8 Flash: чи варто оновлюватися?.
- Якщо вас цікавить, як Hydrogen порівнюється з Carbon і Argon для однакового завдання, у третій статті наведено порівняння всіх трьох моделей із цінами, затримкою та таблицею робочих навантажень: Gemini 4 Carbon проти Hydrogen проти Argon: яка модель для якого завдання?.
Джерела
- Google AI Studio, Gemini 4 Hydrogen: що нового
- Google, мислення Gemini 4
- Google, сторінка моделі Gemini 4 Hydrogen
- Google AI Studio, ціни Gemini API
- Artificial Analysis, Gemini 4 Hydrogen — актуальний знімок станом на 2026-11-13T02:40Z, Intelligence Index v5.0.1


