Gemini 4 Carbon можна без додаткових змін підставити замість Gemini 4 Argon на рівні схеми запиту. Тіло запиту для Chat Completions працює так само: змінюється ідентифікатор моделі, а деякі значення параметрів не підтримуються. Критичні збої виникають рівнем нижче: помилки параметрів із відповіддю 400, непомітне обрізання виводу, а також тайм-аут і модель оплати, розраховані на тривале обдумування.
У перший тиждень усе визначають чотири налаштування за замовчуванням:
- Встановіть для
max_tokensзначення не вище 65,536 на AIHubMix: шлюз документує лише Chat Completions і не публікує шлях із більшим обсягом виводу. - Для фонових запусків через нативний Google Interactions встановіть
store=trueі явно задайтеmax_output_tokens; ці поля не задокументовані для Carbon на AIHubMix. - Під час використання нативного шляху постачальника для тривалого декодування встановіть HTTP-тайм-аут читання на 15–20 хвилин для кожного потоку.
- Приберіть
temperature,top_pіtop_k, які ігноруються, а також штрафи й значенняcandidate_countпонад 1, які в посібнику Google для Carbon призводять до відповіді 400.
Незмінні основи — доступ, відмови з міркувань безпеки й вартість завдання — описані в дописі про міграцію з Argon. У цьому дописі йдеться про особливості Carbon.
Що дає явну помилку, а що — непомітний збій
Збої чітко поділяються на два типи: відповідь 400 повідомляє про проблему одразу, а непомітне обмеження дається взнаки лише в рахунку.
| Що ви бачите | Тип | Перша дія |
|---|---|---|
| HTTP 400 для параметра | Явна помилка | Приберіть непідтримуване поле |
| 400 для фонового запиту | Явна помилка | Додайте store=true |
| Відповідь обривається на 65,536 токенах | Непомітний збій | Збільште max_tokens, але не вище 65,536 |
| Порожній текст, статус incomplete | Непомітний збій | Збільште ліміт і повторіть запит |
| Фоновий запуск завершується приблизно на 64K | Непомітний збій | Задайте max_output_tokens |
| Відповідь здається поверховішою | Непомітний збій | Явно задайте рівень обдумування |
| Рахунок перевищує оцінку | Непомітний збій | Враховуйте обдумування та кроки декодування |
На AIHubMix для gemini-4-carbon вказано ціни $2 за вхідні, $10 за вихідні та $0.10 за кешовані токени на мільйон — це початкові тарифи Google — через Chat Completions. Вони тимчасові; див. розділ про оплату.
Явні помилки: задокументовані відповіді 400
Багато задокументованих відповідей 400 пов’язані з перевіркою параметрів; помилки історії та попередньо заповнених ходів моделі виникають через стан запиту. Наведені нижче правила взято з нативного посібника Google для Carbon, якщо не зазначено інше; наразі AIHubMix документує для Carbon лише Chat Completions. В описі Carbon на AIHubMix цей клас помилок сформульовано одним рядком: «400 — помилка параметра; більшість таких помилок надходить від провайдера вище за ланцюжком». Це опис шлюзу, а не результат тестування. Деталі наведено в посібнику Google для Carbon та на сторінці оновлень.
| Причина | Що ви бачите | Виправлення |
|---|---|---|
| max_output_tokens > 1M* | 400; перевищено ліміт | Нативно — ≤1M; шлюз — ≤65K* |
| frequency/presence penalty | 400; не підтримується | Приберіть поля |
| candidate_count > 1 | 400; кілька варіантів | Не передавайте параметр або задайте значення 1 |
| фоновий режим без store* | 400; потрібен store* | Додайте store=true |
| Історія завершується ходом моделі | Відхилено; не підтримується | Завершуйте ходом користувача |
| обидва параметри керування | 400; не можна поєднувати | Передавайте лише один |
| thinking_budget або MINIMAL | 400; посібник Carbon | Використовуйте low/medium/high |
Google наводить повідомлення дослівно: «store=true is required for background interactions.» * Лише для нативного Google: max_output_tokens обмежено значенням 1M, а для фонового режиму потрібен store=true; AIHubMix не документує цей шлях. Для Chat Completions на AIHubMix використовуйте значення ≤65K.
Рядок minimal має два значення. У нативних полях Carbon від Google значення thinking_budget і thinking_level=MINIMAL призводять до HTTP 400; використовуйте low, medium або high. У шарі сумісності Google з OpenAI параметр reasoning_effort=minimal відповідає low; AIHubMix не повідомляє, чи застосовує це зіставлення для Carbon.
Робота з інструментами — ще одна пов’язана пастка. У посібнику Google для Carbon рекомендується надавати перевагу послідовним ходам виконання інструментів, а в посібнику AIHubMix з Gemini задокументовано tool_choice="auto"; підтримку інструментів Carbon на шлюзі не підтверджено.
Найпростіший безпечний запит до /v1/chat/completions не містить параметрів, які Carbon ігнорує:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Reply with OK."}],
    max_tokens=32768,  # room for thinking plus answer
)
print(response.choices[0].message.content)
Якщо у відповідь надійшло 200, із транспортним рівнем усе гаразд. Далі йдеться про відповіді, які не супроводжуються помилкою.
Непомітні збої: немає помилки, результат не той, рахунок не той
Стандартний ліміт виводу — 65,536; довге декодування через постачальника — окремий шлях
Стандартна верхня межа виводу Carbon — 65,536 токенів. У Chat Completions це поле max_tokens; у нативних посібниках Google воно називається max_output_tokens. Нативний шлях Google для тривалого декодування може повертати до 1,048,576 токенів мінус кількість вхідних; 131,072 і 262,144 — приклади можливих значень. На сторінці оновлень Google зазначено правило: «Якщо задати background: true, не визначивши max_output_tokens, сервер зупиниться після 64K токенів». AIHubMix не документує для Carbon фоновий режим або продовження генерації.
Нативне довге декодування через постачальника виконується сегментами: по 64K за крок у фоновому режимі або під час потокової передачі, по 32K за крок без потокової передачі; один REST-запит без потокової передачі зупиняється після 32,768 токенів. У посібнику Google зазначено: «Попередні версії SDK і шар сумісності з OpenAI не можуть отримувати довгі завершення за допомогою токенів продовження». Для AIHubMix консервативно вважайте 65,536 верхньою межею для max_tokens, хоча це й не підтверджено; не розраховуйте об’єднувати довші відповіді, доки це не буде задокументовано на сторінці моделі.
Низький ліміт обриває обдумування, а за порожній вивід стягується плата
Ліміт стосується обдумування, а не лише тексту. У посібнику Google з довгого декодування зазначено: «Низьке значення, наприклад 8,192, зупиняє модель до завершення обдумування». Статус стає incomplete, а «текст може бути порожнім, якщо модель усе ще обдумувала». Оплата стягується в будь-якому разі. Зважайте на токени обдумування та відповіді; порожню відповідь зі статусом incomplete вважайте наслідком замалого ліміту: збільште його, повторіть запит і врахуйте, що перша спроба теж потрапить у рахунок.
За замовчуванням рівень обдумування — medium
Для Carbon за замовчуванням встановлено medium — так само, як для Argon. Команди, що переходять із Gemini 3.1 Pro Preview, де за замовчуванням встановлено high, отримують нижчий рівень без жодних змін у коді й можуть сприйняти менш глибоку відповідь як погіршення. Google рекомендує medium для більшості завдань із програмування та роботи агентів. Явно задайте рівень у тестовому середовищі й передавайте лише одне поле керування: reasoning_effort і thinking_level не можна поєднувати.
Параметри вибірки ігноруються
temperature, top_p і top_k ігноруються — помилки немає, як і змін у вибірці. Приберіть їх. Штрафи та значення candidate_count понад 1 призводять до відповіді 400.
Явне кешування більше не підтримується
cachedContents і caches.create не підтримуються. Неявне кешування застосовується від 4,096 токенів зі знижкою 95%. Видаліть код для явного кешування, розмістіть незмінний префікс промпту на початку й перш ніж враховувати знижку в бюджеті, перевірте використання кешованих токенів.
Для стану розмови є правило
Google рекомендує використовувати previous_interaction_id для продовження. У Chat Completions такого поля немає, тож зберігайте історію, але завершуйте її ходом користувача; завершення роллю моделі або попередньо заповнений хід моделі не підтримуються.
Тайм-аути: 15–20 хвилин, а не 60 секунд
У посібнику Google з довгого декодування рекомендовано встановлювати HTTP-тайм-аут читання на 15–20 хвилин для кожного потоку; у контрольному списку міграції також вказано мінімум у 15 хвилин. Ця рекомендація стосується запитів із довгим декодуванням. Окреме вимірювання AA показує час очікування першого токена відповіді: для Carbon High це 67.1 секунди, Medium — 23.2, Low — 12.9, а для Argon High — 40.1. Чи встигне надійти перший токен, якщо встановити ліміт у 60 секунд?
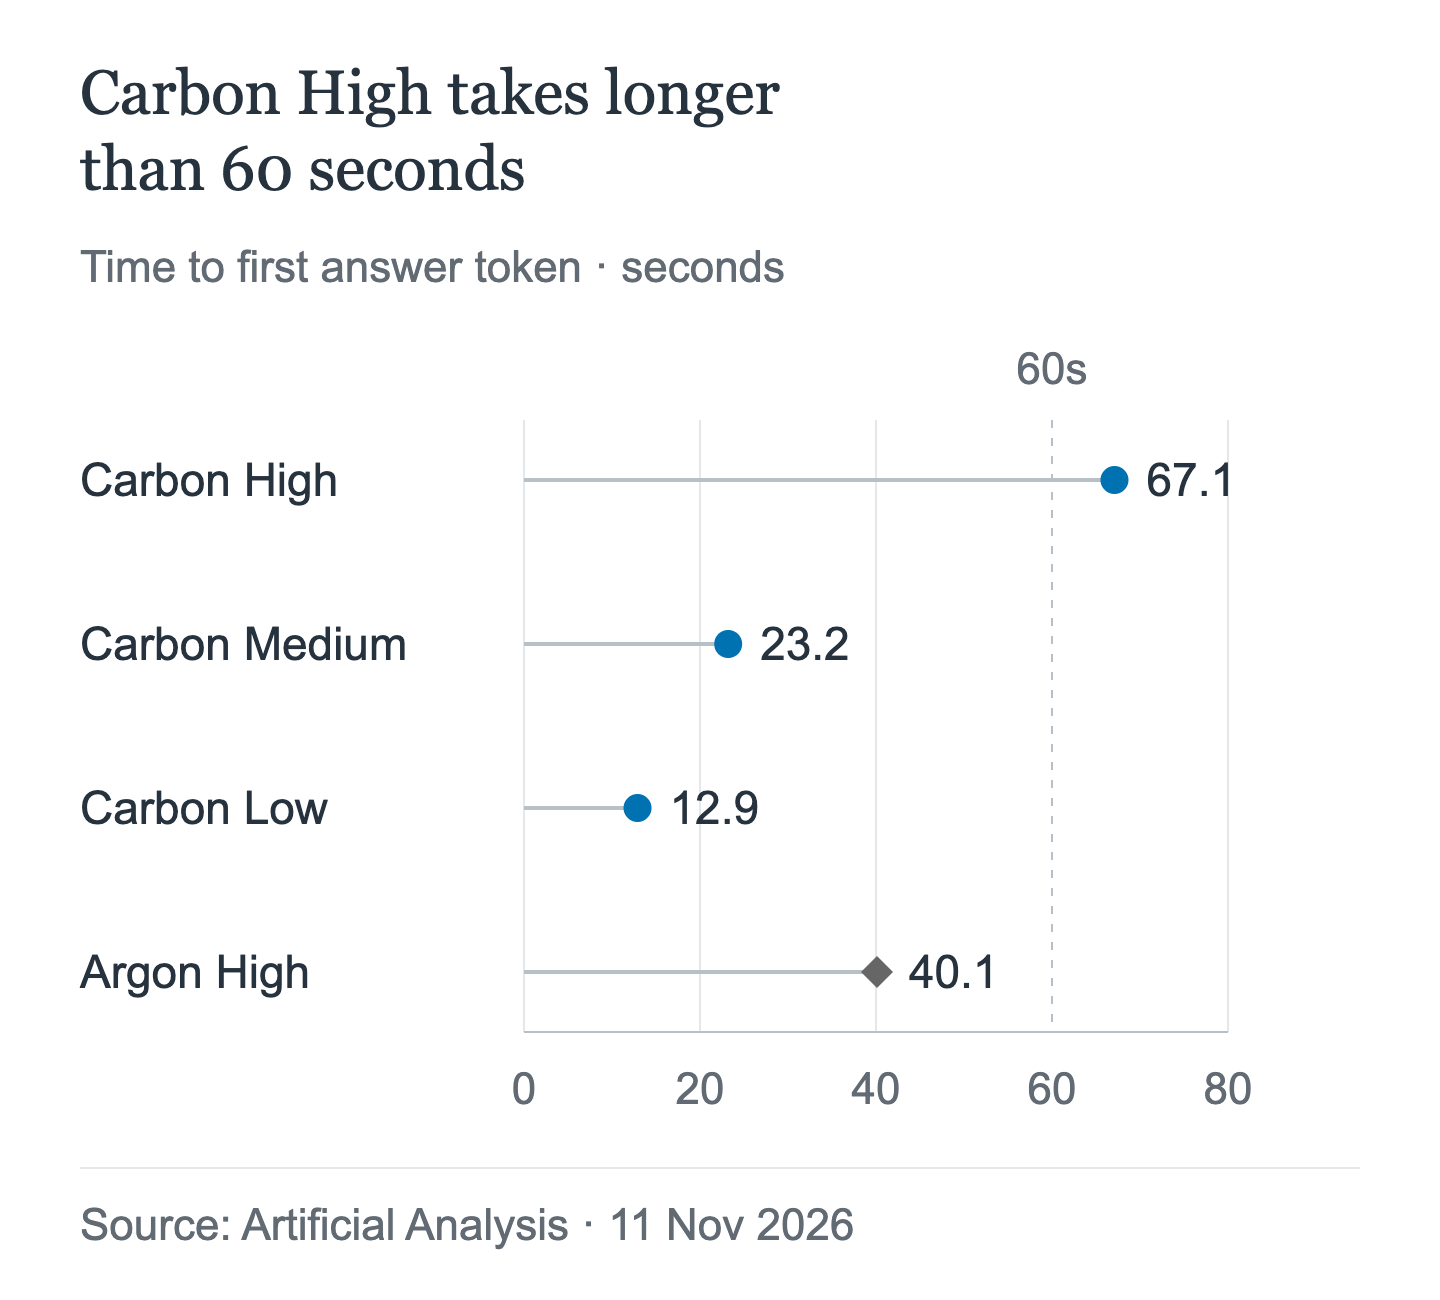
У цьому вимірюванні Carbon High перевищує позначку в 60 секунд. Час до першого токена не визначає безпечний тайм-аут для всього запиту: наведена вище рекомендація щодо 15–20 хвилин походить із посібника Google з довгого декодування. Це результати одного вимірювання, а не гарантії затримки чи тест AIHubMix.
Обмеження часу на один виклик нативного клієнта Google суворіші, ніж обмеження фонового режиму: 20 хвилин для потоку, 10 хвилин для виклику без потокової передачі проти 24 годин для фонового режиму. AIHubMix не документує ці обмеження фонового режиму.
Мінімальні версії нативних SDK для довгого декодування: Python 2.34.0, JS 2.32.0, Go 1.77.0, Java 1.80.0, .NET 1.28.0. У Claude Code значення API_TIMEOUT_MS за замовчуванням становить 10 хвилин; якщо згодом буде підтверджено підтримку Carbon через Claude Code, збільште його до першого запуску.
Пастки в оплаті
Ціна Carbon за токен проста, а рахунок — ні. Кілька механізмів збільшують суму, а одна запланована зміна подвоює всі тарифи.
За токени обдумування стягується плата як за вивід
За токени обдумування стягується плата як за вихідні. Зараз тариф Carbon на вивід становить $10 за мільйон токенів, а з December 1 — $20.
Оплачується кожен крок довгого декодування
Приклад із розрахунками від Google: для промпту обсягом 1,000 токенів, який генерує 200,000 вихідних токенів, значення total_input_tokens становить 397,216 з урахуванням кроків обсягом 1,000, 66,536, 132,072 і 197,608 токенів. «Оплачується кожен токен на кожному кроці, зокрема на тих кроках, які містять лише обдумування». Неявне кешування дає знижку 95% на більшість вхідних токенів, але кроки все одно відображаються у використанні. За виконану роботу також стягується плата, навіть якщо запуск завершується помилкою чи його скасовано: «Оплата за завершені сегменти стягується наприкінці кожного сегмента, навіть якщо пізніший сегмент завершується помилкою чи його скасовано» та «Оплачується вся робота, виконана до завершення взаємодії».
Для заземлення є окремий тариф
У нативному сервісі Google за заземлення через Google Search перші 5,000 запитів на місяць безкоштовні; ліміт спільний для Gemini 3 і новіших моделей, після чого стягується $14 за 1,000 запитів, не більш як 1,500 на день. AIHubMix не документує заземлення для Carbon.
Примітка щодо Vertex стосується лише постачальника
На сторінці цін Google Vertex зазначено додаткове правило: за завершення обсягом понад 32K токенів стягується плата за використання токенів, які можна отримати, навіть якщо запит завершується через тайм-аут клієнта або сервера; правило набуває чинності November 13, 2026. Це правило постачальника; чи застосовує його провайдер VertexAI від AIHubMix, не повідомляється. Перш ніж робити припущення, уточніть це.
З December 1 усі тарифи подвоюються
| Тариф | До November 30 | З December 1 |
|---|---|---|
| Вхідні | $2 за 1M | $4 за 1M |
| Вихідні | $10 за 1M | $20 за 1M |
| Читання з кешу | $0.10 за 1M | $0.20 за 1M |
Для Carbon і Argon діють однакові початкові тарифи; December 1 кожен тариф подвоїться. Сьогодні AIHubMix вказує початкові тарифи, але ще не опублікував ціни після December. Вважайте подвоєння гарантованим, а ціну шлюзу — невідомою; перш ніж затверджувати бюджет, перевірте обидва параметри.
Агенти з реальними дозволами
Для викликів через нативний API Google у посібнику Carbon радять виконувати виклики інструментів послідовно. Працюючи через цей шлях, надсилайте по одному виклику за раз. У посібнику AIHubMix для Gemini описано tool_choice="auto", але підтримка інструментів і примусовий вибір інструментів для Carbon на шлюзі не підтверджені.
Історія не повинна закінчуватися ходом моделі, а попередньо заповнені ходи моделі не підтримуються. Якщо результату роботи інструмента немає, надішліть хід користувача із запитом про наступний крок.
У картці моделі зазначено, що іноді вона працює повільно або завершується з тайм-аутом, а на вищих рівнях використовує більше токенів; дата актуальності знань — березень 2026 року. За наявності прав на запис тайм-аут становить реальний ризик: якщо виконання перевищить ліміт клієнта, після нього можуть залишитися частково виконані зміни, а за завершені сегменти все одно стягується плата.
Інструменти для кодування: перш ніж щось налаштовувати, перевірте сторінку моделі
У каталозі Carbon на AIHubMix задокументовано лише Chat Completions, а Carbon поки що немає в загальнодоступному індексі моделей. Claude Code потребує Anthropic Messages, а Codex — Responses. Підтримку жодного з них для Carbon на AIHubMix не підтверджено. Не припускайте, що вони працюватимуть: відкрийте сторінку моделі Carbon за посиланням вище й перевірте список протоколів. Якщо вказано лише Chat Completions, скористайтеся сумісним із OpenAI клієнтом або зачекайте.
Форма запиту така сама, як для Argon, але доступність протоколів відрізняється: наразі на AIHubMix для Carbon задокументовано лише Chat Completions. У дописі про Claude Code описано ANTHROPIC_BASE_URL, ANTHROPIC_AUTH_TOKEN і API_TIMEOUT_MS; у дописі про Codex — блок провайдера, wire_api і model_reasoning_effort. Відмінність полягає в тому, чи доступний потрібний протокол.
| Клієнт | Потрібний протокол | Carbon на AIHubMix |
|---|---|---|
| Claude Code | Anthropic Messages | Не задокументовано |
| Codex | Responses API | Не задокументовано |
| OpenAI SDK | Chat Completions | Задокументовано |
Налаштування:
- ID моделі:
gemini-4-carbon. - Режим мислення: low, medium, high; за замовчуванням — medium.
- Відповідність рівням зусиль: нативне поле
thinking_level, поле сумісностіreasoning_effort; Google зіставляє значення зусиль, але AIHubMix не опублікував відповідність для Carbon. Надішліть лише одне з цих полів. - Контекст: 1,048,576 за даними Google; AIHubMix не опублікував ліміт для Carbon, тому не розраховуйте на показник постачальника.
- Відомі проблеми: повільна генерація першого токена на рівні high, рекомендація постачальника виконувати ходи з інструментами послідовно, консервативний непідтверджений ліміт AIHubMix у 65,536 вихідних токенів і дата актуальності знань — березень 2026 року.
Швидкий тест, 10–15 хвилин:
- Виберіть невеликий репозиторій із одним тестом модульного тестування, що не проходить, і командою тестування, яка завершується менш ніж за хвилину.
- Задайте модель
gemini-4-carbon, установітьmax_tokensна 65,536 або менше, а тайм-аут HTTP — щонайменше 15 хвилин. - Попросіть інструмент внести найменшу зміну, потрібну для успішного проходження тесту, потім запустіть команду тестування й перевірте різницю.
- Успіх: зміни мінімальні, а тест проходить за 10–15 хвилин. Невдача: зафіксуйте, чи відповідь завершилася помилкою 400, була неповною, сталася затримка через тайм-аут або містила невдалу зміну; для кожного випадку вище наведено окреме рішення.
- Якщо інструмент дає змогу вибрати рівень, перевірте medium і high та залиште той, що завершується в межах відведеного часу.
Контрольний список перед першим запитом у production
- Для ID моделі задано
gemini-4-carbon. - Не використовуються
temperature,top_pіtop_k. - Не використовуються
frequency_penaltyіpresence_penalty; дляcandidate_countзадано значення 1 або параметр не вказано. - Для
max_tokensзадано значення 65,536 або менше. - Для фонових запитів через нативний API Google передаються
store=trueі явне значенняmax_output_tokens; AIHubMix не задокументував цей шлях. - Тайм-аут HTTP — 15 хвилин або більше; бажано використовувати потокову передачу.
- Використовуйте лише один із параметрів:
reasoning_effortабоthinking_level. - Для нативного API Google віддавайте перевагу послідовним ходам з інструментами; AIHubMix документує
tool_choice="auto", але підтримку Carbon не підтверджено. - Не викликайте кеш явно; спочатку передавайте стабільний префікс промпту.
- У бюджеті враховуйте токени мислення та кожен етап тривалого декодування.
- Перевірте тарифи на 1 грудня з відповідальним за бюджет.
- Перш ніж налаштовувати інструмент для кодування, перевірте його на сторінці моделі.
FAQ
Чи потрібно змінювати тіло запиту під час переходу з Argon на Carbon?
Ні. Схема не змінюється. Змініть ID моделі, перевірте значення параметрів і видаліть поля, які тепер спричиняють помилку 400.
Чому max_output_tokens спричиняє помилку 400?
Нативний API Google для Carbon відхиляє значення понад 1,048,576. Для шляху Chat Completions на AIHubMix є окрема консервативна рекомендація: установіть max_tokens на рівні 65,536 або нижче, доки не буде задокументовано шлях із вищим лімітом. Низьке значення натомість обрізає мислення, що ще гірше: відповідь може бути неповною, але оплата за неї все одно стягується.
Чому відповідь порожня?
Якщо статус вказує на незавершене виконання, текст може бути порожнім, бо модель усе ще обробляла запит. Робота вже оплачена. Збільште ліміт і повторіть запит.
Чому фоновий запит зупиняється на 64K?
У фоновому режимі нативного API Google, якщо не вказати max_output_tokens, сервер зупиняється на 64K. Установіть ліміт явно; нативне тривале декодування може досягати 1,048,576 мінус кількість вхідних токенів. AIHubMix не задокументував фоновий режим.
Чи враховується temperature?
Ні. temperature, top_p і top_k ігноруються. Параметри штрафів і значення candidate_count понад 1 натомість спричиняють помилку 400.
Чи подвоїться вартість Carbon 1 грудня?
Тарифи Google подвоюються: вхідні токени — з $2 до $4, вихідні — з $10 до $20, читання з кешу — з $0.10 до $0.20. AIHubMix не опублікував ціни після грудня, тому уточніть їх, перш ніж затверджувати бюджет.
Чи можна використовувати Claude Code або Codex із Carbon?
Це не підтверджено. Для Carbon на AIHubMix задокументовано Chat Completions; Claude Code потребує Anthropic Messages, а Codex — Responses. Спершу перевірте сторінку моделі.
Читайте далі: серія про Gemini 4 Carbon
- Якщо міграція вже триває й лишилося з’ясувати, чи виправдовує Carbon свою ціну, у порівнянні наведено спільні стартові тарифи.
Gemini 4 Carbon проти Argon: однакова ціна — коли варто обрати Carbon? - Якщо ви обираєте агента для кодування, а не переносите ендпоінт, у порівнянні розглянуто використання інструментів і вартість одного завдання.
Gemini 4 Carbon проти Fable 5.2: що обрати для агентного кодування?