

3–4 листопада 2026 року набір APB Full протестували на DeepSeek V4.1 Flash 1017 у п’яти провайдерів через AIHubMix. Для кожного провайдера використовували ті самі запитання, параметри та скрипти запитів; усі п’ять записів провайдерів наведено на сторінці моделей. Цей профіль APB охоплює лише офіційний канал DeepSeek. До нього зверталися через маршрут офіційного постачальника DeepSeek в AIHubMix, а не напряму до API DeepSeek.
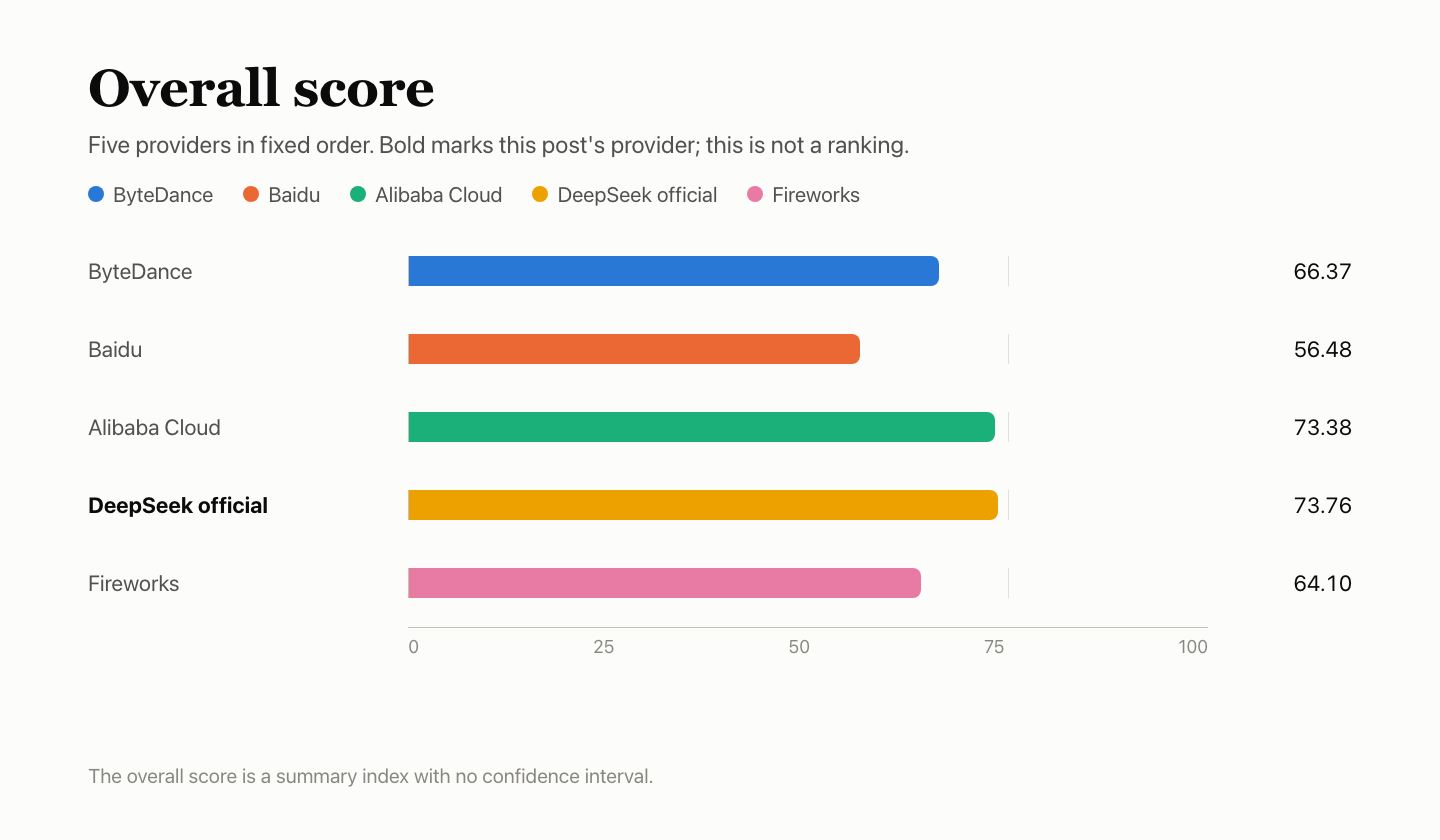
У цій публікації наведено лише бали, без ранжування провайдерів чи рекомендацій: Q 42.45, F 94.00, P 86.14, K 98.38 і R 100. Q, F, P та R — бали чотирьох розділів; K — підбал P. Загальний бал 73.76 — це зведений індекс, а не сертифікація; довірчого інтервалу для нього немає. Стандарт оцінювання — AIHubMix Provider Benchmark Standard v2.0.
Бали п’яти провайдерів
Жирним позначено провайдера, про якого йдеться в цій публікації. Порядок провайдерів фіксований і не є рейтингом. K — підбал P із вагою 20%; його наведено окремо для довідки. Загальний бал — зведений індекс без довірчого інтервалу. Загальні бали офіційного каналу DeepSeek і Alibaba Cloud відрізняються на 0.37, тож розрізнити їх неможливо.
Короткий огляд
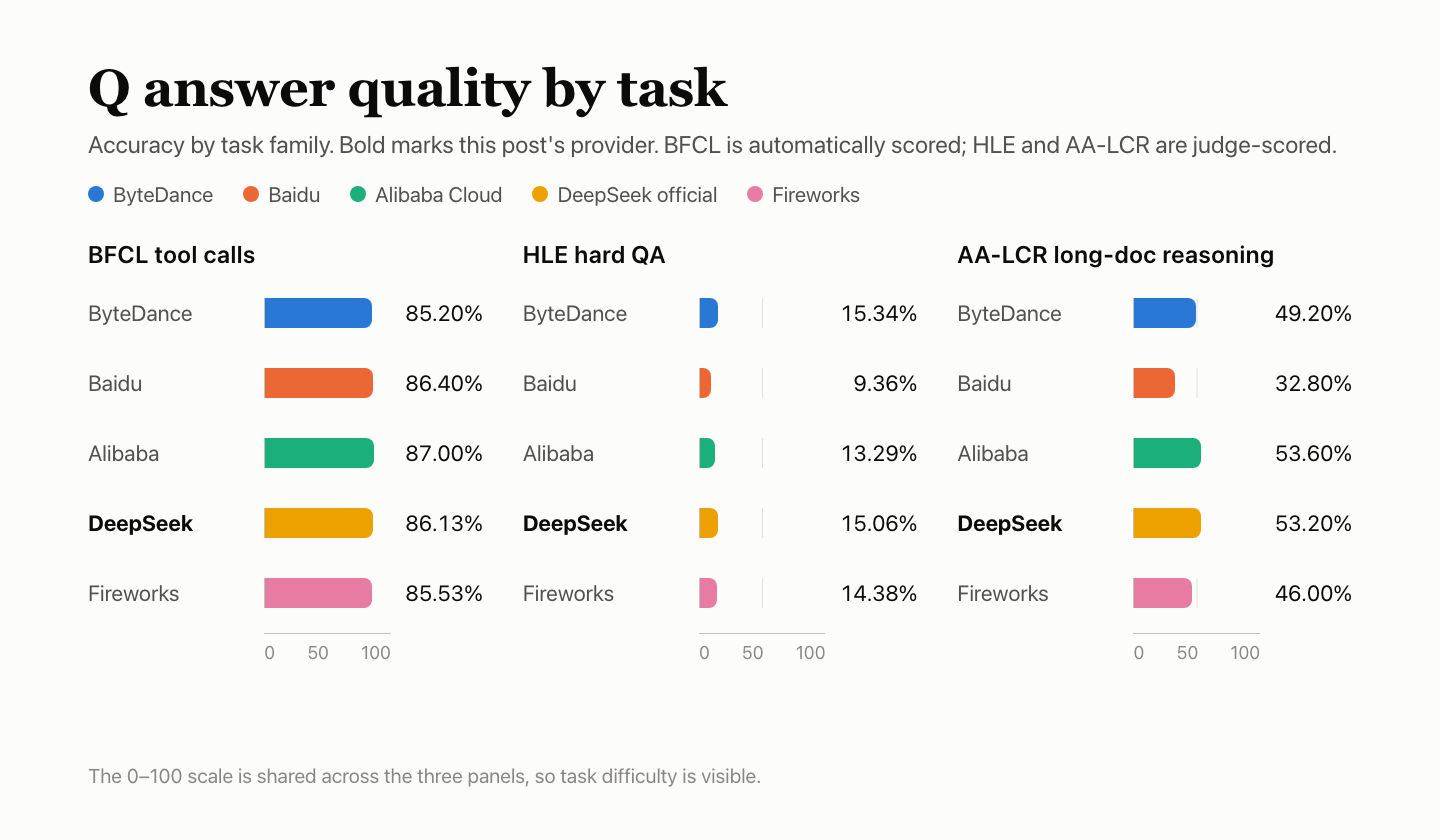
- Якість відповідей: Q 42.45. BFCL 86.13%, HLE 15.06%, AA-LCR 53.20%. Сім відповідей HLE обрізано через досягнення ліміту max_tokens, і їх зараховано як неправильні. Цей канал слугує базовим рівнем Q для порівняння з рештою чотирма.
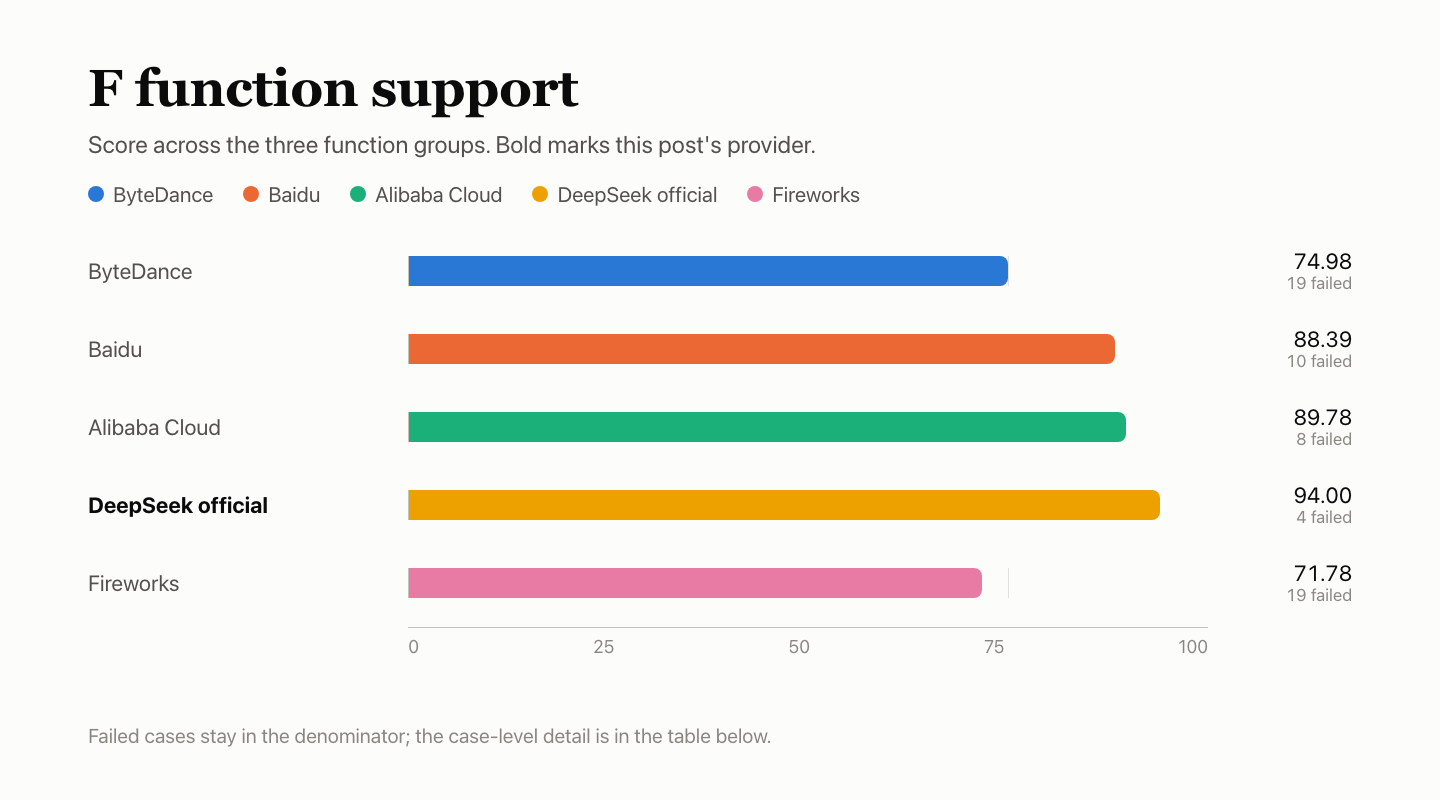
- Підтримка функцій: F 94.00. Пройдено 137 із 147 зарахованих перевірок. Ще 27 перевірок, залежних від точного підрахунку токенів, визнали некоректними й виключили зі знаменника.
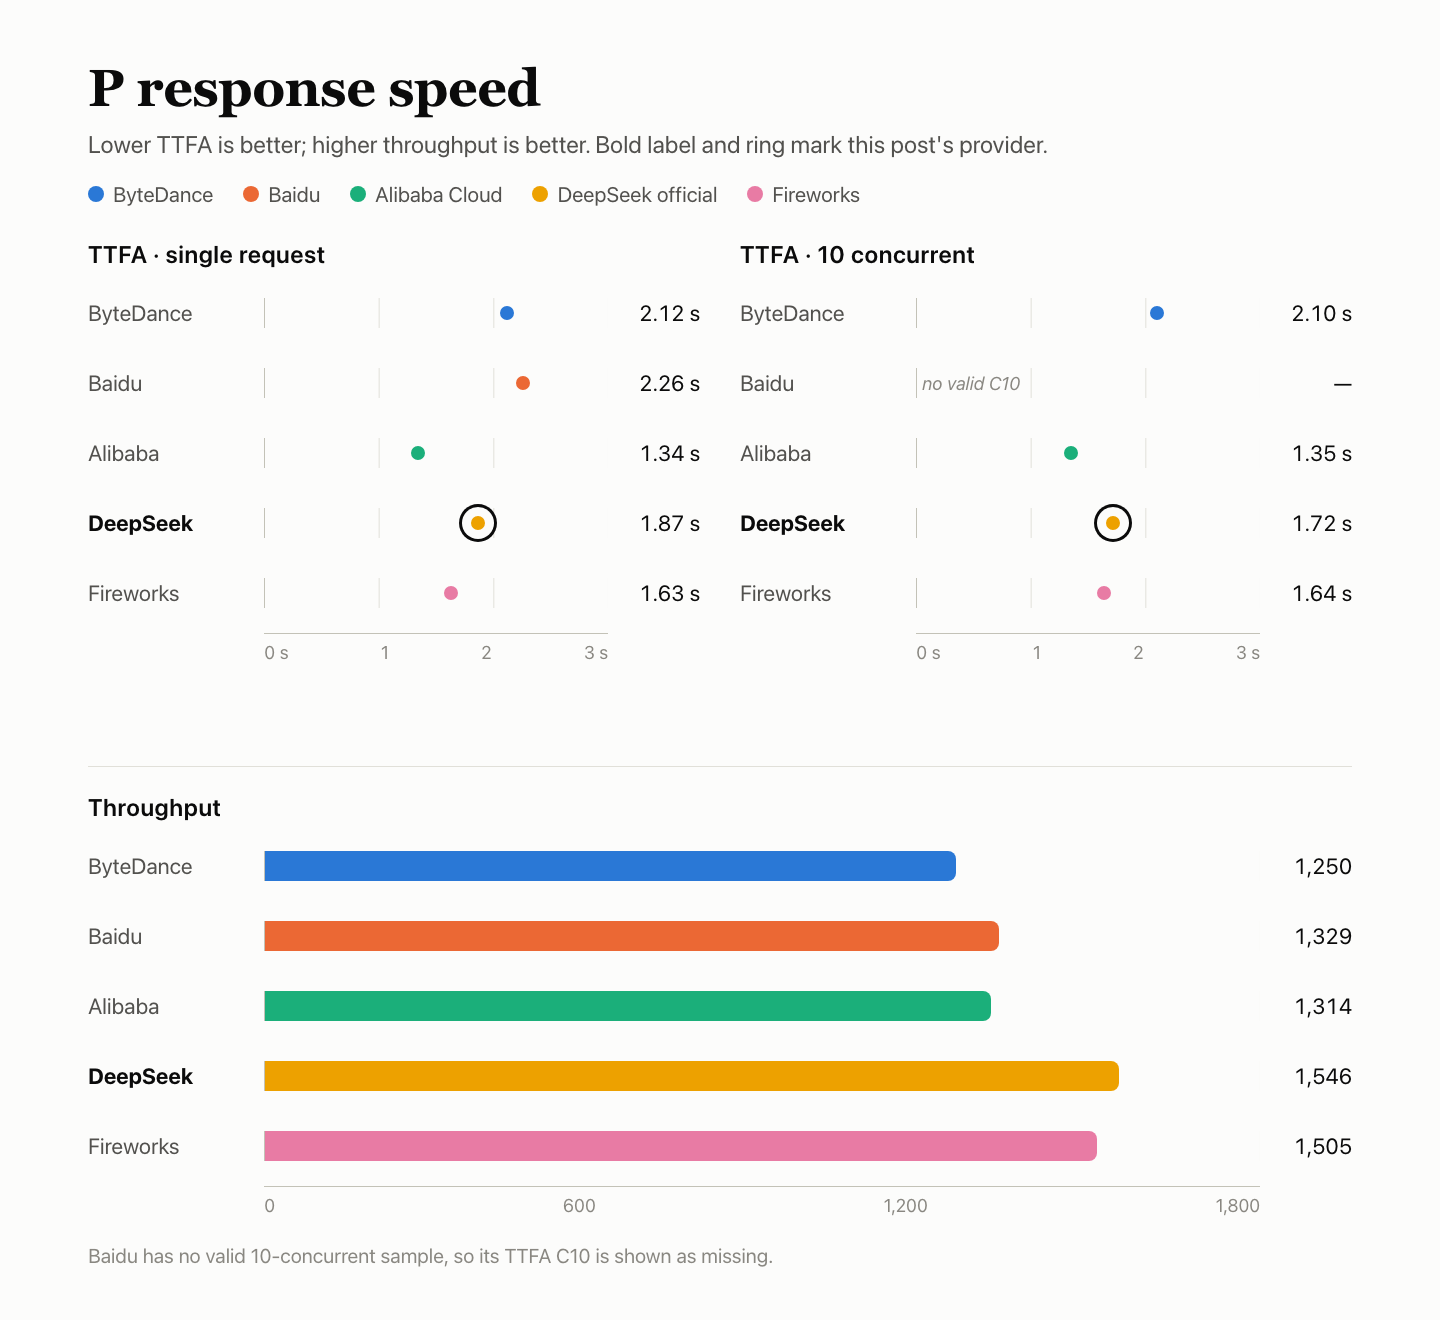
- Швидкість відповіді: P 86.14. У першому вікні з одним одночасним запитом 15 із 30 запитів були некоректними (12 × 503, 2 × deadline, 1 × read timeout) і враховувалися як нескінченні; медіана часу до першого токена — 1.87 с (1.72 с лише для коректних запитів); за 10 одночасних запитів — 1.72 с; TPOT — 2.84 мс.
- Кеш: K 98.38. Усі 18 гарячих запитів із префіксами 8k і 32k влучили в кеш; контрольні запити без кешу не читали дані з кешу.
- Стабільність сервісу: R 100. Усі 300 окремих запитів успішно виконано з першої спроби.
Налаштування тесту
Запити надсилали через AIHubMix, вибравши маршрут офіційного постачальника DeepSeek; налаштування доступу описано в короткому посібнику.
| Параметр | Деталі |
|---|---|
| Модель | DeepSeek V4.1 Flash 1017 |
| Запитаний ID моделі | deepseek-flash |
| Повернена назва моделі | deepseek-flash |
| Маршрут доступу | Маршрут офіційного постачальника DeepSeek в AIHubMix; не пряме підключення до API DeepSeek |
| Параметри | Режим без міркувань, temperature 1.0, max_tokens 16,384, тайм-аут 300 с, автоматичні повторні спроби вимкнено |
| Міркування вимкнено | Для всіх запитів використовували reasoning_effort=none |
| Час | 2026-11-03 18:07 – 11-04 16:33 UTC+8; п’ять провайдерів використовували один Mac mini, одну мережу й один обліковий запис |
| Вибірки | Якість відповідей — 4,250 спроб (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10); функціональні випадки — 60 × 3 вікна; швидкість — 90 запитів з одним одночасним запитом і 90 із 10 одночасними; стабільність — 300; кеш — 30 (три групи для кожного префікса: 8k і 32k) |
Q — якість відповідей: 42.45
Набір об’єднує BFCL: 500 запитань × 3 запуски, HLE: 250 × 10 і AA-LCR: 25 × 10. BFCL оцінюється автоматичними правилами; HLE та AA-LCR — моделлю-суддею deepseek-flash. Усі п’ять провайдерів отримали однакові запитання. Десять відповідей не вдалося оцінити, тому їх вилучили; залишилося 4,240 оцінених спроб.
| Бенчмарк | Запитання | Правильні | Точність | Помилки |
|---|---|---|---|---|
| Виклики інструментів BFCL | 500 × 3 | 1,292/1,500 | 86.13% | 0 |
| Складні запитання-відповіді HLE | 250 × 10 | 375/2,490 | 15.06% | 7 |
| Міркування за довгими документами AA-LCR | 25 × 10 | 133/250 | 53.20% | 0 |
| Усього · 95% ДІ 40.08%–44.73% | 4,240 оцінених | 1,800/4,240 | 42.45% | 7 |
Помилки сервісу — невдалий запит або обрізаний вивід — залишаються у знаменнику й зараховуються як неправильні відповіді. Тут це означає сім відповідей HLE, обрізаних через досягнення ліміту max_tokens. BFCL оцінюється автоматично; HLE та AA-LCR — моделлю-суддею.
Знаменники BFCL — це підсумки трьох запусків.
| Категорія BFCL | Пройдено | Частка проходження |
|---|---|---|
| simple_python — одна функція, правильний виклик і аргументи | 334/360 | 92.78% |
| multiple — вибрати правильну функцію з кількох | 268/300 | 89.33% |
| parallel — викликати ту саму функцію кілька разів паралельно | 271/300 | 90.33% |
| parallel_multiple — паралельно викликати кілька різних функцій | 207/240 | 86.25% |
| irrelevance — жодна функція не доречна, викликати нічого не потрібно | 113/150 | 75.33% |
| ahm_multi_turn — ланцюжок інструментів із трьох етапів | 99/150 | 66.00% |
Порівняння з рештою чотирма
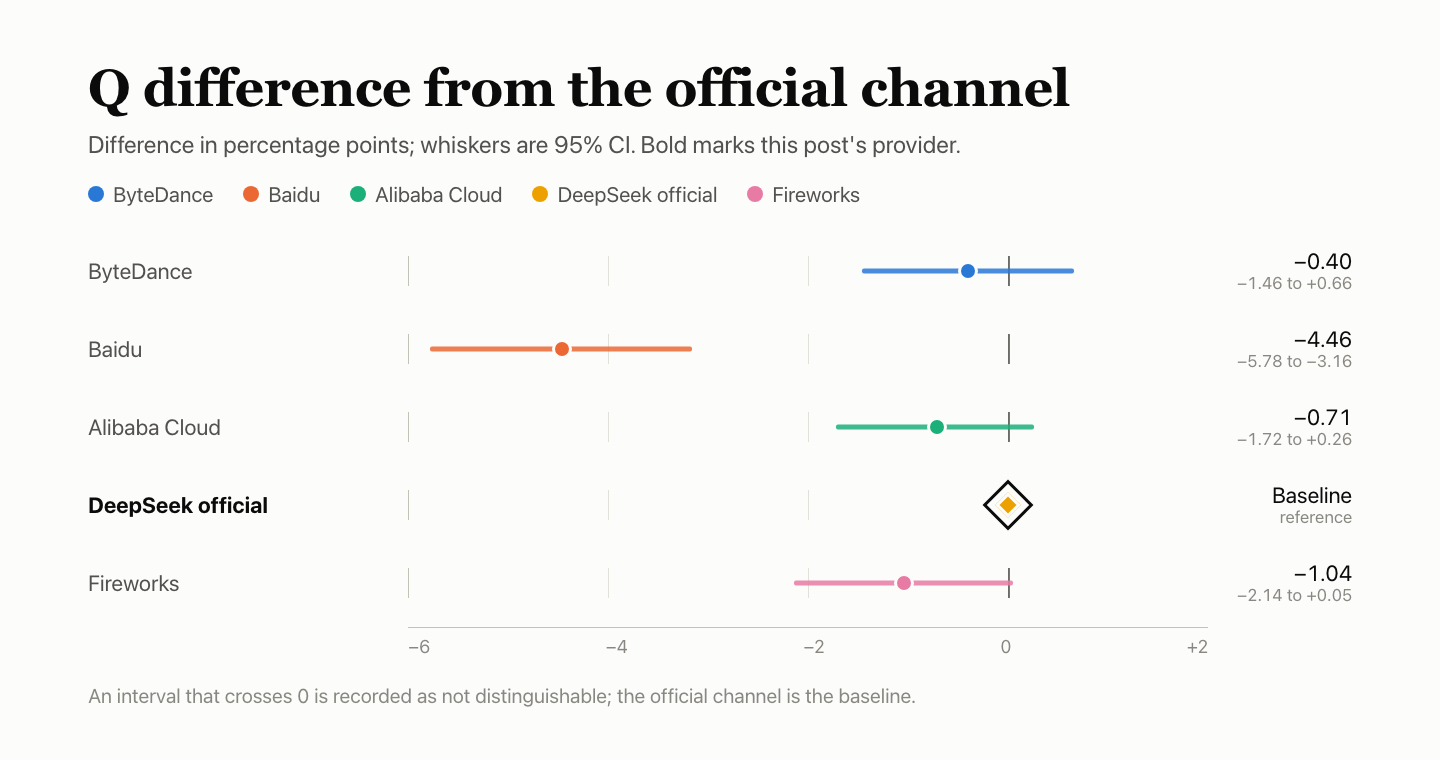
У кожному випадку наведено різницю у відсоткових пунктах відносно цього базового рівня, а вусиками позначено 95% інтервал; якщо інтервал перетинає 0, відмінність не можна розрізнити. Модель-суддя належить до тієї самої родини DeepSeek, що й тестована модель, і її не калібрували, тому оцінювання HLE та AA-LCR може бути поблажливим.
F — підтримка функцій: 94.00
Функціональні випадки перевіряють поведінку протоколу, а не якість відповідей. У кожному з трьох вікон запускали 60 випадків у шести групах — усього 180 перевірок, які оцінювали відповідно до формату, зазначеного в документації кожного провайдера. Непридатні, некоректні та неспостережувані перевірки вилучаються зі знаменника. Цей канал пройшов 137 із 147 зарахованих перевірок; зважений бал становить 94.00. Зважений бал — не просте відношення 137/147.
| Група | Вага | Пройдено | Виключено | Бал групи |
|---|---|---|---|---|
| Потокова передача та протокол повідомлень | 20% | 27/27 | 3 | 100.00 |
| Інтерфейс інструментів | 20% | 30/30 | — | 100.00 |
| Обмеження виводу та параметри | 20% | 30/30 | — | 100.00 |
| Контекст і стан | 15% | 14/15 | 15 | 93.33 |
| Помилки та відновлення | 15% | 24/30 | — | 80.00 |
| Облік використання та протокол кешування | 10% | 12/15 | 15 | 80.00 |
| Усього · зважений бал | — | 137/147 | 33 | 94.00 |
Зважений бал обчислюється відповідно до ваг груп; це не кількість пройдених перевірок, поділена на 147.
| Невдалий випадок | Вікна з помилкою | Причина |
|---|---|---|
| Некоректні повідомлення (Помилки та відновлення) | 3/3 | Повернуто 400, але тіло відповіді порожнє, структурованого опису помилки немає |
| Некоректний stream_options (Помилки та відновлення) | 3/3 | Повернуто 400, але тіло відповіді порожнє, структурованого опису помилки немає |
| Облік токенів міркування (Облік використання та протокол кешування) | 3/3 | Кількість токенів міркування не повернуто |
| Ізоляція запитів (Контекст і стан) | 1/3 | На першому етапі у відповідь не надійшло лише STORED, як вимагалося, тому перевірку ізоляції не вдалося продовжити |
Виключені перевірки не зараховуються ні як пройдені, ні як невдалі.
| Статус | Випадок | Кількість | Причина |
|---|---|---|---|
| Неспостережувана | Послідовність зупинки потокової передачі | 3 | Запит цього кроку не надіслали після попереднього кроку, тому оцінити його не вдалося |
| Некоректна | Довгий ввід 10k; у межах ліміту контексту; довгий ввід 32k; довгий ввід 100k; перевищення контексту; підрахунок вхідних токенів на рівні моделі; врахування визначень інструментів у вхідних даних; узгодженість підрахунку вхідних даних до й після кешування; узгодженість вхідних даних у потоковому режимі та без потокової передачі | 27 | Закріплений у тесті шаблон підрахунку токенів на рівні моделі не відповідав даним про використання, які повертав цей канал, тому перевірки, залежні від точних підрахунків, визнали некоректними й виключили зі знаменника |
| Не застосовується | Явний cache_control | 3 | Заздалегідь зареєстровано як непідтримуваний цим інтерфейсом |
27 некоректних перевірок — це випадки з довгим вводом, лімітом контексту, підрахунком токенів на рівні моделі та узгодженістю кешу зі списку. Оскільки закріплений шаблон не відповідав даним про використання, які повертав цей канал, усі перевірки, залежні від точного підрахунку, виключили, а не оцінили.
Два випадки завершилися помилкою в усіх п’яти провайдерів: некоректні messages і некоректний stream_options. В обох випадках повернуто 400 із порожнім тілом, тож клієнт не отримав структурованого опису помилки. Спільна закономірність радше вказує на рівень шлюзу AIHubMix, який потребує окремого розслідування. Облік токенів міркування також не пройшов у всіх п’яти, але з інших причин: ByteDance і Fireworks і далі повідомляли про токени міркування після вимкнення цього режиму, тоді як решта три не повертали їхньої кількості.
Порівняння з рештою чотирма
P — швидкість відповіді: 86.14
Кожен запит містив близько 10,000 вхідних токенів і вимагав близько 1,100 вихідних. У кожному з трьох вікон надсилали 30 запитів з одним одночасним запитом і 30 — із 10 одночасними, усього 180.
| Метрика | Значення |
|---|---|
| TTFA першого токена | Один одночасний запит: медіана 1.87 с (медіана для коректних запитів — 1.72 с). 10 одночасних запитів: медіана 1.72 с |
| TPOT | Один одночасний запит: 2.84 мс/токен. 10 одночасних запитів: 2.67 мс/токен |
| Пропускна здатність коректних запитів (goodput) | 10 одночасних запитів: 1,546.0 токенів/с |
| Коректні запити | Один одночасний запит — 75/90 (вікно 1: 15/30); 10 одночасних запитів — 90/90. Некоректні: 12 × 503 service_unavailable_error, 2 × deadline reached, 1 × read timeout |
| Компонентні бали | TTFA 51.65, TPOT 100.00, пропускна здатність 100.00; для TTFA та TPOT береться нижчий результат із двох рівнів, ваги — 35% / 35% / 30%; бал відповіді — 83.08 |
| Складові P | Бал відповіді 83.08 із вагою 80%, кеш K 98.38 із вагою 20%; P 86.14 |
Усі 15 некоректних запитів припали на перше вікно з одним одночасним запитом: 12 повернули 503, для 2 минув крайній термін, а 1 завершився тайм-аутом читання. Некоректні запити враховуються як нескінченні, тому вказана медіана становить 1.87 с. Лише для коректних запитів медіана — 1.72 с. За 10 одночасних запитів медіана також дорівнює 1.72 с. TPOT становить 2.84 мс/токен для одного одночасного запиту та 2.67 мс/токен для 10 одночасних.
Порівняння з рештою чотирма
П’ять провайдерів використовували один Mac mini, одну мережу й один обліковий запис. Три вікна планували окремо для кожного провайдера, тож періоди збору даних не повністю збігаються; невеликі розбіжності не варто надмірно інтерпретувати.
K — кеш: 98.38
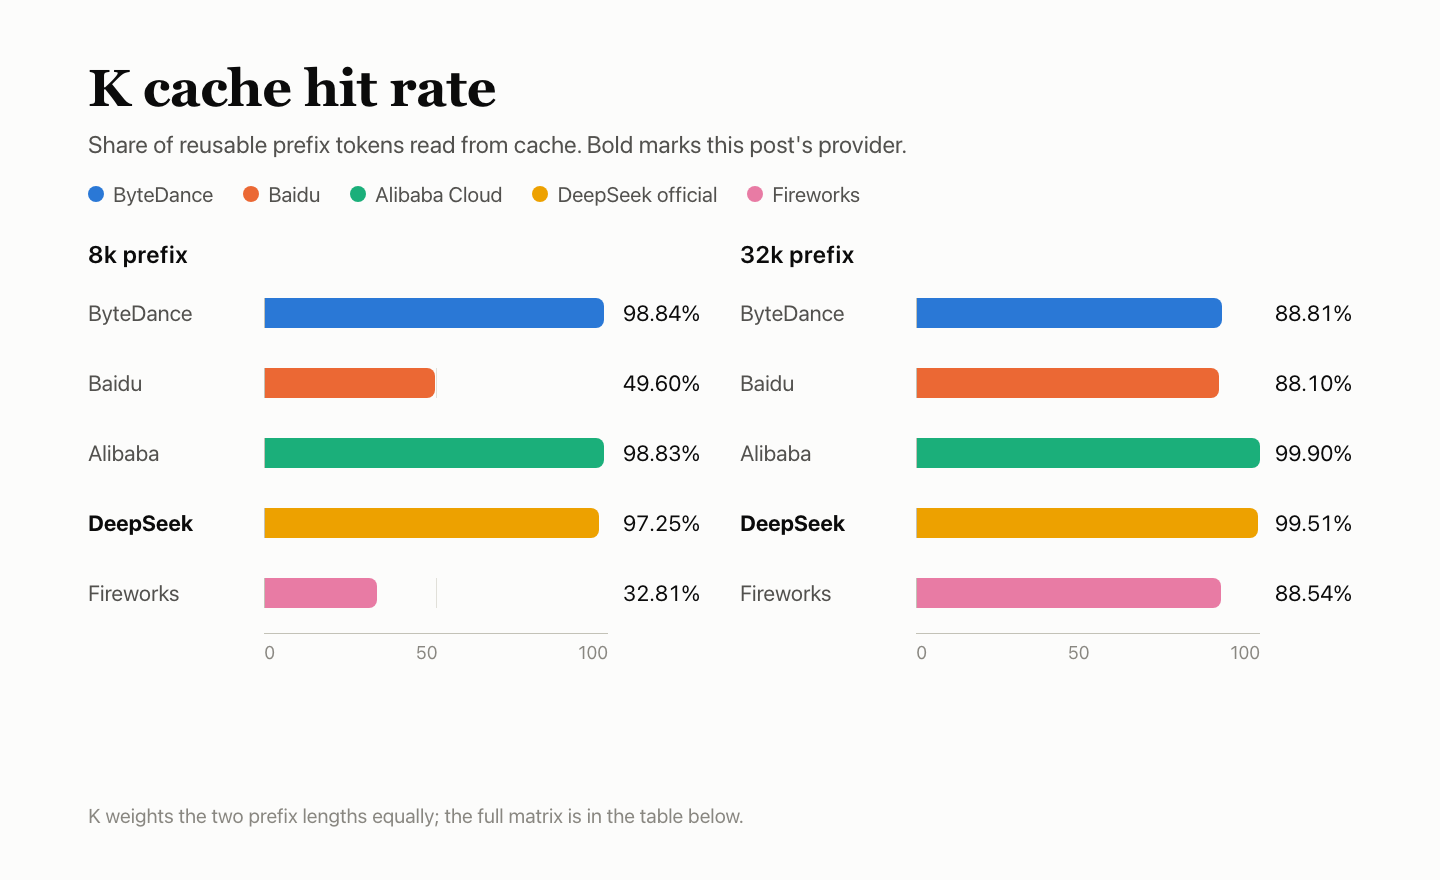
У кожній групі надсилають п’ять запитів. Перший створює фіксований префікс 8k або 32k. У запитах із другого по четвертий префікс не змінюють, змінюють лише останнє запитання; їх надсилають через 5, 30 і 120 секунд. П’ятий запит використовує новий префікс як контрольний без кешу. Три вікна × два розміри — 30 запитів. K обчислюється як відношення токенів, зчитаних із кешу в гарячих запитах, до кількості токенів, які мали повторно використовуватися; кожен розмір має однакову вагу. K становить 20% від P. Кешування контексту описано в документації API DeepSeek.
| Префікс | Вікно | Початковий запит | +5 s | +30 s | +120 s | Контроль без кешу |
|---|---|---|---|---|---|---|
| 8k | Вікно 1 | 0 | 7,808 | 7,808 | 7,808 | 0 |
| 8k | Вікно 2 | 0 | 7,808 | 7,808 | 7,808 | 0 |
| 8k | Вікно 3 | 0 | 7,808 | 7,808 | 7,808 | 0 |
| 32k | Вікно 1 | 0 | 31,872 | 31,872 | 31,872 | 0 |
| 32k | Вікно 2 | 0 | 31,872 | 31,872 | 31,872 | 0 |
| 32k | Вікно 3 | 0 | 31,872 | 31,872 | 31,872 | 0 |
Із гарячих запитів із префіксом 8k у кеш влучили 9 із 9; кожен зчитував 7,808 токенів: 70,272 зчитаних із 72,261 токена, придатного для повторного використання, — 97.25. Із гарячих запитів із префіксом 32k у кеш влучили 9 із 9; кожен зчитував 31,872 токени: 286,848 із 288,270 — 99.51. Контрольні запити без кешу не зчитували дані з кешу. Сукупний K для двох розмірів — 98.38.
Порівняння з рештою чотирма
R — стабільність сервісу: 100
300 запитів охоплюють короткий текст, довгий ввід 10k, виклики інструментів і багатокрокову історію; їх надсилають з одним одночасним запитом упродовж трьох вікон. Перевіряють лише коректність і повноту відповіді з першої спроби, а не її правильність; повторних спроб немає. Помилки, пов’язані з якістю відповідей і швидкістю, зараховують у Q та P, а не повторно в R.
| Тип запиту | Успіх із першої спроби |
|---|---|
| Короткий текст | 120/120 |
| Довгий ввід 10k | 90/90 |
| Виклики інструментів | 60/60 |
| Багатокрокова історія | 30/30 |
| Усього · 95% ДІ 98.78%–100% | 300/300 |
Усі 300 запитів із першої спроби повернули коректну повну відповідь. R 100 охоплює лише ці 300 спеціально виділених запитів; це не означає, що на всьому маршруті не було збоїв. За 300 успішних запитів нижня межа 95% довірчого інтервалу становить 98.78%, тож дані свідчать, що частка збоїв, імовірно, нижча за 1.22%.
Порівняно з іншими чотирма
R охоплює лише 300 спеціально виділених запитів; збої якості відповідей і швидкості фіксуються у Q і P та не враховуються повторно в R.
| Провайдер | Успіх із першої спроби | 95% ДІ |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek офіційний | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Часті запитання
Це пряме підключення до API DeepSeek?
Ні. Запити проходять через маршрут офіційного постачальника DeepSeek в AIHubMix; вони не надсилаються безпосередньо до API DeepSeek.
Чому офіційний канал DeepSeek є базовим для Q?
Це офіційний канал DeepSeek для тієї самої моделі, тож результати якості відповідей інших чотирьох провайдерів виражаються як відмінності від нього. Статус базового каналу не означає, що якість відповідей посідає певне місце в рейтингу.
Що сталося під час першого вікна вимірювання швидкості з одним паралельним запитом?
П’ятнадцять із 30 запитів були некоректними: 12 повернули 503, 2 досягли граничного часу очікування, а 1 завершився тайм-аутом читання. Їх враховано як нескінченність, тому медіана становить 1.87 с; лише для коректних запитів вона дорівнює 1.72 с.
Що це за 27 некоректних перевірок функцій?
Вони залежать від точного підрахунку токенів: довжини вхідних даних, обмежень контексту, нативної кількості вхідних токенів і узгодженості вхідних даних кешу. Шаблон із зафіксованою нативною кількістю токенів на стороні тесту не відповідав даним про використання, які надав цей канал, тому ці перевірки виключили зі знаменника, а не зарахували як невдалі.
Чому R 100 не гарантує, що на маршруті не буде збоїв?
R охоплює лише 300 спеціально виділених запитів для перевірки стабільності. Збої під час тестів якості відповідей і швидкості фіксуються у Q і P. Оскільки успішними були 300 із 300 запитів, нижня межа 95% довірчого інтервалу становить 98.78%, тож частка збоїв, імовірно, нижча за 1.22%, але це не доводить, що вона дорівнює нулю.
Як тест кешу відрізняє повторні читання від читань без кешу?
У кожній групі спочатку подається префікс розміром 8k або 32k, а потім його повторно надсилають через 5, 30 і 120 секунд із новим фінальним запитанням, після чого для контрольної перевірки без кешу надсилають новий префікс. Для обох розмірів 9 із 9 повторних запитів влучили в кеш, а в кожному контрольному запиті без кешу було прочитано нуль кешованих токенів.
Читайте далі: серія DeepSeek V4.1 Flash
- Показник Q у ByteDance відрізняється від цього базового на 0.40 бала, тоді як результати підтримки функцій і кешу різняться: DeepSeek V4.1 Flash у ByteDance: виклики інструментів збігаються, облік — ні.
- У Baidu запити втрачалися через
no_available_channel, що проявляється і в Q, і в P: DeepSeek V4.1 Flash у Baidu: відсутність доступного каналу впливає на Q і P. - Загальний показник Alibaba Cloud відрізняється на 0.37 і статистично не відрізняється: DeepSeek V4.1 Flash в Alibaba Cloud: перший токен за 1.34s, кеш — 99.37.
- Fireworks влучив у кеш у 3 із 9 гарячих запитів розміром 8k, тоді як тут — у 9 із 9: DeepSeek V4.1 Flash у Fireworks: порожні відповіді після stop, 3/9 влучень у кеш.


