

3–4 листопада 2026 року DeepSeek V4.1 Flash 1017 протестували за повним набором APB у п’яти провайдерів — до всіх зверталися через AIHubMix, використовуючи ті самі запитання, параметри й скрипти запитів. Цей профіль APB охоплює лише Fireworks. Модель зазначена як DeepSeek V4.1 Flash 1017.
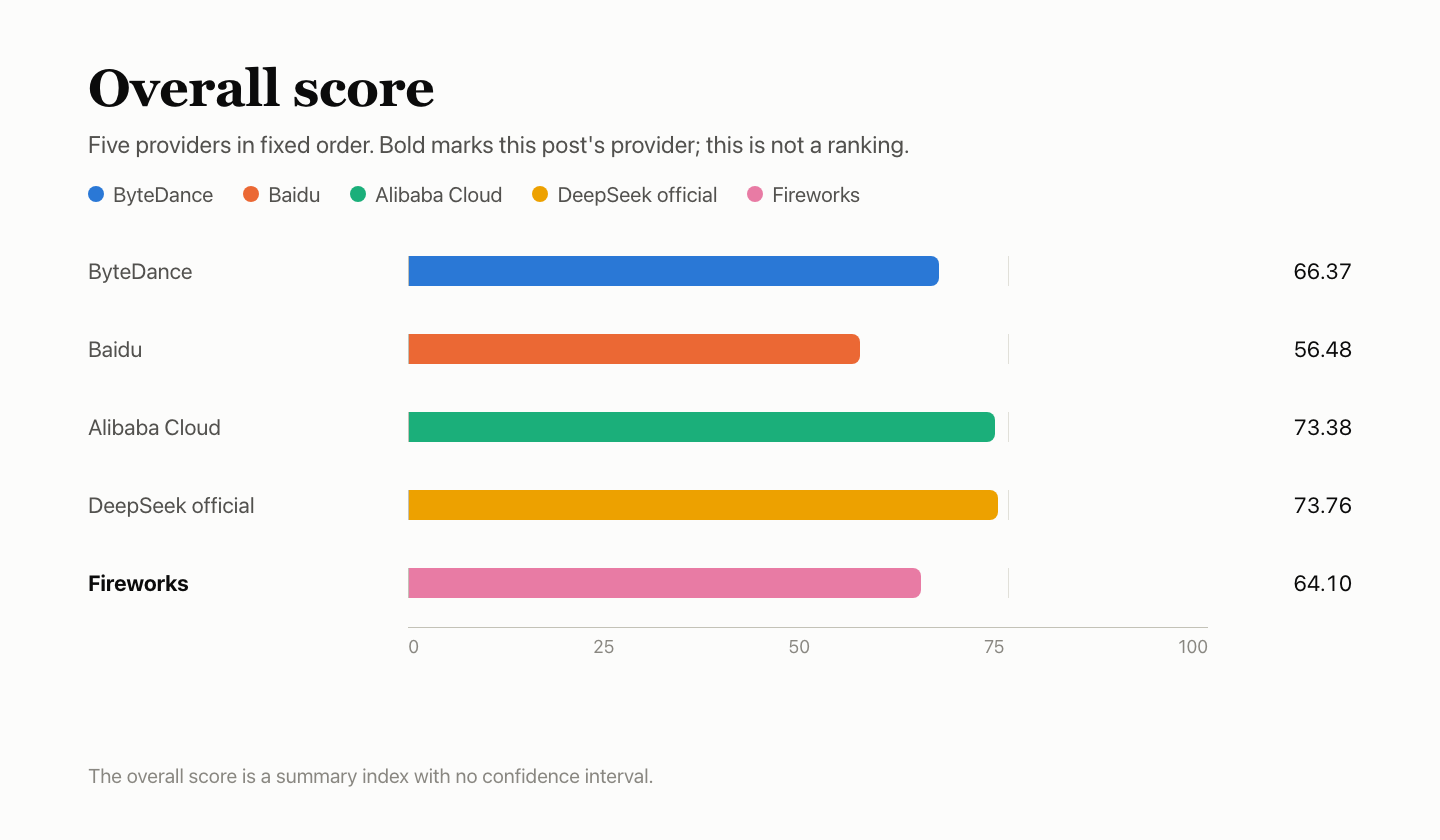
Оцінки: Q — 41.42, F — 71.78, P — 79.51, K — 60.68 і R — 100; загальний індекс — 64.10. У цій публікації наведено лише оцінки, без рейтингу чи рекомендацій щодо провайдера. Спершу подано Q, F, P, K і R; загальний індекс — підсумкове число без довірчого інтервалу. Стандарт — AIHubMix Provider Benchmark Standard v2.0.
Оцінки п’яти провайдерів
Жирним виділено провайдера, якому присвячено цю публікацію. Порядок провайдерів фіксований і не є рейтингом. K — субоцінка P із вагою 20%. Загальний індекс — підсумкове число без довірчого інтервалу. Різниця між офіційним каналом DeepSeek і Alibaba Cloud становить 0.37, тож розрізнити їх неможливо.
Короткий огляд
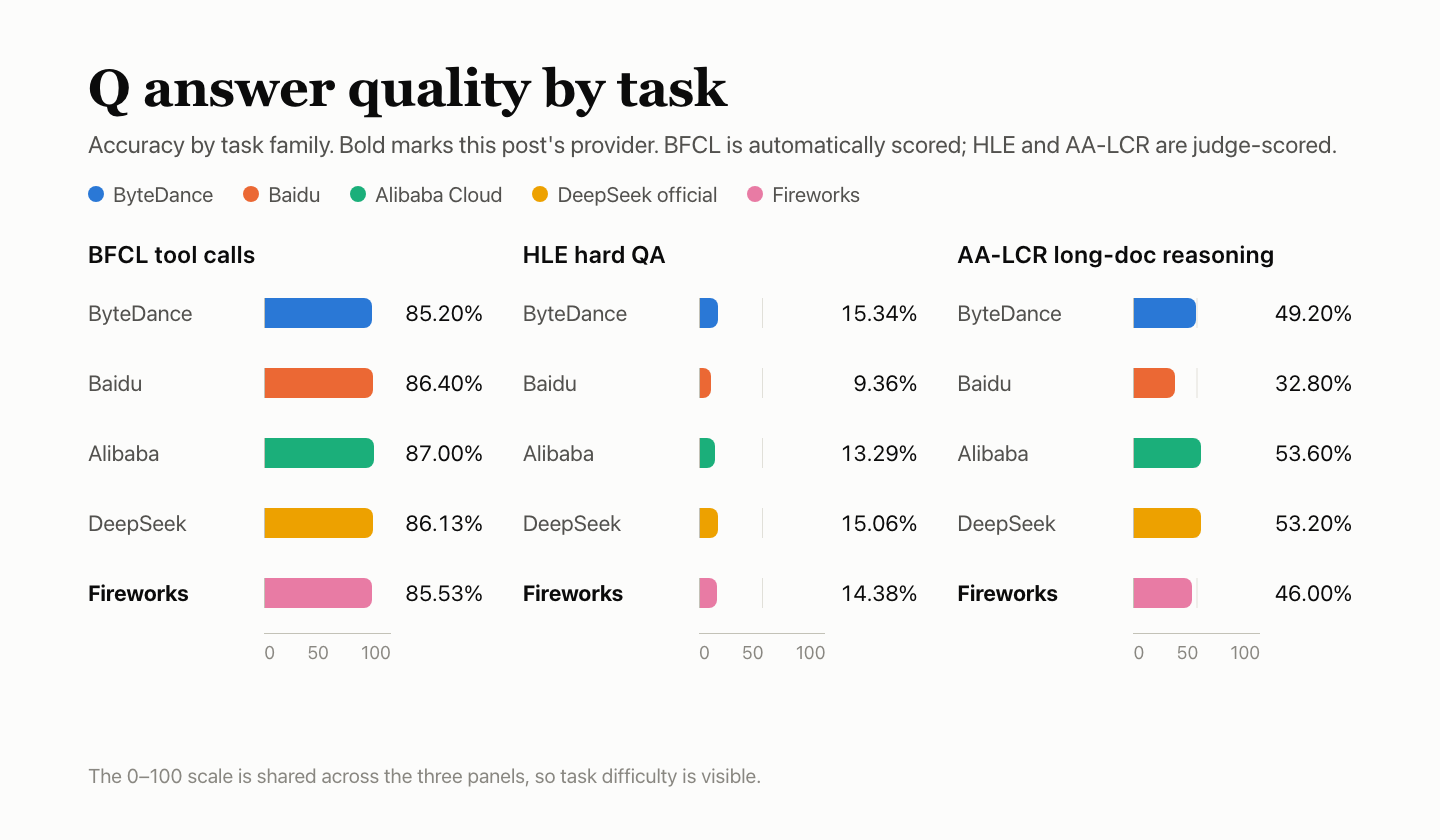
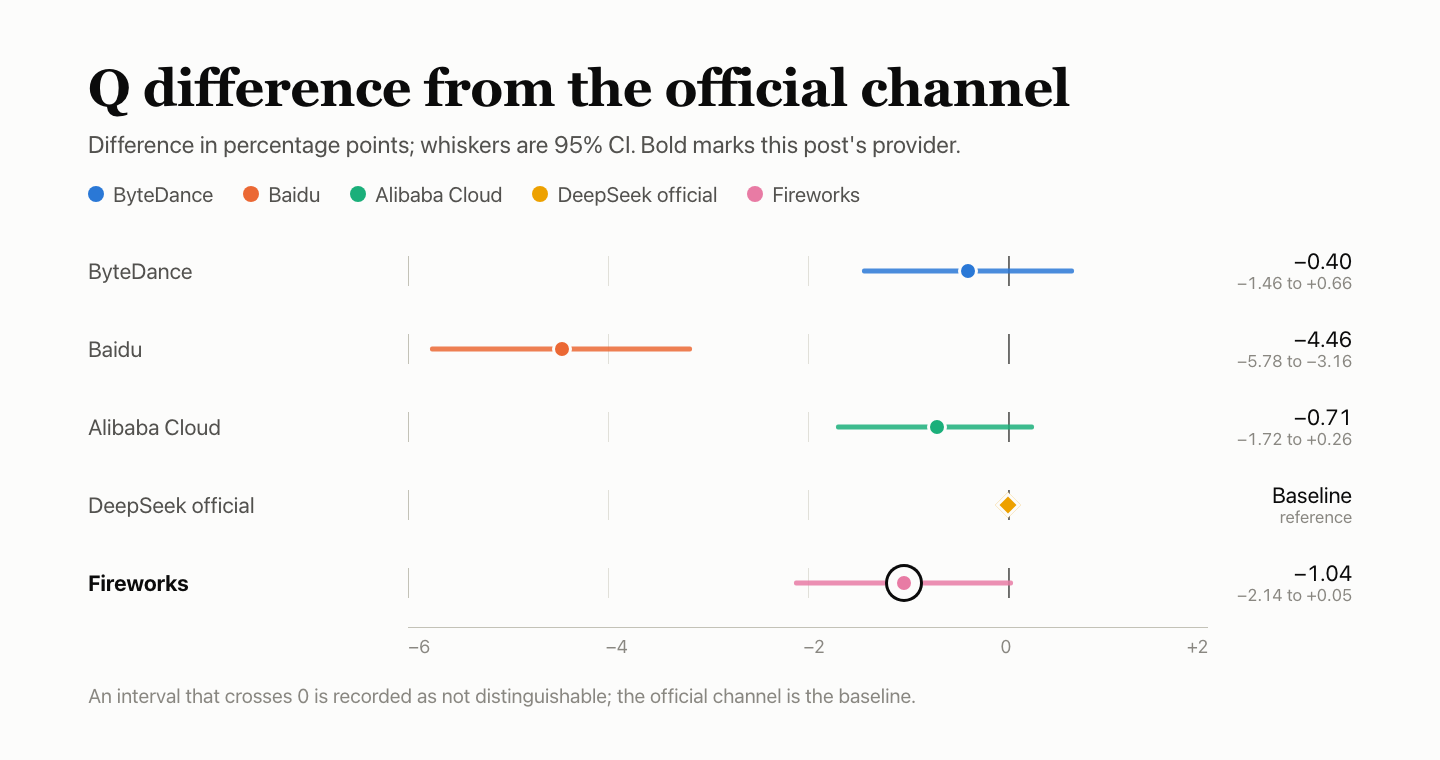
- Q — якість відповідей: 41.42. BFCL — 85.53%, HLE — 14.38%, AA-LCR — 46.00%. Порівняно з офіційним каналом: −1.04 відсоткового пункта, 95% ДІ від −2.14 до +0.05; різницю неможливо розрізнити. Усі 34 помилки AA-LCR припали на вікно 2 і були зараховані як неправильні відповіді.
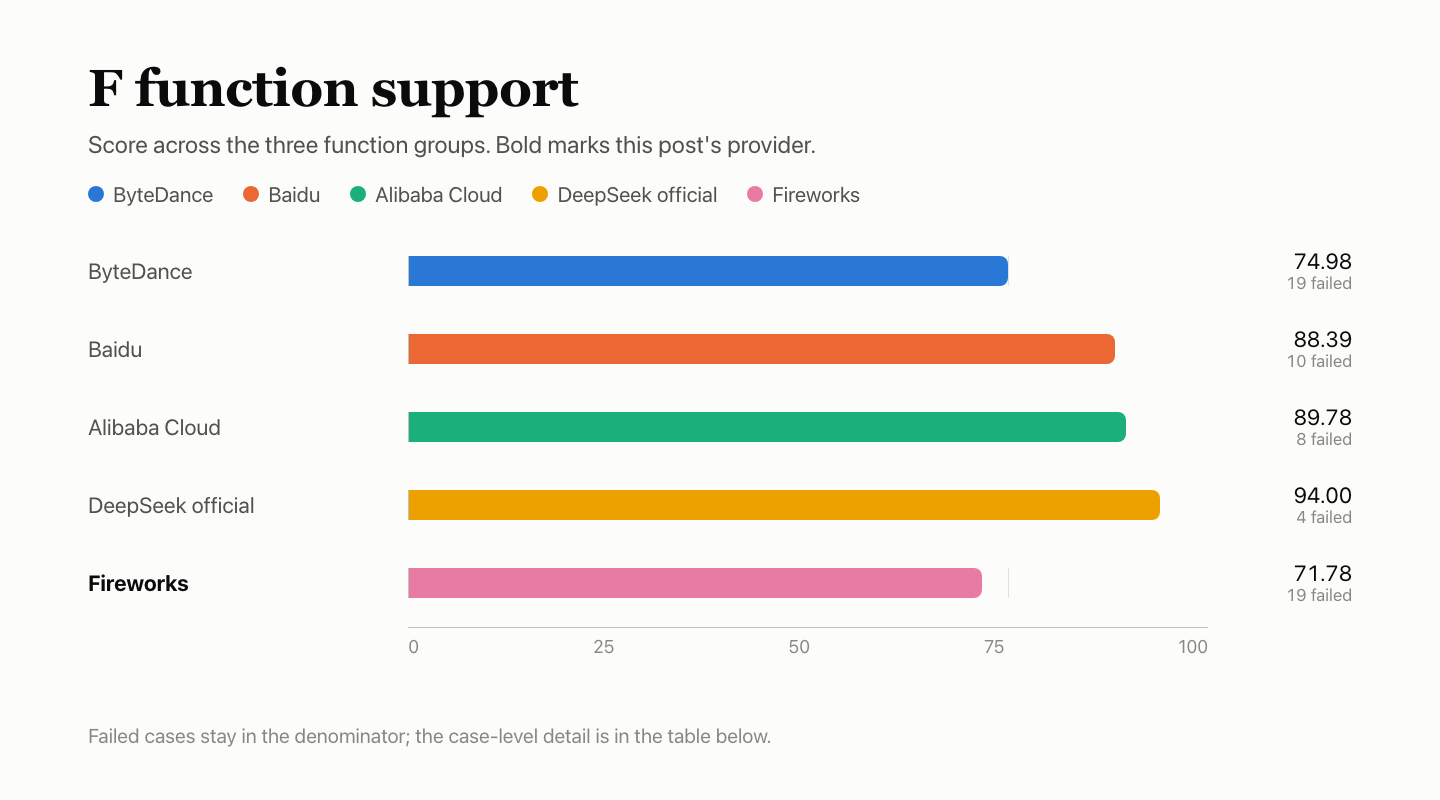
- F — підтримка функцій: 71.78. Із 177 врахованих перевірок пройдено 122. В обох випадках із stop повернулося порожнє тіло відповіді;
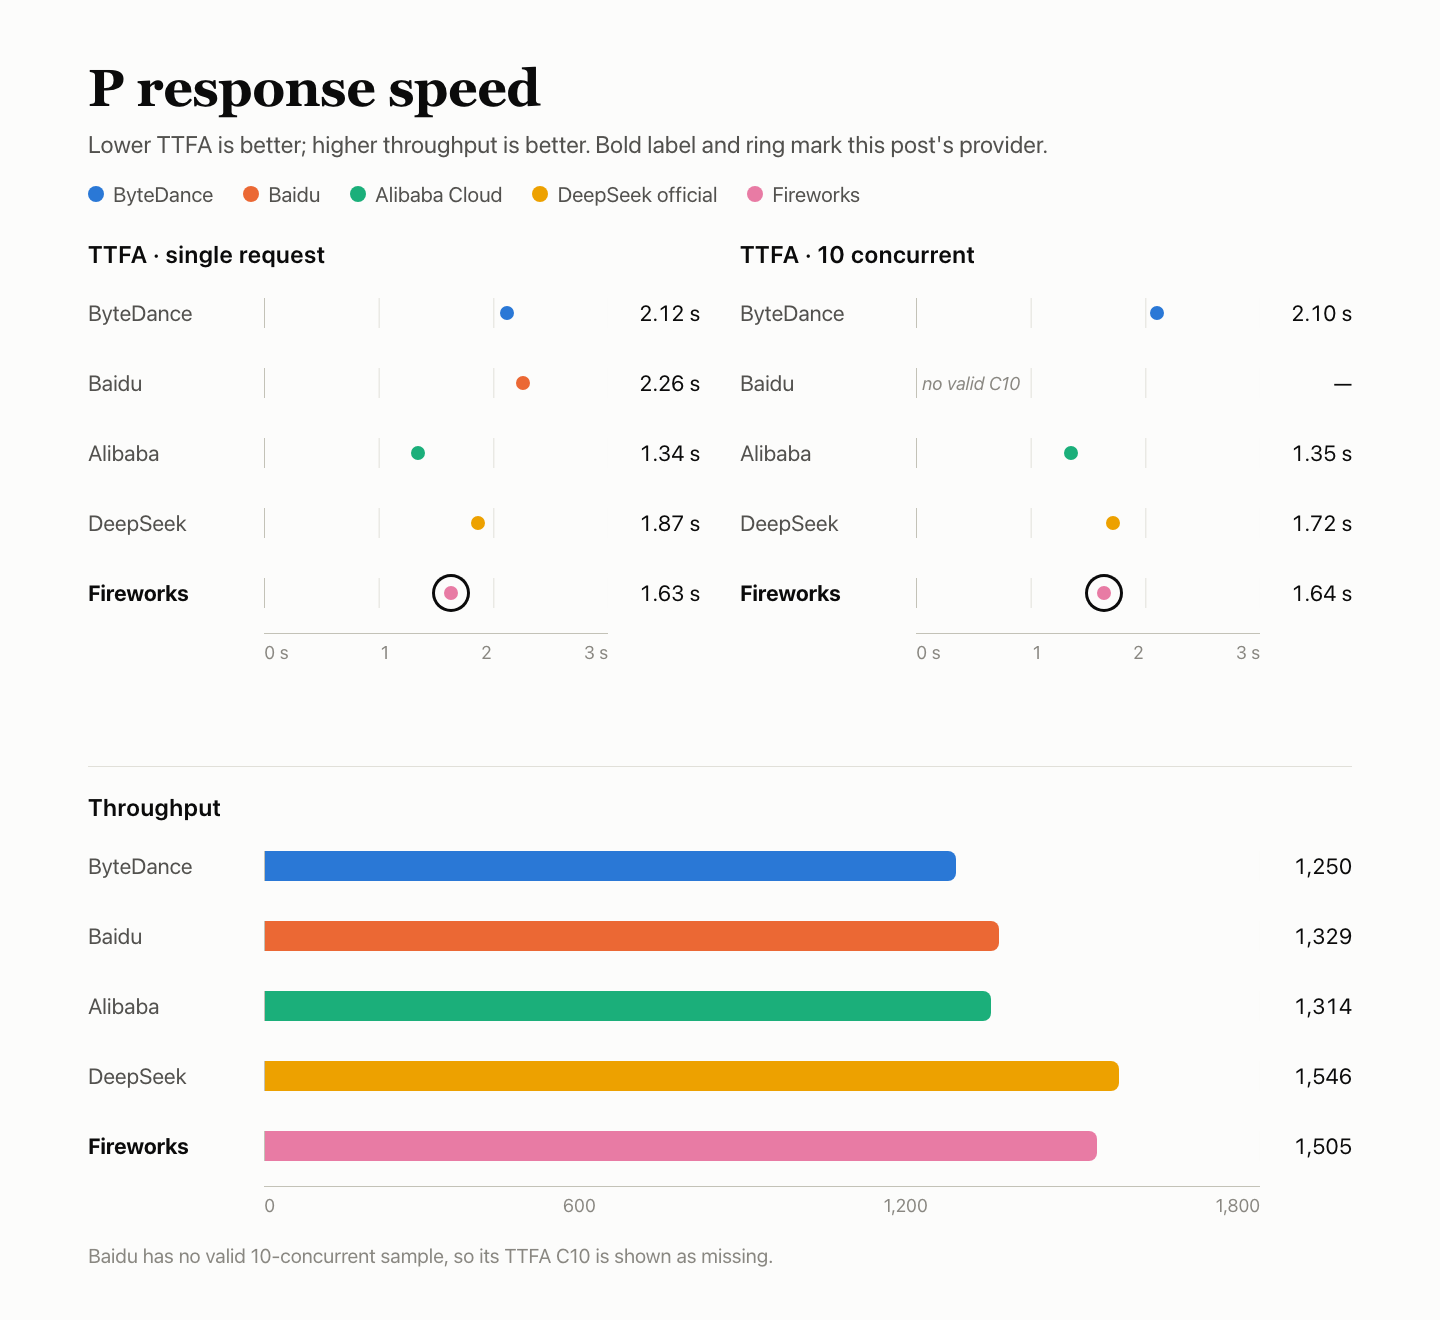
reasoning_effort=noneне вимкнув режим міркування; для вхідних даних обсягом 10k було повідомлено про 10,026 токенів замість нативного значення 10,000. - P — швидкість відповіді: 79.51. Оцінка швидкості відповіді — 84.22, K для кешу має вагу 20%. Медіана TTFA — 1.63 с за одного паралельного запиту й 1.64 с за 10; TPOT — 3.29 мс. Один зі 180 результатів складався з одного токена й був позначений як недійсний.
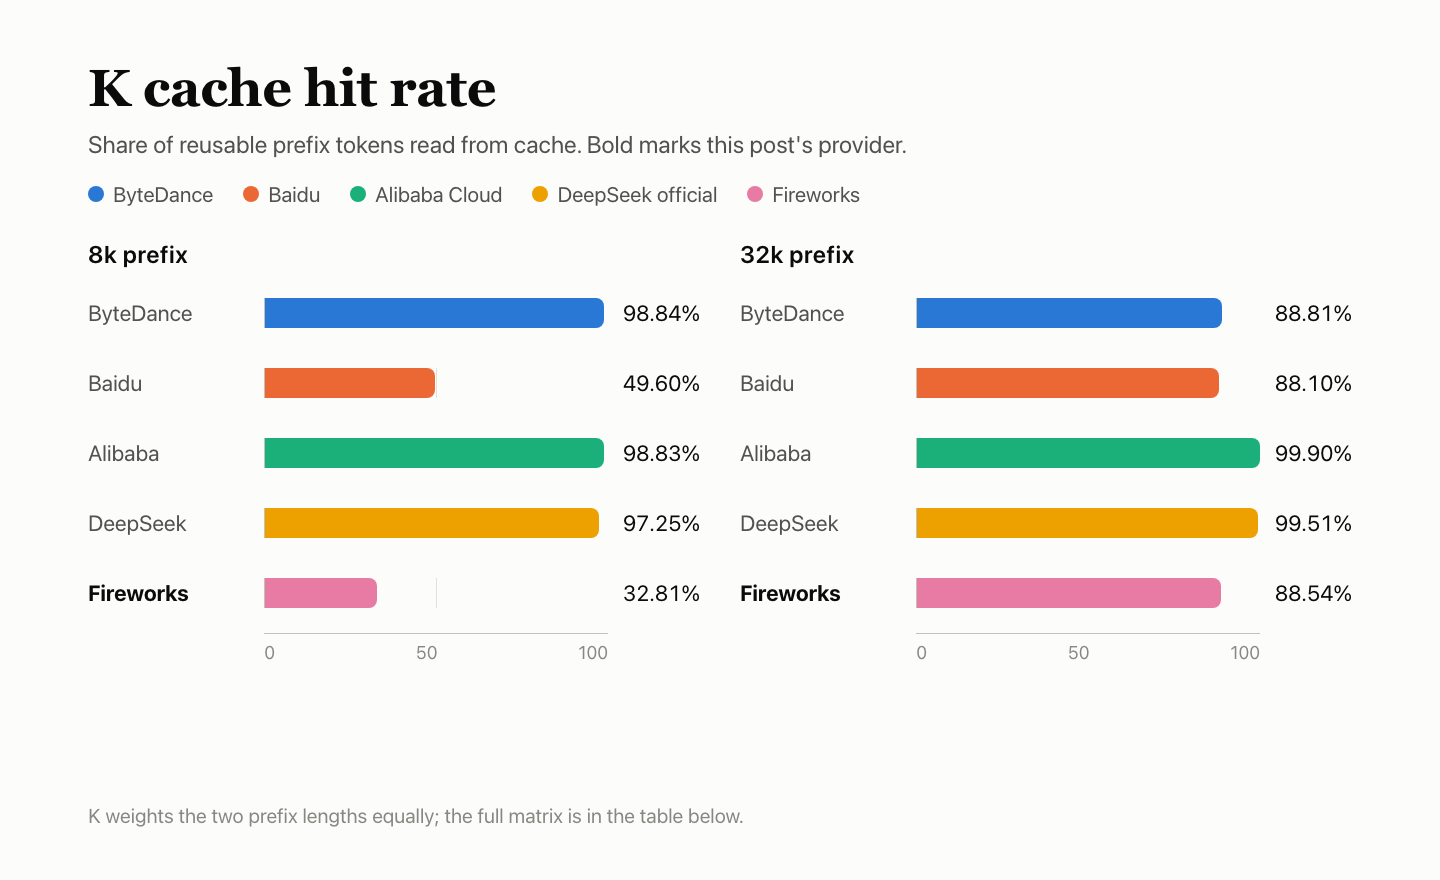
- K — кеш: 60.68. Для перевірок K використовувалася задокументована прив’язка до сесії. Для гарячого кешу 32k — 8/9; для гарячого кешу 8k — 3/9.
- R — стабільність сервісу: 100. Усі 300/300 спеціальних запитів виконалися з першої спроби.
Налаштування тестування
| Пункт | Налаштування |
|---|---|
| Модель | DeepSeek V4.1 Flash 1017 |
| Запитаний ID моделі | fireworks-deepseek-v4.1-flash-1017 |
| Повернена назва моделі | accounts/fireworks/models/deepseek-v4p1-flash-1017 |
| Маршрут доступу | ID моделі провайдера в AIHubMix, а не в обліковому записі самого провайдера |
| Параметри | Режим міркування вимкнено, temperature 1.0, max_tokens 16,384, тайм-аут 300 s, повторних спроб немає |
| Вимкнення режиму міркування | Нативний параметр thinking.type=disabled; reasoning_effort=none не вимикає режим міркування. У перевірках функцій залишено reasoning_effort=none. |
| Час | 2026-11-03 18:07 – 11-04 16:33 UTC+8. Один Mac mini, одна мережа й один обліковий запис для всіх п’яти провайдерів. |
| Вибірки | Q — 4,250 (BFCL 500×3, HLE 250×10, AA-LCR 25×10); F — 60×3; P — 90+90; R — 300; K — 30 |
| Додаткові налаштування | У перевірках K передавали задокументоване поле user і заголовок x-session-affinity для прив’язки до репліки. |
Запити виконували за допомогою короткого посібника AIHubMix; ID моделей наведено на сторінці моделей. Для вимкнення режиму міркування використовували нативний параметр thinking.type=disabled з документації API моделі.
Q — якість відповідей: 41.42
У наборі виконали 500 запитань BFCL × 3 раунди, 250 запитань HLE × 10 і 25 запитань AA-LCR × 10. BFCL оцінювали автоматично; HLE та AA-LCR оцінювала модель-суддя deepseek-flash. Усі п’ять провайдерів отримали однакові запитання. Десять відповідей, які неможливо було оцінити, вилучили; залишилося 4,240 оцінених прикладів.
| Завдання | Запитання | Правильні | Точність | Помилки |
|---|---|---|---|---|
| Виклики інструментів BFCL | 500 × 3 | 1,283/1,500 | 85.53% | 2 |
| Складні запитання й відповіді HLE | 250 × 10 | 358/2,490 | 14.38% | 5 |
| Міркування за довгими документами AA-LCR | 25 × 10 | 115/250 | 46.00% | 34 |
| Разом · 95% ДІ 39.13%–43.59% | — | 1,756/4,240 | 41.42% | 41 |
Помилки залишаються у знаменнику й рахуються як неправильні відповіді: BFCL — 2 (у вікнах 2 і 3), HLE — 5 відповідей, обрізаних через max_tokens, AA-LCR — 34, усі у вікні 2.
| Категорія BFCL | Пройдено | Частка проходження |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 268/300 | 89.33% |
| parallel | 270/300 | 90.00% |
| parallel_multiple | 206/240 | 85.83% |
| irrelevance | 111/150 | 74.00% |
| ahm_multi_turn | 95/150 | 63.33% |
simple_python пройдено у 333/360 випадках (92.50%), parallel — у 270/300 (90.00%), ahm_multi_turn — у 95/150 (63.33%), а irrelevance — у 111/150 (74.00%).
Порівняння з іншими чотирма провайдерами
Різниця у відсоткових пунктах порівняно з офіційним каналом; 95% інтервал показано вусами. Якщо він перетинає 0, різницю неможливо розрізнити. Модель-суддя deepseek-flash належить до тієї самої родини й не калібрована, тому може бути поблажливою.
F — підтримка функцій: 71.78
60 випадків утворюють шість груп, кожну з яких запускали у трьох вікнах: загалом 180 перевірок, оцінених відповідно до задокументованого формату провайдера. Непридатні, недійсні й неспостережувані перевірки не входять до знаменника. Із 177 врахованих перевірок пройдено 122; з урахуванням ваг груп підсумкова оцінка становить 71.78.
| Група випадків | Вага | Пройдено | Вилучено | Оцінка групи |
|---|---|---|---|---|
| Потокова передача й обмін повідомленнями | 20% | 24/30 | — | 80.00 |
| Інтерфейс інструментів | 20% | 29/30 | — | 96.67 |
| Обмеження виводу | 20% | 21/30 | — | 70.00 |
| Контекст і стан | 15% | 15/30 | — | 50.00 |
| Помилки й відновлення | 15% | 21/30 | — | 70.00 |
| Облік токенів і кеш | 10% | 12/27 | 3 | 44.44 |
| Разом · з урахуванням ваг | — | 122/177 | 3 | 71.78 |
«Невдалі вікна» — це кількість вікон, у яких випадок не пройшов перевірку.
| Невдалий випадок | Невдалі вікна | Причина |
|---|---|---|
| Зупинка потокової передачі | 3/3 | Зі stop — порожнє тіло відповіді; без stop працює. |
| Міркування в тілі відповіді | 3/3 | reasoning_effort=none усе одно повертав міркування. |
| Послідовність зупинки | 3/3 | Зі stop — порожнє тіло відповіді; без stop працює. |
| Налаштування режиму міркування | 3/3 | reasoning_effort=none усе одно повертав міркування. |
| Різноманітність семплювання | 3/3 | Temp 0/1 — надто схожі результати |
| Довгий вхід 10k | 3/3 | Повідомлено про 10,026; нативне значення — 10,000. |
| У межах ліміту контексту | 3/3 | Повідомлено про 10,026; нативне значення — 10,000. |
| Довгий вхід 32k | 3/3 | Повідомлено про 10,026; нативне значення — 10,000. |
| Довгий вхід 100k | 3/3 | Повідомлено про 10,026; нативне значення — 10,000. |
| Перевищення контексту | 3/3 | Мала бути помилка параметра; повернуто 200. |
| Некоректні повідомлення | 3/3 | 400, порожнє тіло відповіді |
| Результат інструмента без запиту | 3/3 | Мала бути помилка параметра; повернуто 200. |
| Некоректний stream_options | 3/3 | 400, порожнє тіло відповіді |
| Облік токенів міркування | 3/3 | Після вимкнення повідомляли про токени міркування. |
| Нативний підрахунок вхідних токенів | 3/3 | Повідомлено про 34; нативне значення — 8. |
| Визначення інструментів у вхідних даних | 3/3 | Контрольний запит без інструментів уже давав розбіжність. |
| Підрахунок вхідних токенів із кешем | 3/3 | Підрахунок повторного префікса не збігся з нативним. |
| Збіг вхідних даних у потоковій передачі | 3/3 | Повідомлено про 34; нативне значення — 8 |
| Один інструмент за раз | 1/3 | Помилка upstream 500. |
В обох випадках зі stop поверталося порожнє тіло відповіді, тоді як той самий запит без stop працював — у всіх трьох вікнах. У випадках обох перевірок режиму міркування reasoning_effort=none однаково повертав міркування.
Вилучені перевірки не зараховуються ні як пройдені, ні як невдалі.
| Статус | Випадок | Кількість | Причина |
|---|---|---|---|
| Не застосовується | Явний cache_control | 3 | Заздалегідь визначено як непідтримуваний цим інтерфейсом |
У всіх п’яти провайдерів некоректні messages і stream_options спричиняли помилку: 400 із порожнім тілом відповіді та без структурованої помилки. Імовірніше за все, спільний результат пов’язаний із рівнем шлюзу AIHubMix, який потребує окремого розслідування. Облік токенів міркування також не пройшов перевірку в усіх п’яти, але ByteDance і Fireworks повідомляли про токени міркування після вимкнення, тоді як інші три не повертали їх кількість.
Порівняння з іншими чотирма провайдерами
P — швидкість відповіді: 79.51
Кожен запит містив приблизно 10,000 вхідних токенів і запитував приблизно 1,100 вихідних токенів. У кожному з трьох вікон надсилали 30 запитів за одного паралельного запиту та 30 — за 10 паралельних, загалом 180.
| Метрика | Результат |
|---|---|
| TTFA | 1.63 с за одного паралельного запиту; 1.64 с за 10 |
| TPOT | 3.24 мс за одного паралельного запиту; 3.29 мс за 10 |
| Корисна пропускна здатність | 1,504.5 токена/с за 10 паралельних запитів |
| Коректні | 90/90 за одного паралельного запиту; 89/90 за 10 (29/30 у вікні 3), один результат з одним токеном |
| Компоненти | TTFA 54.91, TPOT 100.00, корисна пропускна здатність 100.00; ваги 35/35/30 |
| Складові P | 84.22 × 80% + 60.68 × 20% = 79.51 |
Із 180 результатів 179 були коректними; недійсний запит повернув один токен і в медіанах враховується як нескінченність, тому медіани можуть бути вищими, ніж лише для коректних запитів. TPOT розраховується за фрагментами потокової передачі; корисна пропускна здатність — це кількість коректних вихідних токенів за 10 паралельних запитів, поділена на тривалість пакета.
Одна машина, одна мережа й один обліковий запис; вікна для провайдерів призначали за розкладом.
K — кеш: 60.68
Кожна група складається з п’яти запитів: спочатку створюється префікс 8k або 32k, потім той самий префікс із новим фінальним запитанням через 5 с, 30 с і 120 с, а тоді — новий префікс як контрольний запит без кешу. Три вікна × два розміри = 30 запитів. K — це кількість прочитаних із гарячого кешу токенів, поділена на кількість токенів, доступних для повторного використання; обидва розміри мають однакову вагу. K становить 20% оцінки P.
| Префікс | Вікно | Початковий запит | +5 s | +30 s | +120 s | Контрольний запит без кешу |
|---|---|---|---|---|---|---|
| 8k | Вікно 1 | 0 | 7,900 | 0 | 7,900 | 0 |
| 8k | Вікно 2 | 0 | 7,906 | 0 | 0 | 0 |
| 8k | Вікно 3 | 0 | 0 | 0 | 0 | 0 |
| 32k | Вікно 1 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | Вікно 2 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | Вікно 3 | 0 | 31,900 | 31,900 | 0 | 0 |
Префікс 8k спрацював у 3 із 9 запитів із кешем: було прочитано 23,706 із 72,252 токенів, придатних для повторного використання, для 32.81. Префікс 32k спрацював у 8 із 9 запитів: було прочитано 255,212 із 288,261 для 88.54. K становить 60.68, якщо однаково зважити обидві довжини. Контрольні запити без кешу прочитали 0. Отже, за однакової схеми префікси різної довжини показали різні результати. У запитах для вимірювання K використовували задокументоване поле user і заголовок x-session-affinity.
R — стабільність сервісу: 100
У трьох вікнах на конкурентності 1 виконано 300 запитів: короткий текст, довгий ввід, виклики інструментів і багатокрокова історія. Перевіряли лише валідність і повноту першої відповіді; відповіді не оцінювали, повторних спроб не було. Збої Q і P тут повторно не враховуються.
| Тип запиту | Успіх із першої спроби |
|---|---|
| Короткий текст | 120/120 |
| Довгий ввід 10k | 90/90 |
| Виклик інструменту | 60/60 |
| Багатокрокова історія | 30/30 |
| Разом · 95% довірчий інтервал 98.78%–100% | 300/300 |
Усі 300 запитів із першої спроби повернули валідну й повну відповідь. За 300 успішних запитів нижня межа 95% довірчого інтервалу становить 98.78%, тож дані підтверджують лише те, що частка збоїв нижча за 1.22%. R 100 стосується цих 300 запитів, а не всього шляху.
| Провайдер | Успіх із першої спроби | 95% довірчий інтервал |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek official | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Поширені запитання
Що охоплює Q 41.42?
BFCL, HLE та AA-LCR на 4,240 оцінених прикладах: 1,756 правильних, 41.42%, 95% ДІ 39.13%–43.59%; різниця порівняно з офіційним каналом статистично не розрізняється.
Чому обидва випадки зі stop завершилися помилкою?
Запит із stop повернув порожнє тіло в усіх трьох вікнах, тоді як той самий ввід без stop спрацював. Це спостерігалося і в потоковому, і в непотоковому режимі.
Чи вимикає reasoning_effort=none мислення?
Ні. В усіх трьох вікнах модель усе одно повертала вміст міркувань; в інших запитах використовували нативне налаштування thinking.type=disabled.
Чому ввід 10k зазначено як 10,026 токенів?
Для випадку 10k було зазначено 10,026 токенів замість нативних 10,000. У випадках 32k і 100k зазначалося те саме значення — 10,026, а розбіжність була й у контрольному запиті без інструментів.
Чому для 8k влучення в кеш було 3/9, а для 32k — 8/9?
Для обох використовували однакову схему й задокументовані налаштування прив’язки до сеансу. Різниця — у даних про читання, повідомлених сервером: для 8k влучення в кеш були у вікнах 1 і 2, а для 32k — в усіх трьох.
Що охоплює R 100?
300 окремих запитів — усі валідні з першої спроби; нижня межа 95% довірчого інтервалу становить 98.78%. Збої Q і P не враховуються в R.
Читайте далі: серія DeepSeek V4.1 Flash
- ByteDance, як і Fireworks, повідомляв про токени мислення після його вимкнення: DeepSeek V4.1 Flash на ByteDance: виклики інструментів збігаються, облік — ні
- Для Baidu зафіксовано Q 38.00 і P 37.77: DeepSeek V4.1 Flash на Baidu: жоден доступний канал не досягає Q і P
- Для Alibaba Cloud зафіксовано перший токен за 1.34 s і кеш 99.37: DeepSeek V4.1 Flash на Alibaba Cloud: перший токен за 1.34s, кеш 99.37
- Офіційний канал є базовим для Q, а F становить 94.00: DeepSeek V4.1 Flash в офіційному каналі: F 94.00, 15 невалідних перевірок


