

3–4 листопада 2026 року DeepSeek V4.1 Flash 1017 протестували у п’яти провайдерів через AIHubMix за допомогою повного набору APB: щоразу використовували ті самі запитання, параметри та сценарії запитів. Цей профіль APB охоплює лише запуск на Baidu і розбирає його за розділами.
Наведені нижче числа — лише оцінки, а не рейтинг і не рекомендація провайдера. Спершу наведено Q 38.00, F 88.39, P 37.77, K 68.85 і R 100; загальний показник 56.48 — це зведений індекс без довірчого інтервалу. Правила оцінювання відповідають стандарту AIHubMix Provider Benchmark Standard v2.0.
Оцінки п’яти провайдерів
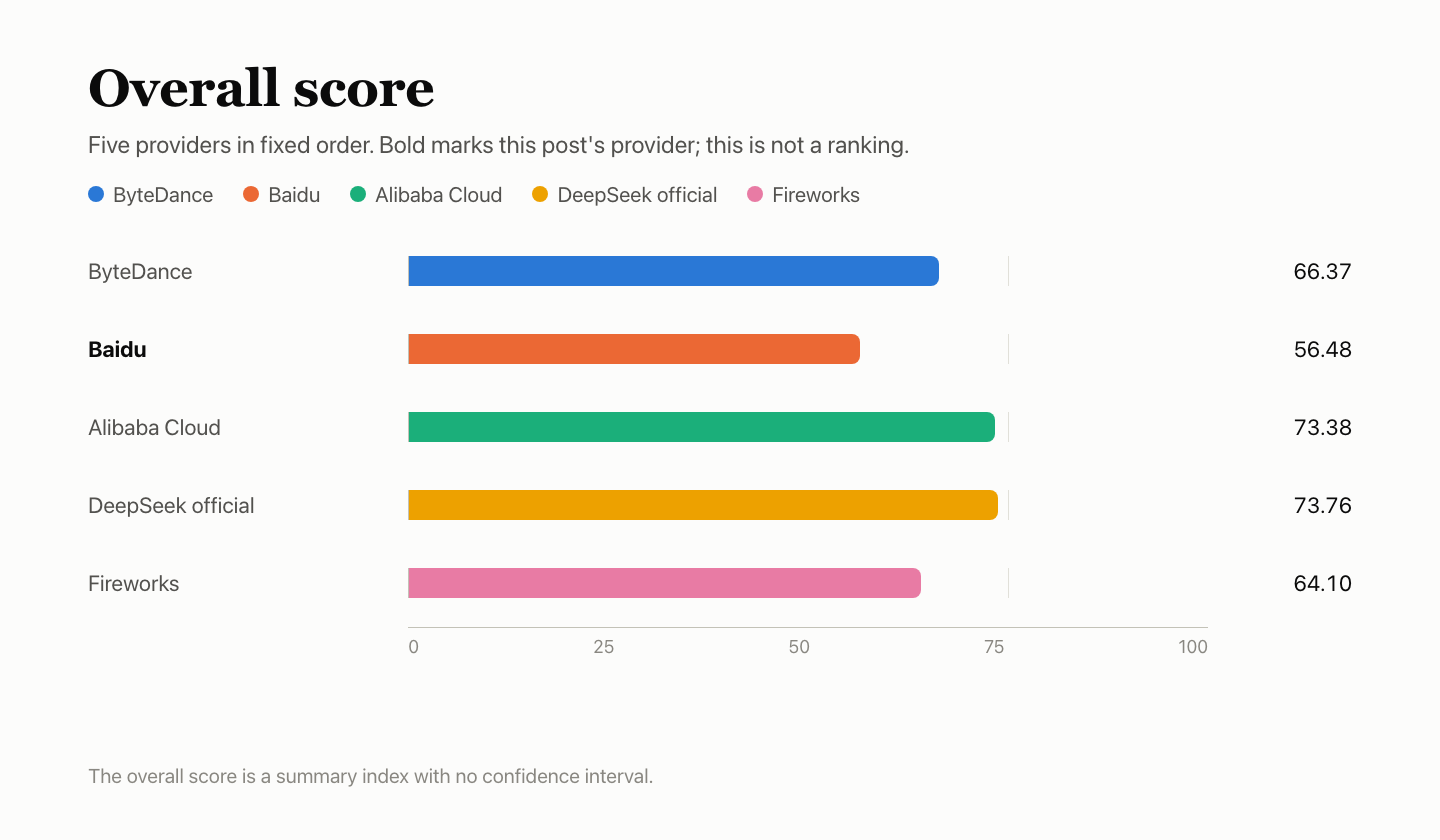
Жирним шрифтом позначено провайдера, якому присвячено цю публікацію. Провайдери наведені в незмінному порядку, а не за рейтингом. K — це субоцінка P із вагою 20%. Загальний показник — зведений індекс без довірчого інтервалу. Різниця між офіційним каналом і Alibaba Cloud становить 0.37 та статистично не розрізняється.
Короткий огляд
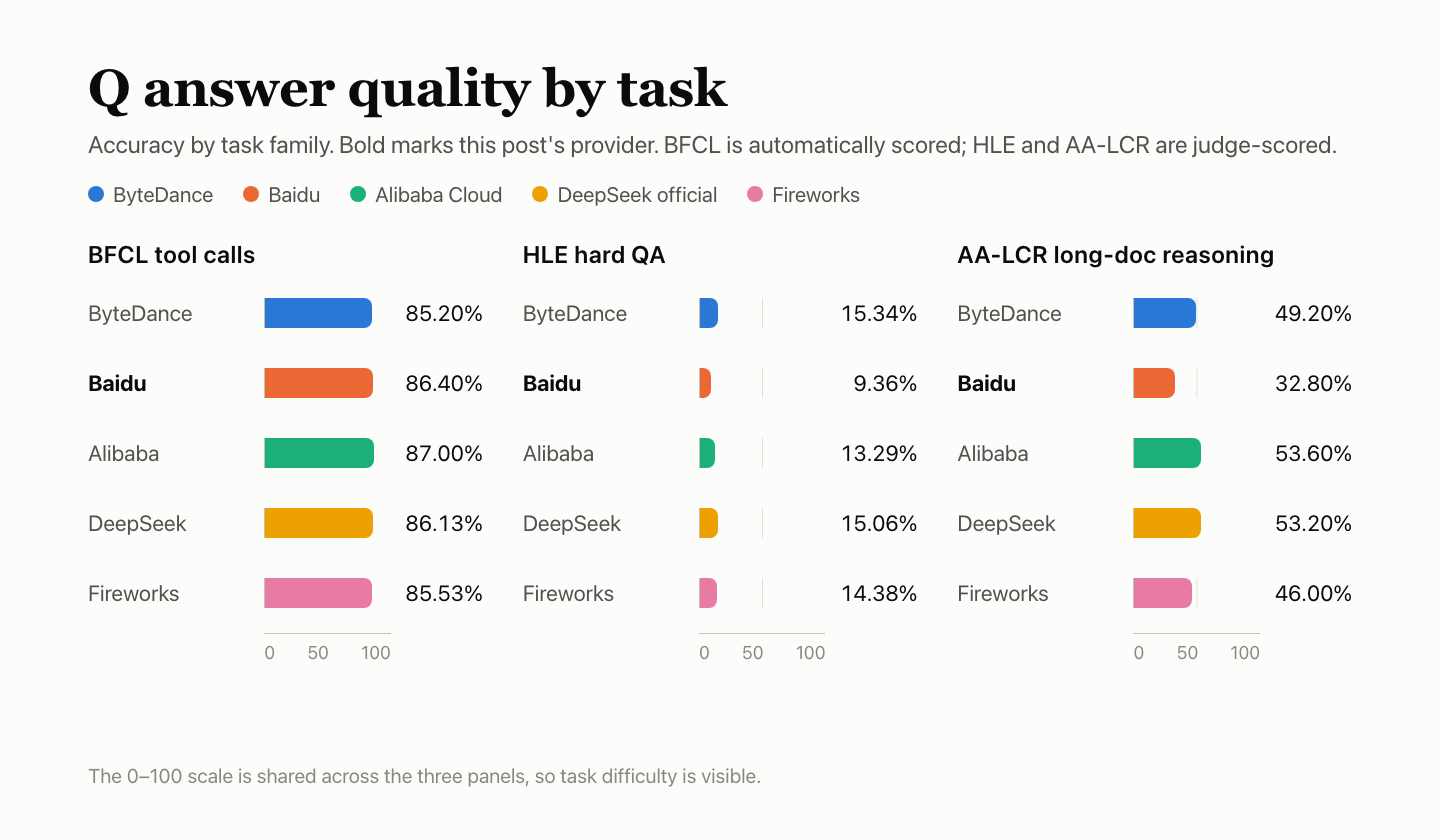
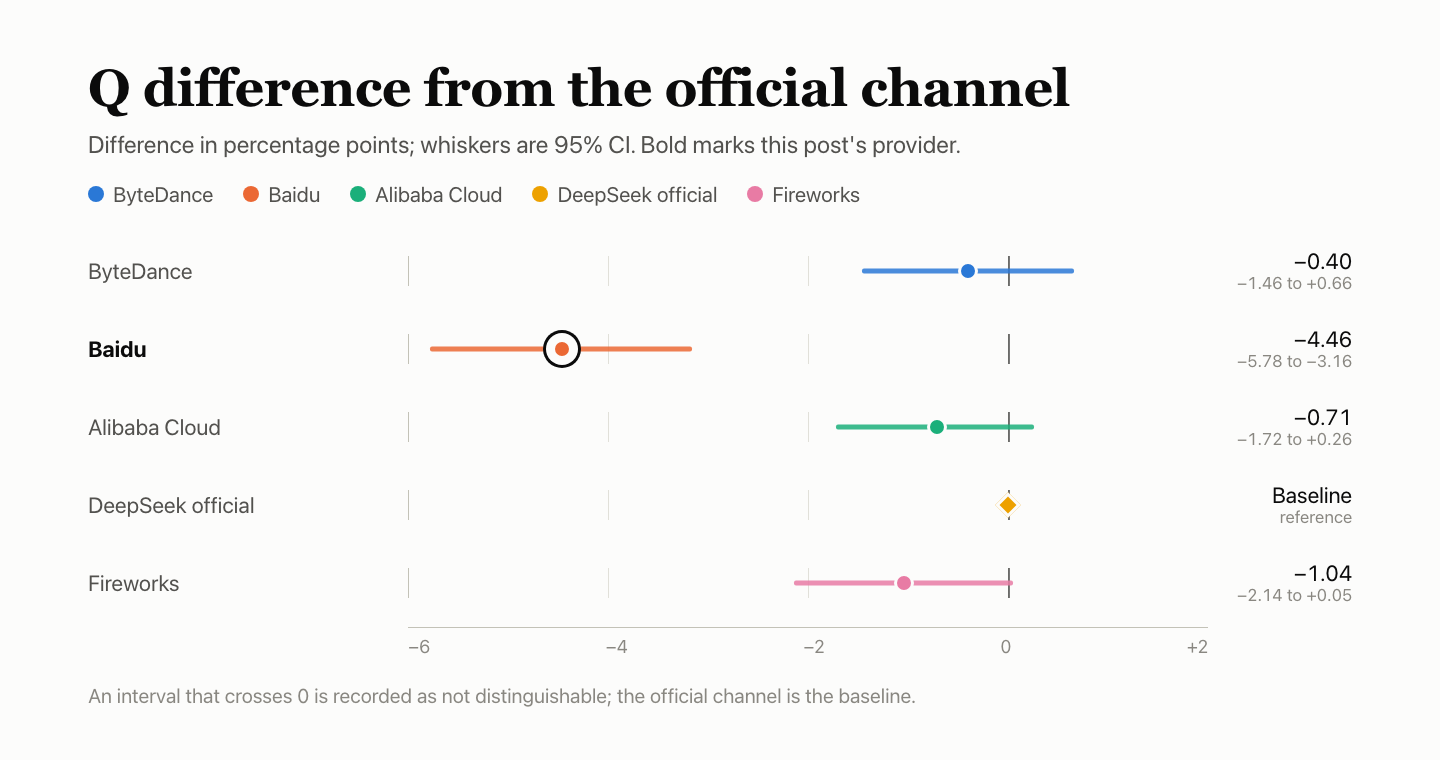
- Q: 38.00. BFCL — 86.40%, HLE — 9.36%, AA-LCR — 32.80%. Сукупний результат на 4.46 бала нижчий, ніж в офіційного каналу; 95% інтервал від −5.78 до −3.16 не охоплює 0. Зафіксовано 864 помилки запитів у HLE та 100 в AA-LCR — майже всі в першому вікні; їх зараховано як неправильні відповіді.
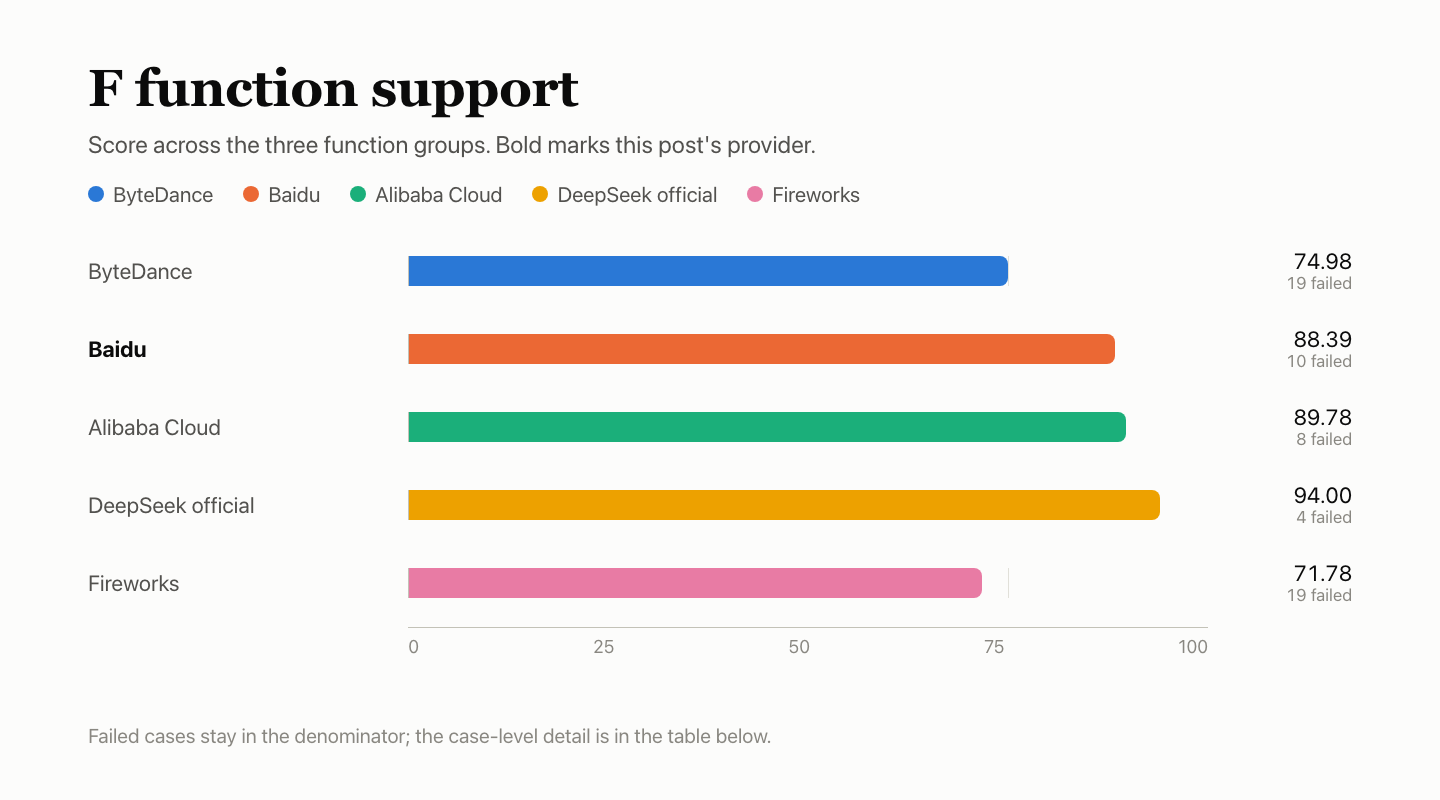
- F: 88.39. Із 174 перевірок, що враховувалися, пройдено 148. Поле зчитування кешу та кількість токенів міркування не повернулися; випадки перевищення контексту й осиротілого результату інструмента повернули код 200.
- P: 37.77. 50 із 90 тестових запитів із десятьма паралельними запитами повернули
no_available_channel, тож понад половина виявилася недійсною, а TTFA і TPOT отримали штрафні значення. За одного паралельного запиту дійсними були 78 із 90 тестів. - K: 68.85. Для гарячих запитів із префіксом 8k кеш спрацював 5 із 9 разів, а 3 запити завершилися помилками; для префікса 32k кеш спрацював 8 із 9 разів. Влучення в кеш звітуються блоками по 1,024 токени: 7,168 токенів для 8k і 31,744 для 32k.
- R: 100. Усі 300 спеціальних запитів успішно виконалися з першої спроби. Помилки каналу під час відповідей і перевірок швидкості враховуються в Q і P.
Налаштування тестування
Для запитів використовувався маршрут AIHubMix швидкого старту з ідентифікатором конкретного провайдера; параметри відповідають документації API DeepSeek. Ідентифікатори інших провайдерів наведено на сторінці моделей. Це не пряме підключення до власного облікового запису Baidu.
| Поле | Значення |
|---|---|
| Модель | DeepSeek V4.1 Flash 1017 |
| Запитаний ID моделі | baidu-deepseek-v4.1-flash-1017 |
| Повернуте ім’я моделі | deepseek-v4.1-flash-1017 |
| Маршрут доступу | Через AIHubMix з ідентифікатором моделі конкретного провайдера; не пряме підключення до власного облікового запису провайдера |
| Параметри | Режим міркування вимкнено, temperature 1.0, max_tokens 16,384, тайм-аут 300 s, автоматичні повторні спроби вимкнено |
| Міркування вимкнено | У кожному запиті використовувався параметр reasoning_effort=none |
| Час | 2026-11-03 18:07 – 11-04 16:33 UTC+8; усі п’ять провайдерів використовували один Mac mini, мережу й обліковий запис |
| Вибірки | 4,250 спроб отримання відповідей (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10); 60 випадків роботи з функціями × 3 вікна; 90 тестів швидкості з одним паралельним запитом і 90 — з десятьма; 300 запитів для перевірки стабільності; 30 тестів кешу (по три групи для префіксів 8k і 32k) |
Q — якість відповідей: 38.00
Якість відповідей оцінюється на трьох типах завдань: 500 завдань BFCL із трьома спробами для кожного, 250 завдань HLE із десятьма спробами та 25 завдань AA-LCR із десятьма спробами. BFCL оцінюється за автоматичними правилами; у HLE й AA-LCR суддівська модель deepseek-flash визначає, чи правильна відповідь. Усі п’ять провайдерів отримали однаковий набір завдань, а результати трьох типів об’єднано в один показник точності. Десять відповідей вилучили, бо їх неможливо було оцінити, тож загалом оцінено 4,240 спроб.
| Завдання | Пункти | Правильно | Точність | Помилки |
|---|---|---|---|---|
| Виклики інструментів BFCL | 500 × 3 | 1,296/1,500 | 86.40% | 0 |
| Складні запитання HLE, оцінені суддею | 250 × 10 | 233/2,490 | 9.36% | 875 |
| Міркування за довгими документами AA-LCR | 25 × 10 | 82/250 | 32.80% | 100 |
| Сукупний результат · 95% інтервал 36.23%–39.58% | — | 1,611/4,240 | 38.00% | 975 |
Помилки сервісу — як невдалі запити, так і обрізані відповіді — залишаються в знаменнику й зараховуються як неправильні відповіді. У HLE було 864 помилки запитів (863 у першому вікні, 1 у другому) та 11 відповідей, обрізаних через обмеження max_tokens. В AA-LCR було 100 помилок запитів — усі в першому вікні.
Кожне завдання BFCL виконується тричі; у таблиці наведено сукупні результати трьох раундів.
| Категорія BFCL | Пройдено | Частка проходження |
|---|---|---|
| simple_python: одна функція, правильний виклик і аргументи | 336/360 | 93.33% |
| multiple: вибрати правильну функцію з кількох | 269/300 | 89.67% |
| parallel: паралельно викликати одну функцію кілька разів | 268/300 | 89.33% |
| parallel_multiple: паралельно викликати кілька різних функцій | 206/240 | 85.83% |
| irrelevance: не викликати функцію, якщо жодна не підходить | 113/150 | 75.33% |
| ahm_multi_turn: триетапний ланцюжок викликів інструментів | 104/150 | 69.33% |
Порівняння з іншими чотирма
Різницю в процентних пунктах наведено відносно офіційного каналу, а 95% інтервал позначено вусами. Інтервал, що перетинає 0, вважається статистично нерозрізнюваним. Суддівська модель для HLE й AA-LCR, deepseek-flash, належить до тієї самої родини DeepSeek, що й тестована модель, і не проходила калібрування, тож її оцінки можуть бути поблажливими.
F — підтримка функцій: 88.39
Тести функцій перевіряють, чи відповідає робота інтерфейсу специфікації протоколу, а не якість відповідей моделі. Шістдесят випадків із шести груп запускали по одному разу в кожному з трьох вікон — загалом 180 перевірок, які оцінювали відповідно до формату, задокументованого провайдером. Перевірки, що були незастосовними, недійсними або не спостерігалися, вилучали зі знаменника. Для Baidu врахували 174 перевірки; 148 пройдено, що дає зважену оцінку 88.39.
Оцінка групи визначається з урахуванням її частки у вазі, а не простим діленням 148 на 174.
| Група випадків | Вага | Пройдено | Вилучено | Оцінка групи |
|---|---|---|---|---|
| Потокова передача й протокол повідомлень | 20% | 27/27 | 3 | 100.00 |
| Інтерфейс інструментів | 20% | 30/30 | — | 100.00 |
| Обмеження виводу й параметри | 20% | 29/30 | — | 96.67 |
| Контекст і стан | 15% | 26/30 | — | 86.67 |
| Помилки й відновлення | 15% | 21/30 | — | 70.00 |
| Облік і протокол кешу | 10% | 15/27 | 3 | 55.56 |
| Разом, зважена оцінка | 100% | 148/174 | 6 | 88.39 |
| Невдалий випадок | Вікна з помилкою | Причина |
|---|---|---|
| Перевищення контексту (контекст і стан) | 3/3 | Мав повернути помилку параметра; повернув 200 |
| Некоректні повідомлення (помилки й відновлення) | 3/3 | Повернув 400 із порожнім тілом, без структурованої помилки |
| Осиротілий результат інструмента (помилки й відновлення) | 3/3 | Мав повернути помилку параметра; повернув 200 |
| Некоректний stream_options (помилки й відновлення) | 3/3 | Повернув 400 із порожнім тілом, без структурованої помилки |
| Поле зчитування кешу (облік і протокол кешу) | 3/3 | Поле зчитування кешу не повернулося; підтвердити результат неможливо |
| Облік токенів міркування (облік і протокол кешу) | 3/3 | Кількість токенів міркування не повернулася |
| Означення інструментів враховуються у вхідних даних (облік і протокол кешу) | 3/3 | За наявності означень інструментів кількість вхідних токенів у звіті не була більшою, ніж без них |
| Узгодженість кількості вхідних токенів до й після кешування (облік і протокол кешу) | 3/3 | Поле зчитування кешу не повернулося; підтвердити результат неможливо |
| Різноманітність семплювання (обмеження виводу й параметри) | 1/3 | Повторні відповіді за temperature 0 і 1 відрізнялися надто мало — нижче за попередньо зареєстрований поріг |
| Ізоляція між запитами (контекст і стан) | 1/3 | На першому кроці не надійшла єдина очікувана відповідь STORED, тож перевірку ізоляції не вдалося продовжити |
Ці перевірки вилучено зі знаменника: вони не вважаються ані пройденими, ані невдалими.
| Статус | Випадок | Кількість | Причина |
|---|---|---|---|
| Не спостерігався | Послідовність зупинки потокової передачі | 3 | Запит для цього кроку не було надіслано після попереднього, тому оцінити його неможливо |
| Не застосовується | Явний cache_control | 3 | Попередньо зареєстровано як непідтримуваний цим інтерфейсом |
Некоректні messages і некоректний stream_options не спрацювали в усіх п’яти провайдерів: обидва випадки повертали 400 із порожнім тілом, не надаючи клієнту структурованої помилки. Помилка, спільна для всіх п’яти, найімовірніше виникає на рівні шлюзу AIHubMix і потребує окремого розслідування. Облік токенів міркування також не пройшов перевірку в усіх п’яти, але з різних причин: ByteDance і Fireworks повідомляли про токени міркування, навіть коли міркування було вимкнено, а решта трьох не повертали їхню кількість.
Порівняння з іншими чотирма
P — швидкість відповіді: 37.77
Кожен запит містив близько 10,000 вхідних токенів і запитував відповідь обсягом приблизно 1,100 вихідних токенів. У кожному з трьох вікон надсилали по 30 тестів з одним паралельним запитом і по 30 — з десятьма, загалом 180 запитів.
| Метрика | Результат |
|---|---|
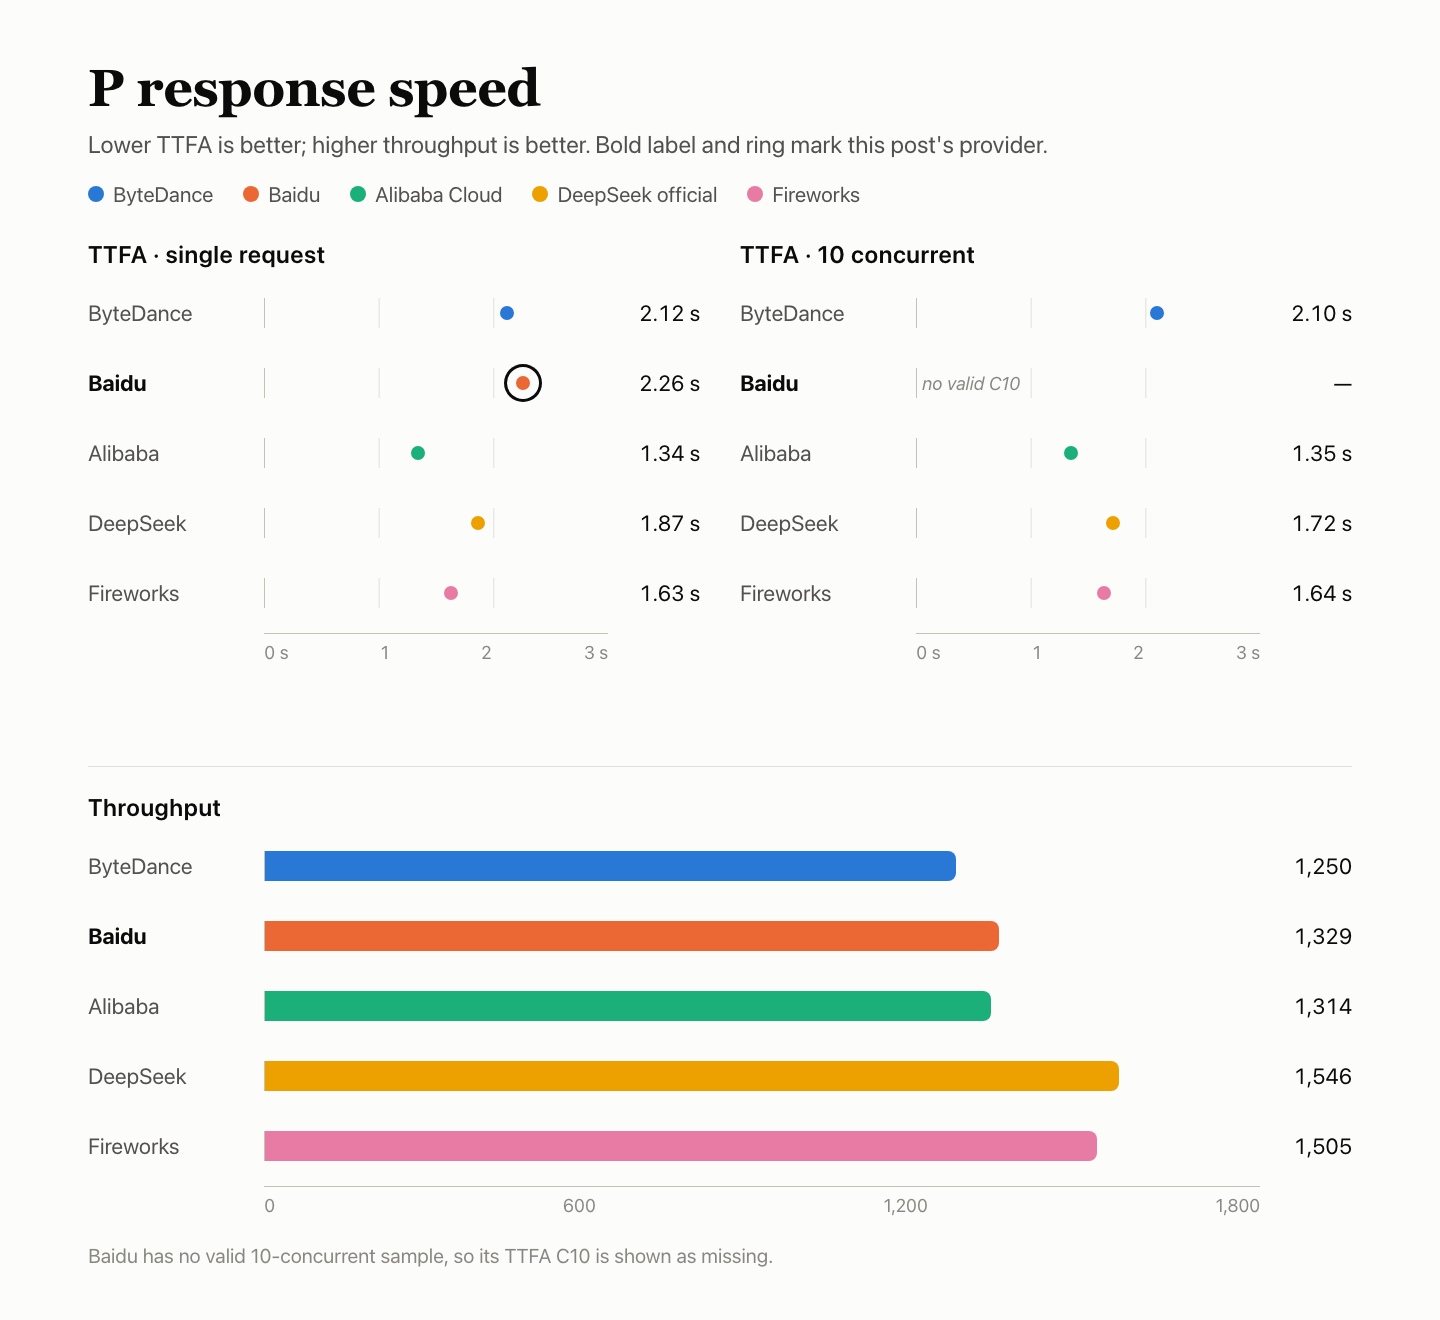
| TTFA — час до першого токена | Один паралельний запит: медіана 2.26 s (медіана для дійсних запитів — 2.05 s); десять паралельних запитів: понад половина недійсна, медіана враховується як нескінченність (медіана для дійсних запитів — 1.86 s) |
| Швидкість генерації TPOT | Один паралельний запит — 3.48 ms/token; десять паралельних запитів — 50.00 ms/token (понад половина недійсна, штрафне значення) |
| Goodput (дійсна пропускна здатність) | Десять паралельних запитів — 1,329.2 token/s |
| Дійсні запити | Один паралельний запит — 78/90 (перше вікно 18/30); десять паралельних запитів — 40/90 (перше вікно 0/30, третє вікно 10/30) |
| Причина недійсності | 62 тести повернули 400 no_available_channel |
| Оцінка компонентів | TTFA 0.00, TPOT 0.00, пропускна здатність 100.00; оцінка відповіді 30.00 |
| Складові P | Оцінка відповіді 30.00 із вагою 80%, кеш K 68.85 із вагою 20%, загальний результат 37.77 |
TPOT оцінюється за потоковими частинами відповіді, а не вимірюється для кожного токена на апаратному рівні. Goodput — це кількість дійсних вихідних токенів за десяти паралельних запитів, поділена на час виконання пакета.
У категорії з десятьма паралельними запитами 50 із 90 тестів повернули no_available_channel. Оскільки недійсними виявилися понад половина, медіанний час до першого токена вважається нескінченним, а TTFA і TPOT отримують штрафні значення. У категорії з одним паралельним запитом дійсними були 78 із 90 тестів.
Усі п’ять провайдерів використовували один комп’ютер, мережу й обліковий запис. Три вікна планувалися для кожного провайдера окремо, тому періоди збору даних не повністю збігаються; невеликі розбіжності не варто переоцінювати.
K — кеш: 68.85
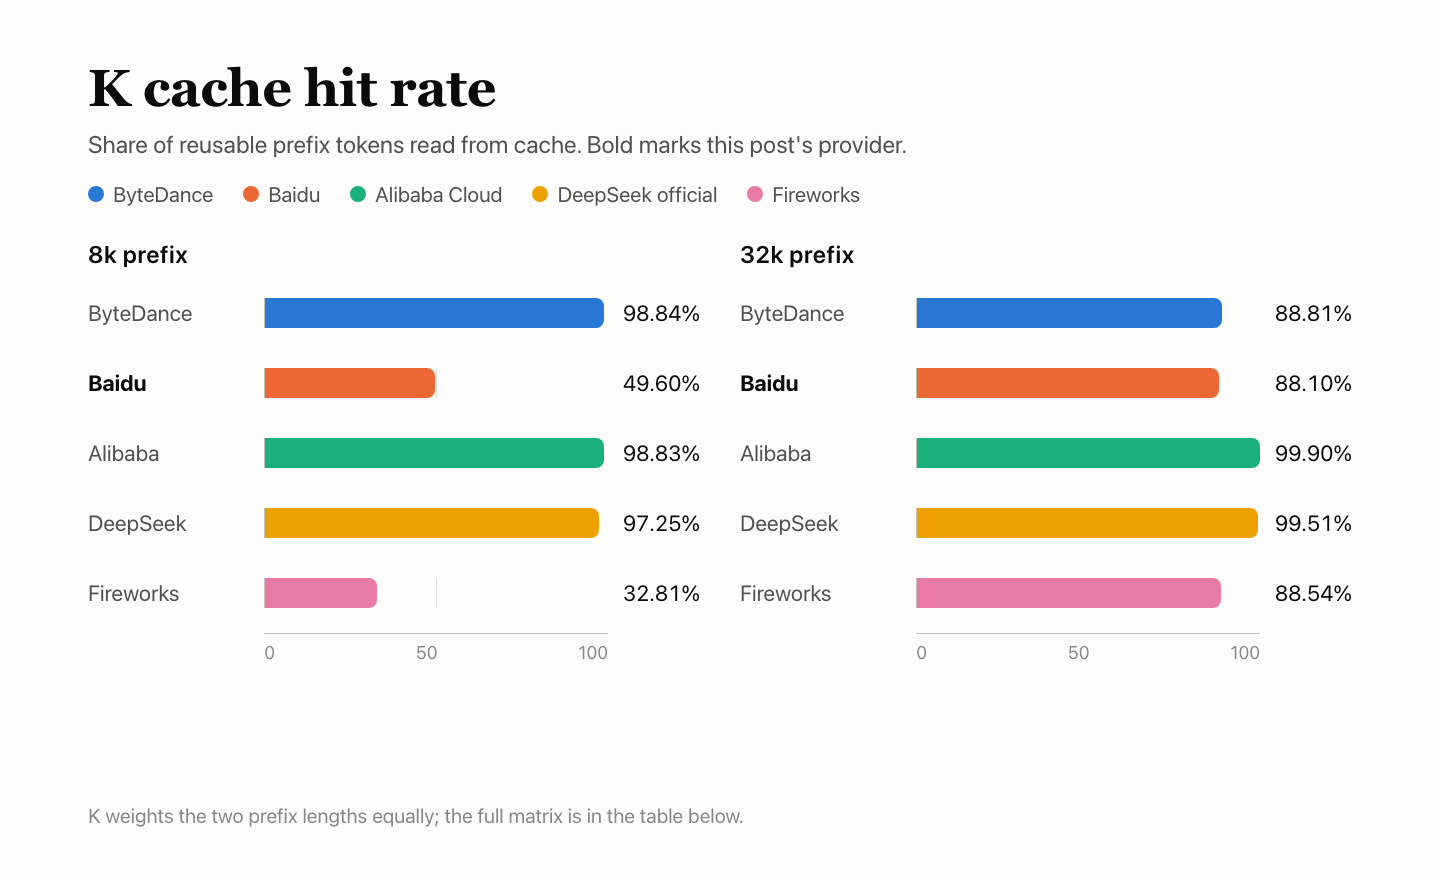
У кожній групі надсилається п’ять запитів. Перший містить фіксований префікс приблизно на 8k або 32k токенів і заповнює кеш. У запитах 2–4 префікс зберігається, а змінюється лише запитання наприкінці; інтервали між ними становлять 5 s, 30 s і 120 s. П’ятий запит використовує новий префікс як контрольний запит без кешу. Три вікна × два розміри — загалом 30 запитів. K — це кількість токенів, зчитаних із кешу гарячими запитами, поділена на кількість токенів, які за правилами можна повторно використовувати; для кожного розміру встановлено однакову вагу. K становить 20% від P.
У таблиці наведено кількість токенів, зчитаних із кешу, за звітом сервера; «не повернуто» означає, що поле було відсутнє у відповіді.
| Префікс | Вікно | Початковий запит | +5 s | +30 s | +120 s | Контрольний запит без кешу |
|---|---|---|---|---|---|---|
| 8k | 1 | Помилка | Помилка | Помилка | Не повернуто | Не повернуто |
| 8k | 2 | Не повернуто | 7,168 | 7,168 | Помилка | Помилка |
| 8k | 3 | Не повернуто | 7,168 | 7,168 | 7,168 | Не повернуто |
| 32k | 1 | Не повернуто | Не повернуто | 31,744 | 31,744 | Не повернуто |
| 32k | 2 | Не повернуто | 31,744 | 31,744 | 31,744 | Не повернуто |
| 32k | 3 | Не повернуто | 31,744 | 31,744 | 31,744 | Не повернуто |
Для префікса 8k влучення зафіксовано в 5 із 9 гарячих запитів: було прочитано 35,840 із 72,252 токенів, які мали повторно використовуватися; результат — 49.60. Для префікса 32k влучення було в 8 із 9 запитів: прочитано 253,952 із 288,261; результат — 88.10. За однакової ваги двох довжин K становить 68.85. Загалом не вдалося виконати п’ять запитів із префіксом 8k: початковий запит у вікні 1, запити через 5 с і 30 с, а також запити через 120 с і для холодного контролю у вікні 2 — усі з помилкою no_available_channel. Отже, у рівні 8k не вдалося виконати три гарячі запити.
За влучення зчитування фіксується блоками по 1,024 токени: 7,168 токенів для префікса 8k і 31,744 для префікса 32k. За промаху блок usage не містить prompt_tokens_details; у таблиці зазначено «не повернуто», а значення враховано як 0.
Порівняно з іншими чотирма
R — стабільність сервісу: 100
300 запитів поділено на чотири типи: короткий текст, довгий ввід, виклик інструменту та історія кількох ходів. Їх надіслано з одночасністю 1 упродовж трьох вікон. Перевіряється лише те, чи була перша відповідь коректною та повною; відповіді не оцінюються, повторних спроб немає. Помилки під час перевірок відповідей і швидкості зараховуються до Q та P, а не до R.
| Тип запиту | Успіх із першої спроби |
|---|---|
| Короткий текст | 120/120 |
| Довгий ввід на 10k | 90/90 |
| Виклик інструменту | 60/60 |
| Історія кількох ходів | 30/30 |
| Усього | 300/300, 95% ДІ 98.78%–100% |
Усі 300 запитів із першої спроби повернули коректну й повну відповідь. R 100 стосується лише цих 300 окремих запитів; це не означає, що на всьому шляху не було збоїв. За 300 успішних запитів із 300 нижня межа 95% інтервалу становить 98.78%, тож імовірно, частка помилок нижча за 1.22%.
Порівняно з іншими чотирма
R охоплює лише ці 300 окремих запитів; помилки під час перевірок відповідей і швидкості зараховуються до Q та P, а не до R.
| Провайдер | Успіх із першої спроби | 95% інтервал |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| Офіційний DeepSeek | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Поширені запитання
Що означає загальний бал?
Це зведений індекс без довірчого інтервалу, а не сертифікація. У цій статті наведено Q, F, P, K і R та не надається рекомендацій щодо провайдерів.
Чому половина перевірок із десятьма одночасними запитами завершилася помилкою?
50 із 90 повернули no_available_channel. Оскільки понад половина результатів були некоректними, медіанний час до першого токена вважається нескінченним, а TTFA і TPOT оцінюються за штрафними значеннями.
Чи означає R 100, що збоїв каналів не було?
Ні. R охоплює 300 окремих запитів, усі успішні з першої спроби. 62 відповіді no_available_channel під час перевірки швидкості та збої під час перевірки відповідей зараховуються до P і Q.
Чому K дорівнює 68.85, якщо для префікса 32k було 8 влучень із 9?
Обидві довжини мають однакову вагу. Для префікса 8k було 5 влучень у 9 гарячих запитах і результат 49.60, а для 32k — 8 влучень із 9 і результат 88.10; середнє становить 68.85.
Чи можна відрізнити якість відповідей Baidu від офіційного каналу?
Так. Різниця за сукупним показником Q становить −4.46 відсоткового пункту; 95% інтервал — від −5.78 до −3.16, тож він не охоплює 0. Це єдиний результат провайдера нижче за офіційний канал, для якого інтервал не охоплює 0.
Які перевірки не включено до F?
Шість: три перевірки потокової передачі з послідовністю зупинки, які не вдалося виконати, оскільки запит на попередньому кроці не було надіслано, і три явні перевірки cache_control, заздалегідь зареєстровані як непідтримувані цим інтерфейсом.
Читайте далі: серія DeepSeek V4.1 Flash
- Точність BFCL у Baidu була близькою до офіційного каналу; у наступній статті про ByteDance той самий набір перевірок розглядається з погляду викликів інструментів і обліку використання: DeepSeek V4.1 Flash на ByteDance: виклики інструментів збігаються, облік — ні
- TTFA Baidu за одночасності 1 — 2.26 с, тоді як в іншому запуску вдалося досягти 1.34 с: DeepSeek V4.1 Flash на Alibaba Cloud: перший токен за 1.34s, кеш 99.37
- F Baidu дорівнює 88.39, тоді як у контрольному запуску показник становив 94.00 за наявності 15 некоректних перевірок: DeepSeek V4.1 Flash на офіційному каналі: F 94.00, 15 некоректних перевірок
- Для кешу 8k у Baidu зафіксовано 5/9 влучень; для порівняння, в іншому запуску було 3/9 і порожні відповіді на зупинку: DeepSeek V4.1 Flash на Fireworks: порожні відповіді на зупинку, 3/9 влучень у кеш


