03–04.11.2026 набір тестів APB Full перевірив DeepSeek V4.1 Flash 1017 у п’яти провайдерів через AIHubMix. Для кожного провайдера використовували ту саму модель, запитання, параметри й скрипти запитів; модель наведена на сторінці моделей AIHubMix, а п’ять записів провайдерів — на сторінці моделей. Цей профіль APB охоплює лише Alibaba Cloud: що вимірював кожен розділ і які результати отримано.
У цій публікації наведено оцінки без ранжування провайдерів і рекомендацій щодо вибору. Спершу розглядаються Q, F, P, K і R; K — підоцінка P. Загальна оцінка — це підсумковий індекс, а не сертифікація, і для неї не наведено довірчого інтервалу. Правила оцінювання визначені в AIHubMix Provider Benchmark Standard v2.0.
Оцінки п’яти провайдерів
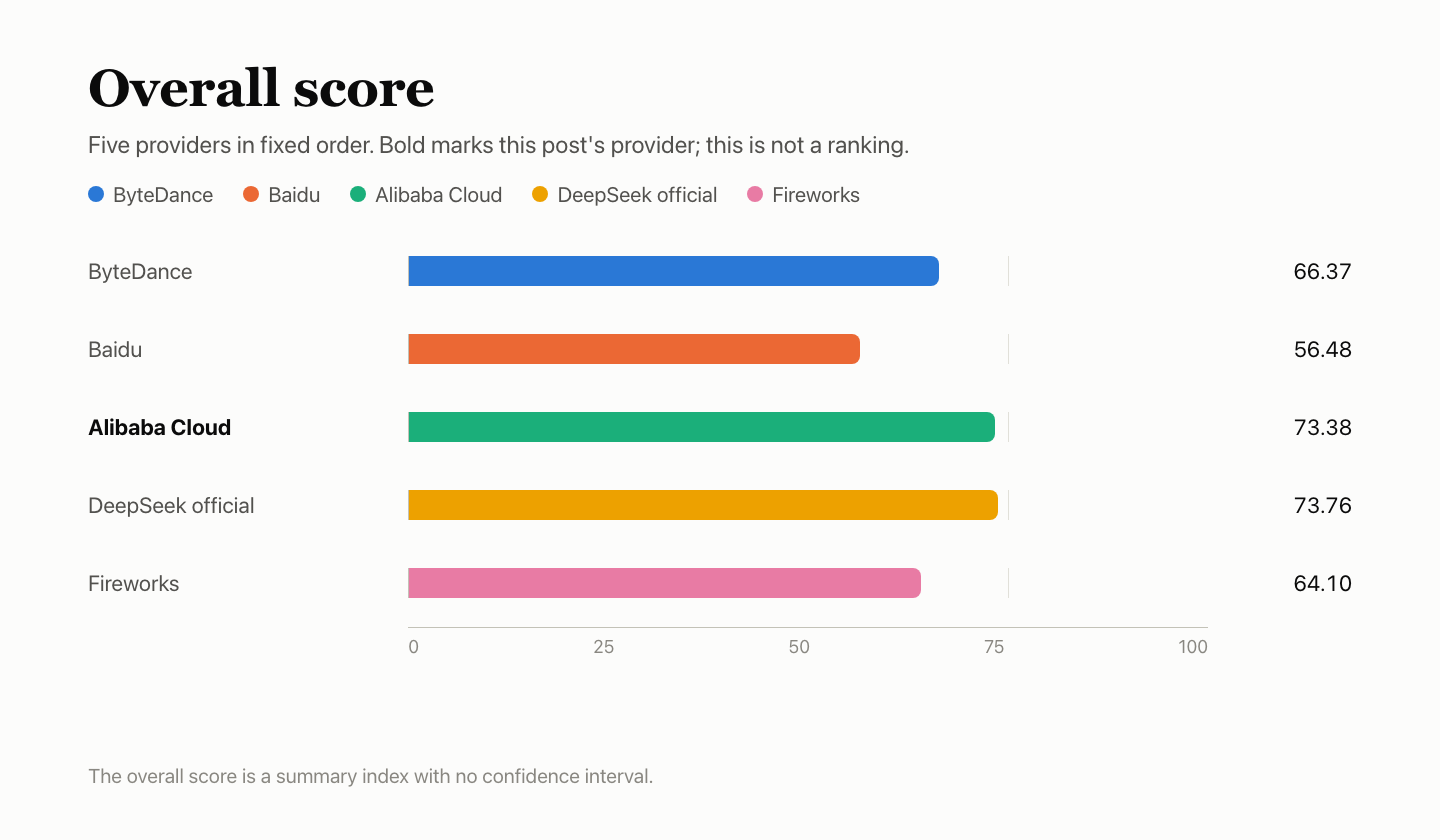
Жирним виділено провайдера, якому присвячена ця публікація. Провайдери наведені у фіксованому порядку, а не в рейтингу. K — підоцінка P із вагою 20%, її наведено окремо для довідки. Загальна оцінка — підсумковий індекс без довірчого інтервалу. Різниця між DeepSeek через офіційний канал і Alibaba Cloud становить 0.37 бала, і ці результати статистично нерозрізнювані.
Короткий огляд
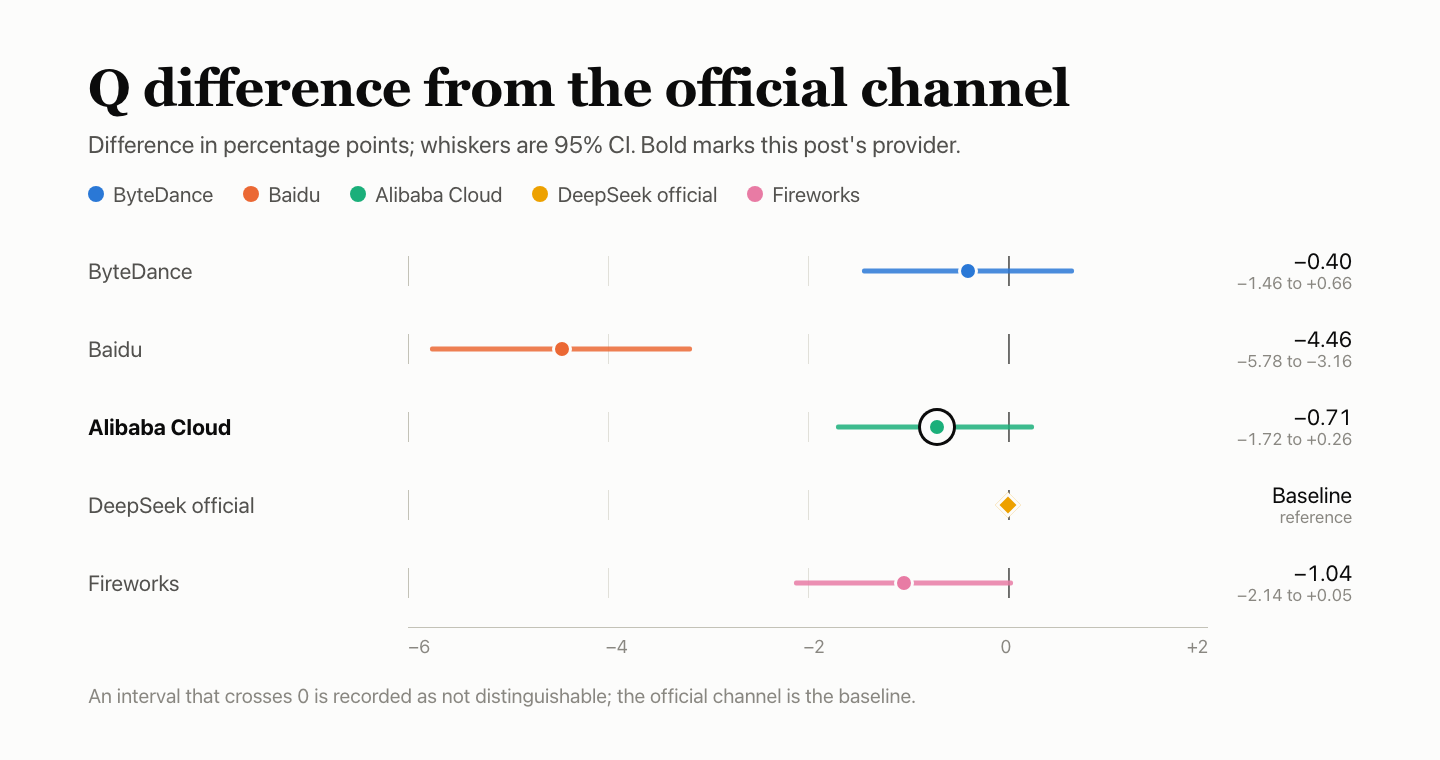
- Якість відповідей: Q 41.75. BFCL — 87.00%, HLE — 13.29%, AA-LCR — 53.60%. Порівняно з офіційним каналом різниця становить −0.71 відсоткового пункту, 95% інтервал — від −1.72 до +0.26, тож ці результати статистично нерозрізнювані.
- Підтримка функцій: F 89.78. Пройдено 155 із 177 перевірок, що увійшли до знаменника. На некоректну схему інструмента надійшла відповідь 503 замість помилки параметрів, переповнення контексту не повернуло документований тип помилки, а ізольований результат інструмента отримав відповідь 200.
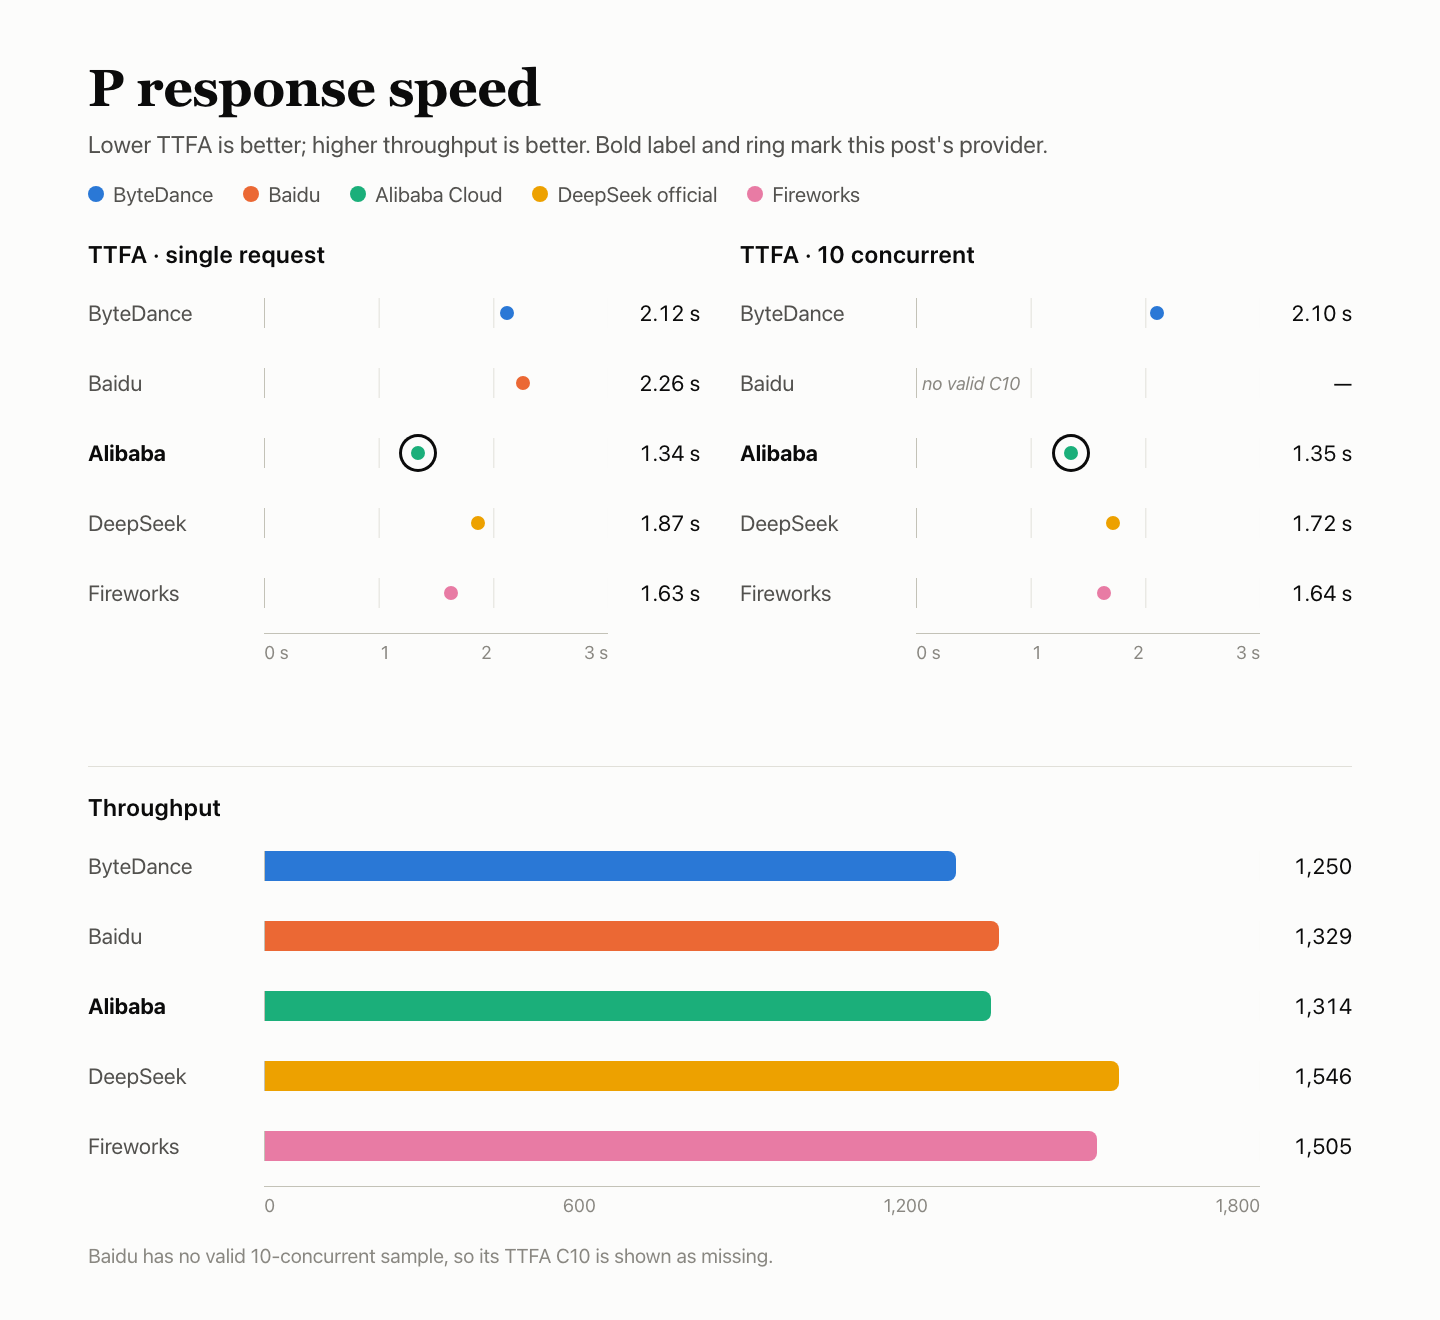
- Швидкість відповіді: P 88.58. Медіанний час до першого токена з вмістом становив 1.34 s за одного паралельного запиту та 1.35 s за 10 паралельних запитів; TPOT — 4.69 ms, усі 180 запитів на швидкість були валідними.
- Кеш: K 99.37. Усі 18 гарячих запитів із префіксами 8k і 32k влучили в кеш, а жоден холодний контрольний запит не зчитав даних із кешу.
- Стабільність сервісу: R 100. Усі 300 окремих запитів успішно виконалися з першої спроби.
Налаштування тестування
Запити надсилалися через AIHubMix після вибору ID моделі провайдера; маршрут описано в короткому посібнику. На сторінці цін DeepSeek наведено опубліковані тарифи моделі.
| Параметр | Деталі |
|---|---|
| Модель | DeepSeek V4.1 Flash 1017 |
| Запитаний ID моделі | alicloud-deepseek-v4.1-flash-1017 |
| Повернуте ім’я моделі | deepseek-v4.1-flash-1017 |
| Маршрут доступу | Через AIHubMix із вибором ID моделі провайдера, а не через підключення до власного облікового запису провайдера |
| Параметри | Режим без мислення, temperature 1.0, max_tokens 16,384, тайм-аут 300 s, автоматичні повторні спроби вимкнено |
| Мислення вимкнено | Для всіх запитів використовувався reasoning_effort=none |
| Час | 03.11.2026 18:07 – 04.11 16:33 UTC+8. П’ять провайдерів використовували один Mac mini, мережу й обліковий запис. |
| Вибірки | Якість відповідей: 4,250 запусків запитань (BFCL — 500 × 3 раунди, HLE — 250 × 10, AA-LCR — 25 × 10); функціональні перевірки — 60 × 3 вікна; швидкість — 90 за одного паралельного запиту та 90 за 10 паралельних запитів; стабільність — 300; кеш — 30 (префікси 8k і 32k, по 3 групи кожного типу) |
Q — якість відповідей: 41.75
Для оцінювання якості відповідей використовували три набори запитань: 500 запитань BFCL по 3 раунди кожне, 250 запитань HLE по 10 раундів і 25 запитань AA-LCR по 10 раундів. BFCL оцінювався за автоматичними правилами, а HLE та AA-LCR — суддівською моделлю deepseek-flash. Усі п’ять провайдерів отримували однакові запитання; результати трьох наборів об’єднали в одну оцінку точності. Десять відповідей вилучили, оскільки їх неможливо було оцінити, тож залишилося 4,240 оцінених запусків запитань.
| Завдання | Запитання | Правильні відповіді | Точність | Помилки |
|---|---|---|---|---|
| Виклики інструментів BFCL | 500 × 3 | 1,305/1,500 | 87.00% | 0 |
| Складні запитання й відповіді HLE | 250 × 10 | 331/2,490 | 13.29% | 8 |
| Міркування за довгими документами AA-LCR | 25 × 10 | 134/250 | 53.60% | 0 |
| Разом · 95% інтервал 39.56%–43.85% | — | 1,770/4,240 | 41.75% | 8 |
Помилки сервісу (невдалі запити або обрізаний вивід) залишаються у знаменнику й рахуються як неправильні відповіді; їх не вилучають. У Alibaba Cloud вивід HLE 8 разів досягав ліміту max_tokens і обрізався.
На кожне запитання BFCL дається 3 раунди; у таблиці наведено сукупні результати за всі 3 раунди.
| Категорія BFCL | Пройдено | Частка проходження |
|---|---|---|
| simple_python: один виклик функції з правильною функцією та аргументами | 332/360 | 92.22% |
| multiple: вибір правильної функції з кількох | 270/300 | 90.00% |
| parallel: паралельний виклик однієї функції кілька разів | 273/300 | 91.00% |
| parallel_multiple: паралельний виклик кількох різних функцій | 212/240 | 88.33% |
| irrelevance: жодна функція не підходить, викликів бути не повинно | 113/150 | 75.33% |
| ahm_multi_turn: триетапний ланцюжок викликів інструментів | 105/150 | 70.00% |
Порівняння з іншими чотирма
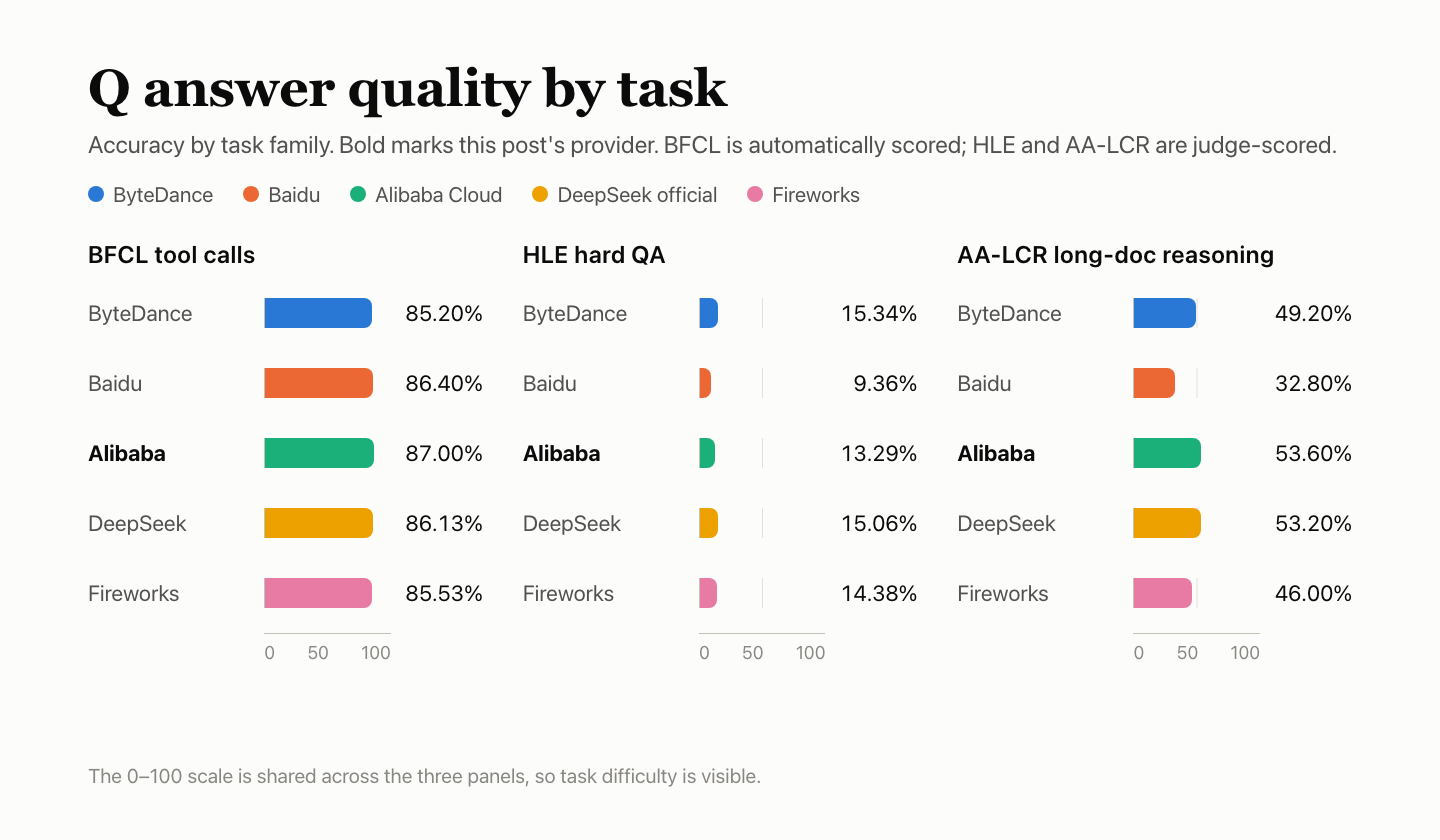
Порівняно з офіційним каналом: різниця в точності у відсоткових пунктах, 95% інтервал показано вусами; якщо інтервал перетинає 0, різниці не вважають. Суддівська модель deepseek-flash для HLE та AA-LCR належить до тієї самої родини DeepSeek, що й тестована модель, і її не калібрували, тому оцінювання може бути поблажливим.
F — підтримка функцій: 89.78
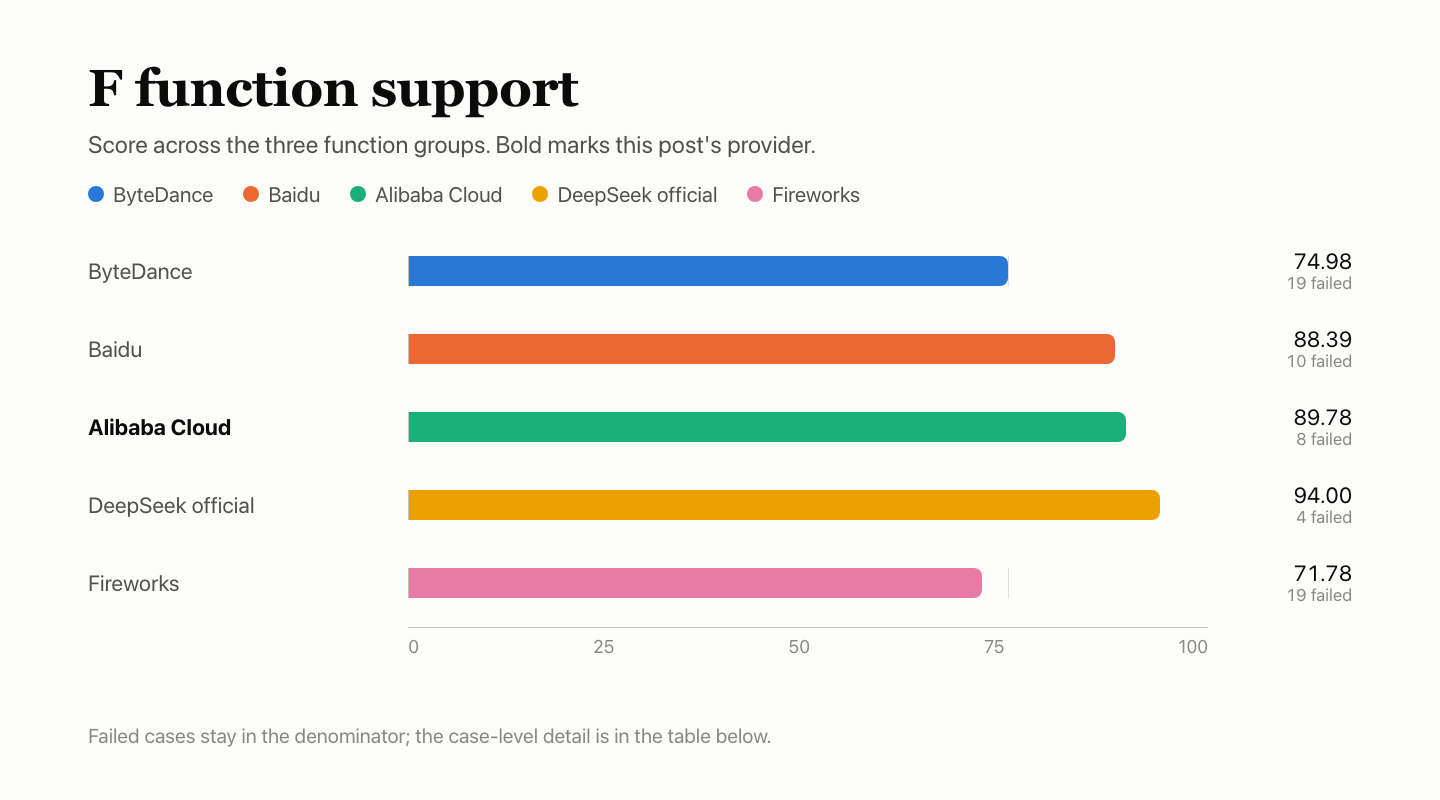
Функціональні перевірки з’ясовують, чи відповідає поведінка інтерфейсу протоколу, а не чи добре модель відповідає. 60 перевірок поділено на шість груп; кожну запускали в трьох вікнах, тобто загалом виконали 180 перевірок, оцінюючи їх відповідно до задокументованого формату кожного провайдера. Перевірки, які не застосовувалися, були некоректними або не спостерігалися, вилучалися зі знаменника. Alibaba Cloud пройшов 155 із 177 перевірок у знаменнику; з урахуванням ваг груп оцінка становить 89.78.
Зважену оцінку обчислюють за вагами груп, а не простим підрахунком пройдених перевірок із 177.
| Група | Вага | Пройдено | Вилучено | Оцінка групи |
|---|---|---|---|---|
| Потокова передача та протокол повідомлень | 20% | 30/30 | — | 100.00 |
| Інтерфейс інструментів | 20% | 30/30 | — | 100.00 |
| Обмеження виводу та параметри | 20% | 30/30 | — | 100.00 |
| Контекст і стан | 15% | 26/30 | — | 86.67 |
| Помилки та відновлення | 15% | 18/30 | — | 60.00 |
| Облік використання та протокол кешу | 10% | 21/27 | 3 | 77.78 |
| Разом · зважена оцінка | — | 155/177 | 3 | 89.78 |
Позначення 3/3 для кількості вікон означає, що перевірка не пройшла в усіх трьох вікнах.
| Невдала перевірка | Вікна з помилкою | Причина |
|---|---|---|
| Переповнення контексту (контекст і стан) | 3/3 | Повернуто помилку, але не документовану помилку довжини контексту |
| Помилка формату messages (помилки та відновлення) | 3/3 | Повернуто 400 із порожнім тілом відповіді, без структурованого опису помилки |
| Некоректна схема інструмента (помилки та відновлення) | 3/3 | Мала надійти помилка параметрів, але повернуто 503 |
| Ізольований результат інструмента (помилки та відновлення) | 3/3 | Мала надійти помилка параметрів, але повернуто 200 |
| Помилка формату stream_options (помилки та відновлення) | 3/3 | Повернуто 400 із порожнім тілом відповіді, без структурованого опису помилки |
| Облік токенів міркування (облік використання та протокол кешу) | 3/3 | Кількість токенів міркування не повернуто |
| Визначення інструментів враховано як вхідні дані (облік використання та протокол кешу) | 3/3 | З визначеннями інструментів повідомлена кількість вхідних токенів не була більшою, ніж без них |
| Ізоляція запитів (контекст і стан) | 1/3 | На першому кроці не надійшла єдина очікувана відповідь STORED, тому перевірку ізоляції не вдалося продовжити |
Ці перевірки вилучаються зі знаменника і не зараховуються ні як пройдені, ні як невдалі.
| Статус | Перевірка | Кількість | Причина |
|---|---|---|---|
| Не застосовується | Явний cache_control | 3 | Заздалегідь зареєстровано як непідтримуваний цим інтерфейсом |
Усі п’ять провайдерів не пройшли перевірки помилок формату messages і stream_options: кожен повернув 400 із порожнім тілом, тож клієнт не отримав структурованого опису помилки. Оскільки всі п’ять демонструють однакову поведінку, імовірніше, її спричиняє рівень шлюзу AIHubMix, тож це потребує окремого розслідування. Усі п’ять також не пройшли перевірку обліку токенів міркування, але з різних причин: ByteDance і Fireworks повідомляли токени міркування навіть із вимкненим мисленням, тоді як решта трьох не повертали їх кількості.
Порівняння з іншими чотирма
P — швидкість відповіді: 88.58
Кожен запит містив приблизно 10,000 вхідних токенів і передбачав приблизно 1,100 вихідних токенів. У трьох вікнах надсилали по 30 запитів за одного паралельного запиту та по 30 за 10 паралельних запитів, загалом — 180. Час до першого токена з вмістом (TTFA) вимірюється для кожного валідного запиту, а в таблиці наведено медіани. TPOT оцінюється за часовими мітками фрагментів потокової передачі, а не за апаратним вимірюванням часу на токен; пропускна здатність — це кількість валідних вихідних токенів за 10 паралельних запитів, поділена на загальний час виконання пакета.
| Метрика | Результат |
|---|---|
| Час до першого токена з вмістом TTFA | Медіана за одного паралельного запиту — 1.34 s, медіана за 10 паралельних запитів — 1.35 s |
| Швидкість генерації TPOT | За одного паралельного запиту — 4.63 ms/токен, за 10 паралельних запитів — 4.69 ms/токен |
| Ефективна пропускна здатність (goodput) | За 10 паралельних запитів — 1,313.6 токен/с |
| Валідні запити | За одного паралельного запиту — 90/90, за 10 паралельних запитів — 90/90 |
| Оцінки складових | TTFA — 59.65, TPOT — 100.00, пропускна здатність — 100.00; для TTFA і TPOT береться нижчий результат із двох рівнів, ваги становлять 35% / 35% / 30%, оцінка швидкості відповіді — 85.88 |
| Оцінка P | Оцінка швидкості відповіді 85.88 із вагою 80%, кеш K 99.37 із вагою 20%, разом — 88.58 |
Порівняння з іншими чотирма
Усі п’ять провайдерів використовували ту саму машину, мережу й обліковий запис. Три вікна планувалися окремо для кожного провайдера, тому періоди збору даних не повністю збігаються, і не варто надмірно інтерпретувати незначні розриви.
K — кеш: 99.37
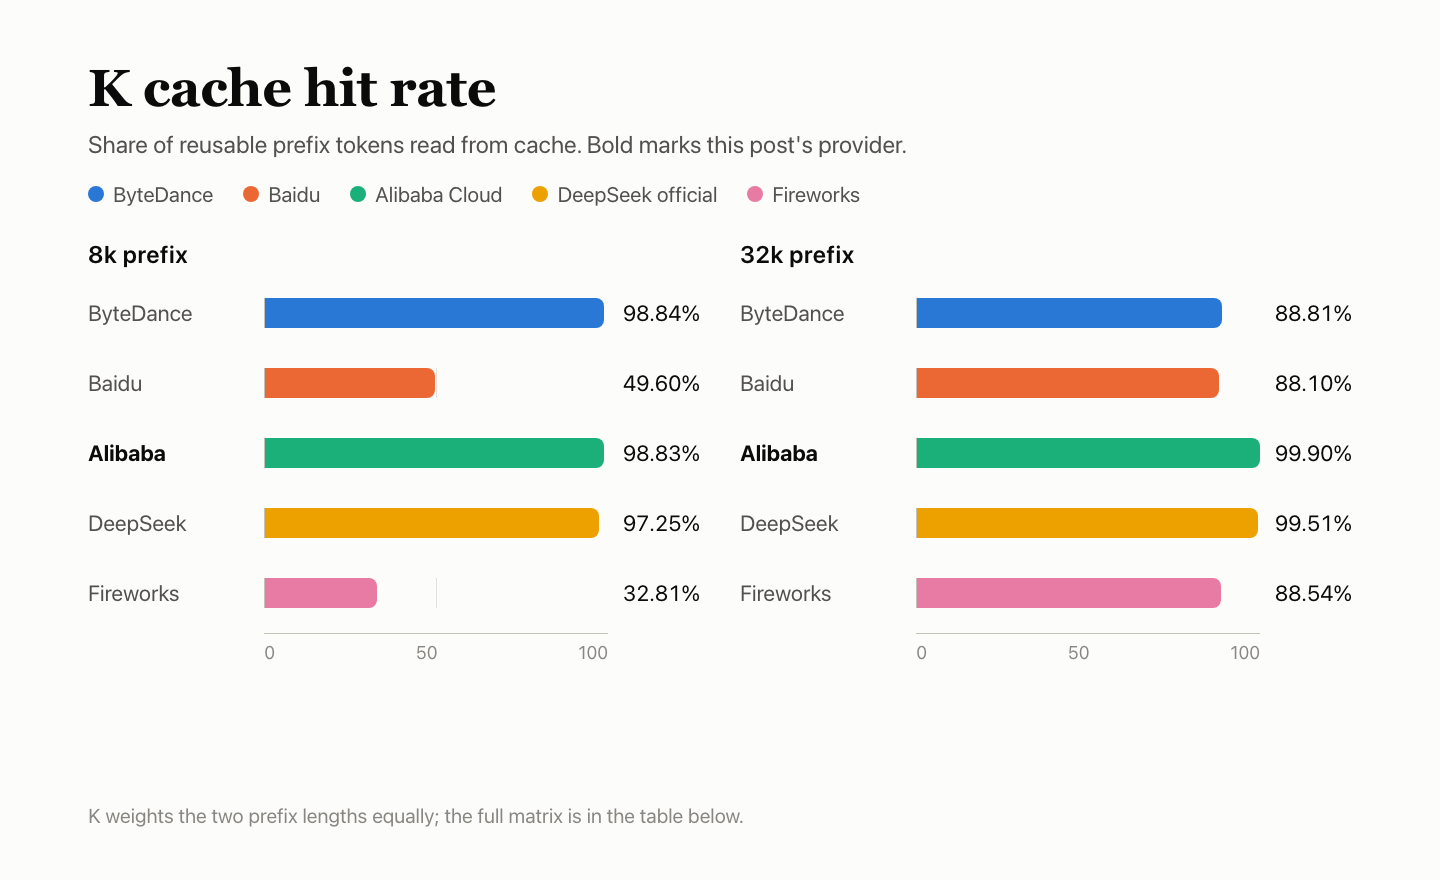
Кожна група містить п’ять запитів: перший передає фіксований префікс приблизно на 8k або 32k токенів і заповнює кеш; запити 2–4 зберігають префікс і змінюють лише запитання наприкінці, надсилаючись через 5, 30 і 120 секунд; п’ятий використовує новий префікс як холодний контроль. Три вікна × дві довжини дають 30 запитів. K — це кількість токенів, зчитаних із кешу в гарячих запитах, поділена на кількість токенів, які за правилом мали б повторно використовуватися; кожна довжина має однакову вагу. K становить 20% оцінки P. У матриці показано кількість зчитаних токенів кешу за даними сервера.
| Префікс | Вікно | Початковий запит (запит 1) | Гарячий запит через 5 s | Гарячий запит через 30 s | Гарячий запит через 120 s | Холодний контроль (запит 5) |
|---|---|---|---|---|---|---|
| 8k | Вікно 1 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Вікно 2 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Вікно 3 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 32k | Вікно 1 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Вікно 2 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Вікно 3 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| Префікс | Влучення в кеш | Зчитано токенів | Мало повторно використовуватися | Оцінка |
|---|---|---|---|---|
| 8k | 9/9 | 71,424 | 72,270 | 98.83 |
| 32k | 9/9 | 288,000 | 288,279 | 99.90 |
| K (8k і 32k, по половині ваги кожному) | 99.37 |
Усі 9 гарячих запитів із префіксом 8k влучили в кеш, зчитавши по 7,936 токенів; усі 9 гарячих запитів із префіксом 32k влучили в кеш, зчитавши по 32,000 токенів. Початковий запит і холодний контроль не зчитували даних із кешу, тож гарячі й холодні запити чітко розрізняються.
Порівняння з іншими чотирма
R — стабільність сервісу: 100
300 запитів охоплювали чотири типи — короткий текст, довгий вхід на 10k, виклики інструментів і багатокрокову історію — та надсилалися за одного паралельного запиту у трьох вікнах. Перевіряли лише першу відповідь: її валідність і повноту; правильність відповіді не оцінювали, повторних спроб не було. Помилки в розділах оцінювання якості відповідей і швидкості враховуються відповідно в Q і P, а не повторно в R.
| Тип запиту | Успіх із першої спроби |
|---|---|
| Короткий текст | 120/120 |
| Довгий вхід на 10k | 90/90 |
| Виклики інструментів | 60/60 |
| Багатокрокова історія | 30/30 |
| Разом · 95% інтервал 98.78%–100% | 300/300 |
Усі 300 запитів із першої спроби повернули коректну й повну відповідь. R 100 охоплює лише ці 300 спеціально виділених запитів і не означає, що в усьому ланцюжку не було збоїв. Нижня межа 95% інтервалу становить 98.78%: навіть за результату 300/300 імовірно, що частка збоїв нижча за 1.22%.
Порівняно з іншими чотирма
R охоплює лише ці 300 спеціально виділених запитів; збої в якості відповідей і швидкості фіксуються в Q і P, а не враховуються повторно в R.
| Провайдер | Успіх із першої спроби | 95% інтервал |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek official | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Поширені запитання
Чи має значення загальний розрив у 0.37 бала між Alibaba Cloud і офіційним каналом?
Ні. У цьому тесті їх не можна розрізнити: різниця Q становить −0.71 відсоткового пункту з 95% інтервалом від −1.72 до +0.26, який охоплює 0, а загальний бал — це зведений індекс без довірчого інтервалу.
Що враховує оцінка Q?
Три набори: 500 запитань BFCL × 3 раунди з автоматичним оцінюванням; HLE 250 × 10 і AA-LCR 25 × 10 з оцінюванням моделлю-суддею deepseek-flash. Сукупна точність становить 41.75% за 4,240 оцінених запусків запитань.
Чому F дорівнює 89.78, якщо пройдено 155 із 177 перевірок?
Оцінка зважується за групами, а не обчислюється як просте співвідношення пройдених перевірок. Помилки й відновлення отримали 60.00, облік використання та протокол кешу — 77.78, тоді як три групи протоколів отримали 100.00.
Чому в R вказано 100, якщо в інших розділах були невдалі запити?
R охоплює лише 300 спеціально виділених запитів для перевірки стабільності. Збої в якості відповідей і швидкості фіксуються в Q і P та не враховуються повторно в R.
Чи є K 99.37 показником влучень у кеш?
Це співвідношення кешованих токенів, зчитаних у запитах із прогрітим кешем, до токенів, які мають повторно використовуватися; префікси 8k і 32k мають однакову вагу. Оцінка префікса 8k становила 98.83, а префікса 32k — 99.90.
Чи означає перший токен за 1.34 с, що повна відповідь надходить за 1.34 с?
Ні. Це час очікування до першого токена вмісту. Кожен запит вимагав приблизно 1,100 вихідних токенів, а TPOT за паралельності 10 становив 4.69 мс на токен.
Читайте далі: серія про DeepSeek V4.1 Flash
- Сукупний показник Q Alibaba Cloud відрізняється від офіційного базового показника на 0.71 відсоткового пункту — це в межах інтервалу, який охоплює 0; у профілі ByteDance таке саме порівняння продовжується перевіркою обліку викликів інструментів: DeepSeek V4.1 Flash на ByteDance: виклики інструментів збігаються, облік використання — ні.
- Alibaba Cloud повернув коректні результати для всіх 180 запитів на швидкість; профіль Baidu використовує той самий тестовий стенд, де жоден доступний канал не вплинув на Q і P: DeepSeek V4.1 Flash на Baidu: жоден доступний канал не впливає на Q і P.
- Офіційний канал є базовим показником для порівняння якості відповідей у цій статті; його власний профіль охоплює F 94.00 і 15 недійсних проб за паралельності 1: DeepSeek V4.1 Flash на офіційному каналі: F 94.00, 15 недійсних проб.
- Alibaba Cloud успішно виконав 9/9 запитів із прогрітим кешем для обох довжин префікса; профіль Fireworks охоплює порожні відповіді з ознакою зупинки та 3/9 влучень у кеш для 8k: DeepSeek V4.1 Flash на Fireworks: порожні відповіді з ознакою зупинки, 3/9 влучень у кеш.