
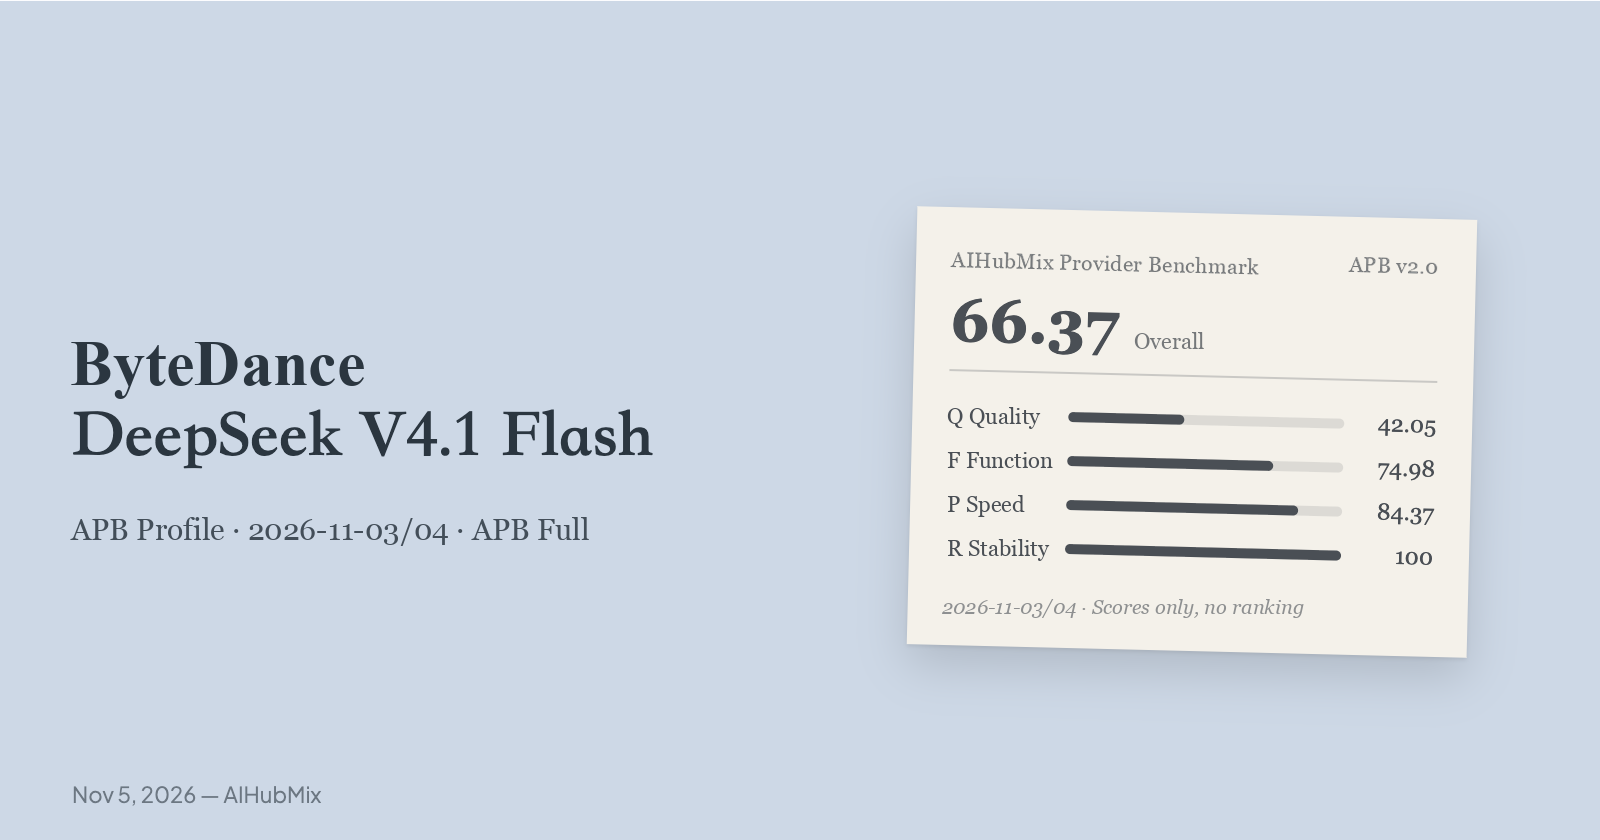
03–04.11.2026 модель DeepSeek V4.1 Flash 1017 протестували у п’яти провайдерів через AIHubMix за набором APB Full: щоразу використовували однакові запитання, параметри та сценарії запитів. Цей профіль APB охоплює лише запуск на ByteDance і розглядає результати за розділами.
Наведені нижче числа — це оцінки, а не рейтинг і не рекомендація провайдера. Спершу йдуть Q, F, P, K і R; загальний бал — це підсумковий індекс, а не сертифікація, і він не має довірчого інтервалу. Правила оцінювання визначено в стандарті AIHubMix Provider Benchmark Standard v2.0.
Оцінки п’яти провайдерів
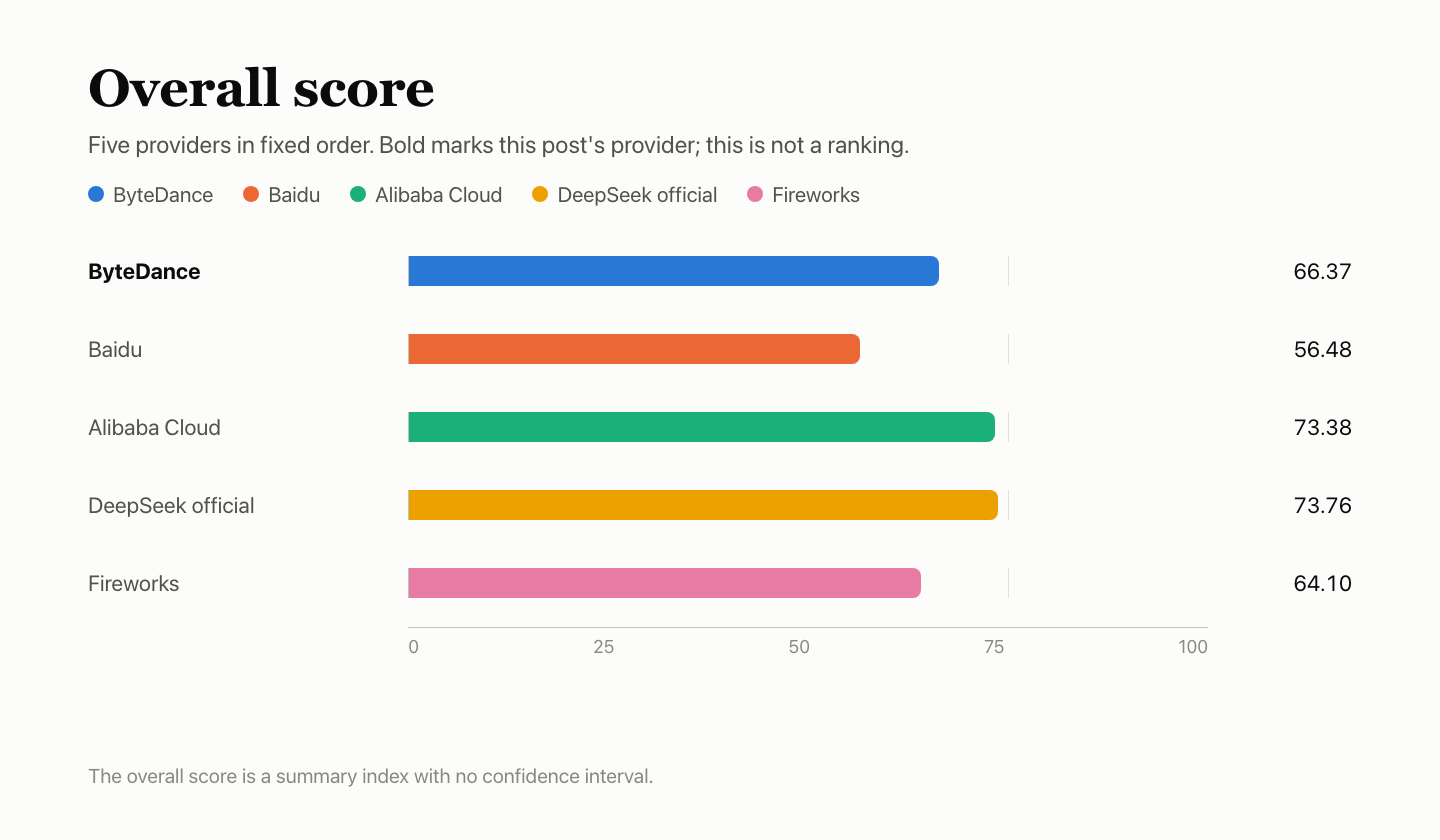
Жирним виділено провайдера, якому присвячено цей допис. Фіксований порядок провайдерів, а не рейтинг. K — складова оцінки P, на яку припадає 20%. Загальний бал — підсумковий індекс без довірчого інтервалу. Різниця між офіційним каналом DeepSeek і Alibaba Cloud становить 0.37, її неможливо розрізнити статистично.
Коротко
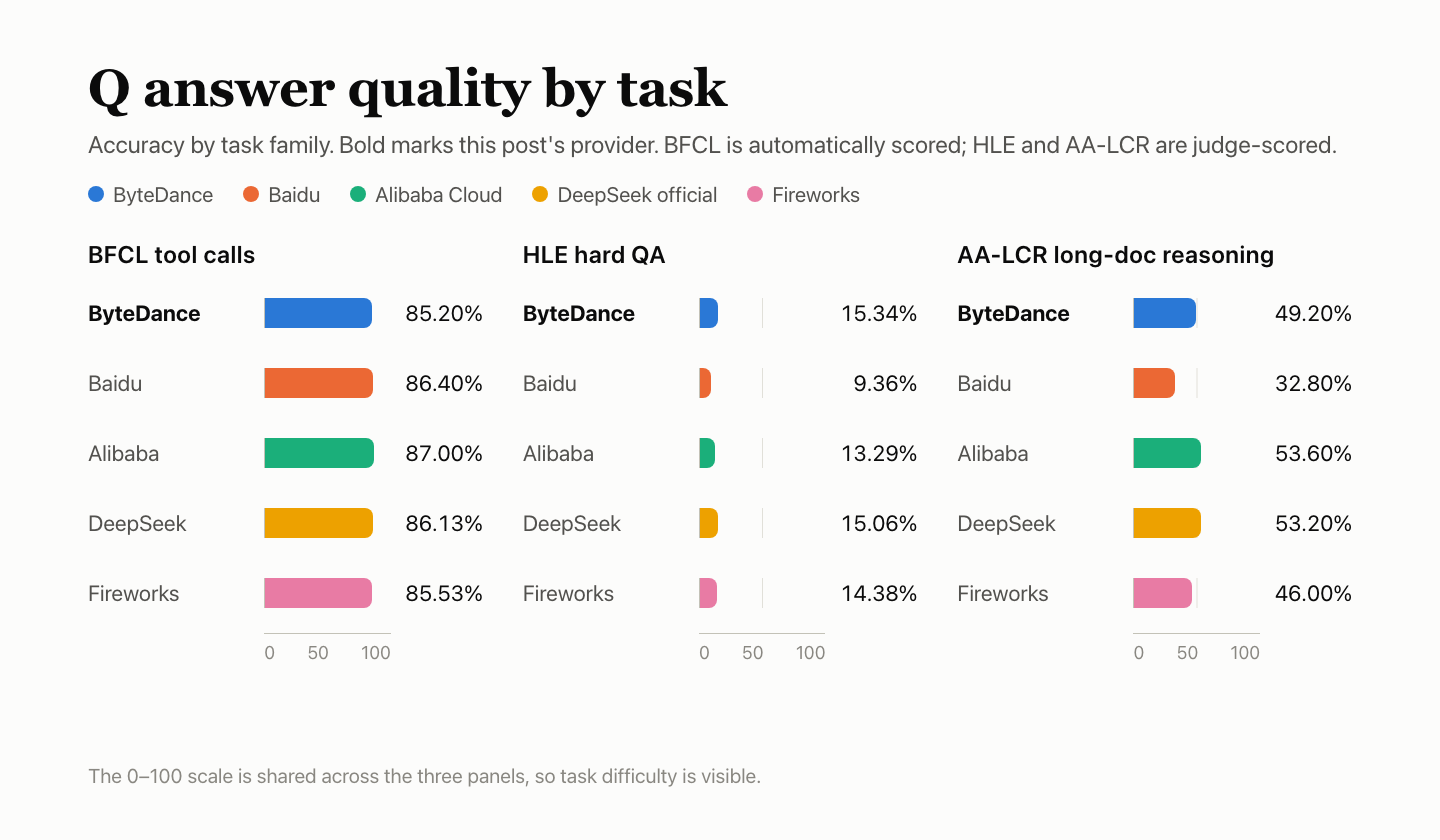
- Q 42.05. BFCL — 85.20%, HLE — 15.34%, AA-LCR — 49.20%. Різниця з офіційним каналом становить −0.40 відсоткового пункту, 95% інтервал — від −1.46 до +0.66: її неможливо розрізнити статистично. У AA-LCR сталося 28 збоїв запитів — усі у вікні 1; їх зараховано як неправильні відповіді.
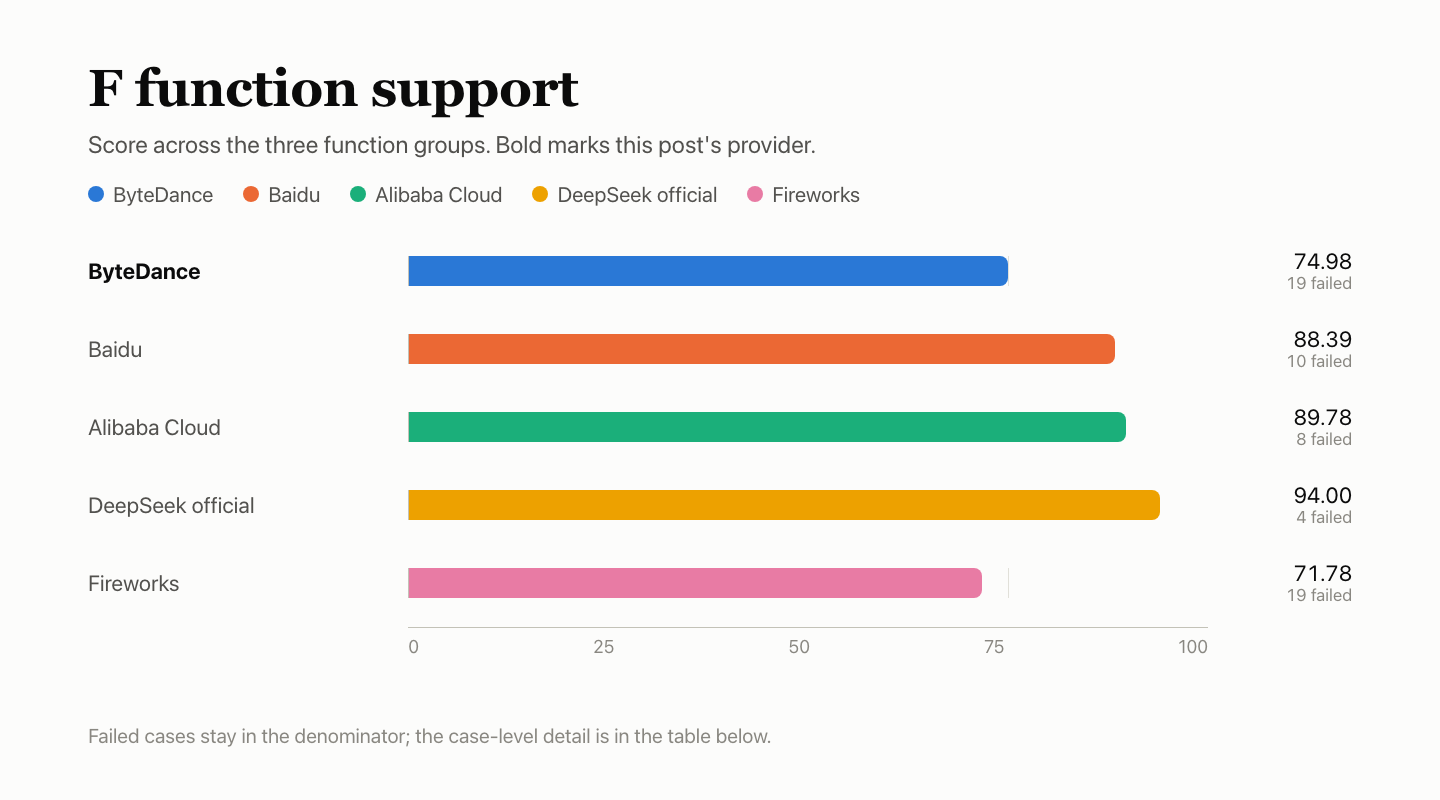
- F 74.98. Пройдено 124 із 174 зарахованих перевірок.
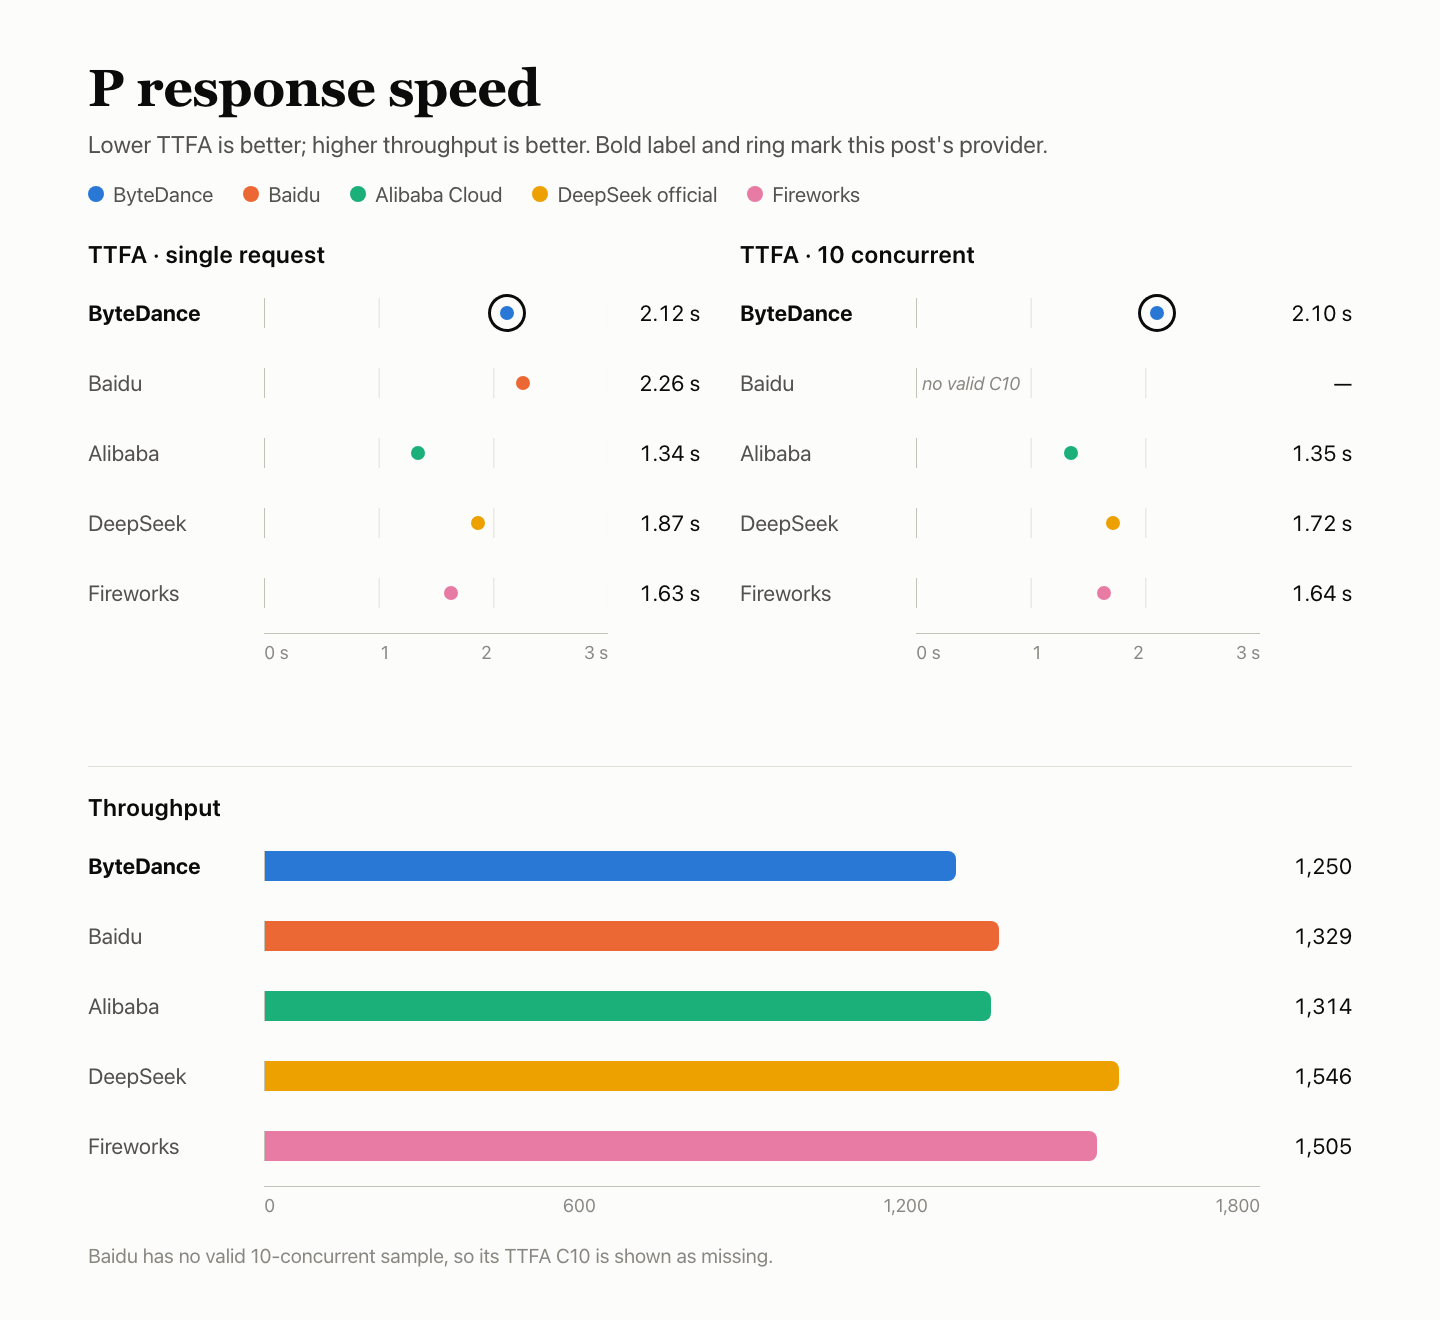
reasoning_effort=noneне вимикає режим мислення. Для вхідних даних обсягом 10k токенів було вказано 10,026 токенів (за нативним підрахунком — 10,000); для вхідних даних обсягом 8 токенів було вказано 34. - P 84.37. Медіанний час до першого токена тіла відповіді: 2.12 с за одного паралельного запиту й 2.10 с за 10 паралельних запитів; TPOT — 3.43 мс/токен; усі 180 запитів на швидкість були валідними.
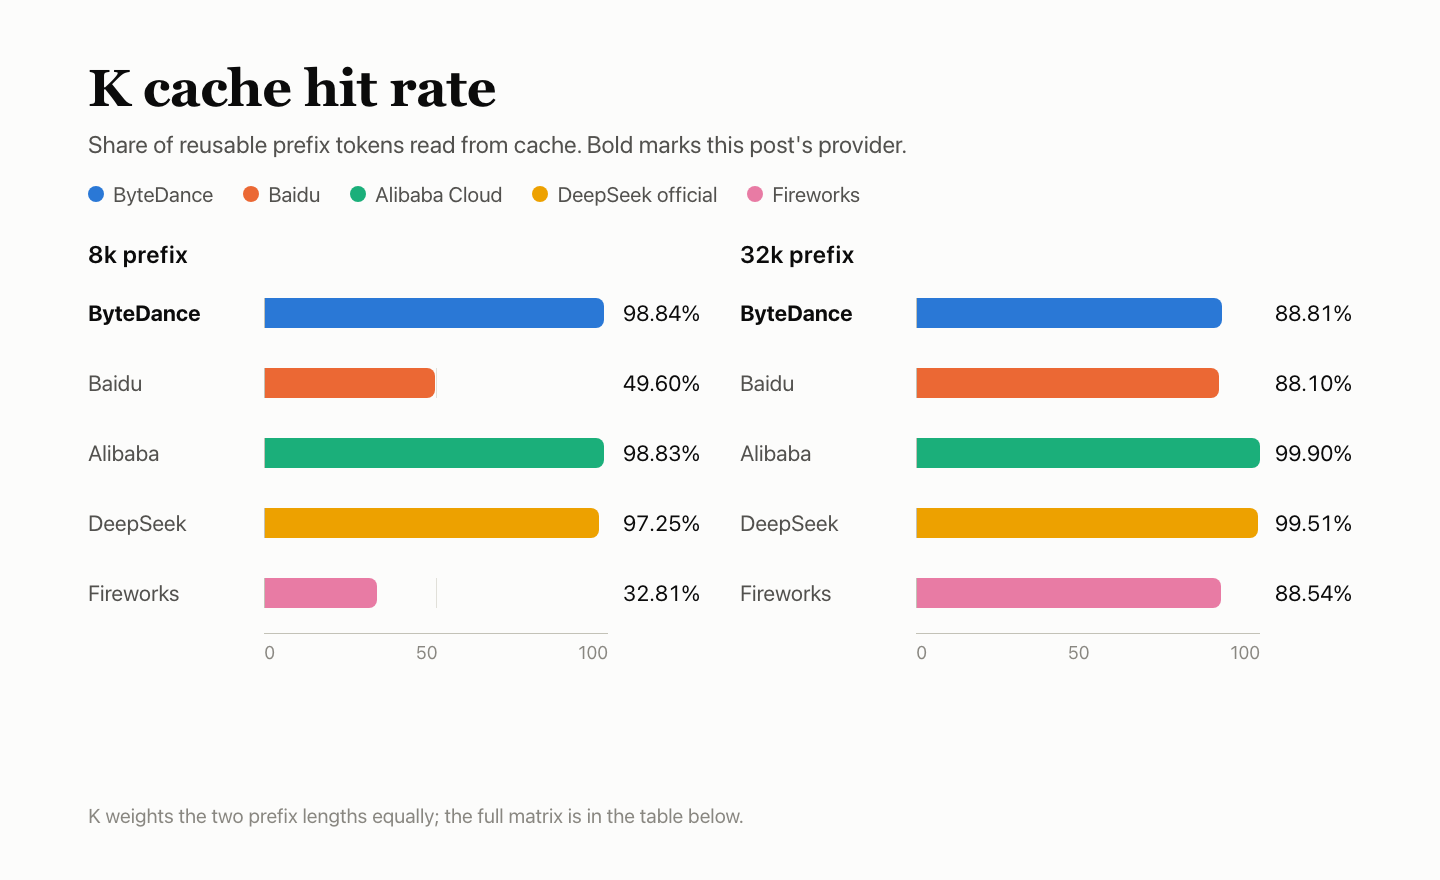
- K 93.83. Гарячі запити 8k дали влучення в кеш у 9 із 9 випадків; для 32k влучення було 8 разів, а один запит не завершився за граничні 300 с.
- R 100. Усі 300 спеціальних запитів успішно виконано з першої спроби.
Налаштування тестування
| Параметр | Деталі |
|---|---|
| Модель | DeepSeek V4.1 Flash 1017 |
| Запитаний ID моделі | doubao-deepseek-v4.1-flash-1017 |
| Повернена назва моделі | deepseek-v4-1-flash-261017 |
| Маршрут доступу | Через AIHubMix із провайдер-специфічним ID моделі, а не напряму через обліковий запис провайдера |
| Параметри | Режим без мислення, temperature 1.0, max_tokens 16,384, час очікування 300 с, без автоматичного повтору |
| Вимкнення мислення | Для запитів на якість відповідей, швидкість, кеш і стабільність використовували нативний параметр thinking.type=disabled (для цього провайдера reasoning_effort=none не вимикав режим мислення); у функціональних тестах залишали reasoning_effort=none, щоб перевірити, чи діє цей параметр |
| Час | 2026-11-03 18:07 – 11-04 16:33 UTC+8; п’ять провайдерів використовували один Mac mini, одну мережу й один обліковий запис |
| Вибірки | Якість відповідей: 4,250 екземплярів запитань (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10); функції: 60 випадків × 3 вікна; швидкість: 90 за одного паралельного запиту й 90 за 10 паралельних; стабільність: 300; кеш: 30 (три групи для префіксів 8k і 32k) |
Запити надсилали через маршрут швидкого старту AIHubMix із провайдер-специфічним ID, а параметри відповідали документації API DeepSeek; ID інших провайдерів наведено на сторінці моделей.
Q — якість відповідей: 42.05
Для оцінювання якості відповідей використано три набори: 500 запитань BFCL із 3 раундами для кожного, 250 запитань HLE із 10 раундами для кожного та 25 запитань AA-LCR із 10 раундами для кожного. BFCL оцінюється за автоматичними правилами; HLE та AA-LCR перевіряє модель deepseek-flash. Усі п’ять провайдерів отримали однакові запитання, а результати трьох наборів об’єднано в один показник точності. Десять відповідей вилучили, бо запитання не підлягало оцінюванню; залишилося 4,240 оцінених екземплярів запитань.
| Набір | Запитання | Правильні | Точність | Збої |
|---|---|---|---|---|
| Виклики інструментів BFCL | 500 × 3 | 1,278/1,500 | 85.20% | 0 |
| Складні запитання й відповіді HLE | 250 × 10 | 382/2,490 | 15.34% | 7 |
| Міркування за довгими документами AA-LCR | 25 × 10 | 123/250 | 49.20% | 28 |
| Разом · 95% інтервал 39.70%–44.33% | — | 1,783/4,240 | 42.05% | 35 |
Збої сервісу — збої запитів або обрізаний вивід — залишаються в знаменнику й зараховуються як неправильні відповіді. У HLE вивід 7 разів досягав межі max_tokens; в AA-LCR сталося 28 збоїв запитів — усі у вікні 1. BFCL оцінюється автоматично, а HLE та AA-LCR — суддею.
На кожне запитання BFCL надано 3 відповіді; у таблиці підсумовано всі 3 раунди.
| Категорія BFCL | Пройдено | Частка проходження |
|---|---|---|
| simple_python — одна функція, правильний виклик і аргументи | 329/360 | 91.39% |
| multiple — вибір однієї з кількох функцій | 268/300 | 89.33% |
| parallel — кілька викликів тієї самої функції | 271/300 | 90.33% |
| parallel_multiple — виклики кількох різних функцій | 207/240 | 86.25% |
| irrelevance — жодна функція не стосується запиту, викликати її не слід | 102/150 | 68.00% |
| ahm_multi_turn — ланцюжок інструментів із трьох етапів | 101/150 | 67.33% |
Порівняння з рештою чотирма
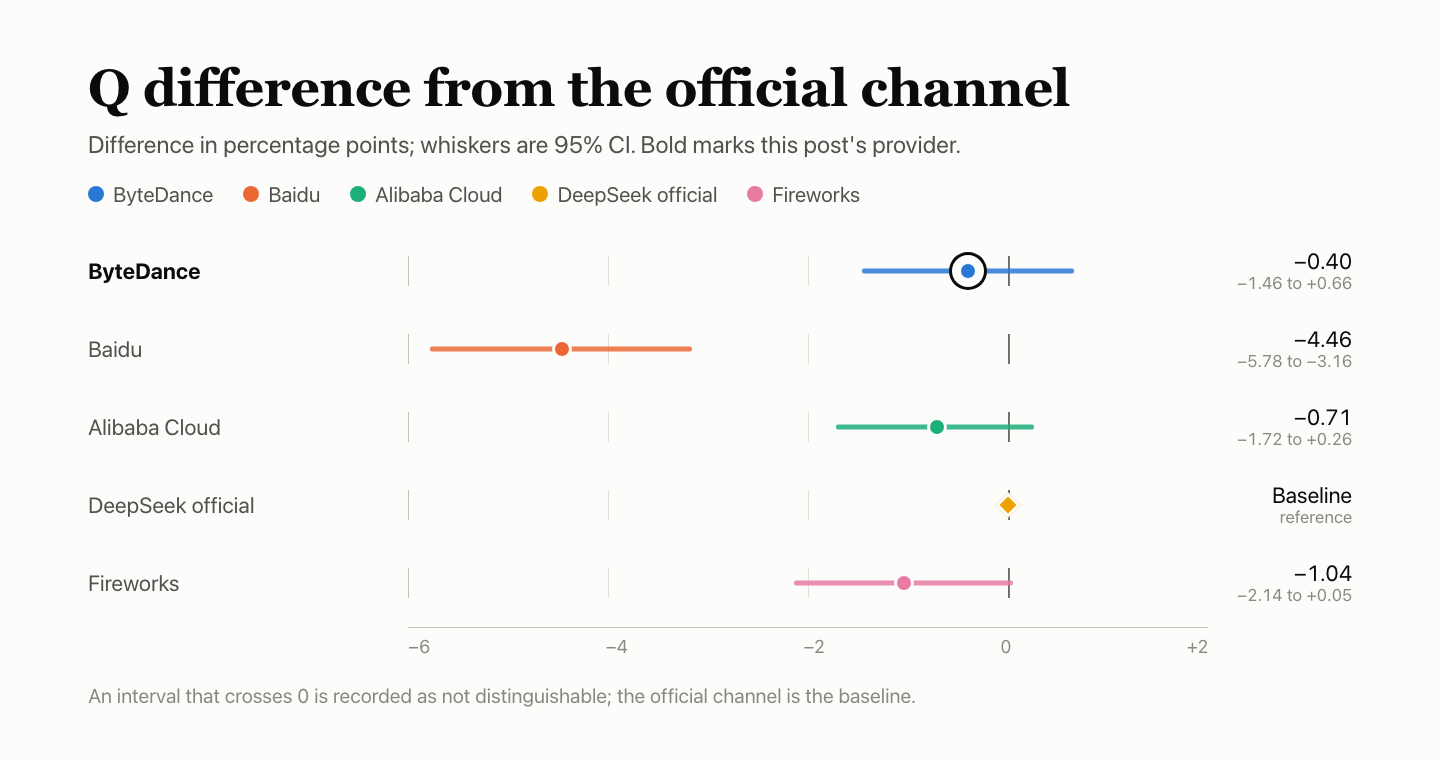
Різницю з офіційним каналом наведено у відсоткових пунктах; 95% інтервал показано вусами. Якщо інтервал перетинає 0, результат позначено як статистично нерозрізнюваний. HLE та AA-LCR оцінює суддя deepseek-flash, який належить до тієї самої родини DeepSeek, що й тестована модель, і не проходив калібрування, тому його оцінки можуть бути поблажливими.
F — підтримка функцій: 74.98
Набір функціональних тестів перевіряє лише відповідність поведінки інтерфейсу протоколу, а не якість відповідей моделі. Шістдесят випадків у шести групах запускали тричі — по одному разу для кожного вікна: 180 перевірок, оцінених за форматом, задокументованим кожним провайдером. Перевірки, які не стосувалися інтерфейсу, були невалідними або за якими не було спостережень, вилучили зі знаменника. ByteDance пройшов 124 із 174 зарахованих перевірок і набрав 74.98 з урахуванням ваг груп.
Зважена оцінка враховує ваги груп; це не частка пройдених перевірок від 174.
| Група | Вага | Пройдено | Вилучено | Оцінка групи |
|---|---|---|---|---|
| Потокова передача та протокол повідомлень | 20% | 23/27 | 3 | 85.19 |
| Інтерфейс інструментів | 20% | 30/30 | — | 100.00 |
| Обмеження виводу й параметри | 20% | 24/30 | — | 80.00 |
| Контекст і стан | 15% | 14/30 | — | 46.67 |
| Помилки та відновлення | 15% | 21/30 | — | 70.00 |
| Облік і протокол кешу | 10% | 12/27 | 3 | 44.44 |
| Разом · зважена оцінка | — | 124/174 | 6 | 74.98 |
«Збої у вікнах» — це кількість вікон із 3, у яких перевірку не пройдено.
| Випадок із помилкою | Збої у вікнах | Причина |
|---|---|---|
| Міркування не потрапляють у вміст — потокова передача та протокол повідомлень | 3/3 | Попри reasoning_effort=none, вміст мислення все одно повертався |
| Параметри мислення застосовуються — обмеження виводу й параметри | 3/3 | Попри reasoning_effort=none, вміст мислення все одно повертався |
| Різноманітність семплювання — обмеження виводу й параметри | 3/3 | Виводи для temperature 0 і 1 недостатньо відрізнялися; не досягнуто попередньо зареєстрованого порогу |
| Довгий вхід 10k — контекст і стан | 3/3 | Вказано 10,026 вхідних токенів; за нативним підрахунком має бути 10,000 |
| У межах контекстного ліміту — контекст і стан | 3/3 | Вказано 10,026 вхідних токенів; за нативним підрахунком має бути 10,000 |
| Довгий вхід 32k — контекст і стан | 3/3 | Вказано 10,026 вхідних токенів; за нативним підрахунком має бути 10,000 |
| Довгий вхід 100k — контекст і стан | 3/3 | Вказано 10,026 вхідних токенів; за нативним підрахунком має бути 10,000 |
| Понад контекстний ліміт — контекст і стан | 3/3 | Збій підключення до вищого рівня або час очікування вичерпано (1); мала повернутися помилка параметра, натомість повернувся код 200 (2) |
| Історія з 12 ходів — контекст і стан | 1/3 | Збій підключення до вищого рівня або час очікування вичерпано |
| Помилка формату messages — помилки та відновлення | 3/3 | Повернуто код 400 із порожнім тілом; структурованого пояснення помилки немає |
| Результат інструмента без виклику — помилки та відновлення | 3/3 | Мала повернутися помилка параметра, натомість повернувся код 200 |
| Помилка формату stream_options — помилки та відновлення | 3/3 | Повернуто код 400 із порожнім тілом; структурованого пояснення помилки немає |
| Облік токенів мислення — облік і протокол кешу | 3/3 | Токени мислення вказано після вимкнення режиму мислення |
| Нативний підрахунок вхідних токенів — облік і протокол кешу | 3/3 | Вказано 34 токени; за нативним підрахунком має бути 8 |
| Визначення інструментів враховано у вхідних даних — облік і протокол кешу | 3/3 | Контрольний запит без інструментів уже не збігався з нативним підрахунком вхідних токенів |
| Підрахунок вхідних даних узгоджений до і після кешування — облік і протокол кешу | 3/3 | Після повторного надсилання того самого префікса вказана кількість вхідних токенів не збігалася з нативним підрахунком |
| Підрахунок вхідних даних узгоджений у потоковому режимі й без нього — облік і протокол кешу | 3/3 | В обох випадках вказано 34 токени; за нативним підрахунком має бути 8 |
| Точний текстовий вивід — потокова передача та протокол повідомлень | 1/3 | Наприкінці тіла відповіді додалася зайва крапка; запитаний текст відтворено неточно |
Ці перевірки вилучаються зі знаменника: вони не зараховуються ні як пройдені, ні як провалені.
| Статус | Випадок | Кількість | Причина |
|---|---|---|---|
| Без спостережень | Послідовності зупинки потокової передачі | 3 | Після попереднього кроку цей запит не надсилали; оцінити неможливо |
| Не застосовується | Явний cache_control | 3 | Заздалегідь зареєстровано як непідтримуваний цим інтерфейсом |
Усі п’ять провайдерів провалили перевірки на помилки формату messages і stream_options: обидва запити повертали код 400 із порожнім тілом, тому клієнти не отримують структурованого пояснення помилки. Збій у всіх п’яти провайдерів, імовірніше за все, виникає на рівні шлюзу AIHubMix і потребує окремого розслідування. Усі п’ять також не пройшли перевірку обліку токенів мислення, але з різних причин: ByteDance і Fireworks указували токени мислення після його вимкнення; решта трьох не повертали кількість токенів мислення.
Порівняння з рештою чотирма
P — швидкість відповіді: 84.37
Кожен запит містив близько 10,000 вхідних токенів і запитував приблизно 1,100 токенів тексту в тілі відповіді. У кожному з трьох вікон запускали 30 запитів за одного паралельного запиту та 30 запитів за 10 паралельних: загалом 180 запитів.
| Метрика | Результат |
|---|---|
| Очікування першого токена тіла відповіді (TTFA) | Медіана 2.12 с за одного паралельного запиту; медіана 2.10 с за 10 паралельних |
| Швидкість генерації (TPOT) | 3.43 мс/токен за одного паралельного запиту; 3.41 мс/токен за 10 паралельних |
| Ефективна пропускна здатність | 1,250.0 токенів/с за 10 паралельних запитів |
| Валідні запити | 90/90 за одного паралельного запиту; 90/90 за 10 паралельних |
| Оцінки складових | TTFA 48.59, TPOT 100.00, пропускна здатність 100.00; для TTFA і TPOT береться нижчий із двох рівнів; ваги 35% / 35% / 30%; оцінка швидкості відповіді 82.00 |
| Оцінка P | Оцінка швидкості відповіді 82.00 із вагою 80%, кеш K 93.83 із вагою 20%; разом 84.37 |
TPOT оцінюється за потоковими фрагментами, а не вимірюється для кожного токена на обладнанні. Пропускна здатність — це кількість валідних вихідних токенів за 10 паралельних запитів, поділена на загальний час виконання пакета.
Порівняння з рештою чотирма
Усі п’ять провайдерів використовували один комп’ютер, одну мережу й один обліковий запис. Три вікна запускали для провайдерів по черзі, тому періоди збору даних повністю не збігаються; не варто надмірно інтерпретувати незначні відмінності.
K — кеш: 93.83
У кожній групі надсилають п’ять запитів. Перший містить фіксований префікс приблизно на 8k або 32k токенів і заповнює кеш. У запитах 2–4 префікс залишається незмінним, а змінюється лише фінальне запитання; їх надсилають через 5 с, 30 с і 120 с. П’ятий запит використовує новий префікс як контрольний запит без кешу. Три вікна, два розміри й п’ять запитів у кожній групі дають 30 запитів. K — це кількість токенів, зчитаних із кешу для гарячих запитів, поділена на кількість токенів, які мають повторно використовуватися згідно з правилами; обидва розміри мають однакову вагу. K становить 20% оцінки P.
| Префікс | Вікно | Початкове заповнення | +5 s | +30 s | +120 s | Контрольний запит без кешу |
|---|---|---|---|---|---|---|
| 8k | Вікно 1 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Вікно 2 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Вікно 3 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 32k | Вікно 1 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Вікно 2 | 0 | 32,000 | 32,000 | помилка | 0 |
| 32k | Вікно 3 | 0 | 32,000 | 32,000 | 32,000 | 0 |
Значення — це токени, зчитані з кешу, за даними сервера.
Усі дев’ять запитів із гарячим кешем і 8k влучили в кеш, кожен зчитав 7,936 токенів. Вісім із дев’яти запитів із гарячим кешем і 32k влучили в кеш, кожен зчитав 32,000 токенів; один запит завершився помилкою. K дорівнює 93.83, причому обидві довжини мають однакову вагу. Холодні запити не зчитували кеш, тож гарячі й холодні запити чітко розділяються. Помилка сталася з четвертим запитом групи 32k у вікні 2: він досяг граничного часу очікування 300 s, так і не завершившись.
Порівняння з іншими чотирма
R — стабільність сервісу: 100
300 запитів поділяються на чотири типи — короткий текст, довгий ввід, виклики інструментів і історія з кількома ходами — і виконувалися з паралельністю 1 у трьох вікнах. Запит зараховується як успішний, лише якщо перша спроба повернула коректну й повну відповідь; правильність відповіді не перевіряється, повторних спроб немає. Помилки в розділах про якість відповідей і швидкість зараховуються до Q і P, а не повторно до R.
| Тип запиту | Успіх із першої спроби |
|---|---|
| Короткий текст | 120/120 |
| Довгий ввід 10k | 90/90 |
| Виклики інструментів | 60/60 |
| Історія з кількома ходами | 30/30 |
| Разом · 95% інтервал 98.78%–100% | 300/300 |
Усі 300 запитів із першої спроби повернули коректну й повну відповідь. R = 100 стосується лише цих 300 окремих запитів; це не означає, що весь ланцюжок пройшов без помилок. Нижня межа 95% інтервалу становить 98.78%: 300 успішних запитів дають підстави лише стверджувати, що ймовірний рівень помилок нижчий за 1.22%.
Порівняння з іншими чотирма
R охоплює лише ці 300 окремих запитів; помилки в розділах про якість відповідей і швидкість фіксуються в Q і P та не зараховуються повторно до R.
| Провайдер | Успіх із першої спроби | 95% інтервал |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek official | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
FAQ
Чи справді reasoning_effort=none не вимкнув мислення?
Так. У всіх трьох вікнах запити з reasoning_effort=none усе одно повертали вміст мислення, тож перевірка провалилася у 3 випадках із 3. Для запитів на перевірку якості відповідей, швидкості, кешу й стабільності натомість використовувався нативний перемикач thinking.type=disabled. У наборі тестів функцій reasoning_effort=none навмисно залишили, щоб перевірити, чи подіяв цей параметр.
Точність BFCL становить 85.20%. Чому Q дорівнює 42.05?
Q об’єднує результати трьох наборів тестів із дуже різним рівнем складності. У BFCL правильними були 1,278 із 1,500 відповідей, у HLE — 382 із 2,490, а в AA-LCR — 123 із 250. Загалом правильними були 1,783 із 4,240 оцінюваних екземплярів запитань: 42.05%. Результат HLE на рівні 15.34% знижує загальний показник.
Чи враховані 35 помилок сервісу в Q?
Так. Помилки запитів і обрізаний вивід залишаються в знаменнику й зараховуються як неправильні відповіді. Сім відповідей HLE обірвалися на max_tokens; 28 запитів AA-LCR завершилися помилкою, усі у вікні 1.
Чому важливий облік вхідних токенів?
Тому що облік має відповідати нативному підрахунку моделі. Для вводу на 10k токенів було вказано 10,026 токенів (нативне значення — 10,000), а для вводу на 8 токенів — 34. Контрольний запит без інструментів уже показав розбіжність, а потокова передача й режим без потокової передачі обидва повертали 34. Усі п’ять перевірок обліку токенів провалилися у 3 випадках із 3.
Результат кешу для 32k — це промах чи помилка?
Помилка. Вісім із дев’яти запитів із гарячим кешем і 32k влучили в кеш і зчитали 32,000 токенів. Один промах — це четвертий запит у вікні 2, який досяг граничного часу очікування 300 s, так і не завершившись. У групі 8k у кеш влучили всі 9 із 9 запитів, по 7,936 токенів.
Чи можна відрізнити якість відповідей ByteDance від офіційного каналу?
Ні. Загальна точність на 0.40 пункту нижча, ніж в офіційному каналі, а 95% інтервал становить від −1.46 до +0.66. Інтервал охоплює 0, тож ці результати не можна розрізнити. Це стосується лише цієї вибірки й не є рейтингом.
Читайте далі: серія матеріалів про DeepSeek V4.1 Flash
- Базовим значенням Q у цій статті є результат офіційного каналу; окремий запуск цього каналу, включно з 15 невалідними пробами з паралельністю 1, описано в статті DeepSeek V4.1 Flash в офіційному каналі: 94.00 F, 15 невалідних проб.
- Baidu — єдиний провайдер, чий інтервал Q лежить нижче за результат офіційного каналу; помилки каналу, що зумовили цей результат, описано в статті DeepSeek V4.1 Flash на Baidu: недоступний канал досягає Q і P.
- Показники кешу Alibaba Cloud можна порівняти з 93.83, наведеним тут: DeepSeek V4.1 Flash на Alibaba Cloud: 1.34s до першого токена, 99.37 для кешу.
- У Fireworks виявлено ті самі помилки мислення й обліку токенів, що й тут, а також порожні відповіді на зупинення: DeepSeek V4.1 Flash на Fireworks: порожні відповіді на зупинення, 3/9 влучень у кеш.


