

У повному прогоні APB від 2026-11-03/04 чотири оцінки Pareto становлять Q 44.58, F 93.42, P 57.69 і R 100, а загальна оцінка — 68.72. Серед гарячих запитів 8k у кеш влучили 2 із 9, а серед 32k — 3 із 9.
2026-11-03/04 DeepSeek V4.1 Flash 1017 перевірили через AIHubMix у шести провайдерів за набором тестів APB Full, використовуючи для кожного однакові запитання, параметри й скрипти запитів. Цей профіль APB присвячений лише Pareto: що вимірював кожен розділ і якими виявилися результати.
Наведені нижче числа — це оцінки, а не рейтинг і не рекомендація провайдера. Спершу подано чотири оцінки — Q, F, P і R; загальна оцінка є зведеним індексом, а не сертифікацією, і для неї не наведено довірчого інтервалу. Правила оцінювання визначені в Стандарті бенчмарку провайдерів AIHubMix v2.0.
Оцінки шести провайдерів
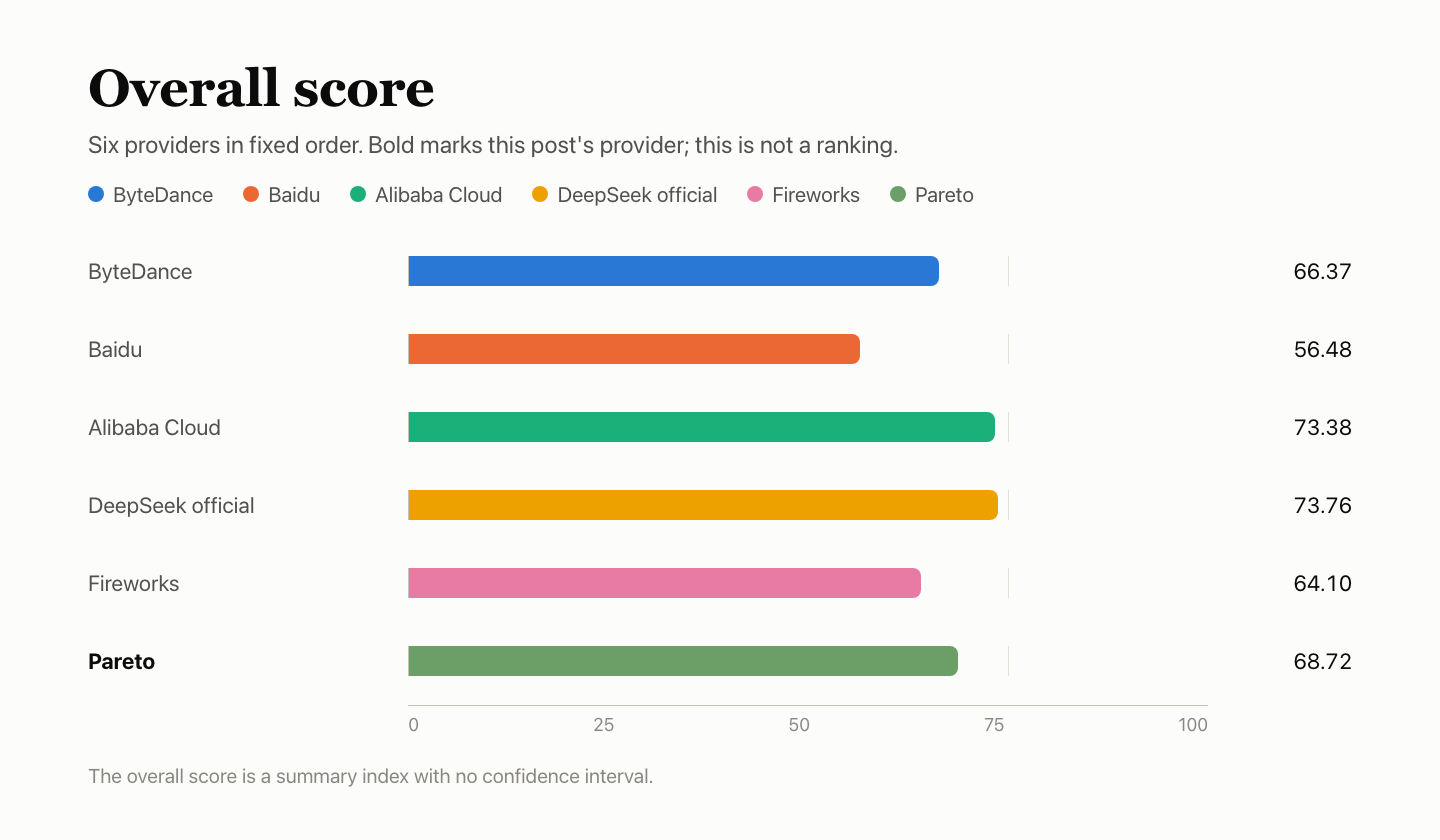
| Провайдер | Q — якість | F — функціональність | P — швидкість | K — кеш | R — стабільність | Загальна оцінка |
|---|---|---|---|---|---|---|
| ByteDance | 42.05 | 74.98 | 84.37 | 93.83 | 100 | 66.37 |
| Baidu | 38.00 | 88.39 | 37.77 | 68.85 | 100 | 56.48 |
| Alibaba Cloud | 41.75 | 89.78 | 88.58 | 99.37 | 100 | 73.38 |
| Офіційний канал DeepSeek | 42.45 | 94.00 | 86.14 | 98.38 | 100 | 73.76 |
| Fireworks | 41.42 | 71.78 | 79.51 | 60.68 | 100 | 64.10 |
| Pareto (ця стаття) | 44.58 | 93.42 | 57.69 | 27.58 | 100 | 68.72 |
Провайдери наведені в сталому порядку, а не за рейтингом. K — складова оцінки P, на яку припадає 20%, і її наведено окремо для довідки. Загальну оцінку обчислено за правилами композиції зі Стандарту бенчмарку провайдерів AIHubMix; у розрахунку також враховано порівняння з офіційним каналом і повноту доказів. Це не пряме зважене середнє чотирьох оцінок у таблиці. Це зведений індекс без довірчого інтервалу. Загальні оцінки офіційного каналу DeepSeek і Alibaba Cloud відрізняються лише на 0.37 — це статистично нерозрізнювана різниця.
Короткий огляд
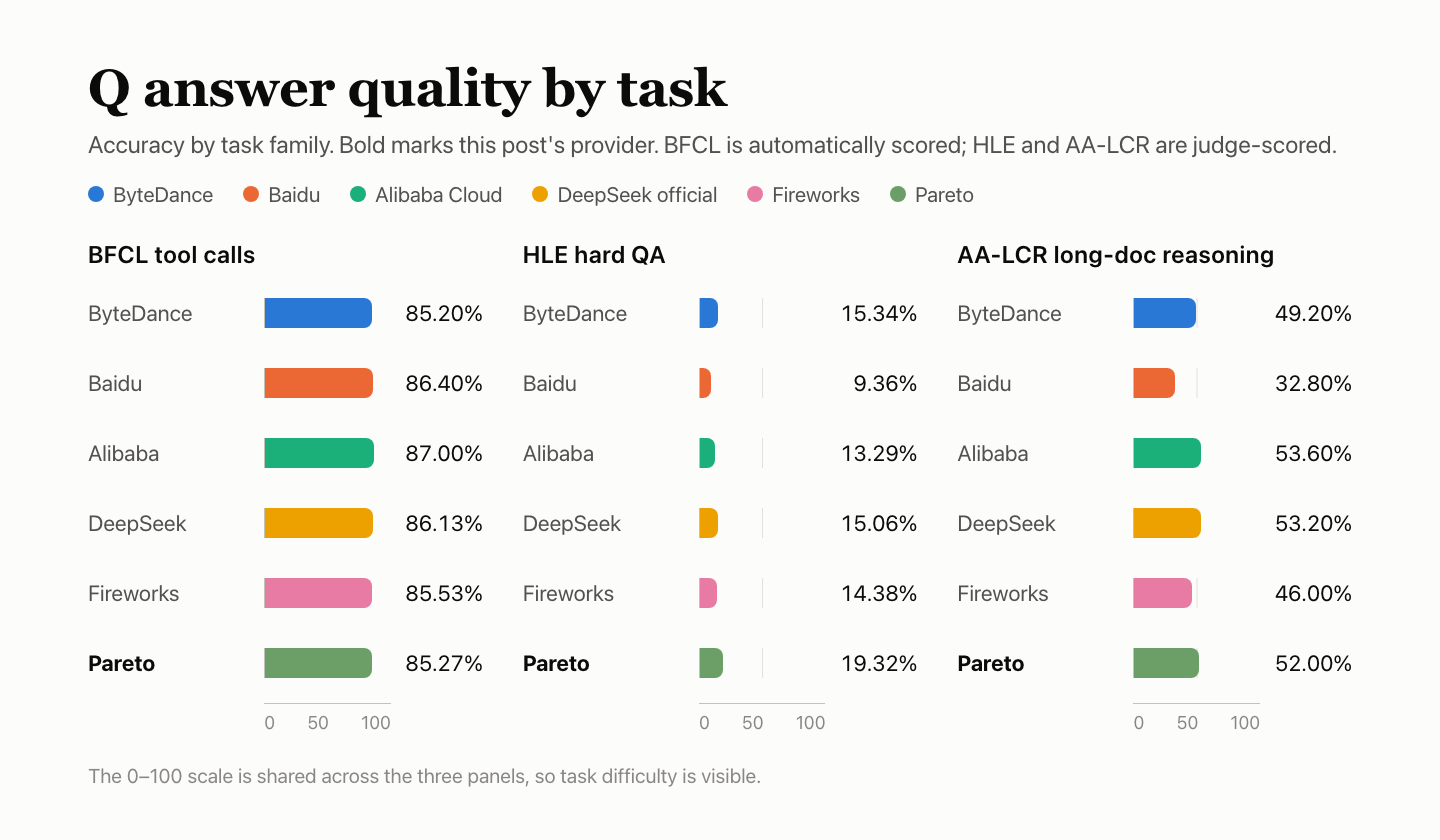
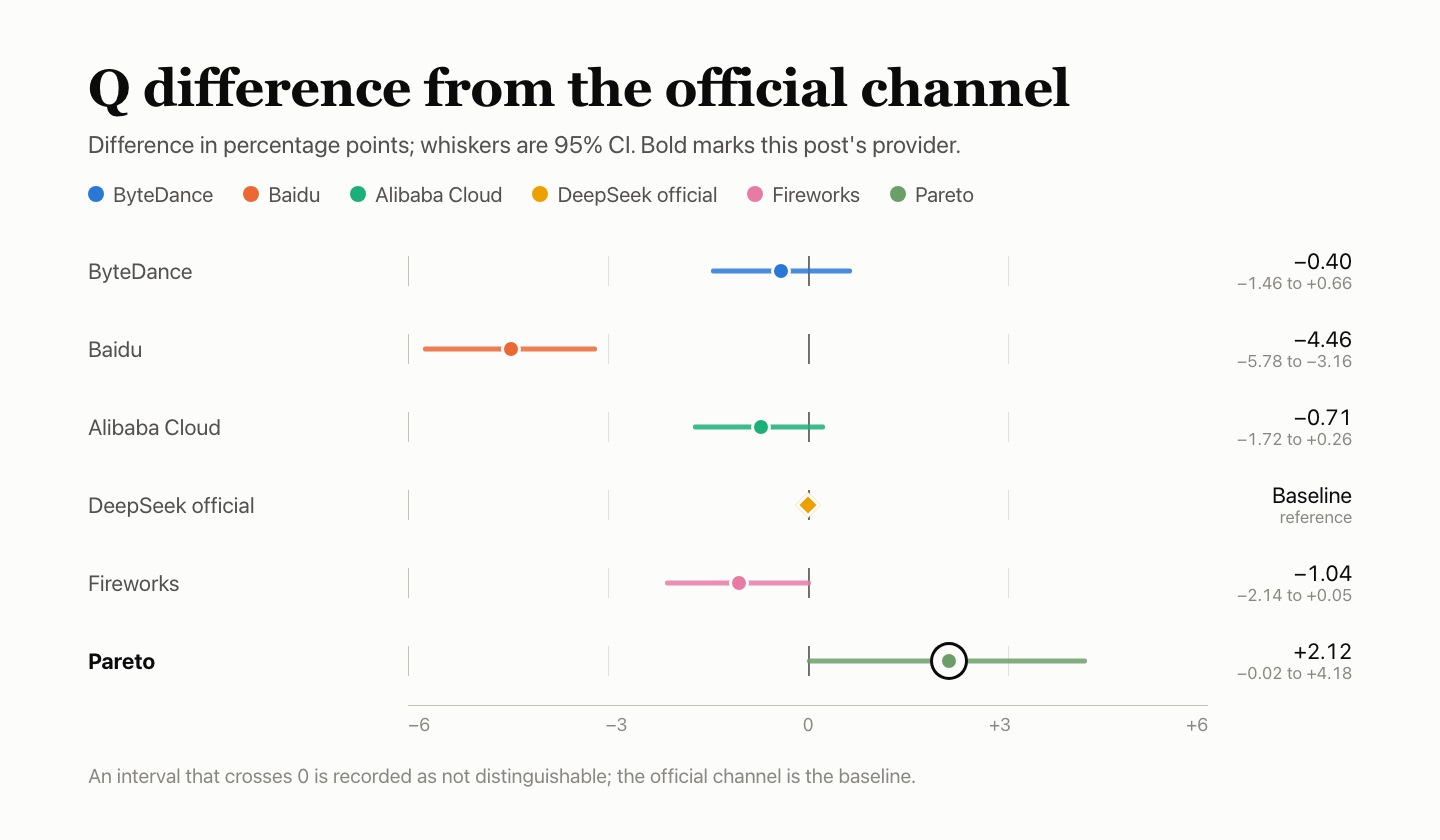
- Якість відповідей: Q 44.58; BFCL — 85.27%, HLE — 19.32%, AA-LCR — 52.00%. Перевага над офіційним каналом становить +2.12 відсоткового пункта, 95% інтервал — від −0.02 до +4.18: різниця статистично нерозрізнювана.
- Підтримка функцій: F 93.42; пройдено 29 із 33 початкових оцінюваних перевірок. Для викликів інструментів і циклу передавання результатів інструментів, паралельних і іменованих викликів, режиму JSON та історії розмов є додаткові успішні записи потокової передачі; оцінки збережено без змін.
- Швидкість відповіді: P 57.69. Медіанний час до першого токена тіла відповіді — 5.85 s за одного паралельного запиту й 6.13 s за 10 паралельних запитів; TPOT — 4.63 ms; валідними були 110 із 180 запитів на швидкість.
- Кеш: K 27.58. Серед гарячих запитів 8k у кеш влучили 2 із 9, а серед 32k — 3 із 9; жоден контрольний холодний запит не зчитав дані з кешу.
- Стабільність сервісу: R 100. Усі 300 спеціальних запитів виконалися з першої спроби.
Налаштування тестування
| Пункт | Деталі |
|---|---|
| Модель | DeepSeek V4.1 Flash 1017 |
| Запитаний ID моделі | deepseek/deepseek-v4.1-flash |
| Повернена назва моделі | deepseek/deepseek-v4.1-flash |
| Маршрут доступу | Через AIHubMix із ID моделі, специфічним для провайдера; не пряме підключення до облікового запису провайдера |
| Параметри | Фіксований профіль запитів APB v2, temperature 1.0, max_tokens 16,384, тайм-аут 300 s, автоматичних повторних спроб немає |
| Час | 2026-11-03 18:07 – 11-04 16:33; запити до кешу — 11-05 19:31 – 11-06 10:35; час усюди UTC+8. Усі шість провайдерів використовували один Mac mini, одну мережу й один обліковий запис. |
| Вибірки | Q — 4,250 екземплярів запитань; F — 180 перевірок; P — 180 запитів; R — 300; K — 30 |
У запитах використовувався маршрут швидкого старту AIHubMix з ID моделі, специфічним для провайдера; ID моделей інших провайдерів наведено на сторінці моделей. Параметри самої моделі описані в документації API DeepSeek.
Q — якість відповідей: 44.58
Якість відповідей оцінюється за трьома наборами тестів: 500 запитань BFCL, на кожне з яких дано по 3 відповіді; 250 запитань HLE, на кожне — по 10 відповідей; і 25 запитань AA-LCR, на кожне — по 10 відповідей. BFCL оцінюється автоматичними правилами; відповіді HLE та AA-LCR суддівська модель deepseek-flash оцінює як правильні або неправильні. Усі шість провайдерів отримали однакові запитання, а результати трьох наборів об’єднано в одну точність. Десять відповідей вилучили, оскільки їхні запитання не можна було оцінити; залишилося 4,240 оцінюваних екземплярів запитань.
| Набір тестів | Запитання × раунди | Правильні відповіді | Точність | Збої сервісу |
|---|---|---|---|---|
| Виклики інструментів BFCL, автоматичне оцінювання | 500 × 3 | 1,279/1,500 | 85.27% | 0 |
| Складні запитання HLE, оцінювання суддівською моделлю | 250 × 10 | 481/2,490 | 19.32% | 0 |
| Міркування за довгими документами AA-LCR, оцінювання суддівською моделлю | 25 × 10 | 130/250 | 52.00% | 0 |
| Разом · 95% інтервал 41.57%–47.49% | — | 1,890/4,240 | 44.58% | 0 |
На кожен екземпляр запитання надійшла повна відповідь; збоїв сервісу не було.
| Категорія BFCL | Пройдено | Частка проходження |
|---|---|---|
| simple_python: одна функція, правильний виклик і аргументи | 333/360 | 92.50% |
| multiple: вибір правильної функції з кількох | 269/300 | 89.67% |
| parallel: одночасний виклик однієї функції кілька разів | 265/300 | 88.33% |
| parallel_multiple: одночасний виклик кількох функцій | 203/240 | 84.58% |
| irrelevance: немає відповідної функції, тож виклик не потрібен | 109/150 | 72.67% |
| ahm_multi_turn: триетапний ланцюжок інструментів | 100/150 | 66.67% |
На кожне запитання BFCL надано 3 відповіді; у таблиці підсумовано результати всіх 3 раундів.
Порівняння з іншими п’ятьма
| Провайдер | BFCL | HLE | AA-LCR | Разом | Порівняно з офіційним каналом |
|---|---|---|---|---|---|
| ByteDance | 85.20% | 15.34% | 49.20% | 42.05% | −0.40 (−1.46 до +0.66), різниця статистично нерозрізнювана |
| Baidu | 86.40% | 9.36% | 32.80% | 38.00% | −4.46 (−5.78 до −3.16), нижче за офіційний канал |
| Alibaba Cloud | 87.00% | 13.29% | 53.60% | 41.75% | −0.71 (−1.72 до +0.26), різниця статистично нерозрізнювана |
| Офіційний канал DeepSeek | 86.13% | 15.06% | 53.20% | 42.45% | Базовий рівень |
| Fireworks | 85.53% | 14.38% | 46.00% | 41.42% | −1.04 (−2.14 до +0.05), різниця статистично нерозрізнювана |
| Pareto (ця стаття) | 85.27% | 19.32% | 52.00% | 44.58% | +2.12 (−0.02 до +4.18), різниця статистично нерозрізнювана |
Порівняння з офіційним каналом: різниця точності у відсоткових пунктах із 95% інтервалом у дужках; якщо інтервал охоплює 0, різницю вважають статистично нерозрізнюваною. Суддівська модель для HLE й AA-LCR, deepseek-flash, належить до тієї самої родини DeepSeek, що й тестована модель, і не проходила калібрування, тому її оцінки можуть бути поблажливими.
F — підтримка функцій: 93.42
Перевірки функцій з’ясовують, чи відповідає поведінка інтерфейсу протоколу. Оцінку F 93.42 отримано за 33 врахованими перевірками (29 пройдено) з перенормуванням фактичних ваг груп; решту 147 запланованих перевірок початкового набору виключено з оцінювання.
| Група перевірок | Вага | Пройдено / спостереження потокової передачі | Виключено | Оцінка групи |
|---|---|---|---|---|
| Потокова передача й протокол повідомлень | 20% | 23/27 | 3 | 85.19 |
| Інтерфейс інструментів Виклики інструментів, цикл передавання результатів інструментів, паралельні й іменовані виклики | 20% | Зафіксовано успішні перевірки потокової передачі* | 30 | — |
| Обмеження виводу й параметри Режим JSON і вимкнене міркування | 20% | Зафіксовано успішні перевірки потокової передачі* | 30 | — |
| Контекст і стан Історія розмови й системні інструкції | 15% | Зафіксовано успішні перевірки потокової передачі* | 30 | — |
| Помилки й відновлення | 15% | 3/3 | 27 | 100.00 |
| Протокол обліку використання й кешу | 10% | 3/3 | 27 | 100.00 |
| Разом · зважена оцінка | 29/33 | 147 | 93.42 | |
- Для перелічених функцій є записи успішної потокової передачі; це не означає, що групі загалом зараховано повний бал. До оцінювання не додавали нових перевірок. Значення F 93.42 і загальна оцінка 68.72 залишаються без змін.
| Невдала перевірка | Вікна | Причина |
|---|---|---|
| Послідовність завершення потокової передачі Потокова передача й протокол повідомлень | 3/3 | Порожнє тіло відповіді із послідовністю завершення; той самий запит без неї спрацював |
| Точний текстовий вивід Потокова передача й протокол повідомлень | 1/3 | Зайва крапка наприкінці порушила точний збіг тексту |
«Вікна» — це кількість із 3 вікон, у яких перевірка завершилася невдачею.
У кількох провайдерів запити з некоректними повідомленнями та некоректними параметрами потокової передачі повернули код 400 із порожнім тілом відповіді. Облік токенів міркування відрізнявся між провайдерами.
Порівняння з іншими п’ятьма
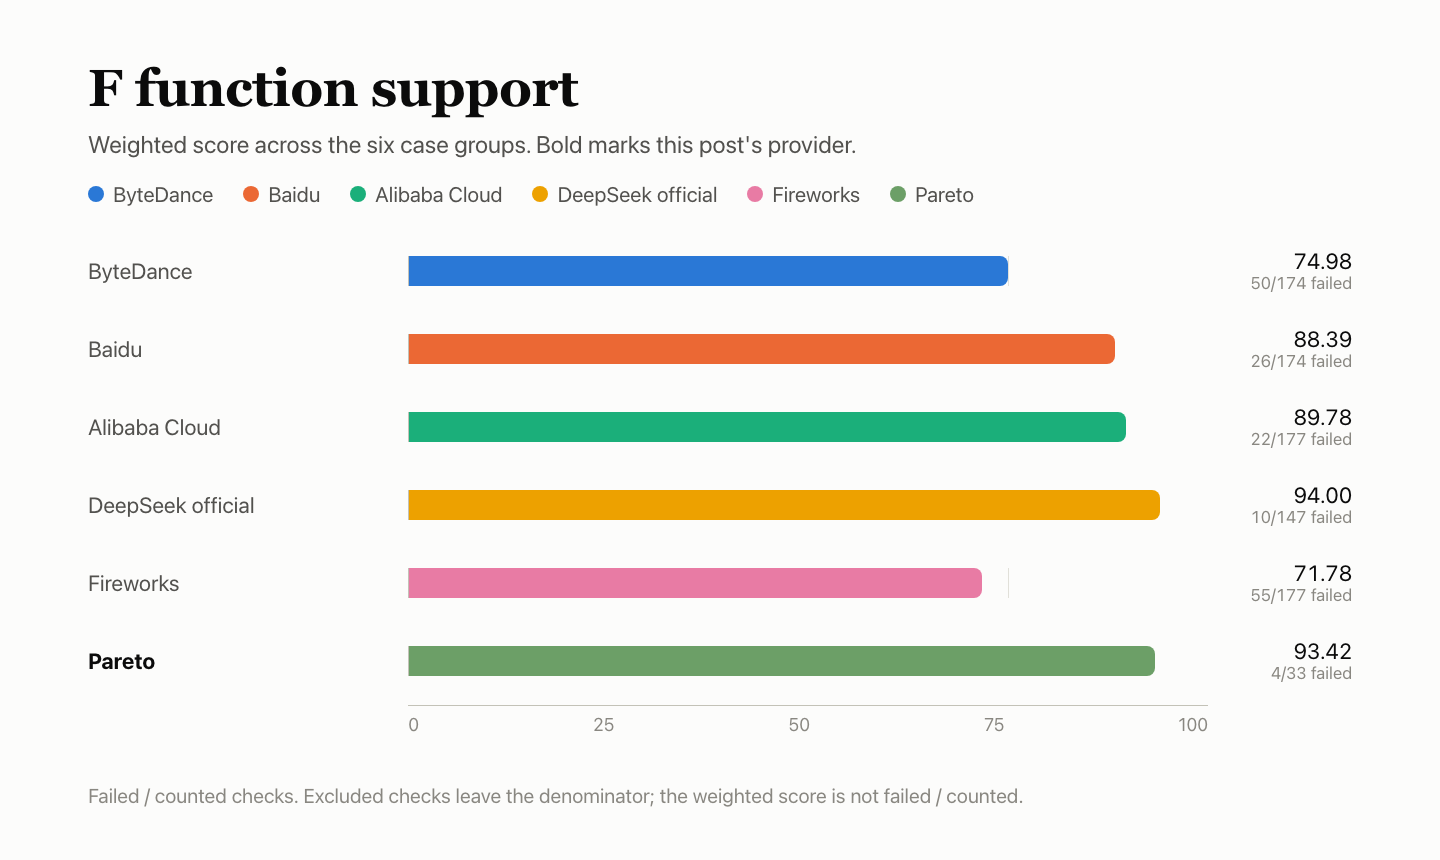
| Провайдер | Пройдено | Не пройдено | Виключено | Зважена оцінка |
|---|---|---|---|---|
| ByteDance | 124 | 50 | 6 | 74.98 |
| Baidu | 148 | 26 | 6 | 88.39 |
| Alibaba Cloud | 155 | 22 | 3 | 89.78 |
| Офіційний канал DeepSeek | 137 | 10 | 33 | 94.00 |
| Fireworks | 122 | 55 | 3 | 71.78 |
| Pareto (ця стаття) | 29 | 4 | 147 | 93.42 |
P — швидкість відповіді: 57.69
Кожен запит містив приблизно 10,000 вхідних токенів і просив згенерувати близько 1,100 вихідних токенів тексту відповіді. У кожному з трьох вікон запускали по 30 запитів з одним паралельним запитом і по 30 із 10 паралельними запитами: загалом 180 запитів.
| Пункт | Деталі |
|---|---|
| Перший токен тіла відповіді (TTFA) | Медіана 5.85 s за одного паралельного запиту (3.08 s лише для валідних), 6.13 s за 10 паралельних запитів (4.92 s лише для валідних) |
| Швидкість генерації (TPOT) | 4.42 ms/токен за одного паралельного запиту, 4.63 ms/токен за 10 паралельних запитів |
| Ефективна пропускна здатність | 519.4 токена/s за 10 паралельних запитів |
| Валідні запити | 53/90 за одного паралельного запиту (вікна 1–3: 15/30, 18/30, 20/30), 57/90 за 10 паралельних запитів (23/30, 16/30, 18/30); невалідні: 70 повернули 200 із None |
| Проміжні оцінки | TTFA 24.59, TPOT 100.00, пропускна здатність 72.05; TTFA і TPOT належать до нижчого рівня, ваги — 35% / 35% / 30%: оцінка швидкості відповіді — 65.22 |
| Оцінка P | Оцінка швидкості відповіді 65.22 × 80% + оцінка кешу K 27.58 × 20% = 57.69 |
Невалідні запити зараховуються як такі, що мають нескінченне значення, тому медіани в таблиці можуть бути вищими за медіани лише для валідних запитів. TPOT оцінюється за потоковими фрагментами, а не вимірюється для кожного токена на апаратному забезпеченні. Пропускна здатність — це кількість валідних вихідних токенів за 10 паралельних запитів, поділена на тривалість виконання пакета.
Порівняння з іншими п’ятьма
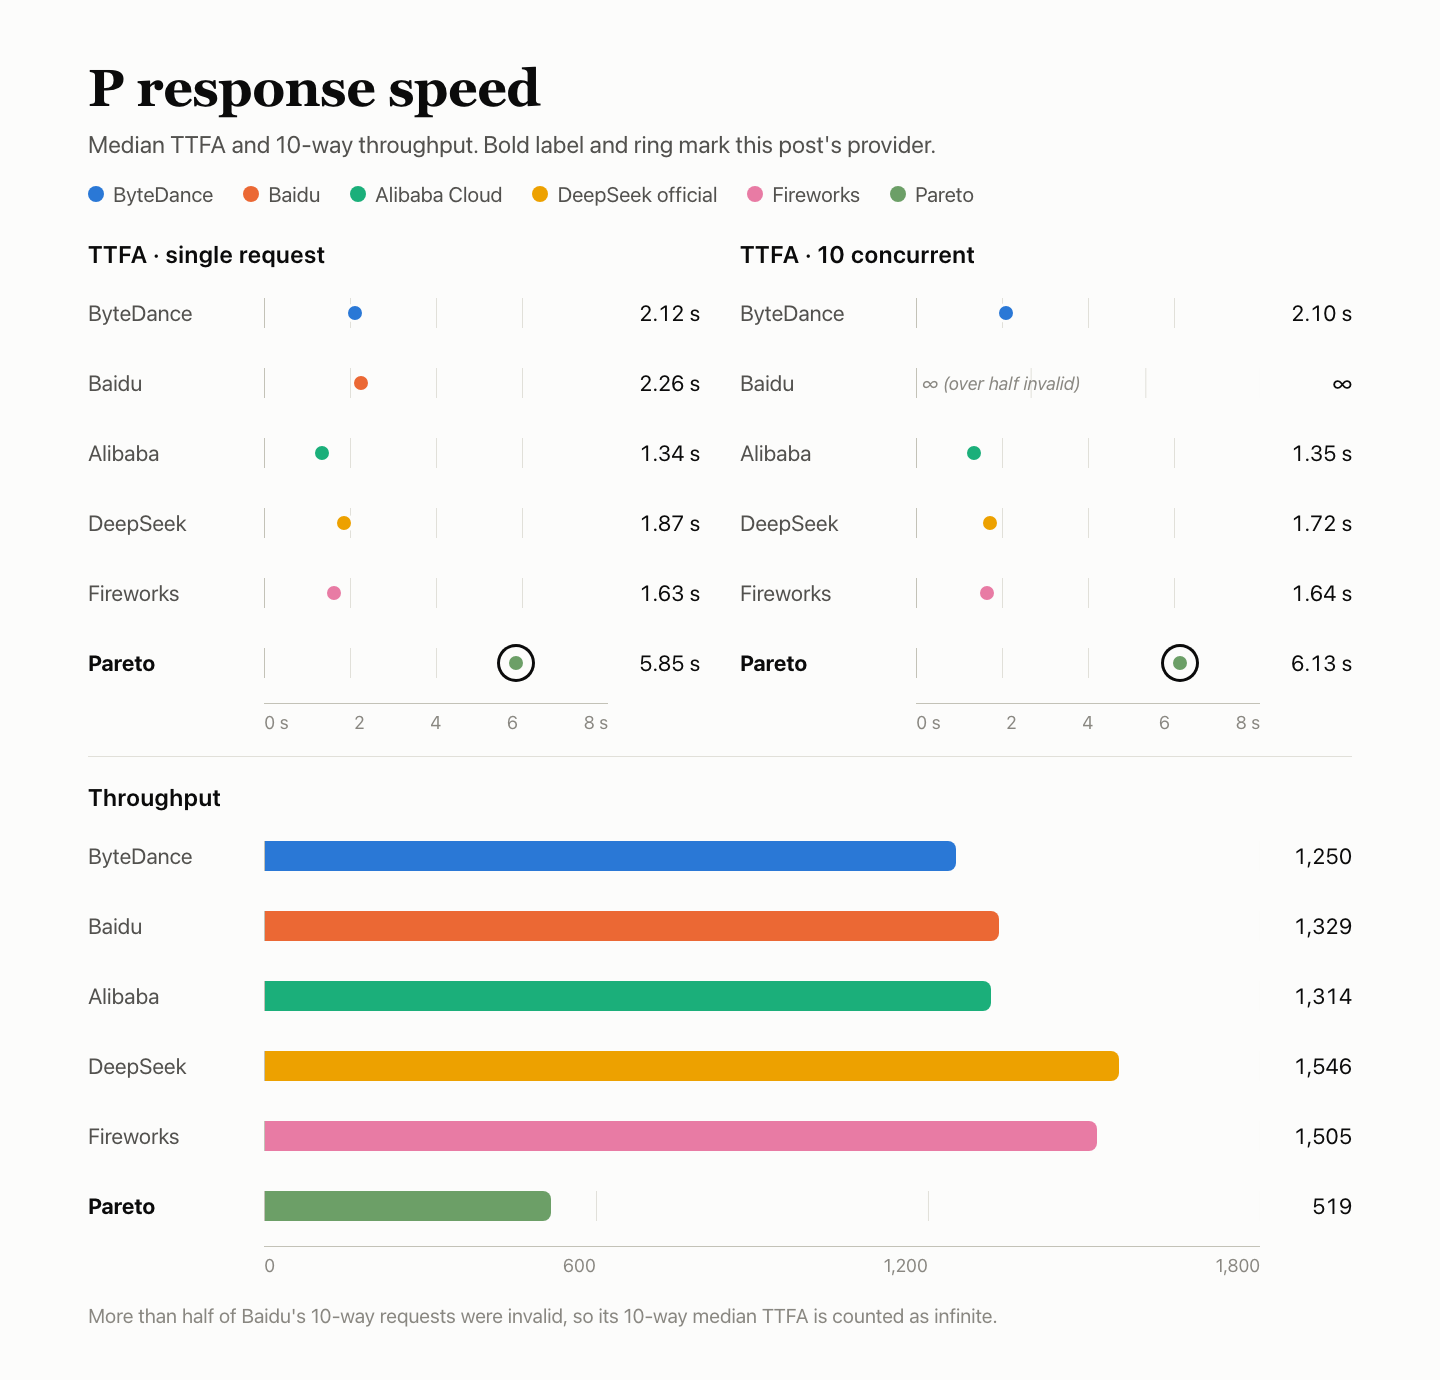
| Провайдер | Валідні запити | TTFA — один паралельний запит | TTFA — 10 паралельних запитів | TPOT (повільніше) | Пропускна здатність, токенів/s | Швидкість відповіді |
|---|---|---|---|---|---|---|
| ByteDance | 180/180 | 2.12 s | 2.10 s | 3.43 мс | 1,250 | 82.00 |
| Baidu | 118/180 | 2.26 s | ∞ | 50.00 мс | 1,329 | 30.00 |
| Alibaba Cloud | 180/180 | 1.34 s | 1.35 s | 4.69 мс | 1,314 | 85.88 |
| Офіційний канал DeepSeek | 165/180 | 1.87 s | 1.72 s | 2.84 мс | 1,546 | 83.08 |
| Fireworks | 179/180 | 1.63 s | 1.64 s | 3.29 мс | 1,505 | 84.22 |
| Pareto (ця стаття) | 110/180 | 5.85 s | 6.13 s | 4.63 мс | 519 | 65.22 |
У всіх шести були спільні машина, мережа й обліковий запис. Три часові вікна планувалися окремо для кожного провайдера, тому періоди збору даних не повністю збігаються; не варто надто перебільшувати значення невеликих розбіжностей. ∞ означає, що понад половина запитів були недійсними, тому медіана вважається нескінченною.
K — кеш: 27.58
У кожній групі надсилається п’ять запитів. Перший містить фіксований префікс приблизно на 8k або 32k токенів і заповнює кеш. У запитах 2–4 префікс залишається незмінним, змінюється лише фінальне запитання; проміжки становлять 5 с, 30 с і 120 с. У п’ятому запиті використовується новий префікс як контрольний запит без кешу. Три часові вікна × дві довжини дають 30 запитів. K — це кількість токенів, прочитаних із кешу гарячими запитами, поділена на кількість токенів, які за правилами мали б повторно використовуватися; обидві довжини мають однакову вагу. K становить 20% від P.
| Вікно | 1 · заповнення | 2 · +5 s | 3 · +30 s | 4 · +120 s | 5 · без кешу |
|---|---|---|---|---|---|
| Префікс 8k · влучення гарячих запитів 2/9 · прочитано 15,872 із 72,504 токенів, доступних для повторного використання · 21.89 | — | — | — | — | — |
| Вікно 1 | 0 | 0 | 7,936 | 0 | 0 |
| Вікно 2 | 0 | 0 | 0 | 0 | 0 |
| Вікно 3 | 0 | 0 | 7,936 | 0 | 0 |
| Префікс 32k · влучення гарячих запитів 3/9 · прочитано 96,000 із 288,513 токенів, доступних для повторного використання · 33.27 | — | — | — | — | — |
| Вікно 1 | 0 | 0 | 32,000 | 0 | 0 |
| Вікно 2 | 0 | 0 | 0 | 0 | 0 |
| Вікно 3 | 0 | 0 | 0 | 32,000 | 0 |
| K (8k і 32k мають однакову вагу) | — | — | — | — | 27.58 |
Значення — це кількість токенів, прочитаних із кешу, за даними сервера; «Не повернуто» означає, що цього поля не було у відповіді.
Гарячі запити з префіксом 8k дали влучення у 2 з 9 випадків, щоразу зчитуючи 7,936 токенів; запити з префіксом 32k дали влучення у 3 з 9 випадків, щоразу зчитуючи 32,000 токенів. Запити без кешу не зчитували даних із кешу, тож гарячі запити чітко відрізняються від запитів без кешу.
Порівняння з іншими п’ятьма
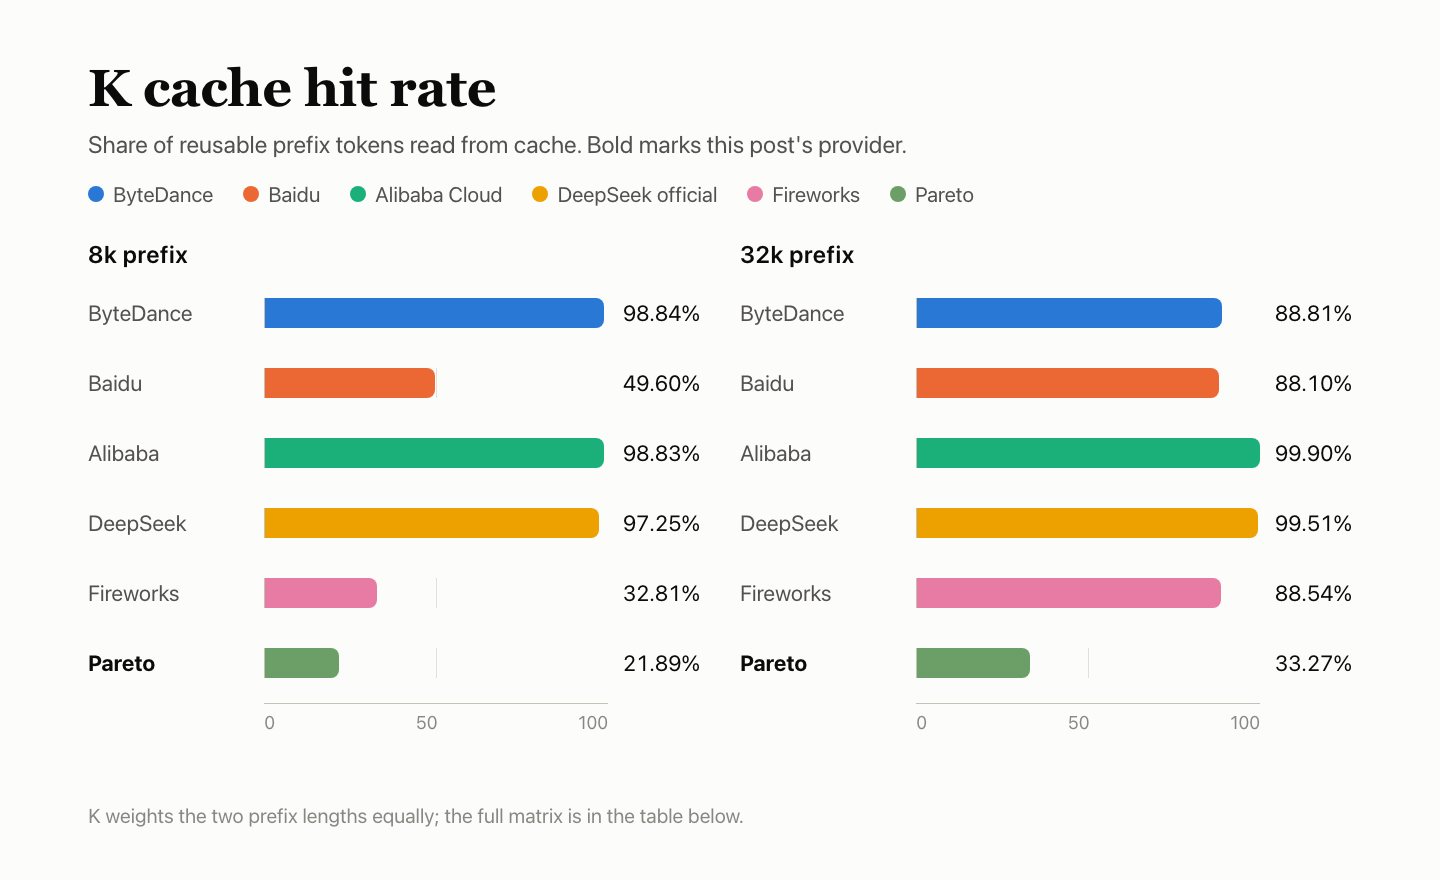
| Провайдер | Влучення для 8k | 8k | Влучення для 32k | 32k | K |
|---|---|---|---|---|---|
| ByteDance | 9/9 | 98.84 | 8/9 | 88.81 | 93.83 |
| Baidu | 5/9 | 49.60 | 8/9 | 88.10 | 68.85 |
| Alibaba Cloud | 9/9 | 98.83 | 9/9 | 99.90 | 99.37 |
| Офіційний канал DeepSeek | 9/9 | 97.25 | 9/9 | 99.51 | 98.38 |
| Fireworks | 3/9 | 32.81 | 8/9 | 88.54 | 60.68 |
| Pareto (ця стаття) | 2/9 | 21.89 | 3/9 | 33.27 | 27.58 |
R — стабільність сервісу: 100
300 запитів поділено на чотири типи: короткий текст, довгий ввід, виклики інструментів і історія з кількох ходів. Їх виконували з паралельністю 1 у трьох часових вікнах. Перевірялося лише, чи повернула перша спроба коректну й повну відповідь; якість відповідей не оцінювалася, повторних спроб не було. Збої в розділах про якість відповідей і швидкість враховуються в Q і P, а не повторно в R.
| Тип запиту | Успіх із першої спроби |
|---|---|
| Короткий текст | 120/120 |
| Довгий ввід 10k | 90/90 |
| Виклики інструментів | 60/60 |
| Історія з кількох ходів | 30/30 |
| Усього · 95% інтервал 98.78%–100% | 300/300 |
Усі 300 запитів повернули коректну й повну відповідь із першої спроби. R = 100 характеризує лише ці 300 спеціально виділених запитів; це не означає, що в усьому ланцюжку не було збоїв. Нижня межа 95% інтервалу — 98.78%: 300 успіхів із 300 дають підстави лише стверджувати, що ймовірно частка збоїв нижча за 1.22%.
Порівняння з іншими п’ятьма
| Провайдер | Успіх із першої спроби | 95% інтервал |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| Офіційний канал DeepSeek | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
| Pareto (ця стаття) | 300/300 | 98.78%–100% |
R охоплює лише ці 300 спеціально виділених запитів; збої в розділах про якість відповідей і швидкість фіксуються в Q і P та не враховуються повторно в R.
Поширені запитання
Чому F дорівнює 93.42, якщо враховано лише 33 перевірки?
У початковому підрахунку пройдено 29 із 33 перевірок, що після перенормування ваг спостережених груп дало F 93.42; решту 147 запланованих перевірок виключено з оцінювання. Записи потокової передачі описують конкретні робочі функції та не додають перевірок, що враховуються в оцінці. Показник загального результату залишається 68.72.
Чому P дорівнює 57.69, якщо TPOT отримав 100.00?
Із 180 запитів для оцінювання швидкості коректними були лише 110; для 70 повернувся код 200 із None. Недійсні запити вважаються нескінченними, тому медіанний час до першого токена відповіді становить 5.85 с за паралельності 1 і 6.13 с за паралельності 10 (3.08 с і 4.92 с лише для коректних запитів). TTFA отримав 24.59, а пропускна здатність — 72.05, тож оцінка швидкості відповіді становить 65.22; з урахуванням кешу K 27.58, що має вагу 20%, P дорівнює 57.69.
Чому K становить лише 27.58?
Гарячі запити дали влучення у 2 з 9 випадків для 8k (21.89) і у 3 з 9 для 32k (33.27); обидві довжини мають однакову вагу. Коли влучення відбувалося, зчитувалося 7,936 або 32,000 токенів, а контрольні запити без кешу не зчитували даних із кешу.
Чи якість відповідей Pareto вища, ніж в офіційного каналу?
Різниця статистично нерозрізненна. Сукупна точність становить 44.58% проти 42.45%, різниця — +2.12 пункту, але 95% інтервал від −0.02 до +4.18 охоплює 0. Модель-суддя deepseek-flash для HLE і AA-LCR не була відкалібрована й може бути поблажливою.
Які перевірки F не пройдено?
Дві. Послідовність зупинки під час потокової передачі повертала порожнє тіло відповіді в усіх трьох часових вікнах, тоді як той самий ввід без stop спрацьовував. У виводі точного тексту в одному з трьох часових вікон наприкінці з’явилася зайва крапка.
Читайте далі: серія оглядів DeepSeek V4.1 Flash
- Різницю Q для Pareto у +2.12 виміряно порівняно з офіційним каналом; власний тест базового варіанта наведено в Огляд DeepSeek V4.1 Flash на офіційному каналі DeepSeek: базовий тест для порівняння, 15 недійсних запитів за паралельності 1.
- Fireworks також повертав порожні тіла відповіді на запити зі stop, а для 8k влучення сталося у 3 з 9 випадків: Огляд DeepSeek V4.1 Flash на Fireworks: запити зі stop повертають порожнє тіло відповіді, гарячі запити кешу 8k дають влучення у 3 з 9 випадків.
- Гарячі запити Alibaba Cloud дали влучення у 18 з 18 випадків, тоді як у Pareto — у 5 з 18: Огляд DeepSeek V4.1 Flash на Alibaba Cloud: 1.34 с до першого токена відповіді, усі 18 гарячих запитів дали влучення в кеш, відповіді не відрізнити від офіційних.
- Усі запити для оцінювання швидкості ByteDance були коректними, час до першого токена відповіді становив 2.12 с: Огляд DeepSeek V4.1 Flash на ByteDance: відповіді не відрізнити від офіційних, кількість вхідних токенів не збігається.
- Baidu також втратив багато запитів для оцінювання швидкості через no_available_channel: Огляд DeepSeek V4.1 Flash на Baidu: виклики інструментів на рівні офіційного каналу, часті no-available-channel знижують якість і швидкість відповідей.
Джерела
- Сторінка моделі DeepSeek V4.1 Flash 1017 (AIHubMix)
- Стандарт порівняльного тестування провайдерів AIHubMix v2.0 (документація AIHubMix)
- Швидкий старт (документація AIHubMix)
- Моделі (AIHubMix)
- Документація API DeepSeek (DeepSeek)


