

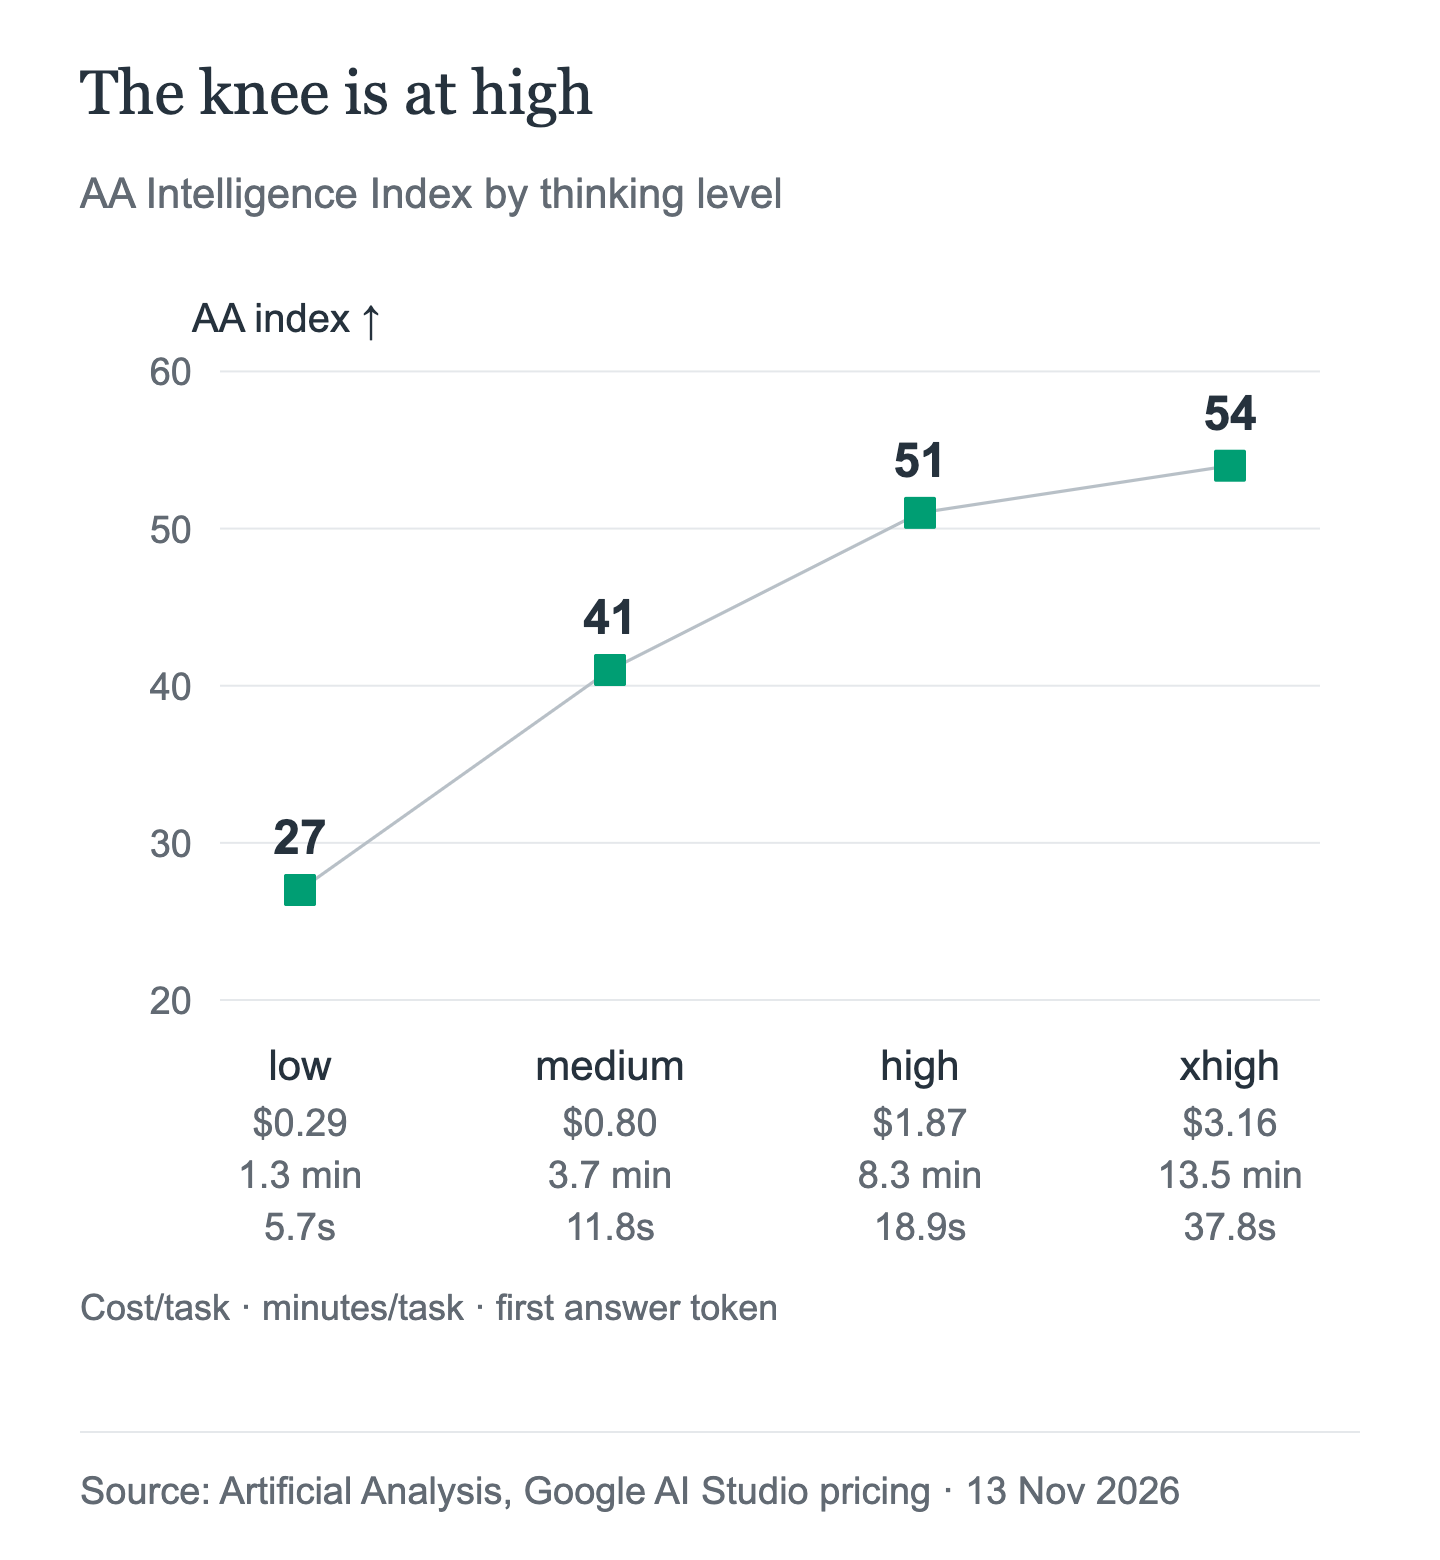
Gemini 4 Hydrogen dört düşünme düzeyine sahip ve her biri sanki farklı bir modelmiş gibi davranıyor. Artificial Analysis'ın canlı ölçümlerinde aynı model low düzeyinde 27, medium düzeyinde 41, high düzeyinde 51 ve xhigh düzeyinde 54 puan alıyor. Varsayılan düzey high; xhigh ise Gemini 4 ailesine yeni eklendi: Carbon ve Argon en fazla high düzeyine çıkıyor.
Aradaki fark büyük: aynı model low ile xhigh arasında 27 indeks puanlık bir aralıkta yer alıyor. medium düzeyinden high düzeyine geçmek, görev başına yaklaşık 1.07$ ek ücretle 10 indeks puanı kazandırıyor. high düzeyinden xhigh düzeyine geçmek ise 1.29$ karşılığında 3 puan kazandırıyor ve ilk yanıt belirtecini bekleme süresini neredeyse ikiye katlıyor. Pratik yaklaşım, high ile başlamak, xhigh düzeyini zor ve çok adımlı işler için ayırmak, low ile medium düzeylerini ise kalite kontrolü gerektiren gecikme ayarları olarak ele almaktır.
Aşağıda her düzeyin ne işe yaradığını, ne kadara mal olduğunu, API'de nelerin değiştiğini ve AIHubMix'in neleri belgelendirip neleri belgelendirmediğini bulabilirsiniz.
Dört düzey ve değişenler
Gemini 4 Hydrogen low, medium, high ve xhigh düzeylerini destekliyor. Google'ın sürüm notlarında konu açıkça belirtiliyor: "Model varsayılan olarak high düzeyini kullanıyor ve xhigh düzeyini sunuyor." Bu, varsayılan olarak medium düzeyini kullanan ve high düzeyinde sona eren Gemini 3.8 Flash ile karşılaştırıldığında iki değişiklik demek.
Ailenin geri kalanında bir değişiklik yok. Carbon ve Argon low, medium ve high düzeylerini destekliyor; varsayılanları medium. high düzeyinin üzerinde bir ayara sahip tek Gemini 4 modeli Hydrogen.
| Model | Düzeyler | Varsayılan |
|---|---|---|
| Gemini 4 Hydrogen | low, medium, high, xhigh | high |
| Gemini 4 Carbon | low, medium, high | medium |
| Gemini 4 Argon | low, medium, high | medium |
MINIMAL bu seçenekler arasında yer almıyor. Gemini 4 düşünme belgelerinde MINIMAL'ın "Gemini 4 modellerinde desteklenmediği" belirtiliyor; Google'ın Hydrogen sürüm notları da modelin "minimal değerini hata vererek reddettiğini" söylüyor. Bu modelde düşünmeyi kapatmaya yönelik belgelenmiş bir seçenek bulunmuyor.
Google'ın önerileri
Google'ın rehberliği makul bir başlangıç noktası sunuyor, ancak aşağıdaki ölçümlerden önce yazılmış. Özellikle etkileşimli kodlama için yapılan medium önerisi, Artificial Analysis'ın medium düzeyinde gözlemlemediği bir kalite seviyesini varsayıyor.
| Düzey | Google'ın açıklaması ve önerilen kullanım alanı |
|---|---|
| low | "En az belirteç, en düşük gecikme" — hızlı sohbet, yüksek hacim |
| medium | "Daha az belirteç kullanımı, daha hızlı yanıtlar" — etkileşimli kodlama, arayüz prototipleri |
| high | "Zekâ ve hız arasında denge" — çoğu görev için varsayılan |
| xhigh | "En fazla belirteç, en derin akıl yürütme" — zor ve çok adımlı kodlama |
Tabloyla birlikte iki uyarı da geliyor. Google, "xhigh kullanımı gecikmeyi ve belirteç tüketimini artırır, basit prompt'larda gereğinden fazla düşünmeye yol açabilir" diyor. Değerlendirme önerisi de açık: "Dört düzeyin tümünde, yüksek bir max_output_tokens değeriyle değerlendirme yapın."
Ölçülen basamaklar
Artificial Analysis dört düzeyin tümünü ölçtü. Ölçüm, 2026-11-13T02:40Z tarihinde alınan ve standart liste fiyatlarını kullanan Intelligence Index v5.0.1 çalışmasıdır; sıralamada 78 model bulunuyor. Bunlar AA'nın görev başına maliyetleridir, AIHubMix faturaları değildir.
| Düzey | AA sıralaması | AA endeksi | $/görev | Dakika/görev | İlk yanıt belirteci |
|---|---|---|---|---|---|
| low | 60 | 27 | 0.29 | 1.3 | 5.71 s |
| medium | 39 | 41 | 0.80 | 3.7 | 11.80 s |
| high | 21 | 51 | 1.87 | 8.3 | 18.89 s |
| xhigh | 16 | 54 | 3.16 | 13.5 | 37.77 s |
Asıl işe yarayan, düzeyler arasındaki farklar:
lowdüzeyindenmediumdüzeyine: +14 indeks puanı, görev başına +$0.51, +2.4 dakika, ilk belirtece kadar +6.1 saniye.mediumdüzeyindenhighdüzeyine: +10 indeks puanı, görev başına +$1.07, +4.6 dakika, ilk belirtece kadar +7.1 saniye.highdüzeyindenxhighdüzeyine: +3 indeks puanı, görev başına +$1.29, +5.2 dakika, ilk belirtece kadar +18.9 saniye.
high kritik eşik. Eklenen ücrete kıyasla kalite artışının hâlâ yüksek olduğu son basamak bu; xhigh düzeyinde ise küçük bir indeks artışı için ilk belirteci bekleme süresi neredeyse ikiye katlanıyor. Bu, xhigh düzeyinin kötü bir ayar olduğu anlamına gelmiyor. Yalnızca high düzeyinin yetersiz kaldığı görevler için uygun olduğu anlamına geliyor; Google'ın tanımı da tam olarak bu.
Bağlam için, aynı anlık görüntüde Carbon high görev başına $5.48 ve 28.1 dakikayla 60 puan; Carbon medium $4.68'la 58 puan; Carbon low $5.22'yle 54 puan; Argon high ise görev başına $4.97 ve 30.6 dakikayla 50 puan alıyor. Hydrogen xhigh, Carbon low'un 54 puanına görev başına %39.5 daha düşük maliyetle ($5.22'ye karşı $3.16) ulaşıyor; ancak ilk belirtecin gelmesi 13.61 saniyeye karşı 37.77 saniye sürüyor. Hydrogen high, Argon high'dan bir indeks puanı fazla alırken görev başına maliyeti %62.4 daha düşük.
Basamakların nerede aksadığı
low, küçük bir kalite düşüşünden ibaret değil. 27 puanla high düzeyinin 24 indeks puanı gerisinde kalıyor. Görev başına $1.58 tasarruf etmek için high düzeyinden low düzeyine geçen bir iş yükü, daha az düşünen ama aynı ürünü satın almıyor; çok daha zayıf bir model seçiyor. Sınıflandırma, yönlendirme veya kısa bilgi çıkarma işlerinde bu uygun olabilir. Ancak göreve özel bir değerlendirme yapılmadan kodlama veya ajan tabanlı işler için uygun değildir.
medium, kalite ayarı değil, gecikme ayarıdır. Görev başına $0.80 karşılığında 41 puan alıyor; high ise $1.87 karşılığında 51 puan alıyor. Tasarruf gerçek — görev başına %57 — ancak kalite farkı, fiyat farkının düşündürdüğünden daha büyük. Google etkileşimli kodlama için medium düzeyini öneriyor; AA verisi ise bu öneriyi benimsemeden önce kendi görevlerinizde sınamanız gerektiğini gösteriyor.
xhigh gereğinden fazla düşünebilir. Google bu konuda doğrudan uyarıyor. AA'nın maliyet ve süre rakamları da etkisini gösteriyor: görev başına $3.16, 13.5 dakika ve ilk belirteç için 37.77 saniye bekleme. Basit bir prompt için küçük bir kazanım karşılığında epey uzun bir gecikme demek. high düzeyinin yetersiz kaldığı zor ve çok adımlı bir kodlama görevinde ise daha ileri giden tek düzey bu.
Uzun yanıtlar faturayı artırır. Artificial Analysis, Hydrogen'ı "çok uzun yanıtlar veren" bir model olarak tanımlıyor: xhigh çalışması endeksi tamamlamak için 304 million çıktı belirteci üretti; 77 model arasında 76. sırada yer aldı. Medyan değer 72.8 million. Çıktı belirteçlerine düşünme belirteçleri de dahildir ve her bir million belirteç için $7.50 ücret alınır. Daha yüksek bir düzey yalnızca daha uzun düşünmekle kalmaz; ücretlendirilen daha fazla belirteç de üretir.
Maliyet: düşünme nasıl belirtece dönüşüyor?
Ücret tarifesi basit. Hydrogen, her million girdi belirteci için $1.50, çıktı belirteci için $7.50 ve önbelleğe alınmış girdi belirteci için $0.075 tutarında ücret alıyor. Çıktı, düşünme belirteçlerini de kapsıyor. Bu yüzden düzey, fiyat tarifesinden daha önemli: model, düzey adının kendisi için değil, ürettiği akıl yürütme için ücretlendiriliyor.
Gözden kaçırılması kolay üç faturalandırma kuralı var.
Varsayılan düzey değişti. Gemini 3.8 Flash varsayılan olarak medium düzeyini kullanıyordu; Hydrogen ise high düzeyini kullanıyor. Daha önce düzey belirtmeyen bir iş yükü, belirteç başına fiyat aynı kalsa bile geçişin ardından her turda daha fazla çıktı belirteci tüketir. Bu, model değişikliği gibi görünen bir bütçe değişikliğidir.
Önbelleğe alma yalnızca örtük olarak destekleniyor. Hydrogen, en az 4,096 belirteç gerektiren ve önbellek isabetlerinde %95 indirim sağlayan örtük önbelleğe almayı destekliyor; açık önbelleğe alma desteklenmiyor. Google'ın kurumsal sayfasında ayrıca "önbellek yazma işlemleri varsayılan olarak standart girdi belirteci fiyatının 1.25 katı üzerinden ücretlendirilir" deniyor. Bu, Google'ın faturalandırma ifadesi; AIHubMix'in bu model için önbellek ücretlendirmesi belgelenmemiş.
Uzun çıktının atlama sınırı var. Eşzamanlı bir istek, akış kullanılsın ya da kullanılmasın, her atlamada en fazla 65,536 belirteç üretir. Daha uzun çıktı için arka plan yürütmesi veya devam belirteçleri gerekir ve max_output_tokens, düşünme ile çıktının toplamını sınırlar. background=true ayarını max_output_tokens olmadan belirlerseniz sunucu 65,536 belirteçten sonra durur. Google'ın uzun çözümleme için önerdiği bütçeler 131,072 veya 262,144; üst sınır ise girdiden 1,048,576 çıkarılarak elde edilir.
API'nin yaptıkları ve reddettikleri
Parametre thinking_level şeklindedir (snake_case). Google'ın Python örneğinde bu parametre thinking_config içine, Node örneğinde ise thinkingConfig içine yerleştiriliyor (camelCase). Model sayfasında değerler LOW, MEDIUM, HIGH ve XHIGH olarak listeleniyor; sürüm notlarında ise küçük harfle yazılıyor. Büyük-küçük harf biçimini elle seçmek yerine SDK'nızdaki enum'u veya belgelenmiş dize değerini kullanın.
Üç istek biçimi hata verir:
- Herhangi bir Gemini 4 modelinde
thinking_budgetkullanmak400: INVALID_ARGUMENThatası döndürür. Hemthinking_levelhem dethinking_budgetayarlamak da hata verir. thinking_level="MINIMAL"desteklenmiyor; Hydrogen bu değeri reddediyor.- Özel
temperature,top_pvetop_kdeğerleri yok sayılır. Sabit varsayılanlar temperature 1.0, topP 0.95 ve topK 64'tür.
Google'ın platformunda Hydrogen ayrıca işlev çağırma, kod yürütme, URL bağlamı ve bilgisayar kullanımını destekliyor. Interactions API'de çok turlu ve araç çağrısı içeren oturumlar için previous_interaction_id kullanın.
AIHubMix'in belgelediği ve belgelemediği özellikler
AIHubMix'in Hydrogen için belgelediği rota, POST https://aihubmix.com/v1/chat/completions ve model="gemini-4-hydrogen" şeklindedir. Model sayfasında metin, görsel, ses, video ve PDF girdisi ile metin çıktısı listeleniyor; llms.txt dosyasında hâlâ eski, yalnızca metin desteğini belirten bir satır bulunduğundan daha güncel kaynak olarak sayfayı esas alın. Araç kullanımı, yapılandırılmış çıktı ve akıl yürütmeye ilişkin özellik bayrakları "yayımlanmamış" olarak belirtiliyor. Model, 2026-11-11 tarihinde oluşturulan model dizininde yer almıyor ve herhangi bir protokol şeması yayımlanmamış.
Bu, bu yazı açısından önemli; çünkü AIHubMix hiçbir Gemini 4 modeli için düşünme düzeyinin nasıl ayarlanacağını belgelemiyor. Gemini kılavuzu, Gemini 2.5 dönemi modelleri için reasoning_effort ayarını kapsıyor; Gemini 4 için thinking_level veya xhigh düzeyini kapsamıyor. Bu parametrelerden herhangi birinin ağ geçidinden geçirileceğini varsaymayın. Google'ın API'sinde gözlemlediğiniz varsayılan düzeyin AIHubMix'te de geçerli olacağını da varsaymayın.
Güvenli istek biçimi, AIHubMix'in belgelediği biçimdir:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "List the failure modes in this retry design."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
Düzey kontrolü kesin bir gereksinimse doğrudan Google API'sini çağırın veya üretim trafiğini yönlendirmeden önce küçük bir istekle ağ geçidinin davranışını doğrulayın. Karar verirken AIHubMix karşılaştırma sayfası maliyetleri kontrol etmek için yararlı olabilir. Bu yazı için canlı test yapılmadı.
İş yüküne göre nereden başlamalı?
| İş yükü | Başlangıç düzeyi ve nedeni |
|---|---|
| Hızlı sohbet, yönlendirme, sınıflandırma | medium ile başlayın, low'u deneyin; low puanı 27 |
| Etkileşimli kodlama, arayüz prototipleme | high; AA'nın medium puanı 41 |
| Aracı yürütme, araç döngüleri | high; yalnızca takılırsanız xhigh |
| Zor hata ayıklama, mimari, planlama | xhigh veya Carbon; %69 daha fazla maliyet karşılığında 3 puan |
| Değerlendirme sonrası yüksek hacimli toplu işler | low veya medium; en ucuz seçenekler, ancak endeks puanları 27/41 |
| 15 saniyenin altında sıkı gecikme bütçesi | medium veya low; high 18.89 sn bekletiyor |
Bunlar başlangıç noktalarıdır, yönlendirme kuralları değil. Doğru düzey, kendi değerlendirmenizi geçen en düşük düzeydir ve Google'ın önerisi de bu değerlendirmeyi dört düzeyin tümünde yapmanızdır.
SSS
Gemini 4 Hydrogen hangi akıl yürütme düzeylerine sahip?
Dört tane: low, medium, high ve xhigh. Varsayılan high düzeyidir.
Gemini 3.8 Flash'tan neler değişti?
Varsayılan düzey medium'dan high'a yükseldi ve xhigh'ın üzerine high eklendi. Carbon ve Argon'un varsayılanı hâlâ medium ve ulaşabildikleri en yüksek düzey high.
xhigh kullanmaya değer mi?
high'ın yetersiz kaldığı, birden çok aşamalı zor görevlerde evet: endeks puanına 3 puan ekler. Ancak görev başına maliyeti high'dan %69 daha fazladır ve ilk jetonun gelme süresini neredeyse ikiye katlar; bu nedenle basit prompt'lar için iyi bir varsayılan değildir.
low neden bu kadar geride?
Artificial Analysis, bunu endekste 27 olarak ölçüyor; bu, high düzeyinin 24 puan altında. Görev başına fiyatı $1.87 yerine $0.29, ancak kalite farkı fiyat farkından çok daha büyük. Yalnızca göreve özel bir değerlendirme bunun yeterli olduğunu gösteriyorsa kullanın.
AIHubMix thinking_level veya xhigh desteği sunuyor mu?
Belgelerinde böyle bir bilgi yok. AIHubMix, Hydrogen için akıl yürütme yeteneğini belirten bir bayrak yayımlamıyor ve Gemini 4 akıl yürütme düzeylerine ilişkin bir kılavuz da sunmuyor. Bunlardan herhangi birine güvenmeden önce doğrulayın.
thinking_budget gönderirsem ne olur?
Gemini 4, 400: INVALID_ARGUMENT hatası döndürür. Hem thinking_budget hem de thinking_level ayarlanırsa da hata döner.
Akıl yürütmeyi kapatabilir miyim?
Belgelenmiş bir kapatma seçeneği yok. Gemini 4'te MINIMAL desteklenmez ve Hydrogen bunu hata döndürerek reddeder.
Okumaya devam edin: Gemini 4 Hydrogen serisi
- Hydrogen'ın Gemini 3.8 Flash'tan yükseltmeye değip değmediğine hâlâ karar veremediyseniz ilk yazıda lansman, fiyat değişikliği ve kıyaslama sonuçlarındaki ödünleşimler ele alınıyor: Gemini 4 Hydrogen vs Gemini 3.8 Flash: Yükseltmeye Değer mi?.
- Hydrogen'ın aynı işte Carbon ve Argon'la nasıl karşılaştırıldığını merak ediyorsanız üçüncü yazıda fiyatlar, gecikme ve iş yükü tablosuyla üç model yan yana inceleniyor: Gemini 4 Carbon vs Hydrogen vs Argon: Hangi İş İçin Hangi Model?.
Kaynaklar
- Google AI Studio, Gemini 4 Hydrogen: yenilikler
- Google, Gemini 4 akıl yürütme
- Google, Gemini 4 Hydrogen model sayfası
- Google AI Studio, Gemini API fiyatlandırması
- Artificial Analysis, Gemini 4 Hydrogen — 2026-11-13T02:40Z tarihli canlı anlık görüntü, Intelligence Index v5.0.1


