Gemini 4 Carbon, istek şeması düzeyinde Gemini 4 Argon’un doğrudan yerine kullanılabilir. Aynı sohbet tamamlama gövdesi çalışır: model kimliği değişir ve birkaç parametre değeri korunmaz. Önemli arızalar bir katman aşağıda yer alır: 400 döndüren parametre hataları, sessizce kırpılan çıktılar ve uzun düşünme süreçlerine göre ayarlanmış zaman aşımı ve faturalandırma profili.
İlk haftayı dört varsayılan belirler:
- AIHubMix’te
max_tokensdeğerini 65,536 veya altında tutun; ağ geçidi yalnızca Chat Completions’ı belgeliyor ve daha yüksek bir çıktı yolu yayımlamıyor. - Google’ın yerel Interactions/arka plan çalıştırmaları için
store=trueve açıkça belirtilmiş birmax_output_tokensayarlayın; bu alanlar AIHubMix’te Carbon için belgelenmemiştir. - Sağlayıcının yerel uzun çözümleme yolunu kullanırken HTTP okuma zaman aşımını her akış için 15–20 dakikaya çıkarın.
- Yok sayılan
temperature,top_pvetop_kparametrelerini ve cezaları kaldırın; Google’ın Carbon kılavuzuna göre 1’den büyükcandidate_countdeğerleri 400 hatası döndürür.
Değişmeyen temel konular — erişim, güvenlik retleri, görev başına maliyet — Argon geçişi yazısında ele alınıyor. Bu yazı, Carbon’a özgü davranışları inceliyor.
Hangileri açık, hangileri sessizce hata verir?
Hatalar net biçimde ikiye ayrılır: 400 hatası hemen haber verir; sessiz bir sınır ise faturada ortaya çıkar.
| Gördüğünüz durum | Tür | İlk yapılacak işlem |
|---|---|---|
| Parametrede HTTP 400 | Açık | Desteklenmeyen alanı kaldırın |
| Arka plan isteğinde 400 | Açık | store=true ekleyin |
| Yanıt 65,536 token’da kesilir | Sessiz | max_tokens değerini 65,536’ya kadar yükseltin |
| Boş metin, durum incomplete | Sessiz | Sınırı yükseltip yeniden deneyin |
| Arka plan çalıştırması yaklaşık 64K’da sona erer | Sessiz | max_output_tokens ayarlayın |
| Yanıt daha yüzeysel görünür | Sessiz | Düşünme düzeyini açıkça ayarlayın |
| Fatura tahmini aşar | Sessiz | Düşünme ve çözümleme adımlarını hesaba katın |
AIHubMix, gemini-4-carbon modelini Chat Completions üzerinden, milyon token başına 2$ girdi, 10$ çıktı ve 0.10$ önbelleğe alınmış token fiyatıyla — Google’ın tanıtım fiyatlarıyla — listeliyor. Bunlar geçici fiyatlardır; faturalandırma bölümüne bakın.
Açık hatalar: belgelenmiş 400’ler
Belgelenmiş 400 hatalarının çoğu parametre doğrulama hatalarıdır; geçmiş ve önceden doldurulmuş model turları ise istek durumu hatalarına yol açar. Aşağıdaki kurallar, aksi belirtilmediği sürece Google’ın yerel Carbon kılavuzundandır; AIHubMix şu anda Carbon için yalnızca Chat Completions’ı belgeliyor. AIHubMix’in Carbon listelemesi bu sınıfı tek satırda şöyle açıklıyor: "400 — parametre hatası; çoğu üst sağlayıcıdan iletilir." Bu, ağ geçidini tanımlar; bir test sonucu değildir. Ayrıntılar Google’ın Carbon kılavuzundan ve yenilikler sayfasından alınmıştır.
| Tetikleyici | Gördüğünüz durum | Çözüm |
|---|---|---|
| max_output_tokens > 1M* | 400; sınır aşıldı | Yerel ≤1M; ağ geçidi ≤65K* |
| frequency/presence penalty | 400; desteklenmiyor | Alanları kaldırın |
| candidate_count > 1 | 400; birden fazla aday | Atlayın veya 1 olarak ayarlayın |
| store olmadan arka plan* | 400; store gerekli* | store=true ekleyin |
| Geçmiş model turuyla sona erer | Reddedildi; desteklenmiyor | Kullanıcı turuyla bitirin |
| iki denetim alanı | 400; birlikte kullanılamaz | Birini gönderin |
| thinking_budget veya MINIMAL | 400; Carbon kılavuzu | low/medium/high kullanın |
Google mesajı aynen şöyle gösteriyor: "store=true is required for background interactions." * Yalnızca Google’ın yerel hizmeti için geçerlidir: max_output_tokens üst sınırı 1M’dir ve arka plan çalıştırmaları store=true gerektirir; AIHubMix bu yolu belgelememiştir. Chat Completions yolunda ≤65K kullanın.
minimal satırının iki anlamı vardır. Google’ın yerel Carbon alanlarında thinking_budget ve thinking_level=MINIMAL HTTP 400 hatası döndürür; low, medium veya high kullanın. Google’ın OpenAI uyumluluk katmanında reasoning_effort=minimal, low değerine eşlenir; AIHubMix bu eşlemeyi Carbon’a uygulayıp uygulamadığını yayımlamamıştır.
Araç işleme de benzer bir tuzaktır. Google’ın Carbon kılavuzu, araç yürütme turlarının sırayla yapılmasını öneriyor; AIHubMix’in Gemini kılavuzu ise tool_choice="auto" alanını belgeliyor. Ancak ağ geçidinde Carbon’a özgü araç desteği henüz doğrulanmış değil.
/v1/chat/completions için en küçük güvenli istek, Carbon’ın yok saydığı alanları çıkarır:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Reply with OK."}],
    max_tokens=32768,  # room for thinking plus answer
)
print(response.choices[0].message.content)
Bu istek 200 döndürürse taşıma katmanı hazır demektir. Geri kalan konular hata vermeyen yanıtlardır.
Sessiz hatalar: hata yok, çıktı yanlış, fatura yanlış
Standart çıktı sınırı 65,536’dır; sağlayıcının uzun çözümleme yolu ayrıdır
Carbon’ın standart çıktı sınırı 65,536 tokendır. Chat Completions’ta sınır alanı max_tokens’tır; Google’ın yerel kılavuzlarında buna max_output_tokens denir. Google’ın yerel uzun çözümleme yolu, girdiden çıkarıldıktan sonra 1,048,576 tokene kadar ulaşabilir; 131,072 ve 262,144 buna örnektir. Google’ın yenilikler sayfasında kural şöyle açıklanıyor: "background: true ayarlayıp max_output_tokens tanımlamazsanız sunucu 64K tokendan sonra durur." AIHubMix, Carbon için arka plan çalıştırmalarını veya devam ettirmeyi belgelemedi.
Sağlayıcının yerel uzun çözümleme işlemi parçalara ayrılır: arka plan veya akış modunda adım başına 64K; akış dışı modda adım başına 32K. Tek bir akış dışı REST isteği 32,768 tokenda durur. Google’ın kılavuzunda şu not yer alıyor: "Önceki SDK sürümleri ve OpenAI uyumluluk katmanı, devam tokenlarını kullanarak uzun tamamlamaları alamaz." AIHubMix için max_tokens değerini 65,536 veya altında tutun; bunu ihtiyatlı, doğrulanmamış bir ağ geçidi sınırı olarak değerlendirin. Model sayfasında belgelenene kadar daha uzun yanıtları birleştirerek oluşturmayı planlamayın.
Düşük sınır düşünmeyi keser, boş çıktı da ücretlendirilir
Sınır yalnızca metni değil, düşünmeyi de kapsar. Google’ın uzun çözümleme kılavuzunda şöyle deniyor: "8,192 gibi düşük bir değer, model düşünmesini tamamlamadan önce onu durdurur." Durum incomplete olur ve "Model hâlâ düşünüyorsa metin boş olabilir." Her iki durumda da ücret ödersiniz. Düşünme ve yanıt için bütçe ayırın; boş bir incomplete yanıtı sınır sorunu olarak değerlendirin: limiti yükseltin, yeniden deneyin ve ilk denemenin de faturaya yansıyacağını hesaba katın.
Varsayılan düşünme düzeyi medium’dur
Carbon’ın varsayılanı, Argon’dakiyle aynı şekilde medium’dur. Varsayılanı high olan Gemini 3.1 Pro Preview’dan gelen ekipler kodu değiştirmeden bir düzey kaybeder ve daha yüzeysel yanıtı gerileme sanabilir. Google, çoğu kodlama ve aracı tabanlı iş için medium düzeyini öneriyor. Düzeyi hazırlık ortamında açıkça ayarlayın ve yalnızca bir denetim alanı gönderin: reasoning_effort ile thinking_level birlikte kullanılamaz.
Örnekleme parametreleri yok sayılır
temperature, top_p ve top_k yok sayılır; hata da örneklemede değişiklik de olmaz. Bunları kaldırın. Cezalar ve 1’den büyük candidate_count değerleri 400 hatası döndürür.
Açık önbellekleme artık yok
cachedContents ve caches.create desteklenmiyor. Örtük önbellekleme 4,096 token ve üzerinde devreye girer ve 95% indirim uygular. Açık önbellek kodunu silin, sabit prompt önekini başta tutun ve indirimi bütçelemeden önce önbelleğe alınmış token kullanımını kontrol edin.
Sohbet durumu için bir kural var
Google, devam etmek için previous_interaction_id kullanılmasını öneriyor. Chat Completions’ta bu alan yoktur; bu nedenle geçmişi koruyun ama kullanıcı turuyla bitirin. Model rolüyle biten bir mesaj veya önceden doldurulmuş model turu desteklenmez.
Zaman aşımları: 60 saniye değil, 15–20 dakika
Google’ın uzun çözümleme kılavuzu, her akış için HTTP okuma zaman aşımının 15–20 dakika olmasını öneriyor; geçiş kontrol listesinde de en az 15 dakika tekrarlanıyor. Bu öneri uzun çözümleme istekleriyle ilgilidir. Ayrı bir AA ölçümü, ilk yanıt token’ının gelmesini bekleme süresini gösteriyor: Carbon High 67.1 saniye, Medium 23.2, Low 12.9 ve Argon High 40.1 saniye sürdü. 60 saniyelik bir sınır, ilk token’ın gelmesine bile izin veriyor mu?
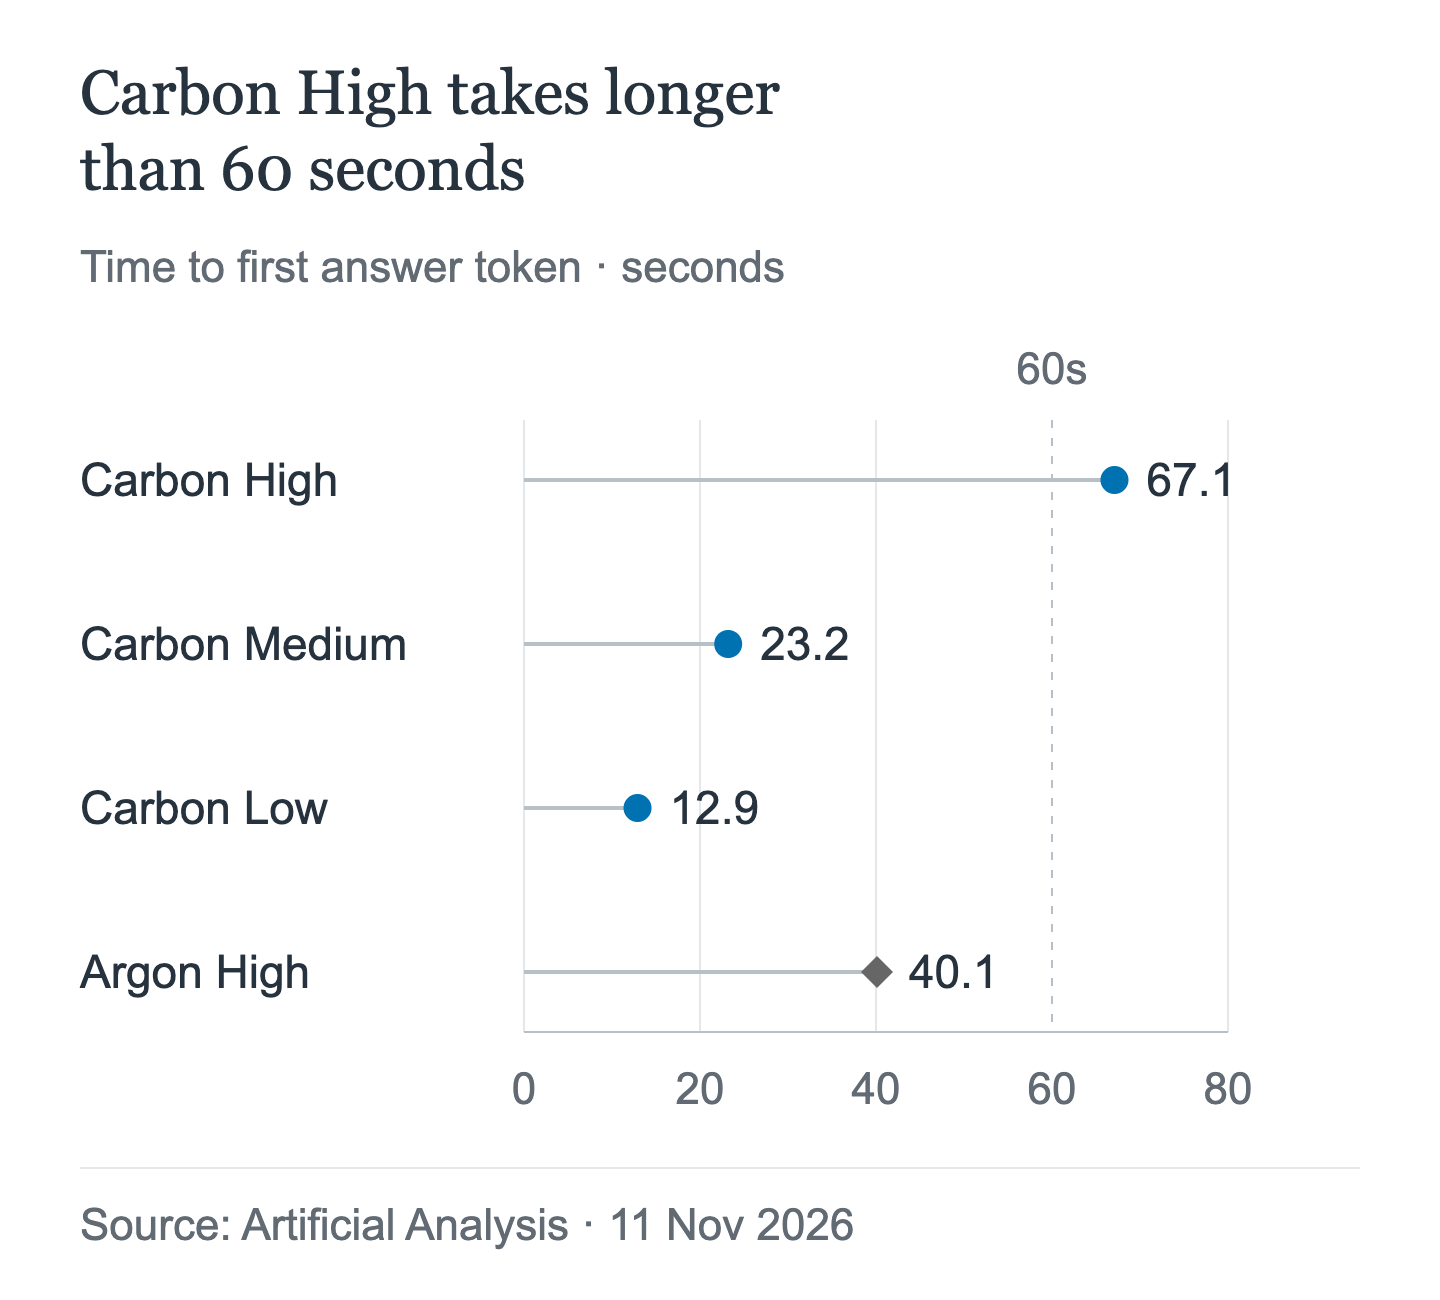
Bu ölçümde Carbon High, 60 saniyelik referans eşiğini aşıyor. İlk token’ın gelme süresi, isteğin tamamı için güvenli bir zaman aşımı belirlemez: yukarıdaki 15–20 dakikalık öneri Google’ın uzun çözümleme kılavuzundan alınmıştır. Bunlar tek bir anlık ölçümün sonuçlarıdır; gecikme garantisi veya AIHubMix testi değildir.
Google’ın yerel istemcisindeki adım sınırları, arka plan sınırından daha kısadır: akış için 20 dakika, akış dışı çağrı için 10 dakika; arka plan içinse 24 saat. AIHubMix bu arka plan sınırlarını belgelemiyor.
Uzun çözümleme için gereken en düşük yerel SDK sürümleri: Python 2.34.0, JS 2.32.0, Go 1.77.0, Java 1.80.0, .NET 1.28.0. Claude Code’un API_TIMEOUT_MS varsayılanı 10 dakikadır; ileride Carbon için Claude Code yolu doğrulanırsa ilk çalıştırmadan önce bu değeri yükseltin.
Faturalandırma tuzakları
Carbon’ın token başına fiyatı basittir; fatura öyle değildir. Birkaç mekanizma faturayı büyütür ve planlanmış bir değişiklik tüm fiyatları ikiye katlar.
Düşünme, çıktı olarak ücretlendirilir
Düşünme tokenları çıktı olarak ücretlendirilir. Carbon’ın çıktı fiyatı şu anda milyon token başına 10$, 1 Aralık’tan itibaren 20$’dır.
Her uzun çözümleme adımı ücretlendirilir
Google’ın örnek hesabında, 200,000 çıktı token’ı üreten 1,000 tokenlık bir prompt için adım başına sırasıyla 1,000, 66,536, 132,072 ve 197,608 token harcanır; raporlanan total_input_tokens değeri 397,216’dır. "Yalnızca düşünme içeren adımlar da dahil olmak üzere her adımdaki her token için ödeme yaparsınız." Örtük önbellekleme girdinin çoğuna 95% indirim uygular, ancak adımlar kullanımda sayılmaya devam eder. Bir çalıştırma başarısız olduğunda veya iptal edildiğinde de tamamlanan işler ücretlendirilir: "Daha sonraki bir adım başarısız olsa veya iptal edilse bile tamamlanan bölümler her bölümün sonunda ücretlendirilir" ve "Etkileşim sona ermeden önce tamamlanan tüm işler için ödeme yaparsınız."
Arama dayanaklandırmasının ayrı bir ölçeri var
Google’ın yerel hizmetinde Google Search ile dayanaklandırma, Gemini 3 ve daha yeni sürümler arasında paylaşılan aylık 5,000 ücretsiz istek içerir; sonrasında 1,000 istek başına 14$ alınır ve günlük 1,500 istekle sınırlandırılır. AIHubMix, Carbon için arama dayanaklandırmasını belgelememiştir.
Vertex dipnotu yalnızca sağlayıcı için geçerlidir
Google’ın Vertex fiyatlandırma sayfasında ek bir kural yer alıyor: 32K token’ı aşan tamamlamalar, istek istemci veya sunucu zaman aşımına uğrasa bile alınabilir token kullanımı üzerinden ücretlendirilir; kural 13 Kasım 2026’da yürürlüğe giriyor. Bu bir sağlayıcı kuralıdır; AIHubMix’in VertexAI sağlayıcısının bunu uygulayıp uygulamadığı yayımlanmamıştır. Varsayımda bulunmadan önce sorun.
1 Aralık’ta tüm fiyatlar ikiye katlanıyor
| Fiyat | 30 Kasım’a kadar | 1 Aralık’tan itibaren |
|---|---|---|
| Girdi | 1M başına 2$ | 1M başına 4$ |
| Çıktı | 1M başına 10$ | 1M başına 20$ |
| Önbellekten okuma | 1M başına 0.10$ | 1M başına 0.20$ |
Carbon ve Argon aynı tanıtım fiyatlarını paylaşır; 1 Aralık’ta tüm fiyatlar ikiye katlanır. AIHubMix bugün tanıtım fiyatlarını listeliyor ve Aralık sonrasındaki fiyatını yayımlamadı. Fiyatların ikiye katlanacağını kesin, ağ geçidindeki fiyatı ise bilinmiyor kabul edin; bütçe taahhüdünde bulunmadan önce her ikisini de kontrol edin.
Gerçek yetkilere sahip aracılar
Google’a özgü çağrılarda Carbon kılavuzu, araçların sırayla yürütüldüğü turları tercih etmenizi söylüyor. Bu yöntemi kullanırken her seferinde tek bir çağrı oluşturun. AIHubMix’in Gemini kılavuzunda tool_choice="auto" belgeleniyor, ancak ağ geçidinde Carbon’a özgü araç desteği ve zorunlu araç davranışı doğrulanmış değil.
Geçmiş bir model turuyla bitmemeli ve önceden doldurulmuş model turları desteklenmiyor. Bir araç sonucu eksikse sonraki adımı soran bir kullanıcı turu gönderin.
Model kartında zaman zaman yavaşlama veya zaman aşımı yaşanabileceği ve yüksek düzeylerde ek token kullanılacağı belirtiliyor; bilgi kesim tarihi Mart 2026. Yazma erişimi varsa asıl risk zaman aşımıdır: bir çalıştırma istemci sınırını aşarsa geride kısmi işler bırakabilir ve tamamlanan segmentler için yine ücret alınır.
Kodlama araçları: herhangi bir şeyi bağlamadan önce model sayfasını kontrol edin
AIHubMix’in Carbon listelemesinde yalnızca Chat Completions belgeleniyor ve Carbon henüz herkese açık model dizininde yer almıyor. Claude Code için Anthropic Messages, Codex için Responses gerekir. AIHubMix’te Carbon için ikisi de doğrulanmış değil. İkisinin de çalışacağını varsaymayın: yukarıda bağlantısı verilen Carbon model sayfasını açıp protokol listesini kontrol edin. Yalnızca Chat Completions görünüyorsa OpenAI uyumlu bir istemci kullanın veya bekleyin.
İstek biçimi Argon ile aynı, ancak protokol kullanılabilirliği farklı: AIHubMix’te Carbon şu anda yalnızca Chat Completions için belgeleniyor. Claude Code yazısı ANTHROPIC_BASE_URL, ANTHROPIC_AUTH_TOKEN ve API_TIMEOUT_MS değişkenlerini ele alıyor; Codex yazısı ise sağlayıcı bloğunu, wire_api ve model_reasoning_effort ayarlarını kapsıyor. Değişen, protokolün mevcut olup olmadığıdır.
| İstemci | Gereken protokol | AIHubMix’te Carbon |
|---|---|---|
| Claude Code | Anthropic Messages | Belgelenmemiş |
| Codex | Responses API | Belgelenmemiş |
| OpenAI SDK | Chat Completions | Belgelenmiş |
Ayarlar:
- Model kimliği:
gemini-4-carbon. - Düşünme: low, medium, high; varsayılan medium.
- Düzey eşlemesi: yerel alan
thinking_level, uyumluluk alanıreasoning_effort; Google akıl yürütme düzeyi değerlerini eşliyor, ancak AIHubMix Carbon eşlemesini yayımlamadı. Birini gönderin. - Bağlam: Google’a göre 1,048,576; AIHubMix Carbon sınırını yayımlamadı, bu nedenle sağlayıcının belirttiği değere göre sistem kurmayın.
- Bilinen sorunlar: yüksek düzeyde ilk tokenın yavaş gelmesi, sağlayıcının araç turlarını sırayla yürütme önerisi, doğrulanmamış ve temkinli bir AIHubMix sınırı olan 65,536 çıktı tokenı ve Mart 2026 bilgi kesim tarihi.
Duman testi, 10–15 dakika:
- Tek bir başarısız birim testi olan ve test komutu bir dakikadan kısa sürede tamamlanan küçük bir depo seçin.
- Modeli
gemini-4-carbon,max_tokensdeğerini 65,536 veya daha düşük bir değere ayarlayın ve HTTP zaman aşımını en az 15 dakika yapın. - Araçtan testi başarılı kılacak en küçük değişikliği yapmasını isteyin, ardından test komutunu çalıştırıp farkı inceleyin.
- Başarılı: düzenleme asgari düzeyde ve test 10–15 dakika içinde geçiyor. Başarısız: yanıtın 400 hatası mı, tamamlanmamış bir yanıt mı, zaman aşımı mı yoksa hatalı bir düzenleme mi olduğunu kaydedin; her biri için yukarıda farklı bir çözüm var.
- Araç düzeyi gösteriyorsa medium ve high değerlerini deneyin; ayrılan süre içinde tamamlananı kullanın.
İlk üretim isteğinden önce kontrol listesi
- Model kimliği
gemini-4-carbonolarak ayarlandı. temperature,top_pveyatop_kyok.frequency_penaltyveyapresence_penaltyyok;candidate_countdeğerini 1’de tutun ya da parametreyi eklemeyin.max_tokensdeğeri 65,536 veya altında.- Google’a özgü arka plan isteklerinde
store=trueve açıkça belirtilmiş birmax_output_tokensgönderilir; AIHubMix bu yolu belgelemedi. - HTTP zaman aşımı en az 15 dakika; akış tercih edilir.
reasoning_effortvethinking_levelseçeneklerinden yalnızca biri.- Google’a özgü kullanımda araç turlarını sırayla yürütmeyi tercih edin; AIHubMix
tool_choice="auto"ayarını belgeliyor, ancak Carbon desteği doğrulanmış değil. - Açık önbellek çağrıları yok; kararlı prompt öneki ilk sırada.
- Bütçeye düşünme tokenları ve her uzun çözümleme adımı dahildir.
- 1 Aralık tarifeleri bütçeden sorumlu kişiyle kontrol edildi.
- Yapılandırmadan önce kodlama aracı model sayfasında kontrol edildi.
SSS
Argon’dan Carbon’a geçerken istek gövdesini değiştirmek gerekir mi?
Hayır. Şema değişmedi. Model kimliğini değiştirin, değerleri gözden geçirin ve artık 400 hatası döndüren alanları kaldırın.
max_output_tokens neden 400 hatası döndürüyor?
Google’ın yerel Carbon API’si 1,048,576 değerinin üzerindekileri reddeder. AIHubMix’in Chat Completions yolu için ayrı ve temkinli bir önerisi var: daha yüksek bir sınır belgelenene kadar max_tokens değerini 65,536 veya altında tutun. Düşük bir değer, bunun yerine düşünmeyi keser ve bu daha kötüdür: yanıt tamamlanmayabilir ve yine de ücretlendirilirsiniz.
Yanıt neden boş?
Durum tamamlanmamışsa model hâlâ düşünüyor olduğu için metin boş olabilir. Yapılan işlem için ücret ödersiniz. Sınırı yükseltip yeniden deneyin.
Arka plan isteği neden 64K’da duruyor?
Google’ın yerel arka plan yolunda max_output_tokens belirtilmezse sunucu 64K’da durur. Sınırı açıkça ayarlayın; yerel uzun çözümleme, girdiden çıkarıldığında en fazla 1,048,576 tokena ulaşabilir. AIHubMix arka plan modunu belgelemedi.
temperature dikkate alınıyor mu?
Hayır. temperature, top_p ve top_k yok sayılır. Ceza değerleri ve 1’den büyük candidate_count değerleri ise 400 hatasına yol açar.
Carbon 1 Aralık’ta iki katına mı mal olacak?
Google’ın tarifeleri iki katına çıkıyor: girdi $2’den $4’e, çıktı $10’dan $20’ye, önbellekten okuma $0.10’dan $0.20’ye yükseliyor. AIHubMix Aralık sonrasındaki fiyatını yayımlamadı; bu yüzden bütçe ayırmadan önce doğrulayın.
Carbon, Claude Code veya Codex ile kullanılabilir mi?
Doğrulanmış değil. AIHubMix, Carbon için Chat Completions’ı belgeliyor; Claude Code için Anthropic Messages, Codex içinse Responses gerekir. Önce model sayfasını kontrol edin.
Okumaya devam edin: Gemini 4 Carbon serisi
- Geçiş çalışıyorsa ve geriye Carbon’ın fiyatına değip değmediği sorusu kaldıysa karşılaştırmada paylaşılan başlangıç tarifeleri yan yana gösteriliyor.
Gemini 4 Carbon ve Argon: Aynı Fiyat, Carbon Ne Zaman Tercih Edilmeli? - Bir uç noktayı taşımak yerine kodlama aracısı seçiyorsanız, kapsamlı karşılaştırmada araç kullanımı ve görev başına maliyet ele alınıyor.
Gemini 4 Carbon ve Fable 5.2: Agentic Kodlama İçin Hangisi?