

Gemini 4 Hydrogen custa o dobro por token em comparação com o preço promocional de lançamento do Gemini 3.8 Flash: US$ 1.50 por milhão de tokens de entrada e US$ 7.50 por milhão de tokens de saída, contra US$ 0.75 e US$ 3.75. Nas medições ao vivo da Artificial Analysis, Hydrogen conclui uma tarefa de índice por US$ 1.87; Gemini 3.8 Flash leva US$ 7.77. O preço por token dobrou, mas o custo por tarefa concluída caiu cerca de três quartos.
Essa é a parte incomum deste upgrade. O Google recomenda Hydrogen como upgrade em relação ao Gemini 3.8 Flash e aos modelos Gemini 3 e 2.5 anteriores, mas ele não é uma atualização do Flash. O cartão do modelo afirma claramente: "Gemini 4 Hydrogen is adapted from Gemini 4 Carbon." Ele herda a janela de contexto do Gemini 4, o caminho de decodificação longa do Gemini 4 e um novo nível de pensamento, xhigh, mantendo uma função típica do Flash: execução rápida e em alto volume.
O resultado é um modelo mais fácil de justificar pelo orçamento por tarefa do que pelo custo por token. A seguir: o que mudou, o que as medições mostram, onde o upgrade deixa de compensar e como chamá-lo pela AIHubMix.
O que é Hydrogen
Hydrogen ficou disponível para o público geral em 2026-11-12, segundo o registro de alterações da Gemini API; o cartão do modelo tem a mesma data. O Google o chama de "nosso modelo de uso diário para fluxos de trabalho agênticos" na publicação de lançamento e descreve Carbon e Argon como modelos "desenvolvidos para raciocínio profundo e de longo horizonte". Hydrogen é o modelo "desenvolvido para execução rápida em diversos fluxos de trabalho agênticos", nas palavras do cartão do modelo, e pode funcionar por conta própria ou como subagente ao lado dos modelos de ponta.
Três fatos do lançamento são importantes para quem usa a API. É o único modelo Gemini 4 no plano gratuito: o Google diz que está disponível "nos planos gratuito e pago do Google AI Studio e da Gemini API". Também é o único modelo Gemini 4 com pensamento xhigh. E, segundo o registro de alterações, é o modelo padrão do agente Antigravity no Gemini Managed Agents.
Uma ressalva que vale mencionar logo de início: a documentação empresarial do Google chama Hydrogen de "um lançamento de disponibilidade geral (GA) de curto prazo, sujeito a uma política de aviso mínimo de 45 dias antes da desativação". A página de descontinuações não informa nenhuma data para encerramento, mas uma equipe que planeje manter uma dependência de longo prazo deve interpretar essa frase como um alerta para manter a string do modelo configurável.
O que muda em relação ao Gemini 3.8 Flash
Os dois modelos têm mais em comum do que a faixa de preço sugere. Na API do Google, ambos aceitam um contexto de 1,048,576 tokens, ambos recebem texto, imagem, áudio e vídeo, e ambos estão disponíveis no plano gratuito. A página do modelo da AIHubMix lista entrada de texto, imagem, áudio, vídeo e PDF para Hydrogen, com saída de texto; a página empresarial do Google também lista Office e OpenDocument, que não aparecem na página do gateway. As diferenças estão no limite de saída, nos padrões de pensamento e no formato da superfície da API.
| Item | Gemini 4 Hydrogen | Gemini 3.8 Flash |
|---|---|---|
| Janela de contexto | 1,048,576 tokens | 1,048,576 tokens |
| Saída máxima | 1,048,576 tokens via decodificação longa | 65,536 tokens |
| Saída síncrona | 65,536 tokens por etapa, com ou sem streaming | 65,536 tokens |
| Níveis de pensamento | low, medium, high (padrão), xhigh | low, medium (padrão), high |
| Modalidades de entrada | texto, imagem, áudio, vídeo, PDF, Office | texto, imagem, áudio, vídeo, PDF |
| Plano gratuito | Sim | Sim |
| Cache | somente implícito, mínimo de 4,096 tokens | implícito e explícito |
Hydrogen adiciona um quarto nível, xhigh, e altera o padrão de medium para high. Também permite uma etapa síncrona de 65,536 tokens nos modos de streaming e sem streaming; Carbon e Argon permitem 65,536 apenas com streaming e 32,768 nos demais casos. Para saídas longas, Hydrogen usa o mesmo caminho de token em segundo plano ou de continuação do restante da família Gemini 4, podendo chegar a 1,048,576 tokens menos a entrada.
O custo por turno decorre do padrão. Hydrogen usa mais tokens de pensamento por turno do que um modelo cujo padrão é medium, e os tokens de saída incluem os de pensamento. Em geral, uma carga de trabalho migrada sem definir um nível terá um custo por turno maior do que tinha no 3.8 Flash, mesmo antes de considerar a diferença de preço por token.
O upgrade medido: 20 pontos a mais no índice por um custo menor por tarefa
A Artificial Analysis mediu Hydrogen na configuração high com 51 no Intelligence Index, ocupando a posição #21 entre 78 modelos. Gemini 3.8 Flash na configuração high obteve 31, na posição #54. O custo da tarefa foi na direção oposta: US$ 1.87 contra US$ 7.77.
| Modelo / esforço | Posição AA | Índice AA | US$/tarefa | Min/tarefa | Primeiro token da resposta |
|---|---|---|---|---|---|
| Hydrogen high | 21 | 51 | 1.87 | 8.3 | 18.89 s |
| Hydrogen xhigh | 16 | 54 | 3.16 | 13.5 | 37.77 s |
| Gemini 3.8 Flash high | 54 | 31 | 7.77 | 14.7 | 17.53 s |
Estes valores são medições ao vivo da Artificial Analysis, consultadas em 2026-11-13T02:40Z, no Intelligence Index v5.0.1, com 78 modelos classificados. Usam os preços de tabela padrão e não representam cobranças da AIHubMix. As duas linhas mostram resultados em high, portanto a comparação é equivalente nesse nível; vale notar que high é o padrão do Hydrogen, mas não do Flash. Flash em seu padrão medium obtém 30 por US$ 6.26 por tarefa, então uma comparação entre os padrões altera os valores, mas não muda a tendência.
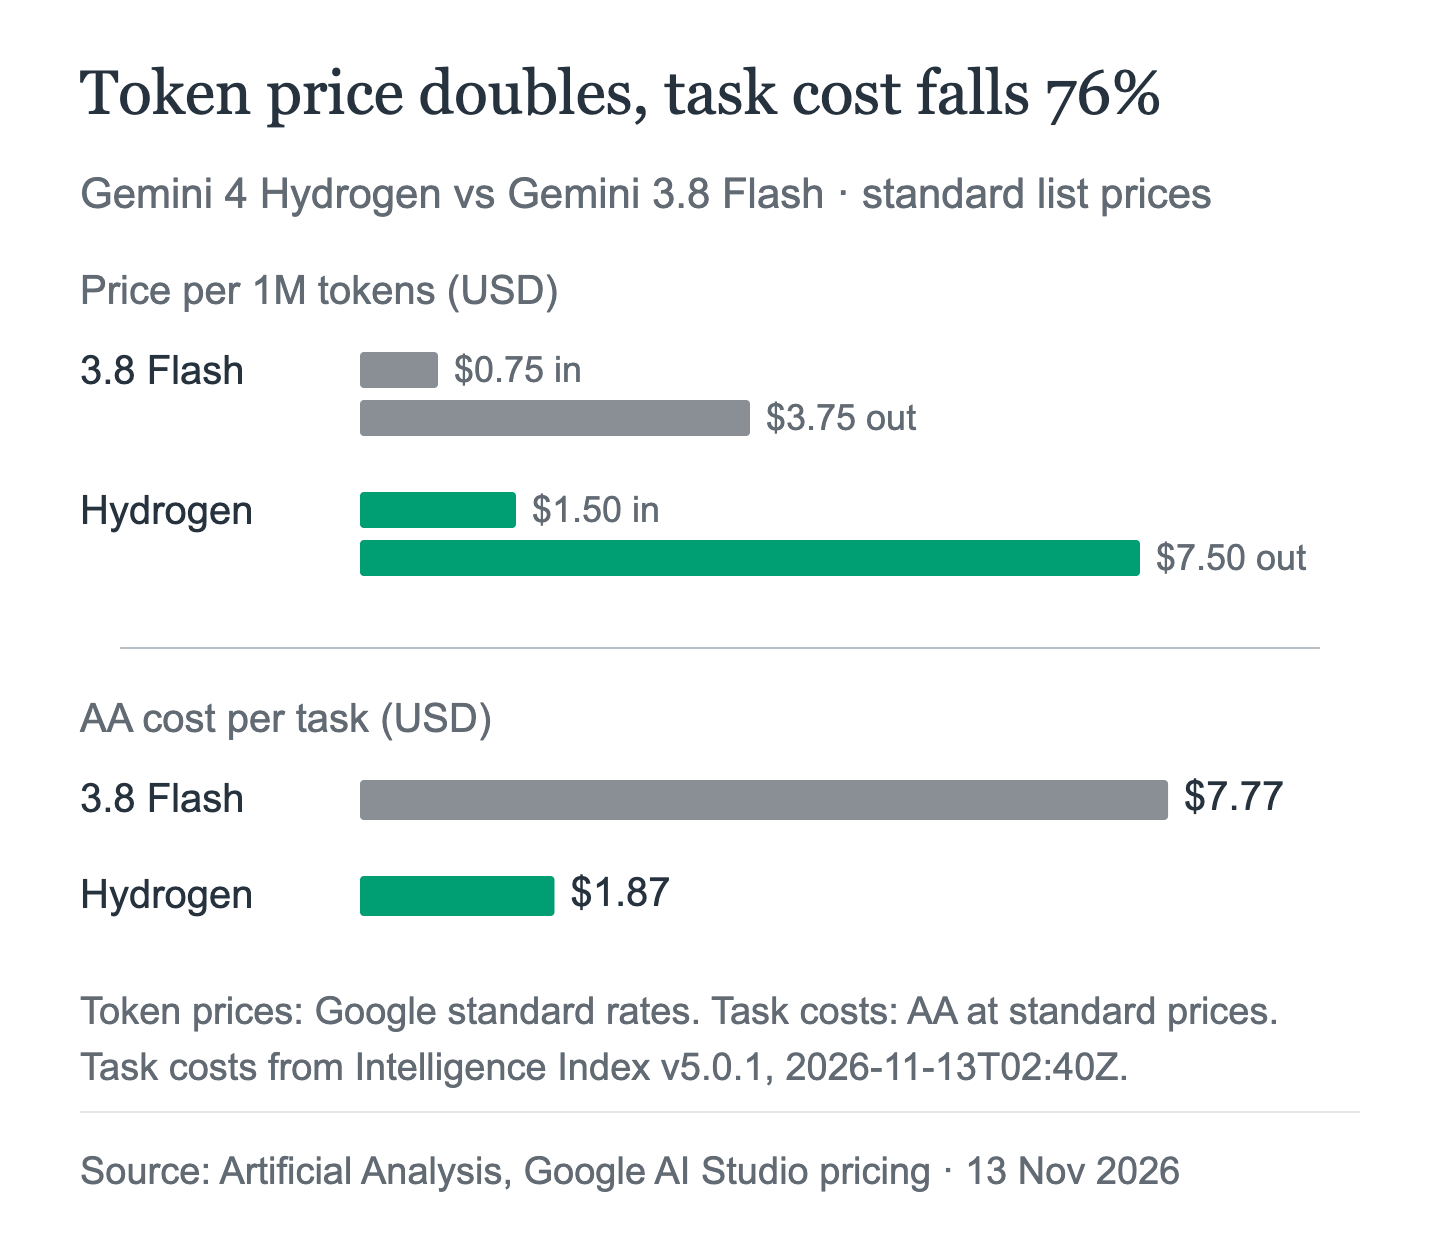
Vale guardar o resultado por tarefa. O preço por token de Hydrogen é o dobro do preço promocional de lançamento do Flash, mas seu custo medido por tarefa é 75.9% menor. A diferença vem do número de tokens que cada modelo usa para concluir o mesmo trabalho, algo que o preço por token não revela. O primeiro token da resposta de Hydrogen chega em 18.89 segundos, cerca de 1.4 segundos mais tarde que os 17.53 segundos do Flash, e ele conclui a tarefa em 8.3 minutos, contra 14.7.
Na configuração xhigh, Hydrogen obtém 54 por US$ 3.16 por tarefa e 13.5 minutos, com o primeiro token chegando em 37.77 segundos. Isso é quatro pontos acima do Gemini 4 Argon high (50) e seis abaixo do Carbon high (60) no mesmo instantâneo. Os quatro níveis são abordados separadamente nesta série; resumindo, high é a configuração com melhor custo-benefício e xhigh é para tarefas difíceis.
A tabela de benchmarks do Google e as três linhas em que Hydrogen perde
O cartão do modelo do Google é um documento do fornecedor: dados autorrelatados, publicados em 2026-11-12 e centrados em dois concorrentes, não no modelo Gemini anterior. Hydrogen lidera em 7 das 10 comparações listadas. As três derrotas são a parte mais útil.
| Benchmark | Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|
| SWE-sweep | 13.5% | 3.1% | 5.8% |
| Terminal-Bench 4.1 | 57.0% | 63.9% | — |
| Agents' Last Exam v1.1 | 71.6% | 60.4% | 69.8% |
| AutomationBench-AA | 76.1% | 71.8% | 60.2% |
| Vending-Bench 2 | $14,549 | $11,165 | $9,107 |
| OSWorld-2.1 | 77.6% | 83.9% | 74.2% |
| MKA | 53.4% | 52.0% | 43.8% |
| Chartography | 66.6% | 61.6% | 63.2% |
| Terminal-Bench-Science 0.1 | 51.4% | 59.9% | 58.3% |
| HLE-Diamond | 58.8% | 53.3% | 47.3% |
Terminal-Bench 4.1 está marcado como "ajustado para trapaça" no cartão do modelo. Sonnet 5.5 vence em Terminal-Bench 4.1 (63.9 contra 57.0), OSWorld-2.1 (83.9 contra 77.6) e Terminal-Bench-Science 0.1 (59.9 contra 51.4). São os casos em que um modelo mais caro ainda oferece algo a mais. A lista de preços da Anthropic mostra o Sonnet 5.5 a US$ 2 de entrada e US$ 10 de saída, então Hydrogen é 25% mais barato por token e vence na maioria das comparações do cartão, mas perde nas três tarefas mais agênticas ou científicas.
Não compare os números de Carbon com esta tabela. O cartão do modelo de Carbon informa 65.2 no Terminal-Bench 4.0; o cartão de Hydrogen informa 57.0 no Terminal-Bench 4.1. São versões diferentes do benchmark e conjuntos de comparação diferentes, portanto não formam uma coluna válida.
A publicação de lançamento do Google traz alegações que não aparecem no cartão do modelo: Hydrogen conclui tarefas "2.5 vezes mais rápido na configuração padrão high" do que Gemini 3.8 Flash e reduz afirmações inventadas em "mais de 5x". Também afirma que ficou em #5 no Agent Arena, em primeiro lugar no Vals Tax Agent Bench (52.3%) e empatado em primeiro no Vals Legal Research Bench (55.8%). São dados informados pelo fornecedor e não reproduzidos de forma independente aqui.
Preço: o dobro por token, mas custo menor por tarefa
O preço padrão de Hydrogen é US$ 1.50 para entrada, US$ 7.50 para saída e US$ 0.075 para entrada em cache. Batch e Flex custam metade desses valores; Priority custa US$ 2.70 e US$ 13.50. O preço é fixo em toda a janela de contexto.
| Modelo / plano | Entrada | Entrada em cache | Saída | Quando |
|---|---|---|---|---|
| Hydrogen Standard | $1.50 | $0.075 | $7.50 | Agora |
| Hydrogen Batch / Flex | $0.75 | $0.0375 | $3.75 | Agora |
| Hydrogen Priority | $2.70 | $0.135 | $13.50 | Agora |
| Gemini 3.8 Flash Standard | $0.75 | $0.075 | $3.75 | Até 2026-12-31 |
| Gemini 3.8 Flash Standard | $1.50 | $0.15 | $7.50 | A partir de 2027-01-01 |
| Gemini 4 Carbon / Argon | $2.00 | $0.10 | $10.00 | Até 2026-11-30 |
| Gemini 4 Carbon / Argon | $4.00 | $0.20 | $20.00 | A partir de 2026-12-01 |
Preços oficiais em USD por milhão de tokens, da página de preços do Google, consultada em 2026-11-13. Nenhuma alteração futura foi anunciada para Hydrogen.
A tabela permite duas comparações. As tarifas de entrada e saída de Hydrogen serão exatamente iguais às tarifas padrão do Gemini 3.8 Flash a partir de 2027-01-01, então a diferença de "duas vezes mais caro" desaparece no dia de Ano-Novo. Em comparação com Carbon e Argon, Hydrogen é 25% mais barato por token até 30 de novembro e 62.5% mais barato quando os preços deles dobrarem em 1º de dezembro.
A AIHubMix lista Hydrogen a US$ 1.50, US$ 7.50 e US$ 0.075, em linha com o preço padrão do Google. O plano gratuito é do Google, não do gateway: a AIHubMix é uma rota paga.
Quando Hydrogen não é o upgrade
A superfície de protocolos é mais limitada. Carbon e Argon têm entradas de esquema que listam Chat Completions, Responses, Anthropic Messages e Gemini nativo. Hydrogen não tem entrada de esquema no instantâneo do índice de modelos de 2026-11-11, e apenas POST /v1/chat/completions está documentado. Clientes Responses no estilo Codex e clientes Anthropic no estilo Claude Code não devem presumir que Hydrogen funciona sem fazer uma verificação.
É um lançamento GA de curto prazo. A política de aviso de 45 dias antes da desativação é uma restrição para o planejamento, não um motivo para evitar o modelo. É um motivo para manter o ID do modelo na configuração, e não no código.
Alguns recursos da plataforma não estão disponíveis. A página empresarial do Google indica que Gemini Live API, RAG Engine, Tuning e cota fixa não são compatíveis com Hydrogen; a inferência Batch é compatível.
O perfil de segurança é misto. O cartão do modelo informa segurança de texto melhor do que a do Gemini 3.8 Flash (+0.80pp em texto para texto, +1.10pp em vários idiomas), mas 5.57 pontos percentuais a mais de recusas injustificadas, sobretudo em prompts multimodais, e uma pontuação de tom 0.65 pontos pior. São avaliações automatizadas, não um exercício de red team.
Carbon continua sendo o teto de qualidade. Hydrogen high marca 51, contra 60 de Carbon high, e os 54 de Hydrogen xhigh ainda ficam seis pontos abaixo. Para depuração complexa, arquitetura, trabalho científico e análise de segurança, o raciocínio adicional de Carbon é o diferencial do produto.
Os níveis mais baixos não preservam a qualidade de graça. Hydrogen medium marca 41 e low, 27 no AA. Uma migração que mantenha, na prática, o padrão antigo ao reduzir para medium perderá muito mais qualidade do que economizará em tokens.
Como chamar pelo AIHubMix
A rota documentada é o endpoint de chat completions compatível com OpenAI. A página do modelo lista dois provedores, VertexAI e Google AI Studio, com nova tentativa automática.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "Summarise this incident report and list the follow-ups."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
O endpoint é POST /v1/chat/completions. O AIHubMix lista entrada de texto, imagem, áudio, vídeo e PDF para Hydrogen, com saída de texto; não publica indicadores de capacidade para raciocínio, uso de ferramentas ou saída estruturada, e seu guia do Gemini aborda os controles de pensamento da era Gemini 2.5, não os níveis do Gemini 4. Não presuma que o parâmetro thinking_level do Google, nem o novo valor xhigh, seja transmitido pelo gateway. Mantenha max_tokens dentro do limite síncrono de 65,536, a menos que o processamento longo esteja confirmado para sua rota. Não foi realizado nenhum teste ao vivo para esta publicação, então o exemplo mostra o formato da solicitação, não uma resposta verificada.
Quem deve migrar agora
Migre agora se você usa Gemini 3.8 Flash e paga por token: a Artificial Analysis mede um custo 76% menor por tarefa concluída, com um índice 20 pontos mais alto, e o plano gratuito permite avaliar a qualidade sem custo com seus próprios prompts. Migre se sua carga de trabalho é de alto volume e pode ser executada pelo Chat Completions com saída de texto, ou se você quer um modelo de execução mais barato ao lado de Carbon em um fluxo com vários modelos.
Espere se seu cliente depende do protocolo Responses ou Anthropic Messages; se sua tarefa envolve os casos mais difíceis de depuração, arquitetura ou segurança, em que o teto de Carbon ainda importa; ou se um aviso de desativação com 45 dias de antecedência é incompatível com seu ciclo de lançamento.
Teste primeiro se estiver em dúvida. Execute de 20 a 50 solicitações reais com Hydrogen high e Gemini 3.8 Flash no padrão, e compare o custo por tarefa concluída, não o custo por token. A página de comparação do AIHubMix é útil para avaliar Carbon nessa decisão.
Perguntas frequentes
Hydrogen é mais barato que Gemini 3.8 Flash?
Por token, não: $1.50/$7.50, contra os valores promocionais de $0.75/$3.75. Por tarefa concluída, a Artificial Analysis mede $1.87, contra $7.77, cerca de 76% a menos. O valor por tarefa depende do uso de tokens, não apenas da tabela de preços.
Hydrogen é um Gemini 3.8 Flash com outro nome?
Não. O cartão do modelo do Google diz que Hydrogen foi adaptado de Gemini 4 Carbon, e o Google o recomenda como atualização em relação a 3.8 Flash. Ele tem um caminho de contexto diferente, um quarto nível de pensamento e um padrão diferente.
Hydrogen aceita imagens?
Sim. A plataforma do Google aceita texto, imagem, áudio, vídeo, PDF e arquivos do Office. A página do modelo no AIHubMix lista entrada de texto, imagem, áudio, vídeo e PDF com saída de texto; Office e OpenDocument não aparecem na lista.
O plano gratuito está disponível no AIHubMix?
Não. O plano gratuito é do Google, no AI Studio e na Gemini API. O AIHubMix é uma rota paga, a $1.50/$7.50.
Qual é o nível de pensamento padrão?
high. O padrão de Gemini 3.8 Flash era medium; Hydrogen adiciona xhigh acima de high.
Hydrogen é melhor que Carbon?
Não. Carbon high marca 60 no índice AA, contra 51 de Hydrogen high e 54 de xhigh, e custa mais por tarefa. Hydrogen é o modelo de execução mais barato, não o modelo de ponta.
Posso definir o nível de pensamento pelo AIHubMix?
A documentação não informa isso. O AIHubMix não publica nenhum indicador de capacidade de raciocínio para Hydrogen, e seu guia do Gemini não aborda os níveis do Gemini 4. Verifique antes de depender desse recurso.
Continue lendo: a série Gemini 4 Hydrogen
- Se a dúvida é qual nível de pensamento usar, a próxima publicação mede os quatro níveis com o mesmo índice e mostra até onde vale subir na escala: Níveis de pensamento do Gemini 4 Hydrogen: low, medium, high, xhigh.
- Se a dúvida é se deve usar Hydrogen ao lado de Carbon ou Argon, a terceira publicação compara os três modelos, com preços, latência e uma tabela de cargas de trabalho: Gemini 4 Carbon vs Hydrogen vs Argon: qual modelo usar para cada tarefa?.
Fontes
- Google, Apresentação do Gemini 4 Hydrogen
- Google AI Studio, Gemini 4 Hydrogen: novidades
- Google DeepMind, cartão do modelo Gemini 4 Hydrogen
- AIHubMix, Gemini 4 Hydrogen
- Artificial Analysis, Gemini 4 Hydrogen — captura ao vivo 2026-11-13T02:40Z, Intelligence Index v5.0.1


