Gemini 4 Carbon não é uma nova família de modelos. É o Gemini 4 Argon com mais pensamento por turno, vendido pelo mesmo preço por token: US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída nas tarifas introdutórias até 30 de novembro de 2026; depois, US$ 4 e US$ 20 a partir de 1º de dezembro. A questão não é qual modelo custa menos por token. O preço é idêntico. A questão é se o pensamento adicional compensa o suficiente por tarefa concluída para justificar uma primeira resposta mais lenta.
Os dados em tempo real da Artificial Analysis dão uma resposta clara para um tipo de trabalho e um alerta igualmente claro para outro. Carbon High ocupa a 4ª posição entre 104 modelos no AA Intelligence Index, com 60.03, contra 50.41 para Argon High. Custa US$ 7.76 por tarefa, contra US$ 9.95, e termina em 25.6 minutos, contra 29.0. Mas o tempo até o primeiro token da resposta é de 67.1 segundos, contra 40.1 para Argon. Carbon é o melhor modelo para uma fila de tarefas. Argon é o melhor modelo para uma conversa.
Essa diferença é o foco de todo este artigo. A seguir: o que mudou, o que mostram as medições, o que acrescenta o cartão do modelo do Google, como o preço muda em 1º de dezembro e quais cargas de trabalho devem continuar no Argon.
O que mudou em relação ao Argon
O cartão do modelo do Google explica a relação com clareza: “Gemini 4 Carbon é baseado no Gemini 4 Argon.” O ID do modelo é gemini-4-carbon, o mesmo no AIHubMix. O Google documenta uma janela de contexto de 1,048,576 tokens. Os níveis de pensamento são baixo, médio e alto, sendo médio o padrão. A saída padrão é de 65,536 tokens; o caminho nativo de decodificação longa do Google pode chegar a 1,048,576 tokens menos a entrada, com 131,072 e 262,144 como exemplos. Atualmente, o AIHubMix documenta apenas Chat Completions, portanto, mantenha as solicitações ao gateway em 65,536 tokens ou menos até que um caminho maior seja documentado. O corte de conhecimento é março de 2026. O Google não oferece o modelo no plano gratuito.
A mudança é descrita nas notas do AI Studio do Google: “Carbon usa mais tokens de pensamento por turno para explorar a fundo e verificar seu trabalho, o que aumenta o uso de tokens por turno e a latência em comparação com Argon.” Essa frase explica quase todas as diferenças que veremos adiante. Mais pensamento eleva o potencial em tarefas difíceis, aumenta o custo por turno e prolonga a espera pelo primeiro token.
A migração é propositalmente simples. “A atualização do Argon não exige alterações no esquema da solicitação.” No nível da API, basta trocar o nome do modelo. A recomendação operacional do Google é “manter thinking_level em medium (padrão), a menos que uma carga de trabalho precise de high, e garantir que max_output_tokens e os tempos limite de HTTP permitam etapas de raciocínio mais longas”.
A troca medida: mais pensamento, menor custo por tarefa
Os números abaixo são medições em tempo real da Artificial Analysis, consultadas em 2026-11-11T05:23Z (páginas dos modelos conferidas novamente às 06:01Z, sem alterações), com os preços padrão de US$ 4 por milhão de tokens de entrada e US$ 20 por milhão de tokens de saída.
A comparação útil é entre qualidade e custo por tarefa concluída: Carbon alcança um índice mais alto por um custo menor? O gráfico mantém separadas as quatro configurações dos modelos.
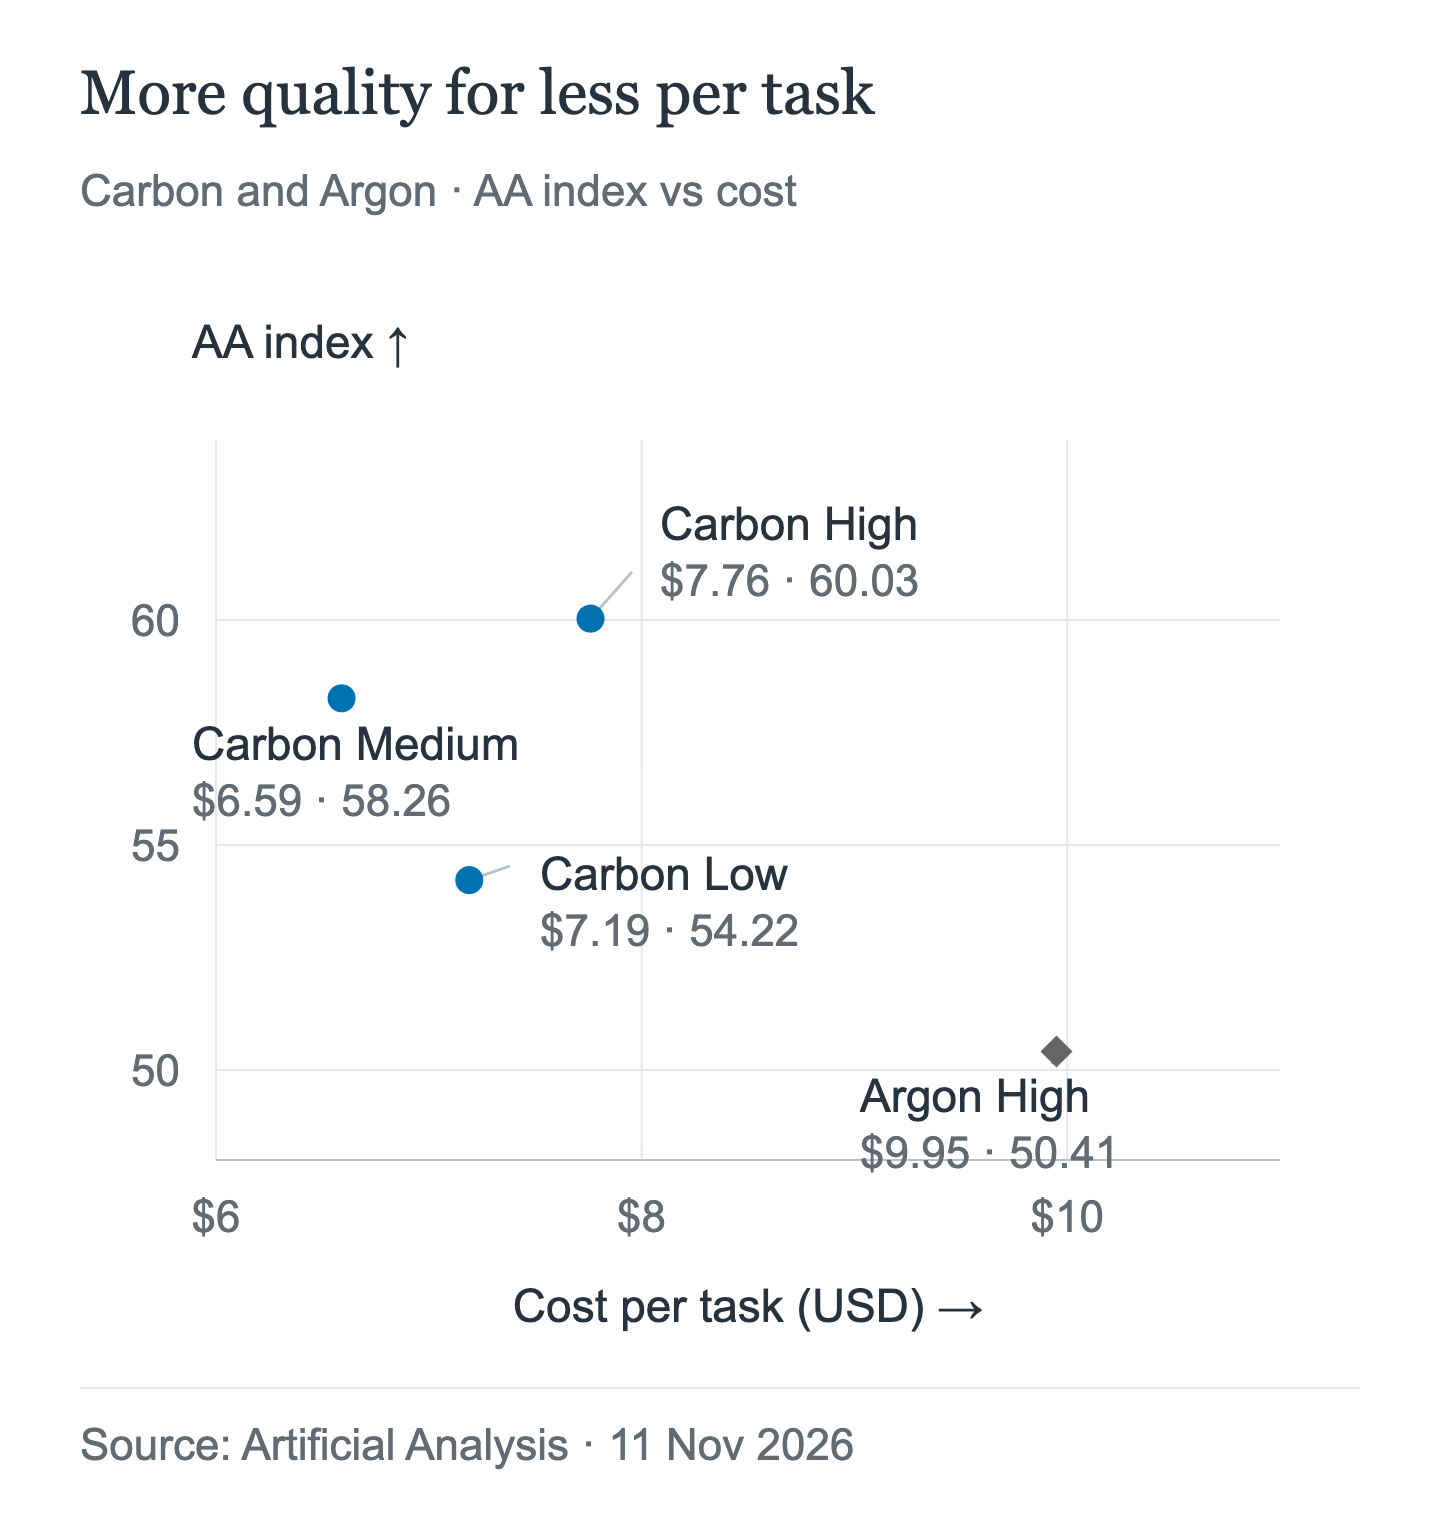
Carbon High fica acima e à esquerda de Argon High. Medium é a configuração mais barata do Carbon nesta rodada; Low é uma opção de latência, não a de menor custo. Esses são custos por tarefa da AA aos preços padrão, não valores cobrados por solicitação pelo AIHubMix.
| Modelo | Índice AA | US$/tarefa | Min/tarefa | Primeiro token | Tokens de saída/s |
|---|---|---|---|---|---|
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s | 80.1 |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s | 73.7 |
| Carbon Low | 54.22 | 7.19 | 22.6 | 12.9 s | 63.5 |
| Argon High | 50.41 | 9.95 | 29.0 | 40.1 s | 66.8 |
Carbon High, Medium e Low ocupam, respectivamente, as posições #4, #6 e #14 entre 104; Argon High fica abaixo deles. As três configurações acima de Carbon High são todas Claude Fable 5.2. “Primeiro token” é o tempo até o primeiro token da resposta. Comparando Carbon High com Argon High: +9.62 pontos no índice, custo 22.0% menor por tarefa, 25.6 contra 29.0 minutos, mas 67.1 contra 40.1 segundos até o primeiro token da resposta.
A diferença no índice é grande o bastante para alterar uma posição no ranking. A diferença na latência é grande o bastante para mudar se uma pessoa fica esperando. As duas afirmações vêm da mesma linha.
A Artificial Analysis descreve Carbon como “notavelmente lento por tarefa e muito prolixo” e informa que ele gerou 205 milhões de tokens para calcular o índice, contra 113 milhões para Argon e uma mediana de 72.8 milhões entre os modelos medidos. Nesta rodada da AA, o custo por tarefa é menor apesar do volume de saída muito maior: o mesmo preço de tabela, muitos mais tokens e um custo total menor por tarefa.
Uma anomalia merece destaque próprio. Carbon Low custa US$ 7.19 por tarefa, mais do que Medium, a US$ 6.59, apesar de usar menos pensamento. Seja qual for a causa, Low funciona como uma configuração de latência, não como uma opção de desconto; portanto, meça o custo por tarefa antes de direcionar volume para ela.
A perspectiva dos agentes de programação
O Intelligence Index calcula a média de muitas tarefas. O Coding Agent Index v2 se aproxima mais do que um cliente de API executa: um agente de programação com ferramentas, medido de ponta a ponta no mesmo ambiente de testes. Carbon High ocupa a 4ª posição; Argon High, a 11ª.
| Posição | Agente + modelo | Índice | US$/tarefa | Min/tarefa | Acerto de cache |
|---|---|---|---|---|---|
| 4 | Antigravity CLI + Carbon High | 59.4 | 7.74 | 29.8 | 0.95 |
| 11 | Antigravity CLI + Argon High | 53.2 | 11.73 | 34.7 | 0.87 |
Mesmo agente, mesmo ambiente de testes, modelo diferente; assim, a comparação isola o modelo, não a estrutura. Carbon custa 34.0% menos por tarefa, ganha +6.2 pontos no índice, é 4.9 minutos mais rápido e produz quase a mesma quantidade de saída por tarefa: 109,031 tokens contra 109,236. A taxa de acerto de cache é maior, 0.95 contra 0.87, e o uso de tokens de entrada é menor: 12.44 milhões contra 13.76 milhões.
Dois alertas. Carbon ocupa a 4ª posição neste índice: Claude Code com Opus 5.5 Max lidera com 61.7, seguido por Devin Fusion CLI e GitHub Copilot Fusion. Além disso, Fable 5.2 não aparece no índice, então esta tabela não resolve a comparação entre Carbon e Fable.
O que acrescenta o cartão do modelo do Google — e o que não acrescenta
O cartão do modelo do Google é um documento do fornecedor: resultados de outubro de 2026, autorrelatados e referentes a um retrato diferente dos dados em tempo real apresentados acima. Em todas as linhas abaixo, o valor do Google para Carbon é maior.
| Benchmark | Carbon | Argon |
|---|---|---|
| AA Index v5.0 (fornecedor) | 59 | 50 |
| Terminal-Bench 4.0 | 65.2 | 57.1 |
| FrontierSWE 2 | 61.2 | 55.0 |
| OSWorld-2.1 | 81.5 | 74.7 |
| Agents' Last Exam | 77.4 | 69.0 |
Na linha AA, o valor arredondado do Google é 59, não os 60.03 em tempo real da tabela anterior; os dois números vêm de retratos diferentes e não devem ser misturados. A comparação externa no cartão é com Fable 5.1, não Fable 5.2.
O aspecto útil é a consistência: o ganho não se limita a um benchmark. O limite também é evidente. Um cartão do fornecedor não calcula o preço de uma tarefa, não mede a latência até o primeiro token nem informa quantos turnos o agente vai usar. Ele sustenta a afirmação “Carbon é, em média, o modelo mais forte”. Não sustenta “Carbon é o melhor modelo para o seu ciclo de trabalho”.
Preço: a mesma tabela de tarifas, com a mesma mudança em 1º de dezembro
Carbon e Argon têm tarifas idênticas em todos os itens. Ambos têm tarifas introdutórias até 30 de novembro de 2026, e as tarifas dos dois dobram em 1º de dezembro.
| Modelo | Entrada | Saída | Leitura em cache |
|---|---|---|---|
| Carbon, tarifa introdutória (até 30 de nov.) | $2.00 | $10.00 | $0.10 |
| Carbon, a partir de 1º de dez. | $4.00 | $20.00 | $0.20 |
| Argon, tarifa introdutória (até 30 de nov.) | $2.00 | $10.00 | $0.10 |
| Argon, a partir de 1º de dez. | $4.00 | $20.00 | $0.20 |
| Gemini 3.1 Pro Preview (≤200k) | $2.00 | $12.00 | $0.20 |
| Fable 5.2 | $8.00 | $40.00 | $0.20 |
Preços oficiais em USD por milhão de tokens, em 11 de novembro de 2026. Gemini 3.1 Pro Preview custa US$ 4/US$ 18/US$ 0.40 acima de 200k tokens de prompt, mais US$ 4.50 por milhão de tokens por hora de armazenamento. As gravações em cache do Fable 5.2 custam US$ 10 por cinco minutos ou US$ 16 por uma hora; o processamento em lote tem 50% de desconto. As tarifas introdutórias de Carbon e Argon terminam em 30 de novembro; todas as tarifas de Carbon e Argon dobram em 1º de dezembro.
O AIHubMix lista Carbon a US$ 2/US$ 10/US$ 0.10, em linha com as tarifas introdutórias do Google. Este artigo não presume quanto o gateway cobrará após 30 de novembro; consulte a página do modelo para ver o valor vigente.
Recalculando as contagens de tokens medidas pela Artificial Analysis com as tarifas introdutórias, as estimativas aproximadas por tarefa são US$ 3.88 para Carbon High, US$ 3.30 para Medium, US$ 3.60 para Low e US$ 4.98 para Argon High. São estimativas calculadas, não medições da AA: o cálculo mantém constante a combinação de tokens de cada tarefa, e seus prompts e sua taxa de acerto de cache alterarão o resultado.
Por token, Fable 5.2 custa o dobro de Carbon nas tarifas padrão e o quádruplo nas tarifas introdutórias. Essa é uma diferença de preço, não um veredito sobre qualidade; o terceiro artigo da série aborda a comparação.
Quando Carbon não é a melhor opção
O argumento contra Carbon não é que ele seja pior. É que aquilo que ele oferece — mais pensamento por turno — é justamente o que um produto interativo não pode se dar ao luxo de gastar.
O primeiro token demora a chegar. Carbon High espera 67.1 segundos antes do primeiro token da resposta; Argon High espera 40.1. Medium reduz a espera para 23.2 segundos e Low, para 12.9, mas ambos abrem mão de pontos no índice. Uma interface de chat que pausa por um minuto já perdeu o turno, seja qual for a resposta quando ela finalmente chegar.
O Google recomenda manter Argon para obter velocidade. Argon é indicado para “respostas mais rápidas e menor gasto de tokens por turno” em “programação interativa, trabalho diário com recursos e ciclos rápidos de produção”. A instrução nas notas de migração é direta: “Mantenha Argon quando a velocidade for importante.” A publicação de anúncio do Google reforça o ponto: “Argon continua sendo a escolha ideal para a maioria das tarefas de engenharia de software e conhecimento.”
O gasto por turno é maior, mesmo quando o custo por tarefa é menor. O preço por token é o mesmo, mas Carbon usa mais tokens de pensamento por turno. Uma equipe que monitora o gasto de tokens por turno ou raciona uma cota de tokens percebe Carbon como o modelo mais caro. A execução do índice com 205 milhões de tokens, contra 113 milhões para Argon, é a versão extrema desse efeito.
Low não é a opção econômica. A US$ 7.19 por tarefa, Carbon Low custa mais do que Medium, a US$ 6.59. Se o critério de encaminhamento for o custo por tarefa concluída, Low não atende a esse critério.
Vitórias em benchmarks não recuperam o tempo perdido. OSWorld-2.1 e FrontierSWE 2 favorecem Carbon na tabela do Google, mas esses resultados são informados pelo fornecedor e nenhum dos dois altera a espera até o primeiro token. Os benchmarks medem o resultado final; os usuários sentem o início.
Quem deve mudar agora e quem deve continuar no Argon
Mude para Carbon agora se você executa tarefas em lote nativas do provedor ou tarefas de agentes em segundo plano (esses fluxos não estão documentados para Carbon no AIHubMix), se uma falha de qualidade custa mais do que o tempo de execução, se suas solicitações podem tolerar tempos limite mais longos e um orçamento de saída maior, ou se você já paga por novas tentativas que Carbon talvez possa evitar.
Continue com Argon se você desenvolve chat, preenchimento automático ou qualquer fluxo em que alguém esteja aguardando; se seu orçamento ou sua cota é calculado por turno; ou se uma meta de latência abaixo de cerca de 30 segundos faz parte do produto.
Teste primeiro se estiver em dúvida. Envie as mesmas 20 a 50 solicitações reais pelos dois modelos, registre o tempo até o primeiro token e o custo por tarefa concluída e escolha o modelo com base nisso, não no índice. A página de comparação do AIHubMix exibe as páginas dos dois modelos lado a lado.
Como fazer chamadas pelo AIHubMix
Carbon usa o mesmo padrão de ID do modelo no AIHubMix e o endpoint de chat completions documentado.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Summarise this incident report and list the follow-ups."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
O endpoint é POST /v1/chat/completions; essa é a única rota que o AIHubMix documenta para este modelo. Texto é a modalidade de entrada listada. A entrada de imagens e PDFs, a Responses API, Anthropic Messages e o endpoint nativo do Gemini não estão documentados para Carbon no AIHubMix, portanto, considere-os não confirmados. O mesmo vale para o mapeamento de reasoning_effort: não presuma que o gateway encaminhe um parâmetro de nível de pensamento. Mantenha max_tokens dentro do limite padrão de saída de 65,536; os limites maiores exigem o modo em segundo plano do Google e não estão confirmados no AIHubMix. Não foi feito nenhum teste ao vivo para esta publicação, então o exemplo mostra o formato da solicitação, não uma resposta verificada.
Perguntas frequentes
Carbon custa o mesmo que Argon?
Sim. As tarifas oficiais do Google são idênticas: US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída até 30 de novembro de 2026; depois, US$ 4 e US$ 20. As leituras em cache custam US$ 0.10 e, depois, US$ 0.20.
Carbon é melhor que Argon?
Em qualidade e custo por tarefa concluída, sim, de acordo com as medições da Artificial Analysis: 60.03 contra 50.41 no Intelligence Index e US$ 7.76 contra US$ 9.95 por tarefa. Em capacidade de resposta, não: leva 67.1 segundos para gerar o primeiro token da resposta, contra 40.1.
Por que Carbon é mais lento se conclui as tarefas mais rápido?
Ele demora mais para responder, mas depois conclui a tarefa inteira mais rápido: 25.6 minutos contra 29.0. A espera até o primeiro token e o tempo total da tarefa são medidas diferentes e apontam em direções opostas.
É preciso alterar as solicitações?
Não. Segundo o Google, a atualização de Argon não exige alterações no esquema; a string do modelo passa a ser gemini-4-carbon. Aumente o limite de saída e o tempo limite de HTTP para acomodar um pensamento mais longo.
Por que Carbon Low custa mais por tarefa do que Medium?
A Artificial Analysis mediu US$ 7.19 para Low contra US$ 6.59 para Medium. Considere Low uma configuração de latência, não de desconto, e meça o custo por tarefa antes de enviar um grande volume por ele.
Qual é a posição de Carbon no ranking da Artificial Analysis?
Ele ocupa a posição #4 no Intelligence Index, atrás de três configurações do Claude Fable 5.2. O cartão do modelo do Google mostra um valor arredondado de 59 para o mesmo índice; o valor atualizado é 60.03, e os dois não devem ser confundidos.
Carbon está disponível no plano gratuito?
Não. O Google não oferece Gemini 4 Carbon no plano gratuito, então o acesso é feito por meio de preços de API pagos ou de um gateway como o AIHubMix.
Continue lendo: a série Gemini 4 Carbon
- Se esta publicação convenceu você a experimentar Carbon, mas sua primeira solicitação falhou, o guia de migração aborda os erros 400, as configurações de tempo limite e os limites de saída que mudam com etapas de pensamento mais longas: Migração da API Gemini 4 Carbon: erros 400, tempos limite e limites de saída.
- Se a questão em aberto é se Carbon é um modelo suficientemente bom para programação agêntica ou se o preço premium do Fable 5.2 vale a pena, o terceiro artigo compara os mesmos números medidos com o Fable 5.2: Gemini 4 Carbon vs Fable 5.2: qual escolher para programação agêntica?.
Fontes
- Google AI Studio, Gemini 4 Carbon: novidades
- Google DeepMind, cartão do modelo Gemini 4 Carbon
- Google AI Studio, preços da Gemini API
- Artificial Analysis, Gemini 4 Carbon
- AIHubMix, Gemini 4 Carbon