

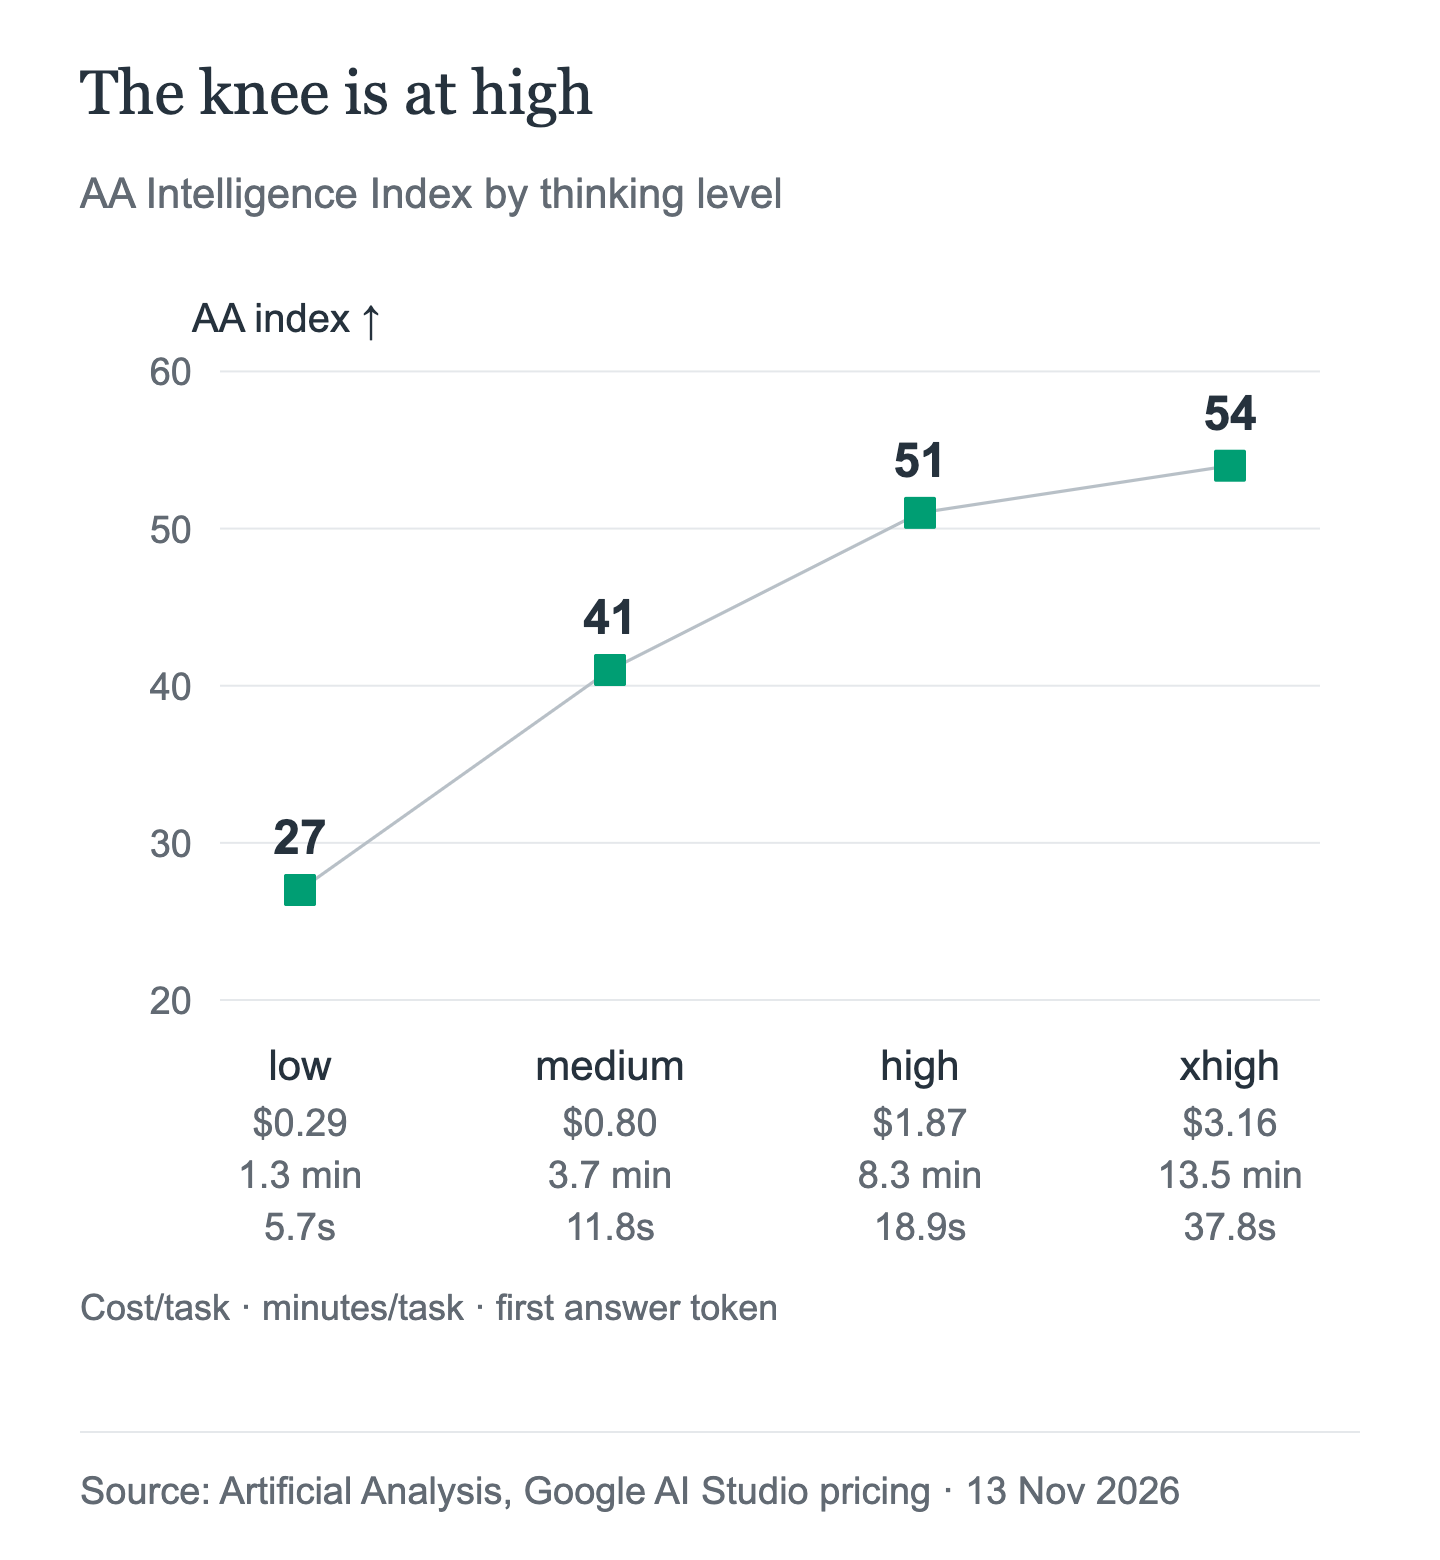
O Gemini 4 Hydrogen tem quatro níveis de pensamento, e cada um se comporta como um modelo diferente. Nas medições em tempo real da Artificial Analysis, o mesmo modelo obtém pontuação 27 em low, 41 em medium, 51 em high e 54 em xhigh. O padrão é high, e xhigh é uma novidade na família Gemini 4: Carbon e Argon chegam apenas até high.
A diferença é grande: o mesmo modelo abrange 27 pontos no índice, de low a xhigh. Passar de medium para high acrescenta 10 pontos no índice por cerca de US$ 1,07 a mais por tarefa. Passar de high para xhigh acrescenta 3 pontos por US$ 1,29, e quase dobra a espera pelo primeiro token da resposta. Na prática, comece com high, reserve xhigh para tarefas difíceis com várias etapas e trate low e medium como configurações de latência que precisam de uma verificação de qualidade própria.
A seguir: para que serve cada nível, quanto custa, o que muda na API e o que a AIHubMix documenta — e o que não documenta.
Os quatro níveis e o que mudou
Gemini 4 Hydrogen oferece suporte a low, medium, high e xhigh. As notas de lançamento do Google deixam isso claro: "O modelo usa high por padrão e introduz xhigh." São duas mudanças em relação ao Gemini 3.8 Flash, que usa medium por padrão e chega apenas até high.
O restante da família não mudou. Carbon e Argon oferecem suporte a low, medium e high, com medium como padrão. Hydrogen é o único modelo Gemini 4 com uma configuração acima de high.
| Modelo | Níveis | Padrão |
|---|---|---|
| Gemini 4 Hydrogen | low, medium, high, xhigh | high |
| Gemini 4 Carbon | low, medium, high | medium |
| Gemini 4 Argon | low, medium, high | medium |
MINIMAL não faz parte do conjunto. A documentação de pensamento do Gemini 4 afirma que MINIMAL "não é compatível com modelos Gemini 4", e as notas de lançamento do Hydrogen dizem que o modelo "rejeita minimal com um erro". Não há uma opção documentada para desativar o pensamento neste modelo.
O que o Google recomenda
As orientações do Google são um ponto de partida razoável, mas foram escritas antes das medições abaixo. Em particular, a recomendação de medium para programação interativa pressupõe um nível de qualidade que a Artificial Analysis não observa em medium.
| Nível | Descrição e uso sugerido pelo Google |
|---|---|
| low | "Menos tokens, latência mais baixa" — conversa rápida, alto volume |
| medium | "Menor uso de tokens, respostas mais rápidas" — programação interativa, protótipos de interface |
| high | "Equilíbrio entre inteligência e velocidade" — padrão para a maioria das tarefas |
| xhigh | "Mais tokens, raciocínio mais profundo" — programação difícil com várias etapas |
A tabela vem acompanhada de duas ressalvas. "Usar xhigh aumenta a latência e o uso de tokens, e pode levar a pensar demais em prompts mais simples", afirma o Google. E a recomendação para avaliação é explícita: "Execute suas avaliações nos quatro níveis com um max_output_tokens alto."
A escala medida
A Artificial Analysis mediu os quatro níveis. A avaliação é a Intelligence Index v5.0.1, com 78 modelos classificados, consultada em 2026-11-13T02:40Z, usando os preços de tabela padrão. Estes são os custos por tarefa da AA, não as cobranças da AIHubMix.
| Nível | Classificação AA | Índice AA | US$/tarefa | Min/tarefa | Primeiro token da resposta |
|---|---|---|---|---|---|
| low | 60 | 27 | 0.29 | 1.3 | 5.71 s |
| medium | 39 | 41 | 0.80 | 3.7 | 11.80 s |
| high | 21 | 51 | 1.87 | 8.3 | 18.89 s |
| xhigh | 16 | 54 | 3.16 | 13.5 | 37.77 s |
O que importa são os incrementos entre os níveis:
lowparamedium: +14 pontos no índice, +US$ 0,51 por tarefa, +2,4 minutos, +6,1 segundos até o primeiro token.mediumparahigh: +10 pontos no índice, +US$ 1,07 por tarefa, +4,6 minutos, +7,1 segundos até o primeiro token.highparaxhigh: +3 pontos no índice, +US$ 1,29 por tarefa, +5,2 minutos, +18,9 segundos até o primeiro token.
high é o ponto de inflexão. É o último passo em que o ganho de qualidade é grande em relação ao custo adicional; xhigh é o passo em que a espera pelo primeiro token quase dobra em troca de um pequeno ganho no índice. Isso não significa que xhigh seja uma configuração ruim. Significa que ela serve para tarefas em que high não dá conta — exatamente como o Google a descreve.
Para contextualizar, no mesmo registro, Carbon high obtém 60 por US$ 5,48 por tarefa e 28,1 minutos; Carbon medium, 58 por US$ 4,68; Carbon low, 54 por US$ 5,22; e Argon high, 50 por US$ 4,97 e 30,6 minutos. Hydrogen xhigh iguala os 54 de Carbon low com um custo por tarefa 39,5% menor (US$ 3,16 contra US$ 5,22), embora o primeiro token leve 37,77 segundos, contra 13,61. Hydrogen high supera Argon high em um ponto no índice, com um custo por tarefa 62,4% menor.
Onde a escala falha
low não é uma pequena redução. Com 27, fica 24 pontos no índice abaixo de high. Uma carga de trabalho que passa de high para low para economizar US$ 1,58 por tarefa não está comprando o mesmo produto com menos pensamento; está comprando um modelo muito mais fraco. Isso pode funcionar para classificação, roteamento ou extração curta. Não é adequado para programação ou tarefas com agentes sem uma avaliação específica para cada tarefa.
medium é uma configuração de latência, não de qualidade. Obtém 41, 10 pontos abaixo de high, por US$ 0,80 contra US$ 1,87. A economia é real — 57% por tarefa —, mas a diferença de qualidade é maior do que a diferença de preço sugere. O Google recomenda medium para programação interativa; a pontuação da AA indica que você deve testar essa recomendação em suas próprias tarefas antes de adotá-la.
xhigh pode pensar demais. O Google alerta diretamente para isso. Os números de custo e tempo da AA mostram o efeito: US$ 3,16 por tarefa, 13,5 minutos e uma espera de 37,77 segundos pelo primeiro token. Para um prompt simples, é muita latência em troca de um ganho pequeno. Para uma tarefa difícil de programação com várias etapas em que high falha, é o único nível que vai além.
A verbosidade faz parte do custo. A Artificial Analysis descreve Hydrogen como "muito verboso": a execução em xhigh gerou 304 milhões de tokens de saída para concluir o índice, ficando em #76 de 77, ante uma mediana de 72,8 milhões. Os tokens de saída incluem os de pensamento, e a saída custa US$ 7,50 por milhão. Um nível mais alto não apenas pensa por mais tempo; ele também gera mais tokens faturáveis.
O custo: como o pensamento se transforma em tokens
A tabela de preços é simples. Hydrogen custa US$ 1,50 por milhão de tokens de entrada, US$ 7,50 por milhão de tokens de saída e US$ 0,075 por milhão de tokens de entrada em cache. A saída inclui tokens de pensamento. Por isso, o nível importa mais do que a tarifa: o modelo cobra pelo raciocínio que produz, não pelo nome do nível.
É fácil deixar passar três regras de cobrança.
O padrão mudou. Gemini 3.8 Flash usava medium por padrão; Hydrogen usa high. Uma carga de trabalho que nunca definiu um nível passará a gastar mais tokens de saída por turno após a migração, mesmo com o mesmo preço por token. É uma mudança de orçamento disfarçada de troca de modelo.
O cache funciona de forma implícita apenas. Hydrogen oferece suporte a cache implícito, com um mínimo de 4,096 tokens e desconto de 95% nos acertos de cache; o cache explícito não é compatível. A página empresarial do Google também afirma que "as gravações no cache são cobradas por padrão a 1.25x do preço padrão dos tokens de entrada". Essa é a formulação de cobrança do Google; a cobrança de cache da AIHubMix não está documentada para este modelo.
A saída longa tem um limite por etapa. Uma solicitação síncrona gera até 65,536 tokens por etapa, com ou sem streaming. Saídas mais longas exigem execução em segundo plano ou tokens de continuação, e max_output_tokens limita o total combinado de pensamento e saída. Se você definir background=true sem um max_output_tokens, o servidor para após 65,536 tokens. Os limites sugeridos pelo Google para decodificações longas são 131,072 ou 262,144, até 1,048,576 menos a entrada.
O que a API aceita e o que rejeita
O parâmetro é thinking_level (snake_case). O exemplo em Python do Google o define dentro de thinking_config; o exemplo em Node o aninha em thinkingConfig (camelCase). A página do modelo lista os valores como LOW, MEDIUM, HIGH e XHIGH; as notas de lançamento os escrevem em minúsculas. Use o enum ou a string documentada do seu SDK em vez de digitar uma variante de capitalização manualmente.
Três formatos de solicitação falham:
thinking_budgetem qualquer modelo Gemini 4 retorna400: INVALID_ARGUMENT. Definirthinking_levelethinking_budgetao mesmo tempo também retorna um erro.thinking_level="MINIMAL"não é compatível; Hydrogen o rejeita.- Valores personalizados de
temperature,top_petop_ksão ignorados. Os valores padrão fixos são temperatura 1.0, topP 0.95 e topK 64.
Na plataforma do Google, Hydrogen também oferece suporte a chamadas de função, execução de código, contexto de URL e uso do computador. Na API Interactions, use previous_interaction_id para sessões com várias interações e chamadas de ferramentas.
O que a AIHubMix documenta — e o que não documenta
A rota documentada pela AIHubMix para Hydrogen é POST https://aihubmix.com/v1/chat/completions com model="gemini-4-hydrogen". A página do modelo lista entradas de texto, imagem, áudio, vídeo e PDF, com saída de texto; llms.txt ainda contém uma linha antiga que menciona apenas texto, então considere a página como a fonte mais recente. Os recursos de uso de ferramentas, saída estruturada e raciocínio estão marcados como "não publicados". O modelo não consta no índice de modelos gerado em 2026-11-11, e nenhum esquema de protocolo foi publicado.
Isso importa para este artigo porque a AIHubMix não documenta como definir um nível de pensamento para nenhum modelo Gemini 4. O guia do Gemini da empresa aborda reasoning_effort para modelos da época do Gemini 2.5, não thinking_level nem xhigh para Gemini 4. Não presuma que qualquer um desses parâmetros será encaminhado pelo gateway, nem que o padrão observado na API do Google também será o padrão na AIHubMix.
O formato de solicitação seguro é o documentado pela AIHubMix:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "List the failure modes in this retry design."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
Se controlar o nível for indispensável, chame a API do Google diretamente ou verifique o comportamento do gateway com uma solicitação pequena antes de encaminhar tráfego de produção. A página de comparação da AIHubMix é útil para conferir os custos enquanto você decide. Nenhum teste em tempo real foi realizado para este artigo.
Por onde começar, de acordo com a carga de trabalho
| Carga de trabalho | Comece em e por quê |
|---|---|
| Chat rápido, roteamento, classificação | medium; teste low; low marca 27 |
| Programação interativa, prototipagem de UI | high; o medium do AA marca 41 |
| Execução de agentes, ciclos de ferramentas | high; xhigh apenas se ficar travado |
| Depuração complexa, arquitetura, planejamento | xhigh ou Carbon; 3 pontos por 69% a mais |
| Processamento em lote de alto volume após avaliação | low ou medium; mais barato, mas índice de 27/41 |
| Orçamento de latência rigoroso, abaixo de 15 segundos | medium ou low; high demora 18.89 s |
Estes são pontos de partida, não regras de roteamento. O nível certo é o mais baixo que passa na sua própria avaliação, e a recomendação do próprio Google é executar essa avaliação nos quatro níveis.
Perguntas frequentes
Quais níveis de pensamento o Gemini 4 Hydrogen tem?
Quatro: low, medium, high e xhigh. O padrão é high.
O que mudou em relação ao Gemini 3.8 Flash?
O padrão passou de medium para high, e xhigh foi adicionado acima de high. Carbon e Argon ainda usam medium como padrão e vão até high.
xhigh vale a pena?
Para tarefas complexas com várias etapas nas quais high falha, sim: ele acrescenta 3 pontos ao índice. Também custa 69% a mais por tarefa que high e quase duplica a espera pelo primeiro token, então não é uma boa opção padrão para prompts simples.
Por que low fica tão atrás?
A Artificial Analysis o classifica com 27 no índice, 24 pontos abaixo de high. O preço é de $0.29 por tarefa, contra $1.87, mas a diferença de qualidade é muito maior que a diferença de preço. Use-o apenas quando uma avaliação específica da tarefa indicar que é suficiente.
O AIHubMix oferece suporte a thinking_level ou xhigh?
Não segundo a documentação. O AIHubMix não publica nenhuma indicação de capacidade de raciocínio para Hydrogen nem um guia sobre os níveis de pensamento do Gemini 4. Verifique antes de confiar em qualquer um dos dois.
O que acontece se eu enviar thinking_budget?
Gemini 4 retorna 400: INVALID_ARGUMENT. Definir thinking_budget e thinking_level ao mesmo tempo também retorna um erro.
Posso desativar o pensamento?
Não há uma opção documentada para desativá-lo. MINIMAL não é compatível com Gemini 4, e Hydrogen o rejeita com um erro.
Continue lendo: a série Gemini 4 Hydrogen
- Se você ainda está decidindo se Hydrogen é a atualização certa em relação ao Gemini 3.8 Flash, o primeiro artigo aborda o lançamento, a mudança de preço e as compensações nos benchmarks: Gemini 4 Hydrogen vs Gemini 3.8 Flash: vale a pena fazer a atualização?.
- Se a questão é como Hydrogen se compara a Carbon e Argon na mesma tarefa, o terceiro artigo compara os três lado a lado, com preços, latência e uma tabela de cargas de trabalho: Gemini 4 Carbon vs Hydrogen vs Argon: qual modelo usar em cada tarefa?.
Fontes
- Google AI Studio, Gemini 4 Hydrogen: novidades
- Google, Gemini 4 thinking
- Google, Página do modelo Gemini 4 Hydrogen
- Google AI Studio, Preços da Gemini API
- Artificial Analysis, Gemini 4 Hydrogen — captura ao vivo 2026-11-13T02:40Z, Intelligence Index v5.0.1


