Gemini 4 Carbon é um substituto direto do Gemini 4 Argon no nível do esquema de requisição. O mesmo corpo de chat completions funciona: o ID do modelo muda, e alguns valores de parâmetros não são aceitos. As falhas importantes estão um nível abaixo — erros de parâmetros que retornam 400, limites de saída que truncam silenciosamente e um perfil de timeout e cobrança pensado para longos períodos de pensamento.
Quatro configurações padrão determinam a primeira semana:
- Mantenha
max_tokensem 65,536 ou menos no AIHubMix; o gateway documenta apenas Chat Completions e não publica uma via de saída com limite maior. - Para execuções em segundo plano do Google Interactions nativo, defina
store=truee ummax_output_tokensexplícito; esses campos não estão documentados para o Carbon no AIHubMix. - Aumente os timeouts de leitura HTTP para 15–20 minutos por fluxo ao usar a via nativa do fornecedor para decodificação longa.
- Remova
temperature,top_petop_k, que são ignorados, além das penalidades e de valores decandidate_countacima de 1, que retornam 400 no guia do Carbon do Google.
Os fundamentos que não mudam — acesso, recusas por segurança e custo por tarefa — estão no artigo sobre a migração do Argon. Este artigo aborda o comportamento específico do Carbon.
O que falha de forma evidente e o que falha silenciosamente
As falhas se dividem claramente: um 400 informa você na hora; um limite silencioso aparece na fatura.
| O que você vê | Tipo | Primeira medida |
|---|---|---|
| HTTP 400 em um parâmetro | Evidente | Remova o campo não compatível |
| 400 em uma requisição em segundo plano | Evidente | Adicione store=true |
| A resposta para em 65,536 tokens | Silenciosa | Aumente max_tokens, até 65,536 |
| Texto vazio, status incompleto | Silenciosa | Aumente o limite e tente novamente |
| A execução em segundo plano termina perto de 64K | Silenciosa | Defina max_output_tokens |
| A resposta parece menos aprofundada | Silenciosa | Defina explicitamente o nível de pensamento |
| Cobrança acima do estimado | Silenciosa | Contabilize o pensamento e as etapas de decodificação |
O AIHubMix lista gemini-4-carbon por US$ 2 de entrada, US$ 10 de saída e US$ 0.10 por milhão de tokens em cache — as tarifas introdutórias do Google — por meio de Chat Completions. Elas são temporárias; consulte a seção sobre cobrança.
Falhas evidentes: os erros 400 documentados
Muitos erros 400 documentados decorrem da validação de parâmetros; problemas com o histórico e turnos do modelo preenchidos previamente são falhas no estado da requisição. As regras abaixo vêm do guia nativo do Carbon do Google, a menos que indicado de outra forma; no momento, o AIHubMix documenta apenas Chat Completions para o Carbon. A descrição do Carbon no AIHubMix resume a categoria em uma linha: "400 — erro de parâmetro; a maioria é encaminhada do provedor upstream." Isso descreve o gateway, não é resultado de um teste. Os detalhes vêm do guia do Carbon e da página de novidades do Google.
| Causa | O que você vê | Correção |
|---|---|---|
| max_output_tokens > 1M* | 400; acima do limite | Nativo ≤1M; gateway ≤65K* |
| frequency/presence penalty | 400; não compatível | Remova os campos |
| candidate_count > 1 | 400; vários candidatos | Omita ou defina como 1 |
| background sem store* | 400; store obrigatório* | Adicione store=true |
| O histórico termina com o modelo | Rejeitado; não compatível | Termine com um turno do usuário |
| ambos os controles | 400; não podem ser combinados | Envie um deles |
| thinking_budget ou MINIMAL | 400; guia do Carbon | Use low/medium/high |
O Google exibe a mensagem exatamente assim: "store=true is required for background interactions." * Apenas no Google nativo: max_output_tokens tem limite de 1M e as execuções em segundo plano exigem store=true; o AIHubMix não documentou essa via. Use ≤65K na via Chat Completions.
A opção minimal tem dois significados. Nos campos nativos do Carbon do Google, thinking_budget e thinking_level=MINIMAL retornam HTTP 400; use low, medium ou high. Na camada de compatibilidade OpenAI do Google, reasoning_effort=minimal é mapeado para low; o AIHubMix não publicou se aplica esse mapeamento ao Carbon.
O tratamento de ferramentas é uma armadilha relacionada. O guia do Carbon do Google recomenda turnos de execução sequencial de ferramentas, e o guia do Gemini do AIHubMix documenta tool_choice="auto"; o suporte específico a ferramentas do Carbon no gateway ainda não foi confirmado.
A requisição mais simples e segura para /v1/chat/completions remove o que o Carbon ignora:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Reply with OK."}],
    max_tokens=32768,  # room for thinking plus answer
)
print(response.choices[0].message.content)
Se isso retornar 200, a camada de transporte está resolvida. O restante diz respeito a respostas que não geram erro algum.
Falhas silenciosas: sem erro, saída errada, cobrança errada
O limite padrão de saída é 65,536; a decodificação longa do fornecedor é uma via separada
O limite padrão de saída do Carbon é 65,536 tokens. Em Chat Completions, o campo de limite é max_tokens; nos guias nativos do Google, ele é chamado de max_output_tokens. A via nativa de decodificação longa do Google pode chegar a 1,048,576 tokens menos a entrada; 131,072 e 262,144 são exemplos. A página de novidades do Google estabelece a regra: "Se você definir background: true sem especificar max_output_tokens, o servidor para após 64K tokens." O AIHubMix não documentou execuções em segundo plano ou continuação para o Carbon.
Uma decodificação longa nativa do fornecedor é executada em segmentos: 64K por etapa com background ou streaming, 32K por etapa sem streaming; uma única requisição REST sem streaming para em 32,768. O guia do Google observa que "Versões anteriores do SDK e a camada de compatibilidade OpenAI não conseguem recuperar conclusões longas usando tokens de continuação." No AIHubMix, mantenha max_tokens em 65,536 ou menos como limite conservador e não verificado do gateway; não planeje concatenar respostas mais longas até que a página do modelo documente esse recurso.
Um limite baixo trunca o pensamento, e a saída vazia é cobrada
O limite abrange o pensamento, não apenas o texto. O guia de decodificação longa do Google diz: "Um valor baixo, como 8,192, interrompe o modelo antes que ele termine de pensar." O status passa a ser incomplete, e "O texto pode estar vazio se o modelo ainda estiver pensando." Você paga de qualquer forma. Reserve tokens para o pensamento e a resposta, e trate uma resposta incompleta e vazia como um problema de limite: aumente o limite, tente novamente e espere que a primeira tentativa apareça na fatura.
O nível de pensamento padrão é medium
O Carbon usa medium por padrão, assim como o Argon. As equipes que vêm do Gemini 3.1 Pro Preview, cujo padrão é high, perdem um nível sem alterar o código e interpretam a resposta menos aprofundada como uma regressão. O Google recomenda medium para a maioria das tarefas de programação e de agentes. Defina o nível explicitamente no ambiente de staging e envie apenas um campo de controle: reasoning_effort e thinking_level não podem ser combinados.
Os parâmetros de amostragem são ignorados
temperature, top_p e top_k são ignorados — sem erro e sem mudança na amostragem. Remova-os. Penalidades e valores de candidate_count acima de 1 retornam 400.
O cache explícito não está mais disponível
cachedContents e caches.create não são compatíveis. O cache implícito é aplicado a partir de 4,096 tokens, com desconto de 95%. Remova o código de cache explícito, mantenha o prefixo estável do prompt primeiro e verifique o uso de tokens em cache antes de calcular o desconto no orçamento.
O estado da conversa tem uma regra
O Google recomenda previous_interaction_id para continuar. Chat Completions não tem esse campo; portanto, mantenha o histórico, mas termine com um turno do usuário. Encerrar com uma mensagem do modelo ou deixar um turno do modelo preenchido previamente não é compatível.
Timeouts: 15 a 20 minutos, não 60 segundos
O guia de decodificação longa do Google recomenda timeouts de leitura HTTP de 15 a 20 minutos por fluxo; a lista de verificação de migração repete o mínimo de 15 minutos. Essa recomendação se refere a requisições de decodificação longa. Uma medição separada da AA mostra o tempo de espera até o primeiro token da resposta: Carbon High levou 67.1 segundos, Medium 23.2, Low 12.9 e Argon High 40.1. Um limite de 60 segundos sequer permite que o primeiro token chegue?
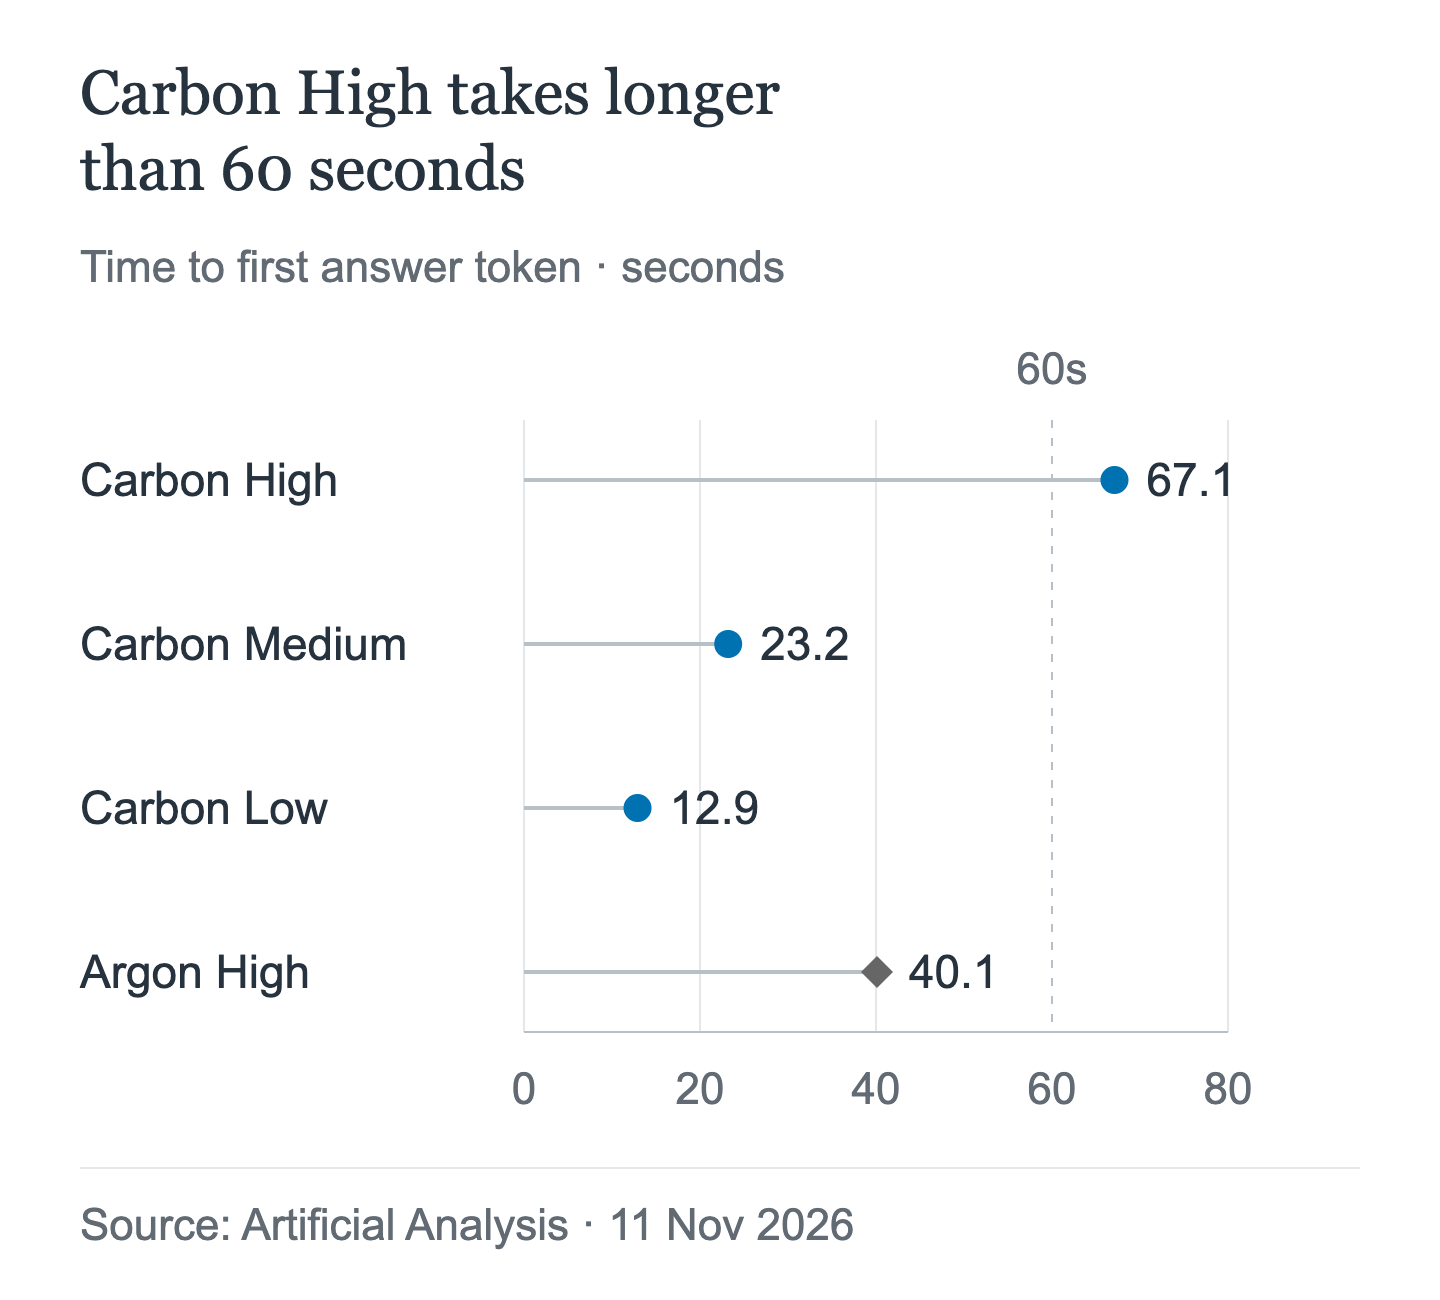
Nesta medição, Carbon High ultrapassa a referência de 60 segundos. O tempo até o primeiro token não determina um timeout seguro para a requisição inteira: a recomendação de 15–20 minutos acima vem do guia de decodificação longa do Google. Estes são resultados de uma única medição, não garantias de latência nem um teste do AIHubMix.
Os limites de tempo por chamada do cliente nativo do Google são mais restritos do que o limite para execução em segundo plano: 20 minutos para um fluxo e 10 para uma chamada sem streaming, contra 24 horas para execução em segundo plano. O AIHubMix não documenta esses limites para execução em segundo plano.
Versões mínimas do SDK nativo para decodificação longa: Python 2.34.0, JS 2.32.0, Go 1.77.0, Java 1.80.0, .NET 1.28.0. API_TIMEOUT_MS do Claude Code tem um padrão de 10 minutos; se uma via do Claude Code para o Carbon for confirmada mais adiante, aumente esse valor antes da primeira execução.
Armadilhas na cobrança
O preço por token do Carbon é simples; a fatura, não. Vários mecanismos aumentam o valor cobrado, e uma alteração programada dobra todas as tarifas.
O pensamento é cobrado como saída
Os tokens de pensamento são cobrados como saída. A tarifa de saída do Carbon é de US$ 10 por milhão de tokens agora e passará a US$ 20 a partir de 1º de dezembro.
Cada etapa de decodificação longa é cobrada
O exemplo detalhado do Google: um prompt de 1,000 tokens que produz 200,000 tokens de saída registra total_input_tokens de 397,216 ao longo de etapas com 1,000, 66,536, 132,072 e 197,608 tokens. "Você paga por cada token em cada etapa, inclusive as etapas que contêm apenas pensamento." O cache implícito dá um desconto de 95% na maior parte da entrada, mas as etapas continuam contabilizadas no uso. O trabalho concluído também é cobrado quando uma execução falha ou é cancelada: "Os segmentos concluídos são cobrados ao fim de cada segmento, mesmo que um segmento posterior falhe ou seja cancelado", e "Você paga por todo o trabalho concluído antes de a interação terminar."
A fundamentação tem cobrança própria
No serviço nativo do Google, a fundamentação com a Pesquisa Google inclui 5,000 requisições gratuitas por mês, compartilhadas entre Gemini 3 e versões posteriores; depois, custa US$ 14 por 1,000 requisições, com limite de 1,500 por dia. O AIHubMix não documentou fundamentação para o Carbon.
A observação sobre Vertex se aplica somente ao fornecedor
A página de preços do Vertex do Google acrescenta uma regra: conclusões com mais de 32K tokens são cobradas com base no uso de tokens recuperáveis, mesmo que a requisição falhe por timeout do cliente ou do servidor; a regra entra em vigor em 13 de novembro de 2026. Essa é uma regra do fornecedor; não foi publicado se o provedor VertexAI do AIHubMix a aplica. Pergunte antes de presumir.
Em 1º de dezembro, todas as tarifas dobram
| Tarifa | Até 30 de novembro | A partir de 1º de dezembro |
|---|---|---|
| Entrada | US$ 2 por 1M | US$ 4 por 1M |
| Saída | US$ 10 por 1M | US$ 20 por 1M |
| Leitura em cache | US$ 0.10 por 1M | US$ 0.20 por 1M |
Carbon e Argon compartilham as tarifas introdutórias; todas dobram em 1º de dezembro. Hoje, o AIHubMix lista as tarifas introdutórias e ainda não publicou os preços após dezembro. Considere certa a duplicação e desconhecido o valor no gateway, e verifique ambos antes de definir o orçamento.
Agentes com permissões reais
Para chamadas nativas do Google, o guia do Carbon recomenda priorizar turnos sequenciais de execução de ferramentas. Nesse fluxo, faça uma chamada de cada vez. O guia Gemini da AIHubMix documenta tool_choice="auto", mas o suporte a ferramentas específico do Carbon e o comportamento de chamada forçada de ferramentas no gateway não foram confirmados.
O histórico não pode terminar em um turno do modelo, e turnos do modelo pré-preenchidos não são compatíveis. Se faltar um resultado de ferramenta, envie um turno do usuário perguntando qual é a próxima etapa.
O cartão do modelo lista lentidão ou timeouts ocasionais e tokens adicionais nos níveis mais altos; a data de corte de conhecimento é março de 2026. Com acesso de gravação, um timeout é o risco real: uma execução que exceda o limite do cliente pode deixar trabalho parcial para trás, e os segmentos concluídos ainda serão cobrados.
Ferramentas de programação: consulte a página do modelo antes de configurar qualquer coisa
A listagem do Carbon na AIHubMix documenta apenas Chat Completions, e o Carbon ainda não está no índice público de modelos. O Claude Code precisa de Anthropic Messages; o Codex precisa de Responses. Nenhum dos dois foi confirmado para o Carbon na AIHubMix. Não presuma que algum deles funciona: abra a página do modelo Carbon vinculada acima e confira a lista de protocolos. Se aparecer apenas Chat Completions, use um cliente compatível com OpenAI ou aguarde.
O formato da solicitação é igual ao do Argon, mas a disponibilidade de protocolos é diferente: atualmente, a AIHubMix documenta o Carbon apenas para Chat Completions. A publicação sobre Claude Code aborda ANTHROPIC_BASE_URL, ANTHROPIC_AUTH_TOKEN e API_TIMEOUT_MS; a publicação sobre Codex aborda o bloco do provedor, wire_api e model_reasoning_effort. O que muda é se o protocolo está disponível.
| Cliente | Protocolo necessário | Carbon na AIHubMix |
|---|---|---|
| Claude Code | Anthropic Messages | Não documentado |
| Codex | Responses API | Não documentado |
| OpenAI SDK | Chat Completions | Documentado |
Configurações:
- ID do modelo:
gemini-4-carbon. - Pensamento: baixo, médio, alto; o padrão é médio.
- Mapeamento do esforço: campo nativo
thinking_level, campo de compatibilidadereasoning_effort; o Google mapeia os valores de esforço, mas a AIHubMix não publicou o mapeamento do Carbon. Envie um dos dois. - Contexto: 1,048,576 segundo o Google; a AIHubMix não publicou um limite para o Carbon, portanto não configure o sistema com base no valor do fornecedor.
- Problemas conhecidos: primeiro token lento no nível alto, recomendação do fornecedor de priorizar turnos sequenciais de ferramentas, limite conservador de 65,536 tokens de saída não verificado na AIHubMix e data de corte em março de 2026.
Teste rápido, 10–15 minutos:
- Escolha um repositório pequeno com um teste de unidade com falha e um comando de teste que termine em menos de um minuto.
- Defina o modelo como
gemini-4-carbon,max_tokenscomo 65,536 ou menos, e o timeout de HTTP como pelo menos 15 minutos. - Peça à ferramenta que faça a menor alteração capaz de fazer o teste passar e, em seguida, execute o comando de teste e inspecione o diff.
- Aprovado: a edição é mínima e o teste passa em 10–15 minutos. Reprovado: registre se a resposta foi um erro 400, uma resposta incompleta, um timeout ou uma edição incorreta; cada caso tem uma solução diferente acima.
- Se a ferramenta permitir escolher o nível, teste médio e alto e mantenha o que terminar dentro do prazo.
Checklist antes da primeira solicitação de produção
- ID do modelo definido como
gemini-4-carbon. - Sem
temperature,top_poutop_k. - Sem
frequency_penaltyoupresence_penalty; mantenhacandidate_countem 1 ou omita-o. max_tokensem 65,536 ou menos.- As solicitações em segundo plano nativas do Google enviam
store=truee ummax_output_tokensexplícito; a AIHubMix não documentou esse fluxo. - Timeout de HTTP de pelo menos 15 minutos; streaming é preferível.
- Use apenas um entre
reasoning_effortethinking_level. - Priorize turnos sequenciais de ferramentas na API nativa do Google; a AIHubMix documenta
tool_choice="auto", mas o suporte ao Carbon não foi confirmado. - Não faça chamadas explícitas de cache; o prefixo estável do prompt vem primeiro.
- O orçamento inclui tokens de pensamento e cada etapa de decodificação longa.
- Confirme com a pessoa responsável pelo orçamento as tarifas de 1º de dezembro.
- Confira a ferramenta de programação na página do modelo antes de configurá-la.
Perguntas frequentes
É preciso alterar o corpo da solicitação ao migrar de Argon para Carbon?
Não. O esquema permanece igual. Altere o ID do modelo, revise os valores e remova os campos que agora retornam erro 400.
Por que max_output_tokens retorna um erro 400?
A API nativa do Carbon do Google rejeita valores acima de 1,048,576. O caminho Chat Completions da AIHubMix tem uma recomendação conservadora separada: mantenha max_tokens em 65,536 ou menos até que um limite maior seja documentado. Um valor baixo interrompe o pensamento, o que é pior: a resposta pode ficar incompleta e ser cobrada.
Por que a resposta está vazia?
Se o status for incompleto, o texto pode estar vazio porque o modelo ainda estava pensando. Você paga pelo trabalho realizado. Aumente o limite e tente novamente.
Por que uma solicitação em segundo plano para em 64K?
No fluxo nativo em segundo plano do Google, se max_output_tokens não for especificado, o servidor para em 64K. Defina o limite explicitamente; a decodificação longa nativa pode chegar a 1,048,576 menos a entrada. A AIHubMix não documentou o modo em segundo plano.
O parâmetro temperature é respeitado?
Não. temperature, top_p e top_k são ignorados. Valores de penalidades e de candidate_count acima de 1 retornam erro 400.
O Carbon vai custar o dobro em 1º de dezembro?
As tarifas do Google dobram: entrada de $2 para $4, saída de $10 para $20 e leituras em cache de $0.10 para $0.20. A AIHubMix não publicou o preço após dezembro, então confirme antes de aprovar um orçamento.
É possível usar Claude Code ou Codex com o Carbon?
Não foi confirmado. A AIHubMix documenta Chat Completions para o Carbon; o Claude Code precisa de Anthropic Messages e o Codex precisa de Responses. Consulte primeiro a página do modelo.
Continue lendo: a série Gemini 4 Carbon
- Se a migração já está em andamento e a dúvida que resta é se o Carbon realmente vale o preço, a comparação coloca lado a lado as mesmas tarifas introdutórias.
Gemini 4 Carbon vs Argon: mesmo preço, quando vale a pena escolher Carbon? - Se você está escolhendo um agente de programação em vez de migrar um endpoint, a comparação direta aborda o uso de ferramentas e o custo por tarefa.
Gemini 4 Carbon vs Fable 5.2: qual escolher para programação agêntica?