
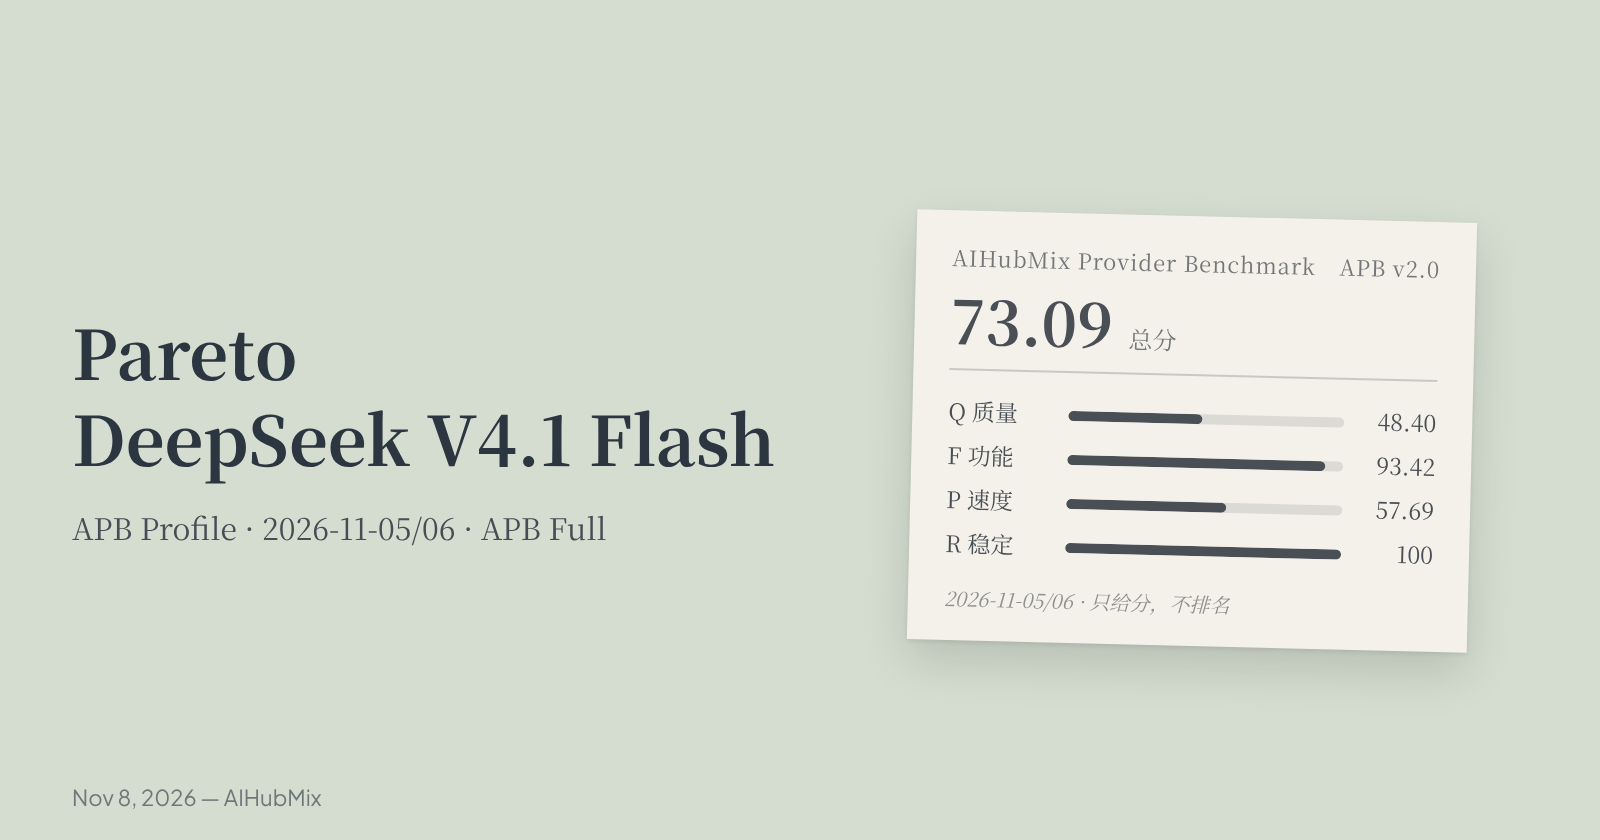
Em 2026-11-05/06, o DeepSeek V4.1 Flash 1017 foi submetido ao conjunto completo do AIHubMix Provider Benchmark (APB) no Pareto. As pontuações foram Q 48.40, F 93.42, P 57.69, K 27.58 e R 100; o índice geral é 73.09. Este perfil do APB abrange somente o Pareto. O modelo está listado como DeepSeek V4.1 Flash 1017.
Esta publicação apresenta apenas pontuações, sem classificação ou recomendação de provedor. Q, F, P, K e R vêm primeiro; o índice geral é um número-resumo sem intervalo de confiança. O padrão aplicado é o AIHubMix Provider Benchmark Standard v2.0.
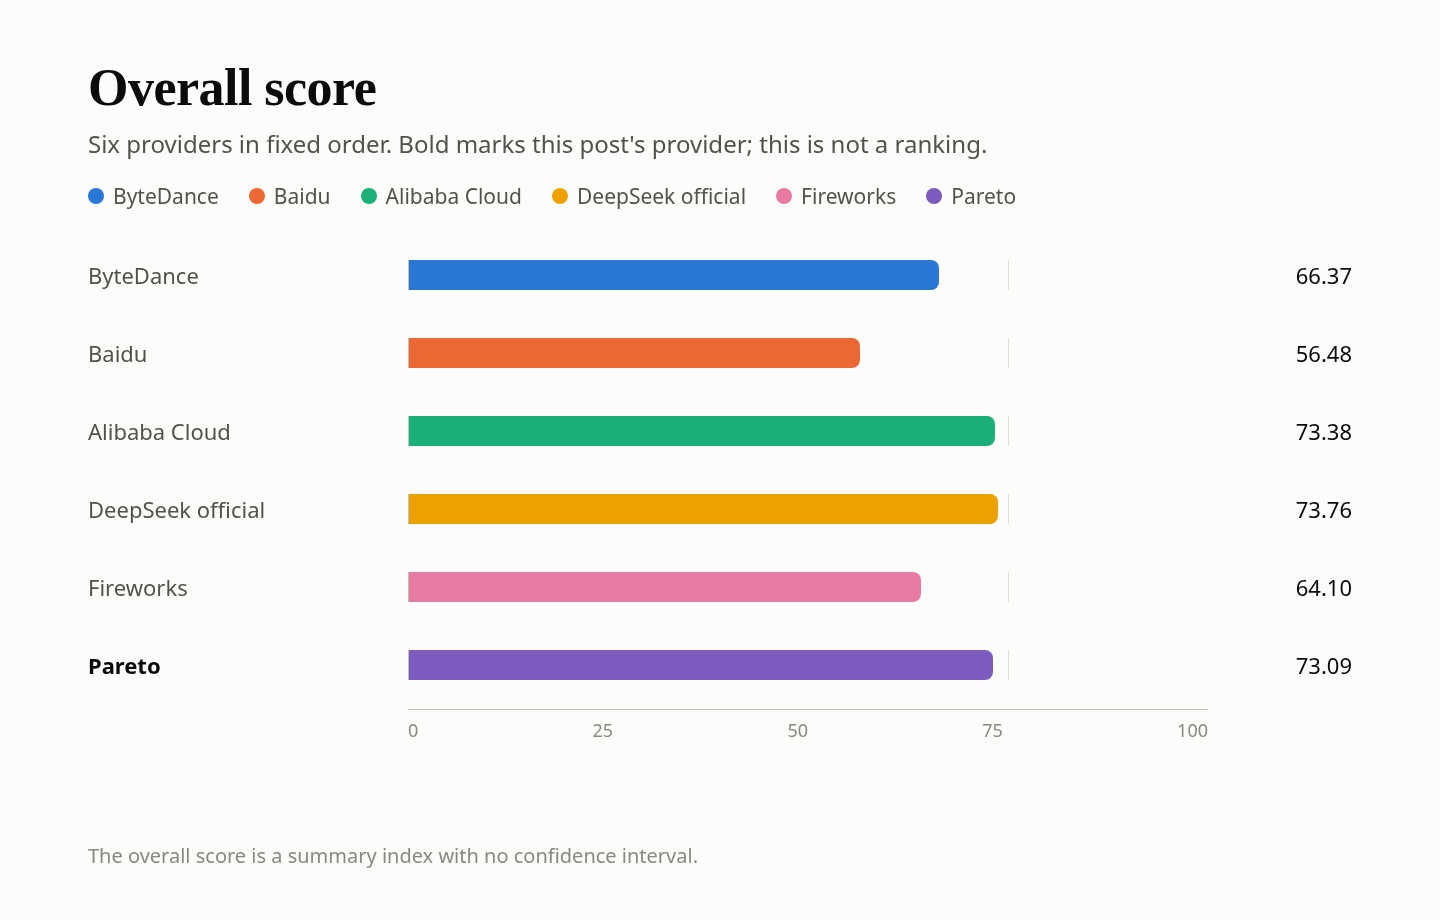
Pontuações em seis provedores
O negrito indica o provedor desta publicação. A ordem dos provedores é fixa e não representa uma classificação. K é uma subpontuação de P, com peso de 20%. O índice geral é um número-resumo sem intervalo de confiança. DeepSeek oficial e Alibaba Cloud diferem por 0.37, uma diferença que não é estatisticamente distinguível.
Resumo
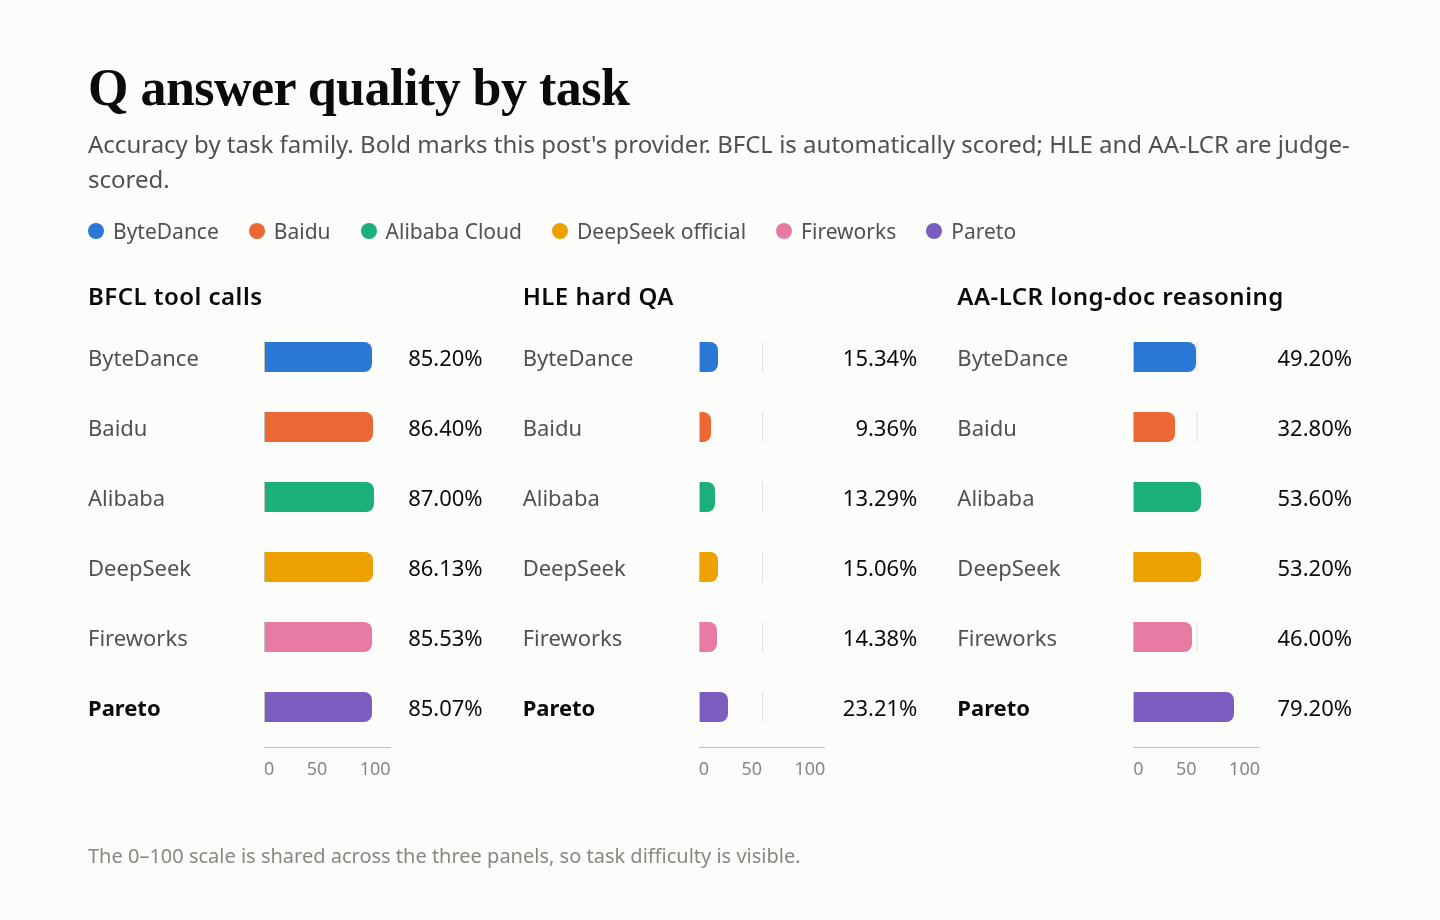
- Q — qualidade das respostas: 48.40. BFCL 85.07%, HLE 23.21%, AA-LCR 79.20%. Em relação ao canal oficial: +5.94 pontos percentuais, IC de 95% de +3.54 a +8.36. O HLE teve 996 falhas de serviço, a maioria por truncamento, pois o pensamento consumiu o limite de tamanho da saída; elas contam como incorretas.
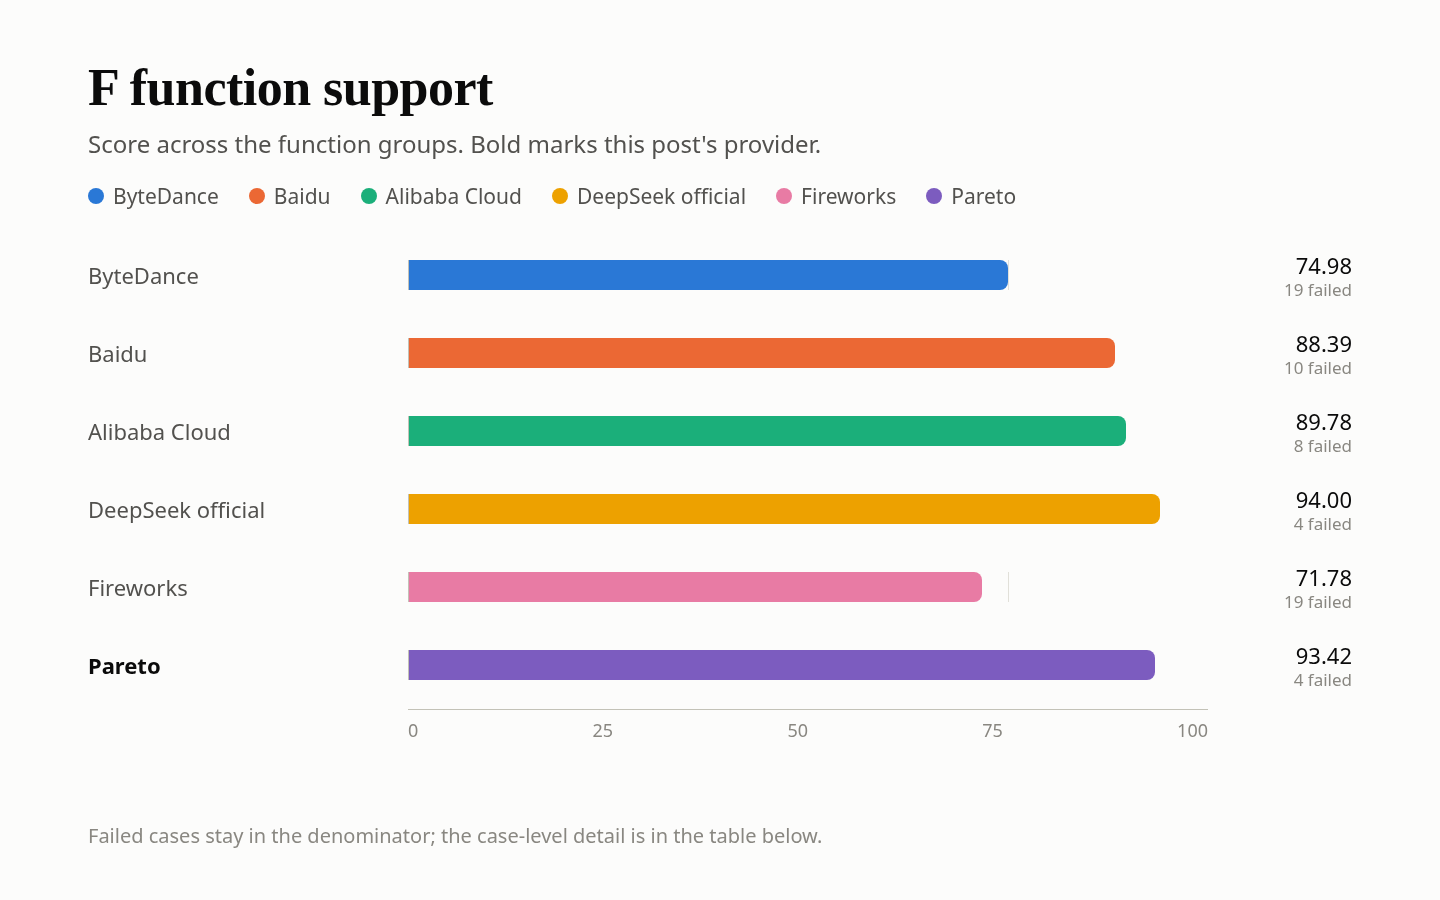
- F — suporte a funções: 93.42. 29 de 33 verificações contabilizadas foram aprovadas (streaming 23/27, erros 3/3, medição 3/3). 147 verificações ficaram fora do denominador. Das 4 falhas, 3 foram respostas vazias em solicitações com sequência de parada e 1 fixture de texto em streaming não correspondeu exatamente.
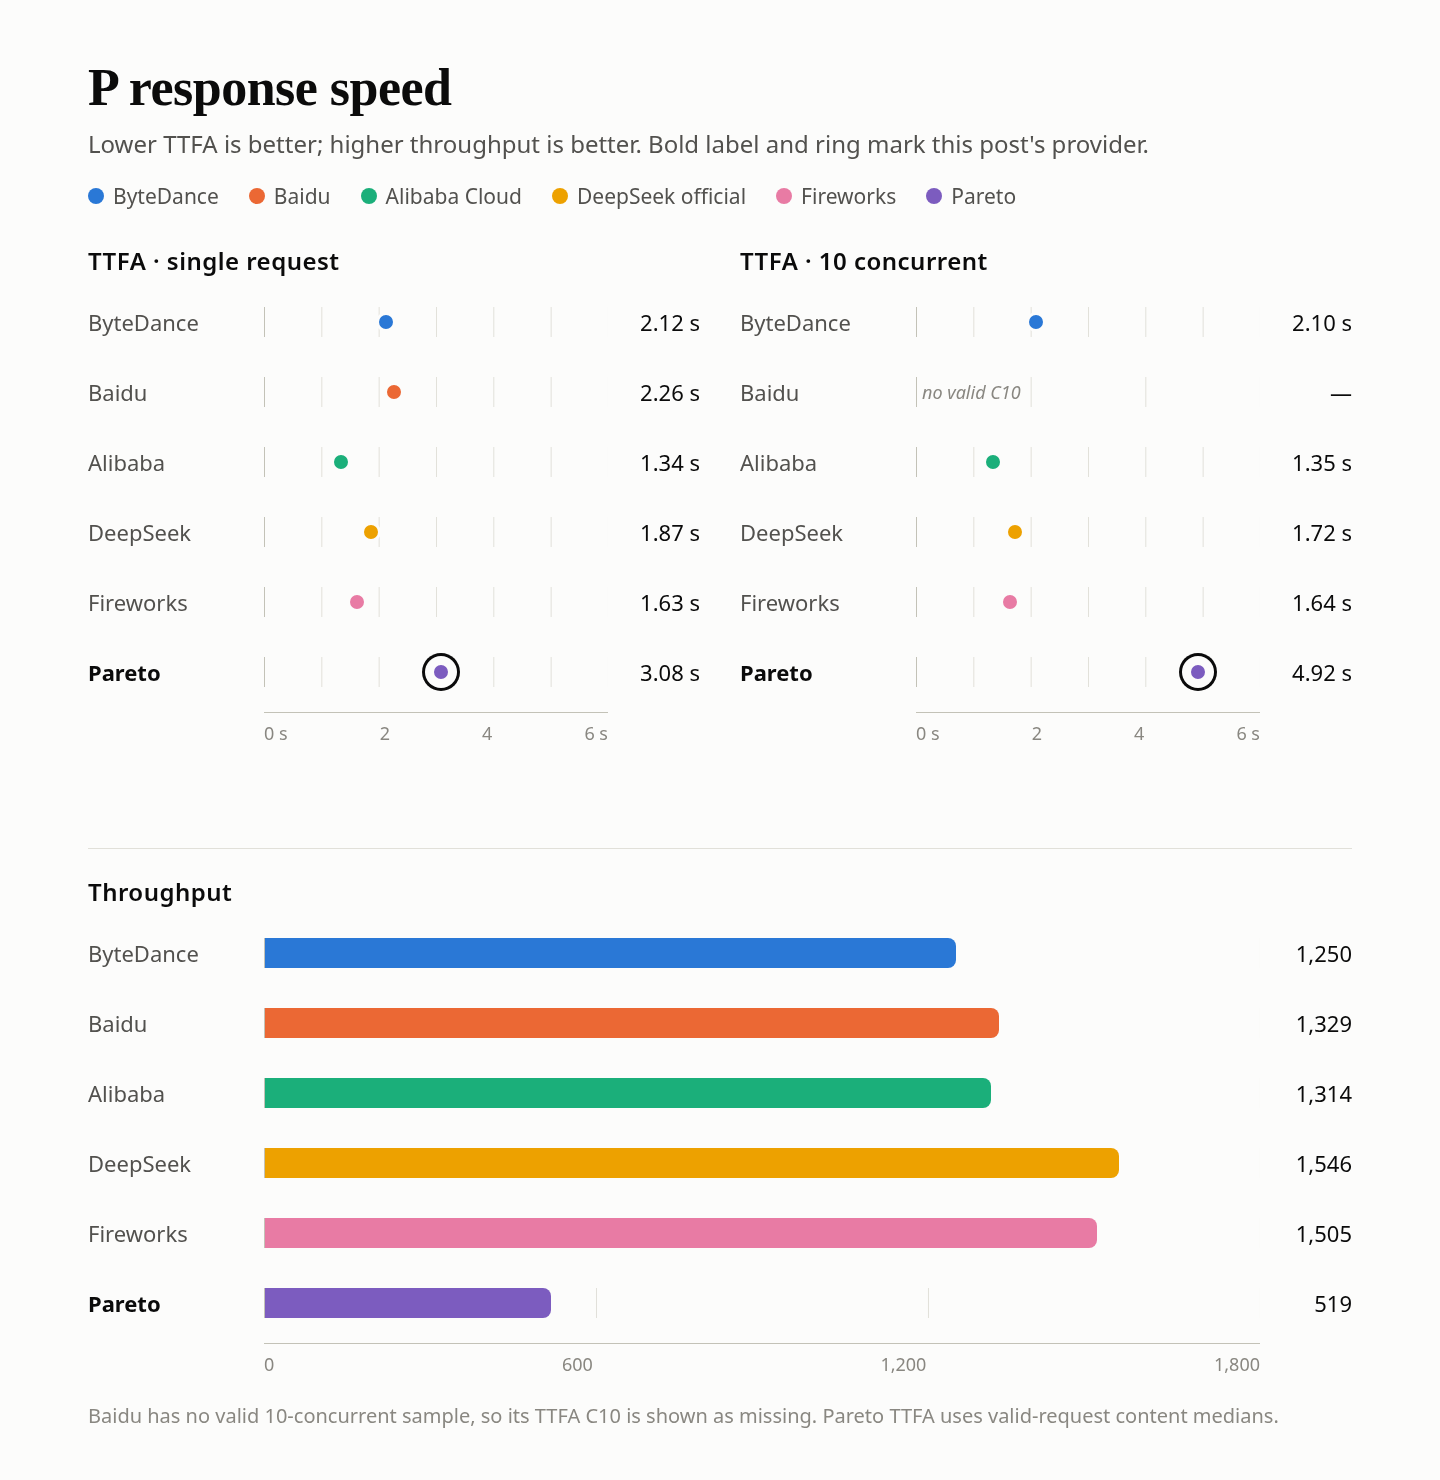
- P — velocidade de resposta: 57.69. Pontuação de resposta 65.22, com cache K ponderado em 20%. Medianas de TTFA para solicitações válidas: 3.08 s com concorrência 1 e 4.92 s com concorrência 10; medianas usadas na pontuação, incluindo solicitações inválidas: 5.85 s e 6.13 s. 110 das 180 sondagens foram válidas; 70 foram inválidas porque o pensamento consumiu o orçamento de saída do teste de velocidade.
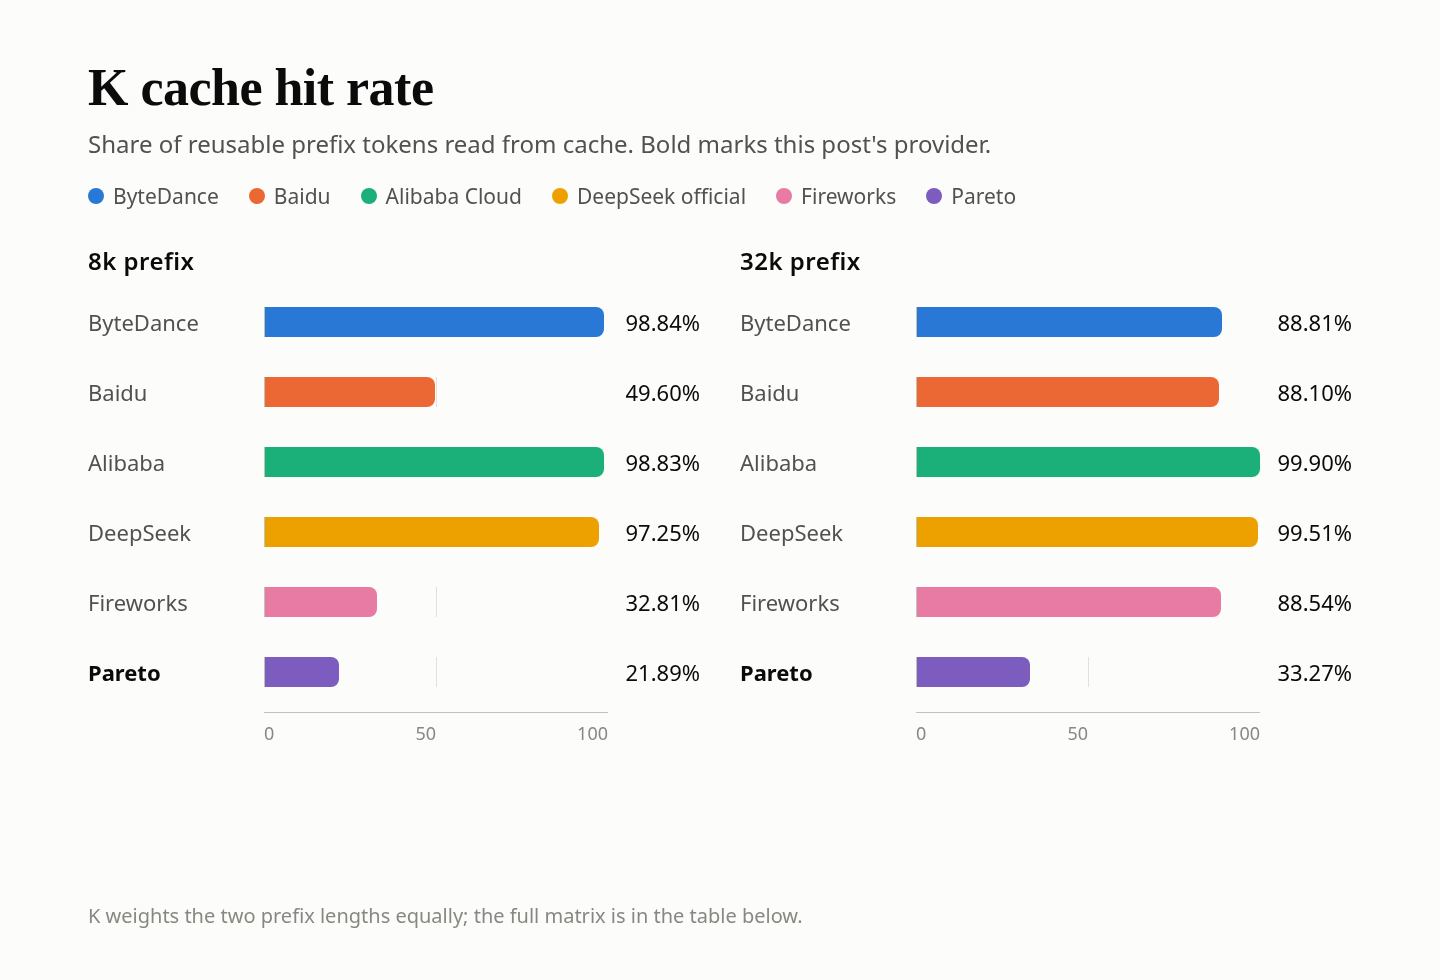
- K — cache: 27.58. 8k quente: 2/9 (leitura 15,872 / reutilizável 72,504); 32k quente: 3/9 (leitura 96,000 / reutilizável 288,513). Pontuação calculada com a configuração padrão.
- R — estabilidade do serviço: 100. 300/300 solicitações dedicadas foram concluídas com sucesso na primeira tentativa.
Configuração do teste
| Item | Configuração |
|---|---|
| Modelo | DeepSeek V4.1 Flash 1017 |
| ID do modelo solicitado | deepseek/deepseek-v4.1-flash |
| Rota de acesso | Pareto, usando o ID do modelo acima |
| Parâmetros | temperature 1.0, max_tokens 16,384, timeout 300 s; somente solicitações em streaming |
| Pensamento | Pensamento de alta intensidade ativado |
| Data | 2026-11-05/06 UTC+8; o cache corresponde a um novo teste em 2026-11-06 com a configuração padrão |
| Amostras | Q 4,250 (BFCL 500×3, HLE 250×10, AA-LCR 25×10); F 60×3; P 90+90; R 300; K 30 |
| Observações | Pensamento de alta intensidade nesta execução; os outros cinco provedores da série não usaram pensamento. O suporte a recursos é pontuado com base no subconjunto disponível em streaming; o cache usa a configuração padrão. |
As solicitações usaram o guia de início rápido do AIHubMix; os IDs dos modelos estão na página de modelos.
Q — qualidade das respostas: 48.40
O conjunto executou 500 perguntas BFCL × 3 rodadas, 250 HLE × 10 e 25 AA-LCR × 10. O BFCL foi pontuado automaticamente; HLE e AA-LCR foram avaliados por deepseek-flash. As três famílias usam os mesmos itens que os outros provedores. Dez respostas impossíveis de pontuar foram removidas, restando 4,240 instâncias pontuadas.
| Tarefa | Perguntas | Corretas | Precisão | Falhas |
|---|---|---|---|---|
| Chamadas de ferramenta BFCL | 500 × 3 | 1,276/1,500 | 85.07% | 0 |
| Perguntas e respostas difíceis do HLE | 250 × 10 | 578/2,490 | 23.21% | 996 |
| Raciocínio sobre documentos longos AA-LCR | 25 × 10 | 198/250 | 79.20% | 0 |
| Total · IC de 95% 45.39%–51.26% | — | 2,052/4,240 | 48.40% | 996 |
As falhas permanecem no denominador como respostas erradas: 996 respostas HLE foram truncadas quando o pensamento consumiu o limite de tamanho da saída. Das 1,494 tentativas de HLE que retornaram uma resposta completa, 578 estavam corretas (cerca de 38.7%).
| Categoria BFCL | Aprovadas | Taxa de aprovação |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 269/300 | 89.67% |
| parallel | 265/300 | 88.33% |
| parallel_multiple | 203/240 | 84.58% |
| irrelevance | 104/150 | 69.33% |
| ahm_multi_turn | 102/150 | 68.00% |
simple_python teve aprovação de 333/360 (92.50%), multiple de 269/300 (89.67%), ahm_multi_turn de 102/150 (68.00%) e irrelevance de 104/150 (69.33%).
Comparação com os outros cinco
Diferença em pontos percentuais em relação ao canal oficial; o intervalo de 95% é mostrado como barras. Se cruzar 0, a diferença não é distinguível. O avaliador deepseek-flash pertence à mesma família e não foi calibrado, portanto pode ser permissivo.
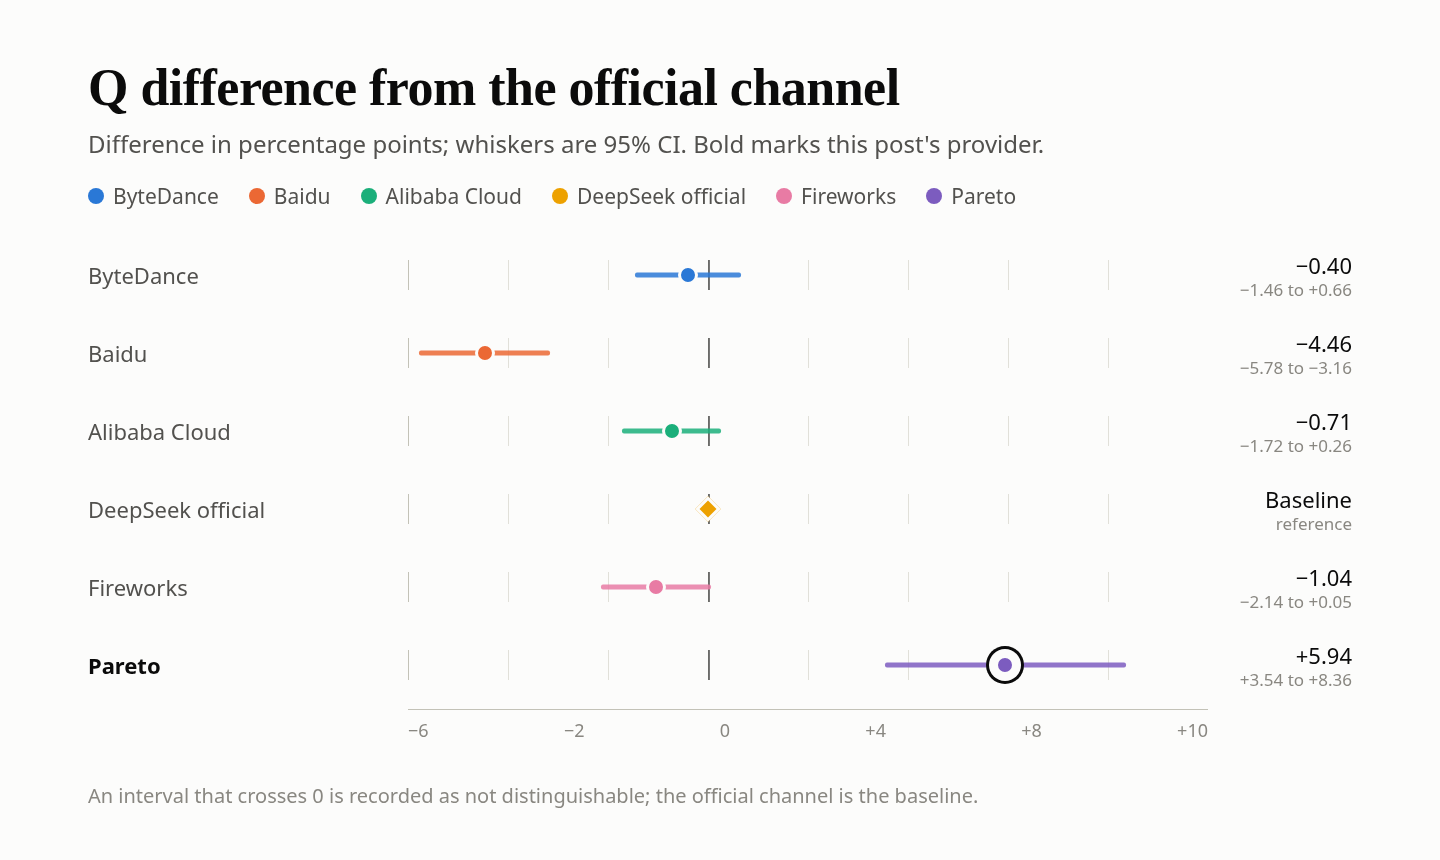
Em comparação com o canal oficial, a diferença numérica é +5.94 (+3.54 a +8.36).
F — suporte a funções: 93.42
33 verificações contabilizadas, 29 aprovadas; 147 não contabilizadas. O valor 93.42 é recalculado normalizando os pesos originais dos grupos apenas entre os grupos observados (streaming 20%, erros 15%, medição 10%; total de 45%). A taxa simples de aprovação de 29/33 é 87.88%. Ferramentas, restrições e contexto não foram contabilizados.
| Grupo de casos | Peso | Aprovadas | Excluídas | Pontuação do grupo |
|---|---|---|---|---|
| Streaming e mensagens | 20% | 23/27 | 3 | 85.19 |
| Interface de ferramentas | 20% | — | 30 | — |
| Restrições de saída | 20% | — | 30 | — |
| Contexto e estado | 15% | — | 30 | — |
| Erro e recuperação | 15% | 3/3 | 27 | 100.00 |
| Medição e cache | 10% | 3/3 | 27 | 100.00 |
| Observado / ponderado | — | 29/33 | 147 | 93.42 |
“Janelas com falha” contabiliza as três janelas em que o caso não foi aprovado.
| Caso com falha | Janelas com falha | Motivo |
|---|---|---|
| Parada do streaming | 3/3 | Corpo vazio com stop |
| Texto em streaming | 1/3 | Ponto final extra no corpo em relação ao fixture |
Comparação com os outros cinco
P — velocidade de resposta: 57.69
A pontuação usa o tempo até o primeiro token de conteúdo, não o tempo até o primeiro token de qualquer tipo. Com o pensamento ativado, o modelo gera conteúdo de pensamento antes do texto visível da resposta, por isso a espera pelo conteúdo é maior do que a espera pelo primeiro pacote. Em cada uma das três janelas, foram enviadas 30 solicitações com concorrência 1 e 30 com concorrência 10, totalizando 180.
| Métrica | Resultado |
|---|---|
| TTFA de conteúdo | Medianas usadas na pontuação: 5.85 s (c=1) e 6.13 s (c=10); medianas de solicitações válidas: 3.08 s e 4.92 s |
| Primeiro token de qualquer tipo | Medianas de solicitações válidas: 1.46 s e 1.76 s |
| TPOT | Faixa mais lenta usada na pontuação: 4.87 ms/token |
| Goodput | 519 token/s com concorrência 10 |
| Válidas | 53/90 com c=1 e 57/90 com c=10, total de 110/180; 70 inválidas porque o pensamento consumiu o orçamento de saída do teste de velocidade (~2,048 tokens) |
| Componentes | TTFA 24.59, TPOT 100.00, goodput 72.05; pontuação de resposta 65.22 |
| Composição de P | 65.22 × 80% + 27.58 × 20% = 57.69 |
Os tokens de pensamento são excluídos do numerador do goodput.
K — cache: 27.58
Leituras agregadas do novo teste de 2026-11-06 com a configuração padrão. As matrizes de cache por solicitação não estão incluídas (os rastreamentos brutos não foram migrados). K atribui o mesmo peso aos dois comprimentos de prefixo; K corresponde a 20% de P.
| Prefixo | Acertos em cache quente | Lidos / reutilizáveis | Segmento |
|---|---|---|---|
| 8k | 2/9 | 15,872 / 72,504 | 21.89 |
| 32k | 3/9 | 96,000 / 288,513 | 33.27 |
| K (peso igual) | 27.58 |
Os controles de cache frio passaram em 6/6 em cada comprimento.
R — estabilidade do serviço: 100
As 300 solicitações cobriram texto curto, entrada longa, chamadas de ferramenta e histórico com várias interações, todas com concorrência 1. Foram verificadas apenas a validade e a integridade da primeira resposta; as respostas não foram avaliadas e nenhuma solicitação foi repetida. As falhas de Q e P não são contabilizadas novamente aqui.
| Tipo de solicitação | Sucesso na primeira tentativa |
|---|---|
| Texto curto | 120/120 |
| Entrada longa de 10k | 90/90 |
| Chamada de ferramenta | 60/60 |
| Histórico com várias interações | 30/30 |
| Total · IC de 95% 98.78%–100% | 300/300 |
Perguntas frequentes
O que abrange Q 48.40?
BFCL, HLE e AA-LCR em 4,240 instâncias pontuadas: 2,052 corretas, 48.40%, IC de 95% 45.39%–51.26%. Em comparação com o canal oficial, a diferença numérica é +5.94 (+3.54 a +8.36).
Por que houve 996 falhas de serviço no HLE?
A maioria foi truncada porque o pensamento consumiu o limite de tamanho da saída; essas respostas permanecem no denominador como incorretas.
Por que F é 93.42 se 147 verificações foram excluídas?
Só é contabilizado o subconjunto disponível em streaming. Os pesos dos grupos são normalizados novamente entre os grupos observados; ferramentas, restrições e contexto não são contabilizados.
Por que os casos com stop falharam?
As solicitações com uma sequência de parada retornaram um corpo vazio nas três janelas.
Por que 70 das 180 sondagens de velocidade foram inválidas?
O pensamento consumiu o orçamento de saída do teste de velocidade (cerca de 2,048 tokens).
O que abrange R 100?
300 solicitações dedicadas, todas válidas na primeira tentativa; o limite inferior de 95% é 98.78%. As falhas de Q e P não são contabilizadas em R.
Continue lendo: a série DeepSeek V4.1 Flash
- A ByteDance relatou tokens de pensamento mesmo depois de desativar o pensamento: DeepSeek V4.1 Flash na ByteDance: chamadas de ferramenta correspondem, medição não
- A Baidu registrou Q 38.00 e P 37.77: DeepSeek V4.1 Flash na Baidu: nenhum canal disponível atinge Q e P
- A Alibaba Cloud registrou um primeiro token em 1.34 s e cache 99.37: DeepSeek V4.1 Flash na Alibaba Cloud: primeiro token em 1.34s, cache 99.37
- O canal oficial é a referência de Q, com F 94.00: DeepSeek V4.1 Flash no canal oficial: F 94.00, 15 sondagens inválidas
- A Fireworks retornou respostas vazias com stop e 3/9 acertos de cache em 8k: DeepSeek V4.1 Flash na Fireworks: respostas vazias com stop, 3/9 acertos de cache


