

Em 2026-11-03/04, o conjunto APB Full foi executado com DeepSeek V4.1 Flash 1017 em cinco provedores por meio do AIHubMix. Todos os provedores usaram o mesmo modelo, as mesmas perguntas, os mesmos parâmetros e os mesmos scripts de requisição; o modelo está listado na página do modelo do AIHubMix, e as cinco entradas dos provedores estão na página de modelos. Este Perfil APB cobre apenas a Alibaba Cloud: o que cada seção mediu e quais foram os resultados.
Esta publicação apresenta pontuações sem classificar os provedores nem recomendar algum deles. Q, F, P, K e R vêm primeiro; K é uma subpontuação de P. A pontuação geral é um índice de resumo, não uma certificação, e não tem intervalo de confiança. As regras de pontuação estão definidas no AIHubMix Provider Benchmark Standard v2.0.
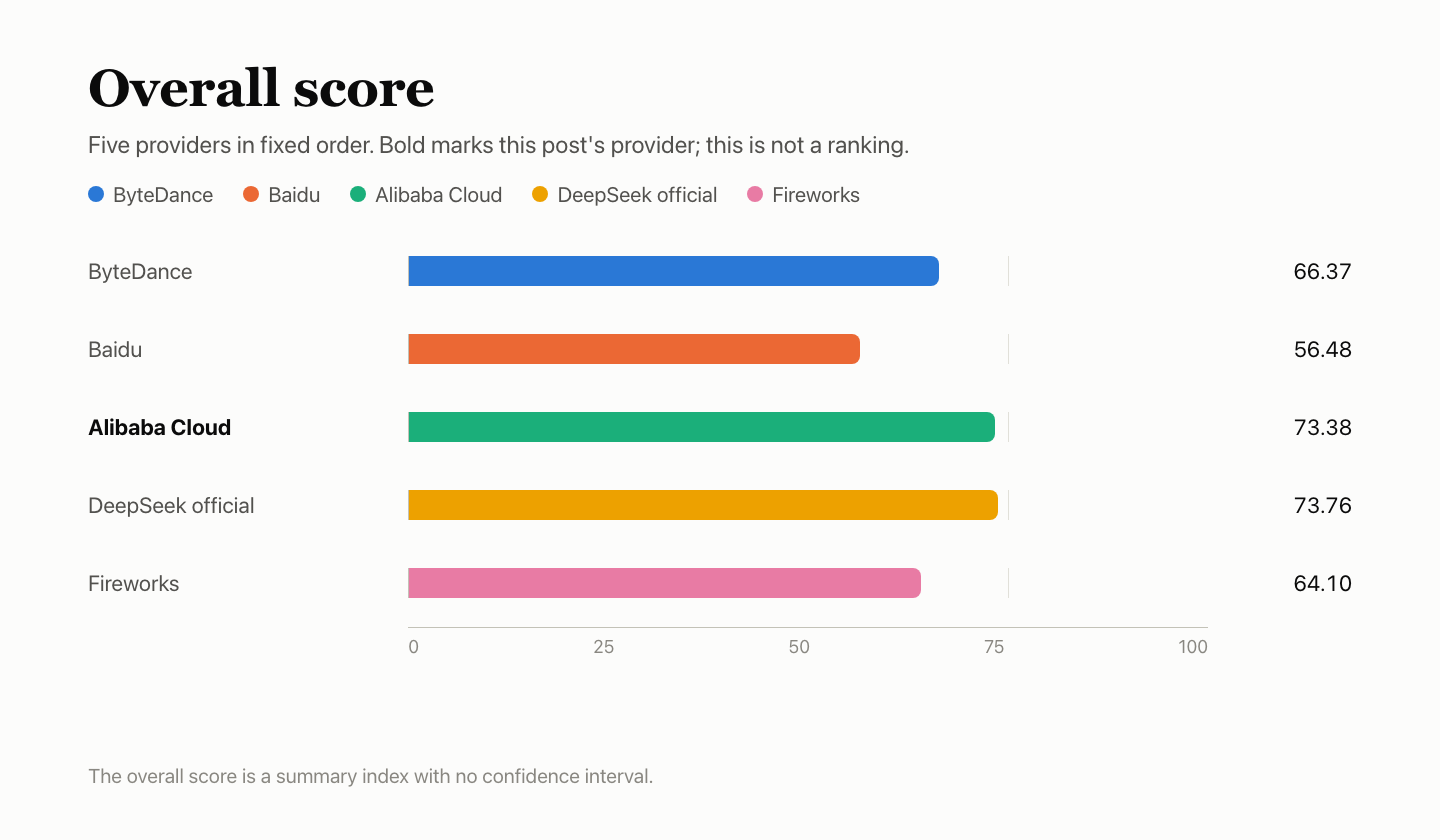
Pontuações dos cinco provedores
O negrito destaca o provedor desta publicação. Os provedores aparecem em uma ordem fixa, não em um ranking. K é uma subpontuação de P, com peso de 20%, exibida separadamente para referência. A pontuação geral é um índice de resumo sem intervalo de confiança. DeepSeek oficial e Alibaba Cloud diferem em 0.37 na pontuação geral, e não é possível distingui-los.
Resumo
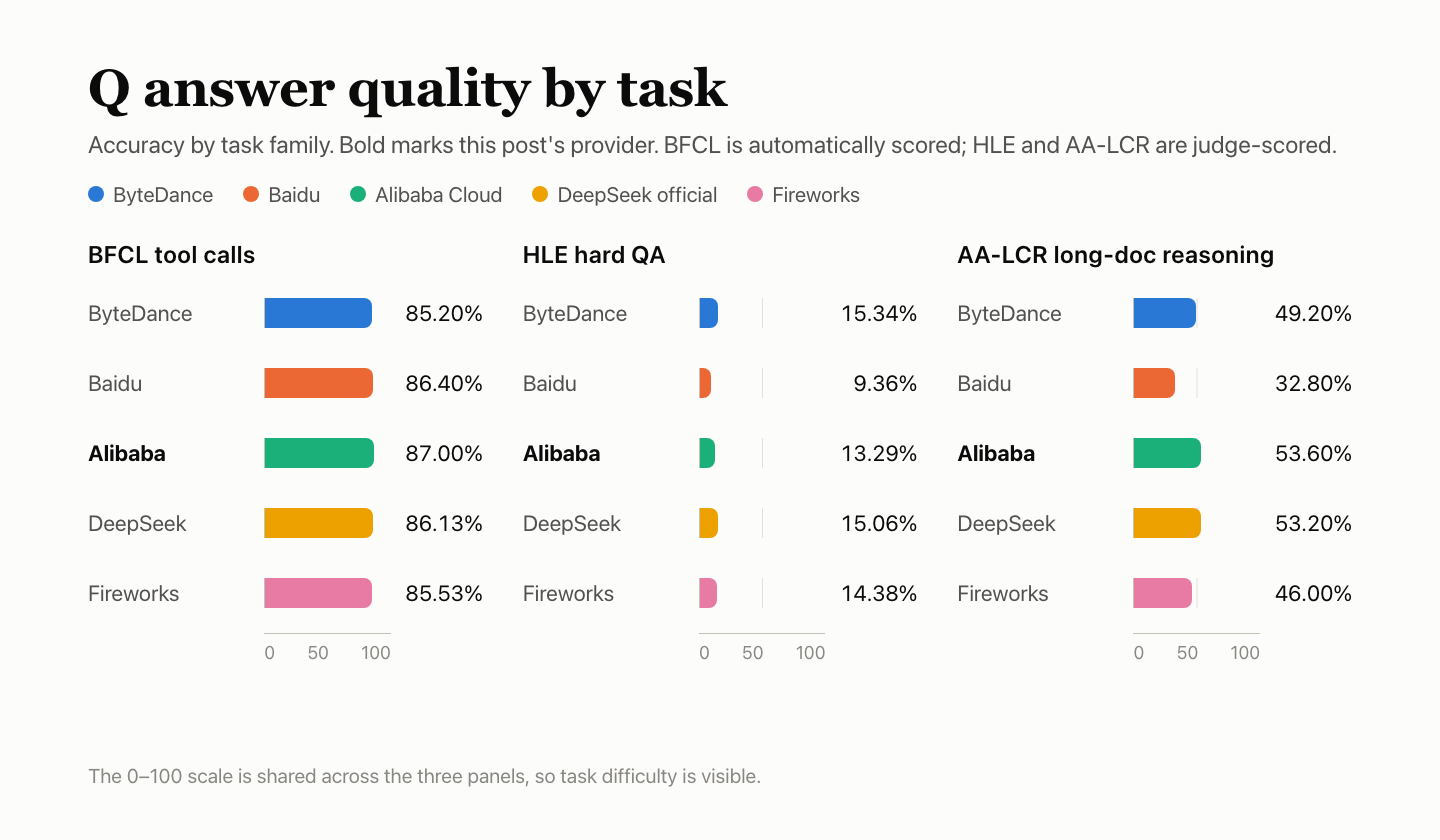
- Qualidade das respostas: Q 41.75. BFCL 87.00%, HLE 13.29%, AA-LCR 53.60%. Em relação ao canal oficial, a diferença é de −0.71 ponto percentual, com intervalo de 95% de −1.72 a +0.26; portanto, não é possível distinguir os dois.
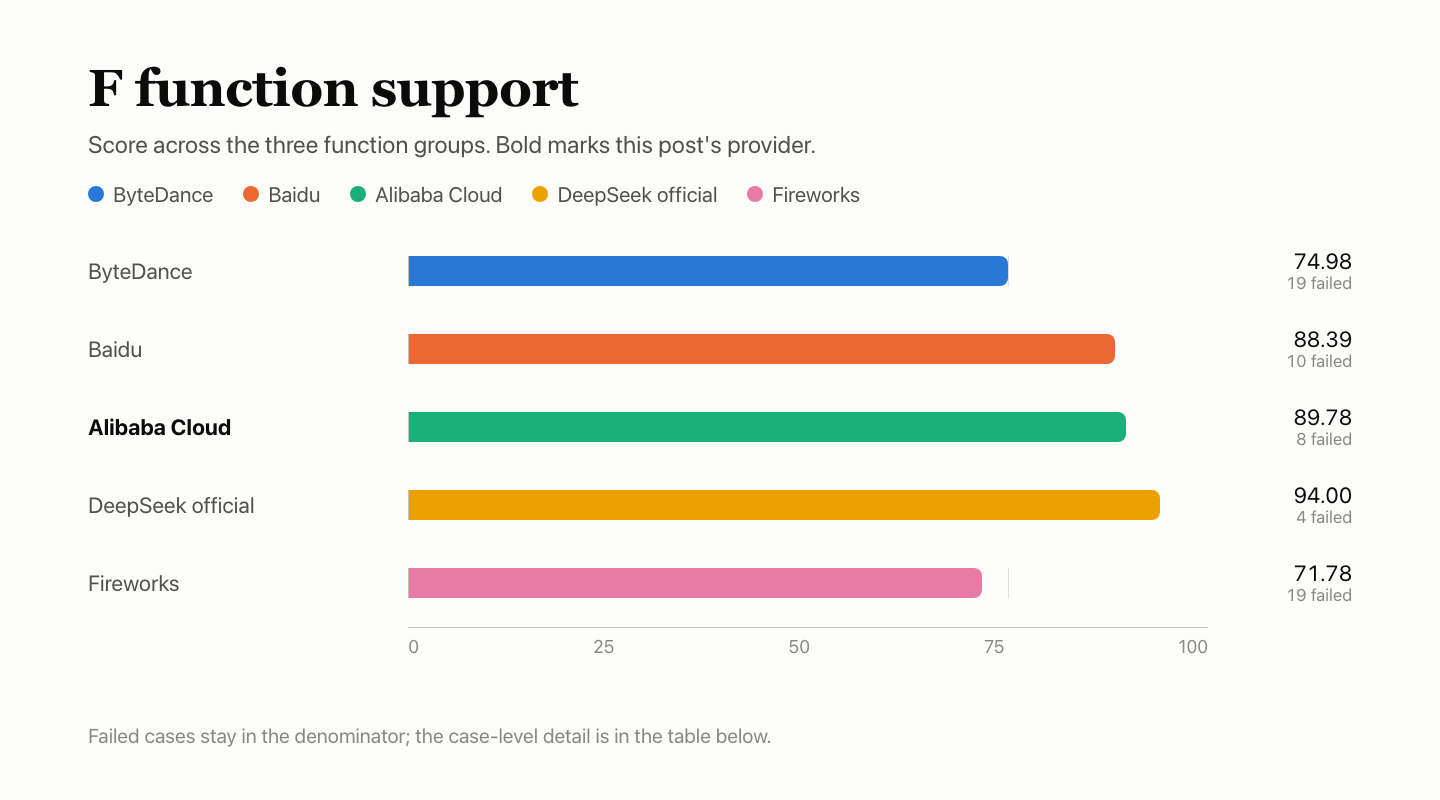
- Suporte a funções: F 89.78. Foram aprovadas 155 das 177 verificações incluídas no denominador. Um esquema de ferramenta inválido retornou 503 em vez de um erro de parâmetro, o estouro de contexto não retornou o tipo de erro documentado e um resultado isolado de ferramenta retornou 200.
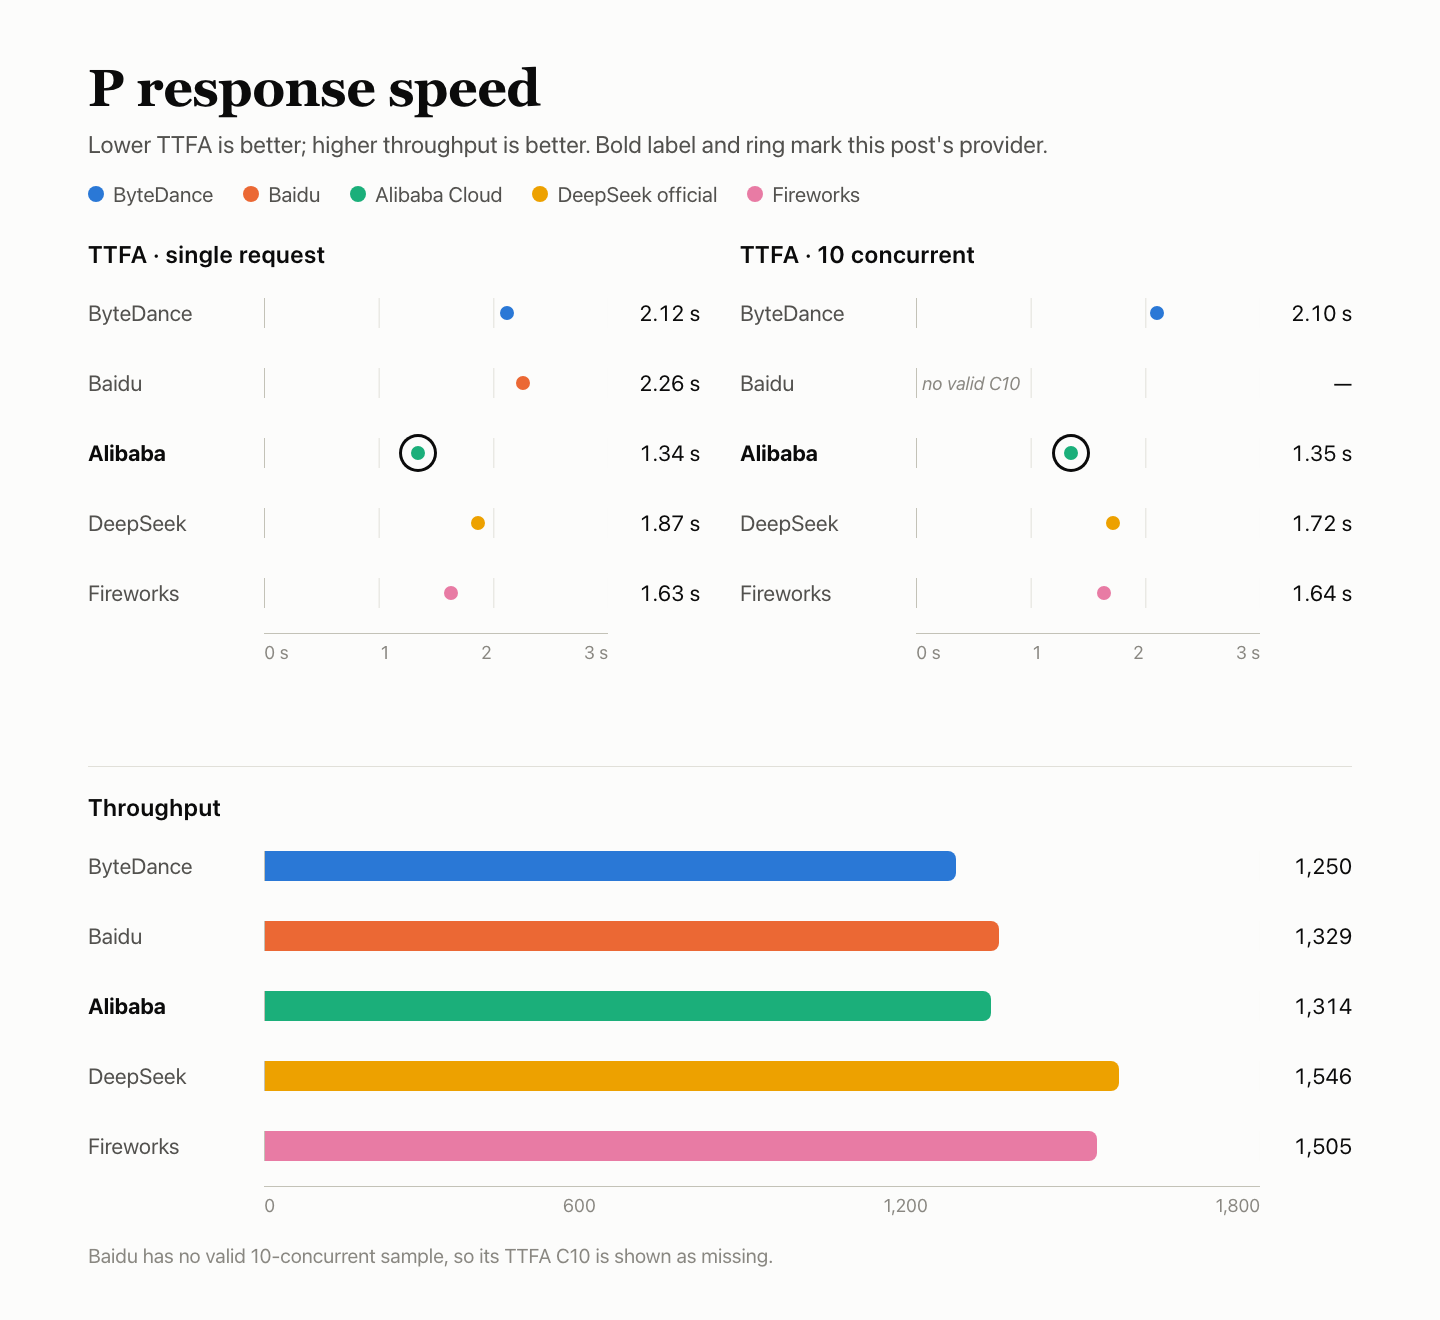
- Velocidade de resposta: P 88.58. A mediana até o primeiro token de conteúdo foi de 1.34 s com concorrência única e 1.35 s com concorrência de 10, o TPOT foi de 4.69 ms, e todas as 180 requisições de velocidade foram válidas.
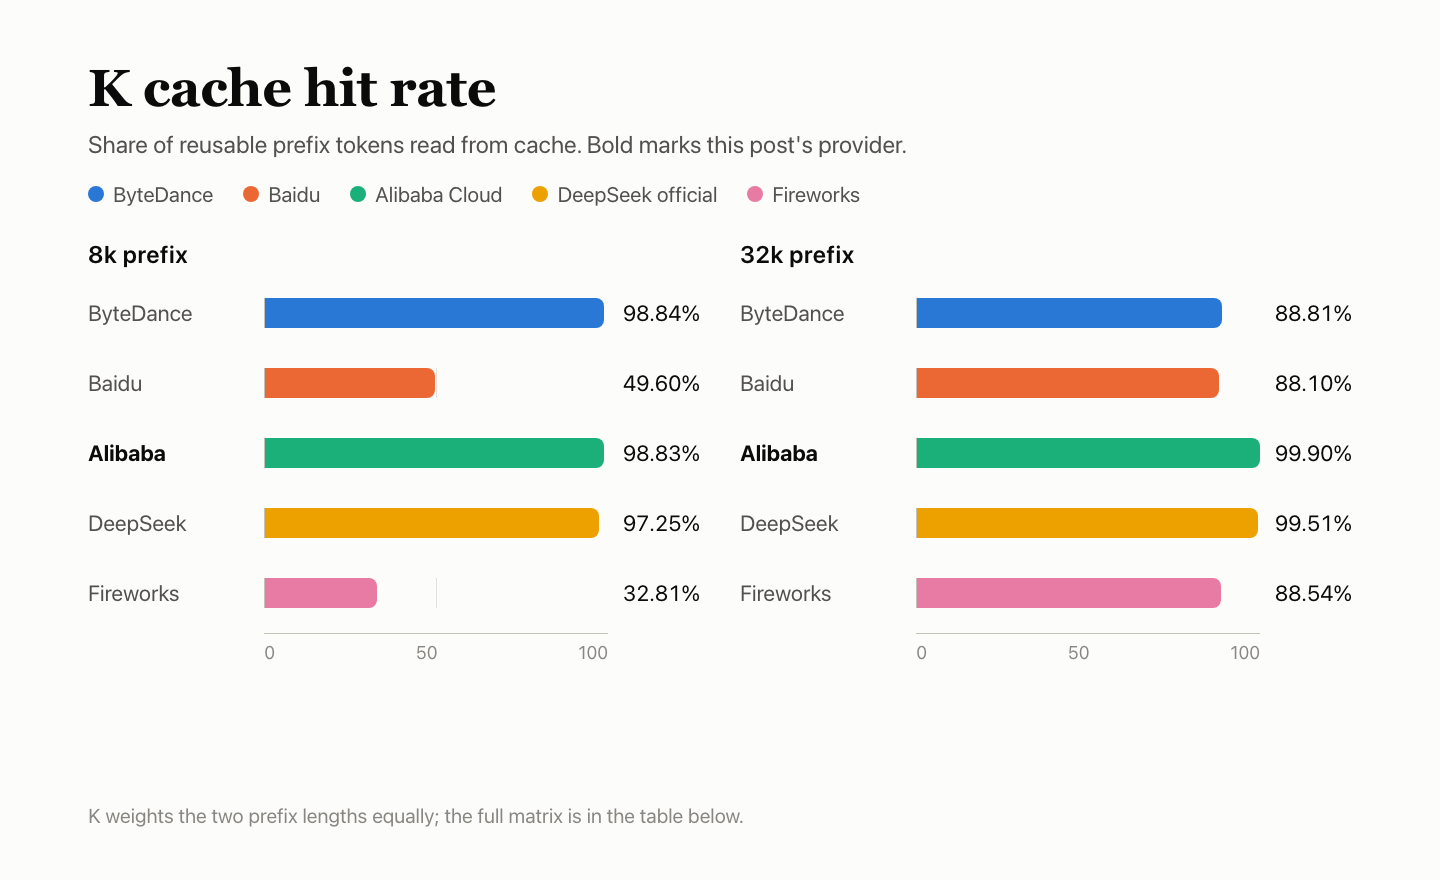
- Cache: K 99.37. Todas as 18 requisições quentes com prefixos de 8k e 32k tiveram acerto, e nenhum controle frio leu do cache.
- Estabilidade do serviço: R 100. Todas as 300 requisições dedicadas foram bem-sucedidas na primeira tentativa.
Configuração dos testes
A execução passou pelo AIHubMix, selecionando o ID do modelo do provedor; o guia de início rápido documenta a rota. A página de preços da DeepSeek lista as tarifas publicadas para o modelo.
| Item | Detalhe |
|---|---|
| Modelo | DeepSeek V4.1 Flash 1017 |
| ID do modelo solicitado | alicloud-deepseek-v4.1-flash-1017 |
| Nome do modelo retornado | deepseek-v4.1-flash-1017 |
| Rota de acesso | Pelo AIHubMix, selecionando o ID do modelo do provedor, não conectando à conta do próprio provedor |
| Parâmetros | Modo sem pensamento, temperature 1.0, max_tokens 16,384, timeout 300 s, sem novas tentativas automáticas |
| Pensamento desativado | Todas as requisições usaram reasoning_effort=none |
| Horário | 2026-11-03 18:07 – 11-04 16:33 UTC+8. Os cinco provedores compartilharam um Mac mini, a rede e a conta. |
| Amostras | Qualidade das respostas: 4,250 execuções de perguntas (BFCL 500 × 3 rodadas, HLE 250 × 10, AA-LCR 25 × 10); casos de função: 60 × 3 janelas; velocidade: 90 com concorrência única e 90 com concorrência de 10; estabilidade: 300; cache: 30 (prefixos de 8k e 32k, 3 grupos cada) |
Q — qualidade das respostas: 41.75
A qualidade das respostas foi avaliada com três conjuntos de perguntas: 500 perguntas BFCL, com 3 rodadas cada; 250 perguntas HLE, com 10 rodadas cada; e 25 perguntas AA-LCR, com 10 rodadas cada. O BFCL foi pontuado por regras automáticas; HLE e AA-LCR foram avaliados pelo modelo avaliador deepseek-flash. Os cinco provedores responderam às mesmas perguntas, e os três conjuntos foram combinados em uma única taxa de acerto. Dez respostas foram removidas porque não era possível pontuar as perguntas, restando 4,240 execuções de perguntas pontuadas.
| Tarefa | Perguntas | Corretas | Taxa de acerto | Falhas |
|---|---|---|---|---|
| Chamadas de ferramenta BFCL | 500 × 3 | 1,305/1,500 | 87.00% | 0 |
| Perguntas e respostas difíceis HLE | 250 × 10 | 331/2,490 | 13.29% | 8 |
| Raciocínio sobre documentos longos AA-LCR | 25 × 10 | 134/250 | 53.60% | 0 |
| Combinado · intervalo de 95% 39.56%–43.85% | — | 1,770/4,240 | 41.75% | 8 |
Falhas do serviço (requisições malsucedidas ou saída truncada) permanecem no denominador e contam como incorretas; não são removidas. Para a Alibaba Cloud, a saída de HLE atingiu o limite de max_tokens e foi truncada 8 vezes.
Cada pergunta BFCL é respondida em 3 rodadas; a tabela mostra as 3 rodadas combinadas.
| Categoria BFCL | Aprovadas | Taxa de aprovação |
|---|---|---|
| simple_python: uma função, chamada e argumentos corretos | 332/360 | 92.22% |
| multiple: escolher a função certa entre várias | 270/300 | 90.00% |
| parallel: chamar a mesma função várias vezes em paralelo | 273/300 | 91.00% |
| parallel_multiple: chamar várias funções diferentes em paralelo | 212/240 | 88.33% |
| irrelevance: nenhuma função é relevante, portanto nenhuma deve ser chamada | 113/150 | 75.33% |
| ahm_multi_turn: cadeia de ferramentas em três etapas | 105/150 | 70.00% |
Comparação com os outros quatro
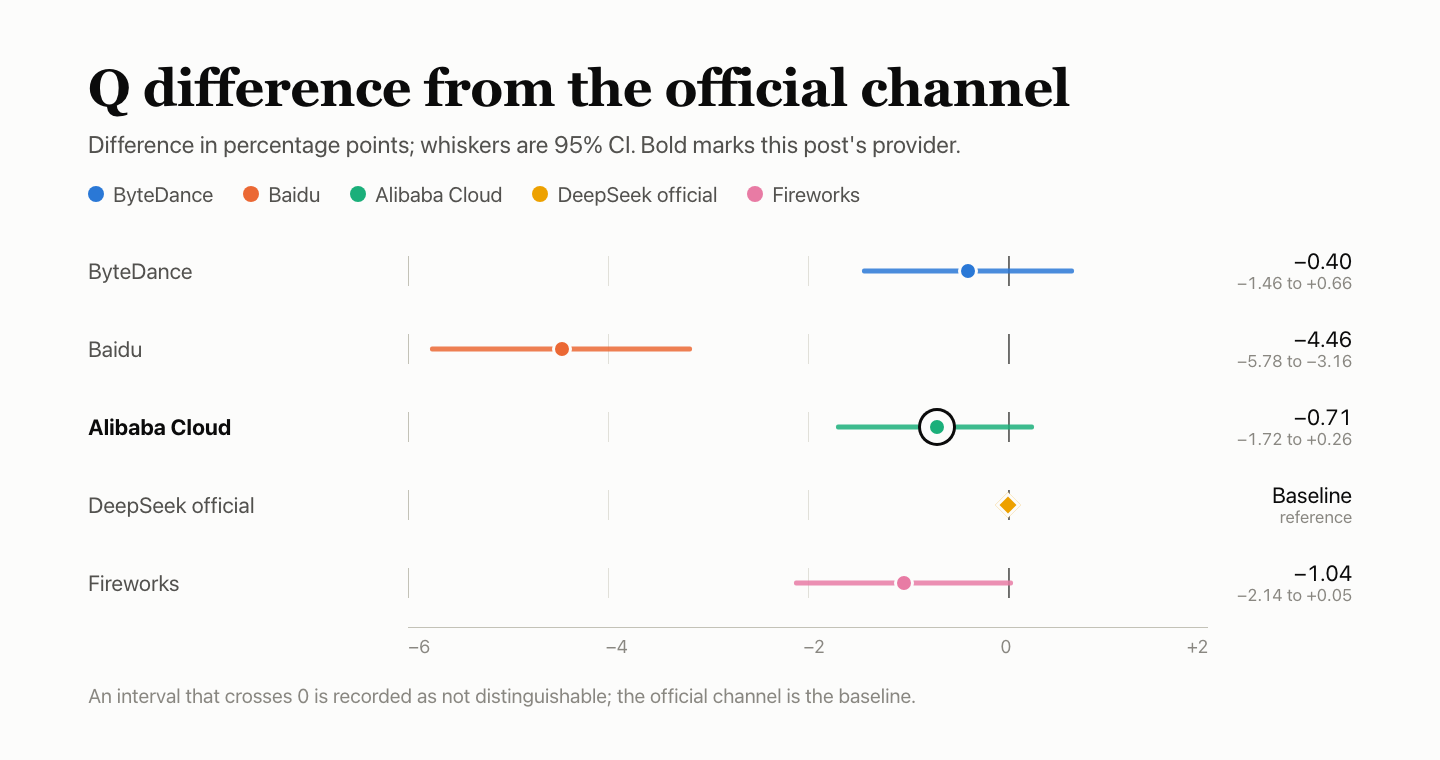
Em relação ao canal oficial: diferença na taxa de acerto, em pontos percentuais, com o intervalo de 95% indicado pelas barras; um intervalo que cruza 0 conta como ausência de distinção. O modelo avaliador deepseek-flash usado em HLE e AA-LCR pertence à mesma família DeepSeek do modelo testado e não foi calibrado, portanto a avaliação pode ser indulgente.
F — suporte a funções: 89.78
Os casos de função verificam se o comportamento da interface segue o protocolo, não se o modelo responde bem. Os 60 casos estão divididos em seis grupos, cada um executado em três janelas, totalizando 180 verificações, avaliadas segundo o formato documentado por cada provedor. Verificações não aplicáveis, inválidas ou não observadas são excluídas do denominador. A Alibaba Cloud aprovou 155 das 177 verificações incluídas no denominador; com os pesos dos grupos, a pontuação é 89.78.
A pontuação ponderada é calculada com os pesos dos grupos, não por uma simples contagem de aprovações entre as 177 verificações.
| Grupo | Peso | Aprovadas | Excluídas | Pontuação do grupo |
|---|---|---|---|---|
| Protocolo de streaming e mensagens | 20% | 30/30 | — | 100.00 |
| Interface de ferramentas | 20% | 30/30 | — | 100.00 |
| Restrições de saída e parâmetros | 20% | 30/30 | — | 100.00 |
| Contexto e estado | 15% | 26/30 | — | 86.67 |
| Erros e recuperação | 15% | 18/30 | — | 60.00 |
| Protocolo de contabilização e cache | 10% | 21/27 | 3 | 77.78 |
| Total · pontuação ponderada | — | 155/177 | 3 | 89.78 |
Uma contagem de janela de 3/3 significa que o caso falhou nas três janelas.
| Caso com falha | Janelas com falha | Motivo |
|---|---|---|
| Estouro de contexto (contexto e estado) | 3/3 | Retornou um erro, mas não o erro de comprimento de contexto documentado |
| Erro de formato de messages (erros e recuperação) | 3/3 | Retornou 400 com o corpo da resposta vazio, sem descrição estruturada do erro |
| Esquema de ferramenta inválido (erros e recuperação) | 3/3 | Deveria retornar um erro de parâmetro; retornou 503 |
| Resultado isolado de ferramenta (erros e recuperação) | 3/3 | Deveria retornar um erro de parâmetro; retornou 200 |
| Erro de formato de stream_options (erros e recuperação) | 3/3 | Retornou 400 com o corpo da resposta vazio, sem descrição estruturada do erro |
| Contabilização de tokens de raciocínio (contabilização e protocolo de cache) | 3/3 | Nenhuma contagem de tokens de raciocínio foi retornada |
| Definições de ferramentas contabilizadas como entrada (contabilização e protocolo de cache) | 3/3 | Com definições de ferramentas, a quantidade de tokens de entrada informada não foi maior do que sem elas |
| Isolamento de requisições (contexto e estado) | 1/3 | A primeira etapa não respondeu apenas STORED, como exigido, portanto não foi possível prosseguir com a verificação de isolamento |
Essas verificações são excluídas do denominador e não contam como aprovação nem como falha.
| Status | Caso | Contagem | Motivo |
|---|---|---|---|
| Não aplicável | Explicit cache_control | 3 | Registrado previamente como não compatível com esta interface |
Os casos de erro de formato de messages e de erro de formato de stream_options falharam para os cinco provedores: cada um retornou 400 com o corpo vazio, então o cliente não recebeu nenhuma descrição estruturada do erro. Como os cinco apresentam o mesmo comportamento, é mais provável que a causa esteja na camada de gateway do AIHubMix e precise ser investigada separadamente. A contabilização de tokens de raciocínio também falhou para os cinco, mas por motivos diferentes: ByteDance e Fireworks informaram tokens de raciocínio mesmo com o pensamento desativado, enquanto os outros três não retornaram a contagem de tokens de raciocínio.
Comparação com os outros quatro
P — velocidade de resposta: 88.58
Cada requisição continha cerca de 10,000 tokens de entrada e solicitava cerca de 1,100 tokens de saída. Em três janelas, foram enviadas 30 requisições com concorrência única e 30 com concorrência de 10, totalizando 180. O tempo até o primeiro token de conteúdo (TTFA) é medido para cada requisição válida, e a tabela apresenta as medianas. O TPOT é estimado a partir dos tempos dos blocos de streaming, não do tempo por token do hardware; o throughput é calculado dividindo os tokens de saída válidos com concorrência de 10 pelo tempo de parede do lote.
| Métrica | Resultado |
|---|---|
| TTFA do primeiro token de conteúdo | Mediana com concorrência única: 1.34 s; mediana com concorrência de 10: 1.35 s |
| Velocidade de geração TPOT | Concorrência única: 4.63 ms/token; concorrência de 10: 4.69 ms/token |
| Throughput efetivo (goodput) | Concorrência de 10: 1,313.6 token/s |
| Requisições válidas | Concorrência única: 90/90; concorrência de 10: 90/90 |
| Pontuações dos componentes | TTFA 59.65, TPOT 100.00, throughput 100.00; TTFA e TPOT usam o menor valor entre os dois níveis, com pesos de 35% / 35% / 30%; pontuação de resposta 85.88 |
| Pontuação P | Pontuação de resposta 85.88 com peso de 80%, cache K 99.37 com peso de 20%, total 88.58 |
Comparação com os outros quatro
Os cinco provedores compartilharam a mesma máquina, rede e conta. As três janelas foram agendadas provedor por provedor, portanto os períodos de coleta não se sobrepõem totalmente e não se deve dar importância excessiva a pequenas diferenças.
K — cache: 99.37
Cada grupo contém cinco requisições: a primeira inclui um prefixo fixo de cerca de 8k ou 32k tokens e preenche o cache; as requisições 2–4 mantêm o prefixo e alteram apenas a pergunta no final, aos 5, 30 e 120 segundos; a quinta usa um prefixo novo como controle frio. Três janelas × dois comprimentos totalizam 30 requisições. K é a quantidade de tokens em cache lidos nas requisições quentes dividida pela quantidade de tokens que deveriam ser reutilizáveis segundo a regra, com cada comprimento recebendo peso igual; K representa 20% de P. A matriz mostra as leituras de tokens em cache informadas pelo servidor.
| Prefixo | Janela | Inicial (requisição 1) | Quente aos 5 s | Quente aos 30 s | Quente aos 120 s | Controle frio (requisição 5) |
|---|---|---|---|---|---|---|
| 8k | Janela 1 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Janela 2 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Janela 3 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 32k | Janela 1 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Janela 2 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Janela 3 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| Prefixo | Acertos quentes | Tokens lidos | Deveriam ser reutilizáveis | Pontuação |
|---|---|---|---|---|
| 8k | 9/9 | 71,424 | 72,270 | 98.83 |
| 32k | 9/9 | 288,000 | 288,279 | 99.90 |
| K (8k e 32k, metade para cada) | 99.37 |
Todas as 9 requisições quentes de 8k tiveram acerto, lendo 7,936 tokens cada; todas as 9 requisições quentes de 32k tiveram acerto, lendo 32,000 tokens cada. A requisição inicial e o controle frio não leram do cache, separando claramente as requisições quentes das frias.
Comparação com os outros quatro
R — estabilidade do serviço: 100
As 300 requisições abrangeram quatro tipos — texto curto, entrada longa de 10k, chamadas de ferramenta e histórico com várias interações — e foram enviadas com concorrência única em três janelas. Apenas a primeira resposta foi verificada, quanto à validade e à completude; a correção da resposta não foi verificada e não houve novas tentativas. As falhas nas seções de qualidade das respostas e velocidade contam em Q e P, respectivamente, e não são contabilizadas novamente em R.
| Tipo de requisição | Sucesso na primeira tentativa |
|---|---|
| Texto curto | 120/120 |
| Entrada longa de 10k | 90/90 |
| Chamadas de ferramenta | 60/60 |
| Histórico com várias interações | 30/30 |
| Total · intervalo de 95% 98.78%–100% | 300/300 |
Todas as 300 solicitações retornaram uma resposta válida e completa na primeira tentativa. R 100 abrange apenas essas 300 solicitações dedicadas e não significa que toda a cadeia não teve falhas. O limite inferior do intervalo de 95% é 98,78%: mesmo com 300/300, a taxa de falhas provavelmente é inferior a 1,22%.
Em comparação com os outros quatro
R abrange apenas essas 300 solicitações dedicadas; as falhas na qualidade e na velocidade das respostas são registradas em Q e P, não sendo contabilizadas novamente em R.
| Provedor | Sucesso na primeira tentativa | Intervalo de 95% |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek oficial | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Perguntas frequentes
A diferença geral de 0.37 entre Alibaba Cloud e o canal oficial é significativa?
Não. Os dois não podem ser distinguidos nesta execução: a diferença em Q é de −0.71 ponto percentual, com um intervalo de 95% de −1.72 a +0.26, que inclui 0, e a pontuação geral é um índice resumido sem intervalo de confiança.
O que a pontuação Q combina?
Três conjuntos: 500 perguntas BFCL × 3 rodadas, avaliadas automaticamente; HLE 250 × 10 e AA-LCR 25 × 10, avaliadas pelo modelo juiz deepseek-flash. A precisão combinada é de 41.75% em 4,240 execuções de perguntas avaliadas.
Por que F é 89.78 quando 155 de 177 verificações foram aprovadas?
A pontuação é ponderada por grupo, não é uma simples proporção de aprovações. Erros e recuperação obtiveram 60.00, e medição e protocolo de cache obtiveram 77.78, enquanto os três grupos de protocolo obtiveram 100.00.
Por que R informa 100 se houve solicitações com falha em outras seções?
R abrange apenas as 300 solicitações dedicadas de estabilidade. As falhas na qualidade e na velocidade das respostas são registradas em Q e P, e não são contabilizadas novamente em R.
K 99.37 é uma taxa de acerto de cache?
É a proporção de tokens em cache lidos em solicitações repetidas em relação aos tokens que deveriam ser reutilizáveis, com os prefixos de 8k e 32k recebendo, cada um, peso de metade. O prefixo de 8k obteve 98.83 e o prefixo de 32k, 99.90.
O primeiro token em 1.34 s significa que a resposta completa chega em 1.34 s?
Não. Esse é o tempo de espera até o primeiro token de conteúdo. Cada solicitação pediu cerca de 1,100 tokens de saída, e o TPOT com concorrência de 10 foi de 4.69 ms por token.
Continue lendo: a série DeepSeek V4.1 Flash
- A pontuação Q combinada do Alibaba Cloud difere da referência oficial em 0.71 ponto percentual, dentro de um intervalo que inclui 0; o perfil da ByteDance dá continuidade à mesma comparação, abordando a medição de chamadas de ferramenta: DeepSeek V4.1 Flash na ByteDance: chamadas de ferramenta correspondem, medição não.
- O Alibaba Cloud retornou válidas todas as 180 solicitações de velocidade; o perfil do Baidu segue o mesmo teste, em que nenhum canal disponível afetou Q e P: DeepSeek V4.1 Flash no Baidu: nenhum canal disponível afeta Q e P.
- O canal oficial é a referência para a comparação da qualidade das respostas neste artigo; seu próprio perfil abrange F 94.00 e 15 sondagens inválidas com concorrência única: DeepSeek V4.1 Flash no canal oficial: F 94.00, 15 sondagens inválidas.
- O Alibaba Cloud acertou 9/9 solicitações repetidas nos dois comprimentos de prefixo; o perfil da Fireworks aborda respostas de parada vazias e 3/9 acertos de cache em 8k: DeepSeek V4.1 Flash na Fireworks: respostas de parada vazias, 3/9 acertos de cache.


