

Em 2026-11-03/04, o DeepSeek V4.1 Flash 1017 foi executado no conjunto completo APB em cinco provedores, todos acessados pelo AIHubMix com as mesmas perguntas, parâmetros e scripts de solicitação. Este perfil APB abrange apenas a Fireworks. O modelo está listado como DeepSeek V4.1 Flash 1017.
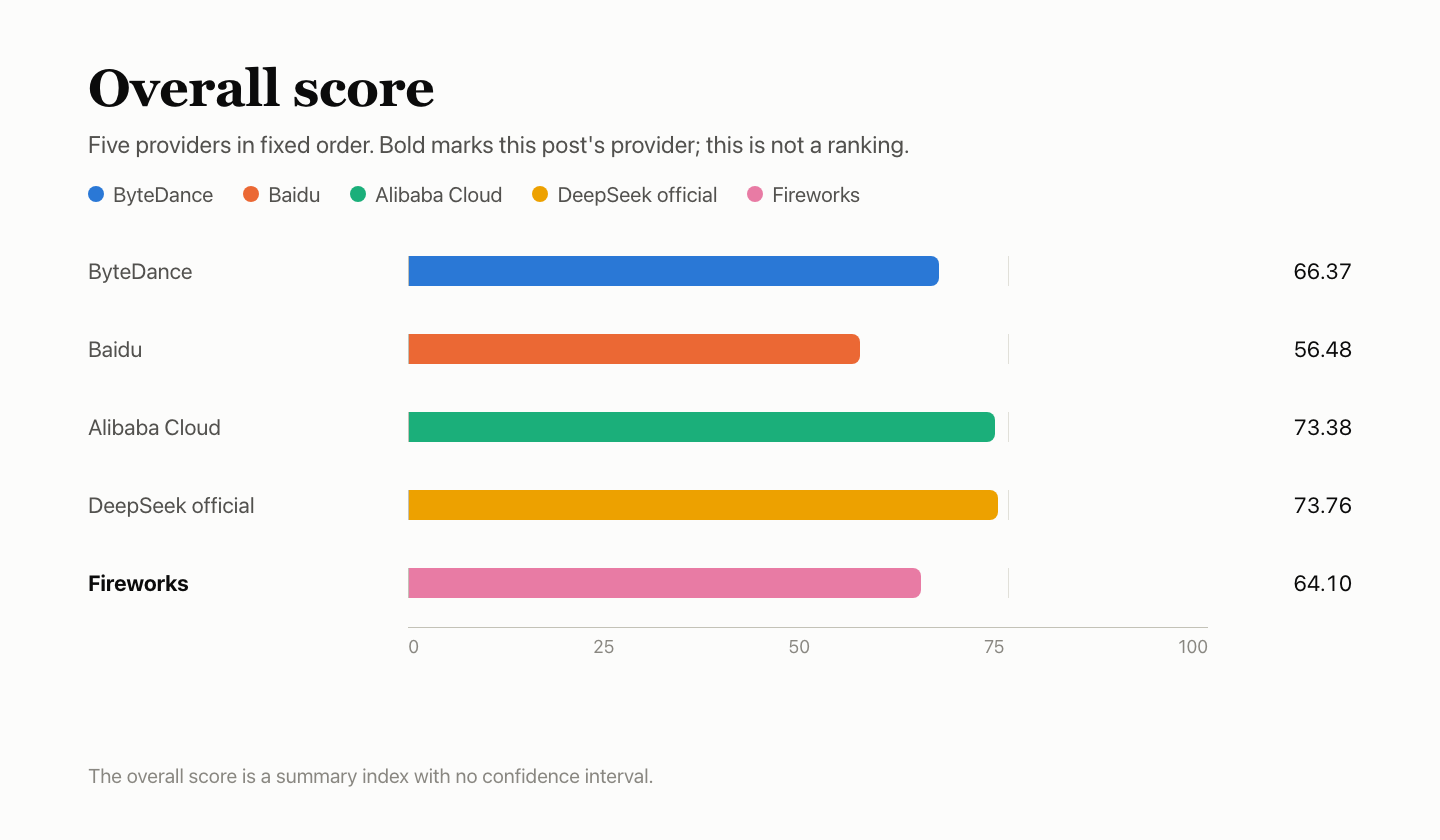
As pontuações são Q 41.42, F 71.78, P 79.51, K 60.68 e R 100; o índice geral é 64.10. Esta publicação apresenta apenas pontuações, sem classificação nem recomendação de provedor. Q, F, P, K e R vêm primeiro; o índice geral é um número de resumo sem intervalo de confiança. O padrão é o AIHubMix Provider Benchmark Standard v2.0.
Pontuações nos cinco provedores
O negrito destaca o provedor desta publicação. Ordem fixa dos provedores, não uma classificação. K é uma subpontuação de P, com peso de 20%. O índice geral é um número de resumo sem intervalo de confiança. A diferença entre o canal oficial do DeepSeek e o Alibaba Cloud é de 0.37 e não é distinguível.
Resumo
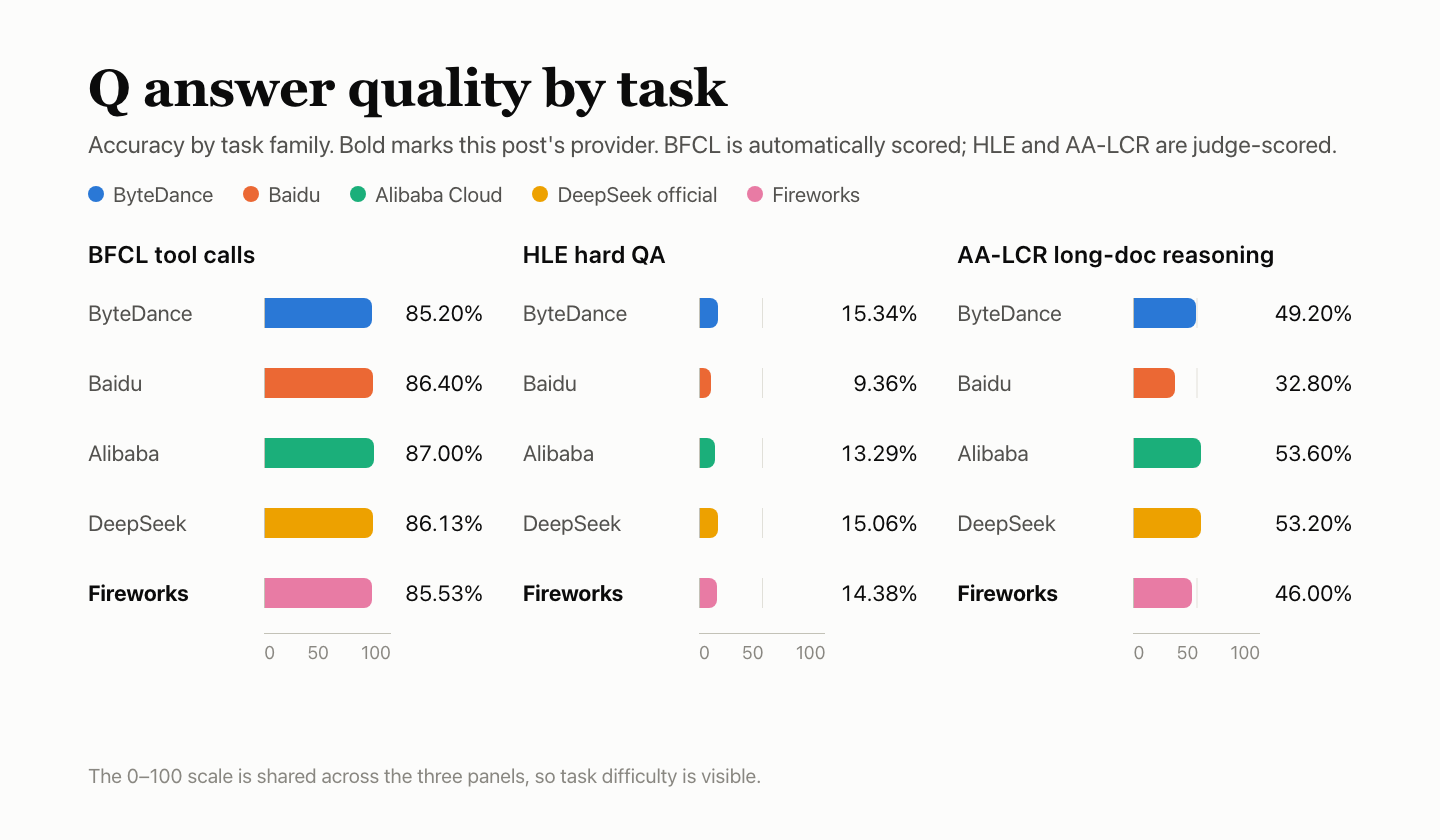
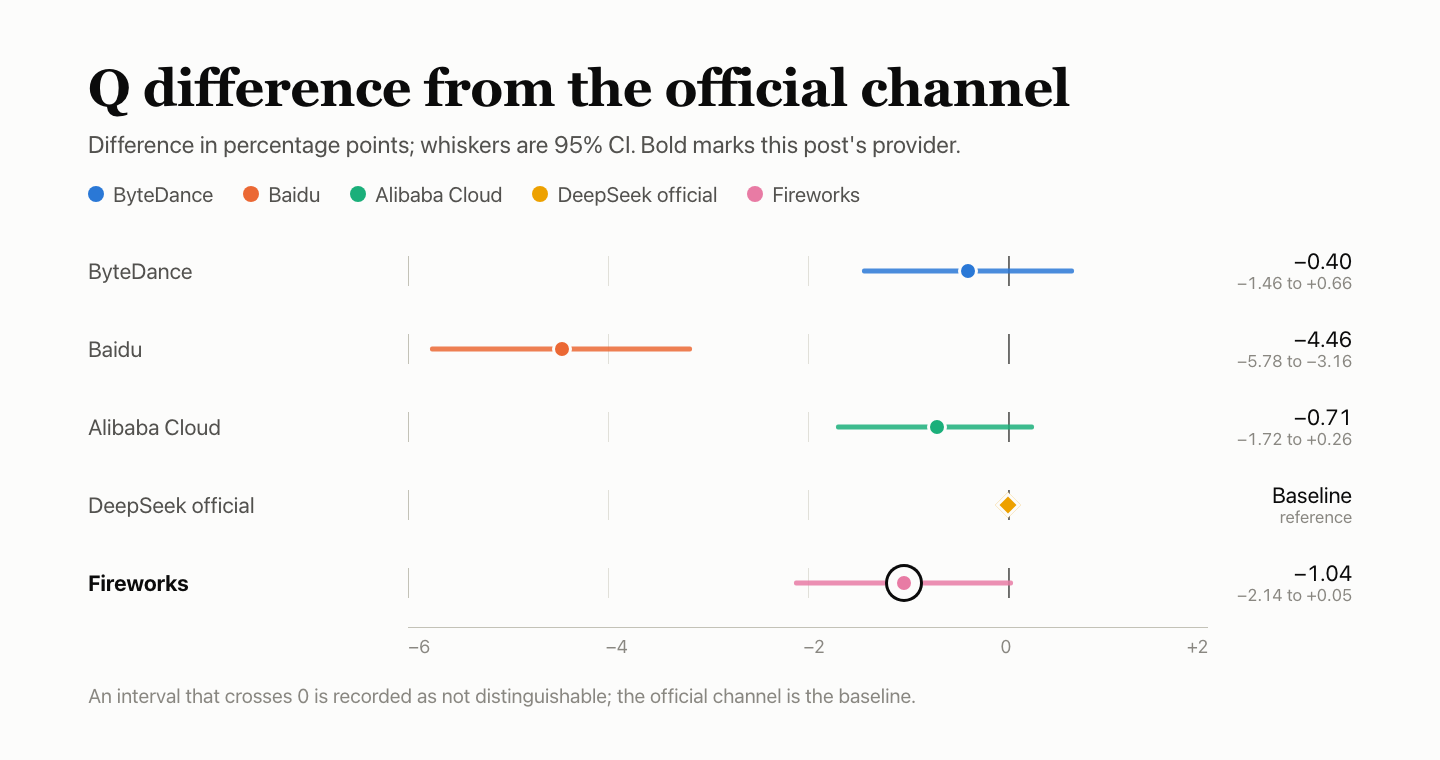
- Q — qualidade das respostas: 41.42. BFCL 85.53%, HLE 14.38%, AA-LCR 46.00%. Em comparação com o canal oficial: −1.04 pontos percentuais, IC de 95% de −2.14 a +0.05, diferença não distinguível. Todas as 34 falhas de AA-LCR ocorreram na janela 2 e foram contabilizadas como incorretas.
- F — suporte funcional: 71.78. 122/177 verificações contabilizadas foram aprovadas. Ambos os casos com stop retornaram um corpo vazio;
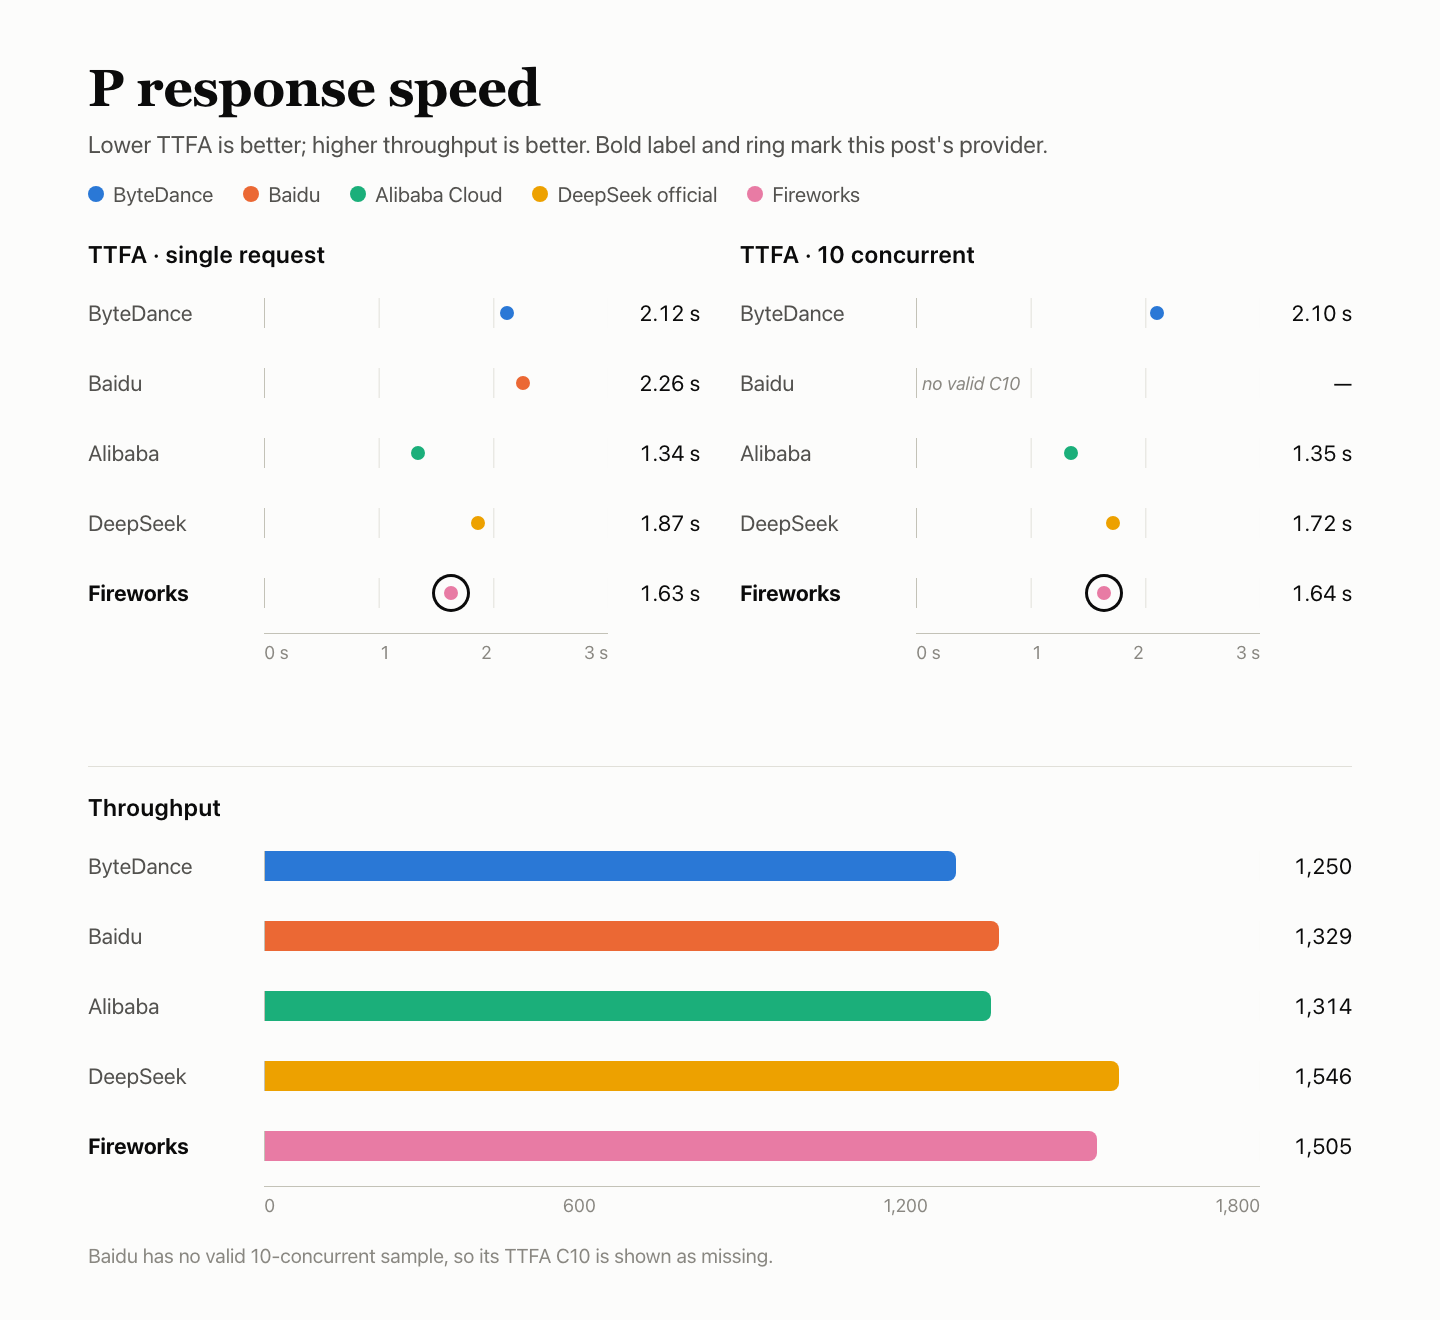
reasoning_effort=nonenão desativou o pensamento; uma entrada de 10k foi reportada como 10,026 tokens, ante uma contagem nativa de 10,000. - P — velocidade de resposta: 79.51. Pontuação de resposta 84.22, cache K com peso de 20%. Mediana de TTFA: 1.63 s com concorrência única, 1.64 s com 10 solicitações simultâneas; TPOT: 3.29 ms. 1 de 180 saídas continha um único token e foi marcada como inválida.
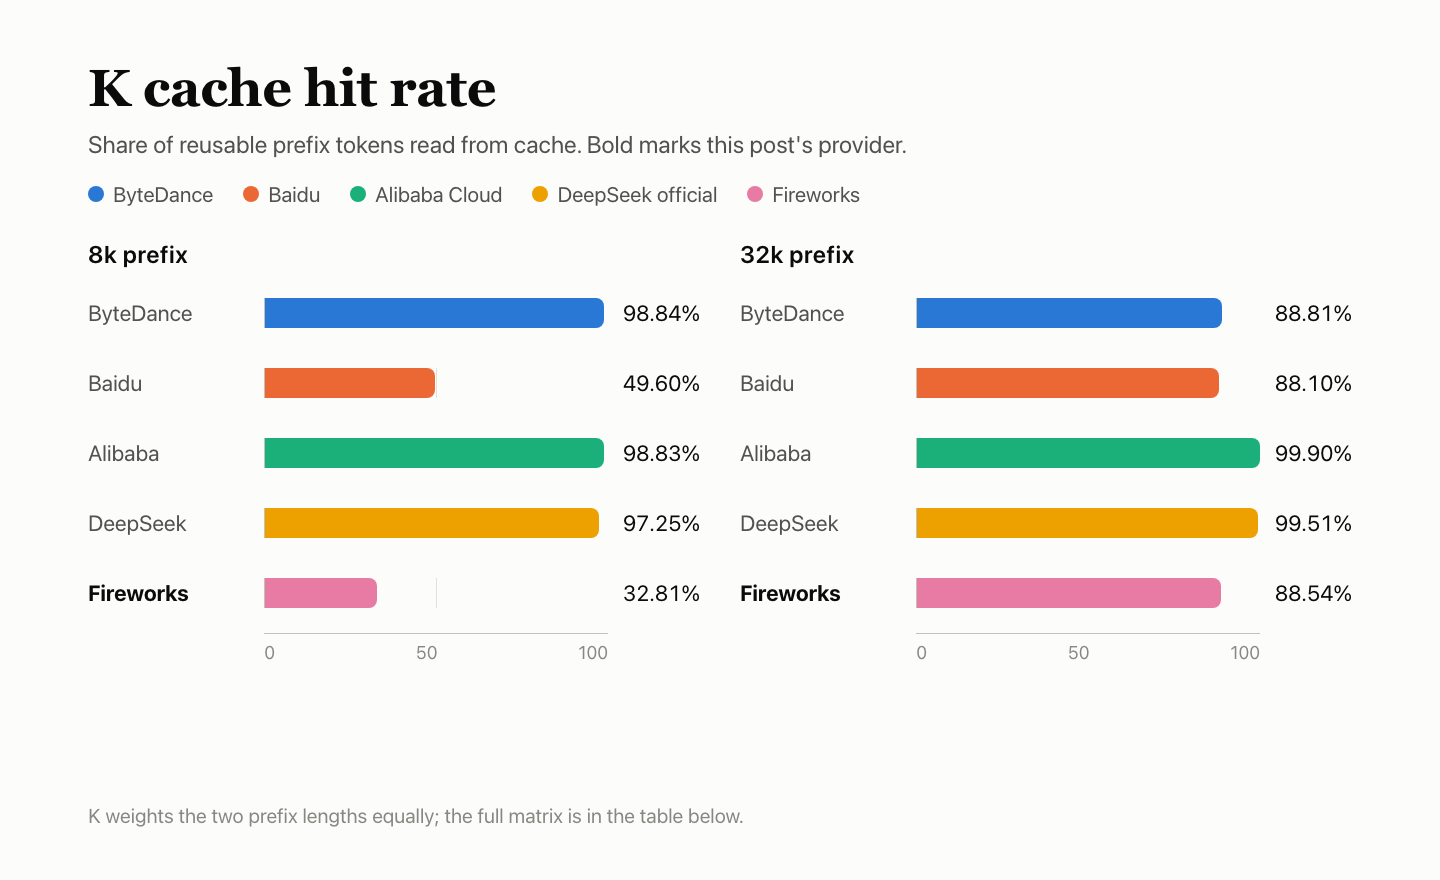
- K — cache: 60.68. As sondagens K usaram a afinidade de sessão documentada. Cache quente de 32k: 8/9; cache quente de 8k: 3/9.
- R — estabilidade do serviço: 100. 300/300 solicitações dedicadas foram concluídas com sucesso na primeira tentativa.
Configuração dos testes
| Item | Configuração |
|---|---|
| Modelo | DeepSeek V4.1 Flash 1017 |
| ID do modelo solicitado | fireworks-deepseek-v4.1-flash-1017 |
| Nome do modelo retornado | accounts/fireworks/models/deepseek-v4p1-flash-1017 |
| Rota de acesso | ID do modelo do provedor no AIHubMix, não a conta própria do provedor |
| Parâmetros | Sem pensamento, temperature 1.0, max_tokens 16,384, timeout 300 s, sem nova tentativa |
| Pensamento desativado | thinking.type=disabled nativo; reasoning_effort=none não desativa o pensamento. Os casos de função mantiveram reasoning_effort=none. |
| Horário | 2026-11-03 18:07 – 11-04 16:33 UTC+8. Um Mac mini, rede e conta para os cinco provedores. |
| Amostras | Q 4,250 (BFCL 500×3, HLE 250×10, AA-LCR 25×10); F 60×3; P 90+90; R 300; K 30 |
| Configurações adicionais | As sondagens K incluíram o campo user documentado e o cabeçalho x-session-affinity para afinidade com a réplica. |
As solicitações usaram o guia de início rápido do AIHubMix; os IDs dos modelos estão na página de modelos. O pensamento foi desativado usando thinking.type=disabled nativo, conforme a documentação da API do modelo.
Q — qualidade das respostas: 41.42
O conjunto executou 500 perguntas BFCL × 3 rodadas, 250 HLE × 10 e 25 AA-LCR × 10. O BFCL recebeu pontuação automática; HLE e AA-LCR foram avaliados por deepseek-flash. Os cinco provedores receberam as mesmas perguntas. Dez respostas impossíveis de pontuar foram removidas, restando 4,240 instâncias pontuadas.
| Tarefa | Perguntas | Corretas | Precisão | Falhas |
|---|---|---|---|---|
| Chamadas de ferramenta BFCL | 500 × 3 | 1,283/1,500 | 85.53% | 2 |
| Perguntas e respostas difíceis do HLE | 250 × 10 | 358/2,490 | 14.38% | 5 |
| Raciocínio sobre documentos longos do AA-LCR | 25 × 10 | 115/250 | 46.00% | 34 |
| Total · IC de 95% 39.13%–43.59% | — | 1,756/4,240 | 41.42% | 41 |
As falhas permanecem no denominador e são consideradas incorretas: 2 no BFCL (janelas 2 e 3), 5 no HLE truncadas em max_tokens, 34 no AA-LCR, todas na janela 2.
| Categoria BFCL | Aprovadas | Taxa de aprovação |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 268/300 | 89.33% |
| parallel | 270/300 | 90.00% |
| parallel_multiple | 206/240 | 85.83% |
| irrelevance | 111/150 | 74.00% |
| ahm_multi_turn | 95/150 | 63.33% |
simple_python teve 333/360 aprovações (92.50%), parallel 270/300 (90.00%), ahm_multi_turn 95/150 (63.33%) e irrelevance 111/150 (74.00%).
Comparação com os outros quatro
Diferença em pontos percentuais em relação ao canal oficial; o intervalo de 95% é indicado pelas barras. Se cruzar 0, a diferença não é distinguível. O avaliador deepseek-flash pertence à mesma família e não foi calibrado, portanto pode ser leniente.
F — suporte funcional: 71.78
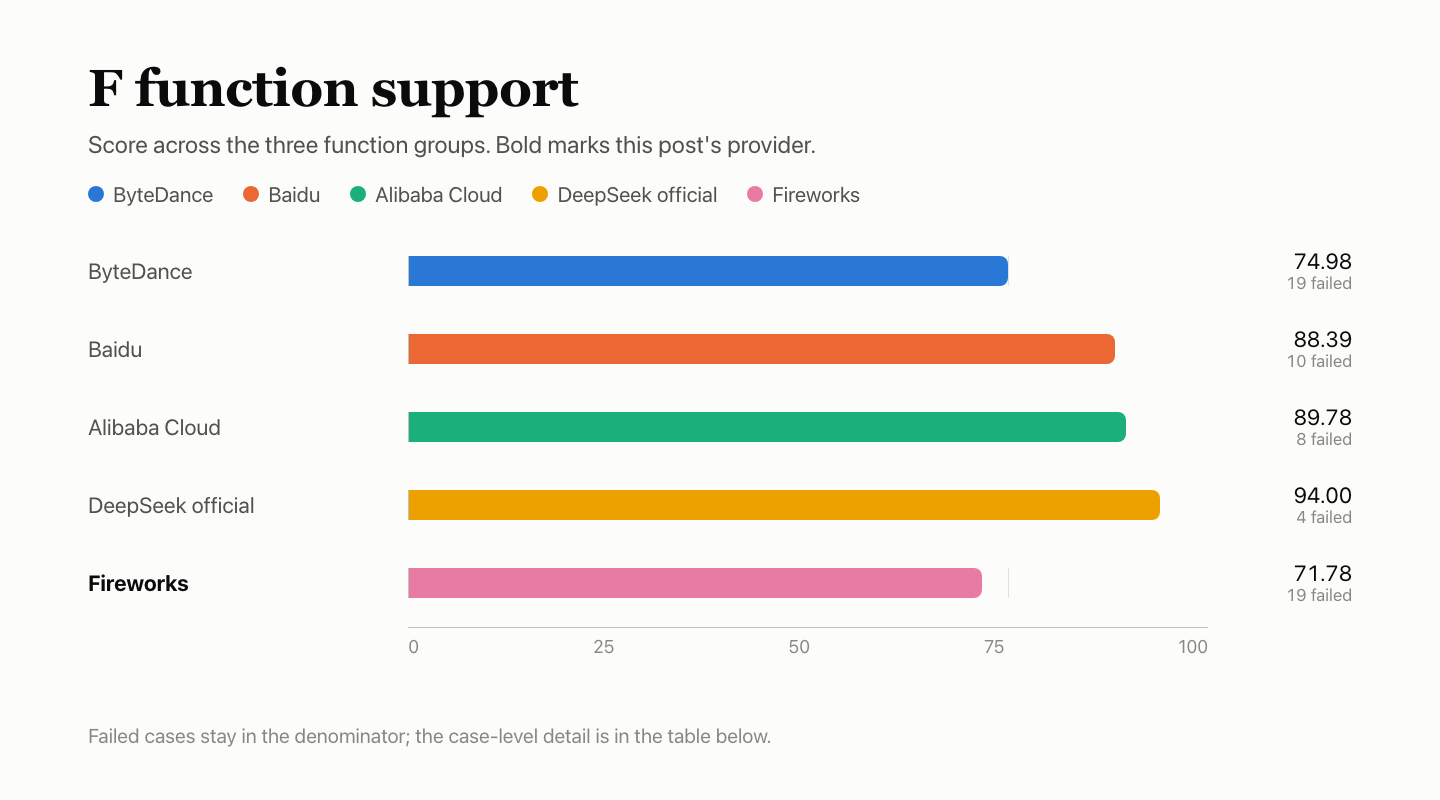
Os 60 casos formam seis grupos, cada um executado em três janelas: 180 verificações avaliadas de acordo com o formato documentado pelo provedor. Verificações não aplicáveis, inválidas e não observadas são excluídas do denominador. 122 das 177 verificações contabilizadas foram aprovadas; a ponderação por grupo resulta em 71.78.
| Grupo de casos | Peso | Aprovadas | Excluídas | Pontuação do grupo |
|---|---|---|---|---|
| Streaming e mensagens | 20% | 24/30 | — | 80.00 |
| Interface de ferramentas | 20% | 29/30 | — | 96.67 |
| Restrições de saída | 20% | 21/30 | — | 70.00 |
| Contexto e estado | 15% | 15/30 | — | 50.00 |
| Erros e recuperação | 15% | 21/30 | — | 70.00 |
| Medição e cache | 10% | 12/27 | 3 | 44.44 |
| Total · ponderado | — | 122/177 | 3 | 71.78 |
“Janelas com falha” contabiliza as três janelas em que o caso não foi aprovado.
| Caso com falha | Janelas com falha | Motivo |
|---|---|---|
| Parada de streaming | 3/3 | Corpo vazio com stop; funciona sem stop. |
| Raciocínio no corpo | 3/3 | reasoning_effort=none ainda retornou raciocínio. |
| Sequência de parada | 3/3 | Corpo vazio com stop; funciona sem stop. |
| Configuração de pensamento | 3/3 | reasoning_effort=none ainda retornou raciocínio. |
| Diversidade de amostragem | 3/3 | Temp 0/1 muito semelhantes |
| Entrada longa de 10k | 3/3 | 10,026 reportados; 10,000 nativos. |
| Dentro do limite de contexto | 3/3 | 10,026 reportados; 10,000 nativos. |
| Entrada longa de 32k | 3/3 | 10,026 reportados; 10,000 nativos. |
| Entrada longa de 100k | 3/3 | 10,026 reportados; 10,000 nativos. |
| Além do contexto | 3/3 | Deveria gerar um erro de parâmetro; retornou 200. |
| Mensagens malformadas | 3/3 | 400, corpo vazio |
| Resultado de ferramenta órfão | 3/3 | Deveria gerar um erro de parâmetro; retornou 200. |
| stream_options malformado | 3/3 | 400, corpo vazio |
| Medição de tokens de pensamento | 3/3 | Tokens de pensamento reportados após a desativação. |
| Contagem nativa de entrada | 3/3 | 34 reportados; 8 nativos. |
| Definições de ferramentas na entrada | 3/3 | O controle sem ferramentas já apresentou divergência. |
| Contagem de entrada entre caches | 3/3 | A contagem do prefixo repetido divergiu da nativa. |
| Concordância da entrada em streaming | 3/3 | 34 reportados; 8 nativos |
| Uma ferramenta por vez | 1/3 | Erro 500 upstream. |
Ambos os casos com stop retornaram um corpo vazio, enquanto a mesma entrada sem stop funcionou, nas três janelas. reasoning_effort=none ainda retornou raciocínio em ambos os casos de pensamento.
As verificações excluídas não contam como aprovação nem como falha.
| Status | Caso | Contagem | Motivo |
|---|---|---|---|
| Não aplicável | cache_control explícito | 3 | Pré-registrado como não compatível com esta interface |
messages e stream_options malformados falharam nos cinco provedores: 400 com corpo vazio e sem erro estruturado. O resultado comum provavelmente está na camada do gateway do AIHubMix e requer investigação à parte. A medição de tokens de pensamento também falhou nos cinco provedores, mas ByteDance e Fireworks reportaram tokens de pensamento após a desativação, enquanto os outros três não retornaram contagem de pensamento.
Comparação com os outros quatro
P — velocidade de resposta: 79.51
Cada solicitação continha cerca de 10,000 tokens de entrada e pedia cerca de 1,100 tokens de saída. Em cada uma das três janelas, foram enviadas 30 solicitações com concorrência única e 30 com concorrência 10, totalizando 180.
| Métrica | Resultado |
|---|---|
| TTFA | 1.63 s com concorrência única; 1.64 s com 10 solicitações simultâneas |
| TPOT | 3.24 ms com concorrência única; 3.29 ms com 10 |
| Goodput | 1,504.5 token/s com 10 |
| Válidas | 90/90 com concorrência única; 89/90 com 10 (29/30 na janela 3), uma saída com um único token |
| Componentes | TTFA 54.91, TPOT 100.00, goodput 100.00; pesos 35/35/30 |
| Composição de P | 84.22 × 80% + 60.68 × 20% = 79.51 |
179 de 180 foram válidas; a solicitação inválida retornou um token e conta como infinito nas medianas, que, por isso, podem ser superiores às das solicitações válidas isoladamente. O TPOT é calculado a partir dos blocos de streaming; o goodput corresponde aos tokens de saída válidos com concorrência 10 divididos pelo tempo total do lote.
Uma máquina, uma rede e uma conta; os provedores definiram os horários das janelas.
K — cache: 60.68
Cada grupo contém cinco solicitações: primeiro, semear um prefixo de 8k ou 32k; depois, usar o mesmo prefixo com uma nova pergunta final após 5 s, 30 s e 120 s; por fim, usar um novo prefixo como controle frio. Três janelas × dois comprimentos = 30. K é a quantidade de tokens lidos do cache quente dividida pelos tokens reutilizáveis; os comprimentos têm pesos iguais; K corresponde a 20% de P.
| Prefixo | Janela | Semeadura | +5 s | +30 s | +120 s | Controle frio |
|---|---|---|---|---|---|---|
| 8k | Janela 1 | 0 | 7,900 | 0 | 7,900 | 0 |
| 8k | Janela 2 | 0 | 7,906 | 0 | 0 | 0 |
| 8k | Janela 3 | 0 | 0 | 0 | 0 | 0 |
| 32k | Janela 1 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | Janela 2 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | Janela 3 | 0 | 31,900 | 31,900 | 0 | 0 |
O prefixo de 8k teve acerto em 3 das 9 requisições frequentes, lendo 23,706 de 72,252 tokens reutilizáveis, para 32.81. O prefixo de 32k teve acerto em 8 das 9, lendo 255,212 de 288,261, para 88.54. K é 60.68, com os dois comprimentos ponderados igualmente. Os controles frios leram 0. Portanto, os dois comprimentos de prefixo se comportaram de maneira diferente sob o mesmo desenho. As sondagens K incluíram o campo user e o cabeçalho x-session-affinity documentados.
R — estabilidade do serviço: 100
300 requisições cobriram texto curto, entrada longa, chamadas de ferramentas e histórico de várias interações, com concorrência única em três janelas. Foram verificadas apenas a validade e a integridade da primeira resposta; as respostas não foram avaliadas e nada foi repetido. As falhas de Q e P não são contabilizadas aqui.
| Tipo de requisição | Sucesso na primeira tentativa |
|---|---|
| Texto curto | 120/120 |
| Entrada longa de 10k | 90/90 |
| Chamada de ferramenta | 60/60 |
| Histórico de várias interações | 30/30 |
| Total · IC de 95%: 98.78%–100% | 300/300 |
As 300 requisições retornaram uma resposta válida e completa na primeira tentativa. Com 300 sucessos, o limite inferior de 95% é 98.78%, portanto os dados só sustentam uma taxa de falhas abaixo de 1.22%. R 100 cobre essas 300 requisições, não o caminho inteiro.
| Provedor | Sucesso na primeira tentativa | Intervalo de 95% |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek oficial | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Perguntas frequentes
O que abrange Q 41.42?
BFCL, HLE e AA-LCR em 4,240 instâncias avaliadas: 1,756 corretas, 41.42%, IC de 95% de 39.13%–43.59%; não é possível distinguir a diferença em relação ao canal oficial.
Por que os dois casos com stop falharam?
Uma requisição com stop retornou um corpo vazio nas três janelas, enquanto a mesma entrada funcionou sem stop. Isso ocorreu tanto nos casos de streaming quanto nos que não usaram streaming.
reasoning_effort=none desativa o modo de pensamento?
Não. Ainda retornou conteúdo de raciocínio nas três janelas; outras requisições usaram thinking.type=disabled nativo.
Por que uma entrada de 10k é informada como 10,026 tokens?
O caso de 10k informou 10,026, embora o valor nativo fosse 10,000. Os casos de 32k e 100k informaram o mesmo valor, 10,026, e um controle sem ferramentas já apresentou divergência.
Por que 8k teve acerto em 3/9, enquanto 32k teve em 8/9?
Ambos usaram o mesmo desenho e as configurações de afinidade documentadas. A diferença está nas leituras informadas pelo servidor: 8k teve acerto nas janelas 1 e 2, e 32k, nas três.
O que abrange R 100?
300 requisições dedicadas, todas válidas na primeira tentativa; o limite inferior de 95% é 98.78%. As falhas de Q e P não são contabilizadas em R.
Continue lendo: a série DeepSeek V4.1 Flash
- A ByteDance informou tokens de pensamento mesmo depois que o modo de pensamento foi desativado, assim como a Fireworks: DeepSeek V4.1 Flash na ByteDance: chamadas de ferramentas correspondem, mas a contabilização não
- A Baidu registrou Q 38.00 e P 37.77: DeepSeek V4.1 Flash na Baidu: nenhum canal disponível atinge Q e P
- A Alibaba Cloud registrou 1.34 s até o primeiro token e cache de 99.37: DeepSeek V4.1 Flash na Alibaba Cloud: 1.34s até o primeiro token, cache de 99.37
- O canal oficial é a referência para Q, com F 94.00: DeepSeek V4.1 Flash no canal oficial: F 94.00, 15 sondagens inválidas


