

Em 2026-11-03/04, DeepSeek V4.1 Flash 1017 foi testado em cinco provedores pelo AIHubMix com o conjunto APB Full: as mesmas perguntas, os mesmos parâmetros e os mesmos scripts de requisição em todas as execuções. Este Perfil APB cobre apenas a execução na Baidu, seção por seção.
Os números abaixo são apenas pontuações, não um ranking nem uma recomendação de provedor. Q 38.00, F 88.39, P 37.77, K 68.85 e R 100 vêm primeiro; o resultado geral, 56.48, é um índice-resumo sem intervalo de confiança. As regras de pontuação são as do AIHubMix Provider Benchmark Standard v2.0.
Pontuações dos cinco provedores
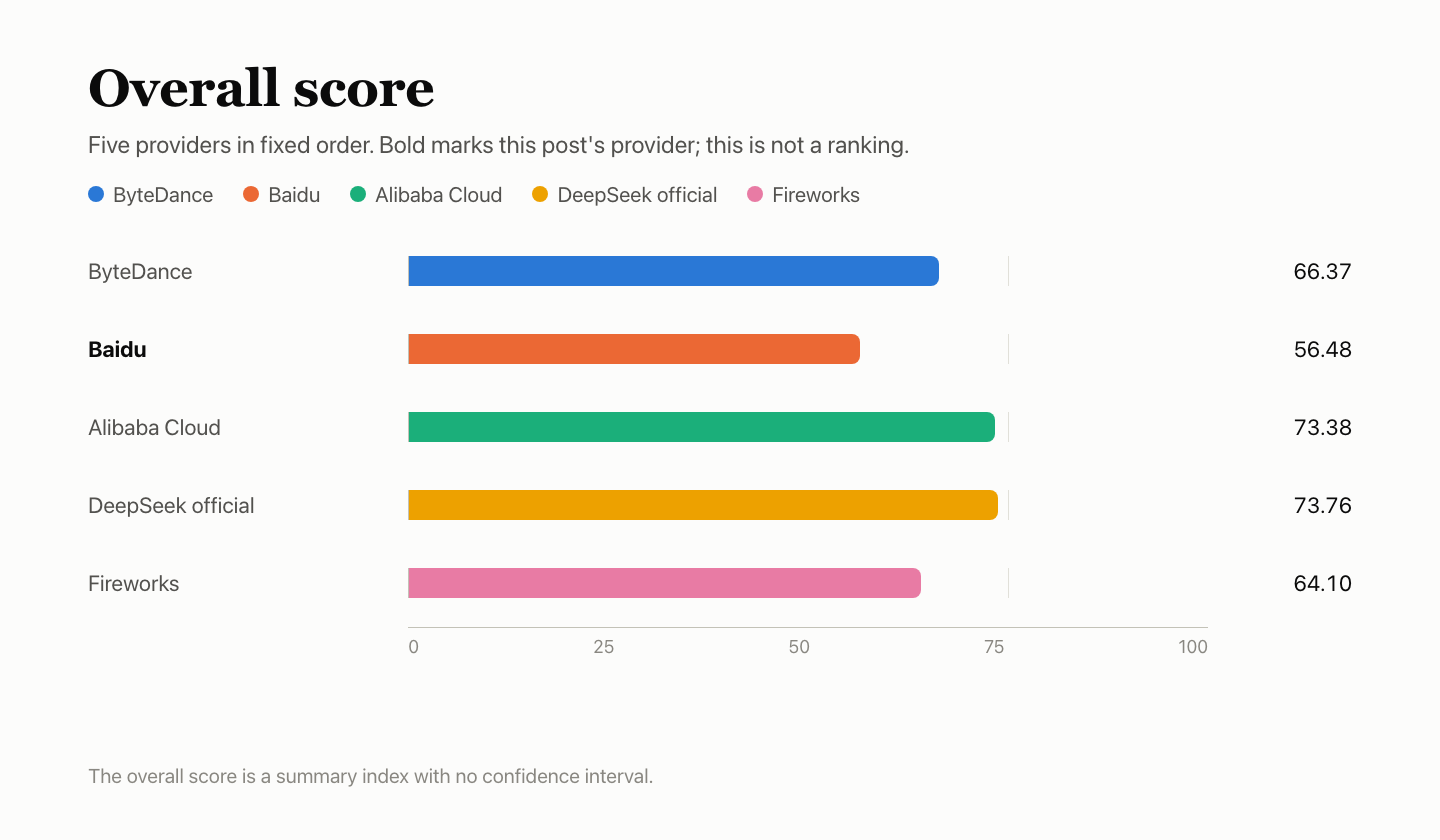
O negrito destaca o provedor deste artigo. Os provedores estão listados em uma ordem fixa, não em um ranking. K é uma subpontuação de P, com peso de 20%. O resultado geral é um índice-resumo sem intervalo de confiança. O canal oficial e a Alibaba Cloud diferem em 0.37, diferença que não é estatisticamente distinguível.
Resumo
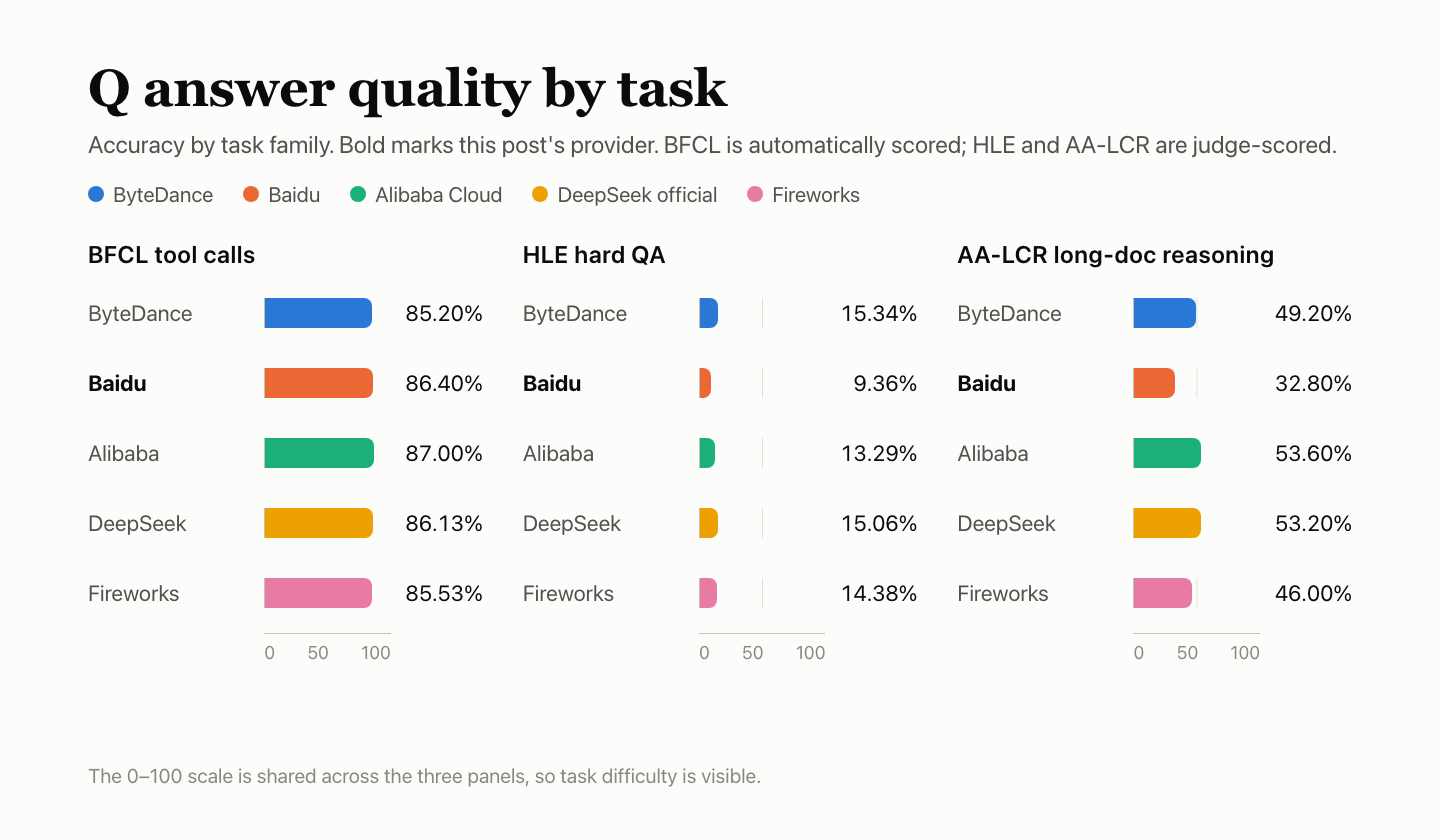
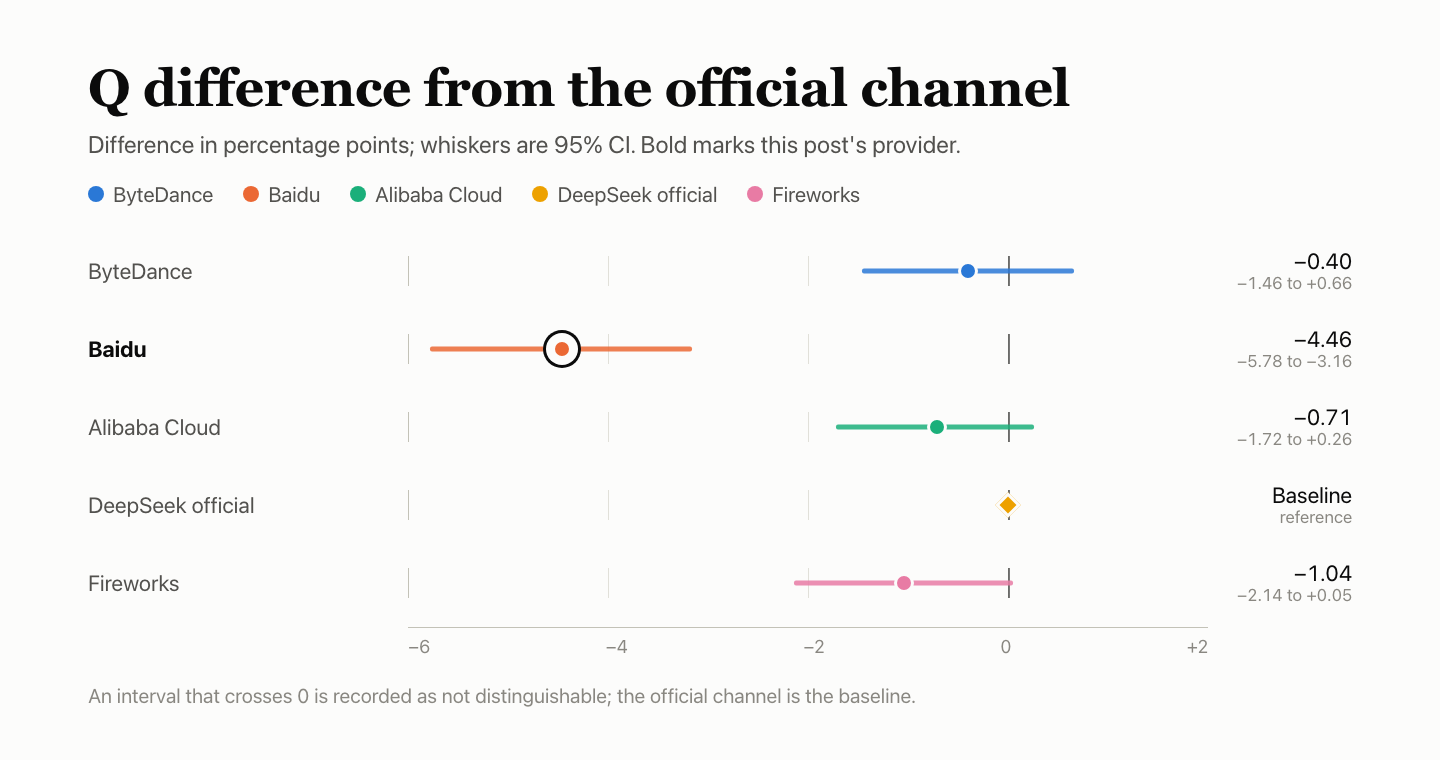
- Q: 38.00. BFCL 86.40%, HLE 9.36%, AA-LCR 32.80%. O resultado combinado fica 4.46 pontos abaixo do canal oficial, com um intervalo de 95% de −5.78 a −3.16, que não inclui 0. HLE registrou 864 falhas de requisição e AA-LCR, 100, quase todas na primeira janela, contabilizadas como respostas incorretas.
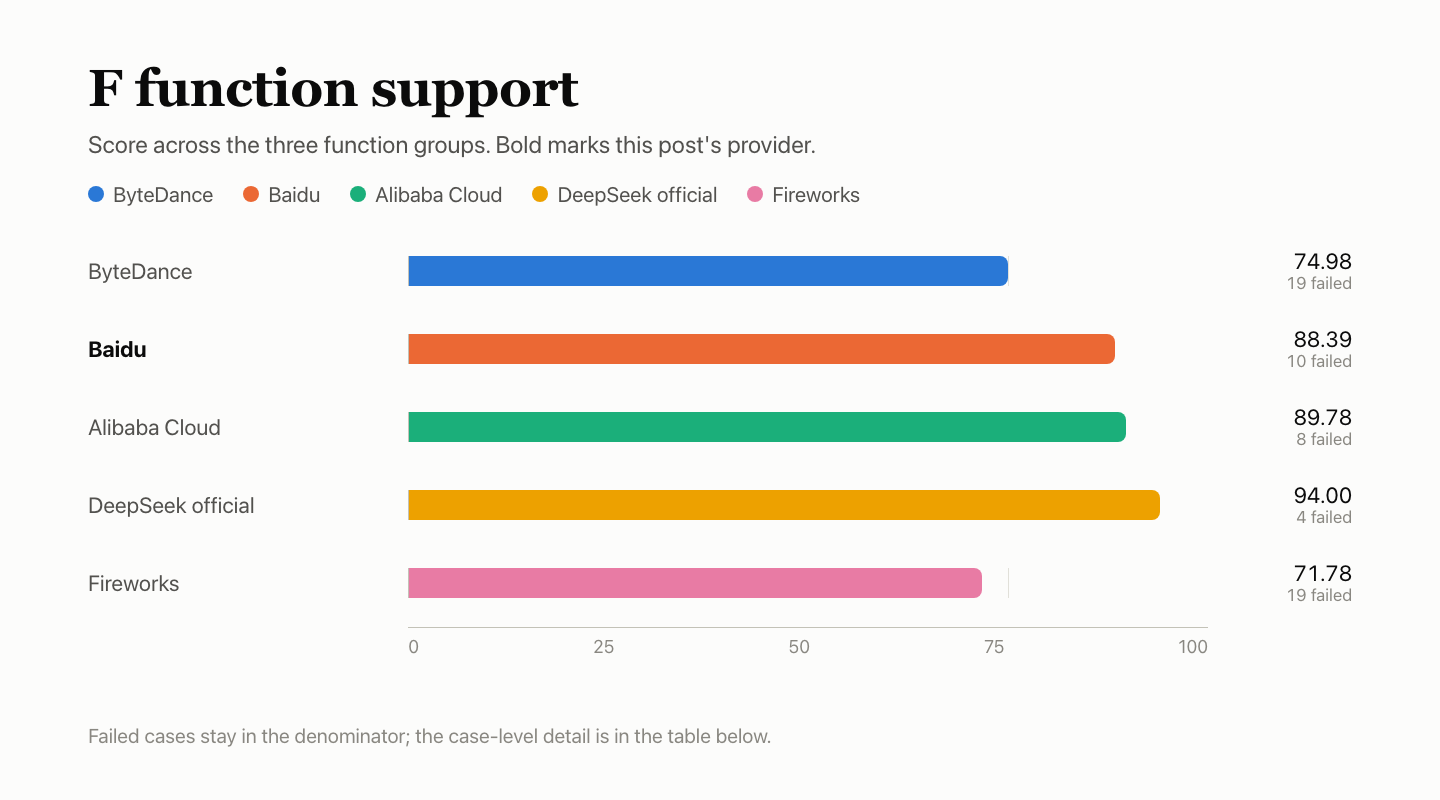
- F: 88.39. 148 de 174 verificações contabilizadas foram aprovadas. O campo de leitura do cache e a contagem de tokens de pensamento não foram retornados; os casos de contexto excedido e resultado de ferramenta órfão retornaram 200.
- P: 37.77. 50 das 90 sondagens com dez requisições concorrentes retornaram
no_available_channel, portanto mais da metade foi inválida e TTFA e TPOT receberam suas pontuações de penalidade. As sondagens com concorrência única foram válidas em 78 das 90 vezes. - K: 68.85. As requisições quentes de 8k tiveram acerto em 5 de 9 tentativas, com 3 falhas de requisição; o prefixo de 32k teve acerto em 8 de 9. Os acertos são informados em blocos de 1,024 tokens: 7,168 tokens para 8k e 31,744 para 32k.
- R: 100. Todas as 300 requisições dedicadas foram concluídas na primeira tentativa. Falhas de canal durante as sondagens de resposta e velocidade são contabilizadas em Q e P.
Configuração do teste
As requisições usaram a rota início rápido do AIHubMix com um ID específico do provedor, e os parâmetros seguem a documentação da API da DeepSeek; os IDs dos outros provedores estão listados na página de modelos. Esta não é uma conexão direta com a própria conta da Baidu.
| Campo | Valor |
|---|---|
| Modelo | DeepSeek V4.1 Flash 1017 |
| ID do modelo solicitado | baidu-deepseek-v4.1-flash-1017 |
| Nome do modelo retornado | deepseek-v4.1-flash-1017 |
| Rota de acesso | Via AIHubMix com o ID do modelo específico do provedor; não é uma conexão direta com a própria conta do provedor |
| Parâmetros | Modo sem pensamento, temperature 1.0, max_tokens 16,384, timeout 300 s, sem novas tentativas automáticas |
| Modo de pensamento desativado | Todas as requisições usaram reasoning_effort=none |
| Horário | 2026-11-03 18:07 – 11-04 16:33 UTC+8; os cinco provedores compartilharam o mesmo Mac mini, a mesma rede e a mesma conta |
| Amostras | 4,250 tentativas de resposta (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10); 60 casos de função × 3 janelas; 90 sondagens de velocidade com concorrência única e 90 com dez requisições concorrentes; 300 requisições de estabilidade; 30 sondagens de cache (três grupos para cada prefixo de 8k e 32k) |
Q — qualidade das respostas: 38.00
A qualidade das respostas é avaliada com três tipos de tarefa: 500 tarefas BFCL respondidas três vezes cada, 250 tarefas HLE respondidas dez vezes cada e 25 tarefas AA-LCR respondidas dez vezes cada. A pontuação do BFCL segue regras automáticas; no HLE e no AA-LCR, o modelo avaliador deepseek-flash julga as respostas como corretas ou incorretas. Os cinco provedores receberam o mesmo conjunto de tarefas, e os três tipos são combinados em um único índice de acurácia. Dez respostas foram removidas porque não foi possível avaliar a tarefa, restando 4,240 tentativas pontuadas.
| Tarefa | Itens | Corretas | Acurácia | Falhas |
|---|---|---|---|---|
| Chamadas de ferramenta BFCL | 500 × 3 | 1,296/1,500 | 86.40% | 0 |
| Perguntas difíceis HLE, avaliadas pelo modelo avaliador | 250 × 10 | 233/2,490 | 9.36% | 875 |
| Raciocínio sobre documentos longos AA-LCR | 25 × 10 | 82/250 | 32.80% | 100 |
| Combinado · intervalo de 95%: 36.23%–39.58% | — | 1,611/4,240 | 38.00% | 975 |
Falhas de serviço, sejam requisições malsucedidas ou saídas truncadas, permanecem no denominador e contam como respostas incorretas. O HLE teve 864 falhas de requisição (863 na primeira janela, 1 na segunda) e 11 saídas truncadas no limite de max_tokens. O AA-LCR teve 100 falhas de requisição, todas na primeira janela.
Cada tarefa BFCL é respondida três vezes; a tabela mostra as três rodadas combinadas.
| Categoria BFCL | Aprovadas | Taxa de aprovação |
|---|---|---|
| simple_python: uma função, chamada e argumentos corretos | 336/360 | 93.33% |
| multiple: escolher a função correta entre várias | 269/300 | 89.67% |
| parallel: chamar uma função várias vezes em paralelo | 268/300 | 89.33% |
| parallel_multiple: chamar várias funções diferentes em paralelo | 206/240 | 85.83% |
| irrelevance: nenhuma função é aplicável; não chamar nenhuma | 113/150 | 75.33% |
| ahm_multi_turn: cadeia de ferramentas em três etapas | 104/150 | 69.33% |
Comparação com os outros quatro
A diferença é expressa em pontos percentuais em relação ao canal oficial, com o intervalo de 95% indicado pelas barras. Um intervalo que cruza 0 é considerado indistinguível. O modelo avaliador do HLE e do AA-LCR, deepseek-flash, pertence à mesma família DeepSeek do modelo testado e não foi calibrado, portanto seus julgamentos podem ser lenientes.
F — suporte a funções: 88.39
Os casos de função testam se a interface se comporta conforme as especificações do protocolo, não se o modelo responde bem. Sessenta casos, divididos em seis grupos, foram executados uma vez em cada uma das três janelas, totalizando 180 verificações, avaliadas de acordo com o formato documentado pelo provedor. Verificações não aplicáveis, inválidas ou não observadas são excluídas do denominador. A Baidu teve 174 verificações contabilizadas e aprovou 148, alcançando uma pontuação ponderada de 88.39.
A pontuação dos grupos é ponderada pela participação de cada grupo, não calculada como uma simples proporção de 148/174.
| Grupo de casos | Peso | Aprovadas | Excluídas | Pontuação do grupo |
|---|---|---|---|---|
| Streaming e protocolo de mensagens | 20% | 27/27 | 3 | 100.00 |
| Interface de ferramentas | 20% | 30/30 | — | 100.00 |
| Restrições de saída e parâmetros | 20% | 29/30 | — | 96.67 |
| Contexto e estado | 15% | 26/30 | — | 86.67 |
| Erro e recuperação | 15% | 21/30 | — | 70.00 |
| Protocolo de medição e cache | 10% | 15/27 | 3 | 55.56 |
| Total ponderado | 100% | 148/174 | 6 | 88.39 |
| Caso reprovado | Janelas com falha | Motivo |
|---|---|---|
| Contexto excedido (contexto e estado) | 3/3 | Deveria retornar um erro de parâmetro; retornou 200 |
| Mensagens malformadas (erro e recuperação) | 3/3 | Retornou 400 com o corpo vazio, sem erro estruturado |
| Resultado de ferramenta órfão (erro e recuperação) | 3/3 | Deveria retornar um erro de parâmetro; retornou 200 |
| stream_options malformado (erro e recuperação) | 3/3 | Retornou 400 com o corpo vazio, sem erro estruturado |
| Campo de leitura do cache (medição e protocolo de cache) | 3/3 | Nenhum campo de leitura do cache foi retornado; não é possível confirmar a leitura |
| Medição de tokens de pensamento (medição e protocolo de cache) | 3/3 | Nenhuma contagem de tokens de pensamento foi retornada |
| Definições de ferramentas contabilizadas como entrada (medição e protocolo de cache) | 3/3 | Com as definições de ferramentas, o número de tokens de entrada informado não foi maior do que sem elas |
| Contagem de entrada consistente antes e depois do cache (medição e protocolo de cache) | 3/3 | Nenhum campo de leitura do cache foi retornado; não é possível confirmar a leitura |
| Diversidade de amostragem (restrições de saída e parâmetros) | 1/3 | As saídas repetidas com temperatura 0 e 1 diferiram pouco demais, abaixo do padrão pré-registrado |
| Isolamento entre requisições (contexto e estado) | 1/3 | A primeira etapa não respondeu apenas STORED, conforme exigido, então não foi possível prosseguir com a verificação de isolamento |
Essas verificações são excluídas do denominador: não foram aprovadas nem reprovadas.
| Status | Caso | Contagem | Motivo |
|---|---|---|---|
| Não observado | Sequência de parada do streaming | 3 | A requisição desta etapa não foi enviada após a etapa anterior, portanto não é possível avaliá-la |
| Não aplicável | cache_control explícito | 3 | Pré-registrado como não compatível com esta interface |
Os casos de messages malformado e stream_options malformado falharam nos cinco provedores: ambos retornaram 400 com o corpo vazio, sem fornecer um erro estruturado ao cliente. Uma falha compartilhada pelos cinco provavelmente está na camada de gateway do AIHubMix e requer investigação separada. A medição de tokens de pensamento também falhou nos cinco provedores, por motivos diferentes: ByteDance e Fireworks informaram tokens de pensamento mesmo com o modo de pensamento desativado, enquanto os outros três não retornaram a contagem de tokens de pensamento.
Comparação com os outros quatro
P — velocidade de resposta: 37.77
Cada requisição tinha cerca de 10,000 tokens de entrada e solicitava um corpo com cerca de 1,100 tokens de saída. Em cada uma das três janelas, foram enviadas 30 sondagens com concorrência única e 30 com dez requisições concorrentes, totalizando 180 requisições.
| Métrica | Resultado |
|---|---|
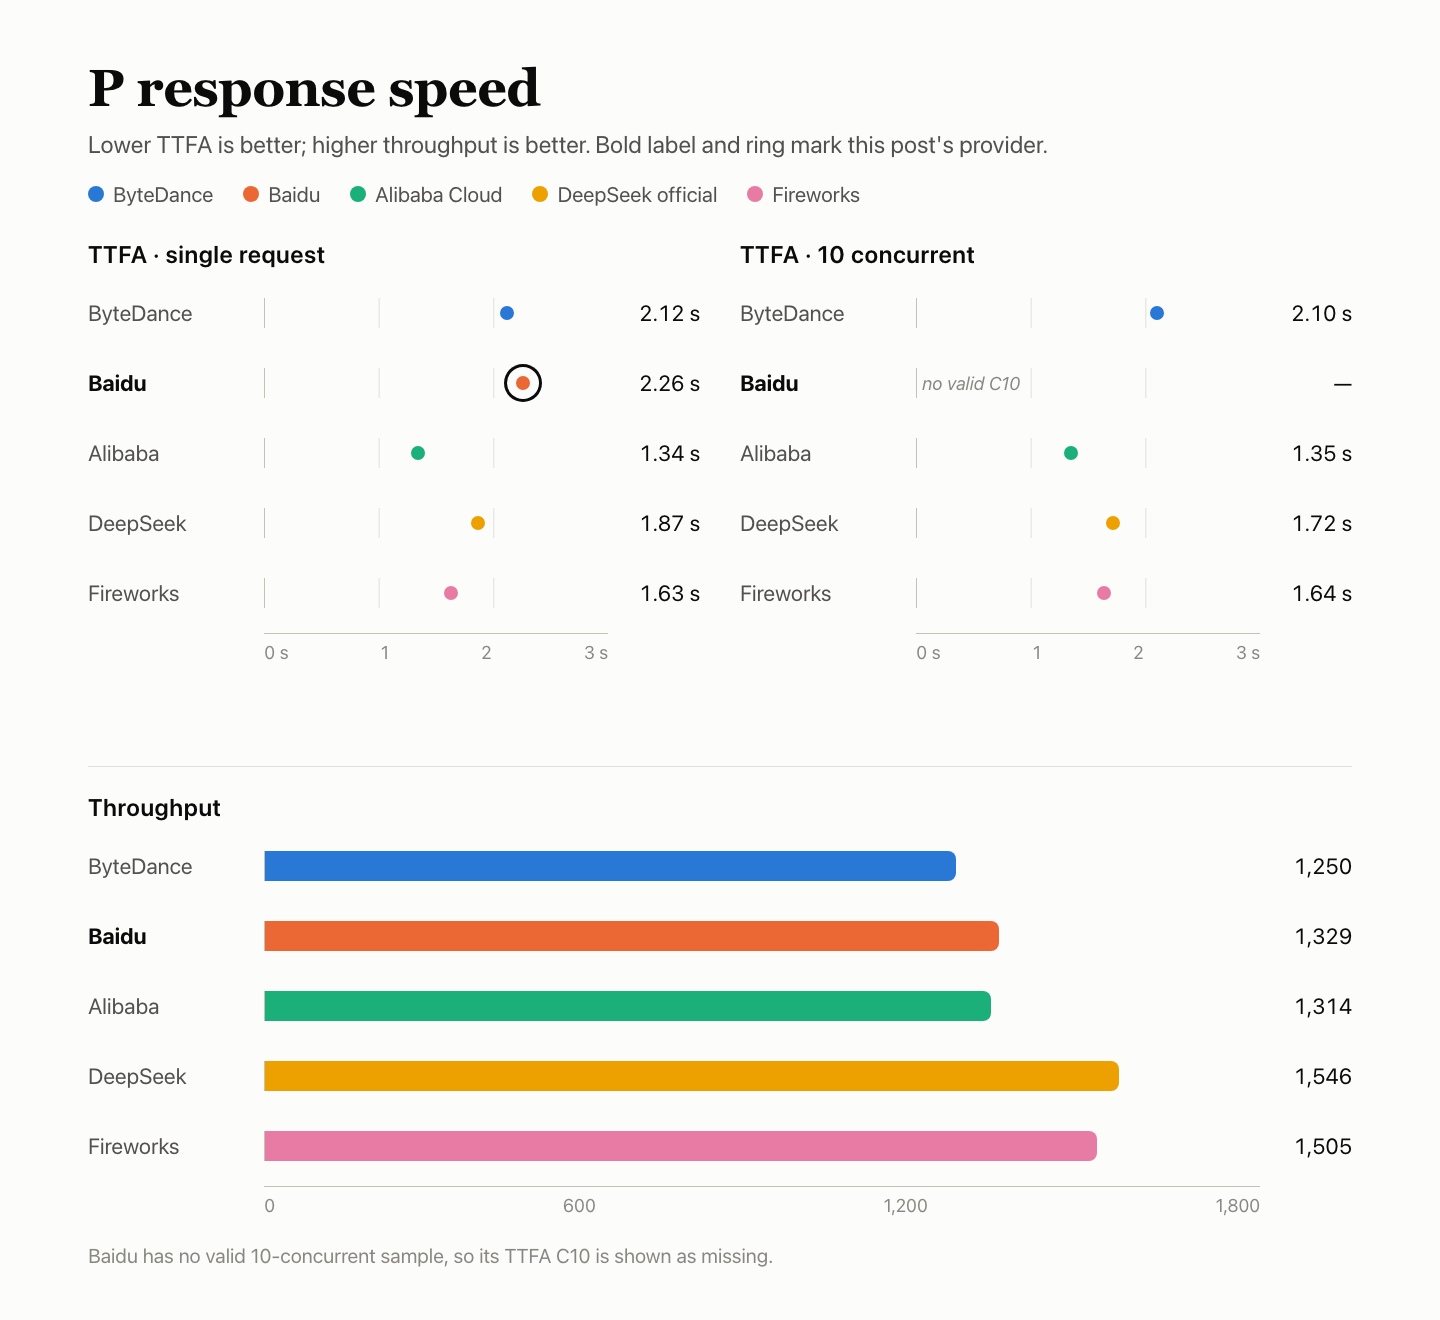
| TTFA do primeiro token | Mediana com concorrência única: 2.26 s (mediana das requisições válidas: 2.05 s); com dez requisições concorrentes, mais da metade foi inválida e a mediana contabilizada foi infinita (mediana das requisições válidas: 1.86 s) |
| Velocidade de geração TPOT | Concorrência única: 3.48 ms/token; dez requisições concorrentes: 50.00 ms/token (mais da metade inválida, valor de penalidade) |
| Goodput (vazão válida) | Dez requisições concorrentes: 1,329.2 token/s |
| Requisições válidas | Concorrência única: 78/90 (primeira janela: 18/30); dez requisições concorrentes: 40/90 (primeira janela: 0/30, terceira janela: 10/30) |
| Motivo da invalidez | 62 sondagens retornaram 400 no_available_channel |
| Pontuação por componente | TTFA 0.00, TPOT 0.00, vazão 100.00; pontuação de resposta 30.00 |
| Composição de P | Pontuação de resposta 30.00 com peso de 80%, cache K 68.85 com peso de 20%, total 37.77 |
O TPOT é estimado com base nos fragmentos transmitidos por streaming, não medido por token no hardware. O goodput corresponde aos tokens de saída válidos com dez requisições concorrentes, divididos pelo tempo total de parede do lote.
No nível de dez requisições concorrentes, 50 das 90 sondagens retornaram no_available_channel. Como mais da metade era inválida, o tempo mediano até o primeiro token é considerado infinito, e tanto TTFA quanto TPOT recebem seus valores de penalidade. O nível de concorrência única manteve 78 das 90 sondagens válidas.
Os cinco provedores compartilharam a mesma máquina, rede e conta. As três janelas foram agendadas provedor por provedor, então os períodos de coleta não se sobrepõem totalmente; não se deve dar importância excessiva a pequenas diferenças.
K — cache: 68.85
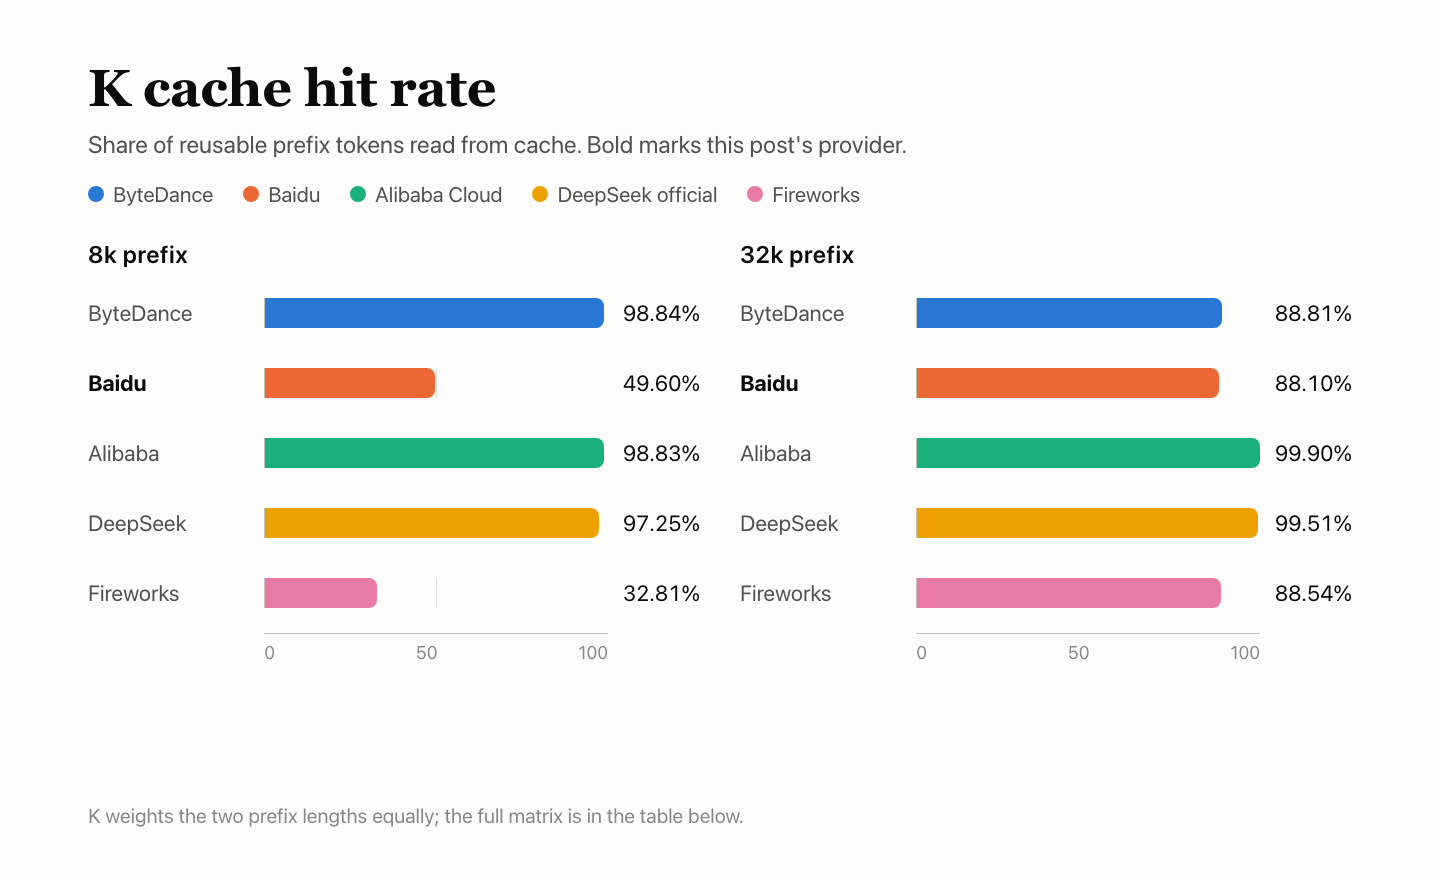
Cada grupo envia cinco requisições. A primeira inclui um prefixo fixo de cerca de 8k ou 32k tokens e alimenta o cache. As requisições 2–4 mantêm o prefixo e alteram apenas a pergunta no final, com intervalos de 5 s, 30 s e 120 s. A quinta usa um prefixo novo como controle frio. Três janelas × dois comprimentos totalizam 30 requisições. K corresponde aos tokens de cache lidos pelas requisições quentes divididos pelos tokens que deveriam poder ser reutilizados segundo as regras, com peso igual para cada comprimento. K representa 20% de P.
A tabela mostra a contagem de tokens lidos do cache informada pelo servidor; “não retornado” significa que o campo estava ausente na resposta.
| Prefixo | Janela | Semente | +5 s | +30 s | +120 s | Controle frio |
|---|---|---|---|---|---|---|
| 8k | 1 | Falhou | Falhou | Falhou | Não retornado | Não retornado |
| 8k | 2 | Não retornado | 7,168 | 7,168 | Falhou | Falhou |
| 8k | 3 | Não retornado | 7,168 | 7,168 | 7,168 | Não retornado |
| 32k | 1 | Não retornado | Não retornado | 31,744 | 31,744 | Não retornado |
| 32k | 2 | Não retornado | 31,744 | 31,744 | 31,744 | Não retornado |
| 32k | 3 | Não retornado | 31,744 | 31,744 | 31,744 | Não retornado |
O prefixo de 8k teve acerto em 5 de 9 solicitações quentes, lendo 35,840 de 72,252 tokens que deveriam ser reutilizáveis, para uma pontuação de 49.60. O prefixo de 32k teve acerto em 8 de 9, lendo 253,952 de 288,261, para uma pontuação de 88.10. K é 68.85, com os dois comprimentos ponderados igualmente. Cinco solicitações de 8k falharam no total: a solicitação seed da janela 1, as solicitações de 5 s e 30 s e as solicitações de 120 s e de controle frio da janela 2, todas com no_available_channel. Isso deixa três solicitações quentes com falha na categoria de 8k.
Em caso de acerto, a leitura informada é contabilizada em blocos de 1,024 tokens: 7,168 tokens para o prefixo de 8k e 31,744 para o prefixo de 32k. Em caso de falha, o bloco de uso omite prompt_tokens_details; a tabela registra «não retornado» e contabiliza o valor como 0.
Em comparação com os outros quatro
R — estabilidade do serviço: 100
As 300 solicitações se dividem em quatro tipos: texto curto, entrada longa, chamada de ferramenta e histórico de várias interações. Foram enviadas com concorrência unitária ao longo de três janelas. Verifica-se apenas se a primeira resposta foi válida e completa; as respostas não são avaliadas e nada é repetido. As falhas durante as respostas e os testes de velocidade são contabilizadas em Q e P, não novamente em R.
| Tipo de solicitação | Sucesso na primeira tentativa |
|---|---|
| Texto curto | 120/120 |
| Entrada longa de 10k | 90/90 |
| Chamada de ferramenta | 60/60 |
| Histórico de várias interações | 30/30 |
| Total | 300/300, IC de 95%: 98.78%–100% |
Todas as 300 solicitações retornaram uma resposta válida e completa na primeira tentativa. R 100 se aplica apenas a essas 300 solicitações dedicadas; isso não significa que o caminho inteiro não teve falhas. Com 300 sucessos em 300 tentativas, o limite inferior do intervalo de 95% é 98.78%, portanto a taxa de falhas provavelmente é inferior a 1.22%.
Em comparação com os outros quatro
R se aplica apenas a essas 300 solicitações dedicadas; as falhas durante as respostas e os testes de velocidade são registradas em Q e P, não novamente em R.
| Provedor | Sucesso na primeira tentativa | Intervalo de 95% |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek oficial | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Perguntas frequentes
O que representa a pontuação geral?
É um índice resumido sem intervalo de confiança, não uma certificação. Esta publicação apresenta Q, F, P, K e R e não recomenda nenhum provedor.
Por que metade dos testes com dez solicitações simultâneas falhou?
50 das 90 solicitações retornaram no_available_channel. Como mais da metade foi inválida, o tempo mediano até o primeiro token é considerado infinito, e TTFA e TPOT recebem as pontuações de penalidade.
R 100 significa que não houve falhas de canal?
Não. R abrange 300 solicitações dedicadas, todas bem-sucedidas na primeira tentativa. As 62 respostas no_available_channel na execução dos testes de velocidade e as falhas na execução de respostas são contabilizadas em P e Q.
Por que K é 68.85 se o prefixo de 32k teve acerto em 8 de 9 solicitações?
Os dois comprimentos têm o mesmo peso. O prefixo de 8k teve acerto em 5 de 9 solicitações quentes e obteve 49.60, enquanto o de 32k teve acerto em 8 de 9 e obteve 88.10; a média é 68.85.
É possível distinguir a qualidade das respostas do Baidu da do canal oficial?
Sim. A diferença combinada em Q é de −4.46 pontos percentuais, com um intervalo de 95% de −5.78 a −3.16, que não inclui 0. É o único resultado de provedor abaixo do canal oficial cujo intervalo não inclui 0.
Quais verificações foram excluídas de F?
Seis: três verificações de sequência de parada em streaming que nunca foram observadas porque a solicitação da etapa anterior não foi enviada, e três verificações explícitas de cache_control, pré-registradas como não compatíveis com esta interface.
Continue lendo: a série DeepSeek V4.1 Flash
- A precisão do Baidu no BFCL ficou próxima à do canal oficial; a publicação sobre a ByteDance aplica o mesmo conjunto de testes às chamadas de ferramentas e aos resultados de cobrança: DeepSeek V4.1 Flash na ByteDance: chamadas de ferramenta correspondem, cobrança não
- O TTFA do Baidu, de 2.26 s com concorrência unitária, contrasta com uma execução que chegou a 1.34 s: DeepSeek V4.1 Flash na Alibaba Cloud: primeiro token em 1.34s, cache a 99.37
- O F de 88.39 do Baidu fica abaixo do valor de referência de 94.00, obtido com 15 testes inválidos: DeepSeek V4.1 Flash no canal oficial: F de 94.00, 15 testes inválidos
- Os acertos de cache de 5/9 do Baidu em 8k se comparam a uma execução com 3/9 e respostas de parada vazias: DeepSeek V4.1 Flash na Fireworks: respostas de parada vazias, 3/9 acertos de cache


