

Na execução completa do APB de 2026-11-03/04, as quatro pontuações do Pareto são Q 44.58, F 93.42, P 57.69 e R 100, com um resultado geral de 68.72. As solicitações com cache aquecido de 8k tiveram 2 acertos em 9, e as de 32k tiveram 3 em 9.
Em 2026-11-03/04, DeepSeek V4.1 Flash 1017 foi testado com seis provedores por meio do AIHubMix, usando a suíte APB Full e as mesmas perguntas, parâmetros e scripts de solicitação para cada um. Este perfil APB abrange apenas o Pareto: o que cada seção mediu e quais foram os resultados.
Os números abaixo são pontuações, não uma classificação nem uma recomendação de provedor. As quatro pontuações, Q, F, P e R, aparecem primeiro; o resultado geral é um índice-resumo, não uma certificação, e não tem intervalo de confiança. As regras de pontuação estão definidas em AIHubMix Provider Benchmark Standard v2.0.
Pontuações dos seis provedores
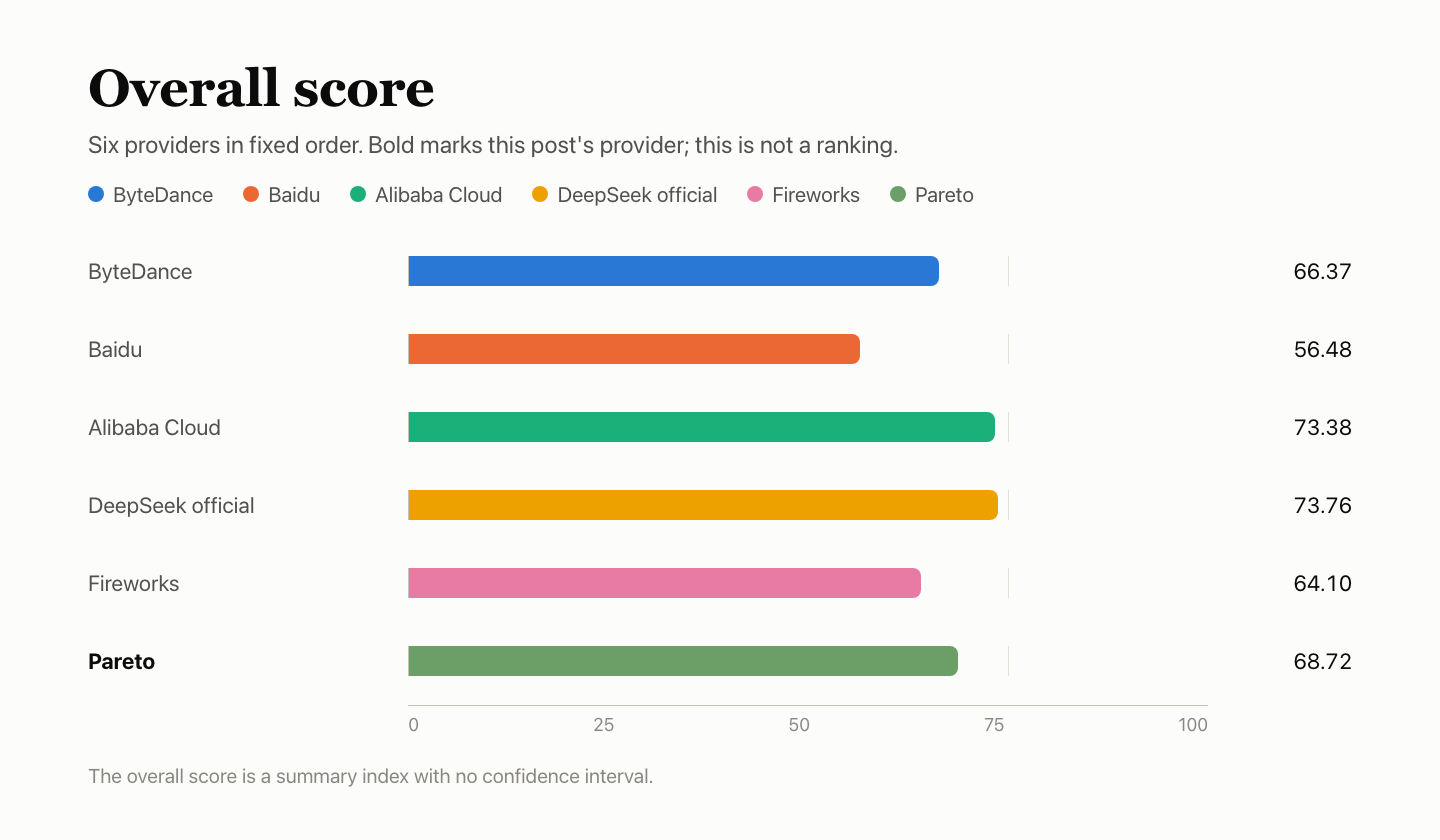
| Provedor | Q qualidade | F funcionalidade | P velocidade | K cache | R estabilidade | Resultado geral |
|---|---|---|---|---|---|---|
| ByteDance | 42.05 | 74.98 | 84.37 | 93.83 | 100 | 66.37 |
| Baidu | 38.00 | 88.39 | 37.77 | 68.85 | 100 | 56.48 |
| Alibaba Cloud | 41.75 | 89.78 | 88.58 | 99.37 | 100 | 73.38 |
| Canal oficial do DeepSeek | 42.45 | 94.00 | 86.14 | 98.38 | 100 | 73.76 |
| Fireworks | 41.42 | 71.78 | 79.51 | 60.68 | 100 | 64.10 |
| Pareto (esta publicação) | 44.58 | 93.42 | 57.69 | 27.58 | 100 | 68.72 |
Os provedores são apresentados em uma ordem fixa, não em uma classificação. K é uma subpontuação de P, correspondendo a 20% dela, e é apresentada separadamente para referência. A pontuação geral é calculada de acordo com as regras de composição do AIHubMix Provider Benchmark Standard, que também consideram a comparação com o canal oficial e a completude das evidências; ela não é uma ponderação direta das quatro pontuações da tabela. É um índice-resumo sem intervalo de confiança. A diferença entre o canal oficial do DeepSeek e o Alibaba Cloud é de apenas 0.37 no resultado geral, o que não representa uma diferença distinguível.
Resumo
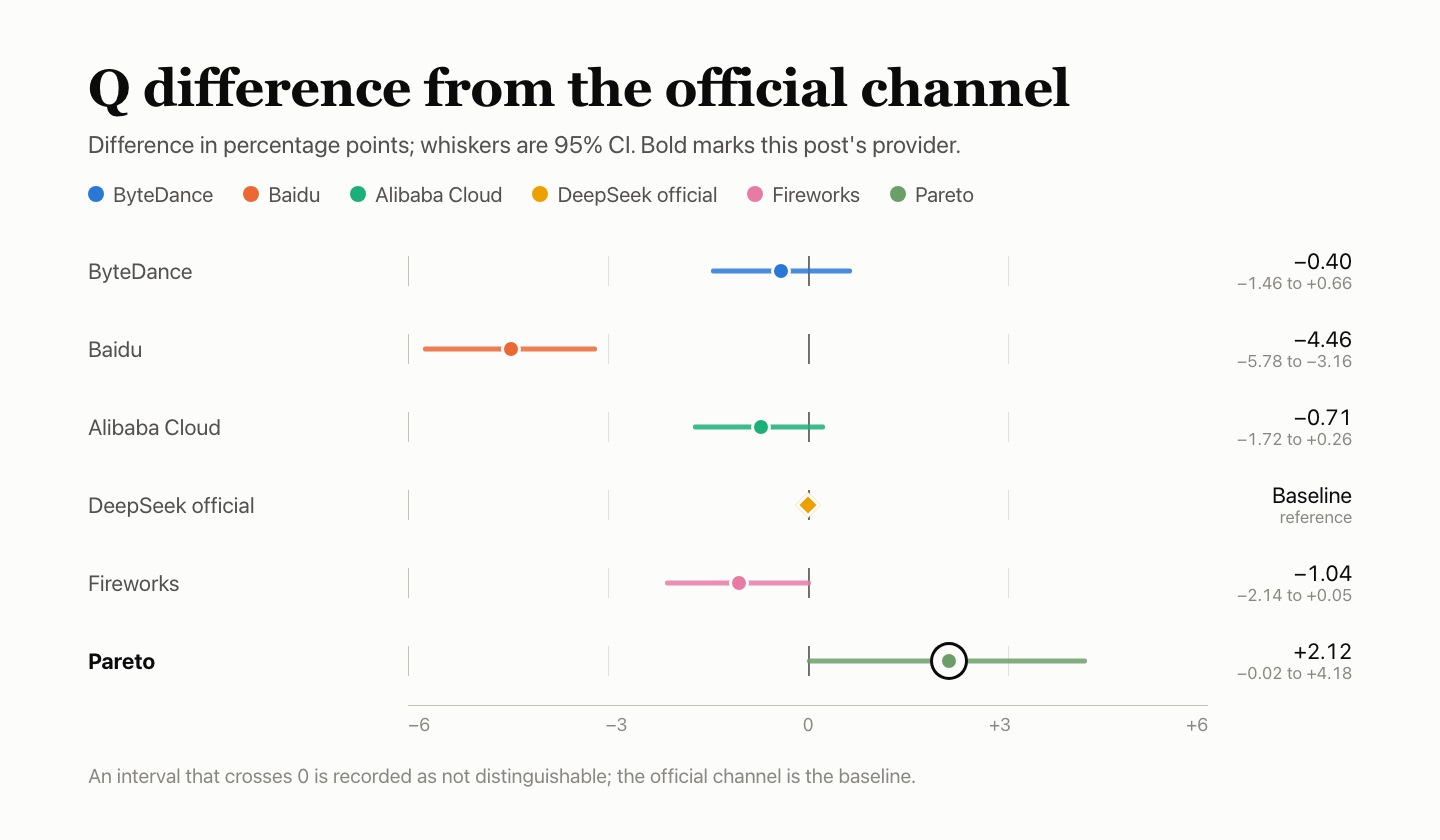
- Qualidade das respostas: Q 44.58, com BFCL 85.27%, HLE 19.32% e AA-LCR 52.00%. A diferença em relação ao canal oficial é de +2.12 pontos percentuais, com intervalo de 95% de −0.02 a +4.18: não é distinguível.
- Suporte a funções: F 93.42, com 29/33 verificações pontuadas originais aprovadas. Há registros adicionais bem-sucedidos em streaming para chamadas de ferramentas e ida e volta dos resultados, chamadas paralelas e nomeadas, modo JSON e histórico da conversa; as pontuações mantêm seus valores originais.
- Velocidade de resposta: P 57.69. Mediana até o primeiro token do corpo: 5.85 s com concorrência única e 6.13 s com concorrência 10, TPOT de 4.63 ms; 110 das 180 solicitações de velocidade foram válidas.
- Cache: K 27.58. As solicitações com cache aquecido de 8k tiveram 2 acertos em 9, e as de 32k tiveram 3 em 9; nenhuma leitura de controle a frio acessou o cache.
- Estabilidade do serviço: R 100. Todas as 300 solicitações dedicadas foram bem-sucedidas na primeira tentativa.
Configuração do teste
| Item | Detalhes |
|---|---|
| Modelo | DeepSeek V4.1 Flash 1017 |
| ID do modelo solicitado | deepseek/deepseek-v4.1-flash |
| Nome do modelo retornado | deepseek/deepseek-v4.1-flash |
| Rota de acesso | Pelo AIHubMix, usando um ID de modelo específico do provedor, e não uma conexão direta à conta do provedor |
| Parâmetros | Perfil de solicitação fixo do APB v2, temperatura 1.0, max_tokens 16,384, tempo limite de 300 s, sem nova tentativa automática |
| Período | 2026-11-03 18:07 – 11-04 16:33; solicitações de cache: 11-05 19:31 – 11-06 10:35; tudo em UTC+8. Os seis provedores compartilharam um Mac mini, uma rede e uma conta. |
| Amostras | Q: 4,250 instâncias de perguntas; F: 180 verificações; P: 180 solicitações; R: 300; K: 30 |
As solicitações usaram a rota de início rápido do AIHubMix com um ID de modelo específico do provedor; os IDs dos outros provedores estão listados na página de modelos. Os parâmetros próprios do modelo estão descritos na documentação da API do DeepSeek.
Q — qualidade das respostas: 44.58
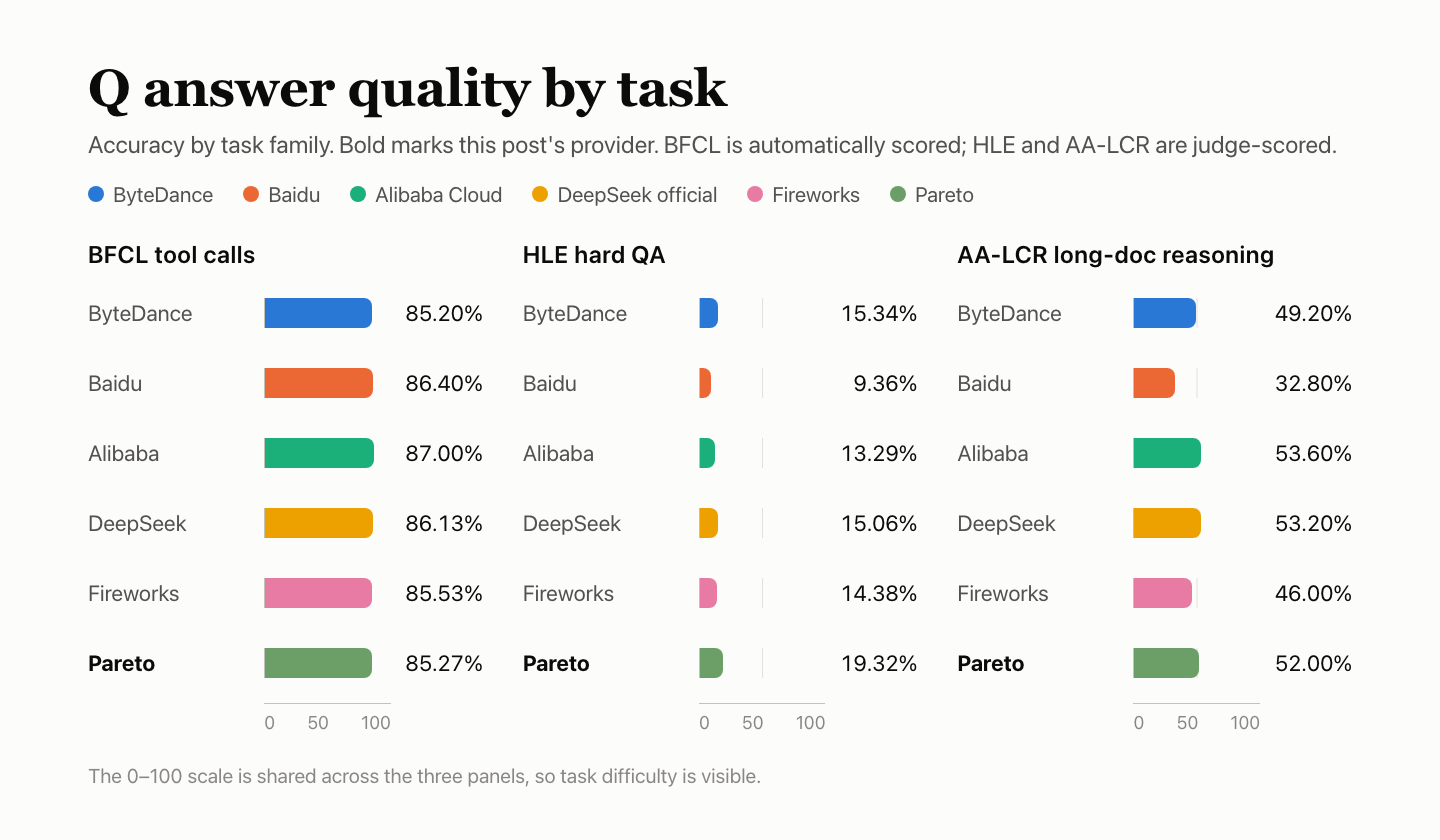
A qualidade das respostas é avaliada com três suítes: 500 perguntas BFCL respondidas 3 vezes cada, 250 perguntas HLE respondidas 10 vezes cada e 25 perguntas AA-LCR respondidas 10 vezes cada. A BFCL é pontuada por regras automáticas; as respostas da HLE e da AA-LCR são avaliadas como certas ou erradas pelo modelo juiz deepseek-flash. Os seis provedores receberam as mesmas perguntas, e as três suítes são agrupadas em uma única taxa de acerto. Dez respostas foram removidas porque não foi possível pontuar a pergunta, restando 4,240 instâncias de perguntas pontuadas.
| Suíte | Perguntas × rodadas | Corretas | Precisão | Falhas do serviço |
|---|---|---|---|---|
| Chamadas de ferramentas BFCL, pontuação automática | 500 × 3 | 1,279/1,500 | 85.27% | 0 |
| Perguntas e respostas difíceis HLE, avaliadas pelo juiz | 250 × 10 | 481/2,490 | 19.32% | 0 |
| Raciocínio sobre documentos longos AA-LCR, avaliado pelo juiz | 25 × 10 | 130/250 | 52.00% | 0 |
| Total · intervalo de 95%: 41.57%–47.49% | — | 1,890/4,240 | 44.58% | 0 |
Todas as instâncias de perguntas receberam uma resposta completa; não houve falhas do serviço.
| Categoria BFCL | Aprovadas | Taxa de aprovação |
|---|---|---|
| simple_python: uma função, chamada e argumentos corretos | 333/360 | 92.50% |
| multiple: escolher a função correta entre várias | 269/300 | 89.67% |
| parallel: chamar a mesma função várias vezes ao mesmo tempo | 265/300 | 88.33% |
| parallel_multiple: chamar várias funções ao mesmo tempo | 203/240 | 84.58% |
| irrelevance: nenhuma função relevante, portanto, nenhuma chamada | 109/150 | 72.67% |
| ahm_multi_turn: cadeia de ferramentas em três etapas | 100/150 | 66.67% |
Cada pergunta BFCL foi respondida 3 vezes; a tabela soma as 3 rodadas.
Comparação com os outros cinco
| Provedor | BFCL | HLE | AA-LCR | Combinado | Em relação ao oficial |
|---|---|---|---|---|---|
| ByteDance | 85.20% | 15.34% | 49.20% | 42.05% | −0.40 (−1.46 a +0.66), não distinguível |
| Baidu | 86.40% | 9.36% | 32.80% | 38.00% | −4.46 (−5.78 a −3.16), abaixo do oficial |
| Alibaba Cloud | 87.00% | 13.29% | 53.60% | 41.75% | −0.71 (−1.72 a +0.26), não distinguível |
| Canal oficial do DeepSeek | 86.13% | 15.06% | 53.20% | 42.45% | Referência |
| Fireworks | 85.53% | 14.38% | 46.00% | 41.42% | −1.04 (−2.14 a +0.05), não distinguível |
| Pareto (esta publicação) | 85.27% | 19.32% | 52.00% | 44.58% | +2.12 (−0.02 a +4.18), não distinguível |
Em relação ao oficial: diferença na precisão, em pontos percentuais, com o intervalo de 95% entre colchetes; quando o intervalo cruza 0, o resultado é registrado como não distinguível. O juiz da HLE e da AA-LCR, deepseek-flash, pertence à mesma família DeepSeek que o modelo testado e não foi calibrado; portanto, suas avaliações podem ser permissivas.
F — suporte a funções: 93.42
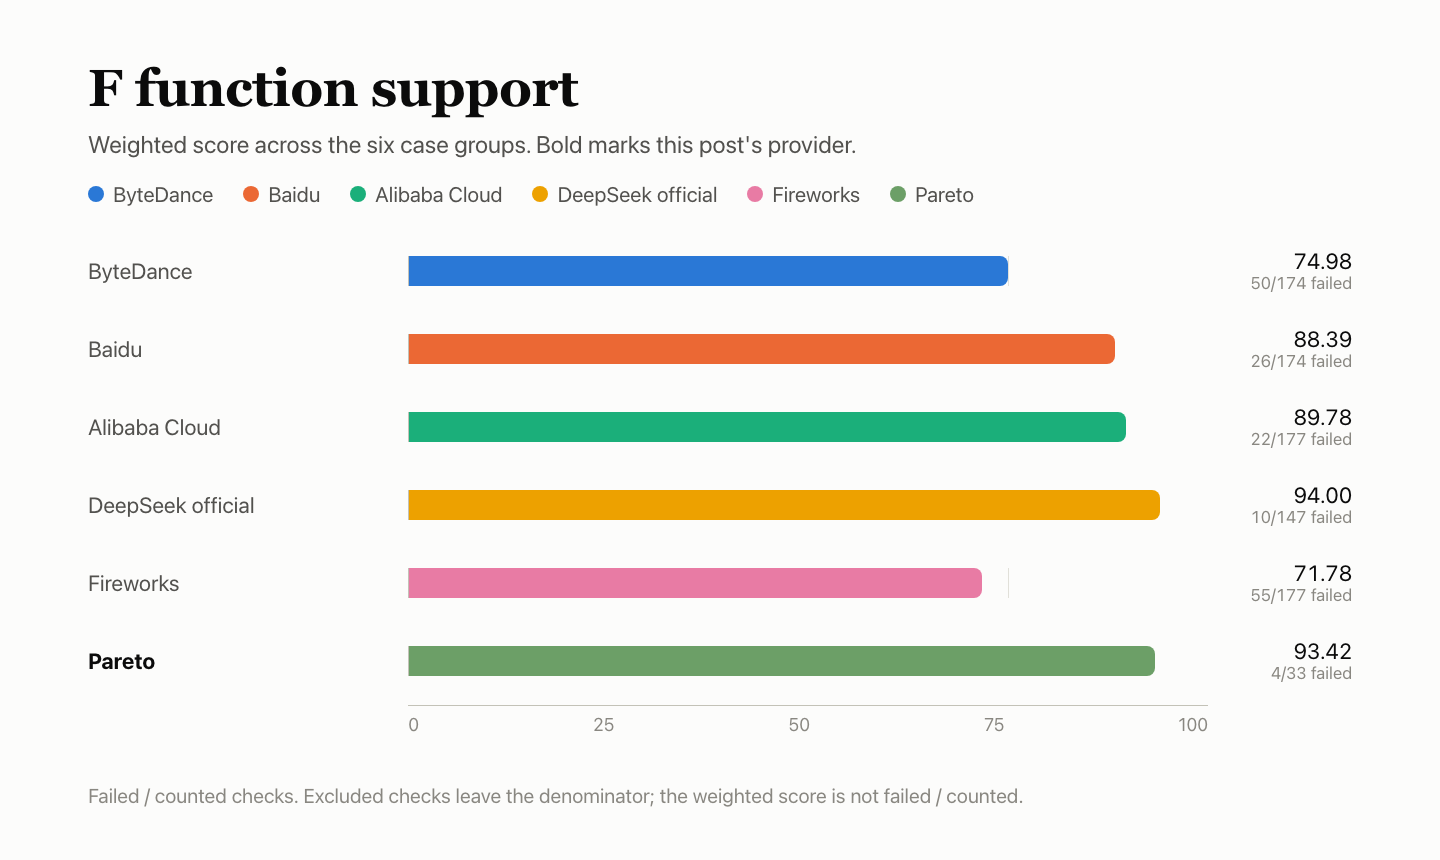
Os casos de funções verificam se o comportamento da interface está de acordo com o protocolo. F 93.42 resulta das 33 verificações contabilizadas (29 aprovadas), após a renormalização dos pesos observados por grupo; as outras 147 verificações planejadas na suíte original foram excluídas da pontuação.
| Grupo de casos | Peso | Aprovadas / observações de streaming | Excluídas | Pontuação do grupo |
|---|---|---|---|---|
| Streaming e protocolo de mensagens | 20% | 23/27 | 3 | 85.19 |
| Interface de ferramentas Chamadas de ferramentas, ida e volta dos resultados, chamadas paralelas e nomeadas | 20% | Aprovações observadas em streaming* | 30 | — |
| Restrições de saída e parâmetros Modo JSON e pensamento desativado | 20% | Aprovações observadas em streaming* | 30 | — |
| Contexto e estado Histórico da conversa e instruções do sistema | 15% | Aprovações observadas em streaming* | 30 | — |
| Erros e recuperação | 15% | 3/3 | 27 | 100.00 |
| Protocolo de medição e cache | 10% | 3/3 | 27 | 100.00 |
| Total · pontuação ponderada | 29/33 | 147 | 93.42 | |
- Os recursos listados têm registros bem-sucedidos em streaming; isso não concede a pontuação máxima ao grupo inteiro. Nenhuma verificação foi adicionada à pontuação. F 93.42 e o resultado geral de 68.72 mantêm seus valores originais.
| Caso reprovado | Janelas | Motivo |
|---|---|---|
| Sequência de parada em streaming Streaming e protocolo de mensagens | 3/3 | Corpo vazio com uma sequência de parada; a mesma entrada funcionou sem a sequência de parada |
| Saída de texto exata Streaming e protocolo de mensagens | 1/3 | Um ponto final adicional quebrou a correspondência exata do texto |
“Janelas” indica em quantas das 3 janelas a verificação falhou.
Os casos de mensagens malformadas e opções de streaming malformadas retornaram 400 com o corpo da resposta vazio em vários provedores. A medição dos tokens de raciocínio teve comportamentos diferentes entre os provedores.
Comparação com os outros cinco
| Provedor | Aprovadas | Reprovadas | Excluídas | Pontuação ponderada |
|---|---|---|---|---|
| ByteDance | 124 | 50 | 6 | 74.98 |
| Baidu | 148 | 26 | 6 | 88.39 |
| Alibaba Cloud | 155 | 22 | 3 | 89.78 |
| Canal oficial do DeepSeek | 137 | 10 | 33 | 94.00 |
| Fireworks | 122 | 55 | 3 | 71.78 |
| Pareto (esta publicação) | 29 | 4 | 147 | 93.42 |
P — velocidade de resposta: 57.69
Cada solicitação continha cerca de 10,000 tokens de entrada e pedia cerca de 1,100 tokens de texto no corpo da resposta. Em cada uma das três janelas, 30 solicitações foram executadas com concorrência única e 30 com concorrência 10: 180 solicitações ao todo.
| Item | Detalhes |
|---|---|
| Primeiro token do corpo (TTFA) | Mediana de 5.85 s com concorrência única (3.08 s apenas nas válidas), 6.13 s com concorrência 10 (4.92 s apenas nas válidas) |
| Velocidade de geração (TPOT) | 4.42 ms/token com concorrência única, 4.63 ms/token com concorrência 10 |
| Vazão efetiva | 519.4 token/s com concorrência 10 |
| Solicitações válidas | 53/90 com concorrência única (janelas 1–3: 15/30, 18/30, 20/30), 57/90 com concorrência 10 (23/30, 16/30, 18/30); inválidas: 70 retornaram 200 com None |
| Subpontuações | TTFA 24.59, TPOT 100.00, vazão 72.05; TTFA e TPOT usam o nível inferior, com pesos de 35% / 35% / 30%: pontuação de resposta 65.22 |
| Pontuação P | Pontuação de resposta 65.22 × 80% + cache K 27.58 × 20% = 57.69 |
As solicitações inválidas são pontuadas como infinitas; por isso, as medianas da tabela podem ser superiores às medianas calculadas apenas com solicitações válidas. O TPOT é estimado a partir dos blocos transmitidos por streaming, não medido por token no hardware. A vazão corresponde aos tokens de saída válidos com concorrência 10 divididos pelo tempo total de processamento em lote.
Comparação com os outros cinco
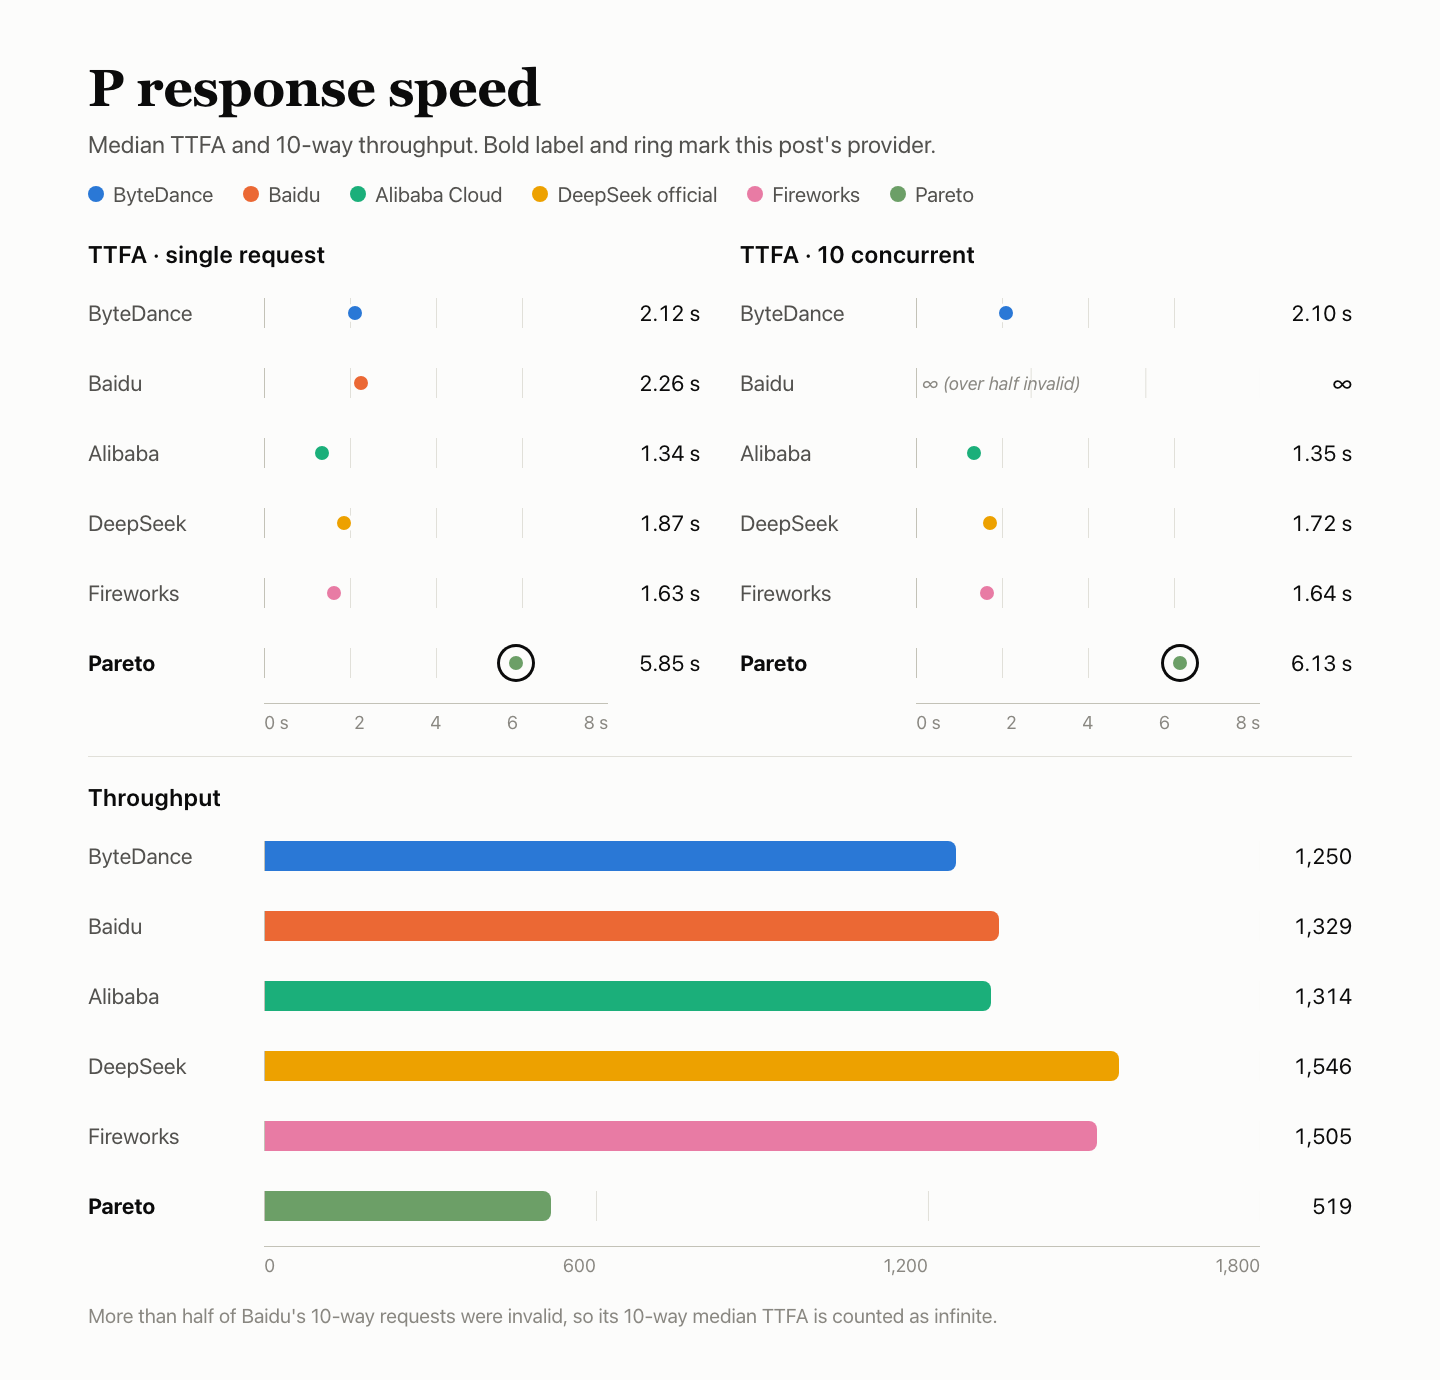
| Provedor | Solicitações válidas | TTFA com concorrência única | TTFA com concorrência 10 | TPOT (mais lento) | Vazão tok/s | Resposta |
|---|---|---|---|---|---|---|
| ByteDance | 180/180 | 2.12 s | 2.10 s | 3.43 ms | 1,250 | 82.00 |
| Baidu | 118/180 | 2.26 s | ∞ | 50.00 ms | 1,329 | 30.00 |
| Alibaba Cloud | 180/180 | 1.34 s | 1.35 s | 4.69 ms | 1,314 | 85.88 |
| Canal oficial da DeepSeek | 165/180 | 1.87 s | 1.72 s | 2.84 ms | 1,546 | 83.08 |
| Fireworks | 179/180 | 1.63 s | 1.64 s | 3.29 ms | 1,505 | 84.22 |
| Pareto (este artigo) | 110/180 | 5.85 s | 6.13 s | 4.63 ms | 519 | 65.22 |
Os seis usaram a mesma máquina, rede e conta. As três janelas foram programadas provedor por provedor, portanto os períodos de coleta não se sobrepõem totalmente; não se deve dar importância excessiva a pequenas diferenças. ∞ significa que mais da metade das requisições foi inválida, então a mediana é considerada infinita.
K — cache: 27.58
Cada grupo envia cinco requisições. A primeira inclui um prefixo fixo de cerca de 8k ou 32k tokens e prepara o cache. As requisições 2–4 mantêm o prefixo e alteram apenas a pergunta final, com intervalos de 5 s, 30 s e 120 s. A quinta usa um prefixo novo como controle sem cache. Três janelas × dois comprimentos totalizam 30 requisições. K corresponde aos tokens de cache lidos pelas requisições quentes divididos pelos tokens que deveriam ser reutilizáveis segundo as regras, com os dois comprimentos ponderados igualmente; K representa 20% de P.
| Janela | 1 · preparação | 2 · +5 s | 3 · +30 s | 4 · +120 s | 5 · sem cache |
|---|---|---|---|---|---|
| Prefixo de 8k · acertos em requisições quentes 2/9 · leitura de 15,872 de 72,504 tokens reutilizáveis · 21.89 | — | — | — | — | — |
| Janela 1 | 0 | 0 | 7,936 | 0 | 0 |
| Janela 2 | 0 | 0 | 0 | 0 | 0 |
| Janela 3 | 0 | 0 | 7,936 | 0 | 0 |
| Prefixo de 32k · acertos em requisições quentes 3/9 · leitura de 96,000 de 288,513 tokens reutilizáveis · 33.27 | — | — | — | — | — |
| Janela 1 | 0 | 0 | 32,000 | 0 | 0 |
| Janela 2 | 0 | 0 | 0 | 0 | 0 |
| Janela 3 | 0 | 0 | 0 | 32,000 | 0 |
| K (8k e 32k ponderados igualmente) | — | — | — | — | 27.58 |
Os valores são os tokens lidos do cache informados pelo servidor; “Não retornado” significa que o campo estava ausente na resposta.
As requisições quentes de 8k tiveram 2 acertos em 9, com 7,936 tokens lidos em cada acerto; as requisições quentes de 32k tiveram 3 acertos em 9, com 32,000 tokens lidos em cada acerto. As requisições sem cache não leram nenhum dado do cache, distinguindo claramente as requisições quentes das sem cache.
Comparação com os outros cinco
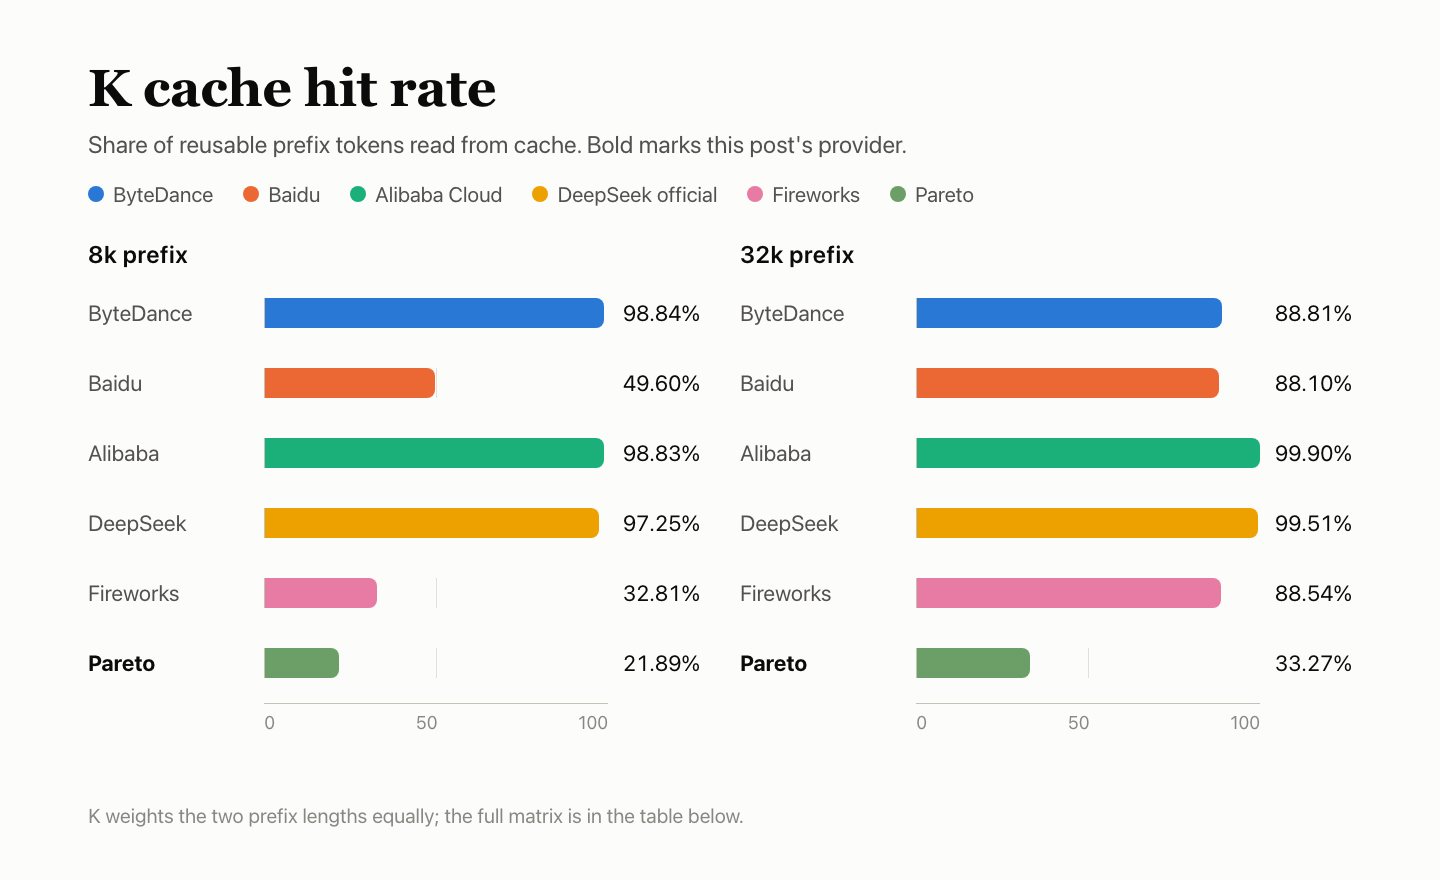
| Provedor | Acertos em 8k | 8k | Acertos em 32k | 32k | K |
|---|---|---|---|---|---|
| ByteDance | 9/9 | 98.84 | 8/9 | 88.81 | 93.83 |
| Baidu | 5/9 | 49.60 | 8/9 | 88.10 | 68.85 |
| Alibaba Cloud | 9/9 | 98.83 | 9/9 | 99.90 | 99.37 |
| Canal oficial da DeepSeek | 9/9 | 97.25 | 9/9 | 99.51 | 98.38 |
| Fireworks | 3/9 | 32.81 | 8/9 | 88.54 | 60.68 |
| Pareto (este artigo) | 2/9 | 21.89 | 3/9 | 33.27 | 27.58 |
R — estabilidade do serviço: 100
As 300 requisições se dividem em quatro tipos: texto curto, entrada longa, chamadas de ferramenta e histórico com várias interações. Elas foram executadas com concorrência única ao longo de três janelas. Verificamos apenas se a primeira tentativa retornou uma resposta válida e completa; as respostas não são avaliadas e nada é repetido. As falhas nas seções de qualidade das respostas e velocidade são contabilizadas em Q e P, não novamente em R.
| Tipo de requisição | Sucesso na primeira tentativa |
|---|---|
| Texto curto | 120/120 |
| Entrada longa de 10k | 90/90 |
| Chamadas de ferramenta | 60/60 |
| Histórico com várias interações | 30/30 |
| Total · intervalo de 95%: 98.78%–100% | 300/300 |
As 300 requisições retornaram uma resposta válida e completa na primeira tentativa. R = 100 descreve apenas essas 300 requisições dedicadas; não significa que toda a cadeia não teve falhas. O limite inferior do intervalo de 95% é 98.78%: 300 sucessos em 300 permitem apenas concluir que a taxa de falhas provavelmente está abaixo de 1.22%.
Comparação com os outros cinco
| Provedor | Sucesso na primeira tentativa | Intervalo de 95% |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| Canal oficial da DeepSeek | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
| Pareto (este artigo) | 300/300 | 98.78%–100% |
R abrange apenas estas 300 requisições dedicadas; as falhas nas seções de qualidade das respostas e velocidade são registradas em Q e P e não são contabilizadas novamente em R.
Perguntas frequentes
Por que F é 93.42 se apenas 33 verificações foram contabilizadas?
As verificações originalmente contabilizadas tiveram 29 aprovações em 33, resultando em F 93.42 após a renormalização dos pesos dos grupos observados; as outras 147 verificações planejadas foram excluídas da pontuação. Os registros de streaming descrevem recursos específicos em funcionamento e não acrescentam verificações pontuadas. A pontuação geral exibida continua sendo 68.72.
Por que P é 57.69 se o TPOT recebeu 100.00?
Apenas 110 das 180 requisições de velocidade foram válidas; 70 retornaram 200 com None. Requisições inválidas contam como infinitas, então a mediana do primeiro token no corpo é 5.85 s com concorrência única e 6.13 s com concorrência de 10 (3.08 s e 4.92 s apenas entre as válidas). O TTFA recebeu 24.59 e a taxa de transferência, 72.05, resultando em uma pontuação de resposta de 65.22; com K do cache em 27.58, ponderado em 20%, P é 57.69.
Por que K é apenas 27.58?
As requisições quentes tiveram 2 acertos em 9 para 8k (21.89) e 3 em 9 para 32k (33.27), e os dois comprimentos têm o mesmo peso. Quando houve um acerto, foram lidos 7,936 ou 32,000 tokens, e nenhum controle sem cache leu dados do cache.
A qualidade das respostas do Pareto é superior à do canal oficial?
Não de forma distinguível. A precisão combinada é de 44.58%, contra 42.45%, uma diferença de +2.12 pontos, mas o intervalo de 95% vai de −0.02 a +4.18 e inclui 0. O avaliador de HLE e AA-LCR, deepseek-flash, não foi calibrado e pode ser leniente.
Quais casos de F falharam?
Dois. A sequência de parada do streaming retornou um corpo vazio nas três janelas, enquanto a mesma entrada sem stop funcionou. A saída de texto exato teve um ponto final extra em uma das três janelas.
Continue lendo: a série DeepSeek V4.1 Flash
- A diferença de Q do Pareto, de +2.12, é medida em relação ao canal oficial; a execução de referência está em Análise do canal oficial da DeepSeek DeepSeek V4.1 Flash: referência de comparação, 15 requisições inválidas com concorrência única.
- Fireworks também retornou corpos vazios em requisições com stop e teve 3 acertos em 9 para 8k: Análise do Fireworks DeepSeek V4.1 Flash: requisições com stop retornam corpo vazio, 3 acertos em 9 nas requisições quentes de cache de 8k.
- As requisições quentes da Alibaba Cloud tiveram 18 acertos em 18, contra 5 em 18 do Pareto: Análise da Alibaba Cloud DeepSeek V4.1 Flash: primeiro token no corpo em 1.34s, todas as 18 requisições quentes acertaram o cache, respostas indistinguíveis das oficiais.
- Todas as requisições de velocidade da ByteDance foram válidas, com o primeiro token no corpo em 2.12 s: Análise da ByteDance DeepSeek V4.1 Flash: respostas indistinguíveis das oficiais, contagens de entrada não correspondem.
- A Baidu também perdeu muitas requisições de velocidade por no_available_channel: Análise da Baidu DeepSeek V4.1 Flash: chamadas de ferramenta à altura das oficiais, erros frequentes de no-available-channel prejudicam a qualidade das respostas e a velocidade.
Fontes
- Página do modelo DeepSeek V4.1 Flash 1017 (AIHubMix)
- Padrão de benchmark de provedores da AIHubMix v2.0 (documentação da AIHubMix)
- Início rápido (documentação da AIHubMix)
- Modelos (AIHubMix)
- Documentação da API da DeepSeek (DeepSeek)


