

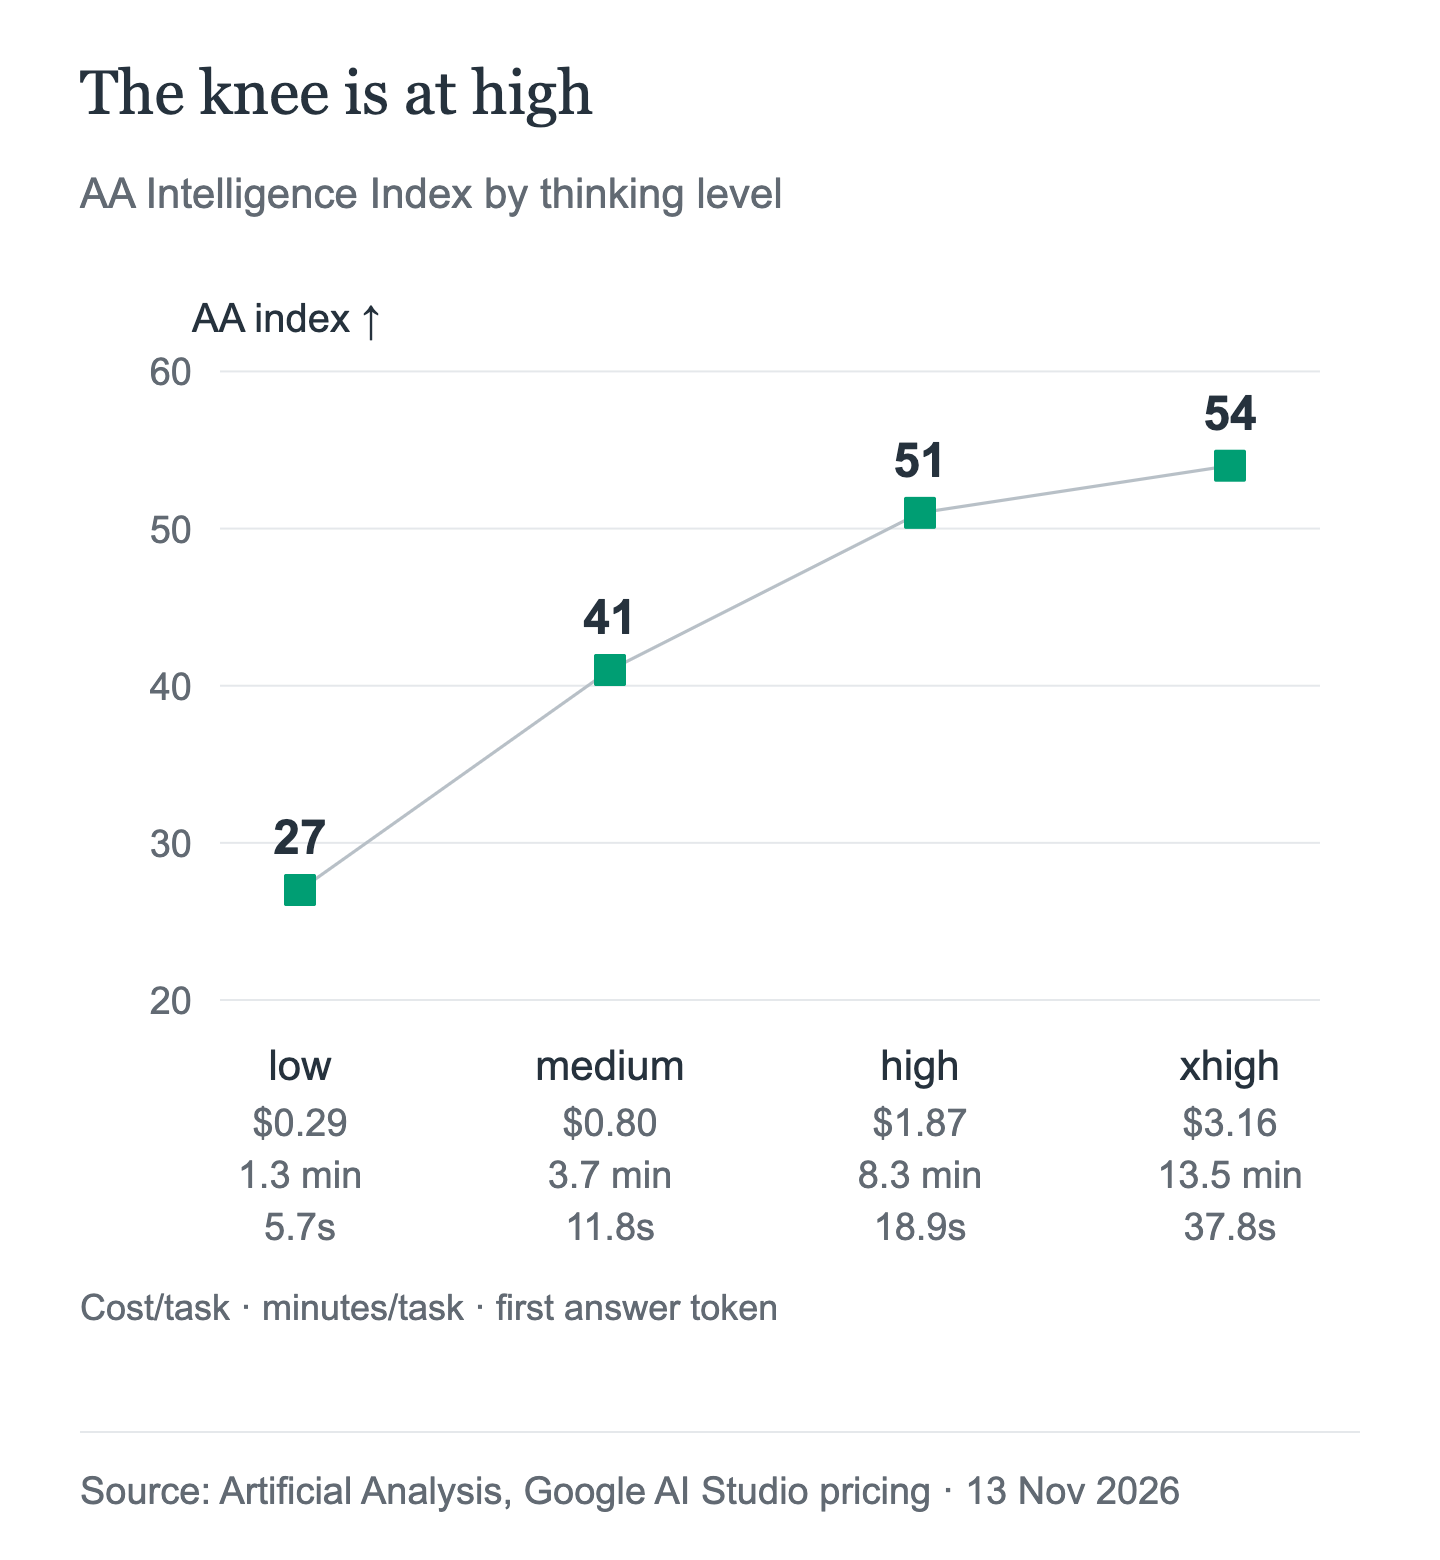
Gemini 4 Hydrogen propose quatre niveaux de réflexion, qui se comportent comme quatre modèles différents. Selon les mesures en temps réel d’Artificial Analysis, le même modèle obtient un score de 27 en low, 41 en medium, 51 en high et 54 en xhigh. Le niveau par défaut est high, et xhigh est une nouveauté de la famille Gemini 4 : Carbon et Argon s’arrêtent à high.
L’écart est important : le même modèle couvre 27 points d’indice entre low et xhigh. Passer de medium à high rapporte 10 points d’indice pour environ 1,07 $ de plus par tâche. Passer de high à xhigh rapporte 3 points pour 1,29 $, et le délai avant le premier token de réponse double presque. En pratique, commencez par high, réservez xhigh aux tâches complexes en plusieurs étapes, et considérez low et medium comme des réglages de latence dont la qualité doit être vérifiée séparément.
Ci-dessous : à quoi sert chaque niveau, ce qu’il coûte, ce qui change dans l’API et ce qu’AIHubMix documente — ou ne documente pas.
Les quatre niveaux et les changements apportés
Gemini 4 Hydrogen prend en charge low, medium, high et xhigh. Les notes de version de Google sont claires : « Le modèle utilise high par défaut et introduit xhigh. » Ce sont deux changements par rapport à Gemini 3.8 Flash, qui utilise medium par défaut et s’arrête à high.
Le reste de la famille n’a pas changé. Carbon et Argon prennent en charge low, medium et high, avec medium comme niveau par défaut. Hydrogen est le seul modèle Gemini 4 qui propose un réglage supérieur à high.
| Modèle | Niveaux | Par défaut |
|---|---|---|
| Gemini 4 Hydrogen | low, medium, high, xhigh | high |
| Gemini 4 Carbon | low, medium, high | medium |
| Gemini 4 Argon | low, medium, high | medium |
MINIMAL ne fait pas partie des niveaux disponibles. La documentation sur la réflexion de Gemini 4 indique que MINIMAL « n’est pas pris en charge par les modèles Gemini 4 », et les notes de version de Hydrogen précisent que le modèle « rejette minimal avec une erreur ». Aucun mécanisme de désactivation de la réflexion n’est documenté pour ce modèle.
Ce que recommande Google
Les recommandations de Google constituent un bon point de départ, mais elles ont été formulées avant les mesures présentées ci-dessous. En particulier, la recommandation d’utiliser medium pour le codage interactif suppose un niveau de qualité que les mesures d’Artificial Analysis ne confirment pas en medium.
| Niveau | Description et utilisations suggérées par Google |
|---|---|
| low | « Moins de tokens, latence minimale » — chat rapide, volume élevé |
| medium | « Moins de tokens, réponses plus rapides » — codage interactif, prototypes d’interface |
| high | « Équilibre entre intelligence et rapidité » — niveau par défaut pour la plupart des tâches |
| xhigh | « Plus de tokens, raisonnement plus approfondi » — codage complexe en plusieurs étapes |
Le tableau s’accompagne de deux mises en garde. « Le recours à xhigh augmente la latence et l’utilisation de tokens, et peut entraîner une réflexion excessive sur les prompts simples », indique Google. Les consignes d’évaluation sont également explicites : « Effectuez vos évaluations avec les quatre niveaux et une valeur élevée de max_output_tokens. »
Les performances mesurées selon les niveaux
Artificial Analysis a mesuré les quatre niveaux. Il s’agit de l’Intelligence Index v5.0.1, qui classe 78 modèles, consulté le 2026-11-13T02:40Z, aux tarifs catalogue standard. Ces coûts par tâche sont ceux d’AA, et non les factures d’AIHubMix.
| Niveau | Rang AA | Indice AA | $/tâche | Min/tâche | Premier token de réponse |
|---|---|---|---|---|---|
| low | 60 | 27 | 0.29 | 1.3 | 5.71 s |
| medium | 39 | 41 | 0.80 | 3.7 | 11.80 s |
| high | 21 | 51 | 1.87 | 8.3 | 18.89 s |
| xhigh | 16 | 54 | 3.16 | 13.5 | 37.77 s |
Les écarts entre les niveaux sont ce qui compte :
lowàmedium: +14 points d’indice, +0,51 $ par tâche, +2,4 minutes, +6,1 secondes avant le premier token.mediumàhigh: +10 points d’indice, +1,07 $ par tâche, +4,6 minutes, +7,1 secondes avant le premier token.highàxhigh: +3 points d’indice, +1,29 $ par tâche, +5,2 minutes, +18,9 secondes avant le premier token.
high est le point d’inflexion. C’est le dernier palier où le gain de qualité est important par rapport au coût supplémentaire ; avec xhigh, le délai avant le premier token double presque pour un faible gain d’indice. Cela ne signifie pas que xhigh est un mauvais réglage. Cela signifie qu’il convient aux tâches pour lesquelles high échoue, exactement comme le décrit Google.
À titre de comparaison, dans le même instantané, Carbon high obtient 60 pour 5,48 $ par tâche et 28,1 minutes, Carbon medium 58 pour 4,68 $, Carbon low 54 pour 5,22 $, et Argon high 50 pour 4,97 $ et 30,6 minutes. Hydrogen xhigh égale le score de 54 de Carbon low, avec un coût par tâche inférieur de 39,5 % (3,16 $ contre 5,22 $), mais le premier token prend 37,77 secondes contre 13,61. Hydrogen high devance Argon high d’un point d’indice, avec un coût par tâche inférieur de 62,4 %.
Là où les écarts deviennent problématiques
low n’est pas une simple dégradation. Avec un score de 27, il se situe 24 points d’indice en dessous de high. Passer une charge de travail de high à low pour économiser 1,58 $ par tâche, ce n’est pas obtenir le même produit avec moins de réflexion : c’est choisir un modèle bien moins performant. Cela peut convenir à la classification, au routage ou à l’extraction de données courtes. En revanche, ce n’est pas adapté au codage ou aux tâches agentiques sans évaluation propre à la tâche.
medium est un réglage de latence, pas de qualité. Il obtient 41, soit 10 points de moins que high, pour 0,80 $ contre 1,87 $. L’économie est réelle — 57 % par tâche — mais l’écart de qualité est plus important que ne le laisse supposer l’écart de prix. Google recommande medium pour le codage interactif ; selon le score AA, il faut tester cette recommandation sur vos propres tâches avant de l’adopter.
xhigh peut trop réfléchir. Google le signale explicitement. Les coûts et durées mesurés par AA illustrent cet effet : 3,16 $ par tâche, 13,5 minutes et 37,77 secondes d’attente avant le premier token. Pour un prompt simple, la latence est élevée pour un gain modeste. Pour une tâche complexe de codage en plusieurs étapes où high échoue, c’est le seul niveau qui va plus loin.
La verbosité a un coût. Artificial Analysis décrit Hydrogen comme « très verbeux » : le test en xhigh a généré 304 millions de tokens de sortie pour calculer l’indice, le classant au rang #76 sur 77, contre une médiane de 72,8 millions. Les tokens de sortie comprennent ceux consacrés à la réflexion, et la sortie est facturée 7,50 $ par million. Un niveau supérieur ne fait pas que réfléchir plus longtemps : il produit davantage de tokens facturables.
Le coût : comment la réflexion se traduit en tokens
La grille tarifaire est simple. Hydrogen coûte 1,50 $ par million de tokens d’entrée, 7,50 $ par million de tokens de sortie et 0,075 $ par million de tokens d’entrée mis en cache. La sortie comprend les tokens de réflexion. C’est pourquoi le niveau compte plus que le tarif : le modèle facture le raisonnement qu’il produit, pas le nom du niveau.
Trois règles de facturation passent facilement inaperçues.
Le niveau par défaut a changé. Gemini 3.8 Flash utilisait medium par défaut ; Hydrogen utilise high. Après la migration, une charge de travail qui ne spécifiait aucun niveau consommera davantage de tokens de sortie par tour, même si le prix par token reste identique. C’est une modification du budget déguisée en changement de modèle.
La mise en cache est uniquement implicite. Hydrogen prend en charge la mise en cache implicite, avec un minimum de 4,096 tokens et une remise de 95 % sur les hits de cache ; la mise en cache explicite n’est pas prise en charge. La page Entreprise de Google précise également que « les écritures dans le cache sont facturées par défaut à 1.25x le prix standard des tokens d’entrée ». Il s’agit des modalités de facturation indiquées par Google ; la facturation du cache par AIHubMix n’est pas documentée pour ce modèle.
La génération longue est soumise à une limite par segment. Une requête synchrone génère jusqu’à 65,536 tokens par segment, avec ou sans streaming. Pour des sorties plus longues, il faut recourir à l’exécution en arrière-plan ou à des tokens de continuation, et max_output_tokens limite le total combiné des tokens de réflexion et de sortie. Si vous définissez background=true sans définir max_output_tokens, le serveur s’arrête après 65,536 tokens. Pour les générations longues, Google recommande des budgets de 131,072 ou 262,144, jusqu’à 1,048,576 moins le nombre de tokens d’entrée.
Ce que l’API accepte et rejette
Le paramètre est thinking_level (snake_case). L’exemple Python de Google le définit dans thinking_config ; dans l’exemple Node, il est imbriqué sous thinkingConfig (camelCase). La page du modèle indique les valeurs LOW, MEDIUM, HIGH et XHIGH ; les notes de version les écrivent en minuscules. Utilisez l’énumération de votre SDK ou la chaîne documentée plutôt que de saisir manuellement une variante de casse.
Trois formats de requête échouent :
thinking_budgetrenvoie400: INVALID_ARGUMENTavec n’importe quel modèle Gemini 4. Définir à la foisthinking_leveletthinking_budgetprovoque également une erreur.thinking_level="MINIMAL"n’est pas pris en charge ; Hydrogen le rejette.- Les valeurs personnalisées de
temperature,top_pettop_ksont ignorées. Les valeurs par défaut fixes sont temperature 1.0, topP 0.95 et topK 64.
Sur la plateforme Google, Hydrogen prend également en charge les appels de fonction, l’exécution de code, le contexte d’URL et l’utilisation d’un ordinateur. Dans l’API Interactions, utilisez previous_interaction_id pour les sessions à plusieurs tours et celles avec appels d’outils.
Ce qu’AIHubMix documente — et ce qu’il ne documente pas
La route documentée par AIHubMix pour Hydrogen est POST https://aihubmix.com/v1/chat/completions avec model="gemini-4-hydrogen". La page du modèle répertorie les entrées texte, image, audio, vidéo et PDF, avec une sortie texte ; llms.txt contient toujours une ancienne mention indiquant une prise en charge du texte uniquement. Considérez donc la page comme la source la plus récente. Les capacités liées à l’utilisation d’outils, à la sortie structurée et au raisonnement sont « non publiées ». Le modèle ne figure pas dans l’index des modèles généré le 2026-11-11, et aucun schéma de protocole n’est publié.
C’est important pour cet article, car AIHubMix ne documente pas comment définir un niveau de réflexion pour les modèles Gemini 4. Son guide Gemini couvre reasoning_effort pour les modèles de l’époque Gemini 2.5, mais pas thinking_level ni xhigh pour Gemini 4. Ne partez pas du principe que l’un ou l’autre paramètre est transmis par la passerelle, ni que le niveau par défaut observé sur l’API de Google est celui que vous obtiendrez avec AIHubMix.
Le format de requête sûr est celui qu’AIHubMix documente :
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "List the failure modes in this retry design."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
Si le contrôle du niveau est indispensable, appelez directement l’API de Google ou vérifiez le comportement de la passerelle avec une petite requête avant d’y acheminer le trafic de production. La page de comparaison d’AIHubMix permet de vérifier les coûts pendant votre réflexion. Aucun test en direct n’a été effectué pour cet article.
Par où commencer selon la charge de travail
| Charge de travail | Niveau de départ et raison |
|---|---|
| Chat rapide, routage, classification | medium, tester low ; low obtient un score de 27 |
| Codage interactif, prototypage d’interface | high ; le niveau medium d’AA obtient 41 |
| Exécution d’agents, boucles d’appels d’outils | high ; xhigh uniquement en cas de blocage |
| Débogage complexe, architecture, planification | xhigh ou Carbon ; 3 points de plus pour 69% de coût supplémentaire |
| Traitement par lots à grand volume après évaluation | low ou medium ; les moins chers, mais avec des indices de 27/41 |
| Budget de latence strict, inférieur à 15 secondes | medium ou low ; high attend 18.89 s |
Ce sont des points de départ, pas des règles de routage. Le bon niveau est le plus bas qui réussit votre propre évaluation, et Google recommande de réaliser cette évaluation aux quatre niveaux.
FAQ
Quels sont les niveaux de réflexion de Gemini 4 Hydrogen ?
Il y en a quatre : low, medium, high et xhigh. Le niveau par défaut est high.
Qu’est-ce qui a changé depuis Gemini 3.8 Flash ?
Le niveau par défaut est passé de medium à high, et xhigh a été ajouté au-dessus de high. Carbon et Argon conservent medium comme niveau par défaut et s’arrêtent à high.
xhigh en vaut-il la peine ?
Pour les tâches complexes en plusieurs étapes qui échouent avec high, oui : il ajoute 3 points à l’indice. Il coûte aussi 69% de plus par tâche que high et fait presque doubler l’attente avant le premier token ; c’est donc un mauvais choix par défaut pour les prompts simples.
Pourquoi low est-il aussi loin derrière ?
Artificial Analysis lui attribue un indice de 27, soit 24 points de moins que high. Son prix est de $0.29 par tâche, contre $1.87, mais l’écart de qualité est bien plus grand que l’écart de prix. Utilisez-le uniquement si une évaluation propre à la tâche montre qu’il suffit.
AIHubMix prend-il en charge thinking_level ou xhigh ?
Rien ne l’indique dans la documentation. AIHubMix ne publie aucun indicateur de capacité de raisonnement pour Hydrogen ni aucun guide sur les niveaux de réflexion de Gemini 4. Vérifiez avant de vous fier à l’un ou l’autre.
Que se passe-t-il si j’envoie thinking_budget ?
Gemini 4 renvoie 400: INVALID_ARGUMENT. Définir à la fois thinking_budget et thinking_level renvoie également une erreur.
Puis-je désactiver la réflexion ?
Il n’existe pas de méthode documentée pour la désactiver. MINIMAL n’est pas pris en charge sur Gemini 4, et Hydrogen le rejette avec une erreur.
À lire ensuite : la série Gemini 4 Hydrogen
- Si vous vous demandez encore si Hydrogen est la bonne mise à niveau par rapport à Gemini 3.8 Flash, le premier article présente le lancement, l’évolution des prix et les compromis en matière de benchmarks : Gemini 4 Hydrogen vs Gemini 3.8 Flash : la mise à niveau en vaut-elle la peine ?.
- Si vous voulez savoir comment Hydrogen se compare à Carbon et Argon pour une même tâche, le troisième article compare les trois modèles côte à côte, avec les prix, la latence et un tableau des charges de travail : Gemini 4 Carbon vs Hydrogen vs Argon : quel modèle pour quelle tâche ?.
Sources
- Google AI Studio, Gemini 4 Hydrogen : nouveautés
- Google, Réflexion de Gemini 4
- Google, Page du modèle Gemini 4 Hydrogen
- Google AI Studio, Tarifs de l’API Gemini
- Artificial Analysis, Gemini 4 Hydrogen — instantané en direct 2026-11-13T02:40Z, Intelligence Index v5.0.1


