Gemini 4 Carbon remplace Gemini 4 Argon sans modification au niveau du schéma des requêtes. Le même corps de requête de complétion de chat fonctionne : l’ID du modèle change et certaines valeurs de paramètres ne sont pas conservées. Les problèmes importants surviennent un niveau plus bas : des erreurs de paramètres qui renvoient un 400, des limites de sortie qui tronquent silencieusement les réponses, ainsi qu’un profil de délai d’expiration et de facturation conçu autour d’une longue réflexion.
Quatre réglages par défaut déterminent la première semaine :
- Gardez
max_tokensà 65,536 ou moins sur AIHubMix ; la passerelle ne documente que Chat Completions et ne publie pas de chemin permettant une sortie plus longue. - Pour les exécutions en arrière-plan avec Google Interactions natif, définissez
store=trueet unmax_output_tokensexplicite ; ces champs ne sont pas documentés pour Carbon sur AIHubMix. - Augmentez les délais d’attente de lecture HTTP à 15–20 minutes par flux lorsque vous utilisez le chemin natif du fournisseur pour le décodage long.
- Supprimez
temperature,top_pettop_k, qui sont ignorés, ainsi que les pénalités et les valeurs decandidate_countsupérieures à 1, qui renvoient une erreur 400 dans le guide Carbon de Google.
Les éléments de base qui n’ont pas changé — accès, refus de sécurité et coût par tâche — sont présentés dans l’article sur la migration vers Argon. Cet article porte sur le comportement propre à Carbon.
Ce qui échoue bruyamment, ce qui échoue en silence
Les échecs se répartissent clairement : un 400 vous avertit immédiatement, une limite silencieuse se remarque sur la facture.
| Ce que vous voyez | Catégorie | Première mesure à prendre |
|---|---|---|
| Erreur HTTP 400 sur un paramètre | Explicite | Supprimez le champ non pris en charge |
| Erreur 400 sur une requête en arrière-plan | Explicite | Ajoutez store=true |
| La réponse s’arrête à 65,536 tokens | Silencieux | Augmentez max_tokens, jusqu’à 65,536 |
| Texte vide, statut incomplet | Silencieux | Augmentez la limite et réessayez |
| L’exécution en arrière-plan s’arrête près de 64K | Silencieux | Définissez max_output_tokens |
| La réponse semble moins approfondie | Silencieux | Définissez explicitement le niveau de réflexion |
| Facture supérieure à l’estimation | Silencieux | Comptabilisez la réflexion et les étapes de décodage |
AIHubMix propose gemini-4-carbon à 2 $ en entrée, 10 $ en sortie et 0.10 $ par million de tokens mis en cache — les tarifs de lancement de Google — via Chat Completions. Ils sont temporaires ; consultez la section sur la facturation.
Échecs explicites : les erreurs 400 documentées
Bon nombre des erreurs 400 documentées sont dues à la validation des paramètres ; les problèmes liés à l’historique et aux tours de modèle préremplis sont des échecs d’état de la requête. Sauf indication contraire, les règles ci-dessous proviennent du guide natif de Google sur Carbon ; AIHubMix ne documente actuellement que Chat Completions pour Carbon. La fiche de Carbon sur AIHubMix résume la catégorie en une ligne : « 400 — erreur de paramètre ; la plupart sont transmises par le fournisseur en amont. » Cela décrit la passerelle, et non un test. Les détails proviennent du guide Carbon et de la page des nouveautés de Google.
| Déclencheur | Ce que vous voyez | Correctif |
|---|---|---|
| max_output_tokens > 1M* | 400 ; dépasse la limite | Natif ≤1M ; passerelle ≤65K* |
| frequency/presence penalty | 400 ; non pris en charge | Supprimez les champs |
| candidate_count > 1 | 400 ; plusieurs candidats | Omettez le paramètre ou définissez-le sur 1 |
| requête en arrière-plan sans store* | 400 ; store obligatoire* | Ajoutez store=true |
| L’historique se termine par le modèle | Rejeté ; non pris en charge | Terminez par un tour utilisateur |
| les deux contrôles | 400 ; combinaison impossible | N’en envoyez qu’un |
| thinking_budget ou MINIMAL | 400 ; guide Carbon | Utilisez low/medium/high |
Google affiche exactement le message suivant : « store=true is required for background interactions. » * Google natif uniquement : max_output_tokens est plafonné à 1M et store=true est obligatoire en arrière-plan ; AIHubMix n’a pas documenté ce chemin. Utilisez ≤65K avec son chemin Chat Completions.
La ligne minimal a deux significations. Dans les champs natifs Carbon de Google, thinking_budget et thinking_level=MINIMAL renvoient une erreur HTTP 400 ; utilisez low, medium ou high. Dans la couche de compatibilité OpenAI de Google, reasoning_effort=minimal est associé à low ; AIHubMix n’a pas indiqué si cette association s’applique à Carbon.
La gestion des outils est un piège connexe. Le guide Carbon de Google recommande de privilégier les tours d’exécution séquentielle des outils, et le guide Gemini d’AIHubMix documente tool_choice="auto" ; la prise en charge des outils propres à Carbon sur la passerelle n’est pas confirmée.
La requête minimale sûre sur /v1/chat/completions supprime les éléments ignorés par Carbon :
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Reply with OK."}],
    max_tokens=32768,  # room for thinking plus answer
)
print(response.choices[0].message.content)
Si cette requête renvoie 200, la couche de transport est opérationnelle. Le reste concerne les réponses qui ne déclenchent jamais d’erreur.
Échecs silencieux : aucune erreur, mauvaise sortie, mauvaise facture
La limite de sortie standard est de 65,536 ; le décodage long du fournisseur est distinct
La limite de sortie standard de Carbon est de 65,536 tokens. Avec Chat Completions, le champ de limite est max_tokens ; les guides natifs de Google l’appellent max_output_tokens. Le chemin natif de décodage long de Google peut atteindre 1,048,576 tokens moins le nombre de tokens d’entrée ; 131,072 et 262,144 en sont des exemples. La page des nouveautés de Google précise la règle : « Si vous définissez background: true sans définir max_output_tokens, le serveur s’arrête après 64K tokens. » AIHubMix n’a documenté ni l’exécution en arrière-plan ni la reprise pour Carbon.
Le décodage long natif du fournisseur s’exécute par segments : 64K par étape en arrière-plan ou en streaming, 32K par étape sans streaming ; une seule requête REST sans streaming s’arrête après 32,768. Le guide de Google indique que « les anciennes versions du SDK et la couche de compatibilité OpenAI ne peuvent pas récupérer de complétions longues à l’aide de jetons de continuation ». Avec AIHubMix, gardez max_tokens à 65,536 ou moins par prudence, car cette limite de la passerelle n’est pas vérifiée ; ne prévoyez pas d’assembler des réponses plus longues tant que la page du modèle ne l’a pas documenté.
Une limite basse tronque la réflexion, et les sorties vides sont facturées
La limite s’applique à la réflexion, et pas seulement au texte. Le guide sur le décodage long de Google indique : « Une valeur basse, comme 8,192, arrête le modèle avant qu’il ait fini de réfléchir. » Le statut devient incomplete et « le texte peut être vide si le modèle était encore en train de réfléchir ». Vous payez dans les deux cas. Prévoyez un budget couvrant la réflexion et la réponse, et considérez une réponse vide au statut incomplet comme un problème de limite : augmentez-la, réessayez et prévoyez que la première tentative apparaîtra sur la facture.
Le niveau de réflexion par défaut est medium
Carbon utilise medium par défaut, comme Argon. Les équipes qui passent de Gemini 3.1 Pro Preview, dont le niveau par défaut est high, perdent un niveau sans modifier leur code et interprètent la réponse moins approfondie comme une régression. Google recommande medium pour la plupart des tâches de programmation et des tâches agentiques. Définissez explicitement le niveau dans l’environnement de préproduction et n’envoyez qu’un seul champ de contrôle : reasoning_effort et thinking_level ne peuvent pas être combinés.
Les paramètres d’échantillonnage sont ignorés
temperature, top_p et top_k sont ignorés — aucune erreur, aucun changement dans l’échantillon. Supprimez-les. Les pénalités et les valeurs de candidate_count supérieures à 1 renvoient une erreur 400.
Le cache explicite a disparu
cachedContents et caches.create ne sont pas pris en charge. La mise en cache implicite s’applique à partir de 4,096 tokens et offre une réduction de 95%. Supprimez le code du cache explicite, placez d’abord le préfixe stable du prompt et vérifiez l’utilisation des tokens mis en cache avant de prévoir cette réduction dans votre budget.
L’état de la conversation est soumis à une règle
Google recommande previous_interaction_id pour poursuivre une conversation. Chat Completions ne comporte pas ce champ : conservez donc l’historique, mais terminez-le par un tour utilisateur ; les fins de tour attribuées au rôle du modèle et les tours de modèle préremplis ne sont pas pris en charge.
Délais d’expiration : 15 à 20 minutes, et non 60 secondes
Le guide de Google sur le décodage long recommande des délais d’attente de lecture HTTP de 15 à 20 minutes par flux ; sa liste de contrôle pour la migration répète une durée minimale de 15 minutes. Cette recommandation concerne les requêtes de décodage long. Une mesure distincte d’AA indique le temps d’attente avant le premier token de réponse : 67.1 secondes pour Carbon High, 23.2 pour Medium, 12.9 pour Low et 40.1 pour Argon High. Un délai de 60 secondes suffit-il seulement à recevoir le premier token ?
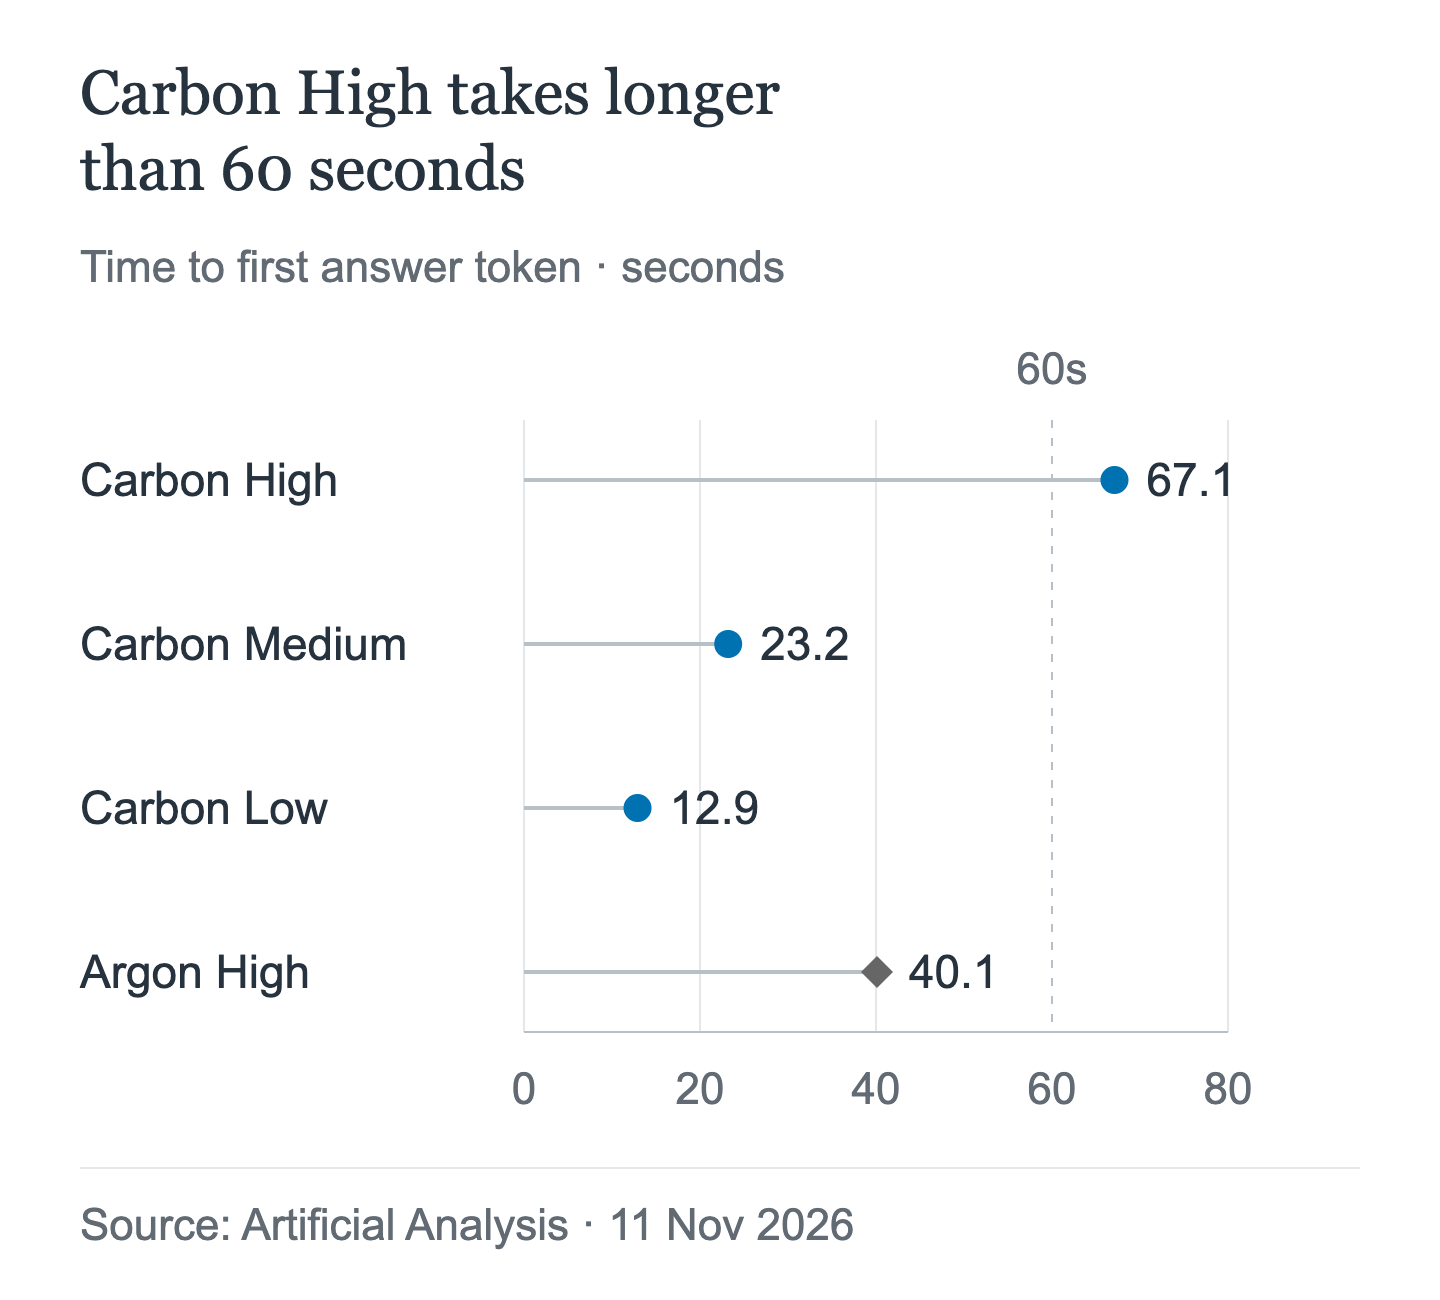
Carbon High dépasse la référence de 60 secondes dans cette mesure. Le délai avant le premier token ne permet pas de déterminer un délai d’expiration sûr pour l’ensemble de la requête : la recommandation de 15 à 20 minutes ci-dessus provient du guide de Google sur le décodage long. Il s’agit des résultats d’un seul instantané, et non de garanties de latence ou d’un test d’AIHubMix.
Les limites de durée des requêtes du client natif de Google sont plus strictes que la limite des tâches en arrière-plan : 20 minutes pour un flux, 10 pour un appel sans streaming, contre 24 heures en arrière-plan. AIHubMix ne documente pas ces limites pour les tâches en arrière-plan.
Versions minimales des SDK natifs pour le décodage long : Python 2.34.0, JS 2.32.0, Go 1.77.0, Java 1.80.0, .NET 1.28.0. Le délai API_TIMEOUT_MS de Claude Code est de 10 minutes par défaut ; si un chemin Claude Code est confirmé pour Carbon ultérieurement, augmentez-le avant la première exécution.
Pièges de facturation
Le prix par token de Carbon est simple ; la facture, elle, ne l’est pas. Plusieurs mécanismes alourdissent la facture, et un changement programmé double tous les tarifs.
La réflexion est facturée comme une sortie
Les tokens de réflexion sont facturés comme des tokens de sortie. Le tarif de sortie de Carbon est actuellement de 10 $ par million de tokens et passera à 20 $ le 1 décembre.
Chaque étape de décodage long est facturée
Exemple détaillé de Google : pour un prompt de 1,000 tokens produisant 200,000 tokens de sortie, total_input_tokens indique 397,216 sur l’ensemble des étapes, qui comptent 1,000, 66,536, 132,072 et 197,608 tokens. « Vous payez chaque token de chaque étape, y compris les étapes qui ne contiennent que de la réflexion. » La mise en cache implicite réduit de 95% la majeure partie des coûts d’entrée, mais les étapes restent comptabilisées dans l’utilisation. Le travail effectué est également facturé en cas d’échec ou d’annulation de l’exécution : « Les segments terminés sont facturés à la fin de chaque segment, même si un segment ultérieur échoue ou est annulé », et « Vous payez tout le travail effectué avant la fin de l’interaction ».
L’ancrage a son propre compteur
Sur le service natif de Google, l’ancrage avec Google Search comprend 5,000 requêtes gratuites par mois, partagées entre Gemini 3 et les versions ultérieures, puis coûte 14 $ par tranche de 1,000, avec un plafond de 1,500 par jour. AIHubMix n’a pas documenté l’ancrage pour Carbon.
La note de bas de page Vertex ne concerne que le fournisseur
La page tarifaire Vertex de Google ajoute une règle : les complétions de plus de 32K tokens sont facturées en fonction de l’utilisation des tokens récupérables, même si la requête échoue à cause d’un délai d’expiration côté client ou serveur. Cette règle entre en vigueur le 13 novembre 2026. Il s’agit d’une règle du fournisseur ; son application par le fournisseur VertexAI d’AIHubMix n’a pas été publiée. Renseignez-vous avant de le supposer.
Le 1 décembre, tous les tarifs doublent
| Tarif | Jusqu’au 30 novembre | À partir du 1 décembre |
|---|---|---|
| Entrée | 2 $ par 1M | 4 $ par 1M |
| Sortie | 10 $ par 1M | 20 $ par 1M |
| Lecture de contenu mis en cache | 0.10 $ par 1M | 0.20 $ par 1M |
Carbon et Argon partagent les tarifs de lancement ; tous les tarifs doublent le 1 décembre. AIHubMix affiche aujourd’hui les tarifs de lancement et n’a pas publié ses tarifs après décembre. Tenez le doublement pour certain et le tarif de la passerelle pour inconnu, et vérifiez les deux avant d’arrêter un budget.
Agents avec de véritables autorisations
Pour les appels natifs Google, le guide Carbon recommande de privilégier les tours d’exécution séquentielle des outils. Avec cette méthode, effectuez un appel à la fois. Le guide Gemini d’AIHubMix documente tool_choice="auto", mais la prise en charge des outils Carbon et le comportement de forçage d’outil sur la passerelle ne sont pas confirmés.
L’historique ne doit pas se terminer par un tour du modèle, et les tours du modèle préremplis ne sont pas pris en charge. Si le résultat d’un outil est manquant, envoyez un tour utilisateur demandant l’étape suivante.
La fiche du modèle signale des ralentissements ou des délais d’expiration occasionnels, ainsi qu’une consommation accrue de tokens aux niveaux supérieurs ; la date limite des connaissances est mars 2026. Avec un accès en écriture, le véritable risque est le délai d’expiration : une exécution qui dépasse la limite du client peut laisser derrière elle un travail partiel, et les segments terminés sont tout de même facturés.
Outils de codage : consultez la page du modèle avant de configurer quoi que ce soit
La fiche Carbon d’AIHubMix ne documente que Chat Completions, et Carbon ne figure pas encore dans l’index public des modèles. Claude Code nécessite Anthropic Messages ; Codex nécessite Responses. La prise en charge de l’un ou l’autre avec Carbon sur AIHubMix n’est pas confirmée. Ne partez pas du principe que l’un ou l’autre fonctionne : ouvrez la page du modèle Carbon indiquée plus haut et vérifiez la liste des protocoles. Si seul Chat Completions apparaît, utilisez un client compatible avec OpenAI ou patientez.
La forme de la requête est la même que pour Argon, mais la disponibilité des protocoles diffère : actuellement, AIHubMix ne documente Carbon que pour Chat Completions. L’article sur Claude Code décrit ANTHROPIC_BASE_URL, ANTHROPIC_AUTH_TOKEN et API_TIMEOUT_MS ; l’article sur Codex décrit le bloc fournisseur, wire_api et model_reasoning_effort. Ce qui change, c’est la disponibilité du protocole.
| Client | Protocole requis | Carbon sur AIHubMix |
|---|---|---|
| Claude Code | Anthropic Messages | Non documenté |
| Codex | Responses API | Non documenté |
| OpenAI SDK | Chat Completions | Documenté |
Paramètres :
- ID du modèle :
gemini-4-carbon. - Réflexion : faible, moyen, élevé ; moyen par défaut.
- Correspondance du niveau : champ natif
thinking_level, champ de compatibilitéreasoning_effort; Google associe les valeurs du niveau de raisonnement, mais AIHubMix n’a pas publié la correspondance pour Carbon. Faites un essai. - Contexte : 1,048,576 chez Google ; AIHubMix n’a pas publié de limite pour Carbon, ne vous basez donc pas sur la valeur du fournisseur.
- Problèmes connus : premier token lent en niveau élevé, recommandation du fournisseur de privilégier les tours d’outils séquentiels, plafond prudent non vérifié de 65,536 tokens en sortie sur AIHubMix, et date limite des connaissances de mars 2026.
Test rapide, 10–15 minutes :
- Choisissez un petit dépôt avec un test unitaire en échec et une commande de test qui s’exécute en moins d’une minute.
- Définissez le modèle sur
gemini-4-carbon,max_tokenssur 65,536 ou moins, et le délai d’expiration HTTP sur au moins 15 minutes. - Demandez à l’outil d’effectuer la modification la plus simple pour que le test réussisse, puis lancez la commande de test et examinez le diff.
- Réussite : la modification est minimale et le test passe en 10–15 minutes. Échec : notez s’il s’agissait d’une erreur 400, d’une réponse incomplète, d’un délai d’expiration ou d’une mauvaise modification ; chacune nécessite une solution différente, indiquée plus haut.
- Si l’outil permet de choisir le niveau, testez les niveaux moyen et élevé, puis conservez celui qui termine dans le délai imparti.
Liste de vérification avant la première requête en production
- ID du modèle défini sur
gemini-4-carbon. - Ni
temperature, nitop_p, nitop_k. - Ni
frequency_penalty, nipresence_penalty; gardezcandidate_countà 1 ou omettez-le. max_tokensdéfini sur 65,536 ou moins.- Les requêtes en arrière-plan natives Google envoient
store=trueet unmax_output_tokensexplicite ; AIHubMix n’a pas documenté cette méthode. - Délai d’expiration HTTP de 15 minutes ou plus ; streaming recommandé.
- Utilisez
reasoning_effortouthinking_level, mais pas les deux. - Privilégiez les tours d’outils séquentiels avec l’API native Google ; AIHubMix documente
tool_choice="auto", mais la prise en charge de Carbon n’est pas confirmée. - Pas d’appels explicites au cache ; le préfixe stable du prompt vient en premier.
- Le budget inclut les tokens de réflexion et chaque étape de décodage long.
- Tarifs du 1er décembre vérifiés avec la personne responsable du budget.
- Outil de codage vérifié sur la page du modèle avant configuration.
FAQ
Faut-il modifier le corps de la requête en passant d’Argon à Carbon ?
Non. Le schéma est inchangé. Modifiez l’ID du modèle, vérifiez les valeurs et supprimez les champs qui renvoient désormais une erreur 400.
Pourquoi max_output_tokens renvoie-t-il une erreur 400 ?
L’API native Carbon de Google rejette les valeurs supérieures à 1,048,576. Le chemin Chat Completions d’AIHubMix a une recommandation prudente distincte : gardez max_tokens à 65,536 ou moins, jusqu’à ce qu’une limite supérieure soit documentée. Une valeur basse tronque plutôt la réflexion, ce qui est pire : la réponse peut être incomplète et tout de même facturée.
Pourquoi la réponse est-elle vide ?
Si le statut indique une réponse incomplète, le texte peut être vide parce que le modèle était encore en train de réfléchir. Le travail vous est facturé. Augmentez la limite et réessayez.
Pourquoi une requête en arrière-plan s’arrête-t-elle à 64K ?
Sur le chemin natif en arrière-plan de Google, si max_output_tokens est omis, le serveur s’arrête à 64K. Définissez explicitement la limite ; le décodage long natif peut atteindre 1,048,576 moins les tokens d’entrée. AIHubMix n’a pas documenté le mode arrière-plan.
temperature est-il pris en compte ?
Non. temperature, top_p et top_k sont ignorés. Les pénalités et les valeurs de candidate_count supérieures à 1 renvoient plutôt une erreur 400.
Carbon coûtera-t-il deux fois plus cher le 1er décembre ?
Les tarifs de Google doublent : l’entrée passe de $2 à $4, la sortie de $10 à $20, et les lectures depuis le cache de $0.10 à $0.20. AIHubMix n’a pas publié ses tarifs après le 1er décembre ; confirmez-les donc avant d’engager un budget.
Peut-on utiliser Claude Code ou Codex avec Carbon ?
Ce n’est pas confirmé. AIHubMix documente Chat Completions pour Carbon ; Claude Code nécessite Anthropic Messages et Codex nécessite Responses. Consultez d’abord la page du modèle.
Poursuivez votre lecture : la série Gemini 4 Carbon
- Si la migration est en cours et que la question restante est de savoir si Carbon justifie vraiment son prix, cette comparaison met côte à côte les mêmes tarifs de lancement.
Gemini 4 Carbon vs Argon : même prix, quand Carbon en vaut-il la peine ? - Si vous choisissez un agent de codage plutôt que de migrer un endpoint, cette comparaison directe porte sur l’utilisation des outils et le coût par tâche.
Gemini 4 Carbon vs Fable 5.2 : lequel choisir pour le codage agentique ?