

Les 2026-11-03/04, la suite complète APB a été exécutée sur DeepSeek V4.1 Flash 1017 auprès de cinq fournisseurs via AIHubMix. Les mêmes questions, paramètres et scripts de requête ont été utilisés pour chaque fournisseur ; les cinq entrées des fournisseurs figurent sur la page des modèles. Ce profil APB couvre uniquement le canal officiel de DeepSeek. Il est accessible via la route du fournisseur officiel DeepSeek d’AIHubMix, et non par une connexion directe à l’API de DeepSeek.
Cet article présente uniquement les scores, sans classer les fournisseurs ni en recommander un : Q 42.45, F 94.00, P 86.14, K 98.38 et R 100. Q, F, P et R sont les scores des quatre sections ; K est un sous-score de P. Le score global, 73.76, est un indice récapitulatif, pas une certification, et ne comporte pas d’intervalle de confiance. La norme de notation est l’AIHubMix Provider Benchmark Standard v2.0.
Scores des cinq fournisseurs
Le fournisseur de cet article est indiqué en gras. L’ordre des fournisseurs est fixe et ne constitue pas un classement. K est un sous-score de P, pondéré à 20 %, indiqué séparément à titre de référence. Le score global est un indice récapitulatif sans intervalle de confiance. Le canal officiel de DeepSeek et Alibaba Cloud ont un écart de 0.37 au score global et ne peuvent pas être distingués.
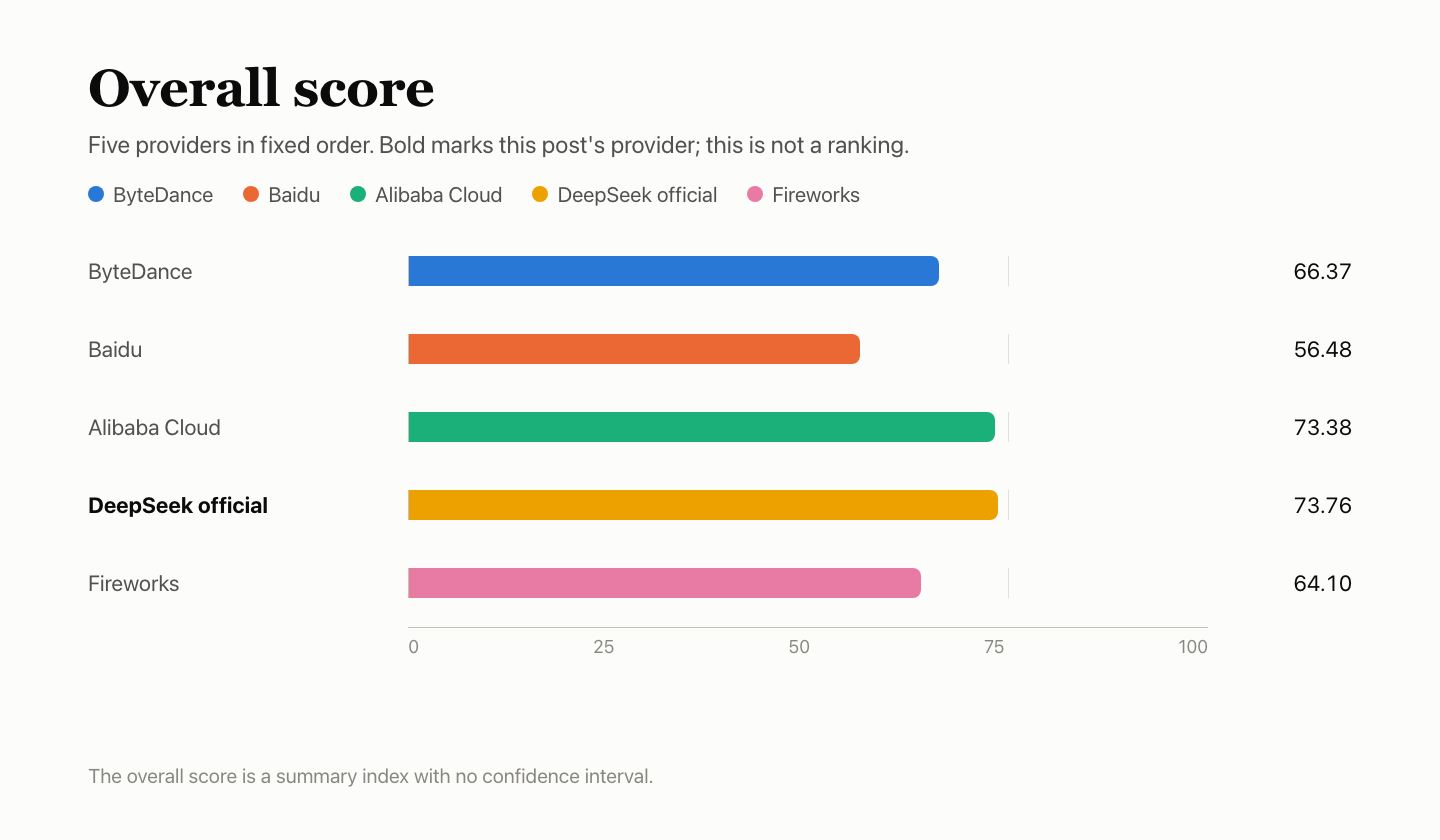
En bref
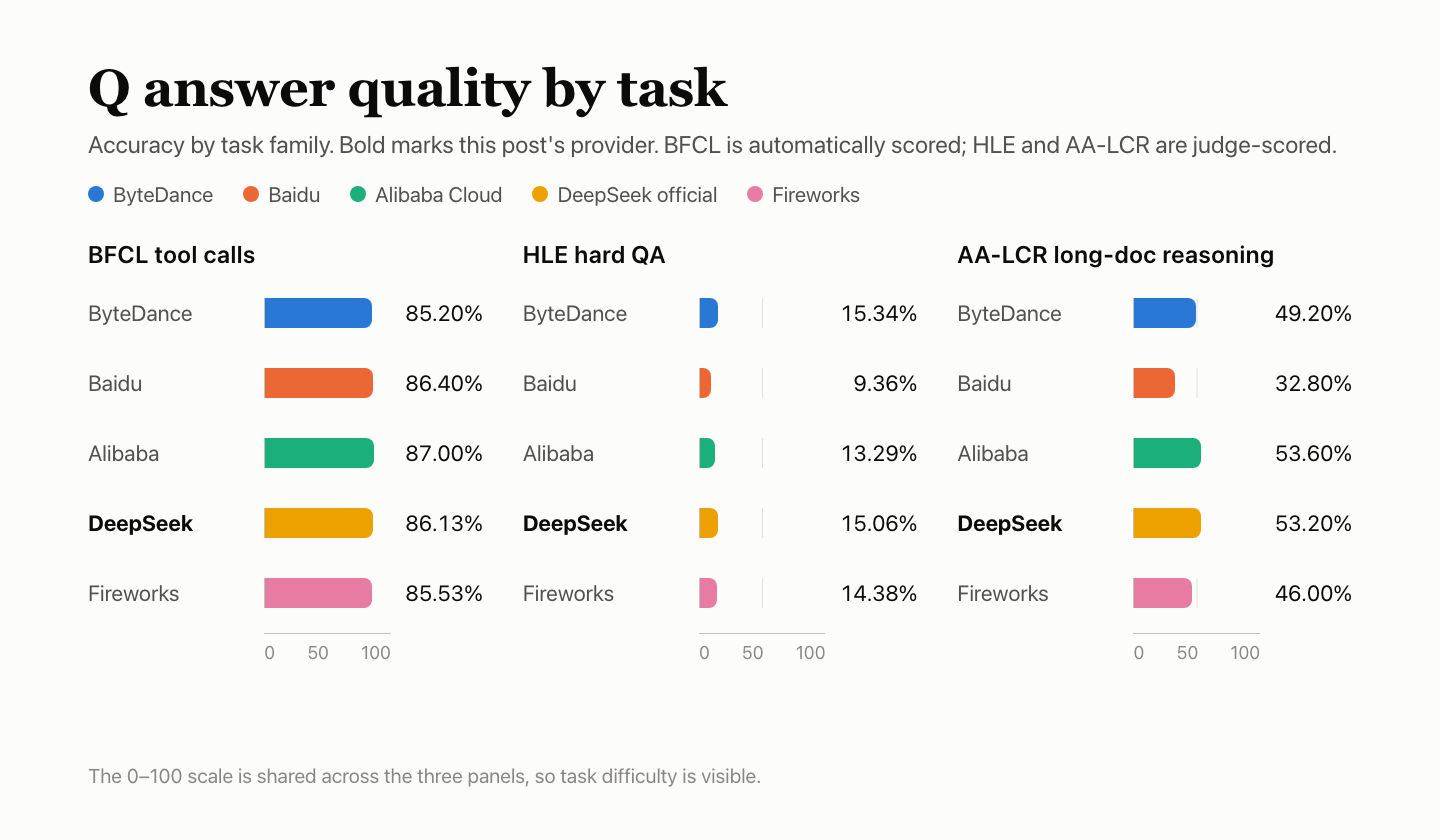
- Qualité des réponses : Q 42.45. BFCL 86.13 %, HLE 15.06 %, AA-LCR 53.20 %. Sept sorties HLE ont été tronquées à la limite max_tokens et considérées comme incorrectes. Ce canal constitue la référence Q pour les quatre autres.
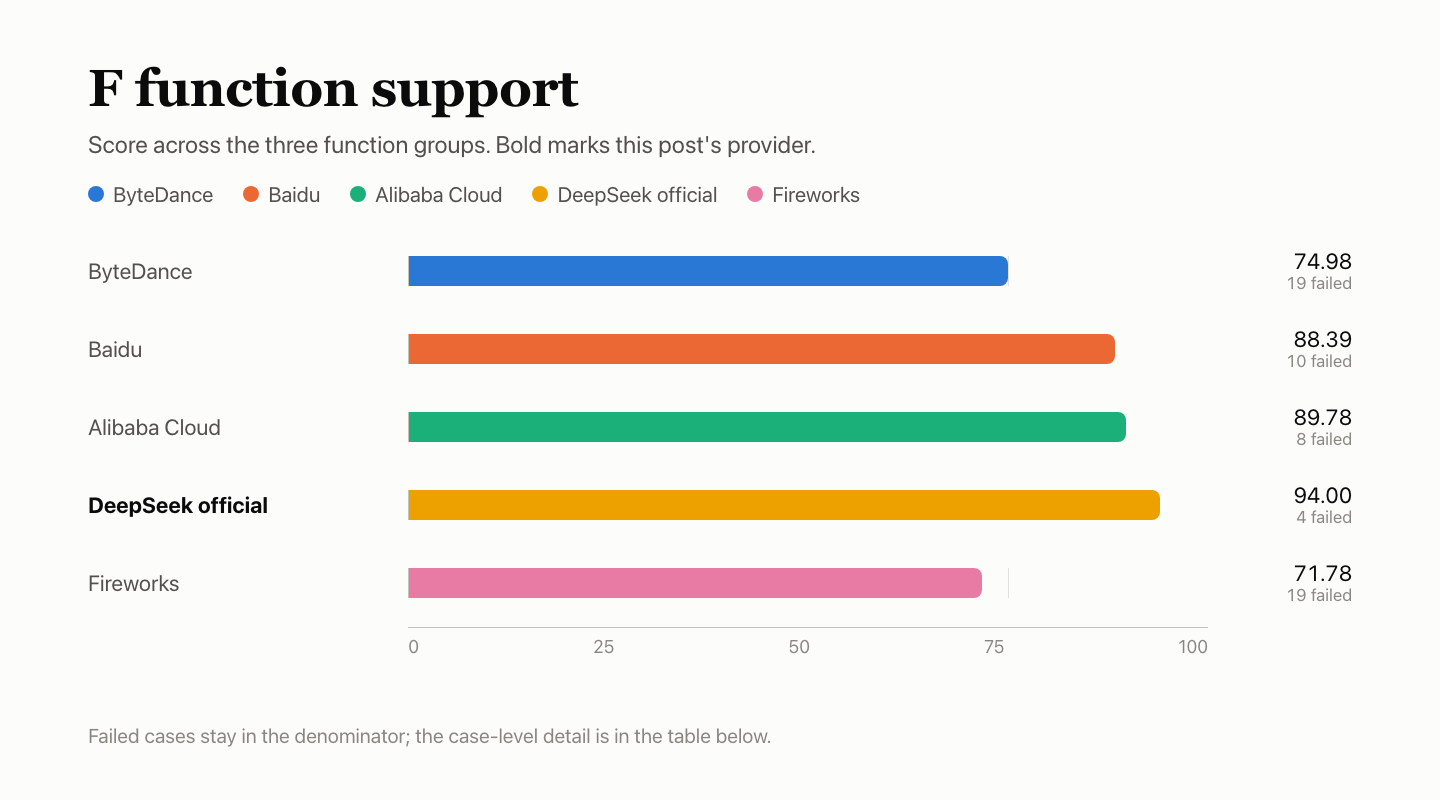
- Prise en charge des fonctions : F 94.00. 137 des 147 vérifications comptabilisées ont réussi. 27 autres vérifications dépendant du décompte exact des tokens ont été déclarées invalides et exclues du dénominateur.
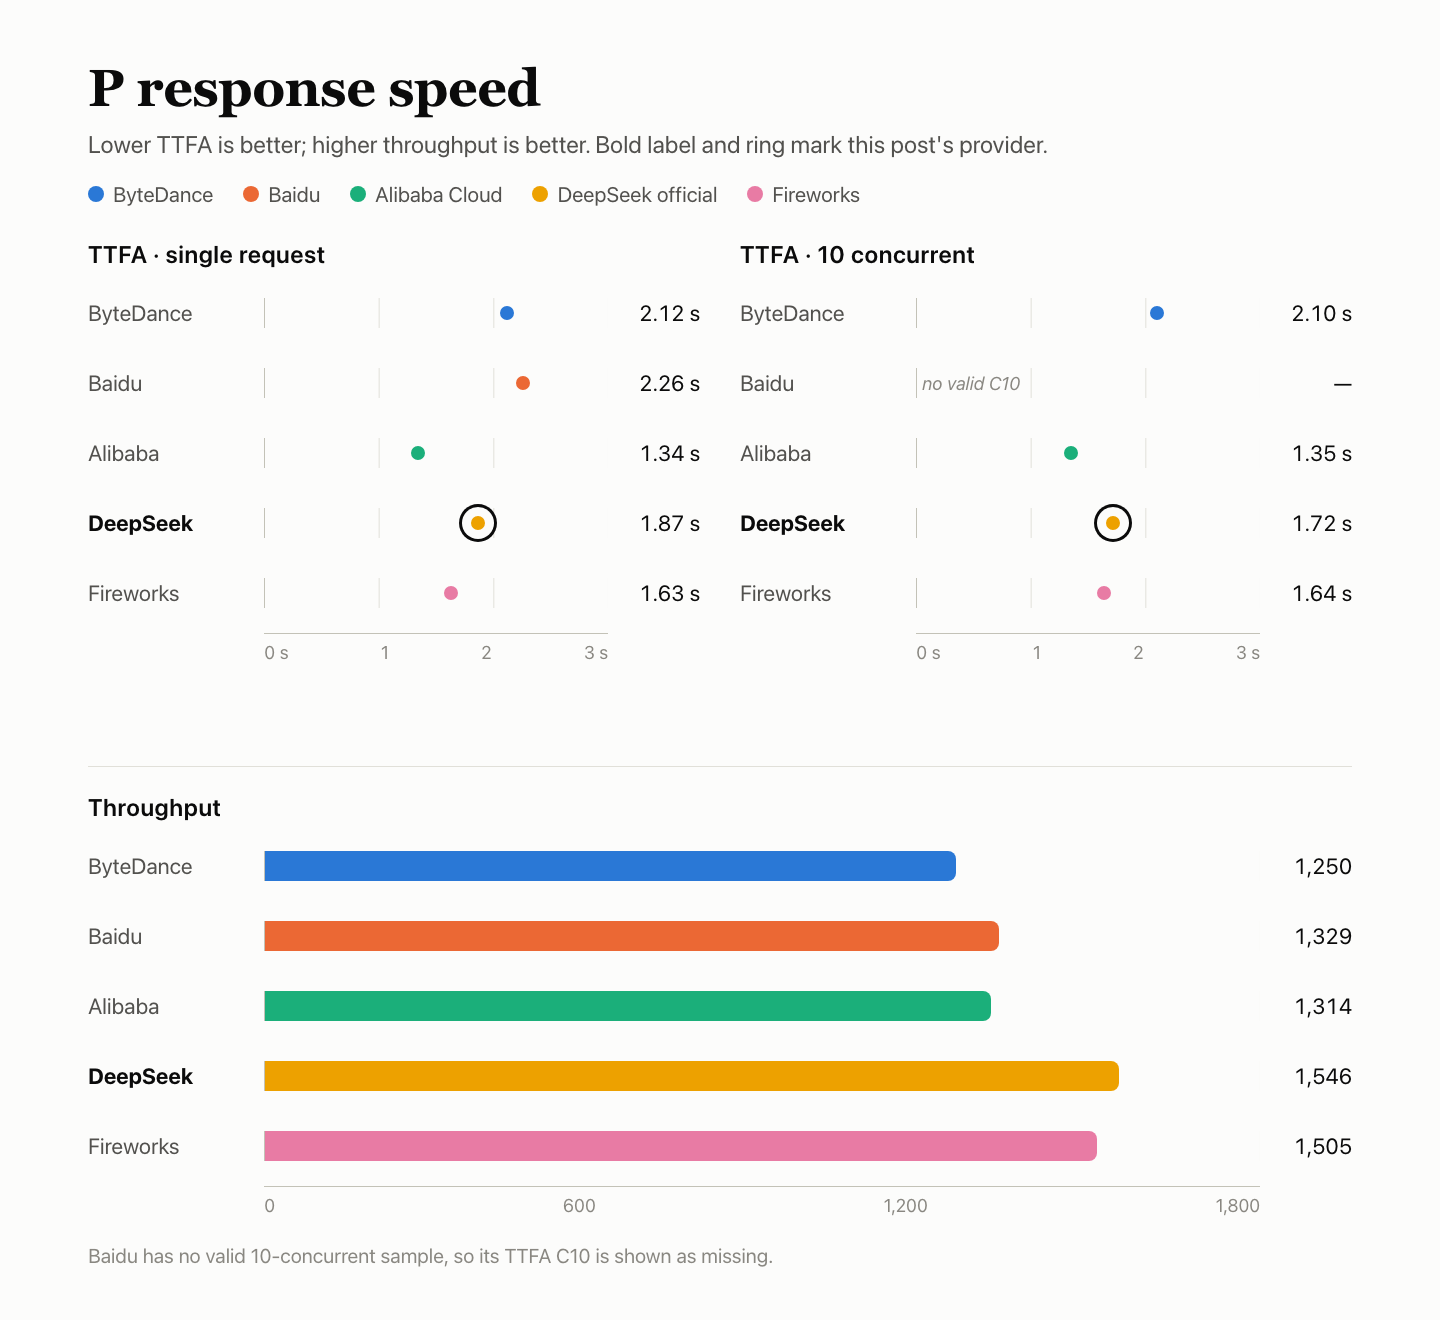
- Vitesse de réponse : P 86.14. La première fenêtre à concurrence unique a enregistré 15 requêtes invalides sur 30 (12 × 503, 2 × délai dépassé, 1 × expiration du délai de lecture), comptabilisées comme infinies ; médiane du délai jusqu’au premier token : 1.87 s (1.72 s pour les requêtes valides uniquement) ; 1.72 s à 10 requêtes simultanées ; TPOT : 2.84 ms.
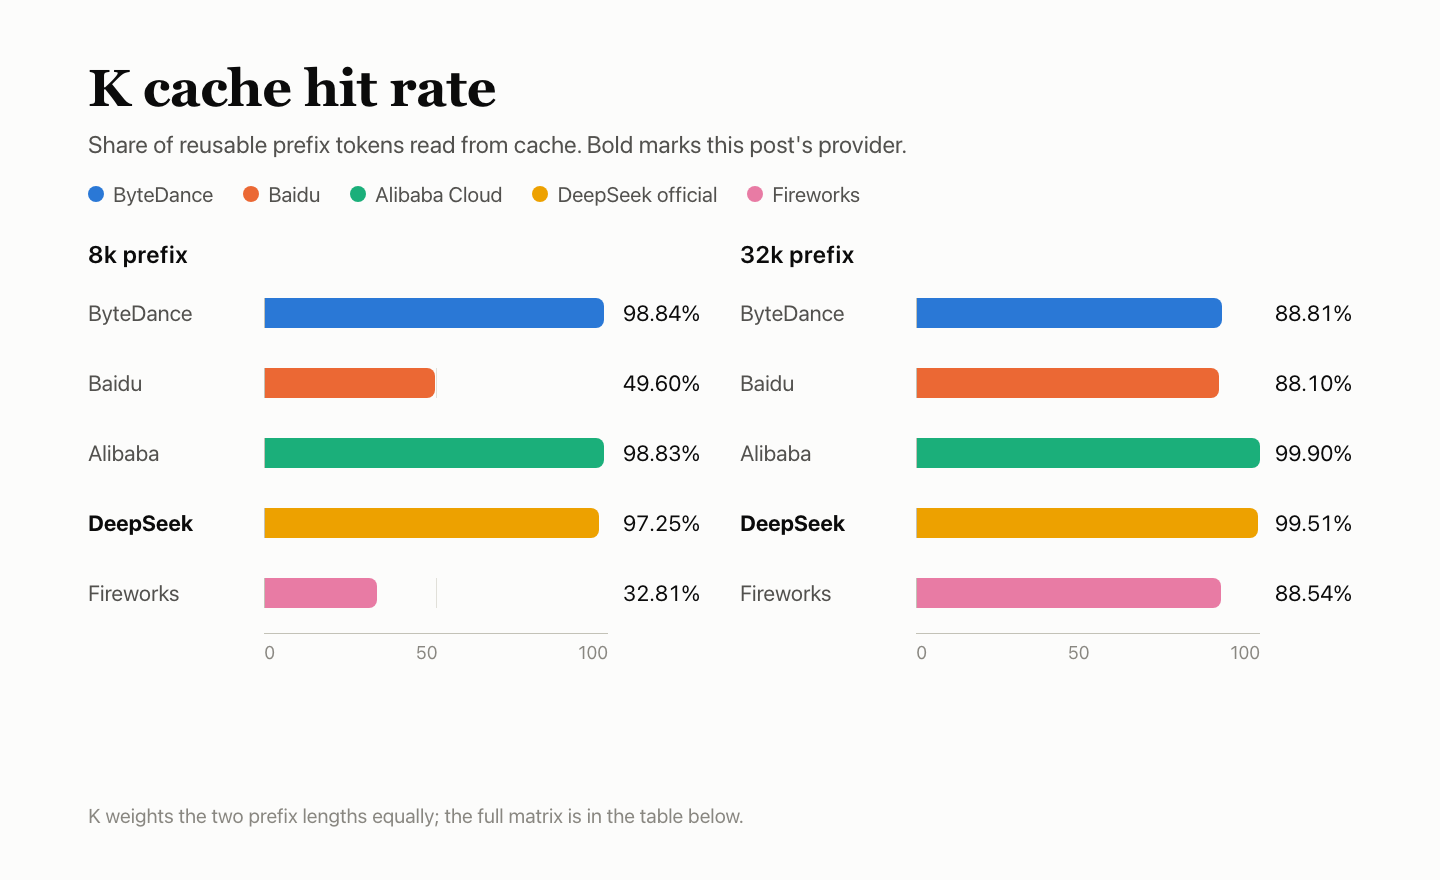
- Cache : K 98.38. Les 18 requêtes avec cache actif aux préfixes de 8k et 32k ont toutes été détectées comme des hits ; les contrôles à froid n’ont lu aucun cache.
- Stabilité du service : R 100. Les 300 requêtes dédiées ont toutes réussi dès la première tentative.
Configuration des tests
Les requêtes ont transité par AIHubMix en sélectionnant la route du fournisseur officiel DeepSeek ; le guide de démarrage rapide explique la configuration de l’accès.
| Élément | Détail |
|---|---|
| Modèle | DeepSeek V4.1 Flash 1017 |
| ID du modèle demandé | deepseek-flash |
| Nom du modèle renvoyé | deepseek-flash |
| Route d’accès | Route du fournisseur officiel DeepSeek d’AIHubMix ; pas de connexion directe à l’API de DeepSeek |
| Paramètres | Mode sans réflexion, temperature 1.0, max_tokens 16,384, délai d’expiration 300 s, aucune nouvelle tentative automatique |
| Réflexion désactivée | Toutes les requêtes utilisaient reasoning_effort=none |
| Période | 2026-11-03 18:07 – 11-04 16:33 UTC+8 ; les cinq fournisseurs partageaient un Mac mini, un réseau et un compte |
| Échantillons | Qualité des réponses : 4,250 tentatives (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10) ; cas de fonctions : 60 × 3 fenêtres ; vitesse : 90 à concurrence unique et 90 à 10 requêtes simultanées ; stabilité : 300 ; cache : 30 (trois groupes chacun pour les préfixes de 8k et 32k) |
Q — qualité des réponses : 42.45
La suite regroupe BFCL 500 questions × 3 passages, HLE 250 × 10 et AA-LCR 25 × 10. BFCL est évalué par des règles automatiques ; HLE et AA-LCR sont évalués par le modèle juge deepseek-flash. Les cinq fournisseurs ont répondu aux mêmes questions. Dix réponses n’ont pas pu être évaluées et ont été retirées, laissant 4,240 tentatives notées.
| Benchmark | Questions | Correctes | Précision | Échecs |
|---|---|---|---|---|
| Appels d’outils BFCL | 500 × 3 | 1,292/1,500 | 86.13% | 0 |
| Questions-réponses difficiles HLE | 250 × 10 | 375/2,490 | 15.06% | 7 |
| Raisonnement sur des documents longs AA-LCR | 25 × 10 | 133/250 | 53.20% | 0 |
| Total · IC à 95 % : 40.08 %–44.73 % | 4,240 réponses notées | 1,800/4,240 | 42.45% | 7 |
Les défaillances du service — une requête échouée ou une sortie tronquée — restent dans le dénominateur et sont comptabilisées comme incorrectes. Ici, cela correspond à sept sorties HLE ayant atteint la limite max_tokens. BFCL est évalué automatiquement ; HLE et AA-LCR le sont par un modèle juge.
Les dénominateurs BFCL sont les totaux sur trois passages.
| Catégorie BFCL | Réussites | Taux de réussite |
|---|---|---|
| simple_python — une fonction, appel et arguments corrects | 334/360 | 92.78% |
| multiple — choisir la bonne fonction parmi plusieurs | 268/300 | 89.33% |
| parallel — appeler plusieurs fois la même fonction en parallèle | 271/300 | 90.33% |
| parallel_multiple — appeler plusieurs fonctions différentes en parallèle | 207/240 | 86.25% |
| irrelevance — aucune fonction n’est pertinente, aucune ne doit être appelée | 113/150 | 75.33% |
| ahm_multi_turn — chaîne d’outils en trois étapes | 99/150 | 66.00% |
Comparaison avec les quatre autres
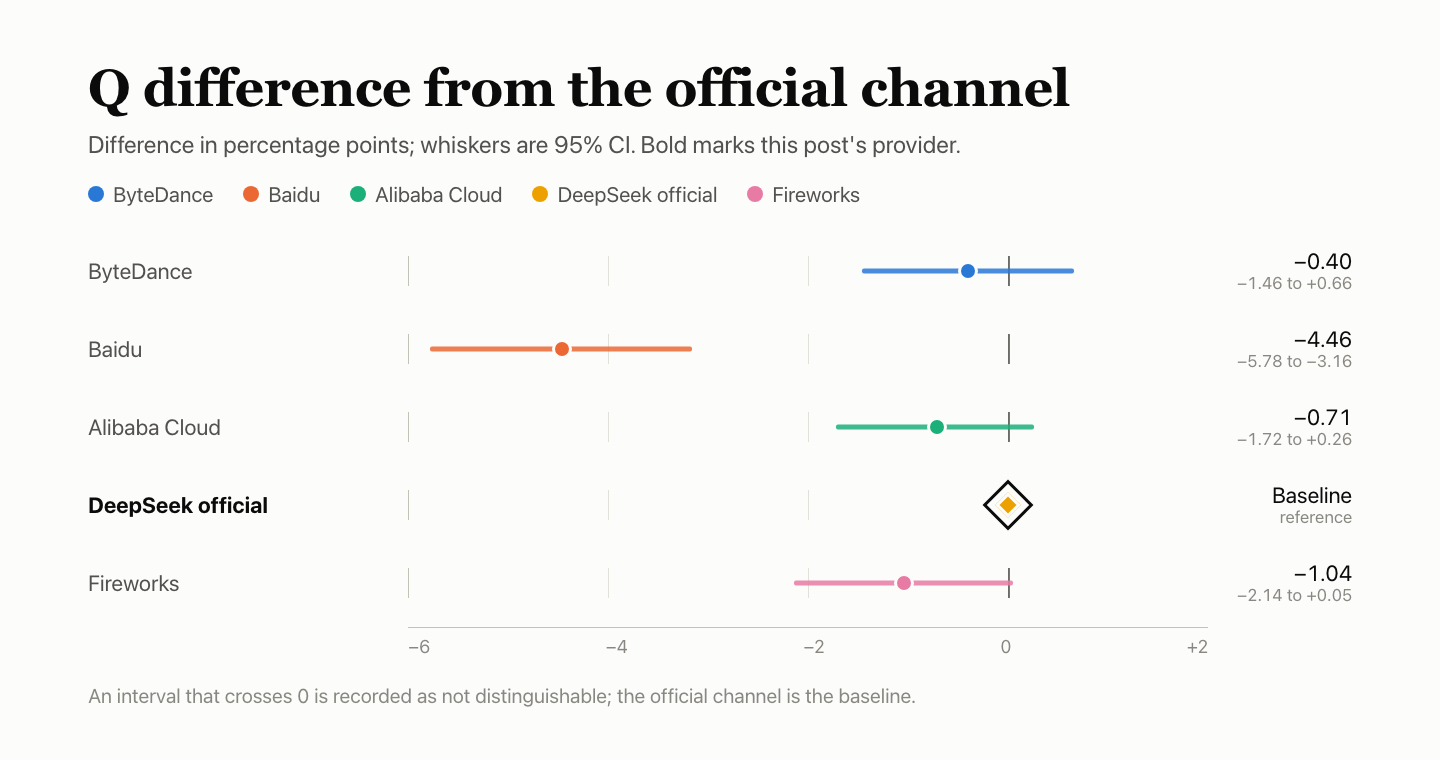
Chaque écart est exprimé en points de pourcentage par rapport à cette référence, avec un intervalle à 95 % représenté par des barres d’erreur ; un intervalle qui traverse 0 signifie que les résultats ne sont pas distinguables. Le modèle juge appartient à la même famille DeepSeek que le modèle testé et n’a pas été calibré ; l’évaluation de HLE et AA-LCR peut donc être indulgente.
F — prise en charge des fonctions : 94.00
Les cas de fonctions testent le comportement du protocole, et non la qualité des réponses. Soixante cas répartis en six groupes ont été exécutés lors de chacune des trois fenêtres — 180 vérifications — et évalués selon le format indiqué dans la documentation de chaque fournisseur. Les vérifications sans objet, invalides ou non observées sont exclues du dénominateur. Ce canal a réussi 137 des 147 vérifications comptabilisées, pour un score pondéré de 94.00 ; le score pondéré n’est pas simplement égal à 137/147.
| Groupe | Pondération | Réussites | Exclues | Score du groupe |
|---|---|---|---|---|
| Streaming et protocole de messages | 20% | 27/27 | 3 | 100.00 |
| Interface d’outils | 20% | 30/30 | — | 100.00 |
| Contraintes de sortie et paramètres | 20% | 30/30 | — | 100.00 |
| Contexte et état | 15% | 14/15 | 15 | 93.33 |
| Erreurs et récupération | 15% | 24/30 | — | 80.00 |
| Comptabilisation et protocole de cache | 10% | 12/15 | 15 | 80.00 |
| Total · pondéré | — | 137/147 | 33 | 94.00 |
Le score pondéré suit les pondérations des groupes ; il ne correspond pas au nombre de vérifications réussies divisé par 147.
| Cas échoué | Fenêtres en échec | Raison |
|---|---|---|
| Messages mal formés (Erreurs et récupération) | 3/3 | 400 renvoyé, mais le corps était vide, sans description structurée de l’erreur |
| stream_options mal formé (Erreurs et récupération) | 3/3 | 400 renvoyé, mais le corps était vide, sans description structurée de l’erreur |
| Comptabilisation des tokens de réflexion (Comptabilisation et protocole de cache) | 3/3 | Aucun décompte des tokens de réflexion renvoyé |
| Isolation des requêtes (Contexte et état) | 1/3 | La première étape n’a pas répondu uniquement par STORED, comme requis ; la vérification de l’isolation n’a donc pas pu continuer |
Les vérifications exclues ne sont comptabilisées ni comme réussites ni comme échecs.
| Statut | Cas | Nombre | Raison |
|---|---|---|---|
| Non observé | Séquence d’arrêt du streaming | 3 | La requête de cette étape n’a pas été envoyée après l’étape précédente ; elle n’a donc pas pu être évaluée |
| Invalide | Entrée longue de 10k ; dans la limite de contexte ; entrée longue de 32k ; entrée longue de 100k ; dépassement du contexte ; décompte natif de l’entrée ; définitions d’outils comptabilisées dans l’entrée ; cohérence du décompte de l’entrée avant et après le cache ; cohérence du décompte de l’entrée en streaming et sans streaming | 27 | Le modèle de décompte natif épinglé côté test ne correspondait pas à l’utilisation rapportée par ce canal ; les vérifications dépendant de décomptes exacts ont donc été déclarées invalides et exclues du dénominateur |
| Non applicable | cache_control explicite | 3 | Préalablement répertorié comme non pris en charge par cette interface |
Les 27 vérifications invalides correspondent aux cas de longues entrées, de limite de contexte, de décompte natif et de cohérence du cache de la liste. Comme le modèle épinglé ne correspondait pas à l’utilisation rapportée par ce canal, toutes les vérifications dépendant d’un décompte exact ont été exclues plutôt que notées.
Deux cas ont échoué chez les cinq fournisseurs : messages mal formés et stream_options mal formé. Les deux ont renvoyé une erreur 400 avec un corps vide ; le client n’a donc reçu aucune description structurée de l’erreur. Cette tendance commune semble davantage pointer vers la couche de passerelle AIHubMix, qui nécessite une investigation distincte. La comptabilisation des tokens de réflexion a également échoué chez les cinq fournisseurs, mais pour des raisons différentes : ByteDance et Fireworks ont continué à signaler des tokens de réflexion après la désactivation du mode de réflexion, tandis que les trois autres n’ont renvoyé aucun décompte de tokens de réflexion.
Comparaison avec les quatre autres
P — vitesse de réponse : 86.14
Chaque requête contenait environ 10,000 tokens d’entrée et demandait environ 1,100 tokens de sortie. Lors de chacune des trois fenêtres, 30 requêtes ont été envoyées à concurrence unique et 30 avec 10 requêtes simultanées, soit 180 au total.
| Métrique | Valeur |
|---|---|
| TTFA du premier token | Concurrence unique : médiane de 1.87 s (médiane de 1.72 s pour les requêtes valides). 10 requêtes simultanées : médiane de 1.72 s |
| TPOT | Concurrence unique : 2.84 ms/token. 10 requêtes simultanées : 2.67 ms/token |
| Débit valide (goodput) | 10 requêtes simultanées : 1,546.0 token/s |
| Requêtes valides | Concurrence unique : 75/90 (fenêtre 1 : 15/30) ; 10 requêtes simultanées : 90/90. Invalides : 12 × 503 service_unavailable_error, 2 × délai dépassé, 1 × délai de lecture expiré |
| Scores des composantes | TTFA 51.65, TPOT 100.00, débit 100.00 ; TTFA et TPOT prennent la valeur la plus faible des deux niveaux, avec des pondérations de 35 % / 35 % / 30 % ; score de réponse 83.08 |
| Composition de P | Score de réponse 83.08 à 80 %, cache K 98.38 à 20 % ; P 86.14 |
Les 15 requêtes invalides se sont toutes produites dans la première fenêtre à concurrence unique : 12 ont renvoyé une erreur 503, 2 ont dépassé le délai d’attente et 1 a subi une expiration du délai de lecture. Les requêtes invalides étant comptabilisées comme infinies, la médiane rapportée est de 1.87 s. Pour les requêtes valides uniquement, la médiane est de 1.72 s. Avec 10 requêtes simultanées, la médiane est également de 1.72 s. Le TPOT est de 2.84 ms/token à concurrence unique et de 2.67 ms/token avec 10 requêtes simultanées.
Comparaison avec les quatre autres
Les cinq fournisseurs partageaient un Mac mini, un réseau et un compte. Les trois fenêtres ont été planifiées fournisseur par fournisseur ; les périodes de collecte ne se chevauchent donc pas complètement. Il ne faut pas surinterpréter les faibles écarts.
K — cache : 98.38
Chaque groupe envoie cinq requêtes. La première initialise un préfixe fixe de 8k ou 32k. Les requêtes deux à quatre conservent le préfixe et ne modifient que la question finale, à 5, 30 et 120 secondes. La cinquième utilise un nouveau préfixe comme contrôle à froid. Trois fenêtres × deux longueurs donnent 30 requêtes. K correspond au nombre de tokens lus depuis le cache pour les requêtes avec cache actif, divisé par le nombre de tokens réutilisables attendu, chaque longueur comptant pour moitié ; K représente 20 % de P. La documentation de l’API de DeepSeek présente la mise en cache du contexte.
| Préfixe | Fenêtre | Initialisation | +5 s | +30 s | +120 s | Contrôle à froid |
|---|---|---|---|---|---|---|
| 8k | Fenêtre 1 | 0 | 7,808 | 7,808 | 7,808 | 0 |
| 8k | Fenêtre 2 | 0 | 7,808 | 7,808 | 7,808 | 0 |
| 8k | Fenêtre 3 | 0 | 7,808 | 7,808 | 7,808 | 0 |
| 32k | Fenêtre 1 | 0 | 31,872 | 31,872 | 31,872 | 0 |
| 32k | Fenêtre 2 | 0 | 31,872 | 31,872 | 31,872 | 0 |
| 32k | Fenêtre 3 | 0 | 31,872 | 31,872 | 31,872 | 0 |
Les requêtes avec cache actif à 8k ont toutes été détectées comme des hits (9 sur 9) et ont lu 7,808 tokens chacune : 70,272 lus sur 72,261 réutilisables, soit 97.25. Les requêtes à 32k ont toutes été détectées comme des hits (9 sur 9) et ont lu 31,872 tokens chacune : 286,848 sur 288,270, soit 99.51. Les contrôles à froid n’ont lu aucun cache. K s’élève à 98.38 pour les deux longueurs.
Comparaison avec les quatre autres
R — stabilité du service : 100
300 requêtes couvrent le texte court, une entrée longue de 10k, les appels d’outils et l’historique multi-tour ; elles sont envoyées à concurrence unique sur trois fenêtres. Seuls la validité et le caractère complet de la réponse à la première tentative sont vérifiés — pas l’exactitude de la réponse — et aucune nouvelle tentative n’est effectuée. Les échecs en qualité des réponses et en vitesse sont comptabilisés dans Q et P, et non une seconde fois dans R.
| Type de requête | Réussite à la première tentative |
|---|---|
| Texte court | 120/120 |
| Entrée longue de 10k | 90/90 |
| Appels d’outils | 60/60 |
| Historique multi-tour | 30/30 |
| Total · IC à 95 % : 98.78 %–100 % | 300/300 |
Les 300 requêtes ont toutes renvoyé une réponse valide et complète dès la première tentative. R 100 ne couvre que ces 300 requêtes dédiées ; cela ne signifie pas que l'ensemble du parcours n'a connu aucun échec. Avec 300 réussites, la borne inférieure de l'intervalle à 95 % est de 98.78 %, ce qui indique que le taux d'échec est probablement inférieur à 1.22 %.
Comparaison avec les quatre autres
R ne couvre que les 300 requêtes dédiées ; les échecs liés à la qualité des réponses et à la vitesse sont consignés dans Q et P, et ne sont pas comptabilisés une seconde fois dans R.
| Fournisseur | Taux de réussite à la première tentative | IC à 95 % |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek officiel | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
FAQ
S'agit-il d'une connexion directe à l'API de DeepSeek ?
Non. Les requêtes passent par le canal du fournisseur officiel DeepSeek d'AIHubMix ; elles ne sont pas envoyées directement à l'API de DeepSeek.
Pourquoi le canal officiel de DeepSeek sert-il de référence pour Q ?
C'est le canal officiel de DeepSeek pour le même modèle ; les résultats de qualité des réponses des quatre autres fournisseurs sont donc exprimés par rapport à lui. Ce rôle de référence n'implique pas de classement en matière de qualité des réponses.
Que s'est-il passé lors du premier test de vitesse à concurrence unique ?
Quinze des 30 requêtes étaient invalides : 12 ont renvoyé une erreur 503, 2 ont dépassé le délai imparti et 1 a subi un délai d'attente de lecture. Elles sont comptées comme infinies ; la médiane est donc de 1.87 s, contre 1.72 s pour les seules requêtes valides.
À quoi correspondent les 27 vérifications de fonctions invalides ?
Elles dépendent du nombre exact de tokens : entrées longues, limites de contexte, nombres d'entrées natifs et cohérence des entrées en cache. Le modèle de comptage natif fixé côté test ne correspondait pas à l'usage déclaré par ce canal ; ces vérifications ont donc été exclues du dénominateur au lieu d'être comptabilisées comme des échecs.
Pourquoi R 100 ne garantit-il pas l'absence d'échec sur le parcours ?
R ne couvre que les 300 requêtes de stabilité dédiées. Les échecs survenus pendant les tests de qualité des réponses et de vitesse sont consignés dans Q et P. Avec 300 réussites sur 300, la borne inférieure de l'intervalle à 95 % est de 98.78 % ; le taux d'échec est donc probablement inférieur à 1.22 %, mais il n'est pas prouvé qu'il soit nul.
Comment le test du cache distingue-t-il les lectures à chaud des lectures à froid ?
Chaque groupe initialise un préfixe de 8k ou 32k, puis le répète après 5, 30 et 120 secondes en posant une nouvelle question finale, avant d'envoyer un nouveau préfixe comme témoin à froid. Pour les deux longueurs, les 9 requêtes à chaud sur 9 ont été des hits, et chaque lecture témoin à froid a renvoyé zéro token en cache.
Poursuivre la lecture : la série DeepSeek V4.1 Flash
- Le score Q de ByteDance se situe à moins de 0.40 point de cette référence, tandis que ses résultats en matière de prise en charge des fonctions et de cache diffèrent : DeepSeek V4.1 Flash sur ByteDance : les appels d'outils concordent, pas la facturation.
- Baidu a perdu des requêtes à cause de
no_available_channel, ce qui apparaît à la fois dans Q et P : DeepSeek V4.1 Flash sur Baidu : l'absence de canal disponible affecte Q et P. - Alibaba Cloud affiche un écart global de 0.37, non significatif : DeepSeek V4.1 Flash sur Alibaba Cloud : premier token en 1.34s, cache à 99.37.
- Fireworks a obtenu 3 succès sur 9 pour les requêtes à chaud de 8k, contre 9 sur 9 ici : DeepSeek V4.1 Flash sur Fireworks : réponses vides à l'arrêt, 3/9 hits de cache.


