

Les 3 et 4 novembre 2026, DeepSeek V4.1 Flash 1017 a été testé chez cinq fournisseurs via AIHubMix avec la suite APB Full : mêmes questions, mêmes paramètres et mêmes scripts de requête à chaque fois. Ce profil APB porte uniquement sur le test chez Baidu et présente les résultats section par section.
Les chiffres ci-dessous sont uniquement des scores, et non un classement ou une recommandation de fournisseur. Q 38.00, F 88.39, P 37.77, K 68.85 et R 100 sont présentés en premier ; le score global, 56.48, est un indice récapitulatif sans intervalle de confiance. Les règles de notation sont celles de la norme AIHubMix Provider Benchmark Standard v2.0.
Scores des cinq fournisseurs
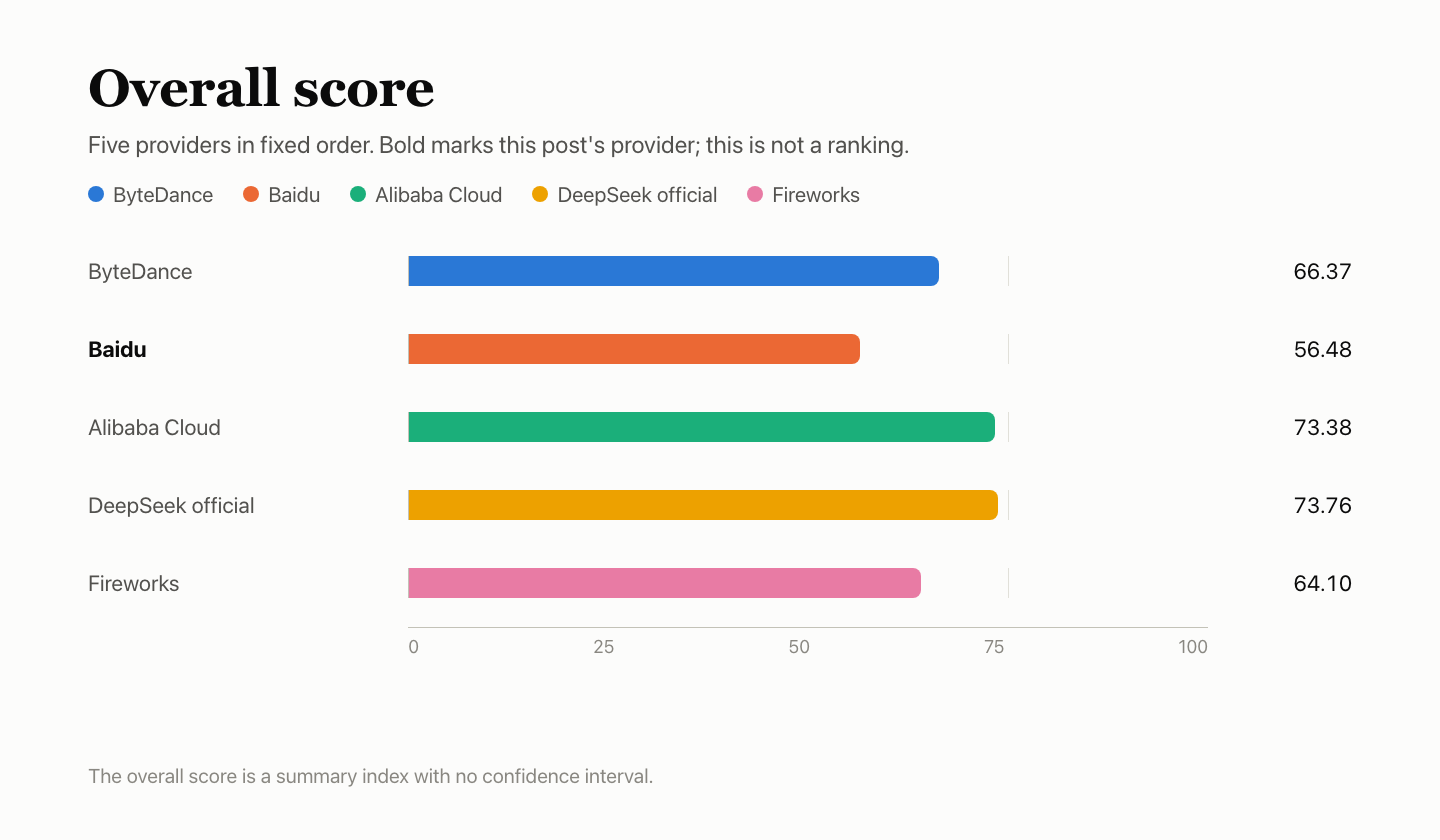
Le gras indique le fournisseur traité dans cet article. Les fournisseurs sont présentés dans un ordre fixe, sans classement. K est un sous-score de P, pondéré à 20 %. Le score global est un indice récapitulatif sans intervalle de confiance. L’écart de 0.37 entre le canal officiel et Alibaba Cloud n’est pas statistiquement discernable.
En bref
- Q : 38.00. BFCL 86.40 %, HLE 9.36 %, AA-LCR 32.80 %. Le résultat combiné est inférieur de 4.46 points à celui du canal officiel, avec un intervalle à 95 % de −5.78 à −3.16 qui exclut 0. HLE a enregistré 864 échecs de requête et AA-LCR, 100, presque tous lors de la première fenêtre ; ils ont été comptabilisés comme des réponses incorrectes.
- F : 88.39. 148 des 174 vérifications comptabilisées ont réussi. Le champ de lecture du cache et le nombre de tokens de réflexion n’ont pas été renvoyés ; les cas de dépassement de contexte et de résultat d’outil orphelin ont renvoyé 200.
- P : 37.77. 50 des 90 tests à 10 requêtes simultanées ont renvoyé
no_available_channel; plus de la moitié étaient donc invalides, et TTFA et TPOT ont été notés à leur valeur de pénalité. Les tests à concurrence simple étaient valides dans 78 cas sur 90. - K : 68.85. Les requêtes à chaud avec un préfixe de 8k ont obtenu un hit 5 fois sur 9, avec 3 échecs de requête ; le préfixe de 32k a obtenu un hit 8 fois sur 9. Les hits sont indiqués par blocs de 1,024 tokens : 7,168 tokens pour 8k et 31,744 pour 32k.
- R : 100. Les 300 requêtes dédiées ont toutes réussi du premier coup. Les échecs de canal survenus pendant les tests de réponse et de vitesse sont comptabilisés dans Q et P.
Configuration du test
Les requêtes ont utilisé la route de démarrage rapide d’AIHubMix avec un ID propre au fournisseur, et les paramètres suivent la documentation de l’API de DeepSeek ; les ID des autres fournisseurs figurent sur la page des modèles. Il ne s’agit pas d’une connexion directe au compte Baidu.
| Champ | Valeur |
|---|---|
| Modèle | DeepSeek V4.1 Flash 1017 |
| ID du modèle demandé | baidu-deepseek-v4.1-flash-1017 |
| Nom du modèle renvoyé | deepseek-v4.1-flash-1017 |
| Route d’accès | Via AIHubMix avec l’ID du modèle propre au fournisseur ; pas de connexion directe au compte du fournisseur |
| Paramètres | Mode sans réflexion, temperature 1.0, max_tokens 16,384, délai d’expiration 300 s, aucune nouvelle tentative automatique |
| Réflexion désactivée | Chaque requête utilisait reasoning_effort=none |
| Période | 2026-11-03 18:07 – 11-04 16:33 UTC+8 ; les cinq fournisseurs partageaient un même Mac mini, réseau et compte |
| Échantillons | 4,250 tentatives de réponse (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10) ; 60 cas de fonction × 3 fenêtres ; 90 tests de vitesse à concurrence simple et 90 à 10 requêtes simultanées ; 300 requêtes de stabilité ; 30 tests de cache (trois groupes chacun pour les préfixes de 8k et de 32k) |
Q — qualité des réponses : 38.00
La qualité des réponses repose sur trois types de tâches : 500 tâches BFCL avec trois réponses chacune, 250 tâches HLE avec dix réponses chacune et 25 tâches AA-LCR avec dix réponses chacune. BFCL est évalué selon des règles automatiques ; le modèle juge deepseek-flash détermine si les réponses HLE et AA-LCR sont correctes ou incorrectes. Les cinq fournisseurs ont reçu le même ensemble de tâches, et les trois types sont regroupés en un seul taux de précision. Dix réponses ont été écartées, car la tâche ne pouvait pas être évaluée, ce qui laisse 4,240 tentatives notées.
| Tâche | Éléments | Correctes | Précision | Échecs |
|---|---|---|---|---|
| Appels d’outils BFCL | 500 × 3 | 1,296/1,500 | 86.40% | 0 |
| Questions difficiles HLE, évaluées par le modèle juge | 250 × 10 | 233/2,490 | 9.36% | 875 |
| Raisonnement sur de longs documents AA-LCR | 25 × 10 | 82/250 | 32.80% | 100 |
| Combiné · intervalle à 95 % : 36.23 %–39.58 % | — | 1,611/4,240 | 38.00% | 975 |
Les défaillances de service, qu’il s’agisse d’une requête échouée ou d’une sortie tronquée, restent dans le dénominateur et comptent comme des réponses incorrectes. HLE a connu 864 échecs de requête (863 dans la première fenêtre, 1 dans la deuxième) et 11 sorties tronquées à la limite max_tokens. AA-LCR a connu 100 échecs de requête, tous dans la première fenêtre.
Chaque tâche BFCL reçoit trois réponses ; le tableau regroupe les résultats des trois séries.
| Catégorie BFCL | Réussites | Taux de réussite |
|---|---|---|
| simple_python : une fonction, appel et arguments corrects | 336/360 | 93.33% |
| multiple : choisir la bonne fonction parmi plusieurs | 269/300 | 89.67% |
| parallel : appeler plusieurs fois une fonction en parallèle | 268/300 | 89.33% |
| parallel_multiple : appeler plusieurs fonctions différentes en parallèle | 206/240 | 85.83% |
| irrelevance : aucune fonction ne convient, ne pas en appeler | 113/150 | 75.33% |
| ahm_multi_turn : chaîne d’outils en trois étapes | 104/150 | 69.33% |
Comparaison avec les quatre autres
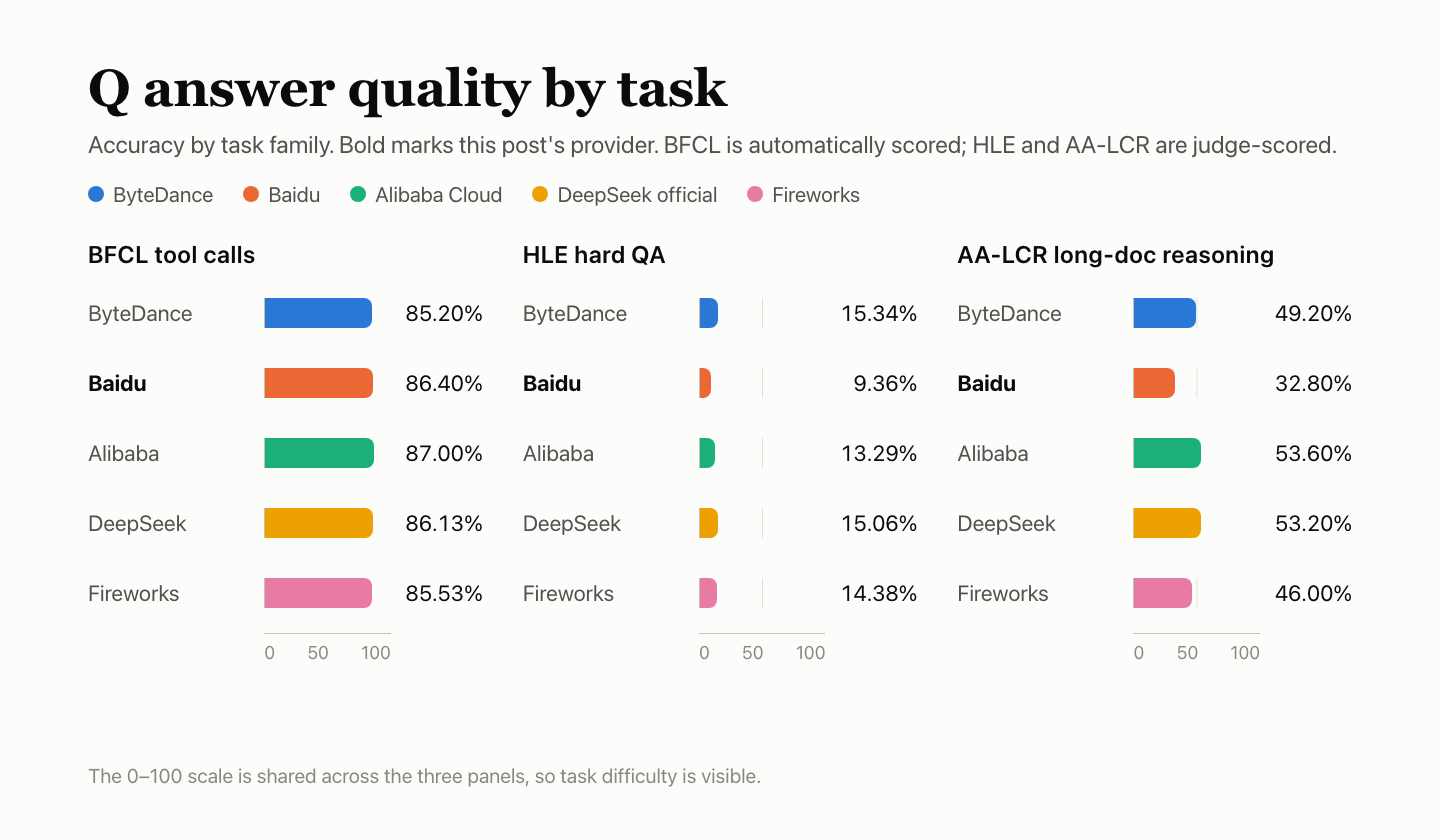
L’écart est exprimé en points de pourcentage par rapport au canal officiel, et l’intervalle à 95 % est représenté par les barres d’erreur. Un intervalle qui croise 0 est considéré comme non discernable. Le modèle juge des tâches HLE et AA-LCR, deepseek-flash, appartient à la même famille DeepSeek que le modèle testé et n’a pas été calibré ; ses évaluations peuvent donc être indulgentes.
F — prise en charge des fonctions : 88.39
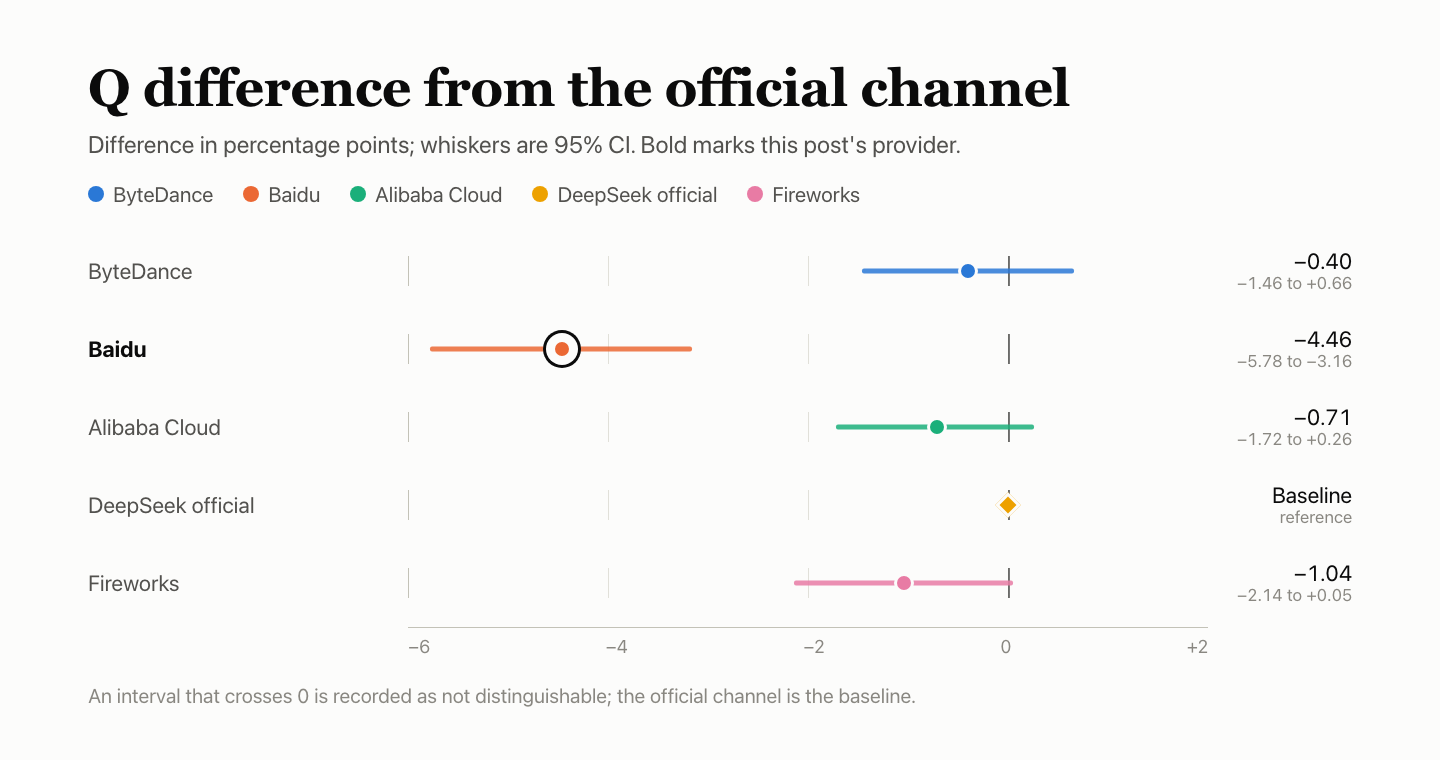
Les cas liés aux fonctions vérifient si l’interface se comporte conformément au protocole, et non si le modèle répond correctement. Soixante cas répartis en six groupes ont été exécutés une fois dans chacune des trois fenêtres, soit 180 vérifications, évaluées selon le format documenté par le fournisseur. Les vérifications non applicables, invalides ou non observées sont exclues du dénominateur. Pour Baidu, 174 vérifications ont été comptabilisées, dont 148 réussies, soit un score pondéré de 88.39.
Le score des groupes est pondéré selon la part de chacun d’eux, et non calculé par une simple division de 148 par 174.
| Groupe de cas | Pondération | Réussites | Exclusions | Score du groupe |
|---|---|---|---|---|
| Streaming et protocole de messages | 20% | 27/27 | 3 | 100.00 |
| Interface d’outil | 20% | 30/30 | — | 100.00 |
| Contraintes de sortie et paramètres | 20% | 29/30 | — | 96.67 |
| Contexte et état | 15% | 26/30 | — | 86.67 |
| Erreur et récupération | 15% | 21/30 | — | 70.00 |
| Protocole de facturation et de cache | 10% | 15/27 | 3 | 55.56 |
| Total pondéré | 100% | 148/174 | 6 | 88.39 |
| Cas en échec | Fenêtres en échec | Motif |
|---|---|---|
| Dépassement de contexte (contexte et état) | 3/3 | Devrait renvoyer une erreur de paramètre ; a renvoyé 200 |
| Messages mal formés (erreur et récupération) | 3/3 | A renvoyé 400 avec un corps vide, sans erreur structurée |
| Résultat d’outil orphelin (erreur et récupération) | 3/3 | Devrait renvoyer une erreur de paramètre ; a renvoyé 200 |
| stream_options mal formé (erreur et récupération) | 3/3 | A renvoyé 400 avec un corps vide, sans erreur structurée |
| Champ de lecture du cache (protocole de facturation et de cache) | 3/3 | Aucun champ de lecture du cache renvoyé ; la lecture ne peut pas être confirmée |
| Comptabilisation des tokens de réflexion (protocole de facturation et de cache) | 3/3 | Aucun nombre de tokens de réflexion renvoyé |
| Définitions d’outils comptabilisées dans l’entrée (protocole de facturation et de cache) | 3/3 | Avec les définitions d’outils, le nombre de tokens d’entrée indiqué n’était pas supérieur à celui sans elles |
| Cohérence du nombre de tokens d’entrée avant et après le cache (protocole de facturation et de cache) | 3/3 | Aucun champ de lecture du cache renvoyé ; la lecture ne peut pas être confirmée |
| Diversité de l’échantillonnage (contraintes de sortie et paramètres) | 1/3 | Les sorties répétées à temperature 0 et 1 différaient trop peu, en dessous du seuil défini à l’avance |
| Isolation entre les requêtes (contexte et état) | 1/3 | La première étape n’a pas renvoyé uniquement STORED comme demandé ; la vérification de l’isolation n’a donc pas pu se poursuivre |
Ces vérifications sont exclues du dénominateur : elles ne sont ni réussies ni échouées.
| État | Cas | Nombre | Motif |
|---|---|---|---|
| Non observé | Séquence d’arrêt du streaming | 3 | La requête correspondant à cette étape n’a pas été envoyée après l’étape précédente ; elle ne peut donc pas être évaluée |
| Non applicable | cache_control explicite | 3 | Défini à l’avance comme non pris en charge par cette interface |
Les messages messages mal formés et les valeurs stream_options mal formées ont échoué chez les cinq fournisseurs : les deux ont renvoyé 400 avec un corps vide, sans fournir d’erreur structurée au client. Un échec partagé par les cinq fournisseurs se situe plus probablement au niveau de la passerelle AIHubMix et nécessite une enquête distincte. La comptabilisation des tokens de réflexion a également échoué chez les cinq fournisseurs, pour des raisons différentes : ByteDance et Fireworks ont indiqué des tokens de réflexion alors que la réflexion était désactivée, tandis que les trois autres n’ont renvoyé aucun nombre de tokens de réflexion.
Comparaison avec les quatre autres
P — vitesse de réponse : 37.77
Chaque requête contenait environ 10,000 tokens d’entrée et demandait un corps d’environ 1,100 tokens de sortie. Sur trois fenêtres, 30 tests à concurrence simple et 30 tests à 10 requêtes simultanées ont été envoyés dans chacune, soit 180 requêtes.
| Métrique | Résultat |
|---|---|
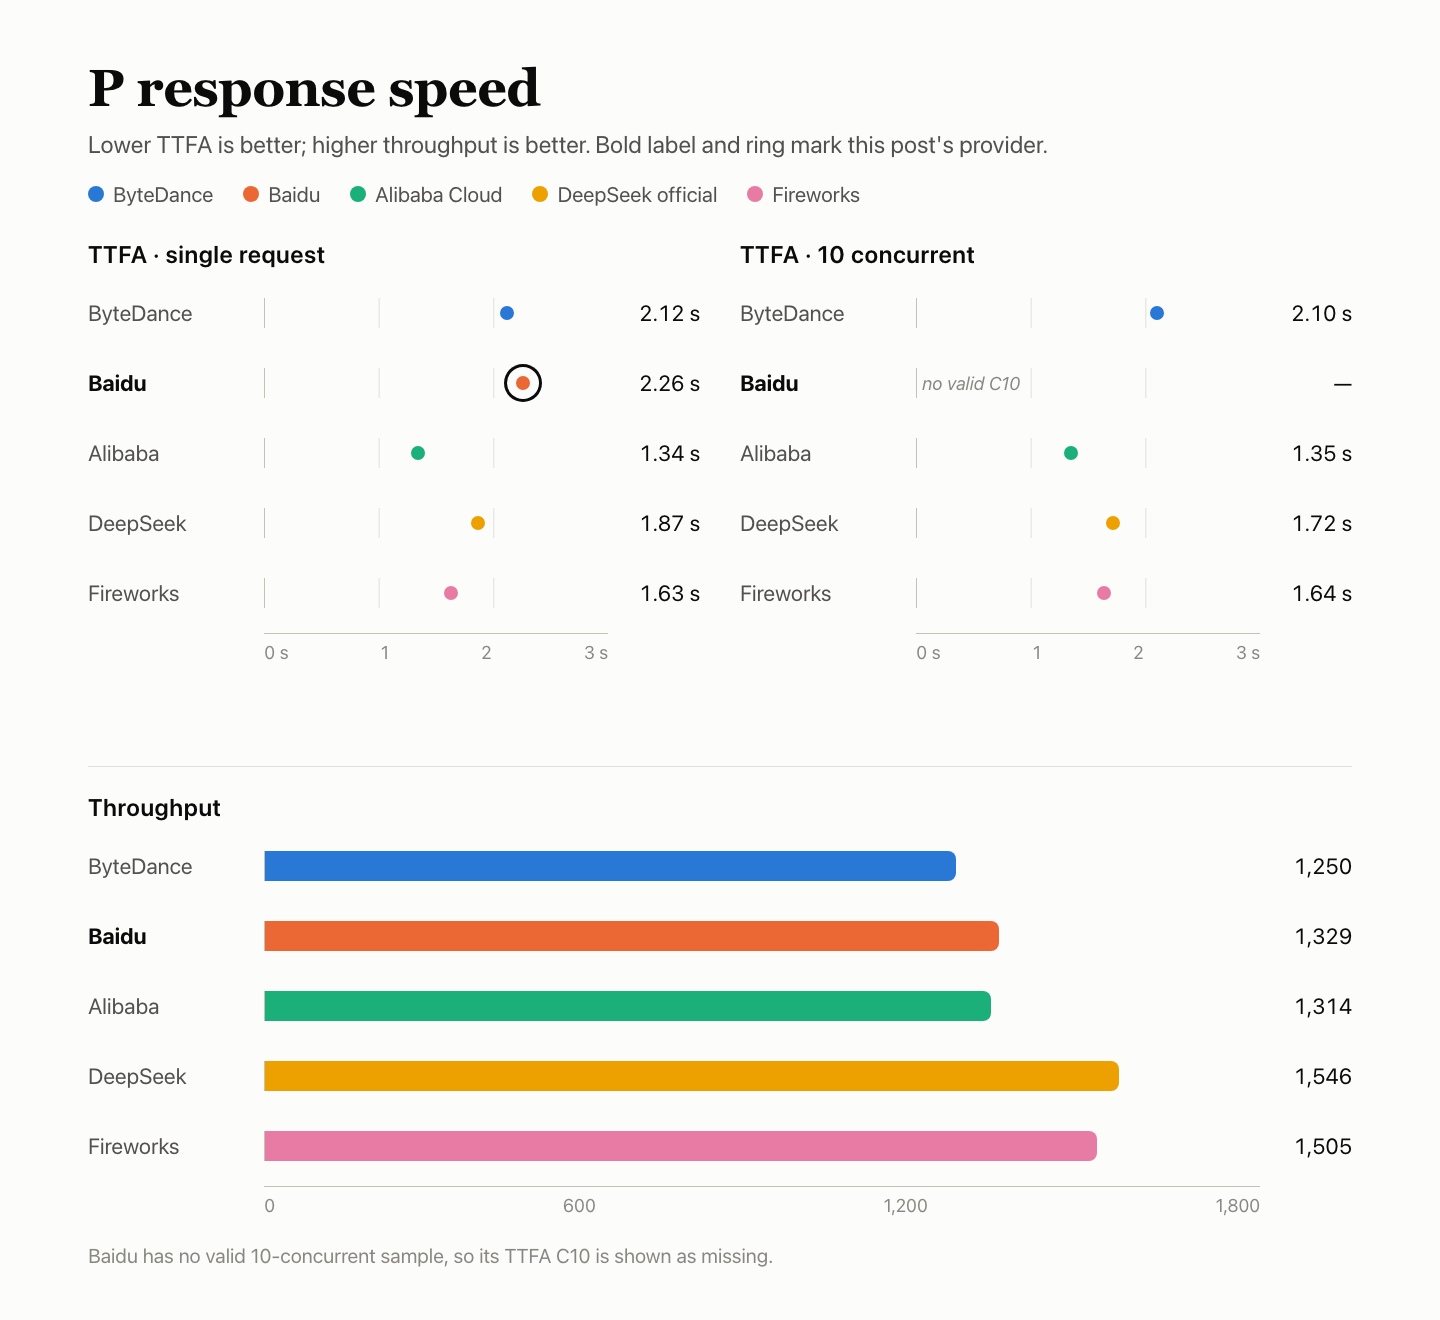
| TTFA du premier token | Concurrence simple : médiane de 2.26 s (médiane des requêtes valides : 2.05 s) ; 10 requêtes simultanées : plus de la moitié des requêtes invalides, médiane comptabilisée comme infinie (médiane des requêtes valides : 1.86 s) |
| Vitesse de génération TPOT | Concurrence simple : 3.48 ms/token ; 10 requêtes simultanées : 50.00 ms/token (plus de la moitié des requêtes invalides, valeur de pénalité) |
| Goodput (débit valide) | 10 requêtes simultanées : 1,329.2 token/s |
| Requêtes valides | Concurrence simple : 78/90 (première fenêtre : 18/30) ; 10 requêtes simultanées : 40/90 (première fenêtre : 0/30, troisième fenêtre : 10/30) |
| Motif d’invalidité | 62 tests ont renvoyé 400 no_available_channel |
| Score des composantes | TTFA 0.00, TPOT 0.00, débit 100.00 ; score de réponse 30.00 |
| Composition de P | Score de réponse 30.00, pondéré à 80 % ; cache K 68.85, pondéré à 20 % ; total 37.77 |
TPOT est estimé à partir des blocs du flux, et non mesuré token par token sur le matériel. Le goodput correspond aux tokens de sortie valides à 10 requêtes simultanées, divisés par le temps écoulé de l’ensemble du lot.
Dans le palier à 10 requêtes simultanées, 50 des 90 tests ont renvoyé no_available_channel. Plus de la moitié étant invalides, le temps médian jusqu’au premier token est considéré comme infini, et TTFA et TPOT prennent tous deux leurs valeurs de pénalité. Au palier à concurrence simple, 78 tests sur 90 sont restés valides.
Les cinq fournisseurs partageaient une même machine, un même réseau et un même compte. Les trois fenêtres ont été planifiées fournisseur par fournisseur ; les périodes de collecte ne se chevauchent donc pas complètement. Il ne faut pas surinterpréter les petits écarts.
K — cache : 68.85
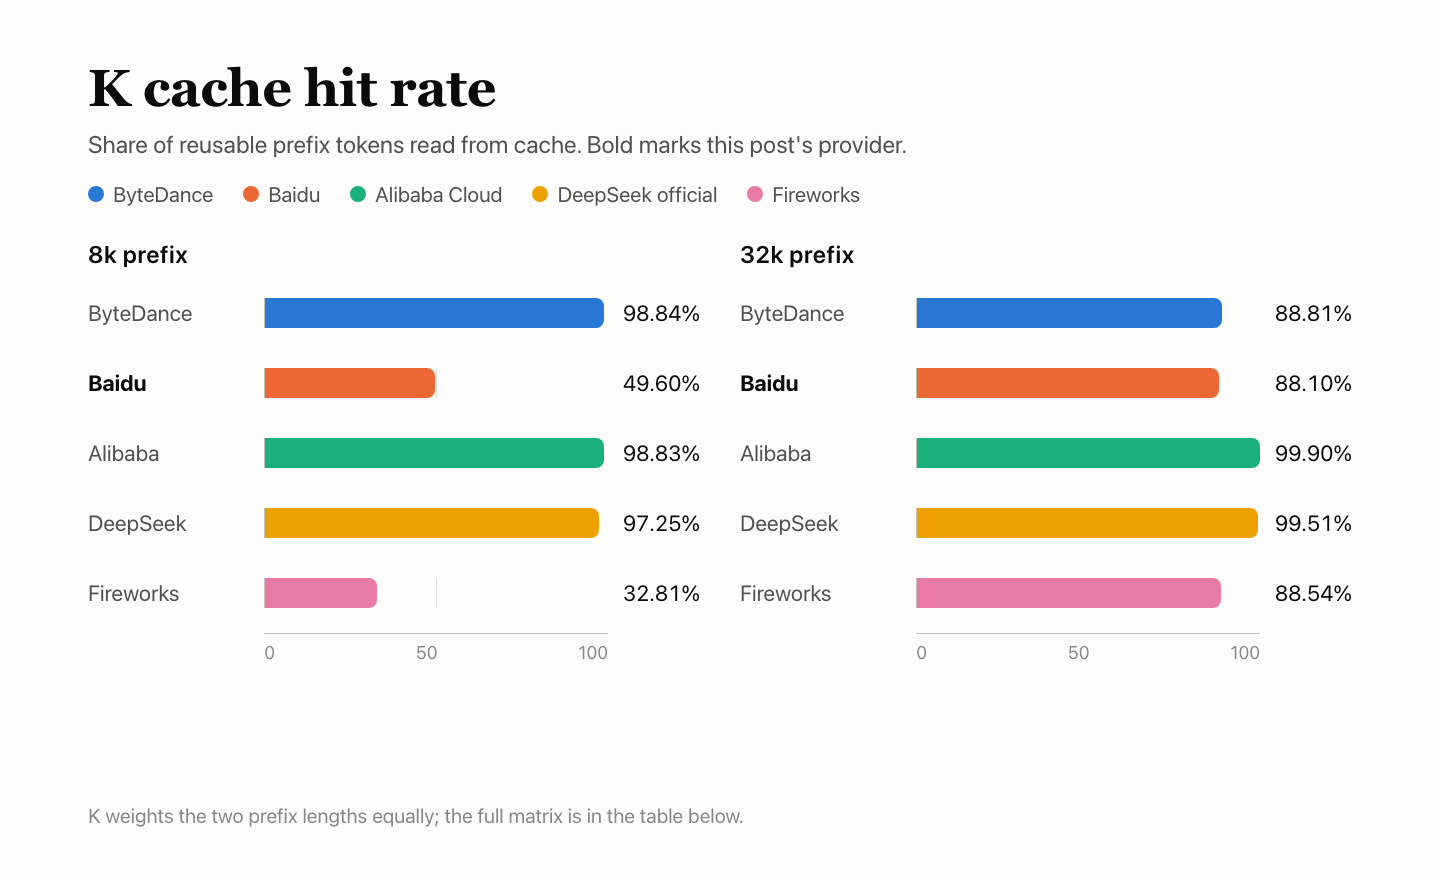
Chaque groupe envoie cinq requêtes. La première comporte un préfixe fixe d’environ 8k ou 32k tokens et initialise le cache. Les requêtes 2 à 4 conservent le préfixe et ne modifient que la question finale, avec des intervalles de 5 s, 30 s et 120 s. La cinquième utilise un nouveau préfixe comme témoin à froid. Trois fenêtres × deux longueurs donnent 30 requêtes. K correspond au nombre de tokens lus depuis le cache par les requêtes à chaud, divisé par le nombre de tokens qui devraient être réutilisables selon les règles, chaque longueur ayant une pondération de moitié. K représente 20 % de P.
Le tableau indique le nombre de tokens lus depuis le cache et communiqué par le serveur ; « non renvoyé » signifie que le champ était absent de la réponse.
| Préfixe | Fenêtre | Initialisation | +5 s | +30 s | +120 s | Témoin à froid |
|---|---|---|---|---|---|---|
| 8k | 1 | Échec | Échec | Échec | Non renvoyé | Non renvoyé |
| 8k | 2 | Non renvoyé | 7,168 | 7,168 | Échec | Échec |
| 8k | 3 | Non renvoyé | 7,168 | 7,168 | 7,168 | Non renvoyé |
| 32k | 1 | Non renvoyé | Non renvoyé | 31,744 | 31,744 | Non renvoyé |
| 32k | 2 | Non renvoyé | 31,744 | 31,744 | 31,744 | Non renvoyé |
| 32k | 3 | Non renvoyé | 31,744 | 31,744 | 31,744 | Non renvoyé |
Le préfixe de 8k a enregistré 5 hits sur 9 requêtes fréquentes, en lisant 35,840 tokens sur les 72,252 qui auraient dû être réutilisables, soit 49.60. Le préfixe de 32k a enregistré 8 hits sur 9, en lisant 253,952 tokens sur 288,261, soit 88.10. K s'établit à 68.85, les deux longueurs étant pondérées à parts égales. Au total, cinq requêtes de 8k ont échoué : la requête seed, celles à 5 s et 30 s de la fenêtre 1, ainsi que celles à 120 s et de contrôle à froid de la fenêtre 2, toutes avec no_available_channel. Il reste donc trois échecs parmi les requêtes fréquentes du niveau 8k.
Lors d'un hit, la lecture signalée est comptabilisée par blocs de 1,024 tokens : 7,168 tokens pour le préfixe de 8k et 31,744 pour celui de 32k. En cas d'absence de hit, le bloc d'utilisation omet prompt_tokens_details ; le tableau indique « non renvoyé » et la valeur est comptée comme 0.
Comparaison avec les quatre autres
R — stabilité du service : 100
Les 300 requêtes se répartissent en quatre types : texte court, entrée longue, appel d'outil et historique à plusieurs tours. Elles ont été envoyées à une concurrence de 1 sur trois fenêtres. Seule la validité et l'exhaustivité de la première réponse sont vérifiées ; les réponses ne sont pas notées et aucune nouvelle tentative n'est effectuée. Les échecs pendant les tests de réponse et de vitesse sont comptabilisés sous Q et P, et non une seconde fois sous R.
| Type de requête | Réussite à la première tentative |
|---|---|
| Texte court | 120/120 |
| Entrée longue de 10k | 90/90 |
| Appel d'outil | 60/60 |
| Historique à plusieurs tours | 30/30 |
| Total | 300/300, IC à 95% : 98.78%–100% |
Les 300 requêtes ont toutes renvoyé une réponse valide et complète dès la première tentative. R 100 ne porte que sur ces 300 requêtes dédiées ; cela ne signifie pas que l'ensemble du parcours n'a connu aucun échec. Avec 300 réussites sur 300, la borne inférieure de l'intervalle à 95% est de 98.78%, ce qui indique un taux d'échec probablement inférieur à 1.22%.
Comparaison avec les quatre autres
R ne porte que sur ces 300 requêtes dédiées ; les échecs pendant les tests de réponse et de vitesse sont comptabilisés sous Q et P, et non une seconde fois sous R.
| Fournisseur | Réussite à la première tentative | Intervalle à 95% |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek officiel | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
FAQ
Que représente le score global ?
Il s'agit d'un indice récapitulatif sans intervalle de confiance, et non d'une certification. Cet article présente Q, F, P, K et R et ne recommande aucun fournisseur.
Pourquoi la moitié des tests à concurrence de dix a-t-elle échoué ?
50 des 90 requêtes ont renvoyé no_available_channel. Plus de la moitié étant invalides, le temps médian jusqu'au premier token est considéré comme infini, et TTFA et TPOT reçoivent leurs valeurs de pénalité.
R 100 signifie-t-il qu'il n'y a eu aucun échec de canal ?
Non. R porte sur 300 requêtes dédiées, toutes réussies à la première tentative. Les 62 réponses no_available_channel de l'exécution des tests de vitesse et les échecs de l'exécution des tests de réponse sont comptabilisés sous P et Q.
Pourquoi K est-il de 68.85 alors que le préfixe de 32k a obtenu 8 hits sur 9 ?
Les deux longueurs ont le même poids. Le préfixe de 8k a obtenu 5 hits sur 9 requêtes fréquentes et un score de 49.60, tandis que celui de 32k a obtenu 8 hits sur 9 et un score de 88.10 ; la moyenne est de 68.85.
Peut-on distinguer la qualité des réponses de Baidu de celle du canal officiel ?
Oui. L'écart combiné de Q est de −4.46 points de pourcentage, avec un intervalle à 95% allant de −5.78 à −3.16, qui exclut 0. C'est le seul résultat d'un fournisseur inférieur à celui du canal officiel dont l'intervalle exclut 0.
Quels contrôles ont été exclus de F ?
Six au total : trois contrôles de séquence d'arrêt en streaming qui n'ont jamais été observés, car la requête de l'étape précédente n'a pas été envoyée, et trois contrôles explicites cache_control préenregistrés comme non pris en charge par cette interface.
Pour aller plus loin : la série DeepSeek V4.1 Flash
- La précision BFCL de Baidu était proche de celle du canal officiel ; l'article sur ByteDance applique la même suite de tests aux résultats des appels d'outil et de la facturation : DeepSeek V4.1 Flash sur ByteDance : les appels d'outil correspondent, pas la facturation
- Le TTFA de Baidu à concurrence de 1, avec 2.26 s, contraste avec une exécution qui a atteint 1.34 s : DeepSeek V4.1 Flash sur Alibaba Cloud : premier token en 1.34s, cache à 99.37
- Le score F de 88.39 de Baidu se compare à une exécution de référence à 94.00 avec 15 tests invalides : DeepSeek V4.1 Flash sur le canal officiel : F à 94.00, 15 tests invalides
- Les hits de cache de Baidu pour 8k, à 5/9, se comparent à une exécution à 3/9 avec des réponses d'arrêt vides : DeepSeek V4.1 Flash sur Fireworks : réponses d'arrêt vides, 3/9 hits de cache


