

Les 3 et 4 novembre 2026, DeepSeek V4.1 Flash 1017 a été évalué avec la suite APB Full auprès de cinq fournisseurs, tous accessibles via AIHubMix et testés avec les mêmes questions, paramètres et scripts de requête. Ce profil APB porte uniquement sur Fireworks. Le modèle est répertorié sous le nom DeepSeek V4.1 Flash 1017.
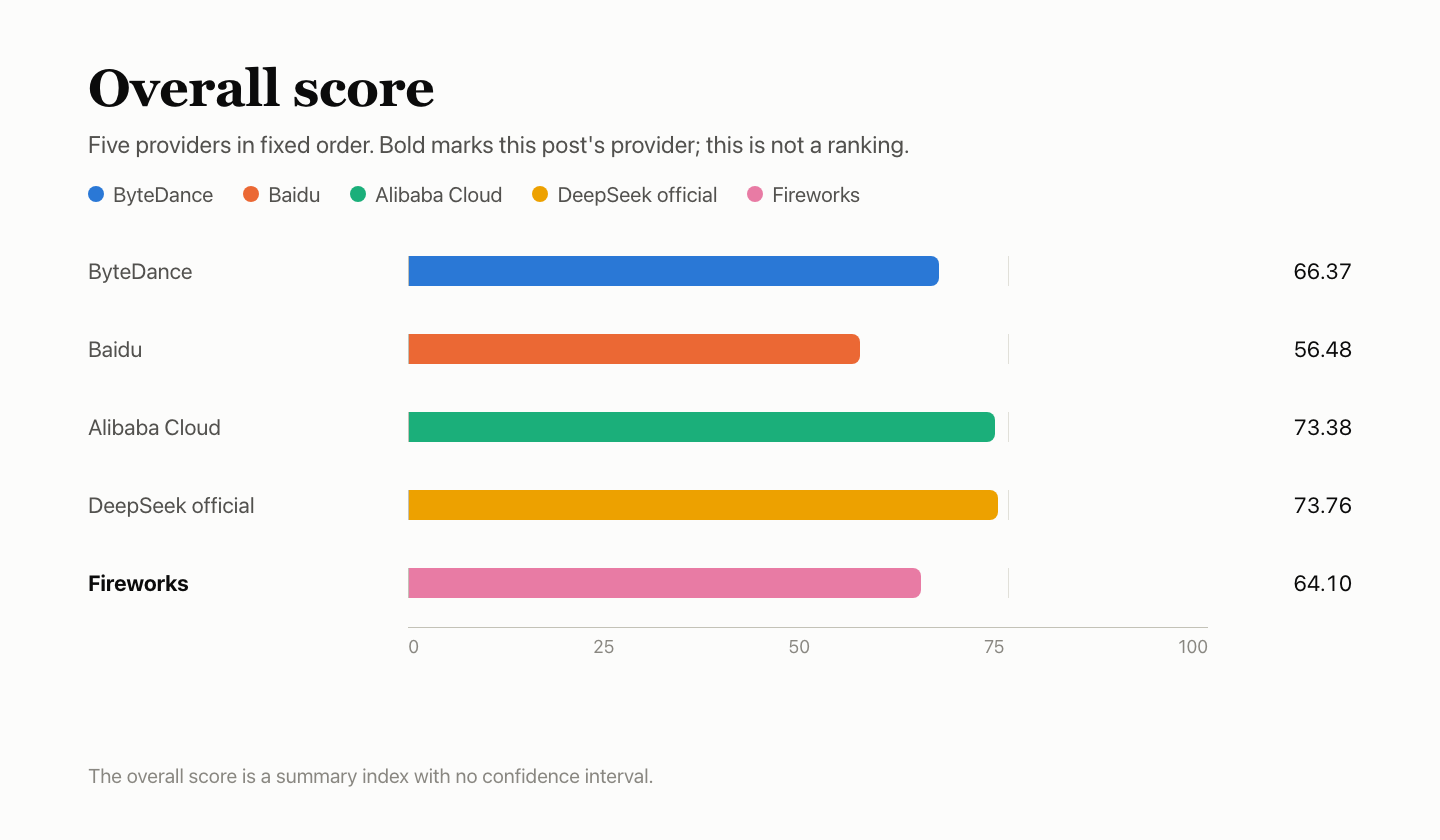
Les scores sont de 41.42 pour Q, 71.78 pour F, 79.51 pour P, 60.68 pour K et 100 pour R ; l’indice global est de 64.10. Cet article présente uniquement les scores, sans classement ni recommandation de fournisseur. Q, F, P, K et R sont présentés en premier ; l’indice global est un chiffre récapitulatif sans intervalle de confiance. La norme utilisée est l’AIHubMix Provider Benchmark Standard v2.0.
Scores des cinq fournisseurs
Le fournisseur concerné par cet article est en gras. L’ordre des fournisseurs est fixe et ne constitue pas un classement. K est une sous-note de P, à hauteur de 20 %. L’indice global est un chiffre récapitulatif sans intervalle de confiance. DeepSeek officiel et Alibaba Cloud ne diffèrent que de 0.37 point et ne sont pas différenciables.
En bref
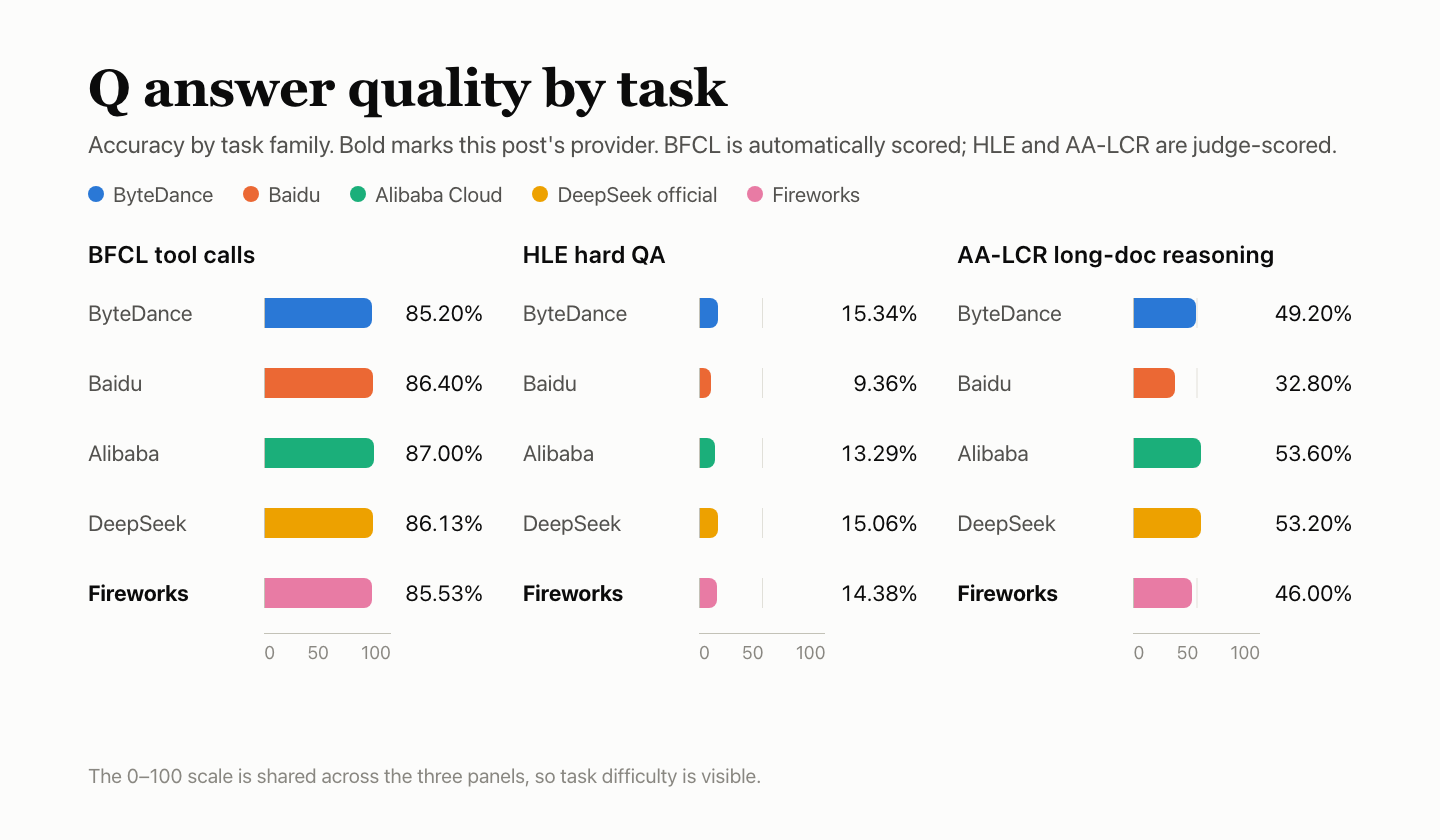
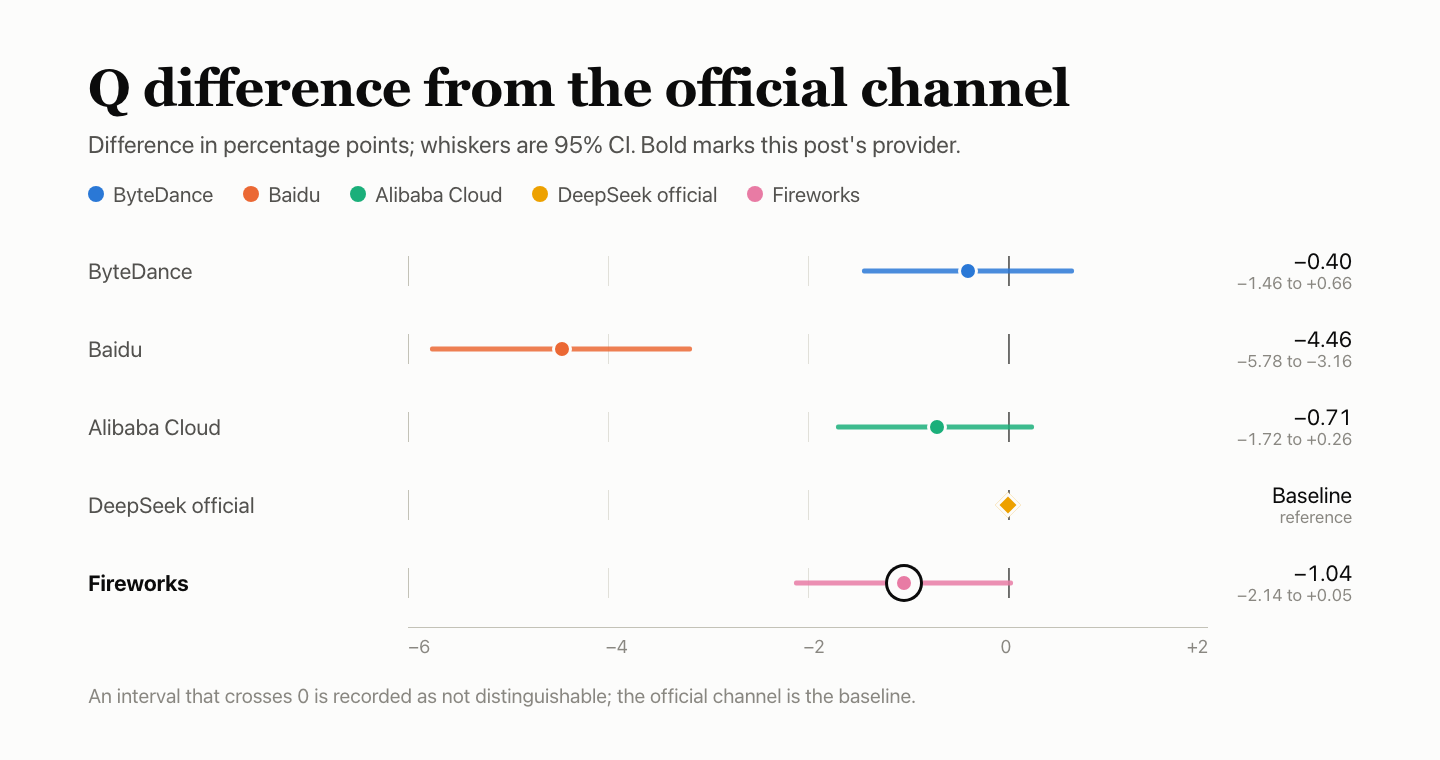
- Q — qualité des réponses : 41.42. BFCL 85.53 %, HLE 14.38 %, AA-LCR 46.00 %. Par rapport au canal officiel : −1.04 point de pourcentage, IC à 95 % de −2.14 à +0.05 ; différence non significative. Les 34 échecs AA-LCR ont tous eu lieu dans la fenêtre 2 et ont été comptabilisés comme des réponses incorrectes.
- F — prise en charge des fonctions : 71.78. 122 des 177 vérifications comptabilisées ont réussi. Les deux cas avec stop ont renvoyé un corps vide ;
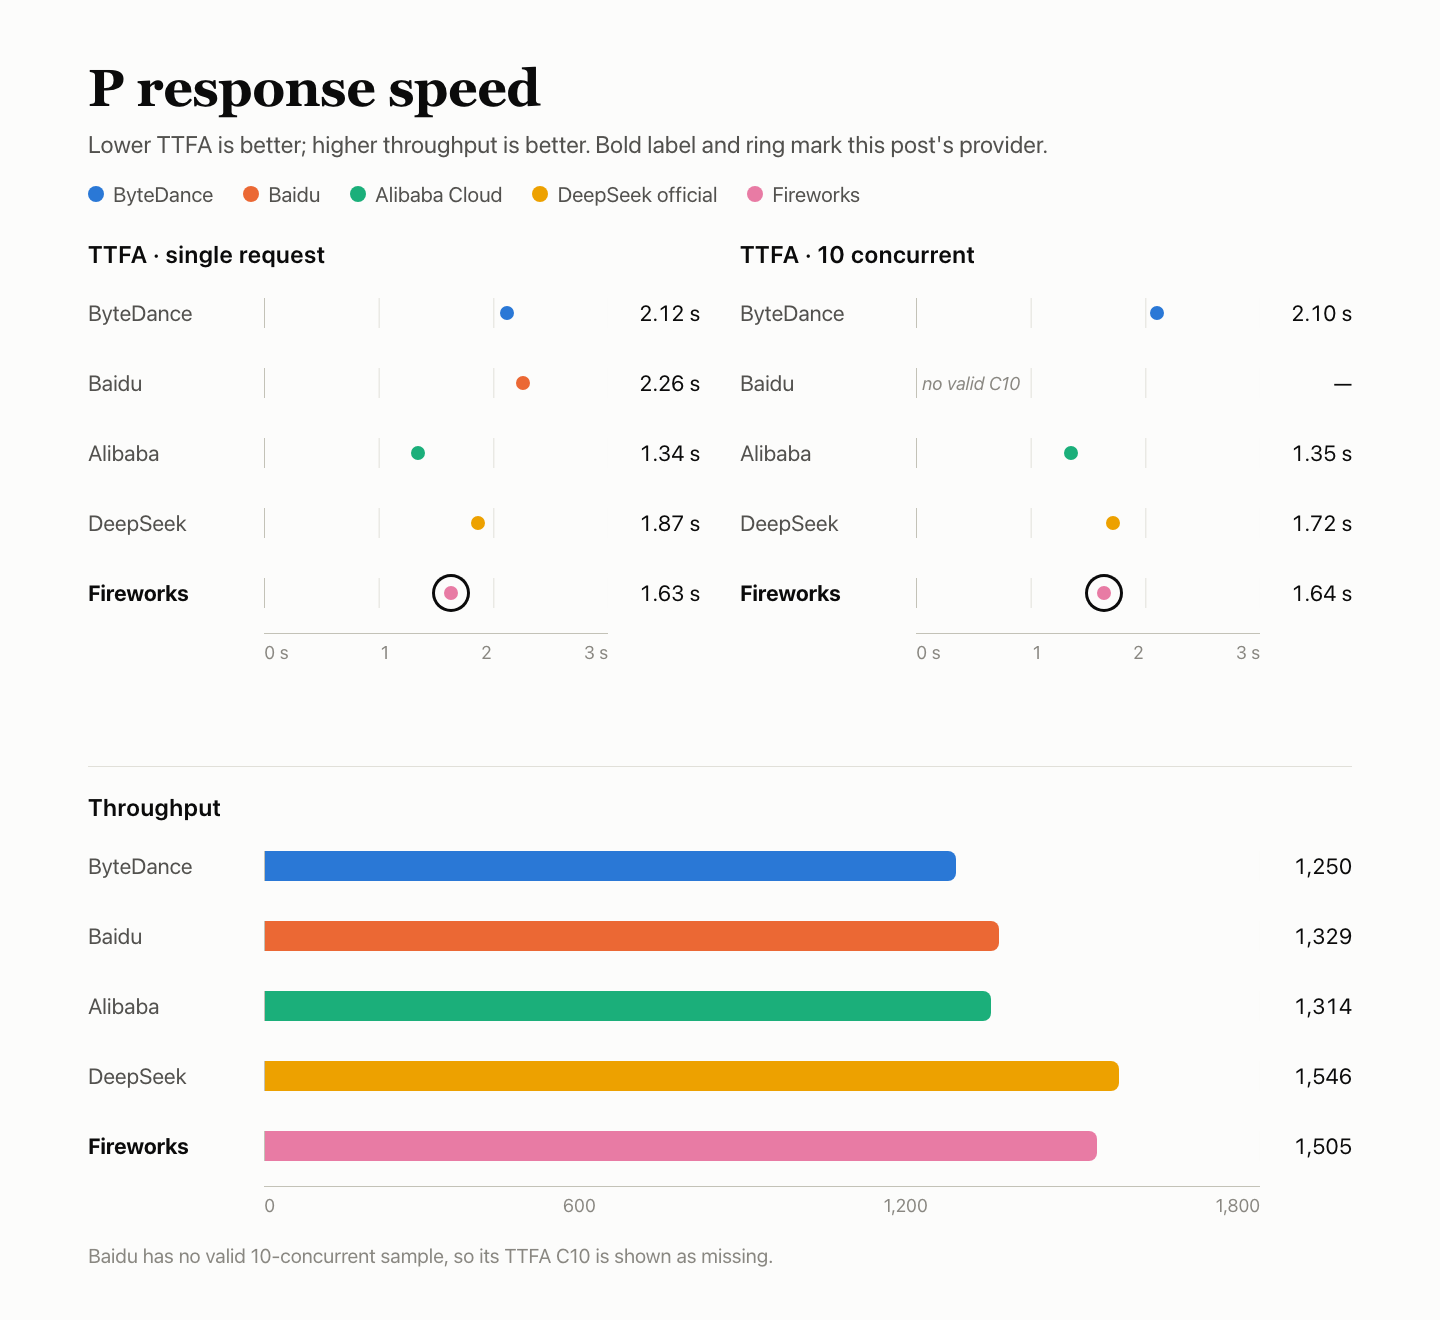
reasoning_effort=nonen’a pas désactivé la réflexion ; une entrée de 10k a été signalée comme contenant 10,026 tokens, contre un compte natif de 10,000. - P — vitesse de réponse : 79.51. Score de réponse : 84.22 ; K pour le cache, à hauteur de 20 %. TTFA médiane : 1.63 s en requêtes séquentielles, 1.64 s avec 10 requêtes simultanées ; TPOT : 3.29 ms. Un résultat sur 180 ne contenait qu’un seul token et a été marqué comme invalide.
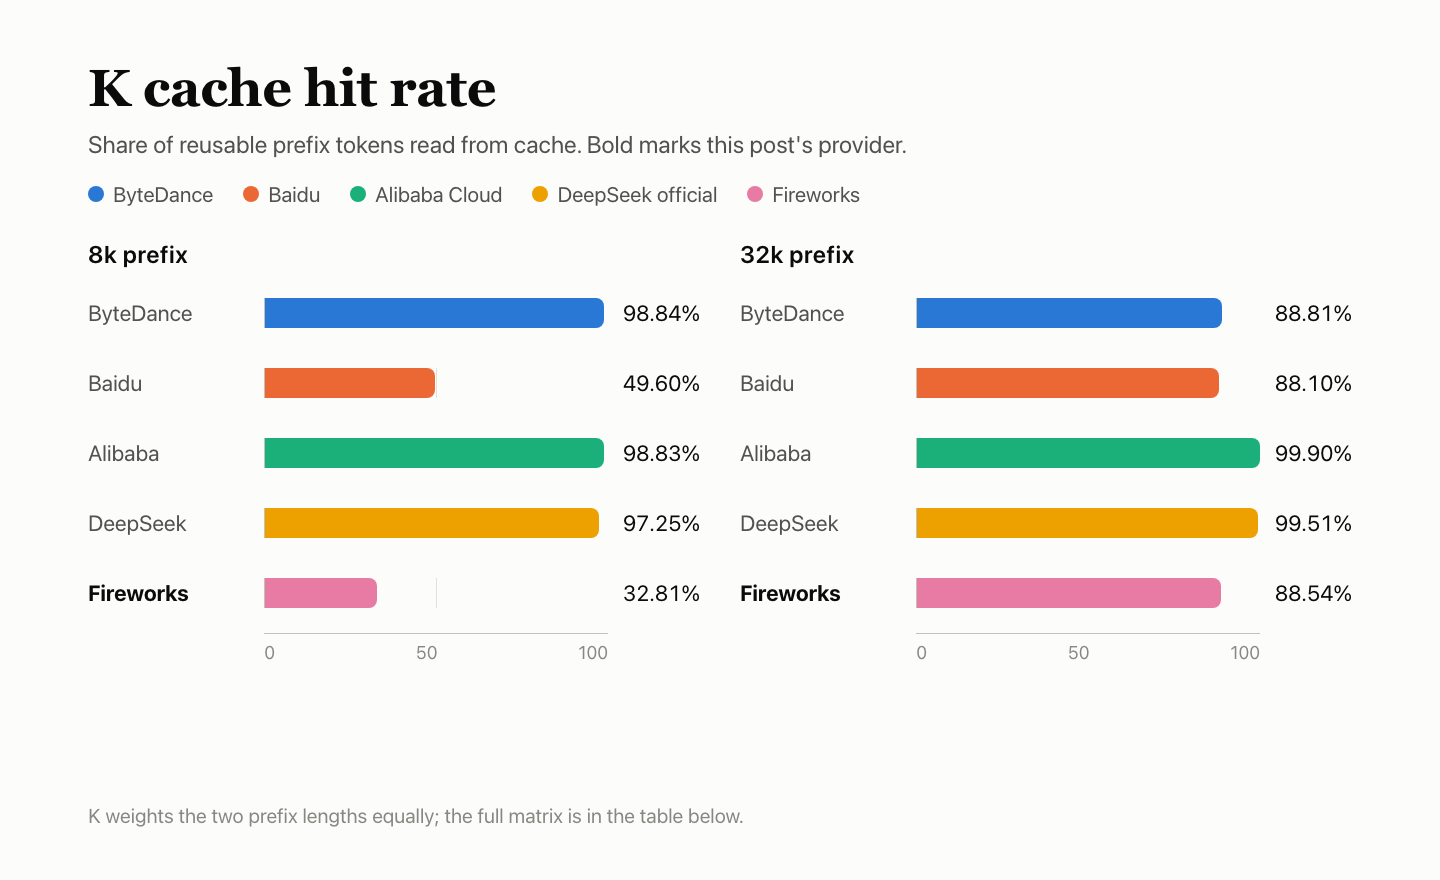
- K — cache : 60.68. Les tests K ont utilisé l’affinité de session documentée. Cache chaud à 32k : 8/9 ; cache chaud à 8k : 3/9.
- R — stabilité du service : 100. 300/300 requêtes dédiées ont réussi dès la première tentative.
Configuration du test
| Élément | Paramètre |
|---|---|
| Modèle | DeepSeek V4.1 Flash 1017 |
| ID du modèle demandé | fireworks-deepseek-v4.1-flash-1017 |
| Nom du modèle renvoyé | accounts/fireworks/models/deepseek-v4p1-flash-1017 |
| Voie d’accès | ID du modèle fournisseur d’AIHubMix, et non le compte propre du fournisseur |
| Paramètres | Sans réflexion, température 1.0, max_tokens 16,384, délai d’expiration 300 s, aucune nouvelle tentative |
| Réflexion désactivée | Paramètre natif thinking.type=disabled ; reasoning_effort=none ne désactive pas la réflexion. Les cas de fonction ont conservé reasoning_effort=none. |
| Période | 2026-11-03 18:07 – 11-04 16:33 UTC+8. Un Mac mini, un réseau et un compte pour les cinq fournisseurs. |
| Échantillons | Q 4,250 (BFCL 500×3, HLE 250×10, AA-LCR 25×10) ; F 60×3 ; P 90+90 ; R 300 ; K 30 |
| Paramètres supplémentaires | Les tests K incluaient le champ user documenté et l’en-tête x-session-affinity pour assurer l’affinité avec un réplica. |
Les requêtes ont utilisé le guide de démarrage rapide d’AIHubMix ; les ID de modèle figurent sur la page des modèles. La réflexion a été désactivée à l’aide du paramètre natif thinking.type=disabled indiqué dans la documentation de l’API du modèle.
Q — qualité des réponses : 41.42
La suite comprenait 500 questions BFCL × 3 tours, 250 questions HLE × 10 et 25 questions AA-LCR × 10. BFCL a été évalué automatiquement ; HLE et AA-LCR ont été évalués par deepseek-flash. Les cinq fournisseurs ont reçu les mêmes questions. Dix réponses impossibles à noter ont été retirées ; il reste 4,240 instances notées.
| Tâche | Questions | Correctes | Précision | Échecs |
|---|---|---|---|---|
| Appels d’outils BFCL | 500 × 3 | 1,283/1,500 | 85.53% | 2 |
| Questions-réponses difficiles HLE | 250 × 10 | 358/2,490 | 14.38% | 5 |
| Raisonnement sur des documents longs AA-LCR | 25 × 10 | 115/250 | 46.00% | 34 |
| Total · IC à 95 % : 39.13 %–43.59 % | — | 1,756/4,240 | 41.42% | 41 |
Les échecs restent dans le dénominateur et sont comptabilisés comme des réponses incorrectes : 2 pour BFCL (fenêtres 2 et 3), 5 pour HLE (réponses tronquées à max_tokens) et 34 pour AA-LCR, tous dans la fenêtre 2.
| Catégorie BFCL | Réussites | Taux de réussite |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 268/300 | 89.33% |
| parallel | 270/300 | 90.00% |
| parallel_multiple | 206/240 | 85.83% |
| irrelevance | 111/150 | 74.00% |
| ahm_multi_turn | 95/150 | 63.33% |
simple_python a réussi 333/360 (92.50 %), parallel 270/300 (90.00 %), ahm_multi_turn 95/150 (63.33 %) et irrelevance 111/150 (74.00 %).
Comparaison avec les quatre autres
Écart en points de pourcentage par rapport au canal officiel ; l’intervalle à 95 % est représenté par les moustaches. S’il traverse 0, la différence n’est pas significative. Le juge deepseek-flash, de la même famille et non calibré, peut se montrer indulgent.
F — prise en charge des fonctions : 71.78
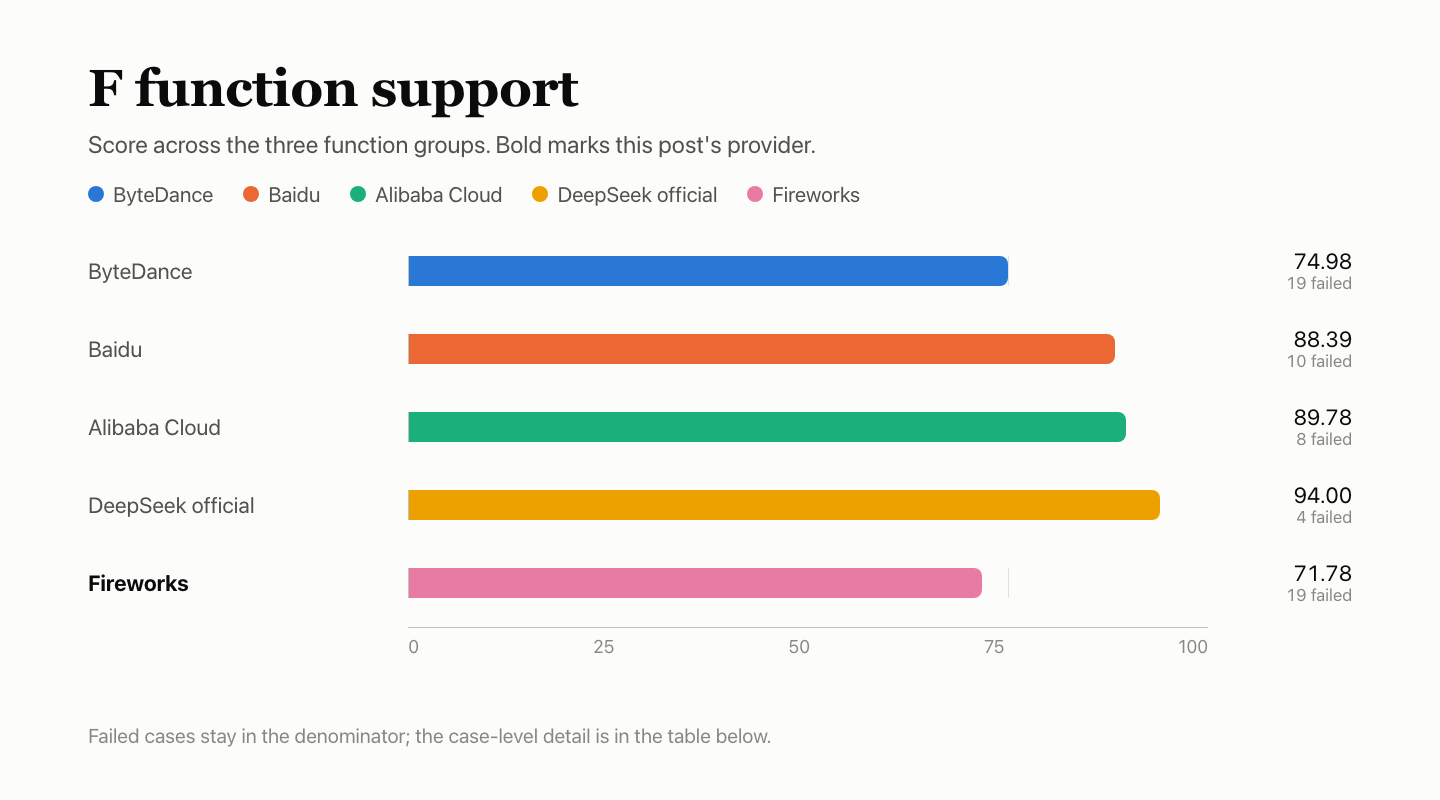
Les 60 cas forment six groupes, chacun exécuté dans trois fenêtres : 180 vérifications ont été évaluées selon le format documenté par le fournisseur. Les vérifications non applicables, invalides ou non observées sont exclues du dénominateur. 122 des 177 vérifications comptabilisées ont réussi ; la pondération par groupe donne un score de 71.78.
| Groupe de cas | Pondération | Réussites | Exclues | Score du groupe |
|---|---|---|---|---|
| Streaming et messagerie | 20% | 24/30 | — | 80.00 |
| Interface des outils | 20% | 29/30 | — | 96.67 |
| Contraintes de sortie | 20% | 21/30 | — | 70.00 |
| Contexte et état | 15% | 15/30 | — | 50.00 |
| Erreur et récupération | 15% | 21/30 | — | 70.00 |
| Mesure de l’utilisation et cache | 10% | 12/27 | 3 | 44.44 |
| Total · pondéré | — | 122/177 | 3 | 71.78 |
« Fenêtres en échec » désigne le nombre des trois fenêtres dans lesquelles le cas n’a pas réussi.
| Cas en échec | Fenêtres en échec | Motif |
|---|---|---|
| Arrêt du streaming | 3/3 | Corps vide avec stop ; fonctionne sans stop. |
| Raisonnement dans le corps | 3/3 | reasoning_effort=none a tout de même renvoyé le raisonnement. |
| Séquence d’arrêt | 3/3 | Corps vide avec stop ; fonctionne sans stop. |
| Paramètre de réflexion | 3/3 | reasoning_effort=none a tout de même renvoyé le raisonnement. |
| Diversité de l’échantillonnage | 3/3 | Temp 0/1 : résultats trop similaires |
| Entrée longue de 10k | 3/3 | 10,026 signalés ; compte natif : 10,000. |
| Dans la limite de contexte | 3/3 | 10,026 signalés ; compte natif : 10,000. |
| Entrée longue de 32k | 3/3 | 10,026 signalés ; compte natif : 10,000. |
| Entrée longue de 100k | 3/3 | 10,026 signalés ; compte natif : 10,000. |
| Au-delà du contexte | 3/3 | Devrait renvoyer une erreur de paramètre ; réponse 200. |
| Messages mal formés | 3/3 | 400, corps vide |
| Résultat d’outil orphelin | 3/3 | Devrait renvoyer une erreur de paramètre ; réponse 200. |
| stream_options mal formé | 3/3 | 400, corps vide |
| Mesure des tokens de réflexion | 3/3 | Des tokens de réflexion ont été signalés après la désactivation. |
| Compte natif de l’entrée | 3/3 | 34 signalés ; compte natif : 8. |
| Définitions d’outils dans l’entrée | 3/3 | Le contrôle sans outils présentait déjà un écart. |
| Compte de l’entrée avec cache | 3/3 | Le compte du préfixe répété ne correspondait pas au compte natif. |
| Concordance de l’entrée en streaming | 3/3 | 34 signalés ; compte natif : 8 |
| Un outil à la fois | 1/3 | Erreur 500 en amont. |
Dans les trois fenêtres, les deux cas avec stop ont renvoyé un corps vide, alors que la même entrée fonctionnait sans stop. reasoning_effort=none a tout de même renvoyé le raisonnement dans les deux cas de réflexion.
Les vérifications exclues ne sont comptées ni comme des réussites ni comme des échecs.
| Statut | Cas | Nombre | Motif |
|---|---|---|---|
| Non applicable | cache_control explicite | 3 | Considéré à l’avance comme non pris en charge par cette interface |
Les messages et stream_options mal formés ont échoué chez les cinq fournisseurs : erreur 400, corps vide et aucune erreur structurée. Ce résultat commun se situe probablement au niveau de la passerelle AIHubMix et doit faire l’objet d’une enquête distincte. La mesure des tokens de réflexion a également échoué chez les cinq fournisseurs, mais ByteDance et Fireworks ont signalé des tokens de réflexion après la désactivation, tandis que les trois autres n’ont renvoyé aucun compte de réflexion.
Comparaison avec les quatre autres
P — vitesse de réponse : 79.51
Chaque requête contenait environ 10,000 tokens en entrée et demandait environ 1,100 tokens en sortie. Dans chacune des trois fenêtres, 30 requêtes ont été envoyées avec une concurrence de 1 et 30 avec une concurrence de 10, soit 180 au total.
| Métrique | Résultat |
|---|---|
| TTFA | 1.63 s en requêtes séquentielles ; 1.64 s avec 10 requêtes simultanées |
| TPOT | 3.24 ms en requêtes séquentielles ; 3.29 ms avec 10 requêtes simultanées |
| Débit utile | 1,504.5 tokens/s avec 10 requêtes simultanées |
| Valides | 90/90 en requêtes séquentielles ; 89/90 avec 10 requêtes simultanées (29/30 dans la fenêtre 3), un résultat ne contenant qu’un seul token |
| Composantes | TTFA 54.91, TPOT 100.00, débit utile 100.00 ; pondérations 35/35/30 |
| Composition de P | 84.22 × 80% + 60.68 × 20% = 79.51 |
179 résultats sur 180 étaient valides ; la requête invalide a renvoyé un token et est comptée comme infinie dans les médianes, qui peuvent donc être supérieures à celles calculées uniquement pour les requêtes valides. Le TPOT est calculé à partir des blocs de streaming ; le débit utile correspond aux tokens de sortie valides avec 10 requêtes simultanées, divisés par la durée murale du lot.
Une seule machine, un seul réseau et un seul compte ; les fenêtres ont été planifiées par fournisseur.
K — cache : 60.68
Chaque groupe comprend cinq requêtes : initialisation d’un préfixe de 8k ou 32k, puis réutilisation du même préfixe avec une nouvelle question finale après 5 s, 30 s et 120 s, puis utilisation d’un nouveau préfixe comme contrôle à froid. Trois fenêtres × deux longueurs = 30. K correspond aux tokens lus depuis le cache chaud divisés par les tokens réutilisables ; les deux longueurs ont le même poids. K représente 20 % de P.
| Préfixe | Fenêtre | Initialisation | +5 s | +30 s | +120 s | Contrôle à froid |
|---|---|---|---|---|---|---|
| 8k | Fenêtre 1 | 0 | 7,900 | 0 | 7,900 | 0 |
| 8k | Fenêtre 2 | 0 | 7,906 | 0 | 0 | 0 |
| 8k | Fenêtre 3 | 0 | 0 | 0 | 0 | 0 |
| 32k | Fenêtre 1 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | Fenêtre 2 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | Fenêtre 3 | 0 | 31,900 | 31,900 | 0 | 0 |
Le préfixe de 8k a enregistré 3 hits sur 9 requêtes récentes, avec 23,706 tokens réutilisables lus sur 72,252, soit 32.81. Le préfixe de 32k a enregistré 8 hits sur 9, avec 255,212 tokens lus sur 288,261, soit 88.54. K est de 60.68 lorsque les deux longueurs ont le même poids. Les contrôles à froid n’ont rien lu. Les deux longueurs de préfixe ont donc réagi différemment malgré une conception identique. Les sondes K comportaient le champ user documenté et l’en-tête x-session-affinity.
R — stabilité du service : 100
300 requêtes ont couvert du texte court, une longue entrée, des appels d’outil et un historique multi-tour, avec une concurrence de 1 sur trois fenêtres. Seules la validité et l’exhaustivité de la première réponse ont été vérifiées ; les réponses n’ont pas été évaluées et aucune nouvelle tentative n’a été effectuée. Les échecs de Q et P ne sont pas recomptés ici.
| Type de requête | Réussite à la première tentative |
|---|---|
| Texte court | 120/120 |
| Entrée longue de 10k | 90/90 |
| Appels d’outil | 60/60 |
| Historique multi-tour | 30/30 |
| Total · IC à 95 % : 98.78%–100% | 300/300 |
Les 300 requêtes ont toutes renvoyé une réponse valide et complète dès la première tentative. Avec 300 réussites, la borne inférieure à 95 % est de 98.78 % ; les données permettent donc seulement de conclure à un taux d’échec inférieur à 1.22 %. Le score R de 100 porte sur ces 300 requêtes, et non sur l’ensemble du parcours.
| Fournisseur | Réussite à la première tentative | Intervalle à 95 % |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek officiel | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
FAQ
Que couvre le score Q de 41.42 ?
BFCL, HLE et AA-LCR sur 4,240 instances évaluées : 1,756 réponses correctes, soit 41.42 %, IC à 95 % de 39.13 %–43.59 % ; l’écart avec le canal officiel n’est pas statistiquement significatif.
Pourquoi les deux cas avec stop ont-ils échoué ?
Une requête avec stop a renvoyé un corps vide dans les trois fenêtres, tandis que la même entrée fonctionnait sans stop. Le problème apparaît dans les cas en streaming comme hors streaming.
reasoning_effort=none désactive-t-il la réflexion ?
Non. Le contenu de raisonnement était toujours renvoyé dans les trois fenêtres ; les autres requêtes utilisaient le paramètre natif thinking.type=disabled.
Pourquoi une entrée de 10k est-elle indiquée comme contenant 10,026 tokens ?
Le cas de 10k indiquait 10,026 tokens pour une entrée native de 10,000. Les cas de 32k et de 100k indiquaient le même nombre de 10,026, et un contrôle sans outils présentait déjà un écart.
Pourquoi 8k a-t-il enregistré 3 hits sur 9, contre 8 sur 9 pour 32k ?
Les deux utilisaient la même conception et les mêmes paramètres d’affinité documentés. La différence concerne les lectures rapportées par le serveur : le préfixe de 8k a été hit dans les fenêtres 1 et 2, celui de 32k dans les trois fenêtres.
Que couvre le score R de 100 ?
300 requêtes dédiées, toutes valides dès la première tentative ; la borne inférieure à 95 % est de 98.78 %. Les échecs de Q et P ne sont pas comptabilisés dans R.
À lire ensuite : la série DeepSeek V4.1 Flash
- ByteDance a renvoyé des tokens de réflexion après la désactivation de la réflexion, comme Fireworks : DeepSeek V4.1 Flash sur ByteDance : les appels d’outil concordent, pas la facturation
- Baidu a obtenu Q à 38.00 et P à 37.77 : DeepSeek V4.1 Flash sur Baidu : aucun canal disponible n’atteint Q et P
- Alibaba Cloud a enregistré un premier token à 1.34 s et un cache à 99.37 : DeepSeek V4.1 Flash sur Alibaba Cloud : premier token à 1.34s, cache à 99.37
- Le canal officiel sert de référence pour Q, avec F à 94.00 : DeepSeek V4.1 Flash sur le canal officiel : F à 94.00, 15 sondes invalides


