
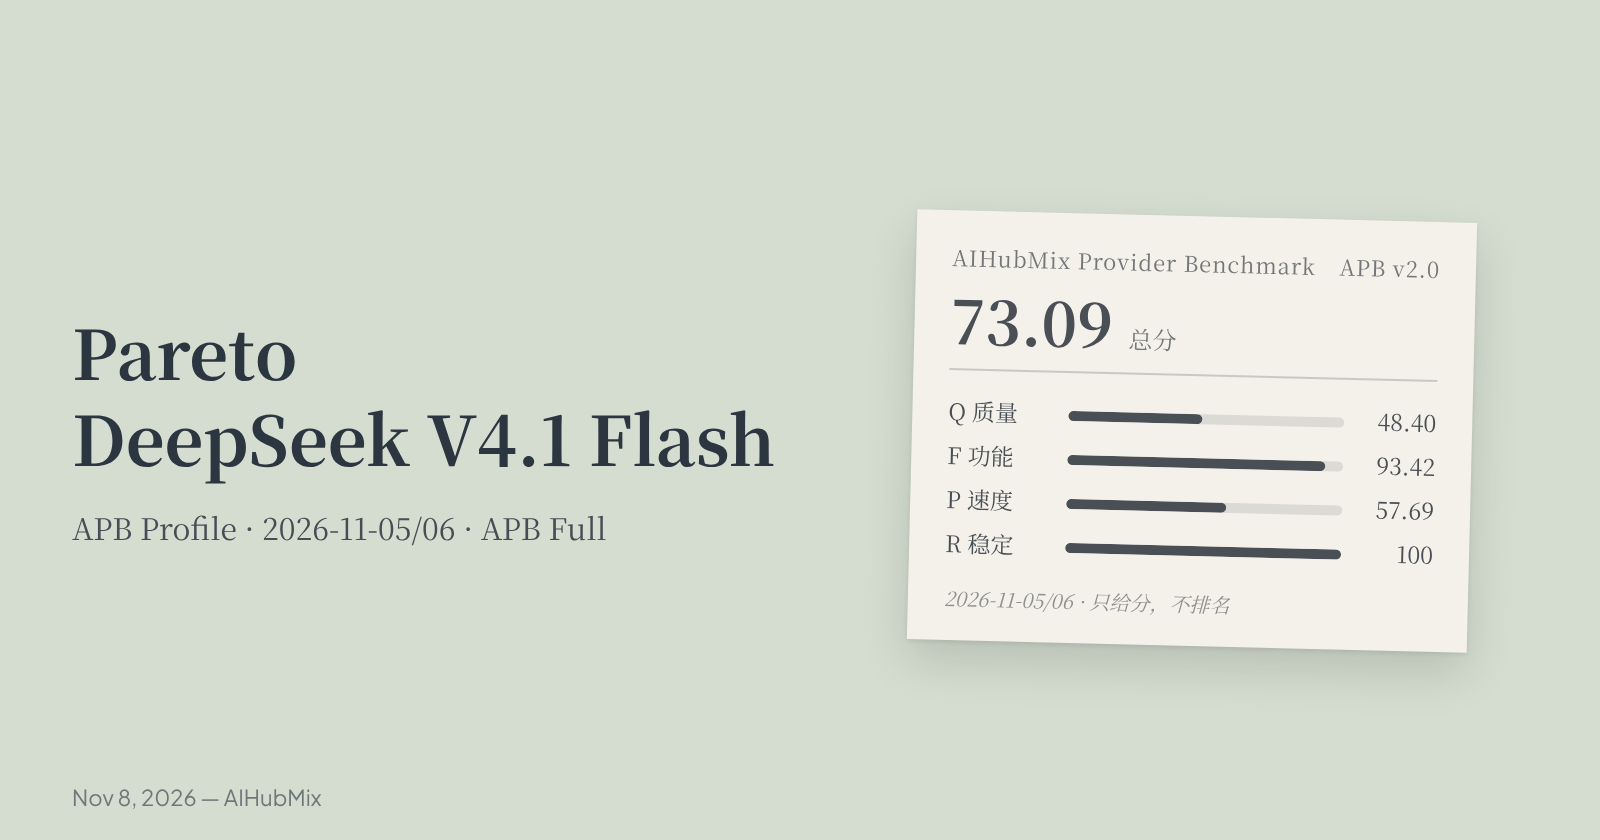
Les 2026-11-05/06, DeepSeek V4.1 Flash 1017 a été évalué sur Pareto avec la suite complète de l’AIHubMix Provider Benchmark (APB). Les scores sont Q 48.40, F 93.42, P 57.69, K 27.58 et R 100 ; l’indice global est de 73.09. Ce profil APB porte uniquement sur Pareto. Le modèle est répertorié sous le nom DeepSeek V4.1 Flash 1017.
Cet article présente uniquement des scores, sans classement ni recommandation de fournisseur. Q, F, P, K et R sont présentés en premier ; l’indice global est un nombre récapitulatif sans intervalle de confiance. La norme appliquée est l’AIHubMix Provider Benchmark Standard v2.0.
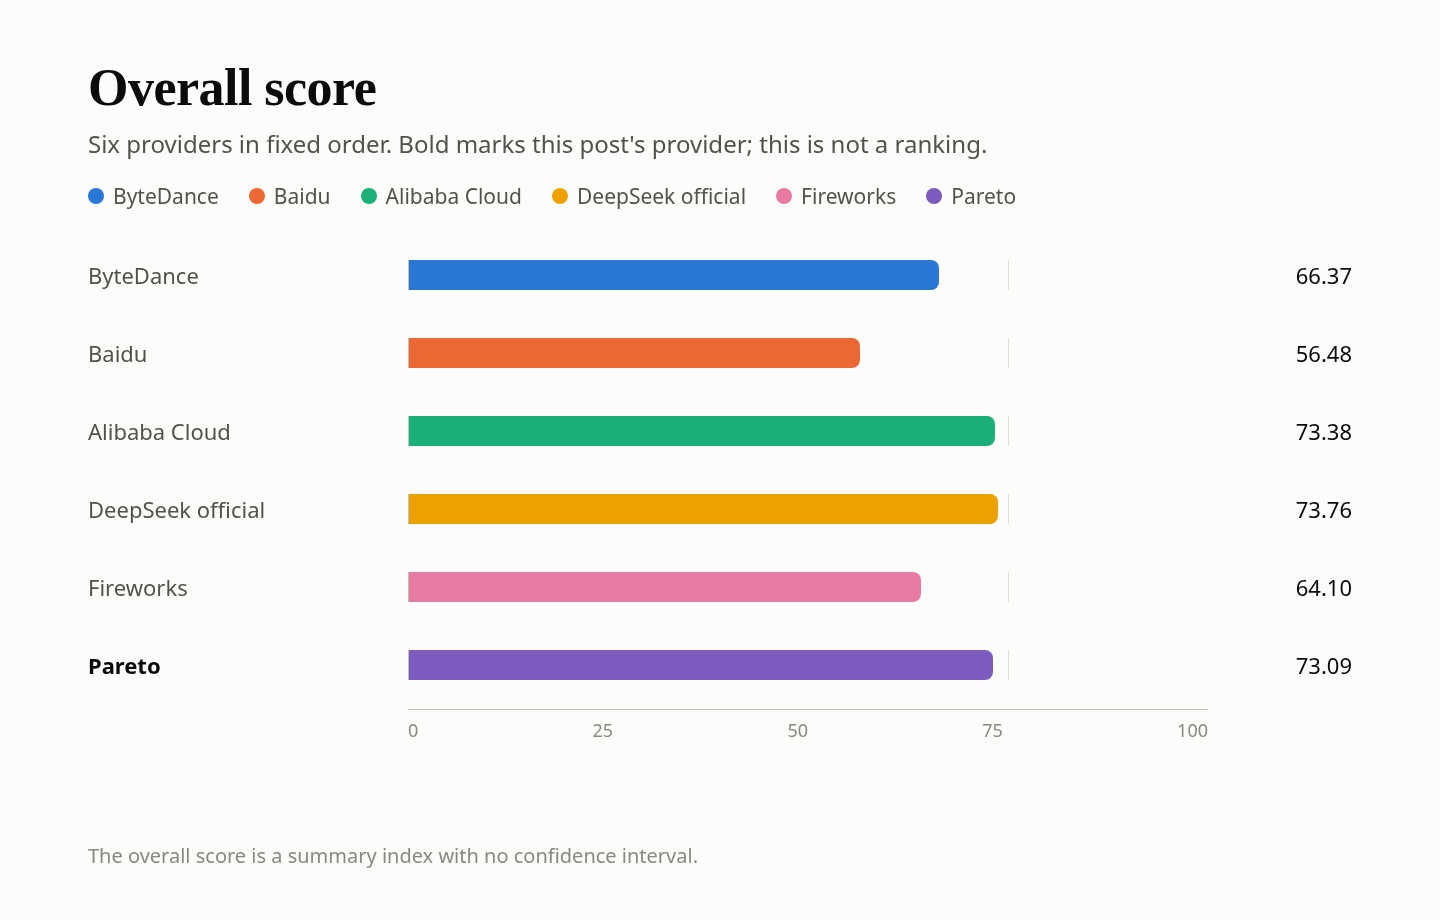
Scores pour six fournisseurs
Le fournisseur concerné par cet article est indiqué en gras. L’ordre des fournisseurs est fixe et ne constitue pas un classement. K est une sous-note de P, avec une pondération de 20 %. L’indice global est un nombre récapitulatif sans intervalle de confiance. L’écart entre le canal officiel DeepSeek et Alibaba Cloud est de 0.37 et n’est pas significatif.
En bref
- Q — qualité des réponses : 48.40. BFCL 85.07 %, HLE 23.21 %, AA-LCR 79.20 %. Par rapport au canal officiel : +5.94 points de pourcentage, IC à 95 % de +3.54 à +8.36. HLE a enregistré 996 échecs de service, la plupart dus à des réponses tronquées parce que la réflexion a consommé le budget de longueur de sortie ; ces réponses sont comptées comme incorrectes.
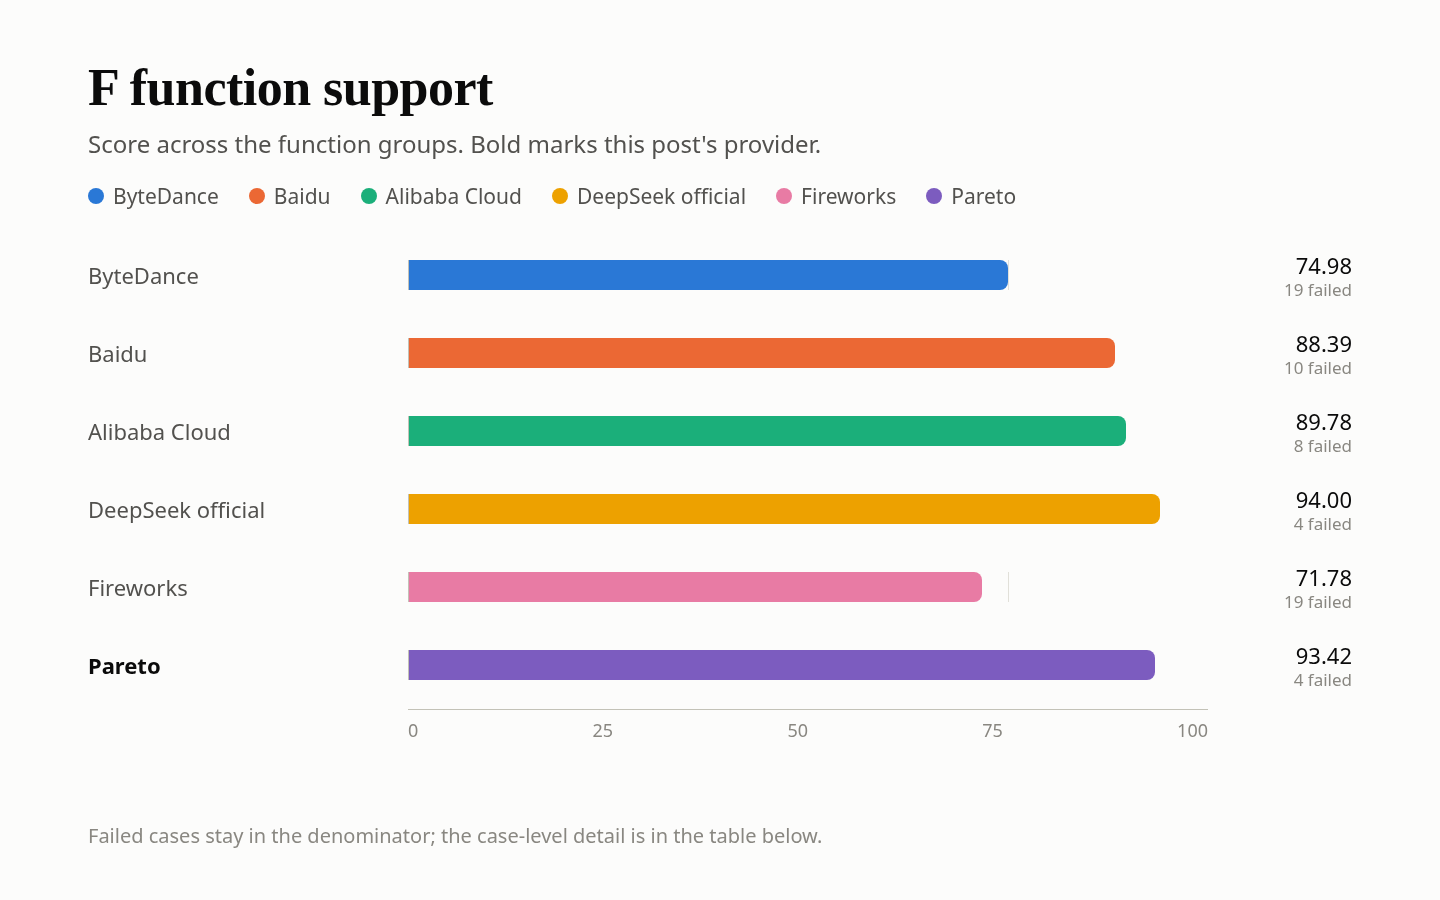
- F — prise en charge des fonctions : 93.42. 29 des 33 vérifications comptabilisées ont réussi (streaming 23/27, erreurs 3/3, comptabilisation 3/3). 147 vérifications ont été exclues du dénominateur. Sur les 4 échecs, 3 correspondaient à des corps de réponse vides pour des requêtes avec séquence stop, et 1 à un texte en streaming qui ne correspondait pas exactement au jeu de données de référence.
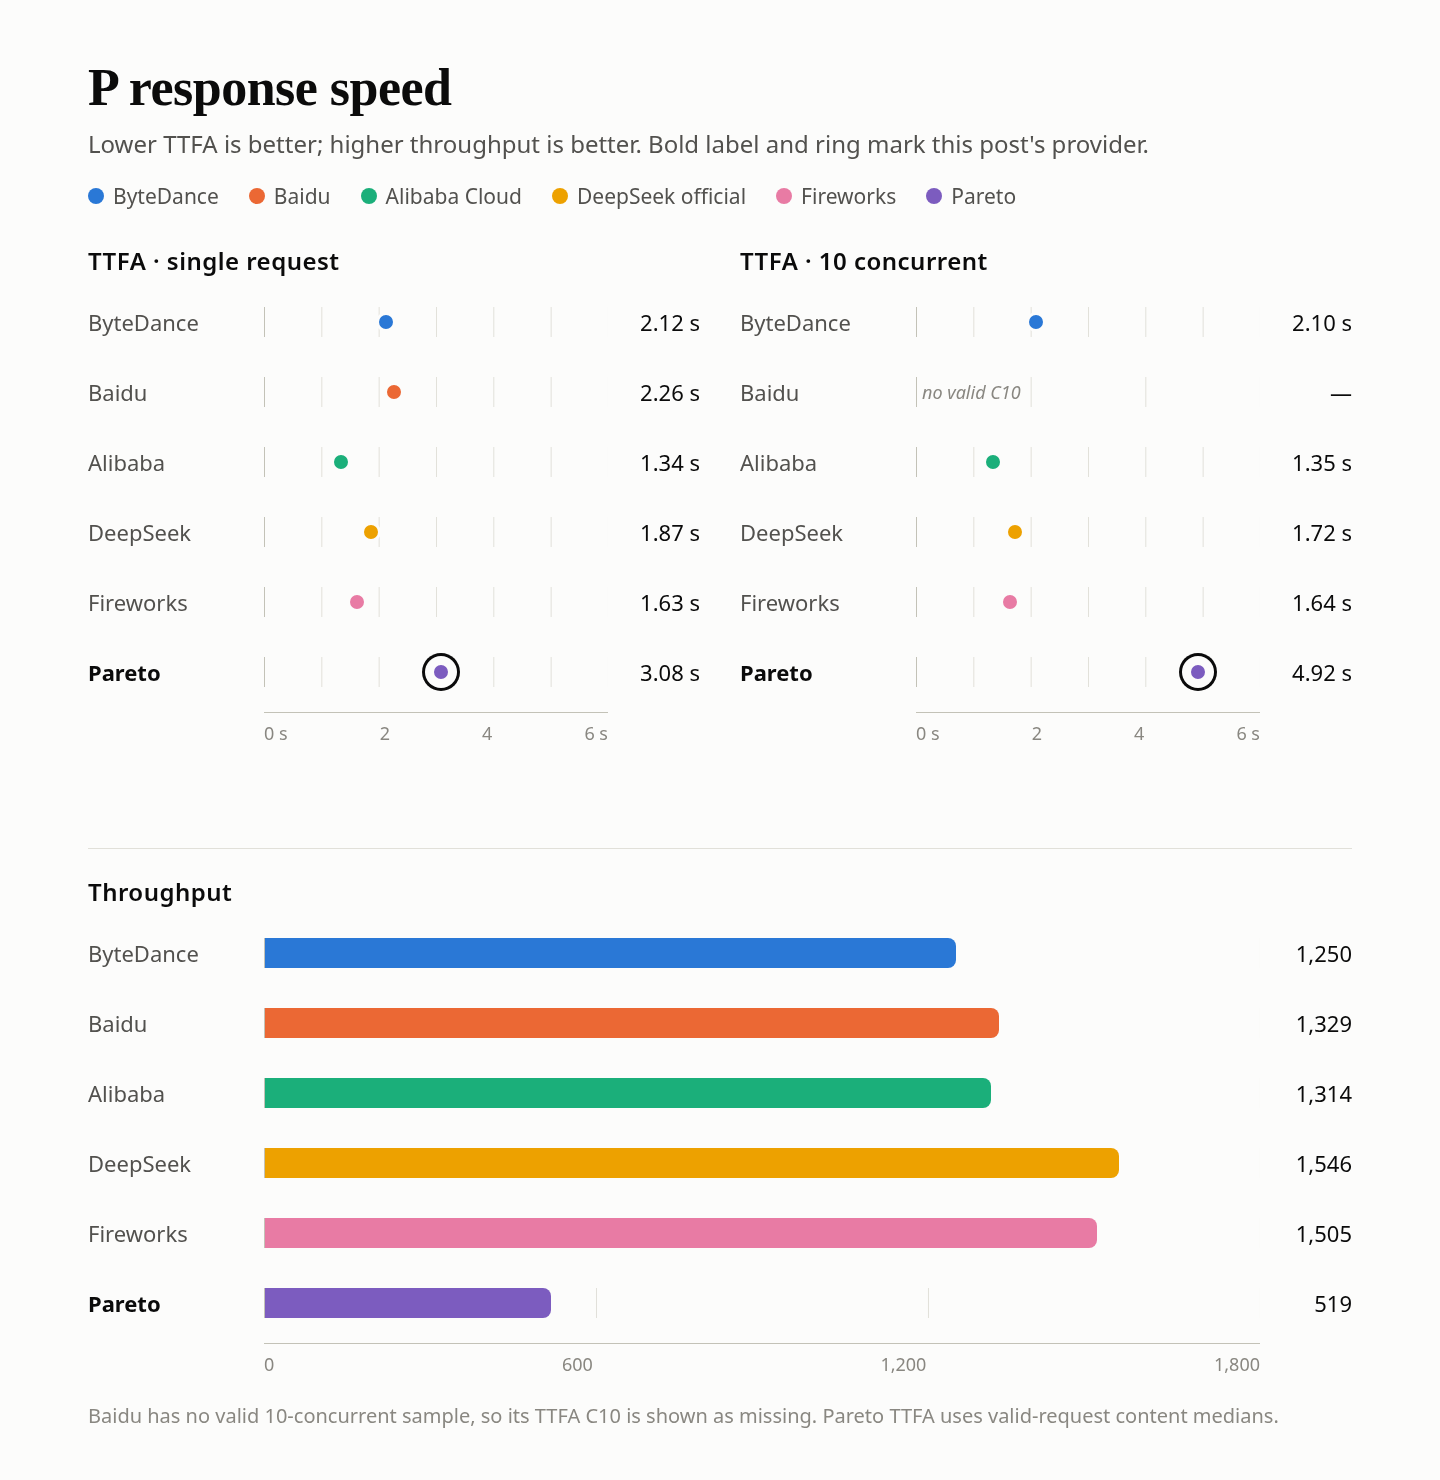
- P — vitesse de réponse : 57.69. Score de réponse 65.22, cache K pondéré à 20 %. Médianes de TTFA pour les requêtes valides : 3.08 s en concurrence simple et 4.92 s avec 10 requêtes concurrentes ; médianes utilisées pour la notation, requêtes invalides incluses : 5.85 s et 6.13 s. Sur 180 sondes, 110 étaient valides et 70 invalides, car la réflexion a consommé le budget de sortie du test de vitesse.
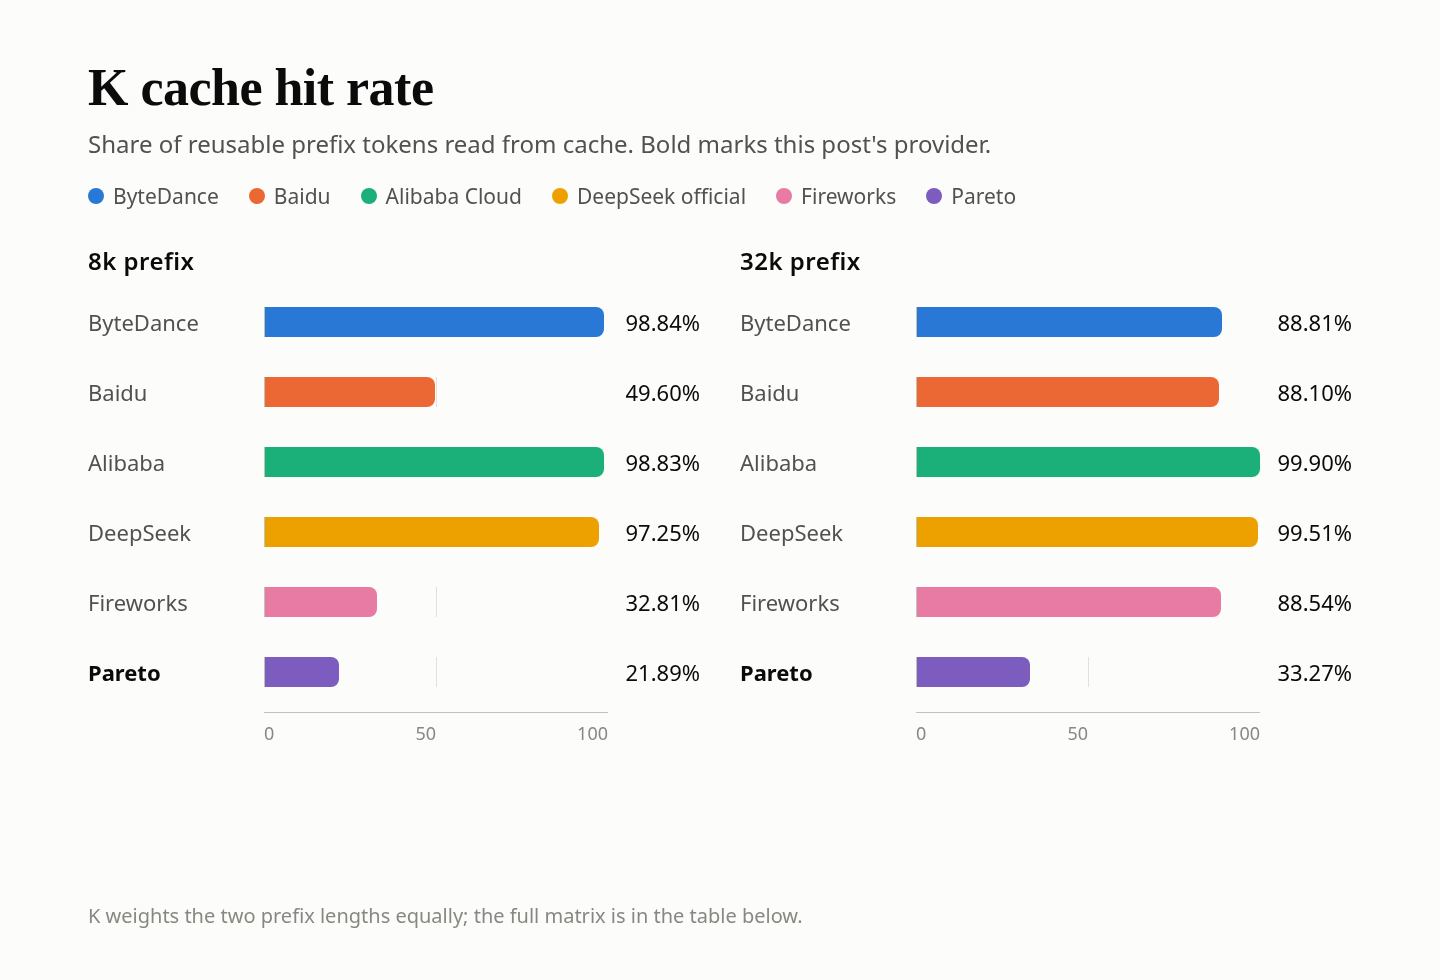
- K — cache : 27.58. 8k à chaud : 2/9 (lu 15,872 / réutilisable 72,504) ; 32k à chaud : 3/9 (lu 96,000 / réutilisable 288,513). Score établi avec la configuration par défaut.
- R — stabilité du service : 100. 300/300 requêtes dédiées ont réussi dès la première tentative.
Configuration du test
| Élément | Paramètre |
|---|---|
| Modèle | DeepSeek V4.1 Flash 1017 |
| ID du modèle demandé | deepseek/deepseek-v4.1-flash |
| Canal d’accès | Pareto, avec l’ID de modèle ci-dessus |
| Paramètres | temperature 1.0, max_tokens 16,384, délai d’expiration 300 s ; requêtes en streaming uniquement |
| Réflexion | Réflexion à forte intensité activée |
| Date | 2026-11-05/06 UTC+8 ; le cache correspond à un nouveau test du 2026-11-06 avec la configuration par défaut |
| Échantillons | Q 4,250 (BFCL 500×3, HLE 250×10, AA-LCR 25×10) ; F 60×3 ; P 90+90 ; R 300 ; K 30 |
| Remarques | Réflexion à forte intensité pour ce test ; les cinq autres fournisseurs de la série n’en utilisaient pas. La prise en charge des fonctionnalités est évaluée sur le sous-ensemble où le streaming est disponible ; le cache utilise la configuration par défaut. |
Les requêtes ont utilisé le démarrage rapide d’AIHubMix ; les ID des modèles figurent sur la page des modèles.
Q — qualité des réponses : 48.40
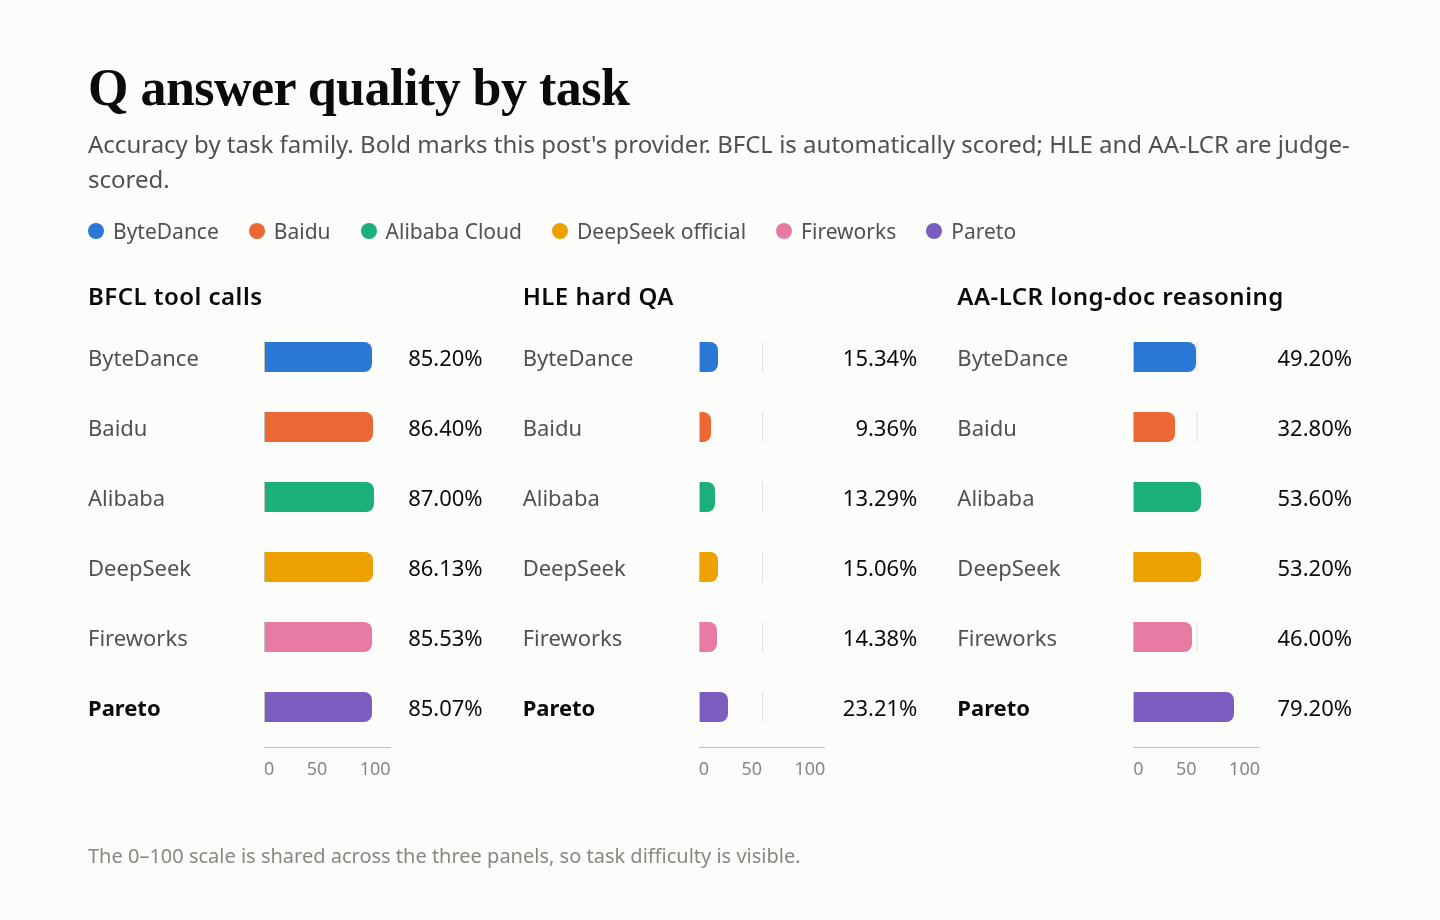
La suite comprenait 500 questions BFCL × 3 tours, 250 questions HLE × 10 et 25 questions AA-LCR × 10. BFCL a été évalué automatiquement ; HLE et AA-LCR ont été évalués par deepseek-flash. Les trois familles utilisent les mêmes éléments que pour les autres fournisseurs. Dix réponses impossibles à noter ont été retirées, laissant 4,240 instances évaluées.
| Tâche | Questions | Réponses correctes | Précision | Échecs |
|---|---|---|---|---|
| Appels d’outils BFCL | 500 × 3 | 1,276/1,500 | 85.07% | 0 |
| Questions-réponses difficiles HLE | 250 × 10 | 578/2,490 | 23.21% | 996 |
| Raisonnement sur des documents longs AA-LCR | 25 × 10 | 198/250 | 79.20% | 0 |
| Total · IC à 95 % : 45.39 %–51.26 % | — | 2,052/4,240 | 48.40% | 996 |
Les échecs restent dans le dénominateur et sont comptés comme incorrects : 996 réponses HLE ont été tronquées lorsque la réflexion a consommé le budget de longueur de sortie. Parmi les 1,494 tentatives HLE ayant produit une réponse complète, 578 étaient correctes (environ 38.7 %).
| Catégorie BFCL | Réussites | Taux de réussite |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 269/300 | 89.67% |
| parallel | 265/300 | 88.33% |
| parallel_multiple | 203/240 | 84.58% |
| irrelevance | 104/150 | 69.33% |
| ahm_multi_turn | 102/150 | 68.00% |
simple_python a réussi 333/360 (92.50 %), multiple 269/300 (89.67 %), ahm_multi_turn 102/150 (68.00 %) et irrelevance 104/150 (69.33 %).
Comparaison avec les cinq autres
Écart en points de pourcentage par rapport au canal officiel ; l’intervalle à 95 % est représenté par des barres d’erreur. S’il traverse 0, la différence n’est pas significative. Le modèle d’évaluation deepseek-flash appartient à la même famille et n’est pas calibré ; il peut donc se montrer indulgent.
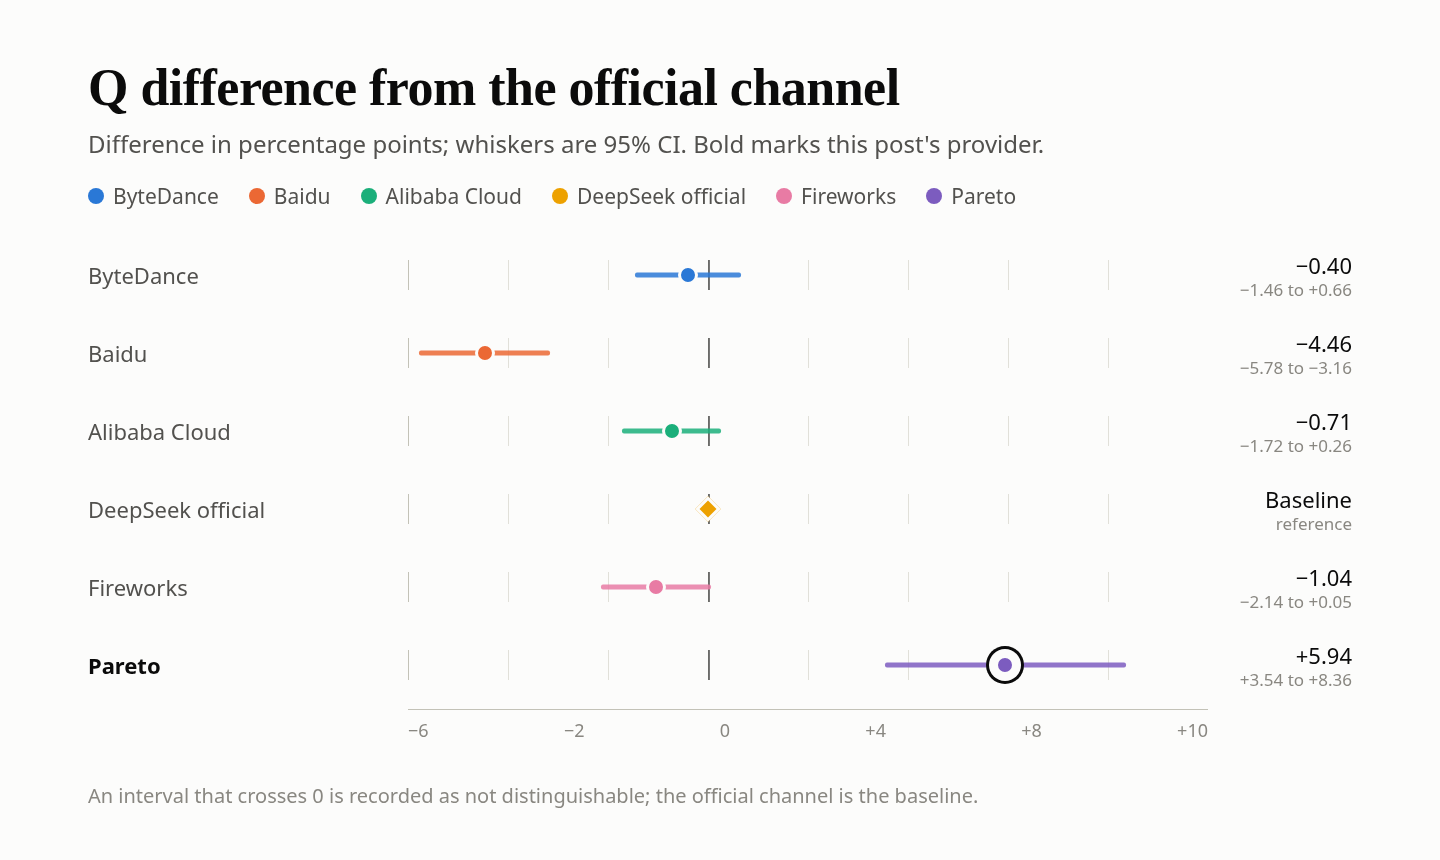
Par rapport au canal officiel, l’écart numérique est de +5.94 (+3.54 à +8.36).
F — prise en charge des fonctions : 93.42
33 vérifications comptabilisées, dont 29 réussies ; 147 exclues. Le score de 93.42 renormalise les pondérations initiales des groupes en fonction des groupes observés (streaming 20 %, erreurs 15 %, comptabilisation 10 % ; total 45 %). Le taux de réussite simple de 29/33 est de 87.88 %. Les outils, les contraintes et le contexte n’ont pas du tout été comptabilisés.
| Groupe de cas | Pondération | Réussites | Exclus | Score du groupe |
|---|---|---|---|---|
| Streaming et messagerie | 20% | 23/27 | 3 | 85.19 |
| Interface des outils | 20% | — | 30 | — |
| Contraintes de sortie | 20% | — | 30 | — |
| Contexte et état | 15% | — | 30 | — |
| Erreurs et récupération | 15% | 3/3 | 27 | 100.00 |
| Comptabilisation et cache | 10% | 3/3 | 27 | 100.00 |
| Observé / pondéré | — | 29/33 | 147 | 93.42 |
« Fenêtres en échec » désigne les trois fenêtres pendant lesquelles le cas n’a pas réussi.
| Cas en échec | Fenêtres en échec | Motif |
|---|---|---|
| Arrêt du streaming | 3/3 | Corps vide avec stop |
| Texte en streaming | 1/3 | Point final supplémentaire à la fin du corps par rapport au jeu de données de référence |
Comparaison avec les cinq autres
P — vitesse de réponse : 57.69
La notation utilise le temps jusqu’au premier token de contenu, et non le temps jusqu’au premier token quel qu’il soit. Lorsque la réflexion est activée, le modèle génère du contenu de réflexion avant le texte de réponse visible ; l’attente du contenu est donc plus longue que l’attente du premier paquet. Lors de chacune des trois fenêtres, 30 requêtes ont été envoyées avec une concurrence de 1 et 30 avec une concurrence de 10, soit 180 au total.
| Métrique | Résultat |
|---|---|
| TTFA du contenu | Médianes utilisées pour la notation : 5.85 s (c=1) et 6.13 s (c=10) ; médianes des requêtes valides : 3.08 s et 4.92 s |
| Premier token, quel qu’il soit | Médianes des requêtes valides : 1.46 s et 1.76 s |
| TPOT | Bande de notation la plus lente : 4.87 ms/token |
| Débit utile | 519 token/s avec une concurrence de 10 |
| Valides | 53/90 à c=1 et 57/90 à c=10, soit 110/180 au total ; 70 invalides, car la réflexion a consommé le budget de sortie du test de vitesse (~2,048 tokens) |
| Composantes | TTFA 24.59, TPOT 100.00, débit utile 72.05 ; score de réponse 65.22 |
| Composition de P | 65.22 × 80% + 27.58 × 20% = 57.69 |
Les tokens de réflexion sont exclus du numérateur du débit utile.
K — cache : 27.58
Lectures agrégées du nouveau test du 2026-11-06 avec la configuration par défaut. Les matrices de cache par requête ne sont pas incluses (les traces brutes n’ont pas été migrées). K pondère également les deux longueurs de préfixe ; K représente 20 % de P.
| Préfixe | Hits à chaud | Lu / réutilisable | Segment |
|---|---|---|---|
| 8k | 2/9 | 15,872 / 72,504 | 21.89 |
| 32k | 3/9 | 96,000 / 288,513 | 33.27 |
| K (pondération égale) | 27.58 |
Les contrôles à froid ont tous réussi : 6/6 pour chaque longueur.
R — stabilité du service : 100
Les 300 requêtes couvraient du texte court, des entrées longues, des appels d’outils et un historique à plusieurs tours, avec une concurrence de 1. Seules la validité et l’exhaustivité de la première réponse ont été vérifiées ; les réponses n’ont pas été évaluées et aucune requête n’a été relancée. Les échecs de Q et P ne sont pas comptabilisés une seconde fois ici.
| Type de requête | Réussite à la première tentative |
|---|---|
| Texte court | 120/120 |
| Entrée longue de 10k | 90/90 |
| Appels d’outils | 60/60 |
| Historique à plusieurs tours | 30/30 |
| Total · IC à 95 % : 98.78 %–100 % | 300/300 |
FAQ
Que couvre Q 48.40 ?
BFCL, HLE et AA-LCR sur 4,240 instances évaluées : 2,052 réponses correctes, soit 48.40 %, IC à 95 % de 45.39 %–51.26 %. Par rapport au canal officiel, l’écart numérique est de +5.94 (+3.54 à +8.36).
Pourquoi y a-t-il eu 996 échecs de service HLE ?
La plupart des réponses ont été tronquées parce que la réflexion a consommé le budget de longueur de sortie ; elles restent dans le dénominateur et sont comptées comme incorrectes.
Pourquoi F est-il de 93.42 alors que 147 vérifications sont exclues ?
Seul le sous-ensemble où le streaming est disponible est comptabilisé. Les pondérations des groupes sont renormalisées en fonction des groupes observés ; les outils, les contraintes et le contexte ne sont pas du tout comptabilisés.
Pourquoi les cas avec stop ont-ils échoué ?
Les requêtes comportant une séquence stop ont renvoyé un corps vide pendant les trois fenêtres.
Pourquoi 70 des 180 sondes de vitesse étaient-elles invalides ?
La réflexion a consommé le budget de sortie du test de vitesse (environ 2,048 tokens).
Que couvre R 100 ?
300 requêtes dédiées, toutes valides dès la première tentative ; la borne inférieure à 95 % est de 98.78 %. Les échecs de Q et P ne sont pas comptabilisés dans R.
Poursuivre la lecture : la série DeepSeek V4.1 Flash
- ByteDance a signalé des tokens de réflexion alors que la réflexion était désactivée : DeepSeek V4.1 Flash sur ByteDance : les appels d’outils correspondent, pas la comptabilisation
- Baidu a enregistré Q 38.00 et P 37.77 : DeepSeek V4.1 Flash sur Baidu : aucun canal disponible n’atteint Q et P
- Alibaba Cloud a enregistré un premier token en 1.34 s et un score de cache de 99.37 : DeepSeek V4.1 Flash sur Alibaba Cloud : premier token en 1.34s, cache à 99.37
- Le canal officiel sert de référence pour Q, avec F 94.00 : DeepSeek V4.1 Flash sur le canal officiel : F 94.00, 15 sondes invalides
- Fireworks a renvoyé des réponses vides avec stop et obtenu 3/9 hits de cache à 8k : DeepSeek V4.1 Flash sur Fireworks : réponses vides avec stop, 3/9 hits de cache


