

Lors de l’exécution APB Full des 2026-11-03/04, les quatre scores de Pareto sont Q 44.58, F 93.42, P 57.69 et R 100, pour un score global de 68.72. Les requêtes à chaud de 8k ont obtenu 2 hits sur 9 et celles de 32k, 3 sur 9.
Les 2026-11-03/04, DeepSeek V4.1 Flash 1017 a été testé chez six fournisseurs via AIHubMix avec la suite APB Full, en utilisant les mêmes questions, paramètres et scripts de requête pour chacun. Ce profil APB porte uniquement sur Pareto : ce que mesurait chaque section et ses résultats.
Les chiffres ci-dessous sont des scores, pas un classement ni une recommandation de fournisseur. Les quatre scores, Q, F, P et R, sont présentés en premier ; le score global est un indice récapitulatif, pas une certification, et il n’a pas d’intervalle de confiance. Les règles de calcul des scores sont définies dans AIHubMix Provider Benchmark Standard v2.0.
Scores de six fournisseurs
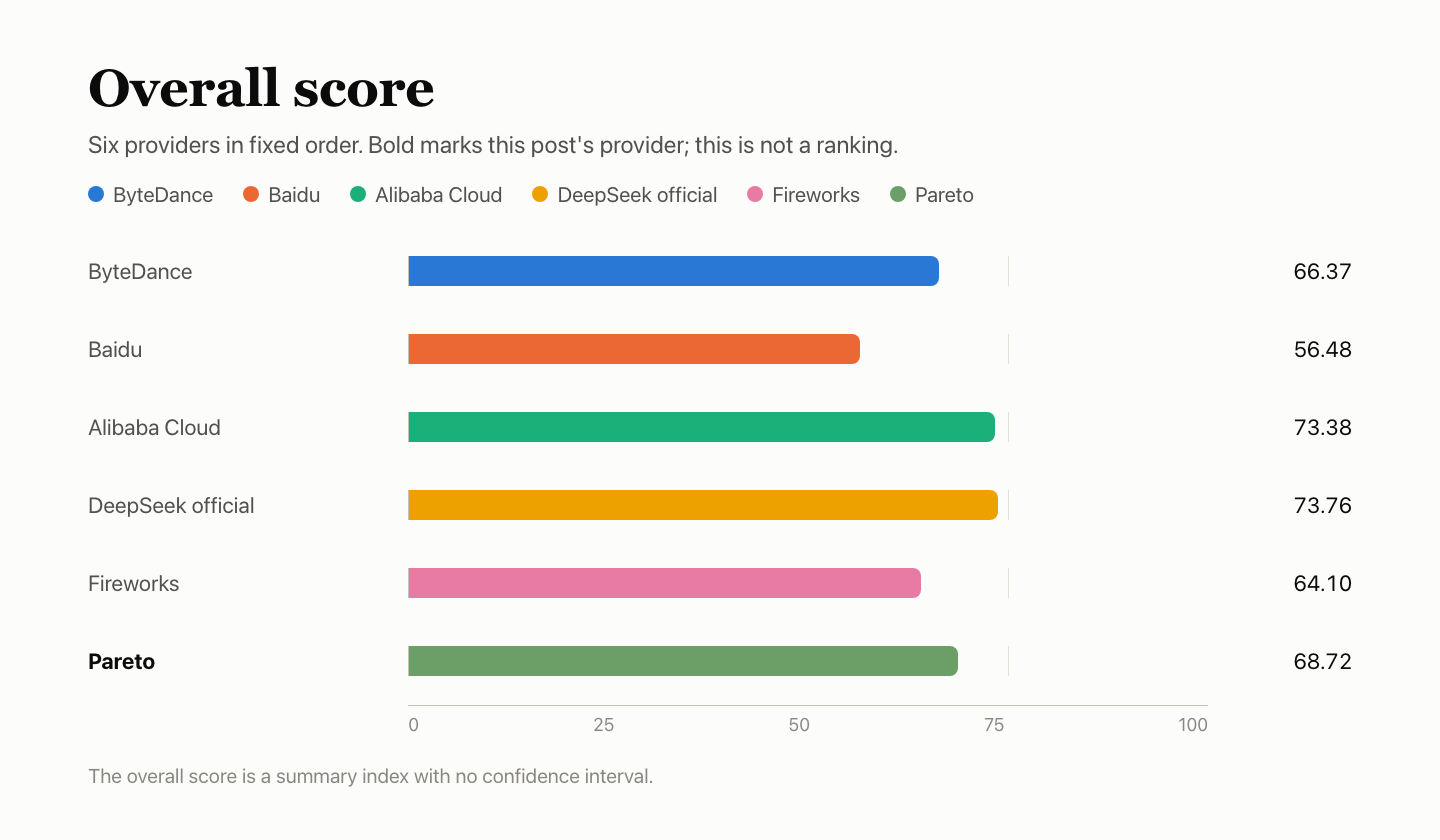
| Fournisseur | Q qualité | F fonctions | P vitesse | K cache | R stabilité | Score global |
|---|---|---|---|---|---|---|
| ByteDance | 42.05 | 74.98 | 84.37 | 93.83 | 100 | 66.37 |
| Baidu | 38.00 | 88.39 | 37.77 | 68.85 | 100 | 56.48 |
| Alibaba Cloud | 41.75 | 89.78 | 88.58 | 99.37 | 100 | 73.38 |
| Canal officiel DeepSeek | 42.45 | 94.00 | 86.14 | 98.38 | 100 | 73.76 |
| Fireworks | 41.42 | 71.78 | 79.51 | 60.68 | 100 | 64.10 |
| Pareto (cet article) | 44.58 | 93.42 | 57.69 | 27.58 | 100 | 68.72 |
Les fournisseurs sont présentés dans un ordre fixe, et non par classement. K est un sous-score de P, dont il représente 20 %, et figure séparément à titre indicatif. Le score global est calculé selon les règles de composition de l’AIHubMix Provider Benchmark Standard, qui tiennent également compte de la comparaison avec le canal officiel et de l’exhaustivité des éléments de preuve ; il ne correspond pas à une pondération directe des quatre scores du tableau. C’est un indice récapitulatif sans intervalle de confiance. L’écart de score global entre le canal officiel DeepSeek et Alibaba Cloud n’est que de 0.37, une différence qui n’est pas discernable.
En un coup d’œil
- Qualité des réponses : Q 44.58, avec BFCL à 85.27%, HLE à 19.32% et AA-LCR à 52.00%. L’écart avec le canal officiel est de +2.12 points de pourcentage, avec un intervalle à 95 % de −0.02 à +4.18 : il n’est pas discernable.
- Prise en charge des fonctions : F 93.42, avec 29 des 33 vérifications initialement notées réussies. Les appels d’outil et les allers-retours avec les résultats des outils, les appels parallèles et nommés, le mode JSON et l’historique de conversation disposent aussi d’enregistrements de streaming réussis ; les scores conservent leurs valeurs initiales.
- Vitesse de réponse : P 57.69. Médiane du premier token du corps : 5.85 s avec une seule requête simultanée et 6.13 s avec 10 requêtes simultanées ; TPOT de 4.63 ms ; 110 requêtes de vitesse sur 180 étaient valides.
- Cache : K 27.58. Les requêtes à chaud de 8k ont obtenu 2 hits sur 9 et celles de 32k, 3 sur 9 ; aucune lecture témoin à froid n’a utilisé le cache.
- Stabilité du service : R 100. Les 300 requêtes dédiées ont toutes réussi dès la première tentative.
Configuration du test
| Élément | Détail |
|---|---|
| Modèle | DeepSeek V4.1 Flash 1017 |
| ID du modèle demandé | deepseek/deepseek-v4.1-flash |
| Nom du modèle renvoyé | deepseek/deepseek-v4.1-flash |
| Voie d’accès | Via AIHubMix, avec un ID de modèle propre au fournisseur, et non une connexion directe au compte du fournisseur |
| Paramètres | Profil de requête APB v2 fixe, temperature 1.0, max_tokens 16,384, délai d’expiration de 300 s, aucune nouvelle tentative automatique |
| Période | 2026-11-03 18:07 – 11-04 16:33 ; requêtes de cache : 11-05 19:31 – 11-06 10:35 ; toutes les heures sont en UTC+8. Les six fournisseurs utilisaient le même Mac mini, le même réseau et le même compte. |
| Échantillons | Q : 4,250 instances-question ; F : 180 vérifications ; P : 180 requêtes ; R : 300 ; K : 30 |
Les requêtes ont emprunté la voie de démarrage rapide d’AIHubMix avec un ID de modèle propre au fournisseur ; les ID des autres fournisseurs figurent sur la page des modèles. Les paramètres propres au modèle sont décrits dans la documentation API de DeepSeek.
Q — qualité des réponses : 44.58
La qualité des réponses repose sur trois suites : 500 questions BFCL avec 3 réponses chacune, 250 questions HLE avec 10 réponses chacune et 25 questions AA-LCR avec 10 réponses chacune. BFCL est évalué selon des règles automatiques ; les réponses HLE et AA-LCR sont jugées correctes ou incorrectes par le modèle de jugement deepseek-flash. Les six fournisseurs ont reçu les mêmes questions, et les résultats des trois suites sont regroupés en un seul taux de réussite. Dix réponses ont été retirées car la question ne pouvait pas être évaluée, laissant 4,240 instances-question notées.
| Suite | Questions × tours | Correctes | Taux de réussite | Échecs du service |
|---|---|---|---|---|
| Appels d’outil BFCL, évaluation automatique | 500 × 3 | 1,279/1,500 | 85.27% | 0 |
| Questions-réponses difficiles HLE, évaluées par un modèle de jugement | 250 × 10 | 481/2,490 | 19.32% | 0 |
| Raisonnement sur de longs documents AA-LCR, évalué par un modèle de jugement | 25 × 10 | 130/250 | 52.00% | 0 |
| Total · intervalle à 95 % : 41.57%–47.49% | — | 1,890/4,240 | 44.58% | 0 |
Chaque instance-question a reçu une réponse complète ; aucun échec du service n’a été constaté.
| Catégorie BFCL | Réussies | Taux de réussite |
|---|---|---|
| simple_python : une fonction, appel et arguments corrects | 333/360 | 92.50% |
| multiple : choisir la bonne fonction parmi plusieurs | 269/300 | 89.67% |
| parallel : appeler plusieurs fois une fonction simultanément | 265/300 | 88.33% |
| parallel_multiple : appeler plusieurs fonctions simultanément | 203/240 | 84.58% |
| irrelevance : aucune fonction pertinente, donc aucun appel | 109/150 | 72.67% |
| ahm_multi_turn : chaîne d’outils en trois étapes | 100/150 | 66.67% |
Chaque question BFCL a reçu 3 réponses ; le tableau totalise les 3 tours.
Comparaison avec les cinq autres
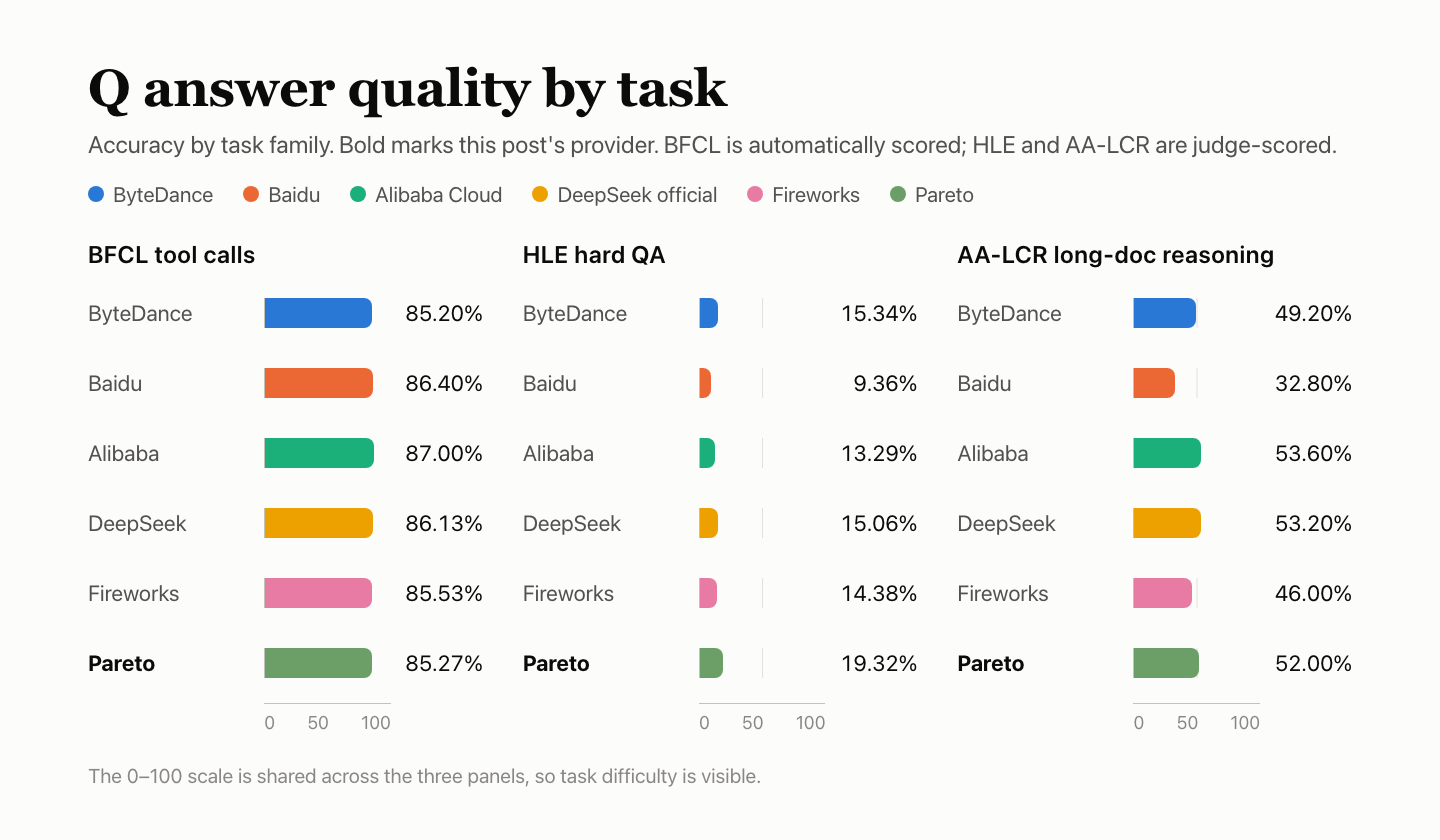
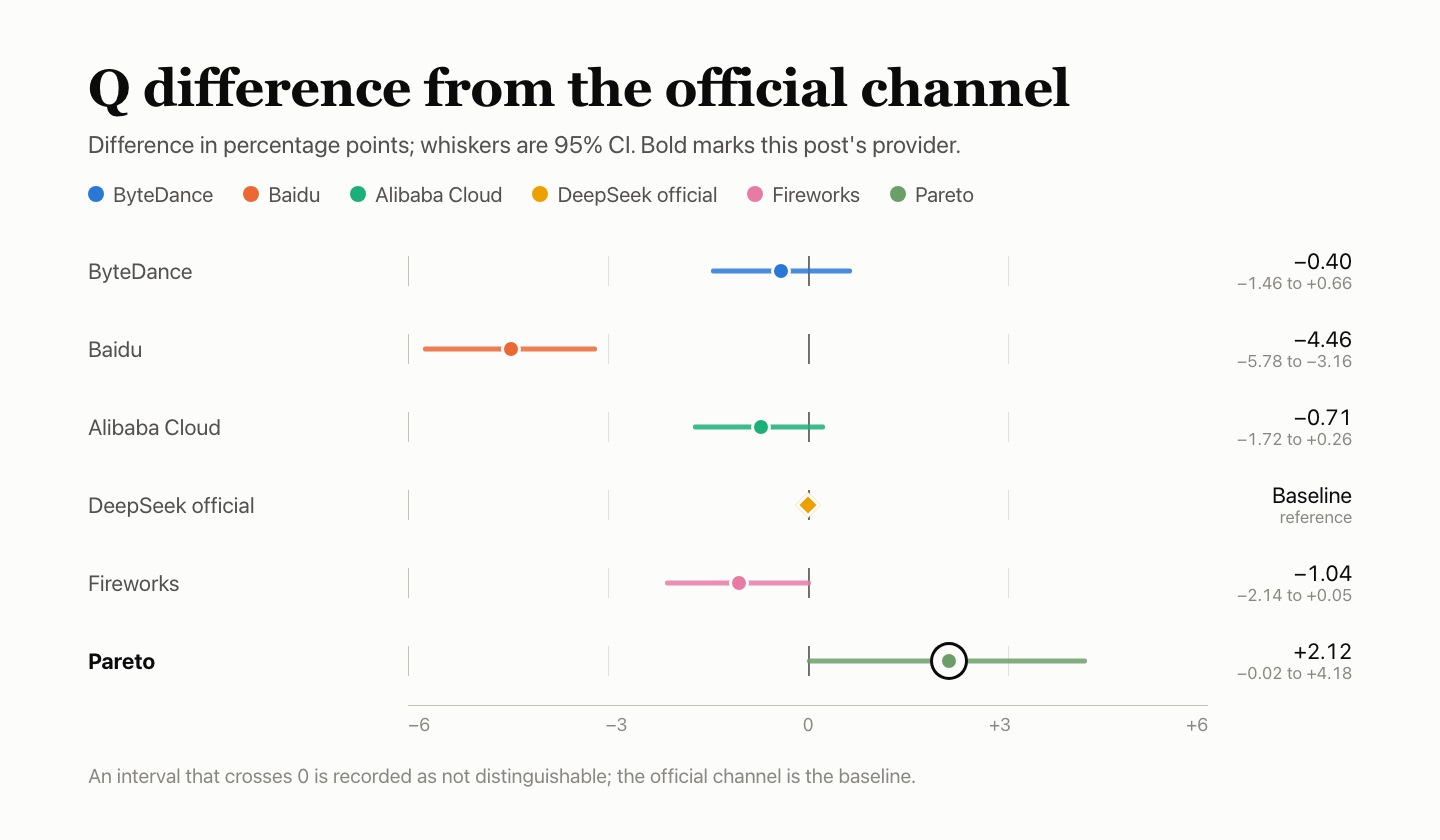
| Fournisseur | BFCL | HLE | AA-LCR | Combiné | Vs officiel |
|---|---|---|---|---|---|
| ByteDance | 85.20% | 15.34% | 49.20% | 42.05% | −0.40 (−1.46 à +0.66), non discernable |
| Baidu | 86.40% | 9.36% | 32.80% | 38.00% | −4.46 (−5.78 à −3.16), inférieur à l’officiel |
| Alibaba Cloud | 87.00% | 13.29% | 53.60% | 41.75% | −0.71 (−1.72 à +0.26), non discernable |
| Canal officiel DeepSeek | 86.13% | 15.06% | 53.20% | 42.45% | Référence |
| Fireworks | 85.53% | 14.38% | 46.00% | 41.42% | −1.04 (−2.14 à +0.05), non discernable |
| Pareto (cet article) | 85.27% | 19.32% | 52.00% | 44.58% | +2.12 (−0.02 à +4.18), non discernable |
Vs officiel : l’écart de taux de réussite en points de pourcentage, avec l’intervalle à 95 % entre parenthèses ; si l’intervalle inclut 0, le résultat est considéré comme non discernable. Le modèle de jugement HLE et AA-LCR, deepseek-flash, appartient à la même famille DeepSeek que le modèle testé et n’a pas été étalonné ; ses jugements peuvent donc être indulgents.
F — prise en charge des fonctions : 93.42
Les tests de fonctions vérifient si le comportement de l’interface est conforme au protocole. Le score F de 93.42 est calculé à partir des 33 vérifications comptabilisées (29 réussies), après renormalisation des pondérations des groupes observés ; les 147 autres emplacements de vérification prévus dans la suite initiale ont été exclus du calcul.
| Groupe de cas | Pondération | Réussites / observations en streaming | Exclus | Score du groupe |
|---|---|---|---|---|
| Streaming et protocole des messages | 20% | 23/27 | 3 | 85.19 |
| Interface des outils Appels d’outil, aller-retour des résultats d’outil, appels parallèles et nommés | 20% | Réussites en streaming observées* | 30 | — |
| Contraintes de sortie et paramètres Mode JSON et réflexion désactivée | 20% | Réussites en streaming observées* | 30 | — |
| Contexte et état Historique de conversation et instructions système | 15% | Réussites en streaming observées* | 30 | — |
| Erreurs et récupération | 15% | 3/3 | 27 | 100.00 |
| Protocole de comptabilisation et de cache | 10% | 3/3 | 27 | 100.00 |
| Total · score pondéré | 29/33 | 147 | 93.42 | |
- Les fonctions répertoriées disposent d’enregistrements de streaming réussis ; cela ne vaut pas la note maximale pour l’ensemble du groupe. Aucune vérification n’est ajoutée au calcul du score. F 93.42 et le score global de 68.72 conservent leurs valeurs initiales.
| Cas échoué | Fenêtres | Raison |
|---|---|---|
| Séquence d’arrêt du streaming Streaming et protocole des messages | 3/3 | Corps vide avec une séquence d’arrêt ; la même entrée fonctionnait sans séquence d’arrêt |
| Texte de sortie exact Streaming et protocole des messages | 1/3 | Un point final supplémentaire a fait échouer la correspondance exacte du texte |
« Fenêtres » indique combien des 3 fenêtres ont échoué à la vérification.
Chez plusieurs fournisseurs, les cas de messages mal formés et d’options de streaming mal formées ont renvoyé une réponse 400 avec un corps vide. La comptabilisation des tokens de raisonnement variait selon les fournisseurs.
Comparaison avec les cinq autres
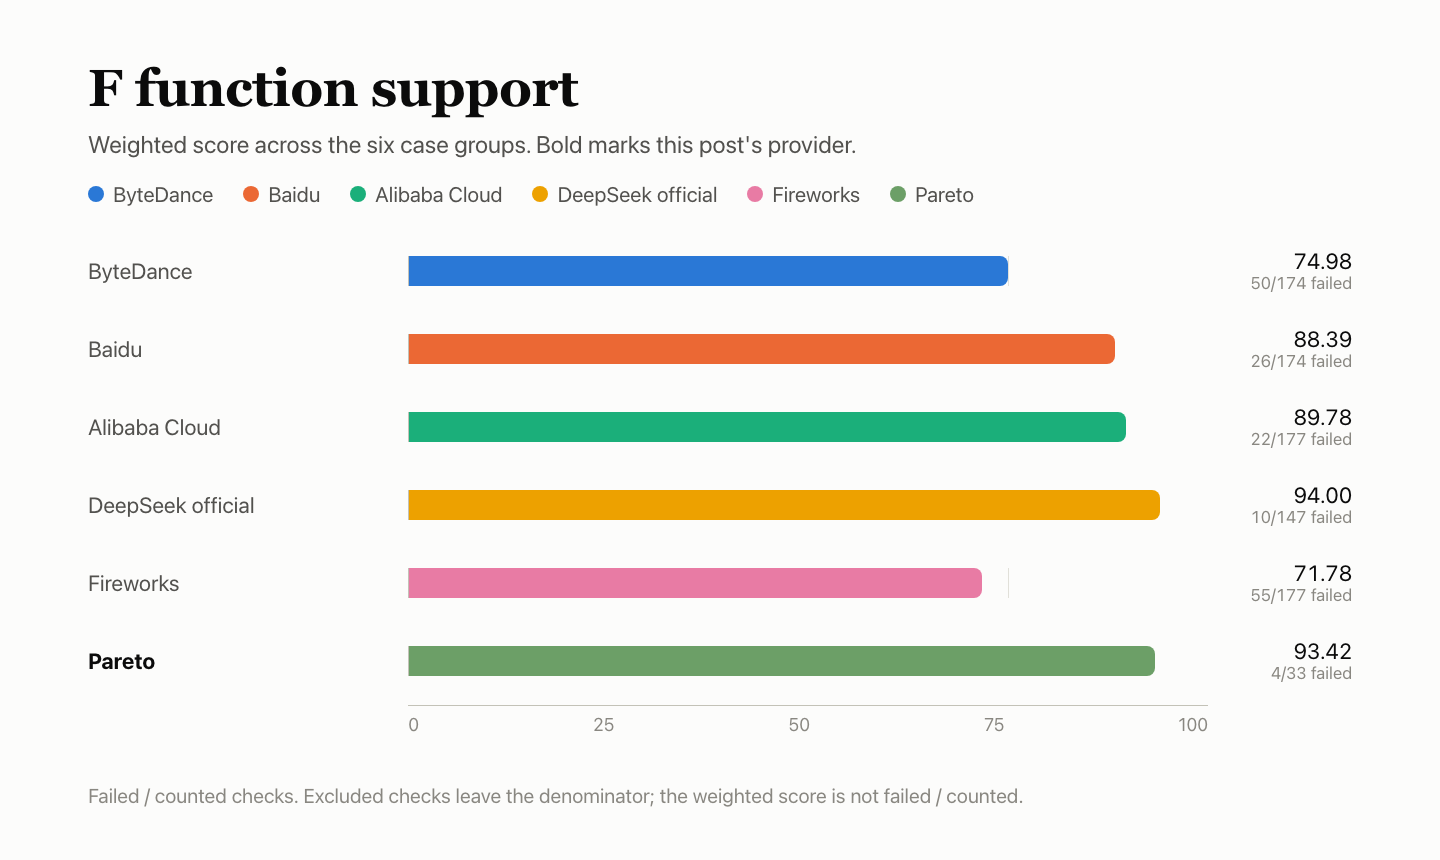
| Fournisseur | Réussies | Échouées | Exclues | Score pondéré |
|---|---|---|---|---|
| ByteDance | 124 | 50 | 6 | 74.98 |
| Baidu | 148 | 26 | 6 | 88.39 |
| Alibaba Cloud | 155 | 22 | 3 | 89.78 |
| Canal officiel DeepSeek | 137 | 10 | 33 | 94.00 |
| Fireworks | 122 | 55 | 3 | 71.78 |
| Pareto (cet article) | 29 | 4 | 147 | 93.42 |
P — vitesse de réponse : 57.69
Chaque requête contenait environ 10,000 tokens d’entrée et demandait environ 1,100 tokens de texte dans le corps de la réponse. Dans chacune des trois fenêtres, 30 requêtes ont été exécutées avec une seule requête simultanée et 30 avec 10 requêtes simultanées : 180 requêtes au total.
| Élément | Détail |
|---|---|
| Premier token du corps (TTFA) | Médiane de 5.85 s en exécution séquentielle (3.08 s pour les requêtes valides uniquement), 6.13 s avec 10 requêtes simultanées (4.92 s pour les requêtes valides uniquement) |
| Vitesse de génération (TPOT) | 4.42 ms/token en exécution séquentielle, 4.63 ms/token avec 10 requêtes simultanées |
| Débit effectif | 519.4 token/s avec 10 requêtes simultanées |
| Requêtes valides | 53/90 en exécution séquentielle (fenêtres 1–3 : 15/30, 18/30, 20/30), 57/90 avec 10 requêtes simultanées (23/30, 16/30, 18/30) ; parmi les requêtes invalides : 70 ont renvoyé 200 avec None |
| Sous-scores | TTFA 24.59, TPOT 100.00, débit 72.05 ; TTFA et TPOT utilisent le palier inférieur, avec une pondération de 35 % / 35 % / 30 % : score de réponse de 65.22 |
| Score P | Score de réponse 65.22 × 80% + cache K 27.58 × 20% = 57.69 |
Les requêtes invalides sont évaluées comme infinies ; les médianes du tableau peuvent donc être supérieures aux médianes des seules requêtes valides. Le TPOT est estimé à partir des segments transmis en streaming, et non mesuré token par token sur le matériel. Le débit correspond aux tokens de sortie valides à 10 requêtes simultanées, divisés par le temps mural du lot.
Comparaison avec les cinq autres
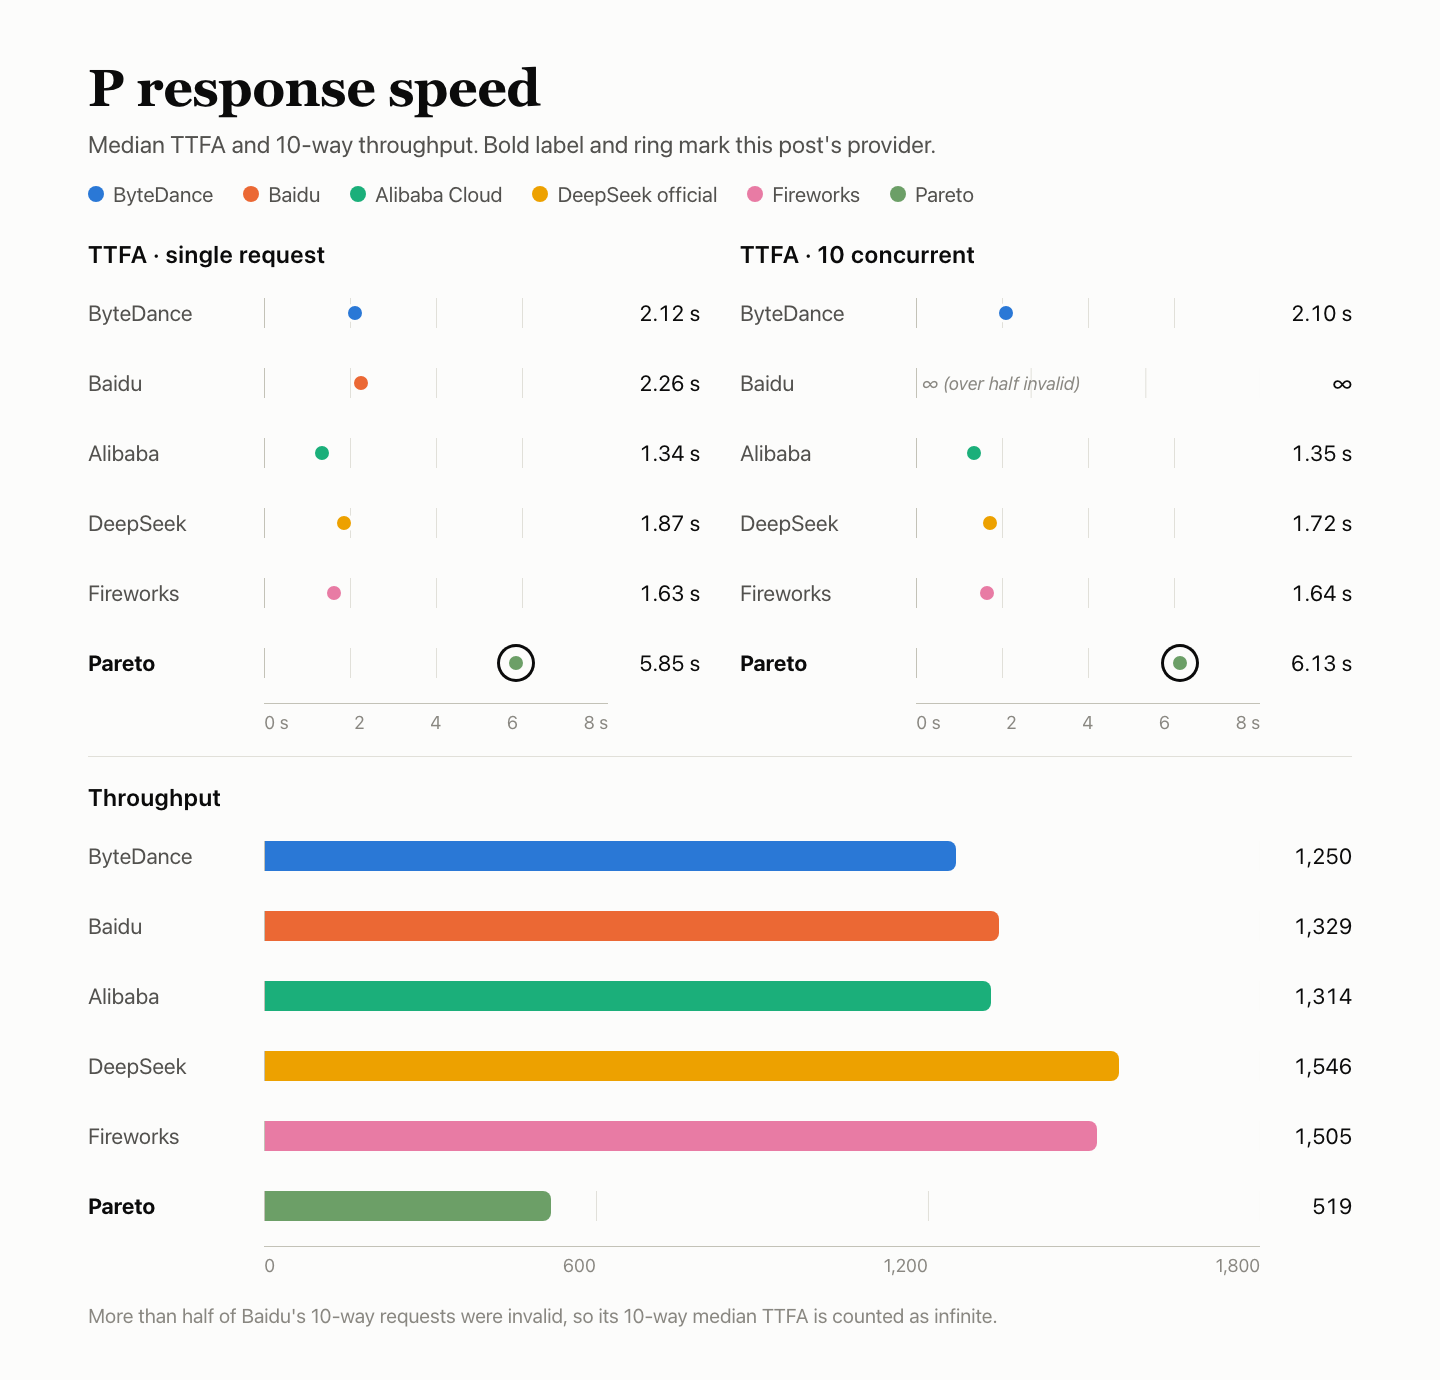
| Fournisseur | Requêtes valides | TTFA en exécution séquentielle | TTFA avec 10 requêtes simultanées | TPOT (plus lent) | Débit tok/s | Réponse |
|---|---|---|---|---|---|---|
| ByteDance | 180/180 | 2.12 s | 2.10 s | 3.43 ms | 1,250 | 82.00 |
| Baidu | 118/180 | 2.26 s | ∞ | 50.00 ms | 1,329 | 30.00 |
| Alibaba Cloud | 180/180 | 1.34 s | 1.35 s | 4.69 ms | 1,314 | 85.88 |
| Canal officiel de DeepSeek | 165/180 | 1.87 s | 1.72 s | 2.84 ms | 1,546 | 83.08 |
| Fireworks | 179/180 | 1.63 s | 1.64 s | 3.29 ms | 1,505 | 84.22 |
| Pareto (cet article) | 110/180 | 5.85 s | 6.13 s | 4.63 ms | 519 | 65.22 |
Les six fournisseurs partageaient la même machine, le même réseau et le même compte. Les trois fenêtres ont été planifiées fournisseur par fournisseur ; les périodes de collecte ne se chevauchent donc pas entièrement. Il ne faut pas accorder trop d’importance aux petits écarts. ∞ signifie que plus de la moitié des requêtes étaient invalides ; la médiane est donc considérée comme infinie.
K — cache : 27.58
Chaque groupe envoie cinq requêtes. La première comporte un préfixe fixe d’environ 8k ou 32k tokens et alimente le cache. Les requêtes 2 à 4 conservent le préfixe et ne modifient que la question finale, avec des intervalles de 5 s, 30 s et 120 s. La cinquième utilise un nouveau préfixe comme témoin à froid. Trois fenêtres × deux longueurs donnent 30 requêtes. K correspond au nombre de tokens lus dans le cache par les requêtes à chaud, divisé par le nombre de tokens qui devraient être réutilisables selon les règles, les deux longueurs étant pondérées de manière égale ; K représente 20% de P.
| Fenêtre | 1 · initialisation | 2 · +5 s | 3 · +30 s | 4 · +120 s | 5 · à froid |
|---|---|---|---|---|---|
| Préfixe de 8k · succès du cache à chaud : 2/9 · 15,872 tokens lus sur 72,504 réutilisables · 21.89 | — | — | — | — | — |
| Fenêtre 1 | 0 | 0 | 7,936 | 0 | 0 |
| Fenêtre 2 | 0 | 0 | 0 | 0 | 0 |
| Fenêtre 3 | 0 | 0 | 7,936 | 0 | 0 |
| Préfixe de 32k · succès du cache à chaud : 3/9 · 96,000 tokens lus sur 288,513 réutilisables · 33.27 | — | — | — | — | — |
| Fenêtre 1 | 0 | 0 | 32,000 | 0 | 0 |
| Fenêtre 2 | 0 | 0 | 0 | 0 | 0 |
| Fenêtre 3 | 0 | 0 | 0 | 32,000 | 0 |
| K (pondération égale des préfixes de 8k et 32k) | — | — | — | — | 27.58 |
Valeurs correspondant aux tokens lus dans le cache, telles que signalées par le serveur ; « Non renvoyé » signifie que le champ était absent de la réponse.
Les requêtes à chaud avec préfixe de 8k ont obtenu 2 succès sur 9, lisant 7,936 tokens à chaque succès ; celles avec préfixe de 32k ont obtenu 3 succès sur 9, lisant 32,000 tokens à chaque succès. Les requêtes à froid n’ont lu aucune donnée du cache : les requêtes à chaud et à froid sont donc clairement distinguées.
Comparaison avec les cinq autres
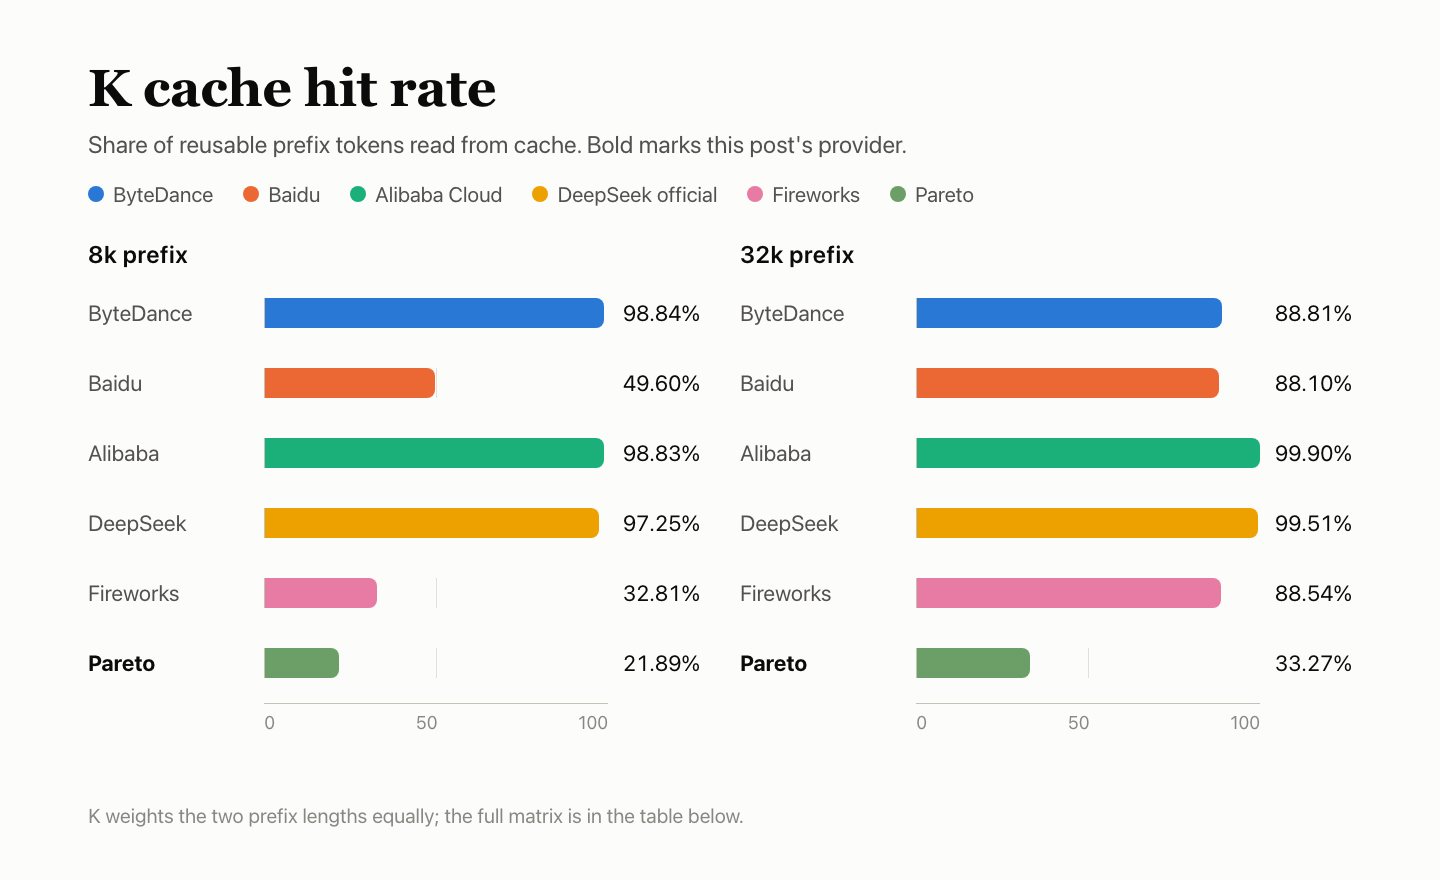
| Fournisseur | Succès avec 8k | 8k | Succès avec 32k | 32k | K |
|---|---|---|---|---|---|
| ByteDance | 9/9 | 98.84 | 8/9 | 88.81 | 93.83 |
| Baidu | 5/9 | 49.60 | 8/9 | 88.10 | 68.85 |
| Alibaba Cloud | 9/9 | 98.83 | 9/9 | 99.90 | 99.37 |
| Canal officiel de DeepSeek | 9/9 | 97.25 | 9/9 | 99.51 | 98.38 |
| Fireworks | 3/9 | 32.81 | 8/9 | 88.54 | 60.68 |
| Pareto (cet article) | 2/9 | 21.89 | 3/9 | 33.27 | 27.58 |
R — stabilité du service : 100
Les 300 requêtes se répartissent en quatre types : texte court, entrée longue, appels d’outil et historique multi-tour. Elles ont été exécutées à concurrence unique sur trois fenêtres. Seule la validité et l’exhaustivité de la réponse au premier essai sont vérifiées ; les réponses ne sont pas évaluées et aucune nouvelle tentative n’est effectuée. Les échecs des sections sur la qualité des réponses et la vitesse sont comptabilisés dans Q et P, et non une seconde fois dans R.
| Type de requête | Réussite au premier essai |
|---|---|
| Texte court | 120/120 |
| Entrée longue de 10k | 90/90 |
| Appels d’outil | 60/60 |
| Historique multi-tour | 30/30 |
| Total · intervalle à 95% : 98.78%–100% | 300/300 |
Les 300 requêtes ont toutes renvoyé une réponse valide et complète au premier essai. R = 100 ne décrit que ces 300 requêtes dédiées ; cela ne signifie pas que l’ensemble du processus n’a connu aucun échec. La borne inférieure de l’intervalle à 95% est de 98.78% : 300 réussites sur 300 permettent seulement d’affirmer que le taux d’échec est probablement inférieur à 1.22%.
Comparaison avec les cinq autres
| Fournisseur | Réussite au premier essai | Intervalle à 95% |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| Canal officiel de DeepSeek | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
| Pareto (cet article) | 300/300 | 98.78%–100% |
R ne couvre que ces 300 requêtes dédiées ; les échecs des sections sur la qualité des réponses et la vitesse sont consignés dans Q et P et ne sont pas comptabilisés une seconde fois dans R.
FAQ
Pourquoi F est-il de 93.42 alors que seuls 33 contrôles ont été comptabilisés ?
Les contrôles effectivement comptabilisés ont réussi dans 29 cas sur 33, donnant F = 93.42 après renormalisation des pondérations observées des groupes ; les 147 autres contrôles prévus ont été exclus du calcul. Les enregistrements du streaming décrivent des fonctionnalités qui fonctionnent et n’ajoutent aucun contrôle comptabilisé. Le score global affiché reste de 68.72.
Pourquoi P est-il de 57.69 alors que le TPOT a obtenu 100.00 ?
Seules 110 des 180 requêtes de vitesse étaient valides ; 70 ont renvoyé 200 avec None. Les requêtes invalides sont comptées comme infinies : la médiane du délai avant le premier token du corps est donc de 5.85 s en concurrence unique et de 6.13 s à 10 voies (3.08 s et 4.92 s pour les seules requêtes valides). Le TTFA a obtenu 24.59 et le débit 72.05, soit un score de réponse de 65.22 ; avec K, le score du cache, à 27.58 et pondéré à 20%, P est de 57.69.
Pourquoi K n’est-il que de 27.58 ?
Les requêtes à chaud ont obtenu 2 succès sur 9 avec 8k (21.89) et 3 sur 9 avec 32k (33.27), les deux longueurs étant pondérées de manière égale. Lorsqu’un succès a eu lieu, 7,936 ou 32,000 tokens ont été lus, tandis qu’aucun témoin à froid n’a lu le cache.
La qualité des réponses de Pareto est-elle supérieure à celle du canal officiel ?
Pas de manière statistiquement distinguable. La précision combinée est de 44.58% contre 42.45%, soit un écart de +2.12 points, mais l’intervalle à 95% va de −0.02 à +4.18 et inclut 0. Le juge HLE et AA-LCR, deepseek-flash, n’a pas été calibré et peut se montrer indulgent.
Quels cas de F ont échoué ?
Deux cas. La séquence d’arrêt en streaming a renvoyé un corps vide dans les trois fenêtres, alors que la même entrée sans séquence d’arrêt fonctionnait. La sortie de texte exacte comportait un point final supplémentaire dans une fenêtre sur trois.
À lire ensuite : la série DeepSeek V4.1 Flash
- L’écart de Q de Pareto, de +2.12, est mesuré par rapport au canal officiel ; l’exécution de référence est présentée dans Revue de DeepSeek V4.1 Flash sur le canal officiel de DeepSeek : référence de comparaison, 15 requêtes invalides en concurrence unique.
- Fireworks a également renvoyé des corps vides pour les requêtes avec séquence d’arrêt, et a obtenu 3 succès sur 9 avec 8k : Revue de DeepSeek V4.1 Flash sur Fireworks : les requêtes avec séquence d’arrêt renvoient un corps vide, 3 succès sur 9 pour les requêtes à chaud avec cache de 8k.
- Les requêtes à chaud d’Alibaba Cloud ont obtenu 18 succès sur 18, contre 5 sur 18 pour Pareto : Revue de DeepSeek V4.1 Flash sur Alibaba Cloud : premier token du corps en 1.34 s, succès du cache pour les 18 requêtes à chaud, réponses indiscernables de celles du canal officiel.
- Toutes les requêtes de vitesse de ByteDance étaient valides, avec un premier token du corps en 2.12 s : Revue de DeepSeek V4.1 Flash sur ByteDance : réponses indiscernables de celles du canal officiel, incohérence dans le décompte des entrées.
- Baidu a également perdu de nombreuses requêtes de vitesse à cause de no_available_channel : Revue de DeepSeek V4.1 Flash sur Baidu : appels d’outil comparables au canal officiel, les fréquentes erreurs no-available-channel pénalisent la qualité des réponses et la vitesse.
Sources
- Page du modèle DeepSeek V4.1 Flash 1017 (AIHubMix)
- Norme de benchmark des fournisseurs AIHubMix v2.0 (documentation AIHubMix)
- Démarrage rapide (documentation AIHubMix)
- Modèles (AIHubMix)
- Documentation de l’API DeepSeek (DeepSeek)


