

Gemini 4 Hydrogen cuesta el doble por token que la tarifa introductoria de Gemini 3.8 Flash: $1.50 por millón de tokens de entrada y $7.50 por millón de tokens de salida, frente a $0.75 y $3.75. Según las mediciones en tiempo real de Artificial Analysis, Hydrogen completa una tarea del índice por $1.87; Gemini 3.8 Flash cuesta $7.77. El precio por token se duplicó, pero el costo por tarea completada se redujo en aproximadamente tres cuartas partes.
Ese es el aspecto inusual de esta actualización. Google recomienda Hydrogen como actualización desde Gemini 3.8 Flash y los modelos Gemini 3 y 2.5 anteriores, pero no es una renovación de Flash. La ficha del modelo lo dice claramente: «Gemini 4 Hydrogen está adaptado de Gemini 4 Carbon». Hereda la ventana de contexto de Gemini 4, la ruta de decodificación prolongada de Gemini 4 y un nuevo nivel de pensamiento, xhigh, a la vez que mantiene una función propia de Flash: ejecución rápida y de gran volumen.
El resultado es un modelo más fácil de justificar por presupuesto por tarea que por token. A continuación: qué cambió, qué indican las mediciones, dónde deja de ser conveniente la actualización y cómo llamarlo a través de AIHubMix.
Qué es Hydrogen
Hydrogen pasó a estar disponible para el público general el 2026-11-12, según el registro de cambios de Gemini API; la ficha del modelo tiene la misma fecha. En la publicación de lanzamiento, Google lo llama «nuestro modelo de uso diario para flujos de trabajo con agentes» y presenta Carbon y Argon como los modelos «diseñados para el razonamiento profundo y de largo horizonte». En palabras de la ficha del modelo, Hydrogen es el modelo «diseñado para la ejecución rápida en diversos flujos de trabajo con agentes», y puede funcionar por sí solo o como subagente junto a los modelos de vanguardia.
Hay tres datos del lanzamiento importantes para quienes usan la API. Es el único modelo Gemini 4 disponible en el nivel gratuito: Google afirma que está disponible «tanto en los niveles gratuito como de pago de Google AI Studio y Gemini API». También es el único modelo Gemini 4 con pensamiento xhigh. Y, según el registro de cambios, es el modelo predeterminado del agente Antigravity en Gemini Managed Agents.
Conviene mencionar una salvedad desde el principio. La documentación empresarial de Google califica Hydrogen como «una versión de disponibilidad general (GA) a corto plazo, sujeta a una política de aviso de retirada con un mínimo de 45 días». La página de obsolescencias no indica una fecha de cierre, pero cualquier equipo que planee depender del modelo a largo plazo debería interpretar esa frase como una advertencia para mantener configurable la cadena del modelo.
Qué cambia respecto de Gemini 3.8 Flash
Los dos modelos comparten más de lo que su nivel de precios sugiere. En la API de Google, ambos admiten un contexto de 1,048,576 tokens, aceptan entradas de texto, imagen, audio y video, y están disponibles en el nivel gratuito. La página del modelo de AIHubMix indica que Hydrogen admite entradas de texto, imagen, audio, video y PDF, y genera texto; la página empresarial de Google también menciona Office y OpenDocument, que no aparecen en la página de la pasarela. Las diferencias están en la capacidad máxima de salida, los valores predeterminados del pensamiento y la estructura de la superficie de la API.
| Elemento | Gemini 4 Hydrogen | Gemini 3.8 Flash |
|---|---|---|
| Ventana de contexto | 1,048,576 tokens | 1,048,576 tokens |
| Salida máxima | 1,048,576 tokens mediante decodificación prolongada | 65,536 tokens |
| Salida síncrona | 65,536 tokens por salto, con o sin streaming | 65,536 tokens |
| Niveles de pensamiento | low, medium, high (predeterminado), xhigh | low, medium (predeterminado), high |
| Modalidades de entrada | texto, imagen, audio, video, PDF, Office | texto, imagen, audio, video, PDF |
| Nivel gratuito | Sí | Sí |
| Almacenamiento en caché | solo implícito, mínimo de 4,096 tokens | implícito y explícito |
Hydrogen añade un cuarto nivel, xhigh, y cambia el valor predeterminado de medium a high. También permite un salto síncrono de 65,536 tokens tanto en modo streaming como sin streaming; Carbon y Argon permiten 65,536 solo con streaming y 32,768 en los demás casos. Para salidas largas, Hydrogen utiliza la misma ruta de tokens en segundo plano o de continuación que el resto de la familia Gemini 4, y puede llegar a 1,048,576 tokens menos la entrada.
El costo por turno se deriva del valor predeterminado. Hydrogen consume más tokens de pensamiento por turno que un modelo cuyo valor predeterminado es medium, y los tokens de salida incluyen los de pensamiento. Si se migra una carga de trabajo sin establecer un nivel, por lo general costará más por turno que con 3.8 Flash, incluso antes de tener en cuenta la diferencia de precio por token.
La mejora medida: 20 puntos más en el índice y menos costo por tarea
Artificial Analysis midió Hydrogen en el nivel high con una puntuación de 51 en Intelligence Index, puesto #21 de 78. Gemini 3.8 Flash en el nivel high obtuvo 31, puesto #54. El costo por tarea fue en la dirección opuesta: $1.87 frente a $7.77.
| Modelo / esfuerzo | Puesto en AA | Índice de AA | $/tarea | Min/tarea | Primer token de respuesta |
|---|---|---|---|---|---|
| Hydrogen high | 21 | 51 | 1.87 | 8.3 | 18.89 s |
| Hydrogen xhigh | 16 | 54 | 3.16 | 13.5 | 37.77 s |
| Gemini 3.8 Flash high | 54 | 31 | 7.77 | 14.7 | 17.53 s |
Estas cifras corresponden a las mediciones en tiempo real de Artificial Analysis, consultadas en 2026-11-13T02:40Z, en Intelligence Index v5.0.1 con 78 modelos clasificados. Se basan en los precios de lista estándar y no representan facturas de AIHubMix. Ambas filas corresponden al nivel de esfuerzo high, así que la comparación está igualada en ese nivel; hay que tener en cuenta que high es el valor predeterminado de Hydrogen, pero no el de Flash. Flash en su nivel predeterminado medium obtiene 30 y cuesta $6.26 por tarea, así que una comparación entre valores predeterminados modifica las cifras, pero no cambia la tendencia.
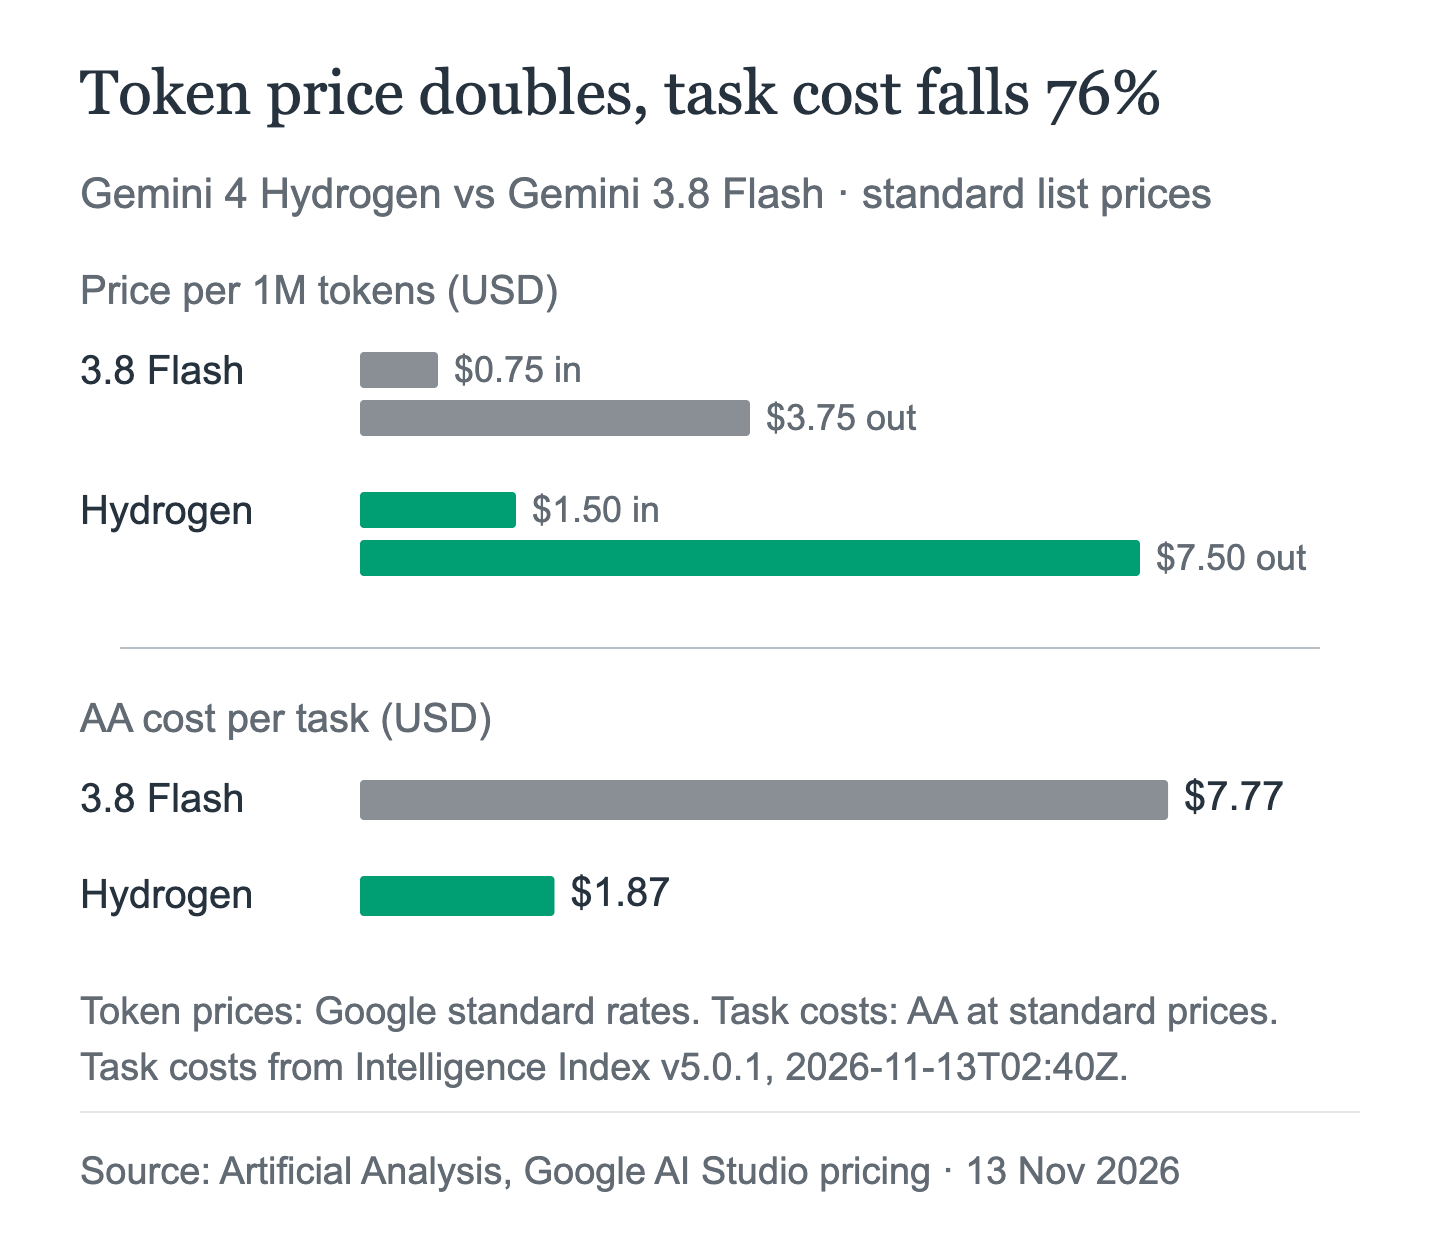
El resultado por tarea es lo importante. El precio por token de Hydrogen es el doble de la tarifa introductoria de Flash, pero su costo medido por tarea es un 75.9% más bajo. La diferencia se debe a cuántos tokens necesita cada modelo para completar el mismo trabajo, algo que el precio por token no refleja. El primer token de respuesta de Hydrogen llega a los 18.89 segundos, unos 1.4 segundos más tarde que los 17.53 de Flash, y completa la tarea en 8.3 minutos, frente a los 14.7 de Flash.
En xhigh, Hydrogen obtiene 54, cuesta $3.16 por tarea y tarda 13.5 minutos; el primer token llega a los 37.77 segundos. Eso lo sitúa cuatro puntos por encima de Gemini 4 Argon high (50) y seis por debajo de Carbon high (60) en la misma instantánea. En esta serie analizamos por separado los cuatro niveles; en resumen, high es la opción más rentable y xhigh es para tareas difíciles.
La tabla de benchmarks de Google y las tres filas en las que Hydrogen pierde
La ficha del modelo de Google es un documento del proveedor: los resultados son autodeclarados, se publicó el 2026-11-12 y se centra en dos rivales, no en el modelo Gemini anterior. Hydrogen lidera 7 de las 10 comparaciones indicadas. Las tres derrotas son lo más útil.
| Benchmark | Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|
| SWE-sweep | 13.5% | 3.1% | 5.8% |
| Terminal-Bench 4.1 | 57.0% | 63.9% | — |
| Agents' Last Exam v1.1 | 71.6% | 60.4% | 69.8% |
| AutomationBench-AA | 76.1% | 71.8% | 60.2% |
| Vending-Bench 2 | $14,549 | $11,165 | $9,107 |
| OSWorld-2.1 | 77.6% | 83.9% | 74.2% |
| MKA | 53.4% | 52.0% | 43.8% |
| Chartography | 66.6% | 61.6% | 63.2% |
| Terminal-Bench-Science 0.1 | 51.4% | 59.9% | 58.3% |
| HLE-Diamond | 58.8% | 53.3% | 47.3% |
La ficha del modelo marca Terminal-Bench 4.1 como «ajustado para tener en cuenta las trampas». Sonnet 5.5 gana en Terminal-Bench 4.1 (63.9 frente a 57.0), OSWorld-2.1 (83.9 frente a 77.6) y Terminal-Bench-Science 0.1 (59.9 frente a 51.4). En esas filas, un modelo más caro todavía ofrece algo a cambio. La lista de precios de Anthropic fija Sonnet 5.5 en $2 por entrada y $10 por salida; por lo tanto, Hydrogen es un 25% más barato por token y lidera en la mayoría de las comparaciones de la ficha, aunque pierde en las tres pruebas más relacionadas con agentes o ciencias.
No pongas las cifras de Carbon junto a esta tabla. La ficha del modelo de Carbon informa 65.2 en Terminal-Bench 4.0; la de Hydrogen informa 57.0 en Terminal-Bench 4.1. Son versiones distintas del benchmark y conjuntos de comparación diferentes: no son columnas comparables.
La publicación de lanzamiento de Google añade afirmaciones que la ficha del modelo no repite: Hydrogen completa tareas «2.5 veces más rápido, con su configuración predeterminada high» que Gemini 3.8 Flash y reduce las afirmaciones inventadas «más de 5 veces». También afirma que ocupa el puesto #5 en Agent Arena, que queda primero en Vals Tax Agent Bench (52.3%) y que empata en el primer puesto en Vals Legal Research Bench (55.8%). Son resultados declarados por el proveedor y no se han reproducido de forma independiente aquí.
Precio: el doble por token, menor costo por tarea
El precio estándar de Hydrogen es $1.50 por entrada, $7.50 por salida y $0.075 por entrada en caché. Batch y Flex cuestan la mitad, mientras que Priority cuesta $2.70 y $13.50. El precio es fijo en toda la ventana de contexto.
| Modelo / nivel | Entrada | Entrada en caché | Salida | Vigencia |
|---|---|---|---|---|
| Hydrogen Standard | $1.50 | $0.075 | $7.50 | Actual |
| Hydrogen Batch / Flex | $0.75 | $0.0375 | $3.75 | Actual |
| Hydrogen Priority | $2.70 | $0.135 | $13.50 | Actual |
| Gemini 3.8 Flash Standard | $0.75 | $0.075 | $3.75 | Hasta 2026-12-31 |
| Gemini 3.8 Flash Standard | $1.50 | $0.15 | $7.50 | A partir de 2027-01-01 |
| Gemini 4 Carbon / Argon | $2.00 | $0.10 | $10.00 | Hasta 2026-11-30 |
| Gemini 4 Carbon / Argon | $4.00 | $0.20 | $20.00 | A partir de 2026-12-01 |
Precios oficiales en USD por millón de tokens, tomados de la página de precios de Google, consultada el 2026-11-13. No se ha anunciado ningún cambio futuro para Hydrogen.
De la tabla se desprenden dos comparaciones. Las tarifas de entrada y salida de Hydrogen son exactamente iguales a las tarifas estándar de Gemini 3.8 Flash a partir del 2027-01-01, así que la diferencia de «el doble de caro» desaparece el día de Año Nuevo. Frente a Carbon y Argon, Hydrogen es un 25% más barato por token hasta el 30 de noviembre y un 62.5% más barato cuando sus precios se dupliquen el 1 de diciembre.
AIHubMix ofrece Hydrogen a $1.50, $7.50 y $0.075, en línea con el precio estándar de Google. El nivel gratuito corresponde a Google, no a la pasarela: AIHubMix es una opción de pago.
Cuándo Hydrogen no es una mejora
La superficie de protocolos es más limitada. Carbon y Argon tienen entradas de esquema que indican Chat Completions, Responses, Anthropic Messages y Gemini nativo. Hydrogen no tiene una entrada de esquema en la instantánea del índice de modelos del 2026-11-11, y solo está documentado POST /v1/chat/completions. Quienes usen clientes Responses al estilo de Codex o clientes Anthropic al estilo de Claude Code no deberían asumir que Hydrogen funcionará sin comprobarlo.
Es una versión GA a corto plazo. La política de aviso de retirada con 45 días de antelación es una limitación para la planificación, no una razón para evitar el modelo. Sí es una razón para mantener el ID del modelo en la configuración y no en el código.
Faltan algunas funciones de la plataforma. La página empresarial de Google indica que Gemini Live API, RAG Engine, Tuning y la cuota fija no son compatibles con Hydrogen; la inferencia Batch sí es compatible.
El perfil de seguridad es mixto. La ficha del modelo informa mejores resultados de seguridad de texto que Gemini 3.8 Flash (+0.80pp de texto a texto, +1.10pp en varios idiomas), pero también 5.57 puntos porcentuales más de rechazos injustificados, en particular ante prompts multimodales, y un tono 0.65 puntos peor. Se trata de evaluaciones automatizadas, no de pruebas de red team.
Carbon sigue marcando el techo de calidad. Hydrogen high obtiene 51 frente a los 60 de Carbon high, y los 54 de Hydrogen xhigh siguen estando seis puntos por debajo. Para depuración compleja, arquitectura, trabajo científico y análisis de seguridad, el razonamiento adicional de Carbon es lo que ofrece el producto.
Los niveles inferiores no conservan la misma calidad gratis. Hydrogen medium obtiene 41 y low, 27 en AA. Una migración que mantenga en espíritu el valor predeterminado anterior bajando a medium perderá mucha más calidad de la que ahorra en el precio de los tokens.
Cómo llamarlo a través de AIHubMix
La ruta documentada es el endpoint de chat completions compatible con OpenAI. La página del modelo indica dos proveedores, VertexAI y Google AI Studio, con reintento automático.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "Summarise this incident report and list the follow-ups."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
El endpoint es POST /v1/chat/completions. AIHubMix indica que Hydrogen admite entradas de texto, imagen, audio, video y PDF, y genera texto; no publica indicadores de capacidad para razonamiento, uso de herramientas ni salida estructurada, y su guía de Gemini abarca controles de pensamiento de la era Gemini 2.5, no los niveles de Gemini 4. No des por hecho que el parámetro thinking_level de Google, ni el nuevo valor xhigh, se transmite a través de la pasarela. Mantén max_tokens dentro del límite síncrono de 65,536, salvo que se confirme la generación prolongada para tu ruta. No se hizo ninguna prueba en vivo para esta publicación, así que el ejemplo muestra la estructura de la solicitud, no una respuesta verificada.
Quién debería cambiar ahora
Cambia ahora si usas Gemini 3.8 Flash y pagas por token: Artificial Analysis mide un costo por tarea completada un 76% menor con un índice 20 puntos más alto, y el nivel gratuito te permite comprobar la calidad sin costo con tus propios prompts. Cambia si tu carga de trabajo es de gran volumen y puede ejecutarse con Chat Completions y salida de texto, o si quieres un modelo de ejecución más barato junto a Carbon en un flujo de varios modelos.
Espera si tu cliente depende del protocolo Responses o Anthropic Messages; si tu tarea está en el extremo más complejo de la depuración, la arquitectura o la seguridad, donde el techo de Carbon sigue siendo importante; o si un aviso de retirada con 45 días de antelación no encaja con tu ciclo de lanzamientos.
Haz una prueba primero si estás indeciso. Ejecuta entre 20 y 50 solicitudes reales con Hydrogen high y Gemini 3.8 Flash en su valor predeterminado, y compara el costo por tarea completada, no el costo por token. La página comparativa de AIHubMix es útil para evaluar Carbon en esa decisión.
Preguntas frecuentes
¿Hydrogen es más barato que Gemini 3.8 Flash?
Por token, no: $1.50/$7.50 frente a los $0.75/$3.75 del precio introductorio. Por tarea completada, Artificial Analysis mide $1.87 frente a $7.77, alrededor de un 76% menos. La cifra por tarea depende del uso de tokens, no solo de la tarifa.
¿Hydrogen es Gemini 3.8 Flash con otro nombre?
No. La ficha del modelo de Google dice que Hydrogen está adaptado de Gemini 4 Carbon, y Google lo recomienda como actualización desde 3.8 Flash. Tiene una ruta de contexto distinta, un cuarto nivel de pensamiento y un valor predeterminado diferente.
¿Hydrogen admite imágenes?
Sí. La plataforma de Google admite texto, imágenes, audio, video, PDF y archivos de Office. La página del modelo de AIHubMix indica que acepta texto, imágenes, audio, video y PDF, y genera texto; allí no se mencionan archivos de Office ni OpenDocument.
¿Está disponible el nivel gratuito en AIHubMix?
No. El nivel gratuito es de Google, en AI Studio y la API de Gemini. AIHubMix es una ruta de pago a $1.50/$7.50.
¿Cuál es el nivel de pensamiento predeterminado?
high. El valor predeterminado de Gemini 3.8 Flash era medium; Hydrogen añade xhigh por encima de high.
¿Hydrogen es mejor que Carbon?
No. Carbon high obtiene 60 en el índice de AA, frente a los 51 de Hydrogen high y los 54 de xhigh, y cuesta más por tarea. Hydrogen es el modelo de ejecución más barato, no el modelo de frontera.
¿Puedo configurar el nivel de pensamiento a través de AIHubMix?
La documentación no lo indica. AIHubMix no publica ningún indicador de capacidad de razonamiento para Hydrogen, y su guía de Gemini no abarca los niveles de Gemini 4. Verifícalo antes de depender de esta función.
Sigue leyendo: la serie Gemini 4 Hydrogen
- Si quieres saber qué nivel de pensamiento usar, la siguiente publicación mide los cuatro niveles con el mismo índice y muestra en qué punto la progresión deja de compensar: Niveles de pensamiento de Gemini 4 Hydrogen: low, medium, high, xhigh.
- Si quieres saber si usar Hydrogen junto a Carbon o Argon, la tercera publicación compara los tres modelos en cuanto a precios, latencia y cargas de trabajo: Gemini 4 Carbon vs Hydrogen vs Argon: ¿qué modelo conviene para cada tarea?.
Fuentes
- Google, Presentamos Gemini 4 Hydrogen
- Google AI Studio, Gemini 4 Hydrogen: novedades
- Google DeepMind, Ficha del modelo Gemini 4 Hydrogen
- AIHubMix, Gemini 4 Hydrogen
- Artificial Analysis, Gemini 4 Hydrogen — instantánea en vivo 2026-11-13T02:40Z, Intelligence Index v5.0.1


