Gemini 4 Carbon no es una nueva familia de modelos. Es Gemini 4 Argon con más razonamiento por turno, al mismo precio por token: $2 por millón de tokens de entrada y $10 por millón de tokens de salida con las tarifas promocionales hasta el 30 de noviembre de 2026; luego, $4 y $20 a partir del 1 de diciembre. La pregunta no es cuál de los modelos cuesta menos por token. Cuestan exactamente lo mismo. La pregunta es si el razonamiento adicional compensa lo suficiente por tarea completada como para justificar una primera respuesta más lenta.
Las cifras en tiempo real de Artificial Analysis dan una respuesta clara para un tipo de trabajo y una advertencia igualmente clara para otro. Carbon High ocupa el puesto n.º 4 de 104 en el AA Intelligence Index, con 60.03, frente a 50.41 de Argon High. Cuesta $7.76 por tarea, frente a $9.95, y termina en 25.6 minutos, frente a 29.0. Pero su tiempo hasta el primer token de respuesta es de 67.1 segundos, frente a 40.1 en Argon. Carbon es el mejor modelo para una cola de tareas. Argon es el mejor para una conversación.
Esa diferencia es el tema central de este artículo. A continuación: qué cambió, qué dicen las mediciones, qué aporta la ficha del modelo de Google, cómo cambia el precio el 1 de diciembre y qué cargas de trabajo deberían seguir usando Argon.
Qué cambió respecto a Argon
La ficha del modelo de Google explica claramente la relación: «Gemini 4 Carbon se basa en Gemini 4 Argon». El ID del modelo es gemini-4-carbon, también en AIHubMix. Google documenta una ventana de contexto de 1,048,576 tokens. Los niveles de razonamiento son bajo, medio y alto; el valor predeterminado es medio. La salida estándar es de 65,536 tokens; la ruta nativa de decodificación larga de Google puede alcanzar hasta 1,048,576 tokens menos la entrada, con 131,072 y 262,144 como ejemplos. Actualmente, AIHubMix solo documenta Chat Completions, así que mantén las solicitudes al gateway en 65,536 tokens o menos hasta que se documente una ruta de mayor capacidad. La fecha de corte de conocimiento es marzo de 2026. Google no ofrece el modelo en el nivel gratuito.
El cambio se describe en las notas de AI Studio de Google: «Carbon dedica más tokens de razonamiento por turno a explorar a fondo y verificar su trabajo, lo que aumenta el uso de tokens y la latencia por turno en comparación con Argon». Esa frase explica casi todas las diferencias que veremos más adelante. Más razonamiento eleva el potencial en tareas difíciles, aumenta el coste por turno y prolonga la espera hasta el primer token.
La migración es deliberadamente sencilla. «Actualizar desde Argon no requiere cambios en el esquema de las solicitudes». Basta con cambiar el nombre del modelo en la API. El consejo operativo de Google es «mantener thinking_level en medio (valor predeterminado), a menos que una carga de trabajo necesite el nivel alto, y asegurarse de que max_output_tokens y los tiempos de espera de HTTP permitan sesiones de razonamiento más largas».
El equilibrio medido: más razonamiento, menor coste por tarea
Las cifras que aparecen a continuación son mediciones en tiempo real de Artificial Analysis, consultadas el 2026-11-11T05:23Z (las páginas de los modelos se volvieron a comprobar a las 06:01Z y no habían cambiado), con los precios estándar de $4 por millón de tokens de entrada y $20 por millón de tokens de salida.
La comparación útil es la calidad frente al coste de una tarea completada: ¿Carbon obtiene un índice más alto con una factura menor? El gráfico mantiene separadas las cuatro configuraciones de modelo.
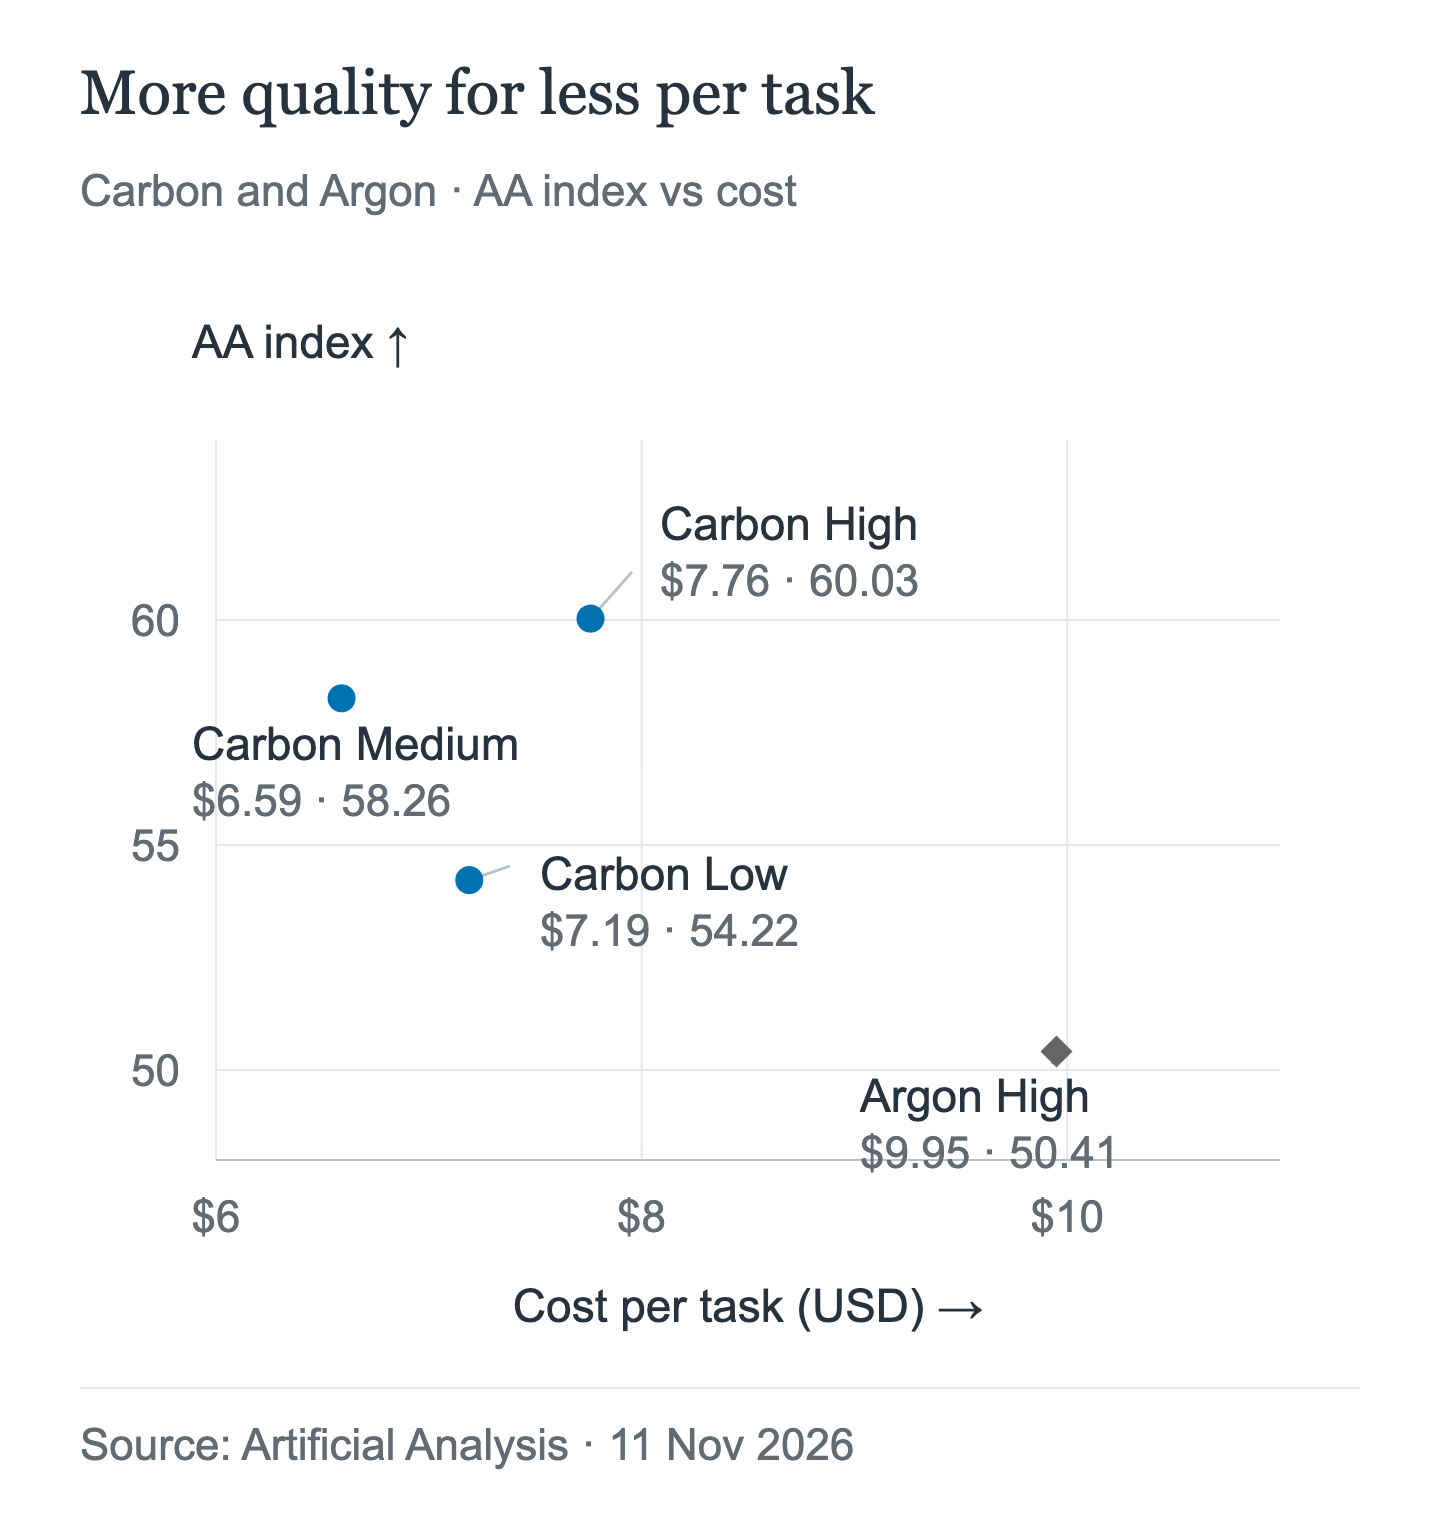
Carbon High queda por encima y a la izquierda de Argon High. Medium es la configuración de Carbon más barata en esta prueba; Low es una opción para reducir la latencia, no el coste. Estos son los costes por tarea de AA con los precios estándar, no las facturas por solicitud de AIHubMix.
| Modelo | Índice AA | $/tarea | Min/tarea | Primer token | Tokens de salida/s |
|---|---|---|---|---|---|
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s | 80.1 |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s | 73.7 |
| Carbon Low | 54.22 | 7.19 | 22.6 | 12.9 s | 63.5 |
| Argon High | 50.41 | 9.95 | 29.0 | 40.1 s | 66.8 |
Carbon High, Medium y Low ocupan los puestos n.º 4, n.º 6 y n.º 14 de 104, respectivamente; Argon High queda por debajo. Las tres configuraciones por encima de Carbon High son de Claude Fable 5.2. «Primer token» indica el tiempo hasta el primer token de respuesta. Carbon High frente a Argon High: +9.62 puntos de índice, un 22.0% menos por tarea, 25.6 frente a 29.0 minutos, pero 67.1 frente a 40.1 segundos hasta el primer token de respuesta.
La diferencia en el índice es lo bastante grande como para cambiar una posición en la clasificación. La diferencia de latencia es lo bastante grande como para cambiar si una persona tiene que esperar. Ambas afirmaciones salen de la misma fila.
Artificial Analysis describe Carbon como «notablemente lento por tarea y muy prolijo» e informa que generó 205 millones de tokens para calcular el índice, frente a 113 millones de Argon y una mediana de 72.8 millones en los modelos medidos. En esta prueba de AA, el coste por tarea es menor pese a un volumen de salida mucho mayor: el mismo precio de lista, muchos más tokens y un coste total menor por tarea.
Hay una anomalía que merece una mención aparte. Carbon Low cuesta $7.19 por tarea, más que Medium, que cuesta $6.59, pese a usar menos razonamiento. Sea cual sea la causa, Low funciona como una opción para reducir la latencia, no como una opción para ahorrar; por eso, mide el coste por tarea antes de dirigirle un volumen alto.
La perspectiva de los agentes de programación
El Intelligence Index promedia muchas tareas. El Coding Agent Index v2 se acerca más a lo que ejecuta un cliente de API: un agente de programación con herramientas, medido de principio a fin con el mismo entorno de pruebas. Carbon High ocupa el puesto n.º 4; Argon High, el n.º 11.
| Puesto | Agente + modelo | Índice | $/tarea | Min/tarea | Acierto de caché |
|---|---|---|---|---|---|
| 4 | Antigravity CLI + Carbon High | 59.4 | 7.74 | 29.8 | 0.95 |
| 11 | Antigravity CLI + Argon High | 53.2 | 11.73 | 34.7 | 0.87 |
Mismo agente, mismo entorno de pruebas y distinto modelo: así, la comparación aísla el modelo y no el andamiaje. Carbon cuesta un 34.0% menos por tarea, suma +6.2 puntos de índice, tarda 4.9 minutos menos y produce casi la misma cantidad de tokens por tarea: 109,031 frente a 109,236. Su tasa de acierto de caché es mayor, 0.95 frente a 0.87, y consume menos tokens de entrada: 12.44 millones frente a 13.76 millones.
Dos advertencias. Carbon ocupa el puesto n.º 4 en este índice: Claude Code con Opus 5.5 Max lidera con 61.7, seguido de Devin Fusion CLI y GitHub Copilot Fusion. Además, Fable 5.2 no aparece en el índice, así que esta tabla no permite zanjar la comparación entre Carbon y Fable.
Qué aporta la ficha del modelo de Google y qué no
La ficha del modelo de Google es un documento del proveedor: presenta resultados de octubre de 2026, autodeclarados y correspondientes a una instantánea distinta de los datos en tiempo real anteriores. En las filas siguientes, la cifra de Carbon de Google es mayor en todos los casos.
| Benchmark | Carbon | Argon |
|---|---|---|
| AA Index v5.0 (proveedor) | 59 | 50 |
| Terminal-Bench 4.0 | 65.2 | 57.1 |
| FrontierSWE 2 | 61.2 | 55.0 |
| OSWorld-2.1 | 81.5 | 74.7 |
| Agents' Last Exam | 77.4 | 69.0 |
La cifra de AA es el 59 redondeado de Google, no el 60.03 en tiempo real de la tabla anterior; ambas cifras proceden de instantáneas distintas y no deben mezclarse. La comparación externa de la ficha es con Fable 5.1, no con Fable 5.2.
Lo útil es la consistencia: la mejora no se limita a un benchmark. También queda clara la limitación. La ficha del proveedor no calcula el precio de una tarea, no mide la latencia hasta el primer token ni te dice cuántos turnos necesitará tu agente. Sirve para afirmar que «Carbon es el modelo más potente en promedio». No permite afirmar que «Carbon sea el mejor modelo para tu ciclo de trabajo».
Precio: la misma tabla de tarifas, con el mismo cambio el 1 de diciembre
Las tarifas de Carbon y Argon coinciden en todos los conceptos. Ambos tienen tarifas promocionales hasta el 30 de noviembre de 2026, y ambos duplican sus precios el 1 de diciembre.
| Modelo | Entrada | Salida | Lectura en caché |
|---|---|---|---|
| Carbon, promoción (hasta el 30 de nov.) | $2.00 | $10.00 | $0.10 |
| Carbon, desde el 1 de dic. | $4.00 | $20.00 | $0.20 |
| Argon, promoción (hasta el 30 de nov.) | $2.00 | $10.00 | $0.10 |
| Argon, desde el 1 de dic. | $4.00 | $20.00 | $0.20 |
| Gemini 3.1 Pro Preview (≤200k) | $2.00 | $12.00 | $0.20 |
| Fable 5.2 | $8.00 | $40.00 | $0.20 |
Precios oficiales en USD por millón de tokens, al 11 de noviembre de 2026. Gemini 3.1 Pro Preview cuesta $4/$18/$0.40 cuando se superan los 200k tokens de prompt, más $4.50 por millón de tokens por hora de almacenamiento. Las escrituras en caché de Fable 5.2 cuestan $10 por cinco minutos o $16 por una hora; el procesamiento por lotes tiene un descuento del 50%. Las tarifas promocionales de Carbon y Argon terminan el 30 de noviembre; todas sus tarifas se duplican el 1 de diciembre.
AIHubMix ofrece Carbon a $2/$10/$0.10, en línea con las tarifas promocionales de Google. Este artículo no presupone cuánto cobrará el gateway después del 30 de noviembre; consulta la página del modelo para ver la tarifa vigente.
Al recalcular las cantidades de tokens medidas por Artificial Analysis con las tarifas promocionales, se obtienen estimaciones aproximadas por tarea de $3.88 para Carbon High, $3.30 para Medium, $3.60 para Low y $4.98 para Argon High. Son estimaciones calculadas, no mediciones de AA: el cálculo mantiene constante la combinación de tokens de cada tarea, pero tus prompts y tu tasa de acierto de caché cambiarán el resultado.
Por token, Fable 5.2 cuesta el doble que Carbon con las tarifas estándar y cuatro veces más con las promocionales. Esa es una diferencia de precio, no un veredicto sobre la calidad; la tercera publicación de la serie cubre esa comparación.
Cuándo Carbon no es la mejor opción
El argumento contra Carbon no es que sea peor. Es que aquello que ofrece —más razonamiento por turno— es justo lo que un producto interactivo no puede permitirse.
El primer token tarda en llegar. Carbon High espera 67.1 segundos antes del primer token de respuesta; Argon High, 40.1. Medium reduce la espera a 23.2 segundos y Low, a 12.9, pero ambos ceden puntos en el índice. Una interfaz de chat que se queda en pausa durante un minuto ya ha perdido el turno, independientemente de cómo sea la respuesta cuando llega.
Google recomienda mantener Argon para obtener velocidad. Argon está pensado para «respuestas más rápidas y menos tokens por turno» en «programación interactiva, trabajo diario con funcionalidades y ciclos de producción rápidos». Las notas de migración son tajantes: «Mantén Argon donde la velocidad sea importante». La publicación del anuncio de Google insiste en el mismo punto: «Argon sigue siendo la opción ideal para la mayoría de las tareas de ingeniería de software y trabajo de conocimiento».
El gasto por turno es mayor aunque el coste por tarea sea menor. El precio por token es el mismo, pero Carbon usa más tokens de razonamiento por turno. Para un equipo que controla el gasto de tokens por turno o raciona una cuota de tokens, Carbon es el modelo más caro. La ejecución del índice, con 205 millones de tokens frente a los 113 millones de Argon, es el ejemplo extremo de ese efecto.
Low no es la opción barata. A $7.19 por tarea, Carbon Low cuesta más que Medium, a $6.59. Si la regla para asignar tareas es el coste por tarea completada, Low no la cumple.
Ganar en benchmarks no recupera el tiempo perdido. OSWorld-2.1 y FrontierSWE 2 favorecen a Carbon en la tabla de Google, pero esos resultados los declara el proveedor y ninguno cambia la espera hasta el primer token. Los benchmarks miden el resultado final; los usuarios experimentan el comienzo.
Quién debería cambiar ahora y quién debería seguir con Argon
Pásate a Carbon ahora si ejecutas trabajos por lotes nativos del proveedor o tareas de agentes en segundo plano (esas opciones no están documentadas para Carbon en AIHubMix), si un fallo de calidad cuesta más que el tiempo de ejecución, si tus solicitudes pueden tolerar tiempos de espera más largos y un presupuesto de salida mayor, o si ya estás pagando reintentos que Carbon podría evitar.
Quédate con Argon si desarrollas chats, autocompletado o cualquier flujo en el que haya una persona esperando; si tu presupuesto o cuota se mide por turno; o si el producto exige una latencia inferior a unos 30 segundos.
Haz pruebas primero si estás en un punto intermedio. Envía las mismas 20 a 50 solicitudes reales a ambos modelos, registra el tiempo hasta el primer token y el costo por tarea completada, y elige según esos datos en lugar de basarte en el índice. La página de comparación de AIHubMix muestra lado a lado las páginas de ambos modelos.
Cómo llamarlo a través de AIHubMix
Carbon usa el mismo patrón de ID de modelo en AIHubMix y el endpoint documentado de chat completions.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Summarise this incident report and list the follow-ups."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
El endpoint es POST /v1/chat/completions; es la única ruta que AIHubMix documenta para este modelo. El texto es la modalidad de entrada indicada. AIHubMix no documenta para Carbon la entrada de imágenes y PDF, la API de Responses, Anthropic Messages ni el endpoint nativo de Gemini, así que considéralas opciones no confirmadas. Lo mismo se aplica a la asignación de reasoning_effort: no des por hecho que la pasarela transmite un parámetro de nivel de pensamiento. Mantén max_tokens dentro del límite estándar de salida de 65,536; los límites superiores requieren el modo en segundo plano de Google y no están confirmados en AIHubMix. No se realizó ninguna prueba en vivo para esta publicación, así que el ejemplo muestra la estructura de la solicitud, no una respuesta verificada.
Preguntas frecuentes
¿Carbon cuesta lo mismo que Argon?
Sí. Las tarifas oficiales de Google son idénticas: $2 por millón de tokens de entrada y $10 por millón de tokens de salida hasta el 30 de noviembre de 2026; después, $4 y $20. Las lecturas en caché cuestan $0.10 y luego $0.20.
¿Carbon es mejor que Argon?
En calidad y costo por tarea completada, sí, según las mediciones de Artificial Analysis: 60.03 frente a 50.41 en el Intelligence Index y $7.76 frente a $9.95 por tarea. En capacidad de respuesta, no: tarda 67.1 segundos en generar el primer token de respuesta, frente a 40.1.
¿Por qué Carbon es más lento si termina las tareas más rápido?
Espera más antes de responder, pero luego completa toda la tarea antes: 25.6 minutos frente a 29.0. La espera hasta el primer token y el tiempo total de la tarea son mediciones distintas y apuntan en direcciones opuestas.
¿Hay que cambiar las solicitudes?
No. Google indica que actualizar desde Argon no requiere cambios en el esquema; la cadena del modelo pasa a ser gemini-4-carbon. Aumenta el límite de salida y el tiempo de espera HTTP para dar cabida a un modo de pensamiento más prolongado.
¿Por qué Carbon Low cuesta más por tarea que Medium?
Artificial Analysis midió un costo de $7.19 para Low frente a $6.59 para Medium. Considera Low una configuración de latencia, no de descuento, y mide el costo por tarea antes de enviarle un gran volumen.
¿Qué puesto ocupa Carbon en Artificial Analysis?
Ocupa el puesto #4 en el Intelligence Index, detrás de tres configuraciones de Claude Fable 5.2. La ficha del modelo de Google muestra un 59 redondeado para el mismo índice; la cifra actual es 60.03 y no deben confundirse.
¿Carbon está disponible en el nivel gratuito?
No. Google no ofrece Gemini 4 Carbon en el nivel gratuito, así que se accede mediante las tarifas de API de pago o una pasarela como AIHubMix.
Sigue leyendo: la serie Gemini 4 Carbon
- Si esta publicación te convenció de probar Carbon, pero falló tu primera solicitud, la guía de migración explica los errores 400, la configuración de tiempos de espera y los límites de salida que cambian con los ciclos de pensamiento más prolongados: Migración a la API de Gemini 4 Carbon: errores 400, tiempos de espera y límites de salida.
- Si la pregunta pendiente es si Carbon es suficientemente capaz para la programación con agentes o si la opción prémium Fable 5.2 ofrece alguna ventaja, la tercera publicación compara las mismas cifras medidas con Fable 5.2: Gemini 4 Carbon frente a Fable 5.2: ¿cuál elegir para la programación con agentes?.
Fuentes
- Google AI Studio, Gemini 4 Carbon: novedades
- Google DeepMind, ficha del modelo Gemini 4 Carbon
- Google AI Studio, precios de la API de Gemini
- Artificial Analysis, Gemini 4 Carbon
- AIHubMix, Gemini 4 Carbon