

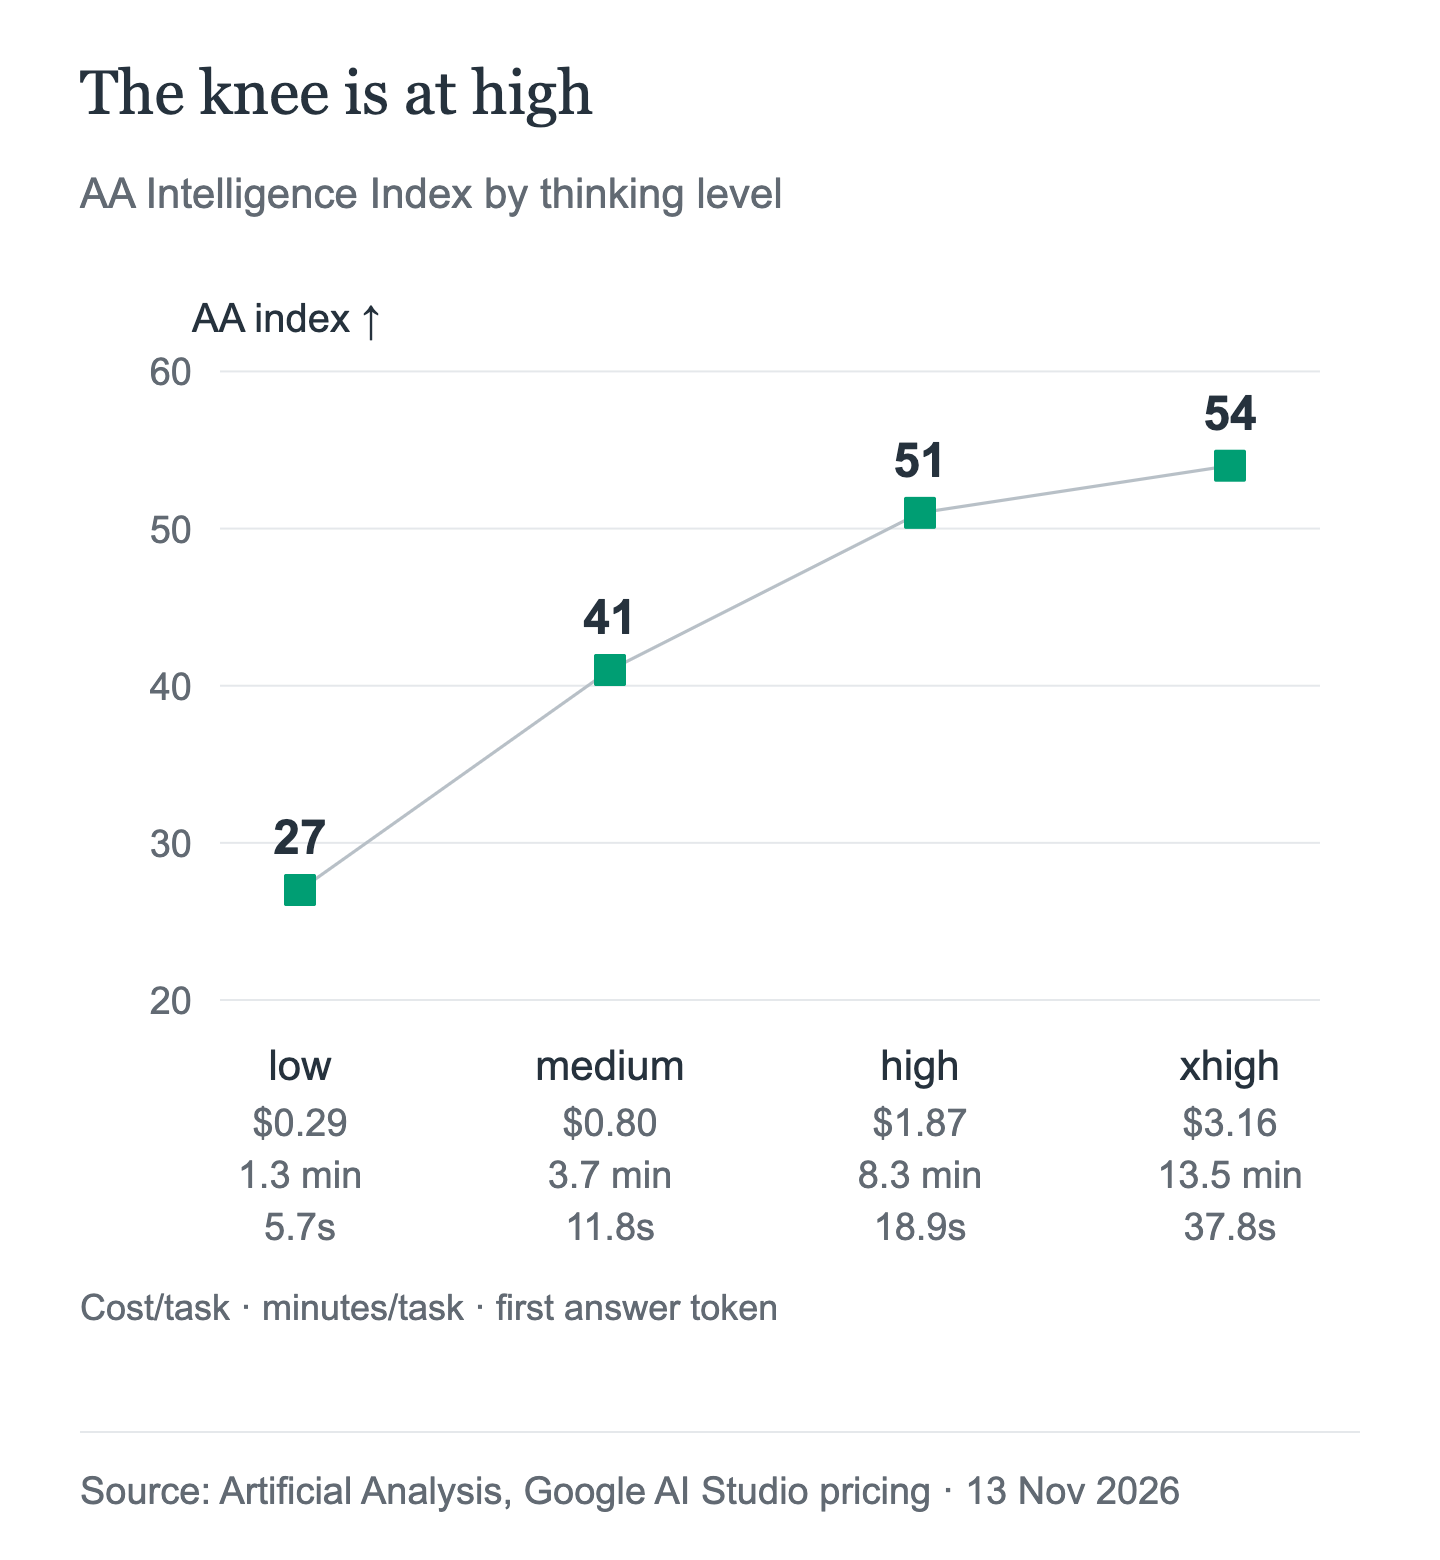
Gemini 4 Hydrogen tiene cuatro niveles de pensamiento que se comportan como cuatro modelos distintos. Según las mediciones en tiempo real de Artificial Analysis, el mismo modelo obtiene 27 con low, 41 con medium, 51 con high y 54 con xhigh. El nivel predeterminado es high, y xhigh es nuevo en la familia Gemini 4: Carbon y Argon llegan solo hasta high.
La diferencia es amplia: el mismo modelo abarca 27 puntos del índice entre low y xhigh. Pasar de medium a high suma 10 puntos del índice por unos $1.07 más por tarea. Pasar de high a xhigh suma 3 puntos por $1.29 y casi duplica la espera hasta el primer token de respuesta. En la práctica, conviene empezar con high, reservar xhigh para tareas difíciles de varios pasos y tratar low y medium como ajustes de latencia que requieren su propia evaluación de calidad.
A continuación: para qué sirve cada nivel, cuánto cuesta, qué cambia en la API y qué documenta AIHubMix y qué no.
Los cuatro niveles y qué ha cambiado
Gemini 4 Hydrogen admite low, medium, high y xhigh. Las notas de la versión de Google lo dicen claramente: «El nivel predeterminado del modelo es high y se incorpora xhigh». Son dos cambios respecto a Gemini 3.8 Flash, cuyo nivel predeterminado es medium y que llega solo hasta high.
El resto de la familia no ha cambiado. Carbon y Argon admiten low, medium y high, con medium como nivel predeterminado. Hydrogen es el único modelo Gemini 4 con un ajuste superior a high.
| Modelo | Niveles | Predeterminado |
|---|---|---|
| Gemini 4 Hydrogen | low, medium, high, xhigh | high |
| Gemini 4 Carbon | low, medium, high | medium |
| Gemini 4 Argon | low, medium, high | medium |
MINIMAL no forma parte de las opciones. La documentación de pensamiento de Gemini 4 indica que MINIMAL «no es compatible con los modelos Gemini 4», y las notas de la versión de Hydrogen de Google dicen que el modelo «rechaza minimal con un error». No hay ningún interruptor documentado para desactivar el pensamiento en este modelo.
Qué recomienda Google
Las recomendaciones de Google son un punto de partida razonable, pero se redactaron antes de las mediciones que aparecen a continuación. En particular, la recomendación de usar medium para programación interactiva presupone un nivel de calidad que Artificial Analysis no observa con medium.
| Nivel | Descripción y uso recomendado por Google |
|---|---|
| low | «Menos tokens y menor latencia»: chat rápido, gran volumen |
| medium | «Menos tokens, respuestas más rápidas»: programación interactiva, prototipos de interfaz |
| high | «Equilibrio entre inteligencia y velocidad»: predeterminado para la mayoría de las tareas |
| xhigh | «Más tokens, razonamiento más profundo»: programación difícil de varios pasos |
La tabla viene acompañada de dos advertencias. «Usar xhigh aumenta la latencia y el uso de tokens, y puede provocar que el modelo piense demasiado en prompts más sencillos», advierte Google. Además, las recomendaciones de evaluación son explícitas: «Realiza las evaluaciones en los cuatro niveles con un max_output_tokens alto».
La escala medida
Artificial Analysis midió los cuatro niveles. La prueba es Intelligence Index v5.0.1, con 78 modelos clasificados, consultada en 2026-11-13T02:40Z, a los precios de lista estándar. Estos son los costes por tarea de AA, no las facturas de AIHubMix.
| Nivel | Puesto en AA | Índice de AA | $/tarea | Min/tarea | Primer token de respuesta |
|---|---|---|---|---|---|
| low | 60 | 27 | 0.29 | 1.3 | 5.71 s |
| medium | 39 | 41 | 0.80 | 3.7 | 11.80 s |
| high | 21 | 51 | 1.87 | 8.3 | 18.89 s |
| xhigh | 16 | 54 | 3.16 | 13.5 | 37.77 s |
Lo más útil son las diferencias entre niveles:
lowamedium: +14 puntos del índice, +$0.51 por tarea, +2.4 minutos y +6.1 segundos hasta el primer token.mediumahigh: +10 puntos del índice, +$1.07 por tarea, +4.6 minutos y +7.1 segundos hasta el primer token.highaxhigh: +3 puntos del índice, +$1.29 por tarea, +5.2 minutos y +18.9 segundos hasta el primer token.
high es el punto de inflexión. Es el último paso en que la mejora de calidad es grande en relación con el coste adicional; xhigh es el paso en que la espera hasta el primer token casi se duplica a cambio de una pequeña mejora en el índice. Eso no convierte a xhigh en un mal ajuste. Lo convierte en una opción para las tareas en las que high no da la talla, justo como lo describe Google.
Como referencia, en la misma instantánea Carbon high obtiene 60 por $5.48 por tarea y 28.1 minutos; Carbon medium, 58 por $4.68; Carbon low, 54 por $5.22; y Argon high, 50 por $4.97 y 30.6 minutos. Hydrogen xhigh iguala los 54 de Carbon low con un coste por tarea un 39.5% menor ($3.16 frente a $5.22), aunque su primer token tarda 37.77 segundos, frente a 13.61. Hydrogen high supera a Argon high por un punto del índice con un coste por tarea un 62.4% menor.
Dónde falla la escala
low no es una pequeña rebaja. Con 27, queda 24 puntos del índice por debajo de high. Si una carga de trabajo pasa de high a low para ahorrar $1.58 por tarea, no está comprando el mismo producto con menos pensamiento: está comprando un modelo mucho más débil. Puede ser aceptable para clasificación, enrutamiento o extracción breve. No lo es para programación ni para tareas agénticas sin una evaluación específica de la tarea.
medium es un ajuste de latencia, no de calidad. Obtiene 41, 10 puntos menos que high, por $0.80 frente a $1.87. El ahorro es real —un 57% por tarea—, pero la brecha de calidad es mayor de lo que sugiere la diferencia de precio. Google recomienda medium para programación interactiva; los resultados de AA indican que conviene probar esa recomendación con tus propias tareas antes de adoptarla.
xhigh puede pensar demasiado. Google lo advierte directamente. Las cifras de coste y duración de AA muestran el efecto: $3.16 por tarea, 13.5 minutos y una espera de 37.77 segundos hasta el primer token. Para un prompt sencillo, es mucha latencia a cambio de una pequeña mejora. Para una tarea difícil de programación de varios pasos en la que high falla, es el único nivel que va más allá.
La verbosidad también forma parte de la factura. Artificial Analysis describe Hydrogen como «muy verboso»: la ejecución de xhigh generó 304 millones de tokens de salida para completar el índice, con el puesto #76 de 77, frente a una mediana de 72.8 millones. Los tokens de salida incluyen el pensamiento, y la salida se factura a $7.50 por millón. Un nivel más alto no solo piensa durante más tiempo: también genera más tokens facturables.
El coste: cómo el pensamiento se convierte en tokens
La tarifa es sencilla. Hydrogen cuesta $1.50 por millón de tokens de entrada, $7.50 por millón de tokens de salida y $0.075 por millón de tokens de entrada almacenados en caché. La salida incluye los tokens de pensamiento. Por eso, el nivel importa más que la tarifa: se cobra al modelo por el razonamiento que genera, no por el nombre del nivel.
Hay tres reglas de facturación fáciles de pasar por alto.
El nivel predeterminado cambió. Gemini 3.8 Flash usaba medium de forma predeterminada; Hydrogen usa high. Una carga de trabajo que nunca especificó un nivel consumirá más tokens de salida por turno después de la migración, aunque el precio por token sea el mismo. Es un cambio de presupuesto disfrazado de cambio de modelo.
El almacenamiento en caché solo es implícito. Hydrogen admite el almacenamiento en caché implícito, con un mínimo de 4,096 tokens y un descuento del 95% cuando hay un acierto de caché; el almacenamiento en caché explícito no es compatible. La página empresarial de Google también indica que «las escrituras en caché se facturan de forma predeterminada a 1.25x el precio estándar de los tokens de entrada». Esa es la descripción de facturación de Google; AIHubMix no documenta cómo se factura la caché para este modelo.
La salida larga tiene un límite por tramo. Una solicitud síncrona genera hasta 65,536 tokens por tramo, tanto si usa streaming como si no. Para salidas más largas se necesita ejecución en segundo plano o continuar mediante tokens; además, max_output_tokens limita la suma del pensamiento y la salida. Si configuras background=true sin especificar max_output_tokens, el servidor se detiene al llegar a 65,536 tokens. Los presupuestos que recomienda Google para decodificaciones largas son 131,072 o 262,144, hasta un máximo de 1,048,576 menos la entrada.
Qué hace la API y qué rechaza
El parámetro es thinking_level (snake_case). El ejemplo de Google en Python lo establece dentro de thinking_config; el ejemplo para Node lo anida bajo thinkingConfig (camelCase). La página del modelo enumera los valores como LOW, MEDIUM, HIGH y XHIGH; las notas de la versión los escriben en minúsculas. Usa el enum o la cadena documentada de tu SDK en lugar de escribir a mano una variante con mayúsculas y minúsculas distintas.
Tres formatos de solicitud fallan:
thinking_budgetdevuelve400: INVALID_ARGUMENTen cualquier modelo Gemini 4. Especificarthinking_levelythinking_budgeta la vez también devuelve un error.thinking_level="MINIMAL"no es compatible; Hydrogen lo rechaza.- Se ignoran los valores personalizados de
temperature,top_pytop_k. Los valores predeterminados fijos son temperature 1.0, topP 0.95 y topK 64.
En la plataforma de Google, Hydrogen también admite llamadas a funciones, ejecución de código, contexto de URL y uso de ordenador. En la API Interactions, usa previous_interaction_id para sesiones de varios turnos y llamadas a herramientas.
Qué documenta AIHubMix y qué no
La ruta documentada de AIHubMix para Hydrogen es POST https://aihubmix.com/v1/chat/completions con model="gemini-4-hydrogen". La página del modelo indica que admite entradas de texto, imagen, audio, vídeo y PDF, y genera texto; llms.txt todavía incluye una línea anterior que solo menciona texto, así que considera la página como la fuente más reciente. Las funciones de uso de herramientas, salida estructurada y razonamiento figuran como «no publicadas». El modelo no aparece en el índice de modelos generado el 2026-11-11 y no se ha publicado ningún esquema de protocolo.
Esto es relevante para este artículo porque AIHubMix no documenta cómo establecer un nivel de pensamiento en ningún modelo Gemini 4. Su guía de Gemini cubre reasoning_effort para modelos de la era Gemini 2.5, no thinking_level ni xhigh para Gemini 4. No des por hecho que alguno de esos parámetros se transmite a través de la pasarela ni que el nivel predeterminado observado en la API de Google sea el mismo que obtendrás en AIHubMix.
La estructura de solicitud segura es la que documenta AIHubMix:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "List the failure modes in this retry design."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
Si controlar el nivel es un requisito indispensable, llama directamente a la API de Google o verifica el comportamiento de la pasarela con una solicitud pequeña antes de dirigir tráfico de producción. La página comparativa de AIHubMix puede ayudarte a comparar costes mientras lo decides. Para este artículo no se realizó ninguna prueba en vivo.
Por dónde empezar según la carga de trabajo
| Carga de trabajo | Nivel inicial y motivo |
|---|---|
| Chat rápido, enrutamiento, clasificación | medium; prueba low: low obtiene 27 |
| Programación interactiva, creación de prototipos de interfaz | high; medium de AA obtiene 41 |
| Ejecución de agentes, ciclos de llamadas a herramientas | high; usa xhigh solo si te quedas atascado |
| Depuración compleja, arquitectura, planificación | xhigh o Carbon; 3 puntos por un 69% más |
| Procesamiento por lotes de gran volumen tras la evaluación | low o medium; son los más baratos, pero el índice es de 27/41 |
| Presupuesto estricto de latencia inferior a 15 segundos | medium o low; high tarda 18.89 s |
Estos son puntos de partida, no reglas de enrutamiento. El nivel adecuado es el más bajo que supere tu propia evaluación, y la recomendación de Google es realizarla con los cuatro niveles.
Preguntas frecuentes
¿Qué niveles de pensamiento tiene Gemini 4 Hydrogen?
Cuatro: low, medium, high y xhigh. El valor predeterminado es high.
¿Qué cambió con respecto a Gemini 3.8 Flash?
El valor predeterminado pasó de medium a high, y se añadió xhigh por encima de high. Carbon y Argon siguen teniendo medium como valor predeterminado y llegan hasta high.
¿Vale la pena xhigh?
Sí, para tareas complejas de varios pasos en las que high no da resultado: añade 3 puntos al índice. También cuesta un 69% más por tarea que high y casi duplica la espera hasta el primer token, por lo que no es una buena opción predeterminada para prompts sencillos.
¿Por qué low está tan por detrás?
Artificial Analysis le asigna 27 puntos en el índice, 24 puntos menos que a high. Cuesta $0.29 por tarea frente a $1.87, pero la diferencia de calidad es mucho mayor que la diferencia de precio. Úsalo solo cuando una evaluación específica de la tarea indique que es suficiente.
¿AIHubMix admite thinking_level o xhigh?
No según la documentación. AIHubMix no publica ninguna indicación de compatibilidad con el razonamiento para Hydrogen ni una guía sobre los niveles de pensamiento de Gemini 4. Verifícalo antes de depender de cualquiera de los dos.
¿Qué ocurre si envío thinking_budget?
Gemini 4 devuelve 400: INVALID_ARGUMENT. Si se configuran tanto thinking_budget como thinking_level, también se devuelve un error.
¿Puedo desactivar el pensamiento?
No hay una opción documentada para desactivarlo. Gemini 4 no admite MINIMAL y Hydrogen lo rechaza con un error.
Sigue leyendo: la serie Gemini 4 Hydrogen
- Si todavía estás decidiendo si Hydrogen es la actualización adecuada desde Gemini 3.8 Flash, el primer artículo trata el lanzamiento, el cambio de precio y las ventajas y desventajas en los benchmarks: Gemini 4 Hydrogen vs Gemini 3.8 Flash: ¿vale la pena actualizar?.
- Si quieres saber cómo se compara Hydrogen con Carbon y Argon para la misma tarea, el tercer artículo compara los tres, con precios, latencia y una tabla de cargas de trabajo: Gemini 4 Carbon vs Hydrogen vs Argon: ¿qué modelo elegir para cada tarea?.
Fuentes
- Google AI Studio, Gemini 4 Hydrogen: novedades
- Google, pensamiento de Gemini 4
- Google, página del modelo Gemini 4 Hydrogen
- Google AI Studio, precios de Gemini API
- Artificial Analysis, Gemini 4 Hydrogen — instantánea en vivo 2026-11-13T02:40Z, Intelligence Index v5.0.1


