Gemini 4 Carbon sustituye directamente a Gemini 4 Argon en lo que respecta al esquema de las solicitudes. El mismo cuerpo de chat completions funciona: cambia el ID del modelo y algunos valores de parámetros no se conservan. Los fallos importantes ocurren un nivel más abajo: errores de parámetros que devuelven 400, límites de salida que truncan en silencio y un perfil de tiempos de espera y facturación pensado para un modo de pensamiento prolongado.
Cuatro valores predeterminados determinan la primera semana:
- Mantén
max_tokensen 65,536 o menos en AIHubMix; la pasarela solo documenta Chat Completions y no publica una vía para obtener una salida mayor. - Para las ejecuciones en segundo plano de Google Interactions nativo, establece
store=truey unmax_output_tokensexplícito; estos campos no están documentados para Carbon en AIHubMix. - Aumenta los tiempos de espera de lectura HTTP a 15–20 minutos por flujo cuando uses la vía nativa del proveedor para decodificación prolongada.
- Elimina
temperature,top_pytop_k, que se ignoran, así como las penalizaciones y los valores decandidate_countsuperiores a 1, que devuelven 400 según la guía de Carbon de Google.
Los aspectos básicos que no cambian —el acceso, los rechazos por seguridad y el coste por tarea— se explican en la publicación sobre la migración a Argon. Esta publicación cubre el comportamiento específico de Carbon.
Qué falla de forma evidente y qué falla en silencio
Los fallos se dividen claramente: un 400 te avisa de inmediato; un límite silencioso te avisa con la factura.
| Qué ves | Tipo | Primera medida |
|---|---|---|
| HTTP 400 en un parámetro | Evidente | Elimina el campo no admitido |
| 400 en una solicitud en segundo plano | Evidente | Añade store=true |
| La respuesta se detiene en 65,536 tokens | Silencioso | Aumenta max_tokens, hasta 65,536 |
| Texto vacío, estado incomplete | Silencioso | Aumenta el límite y vuelve a intentarlo |
| La ejecución en segundo plano termina cerca de 64K | Silencioso | Establece max_output_tokens |
| La respuesta parece menos profunda | Silencioso | Establece explícitamente el nivel de pensamiento |
| La factura supera lo estimado | Silencioso | Cuenta los tokens de pensamiento y los saltos de decodificación |
AIHubMix ofrece gemini-4-carbon a $2 por millón de tokens de entrada, $10 por millón de tokens de salida y $0.10 por millón de tokens en caché —las tarifas introductorias de Google— mediante Chat Completions. Son temporales; consulta la sección de facturación.
Fallos evidentes: los errores 400 documentados
Muchos de los errores 400 documentados se deben a la validación de parámetros; el historial y los turnos del modelo rellenados previamente son errores del estado de la solicitud. Las reglas siguientes proceden de la guía nativa de Carbon de Google, salvo que se indique lo contrario; AIHubMix solo documenta actualmente Chat Completions para Carbon. La ficha de Carbon de AIHubMix describe el tipo de error en una línea: «400: error de parámetro; la mayoría se reenvían desde el proveedor ascendente». Eso describe la pasarela, no una prueba. Los detalles proceden de la guía de Carbon y la página de novedades de Google.
| Causa | Qué ves | Solución |
|---|---|---|
| max_output_tokens > 1M* | 400; supera el límite | Nativo ≤1M; pasarela ≤65K* |
| frequency/presence penalty | 400; no admitido | Elimina los campos |
| candidate_count > 1 | 400; varios candidatos | Omítelo o establece 1 |
| solicitud en segundo plano sin store* | 400; store obligatorio* | Añade store=true |
| El historial termina con el modelo | Rechazado; no admitido | Termina con un turno del usuario |
| ambos controles | 400; no se pueden combinar | Envía uno |
| thinking_budget o MINIMAL | 400; guía de Carbon | Usa low/medium/high |
Google muestra el mensaje exactamente así: «store=true is required for background interactions». * Solo para Google nativo: max_output_tokens tiene un límite de 1M y las solicitudes en segundo plano requieren store=true; AIHubMix no ha documentado esta vía. Usa ≤65K en su vía de Chat Completions.
La fila de minimal tiene dos significados. En los campos nativos de Carbon de Google, thinking_budget y thinking_level=MINIMAL devuelven HTTP 400; usa low, medium o high. En la capa de compatibilidad con OpenAI de Google, reasoning_effort=minimal se asigna a low; AIHubMix no ha publicado si aplica esa asignación a Carbon.
La gestión de herramientas es otra trampa relacionada. La guía de Carbon de Google recomienda turnos de ejecución secuencial de herramientas, y la guía de Gemini de AIHubMix documenta tool_choice="auto"; la compatibilidad específica con las herramientas de Carbon en la pasarela aún no está confirmada.
La solicitud mínima segura en /v1/chat/completions elimina lo que Carbon ignora:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Reply with OK."}],
    max_tokens=32768,  # room for thinking plus answer
)
print(response.choices[0].message.content)
Si devuelve 200, la capa de transporte está lista. El resto tiene que ver con respuestas que no generan errores.
Fallos silenciosos: sin errores, pero con una salida incorrecta y una factura equivocada
El límite estándar de salida es 65,536; la decodificación prolongada del proveedor es independiente
El límite estándar de salida de Carbon es de 65,536 tokens. En Chat Completions, el campo de límite es max_tokens; en las guías nativas de Google se llama max_output_tokens. La vía nativa de Google para decodificación prolongada puede llegar hasta 1,048,576 tokens menos la entrada; 131,072 y 262,144 son ejemplos. La página de novedades de Google establece la regla: «Si estableces background: true sin definir max_output_tokens, el servidor se detiene tras 64K tokens». AIHubMix no ha documentado la ejecución en segundo plano ni la continuación para Carbon.
La decodificación prolongada nativa del proveedor se ejecuta en segmentos: 64K por salto con background o streaming, y 32K por salto sin streaming; una sola solicitud REST sin streaming se detiene tras 32,768. La guía de Google señala que «las versiones anteriores de los SDK y la capa de compatibilidad con OpenAI no pueden recuperar finalizaciones largas mediante tokens de continuación». Para AIHubMix, mantén max_tokens en 65,536 o menos como límite conservador y no verificado de la pasarela; no planifiques unir respuestas más largas hasta que la página del modelo lo documente.
Un límite bajo trunca el pensamiento y la salida vacía se factura
El límite abarca el pensamiento, no solo el texto. La guía de decodificación prolongada de Google dice: «Un valor bajo, como 8,192, detiene el modelo antes de que termine de pensar». El estado pasa a ser incomplete y «el texto puede estar vacío si el modelo seguía pensando». Se cobra en ambos casos. Reserva tokens para el pensamiento y la respuesta, y trata una respuesta incompleta y vacía como un problema de límite: súbelo, vuelve a intentarlo y cuenta con que el primer intento aparezca en la factura.
El nivel de pensamiento predeterminado es medium
Carbon usa medium de forma predeterminada, igual que Argon. Los equipos que vienen de Gemini 3.1 Pro Preview, cuyo valor predeterminado es high, pierden un nivel sin cambiar el código y pueden interpretar la respuesta menos profunda como una regresión. Google recomienda medium para la mayoría de las tareas de programación y de tipo agéntico. Establece explícitamente el nivel en staging y envía un solo campo de control: reasoning_effort y thinking_level no se pueden combinar.
Los parámetros de muestreo se ignoran
Se ignoran temperature, top_p y top_k: no hay error ni cambia la muestra. Elimínalos. Las penalizaciones y los valores de candidate_count superiores a 1 devuelven 400.
La caché explícita ya no está disponible
cachedContents y caches.create no son compatibles. El almacenamiento en caché implícito se aplica a partir de 4,096 tokens y ofrece un descuento del 95%. Elimina el código de caché explícita, coloca primero el prefijo estable del prompt y comprueba el uso de tokens en caché antes de calcular el descuento en el presupuesto.
El estado de la conversación tiene una regla
Google recomienda previous_interaction_id para continuar. Chat Completions no tiene ese campo, así que conserva el historial, pero termina con un turno del usuario; no se admiten los historiales que terminan con un rol de modelo ni los turnos del modelo rellenados previamente.
Tiempos de espera: 15 a 20 minutos, no 60 segundos
La guía de decodificación prolongada de Google recomienda tiempos de espera de lectura HTTP de 15 a 20 minutos por flujo; su lista de verificación para la migración repite el mínimo de 15 minutos. Esa recomendación se refiere a solicitudes de decodificación prolongada. Una medición independiente de AA muestra el tiempo de espera hasta el primer token de respuesta: Carbon High tardó 67.1 segundos, Medium 23.2, Low 12.9 y Argon High 40.1. ¿Un límite de 60 segundos siquiera permite que llegue el primer token?
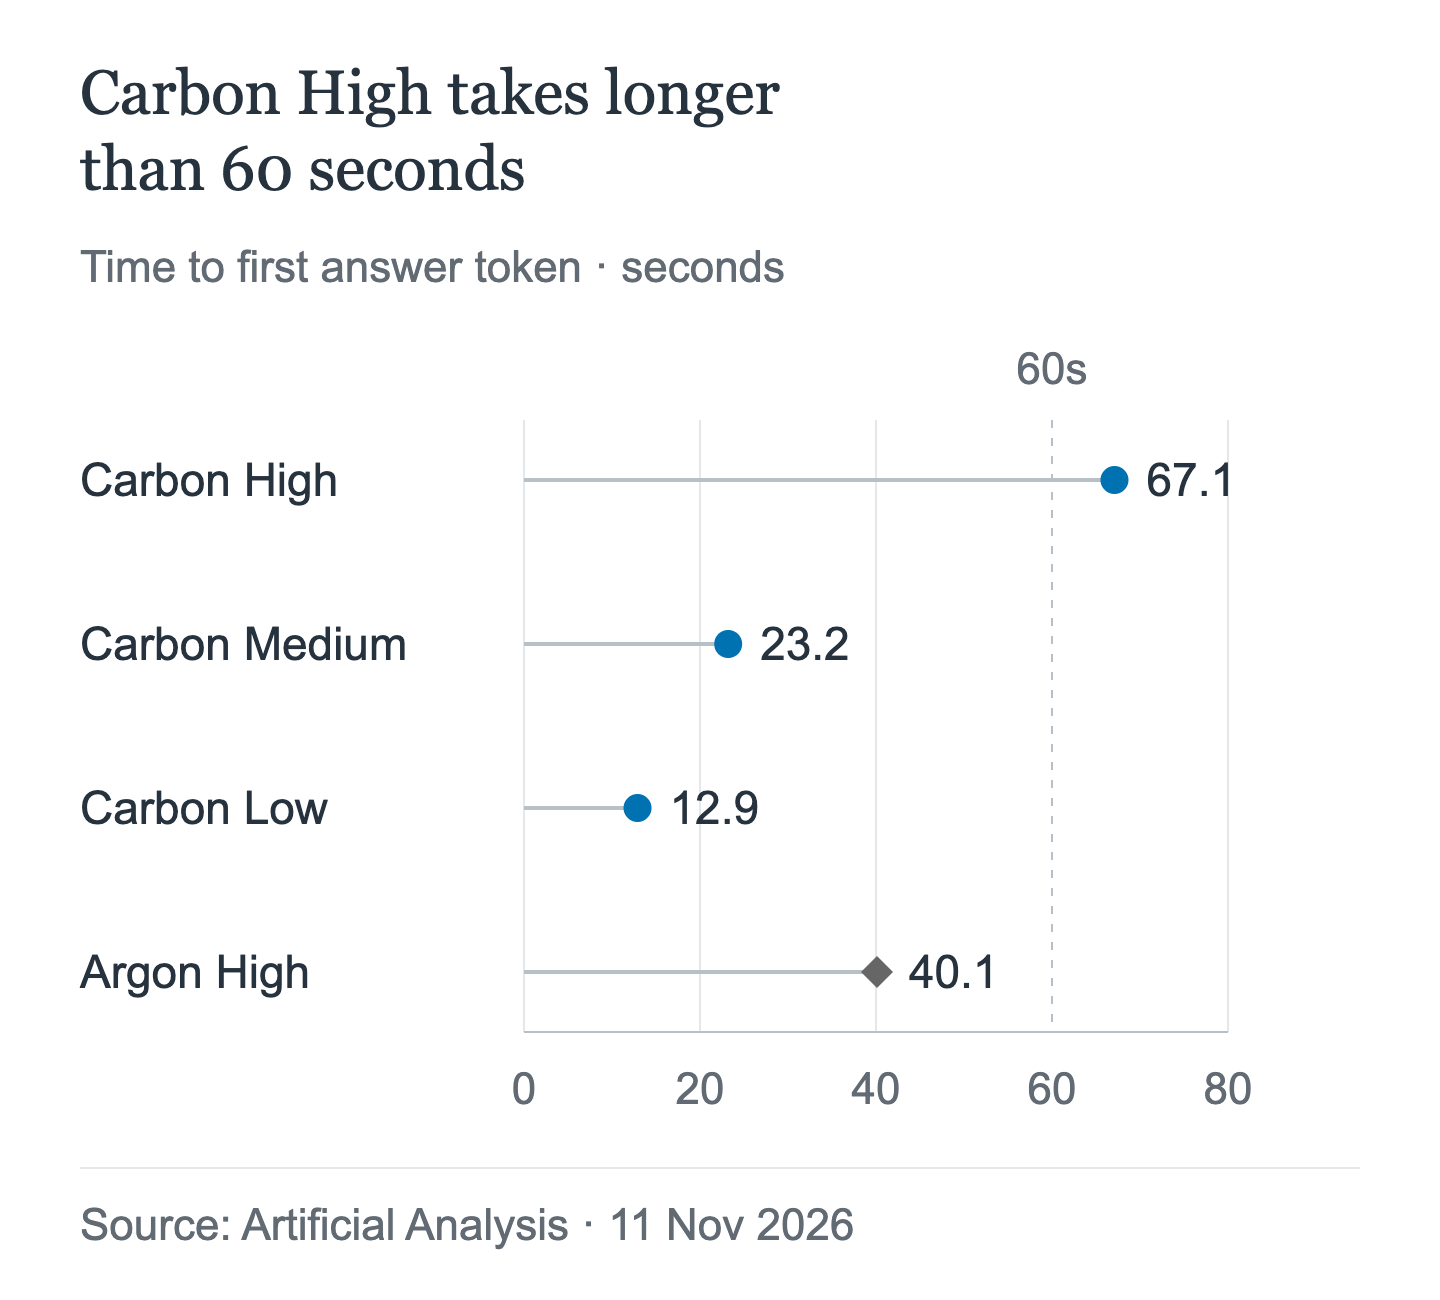
En esta medición, Carbon High supera la referencia de 60 segundos. El tiempo hasta el primer token no determina un tiempo de espera seguro para toda la solicitud: la recomendación de 15–20 minutos anterior procede de la guía de decodificación prolongada de Google. Son resultados de una sola medición puntual, no garantías de latencia ni una prueba de AIHubMix.
Los límites de los saltos del cliente nativo de Google son más estrictos que el límite para segundo plano: 20 minutos para un flujo y 10 para una llamada sin streaming, frente a 24 horas para el modo en segundo plano. AIHubMix no documenta estos límites para solicitudes en segundo plano.
Versiones mínimas de los SDK nativos para la decodificación prolongada: Python 2.34.0, JS 2.32.0, Go 1.77.0, Java 1.80.0, .NET 1.28.0. API_TIMEOUT_MS de Claude Code tiene un valor predeterminado de 10 minutos; si más adelante se confirma una vía de Claude Code para Carbon, auméntalo antes de la primera ejecución.
Trampas de facturación
El precio por token de Carbon es sencillo; la factura, no. Varios mecanismos elevan el importe, y un cambio programado duplica todas las tarifas.
El pensamiento se factura como salida
Los tokens de pensamiento se facturan como tokens de salida. La tarifa de salida de Carbon es ahora de $10 por millón de tokens y subirá a $20 a partir del 1 de diciembre.
Se factura cada salto de decodificación prolongada
Ejemplo práctico de Google: un prompt de 1,000 tokens que genera 200,000 tokens de salida registra total_input_tokens de 397,216 a lo largo de saltos de 1,000, 66,536, 132,072 y 197,608. «Pagas por cada token de cada salto, incluidos los saltos que solo contienen pensamiento». El almacenamiento en caché implícito descuenta el 95% de la mayoría de los tokens de entrada, pero los saltos siguen contabilizándose en el uso. También se factura el trabajo completado cuando una ejecución falla o se cancela: «Los segmentos completados se facturan al final de cada segmento, aunque un segmento posterior falle o se cancele» y «Pagas por todo el trabajo completado antes de que termine la interacción».
La fundamentación tiene su propio contador
En el servicio nativo de Google, la fundamentación con Google Search incluye 5,000 solicitudes gratuitas al mes, compartidas entre Gemini 3 y las versiones posteriores; después cuesta $14 por cada 1,000, con un límite de 1,500 al día. AIHubMix no ha documentado la fundamentación para Carbon.
La nota al pie de Vertex solo se aplica al proveedor
La página de precios de Vertex de Google añade una regla: las finalizaciones de más de 32K tokens se cobran según el uso de tokens recuperables, aunque la solicitud falle por un tiempo de espera agotado en el cliente o el servidor; entra en vigor el 13 de noviembre de 2026. Es una regla del proveedor; no se ha publicado si el proveedor VertexAI de AIHubMix la aplica. Pregunta antes de darlo por hecho.
El 1 de diciembre se duplican todas las tarifas
| Tarifa | Hasta el 30 de noviembre | A partir del 1 de diciembre |
|---|---|---|
| Entrada | $2 por 1M | $4 por 1M |
| Salida | $10 por 1M | $20 por 1M |
| Lectura desde caché | $0.10 por 1M | $0.20 por 1M |
Carbon y Argon comparten las tarifas introductorias; todas se duplican el 1 de diciembre. AIHubMix muestra hoy las tarifas introductorias y no ha publicado los precios posteriores al 1 de diciembre. Da por seguro que se duplicarán y considera desconocido el precio de la pasarela; comprueba ambos antes de comprometer un presupuesto.
Agentes con permisos reales
Para las llamadas nativas de Google, la guía de Carbon recomienda usar turnos secuenciales de ejecución de herramientas. Si sigues esa ruta, haz una llamada a la vez. La guía de Gemini de AIHubMix documenta tool_choice="auto", pero no se han confirmado la compatibilidad de Carbon con herramientas ni el comportamiento de selección forzada de herramientas en la pasarela.
El historial no debe terminar con un turno del modelo, y no se admiten turnos del modelo rellenados previamente. Si falta el resultado de una herramienta, envía un turno de usuario que solicite el siguiente paso.
La ficha del modelo menciona lentitud ocasional o tiempos de espera agotados, así como tokens adicionales en los niveles más altos; la fecha de corte de conocimientos es marzo de 2026. Con acceso de escritura, el riesgo real es que se agote el tiempo de espera: una ejecución que supere el límite del cliente puede dejar trabajo parcial sin terminar, y los segmentos completados igualmente se cobran.
Herramientas de programación: consulta la página del modelo antes de configurar nada
La ficha de Carbon de AIHubMix documenta solo Chat Completions, y Carbon aún no aparece en el índice público de modelos. Claude Code necesita Anthropic Messages; Codex necesita Responses. Ninguno está confirmado para Carbon en AIHubMix. No des por sentado que alguno funcionará: abre la página del modelo Carbon enlazada arriba y comprueba la lista de protocolos. Si solo aparece Chat Completions, usa un cliente compatible con OpenAI o espera.
La estructura de la solicitud es la misma que para Argon, pero la disponibilidad de protocolos es distinta: actualmente, AIHubMix solo documenta Carbon para Chat Completions. La publicación sobre Claude Code explica ANTHROPIC_BASE_URL, ANTHROPIC_AUTH_TOKEN y API_TIMEOUT_MS; la publicación sobre Codex explica el bloque del proveedor, wire_api y model_reasoning_effort. Lo que cambia es si el protocolo está disponible.
| Cliente | Protocolo que necesita | Carbon en AIHubMix |
|---|---|---|
| Claude Code | Anthropic Messages | No documentado |
| Codex | Responses API | No documentado |
| OpenAI SDK | Chat Completions | Documentado |
Configuración:
- ID del modelo:
gemini-4-carbon. - Pensamiento: bajo, medio, alto; medio de forma predeterminada.
- Correspondencia del esfuerzo: campo nativo
thinking_level, campo de compatibilidadreasoning_effort; Google asigna valores al esfuerzo, pero AIHubMix no ha publicado la correspondencia para Carbon. Envía uno solo. - Contexto: 1,048,576 según Google; AIHubMix no ha publicado un límite para Carbon, así que no configures tu sistema en función de la cifra del proveedor.
- Problemas conocidos: primer token lento en el nivel alto, recomendación del proveedor de preferir turnos secuenciales de herramientas, límite conservador no verificado de AIHubMix de 65,536 tokens de salida y fecha de corte de marzo de 2026.
Prueba de humo, 10–15 minutos:
- Elige un repositorio pequeño con una prueba unitaria fallida y un comando de prueba que tarde menos de un minuto en ejecutarse.
- Configura el modelo como
gemini-4-carbon,max_tokensen 65,536 o menos y el tiempo de espera HTTP en al menos 15 minutos. - Pide a la herramienta que haga el cambio más pequeño que haga pasar la prueba; luego ejecuta el comando de prueba y revisa el diff.
- Aprobado: la edición es mínima y la prueba pasa en 10–15 minutos. No aprobado: registra si la respuesta fue un 400, una respuesta incompleta, un tiempo de espera agotado o una edición incorrecta; cada caso tiene una solución distinta indicada arriba.
- Si la herramienta permite elegir el nivel, prueba medio y alto, y quédate con el que termine dentro del plazo.
Lista de comprobación antes de la primera solicitud de producción
- ID del modelo configurado como
gemini-4-carbon. - Sin
temperature,top_pnitop_k. - Sin
frequency_penaltynipresence_penalty; dejacandidate_counten 1 u omítelo. max_tokensen 65,536 o menos.- Las solicitudes nativas de Google en segundo plano envían
store=truey unmax_output_tokensexplícito; AIHubMix no ha documentado esta ruta. - Tiempo de espera HTTP de 15 minutos o más; se recomienda streaming.
- Usa solo uno de estos parámetros:
reasoning_effortothinking_level. - En Google nativo, prefiere turnos secuenciales de herramientas; AIHubMix documenta
tool_choice="auto", pero la compatibilidad con Carbon no está confirmada. - No hagas llamadas explícitas a la caché; primero va el prefijo estable del prompt.
- El presupuesto incluye los tokens de pensamiento y cada paso de decodificación prolongada.
- Confirma las tarifas del 1 de diciembre con quien se encargue del presupuesto.
- Comprueba la herramienta de programación en la página del modelo antes de configurarla.
Preguntas frecuentes
¿Hay que cambiar el cuerpo de la solicitud al pasar de Argon a Carbon?
No. El esquema no cambia. Cambia el ID del modelo, revisa los valores y elimina los campos que ahora devuelvan un 400.
¿Por qué max_output_tokens devuelve un 400?
La API nativa de Carbon de Google rechaza los valores superiores a 1,048,576. La ruta de Chat Completions de AIHubMix tiene una recomendación conservadora aparte: mantén max_tokens en 65,536 o menos hasta que se documente una ruta con un límite mayor. Un valor bajo trunca el pensamiento, lo cual es peor: la respuesta puede quedar incompleta y se cobra igualmente.
¿Por qué la respuesta está vacía?
Si el estado es incompleto, el texto puede estar vacío porque el modelo seguía pensando. El trabajo se cobra. Aumenta el límite y vuelve a intentarlo.
¿Por qué una solicitud en segundo plano se detiene en 64K?
En la ruta nativa de Google en segundo plano, si se omite max_output_tokens, el servidor se detiene en 64K. Establece el límite de forma explícita; la decodificación prolongada nativa puede alcanzar hasta 1,048,576 menos la entrada. AIHubMix no ha documentado el modo en segundo plano.
¿Se respeta temperature?
No. Se ignoran temperature, top_p y top_k. En cambio, los valores de las penalizaciones y de candidate_count superiores a 1 devuelven un 400.
¿Carbon costará el doble el 1 de diciembre?
Las tarifas de Google se duplican: la entrada pasa de $2 a $4, la salida de $10 a $20 y las lecturas en caché de $0.10 a $0.20. AIHubMix no ha publicado el precio posterior a diciembre, así que confírmalo antes de comprometer un presupuesto.
¿Se puede usar Claude Code o Codex con Carbon?
No está confirmado. AIHubMix documenta Chat Completions para Carbon; Claude Code necesita Anthropic Messages y Codex necesita Responses. Consulta primero la página del modelo.
Sigue leyendo: la serie Gemini 4 Carbon
- Si la migración está en marcha y lo que queda por saber es si Carbon justifica su precio, la comparación presenta lado a lado las tarifas introductorias compartidas.
Gemini 4 Carbon vs Argon: mismo precio, ¿cuándo vale la pena Carbon? - Si estás eligiendo un agente de programación en lugar de migrar un endpoint, la comparación directa analiza el uso de herramientas y el costo por tarea.
Gemini 4 Carbon vs Fable 5.2: ¿cuál elegir para la programación agéntica?