
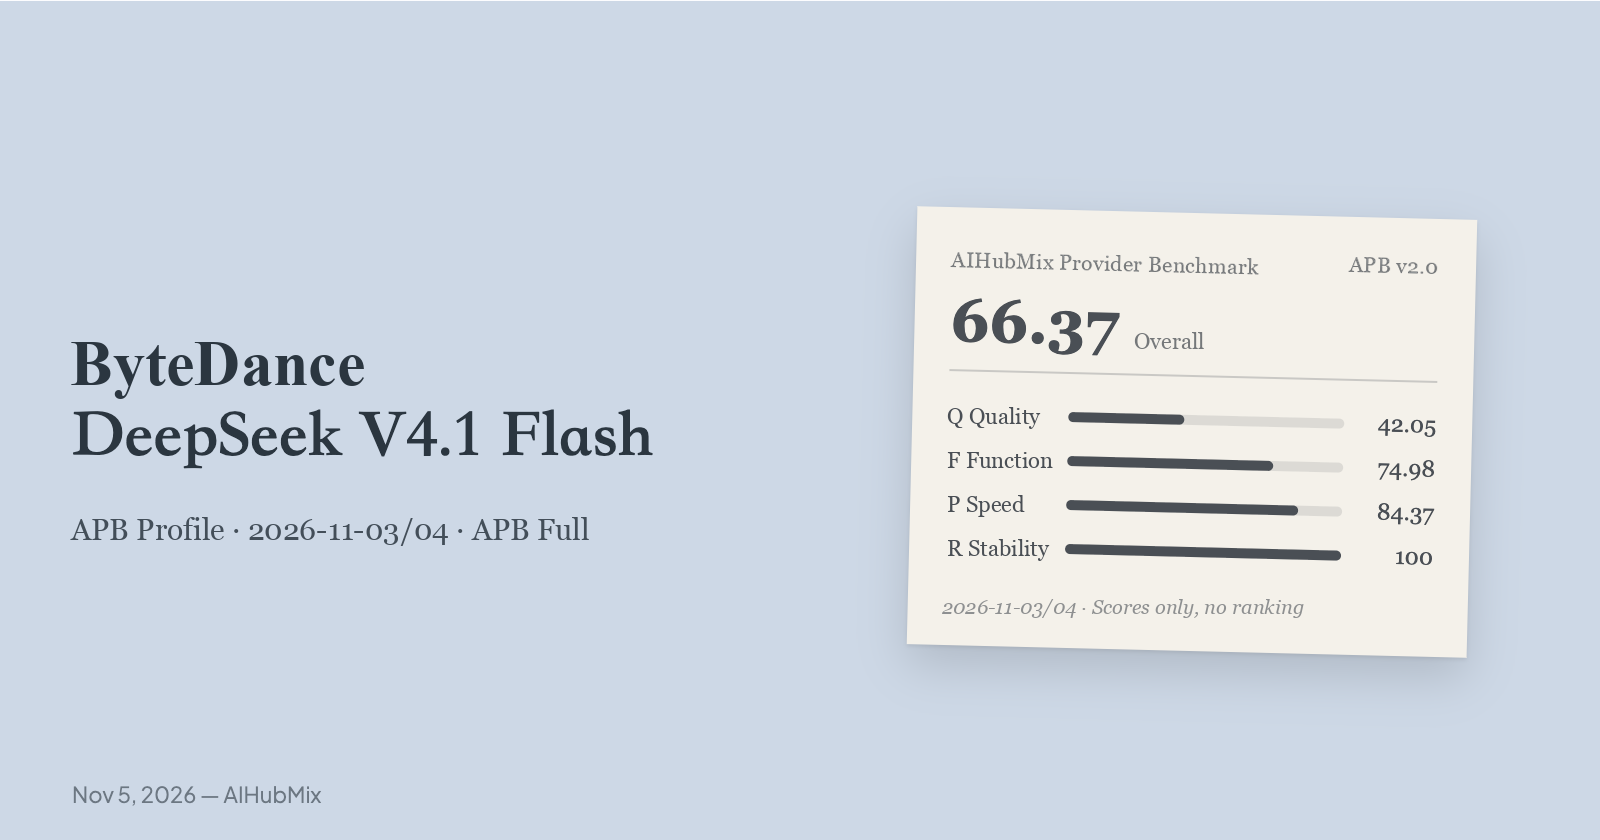
El 2026-11-03/04, se probó DeepSeek V4.1 Flash 1017 en cinco proveedores a través de AIHubMix con la suite APB Full: las mismas preguntas, parámetros y scripts de solicitudes en cada caso. Este perfil APB cubre únicamente la ejecución en ByteDance, sección por sección.
Las cifras siguientes son puntuaciones, no una clasificación ni una recomendación de proveedor. Q, F, P, K y R aparecen primero; la puntuación general es un índice de resumen, no una certificación, y no tiene intervalo de confianza. Las reglas de puntuación se definen en AIHubMix Provider Benchmark Standard v2.0.
Puntuaciones de cinco proveedores
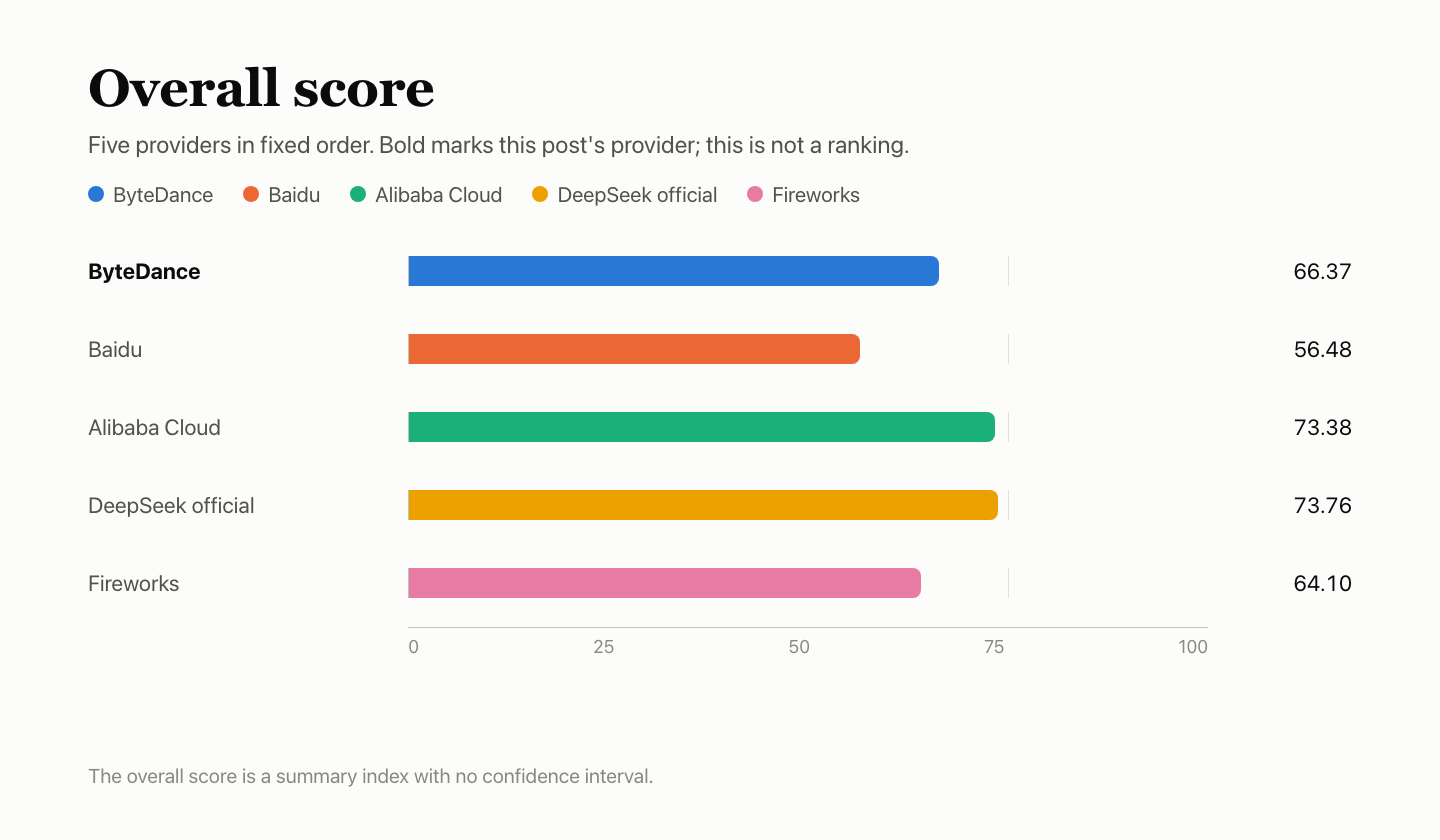
La negrita marca el proveedor de esta publicación. Orden fijo de proveedores, no una clasificación. K es una subpuntuación de P y representa el 20% de esta. La puntuación general es un índice de resumen sin intervalo de confianza. DeepSeek oficial y Alibaba Cloud difieren en 0.37 y no se pueden distinguir.
De un vistazo
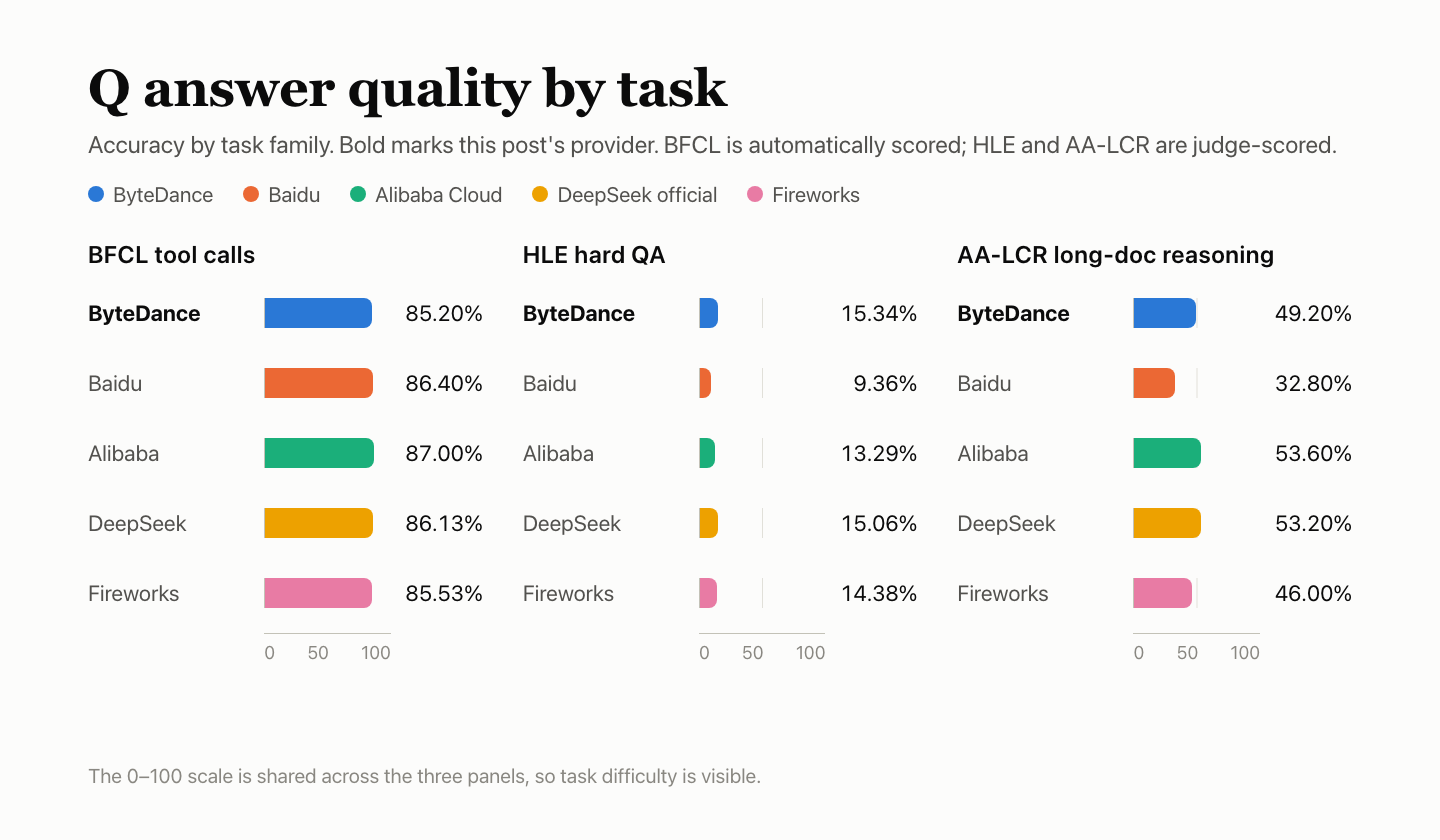
- Q 42.05. BFCL 85.20%, HLE 15.34%, AA-LCR 49.20%. La diferencia con el canal oficial es de −0.40 puntos porcentuales, con un intervalo del 95% de −1.46 a +0.66: no se pueden distinguir. AA-LCR tuvo 28 fallos de solicitud, todos en la ventana 1, contabilizados como respuestas incorrectas.
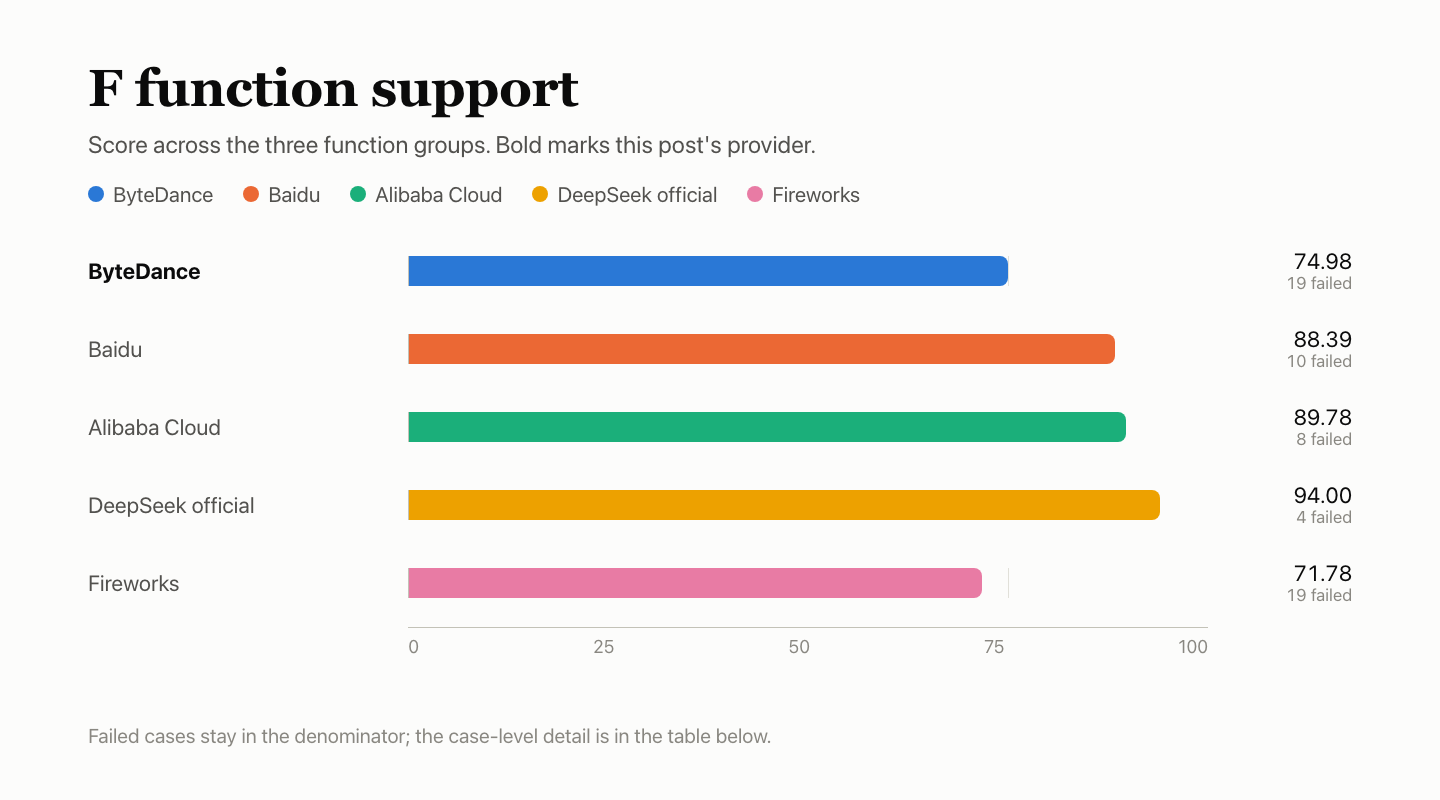
- F 74.98. De las 174 comprobaciones contabilizadas, 124 se superaron.
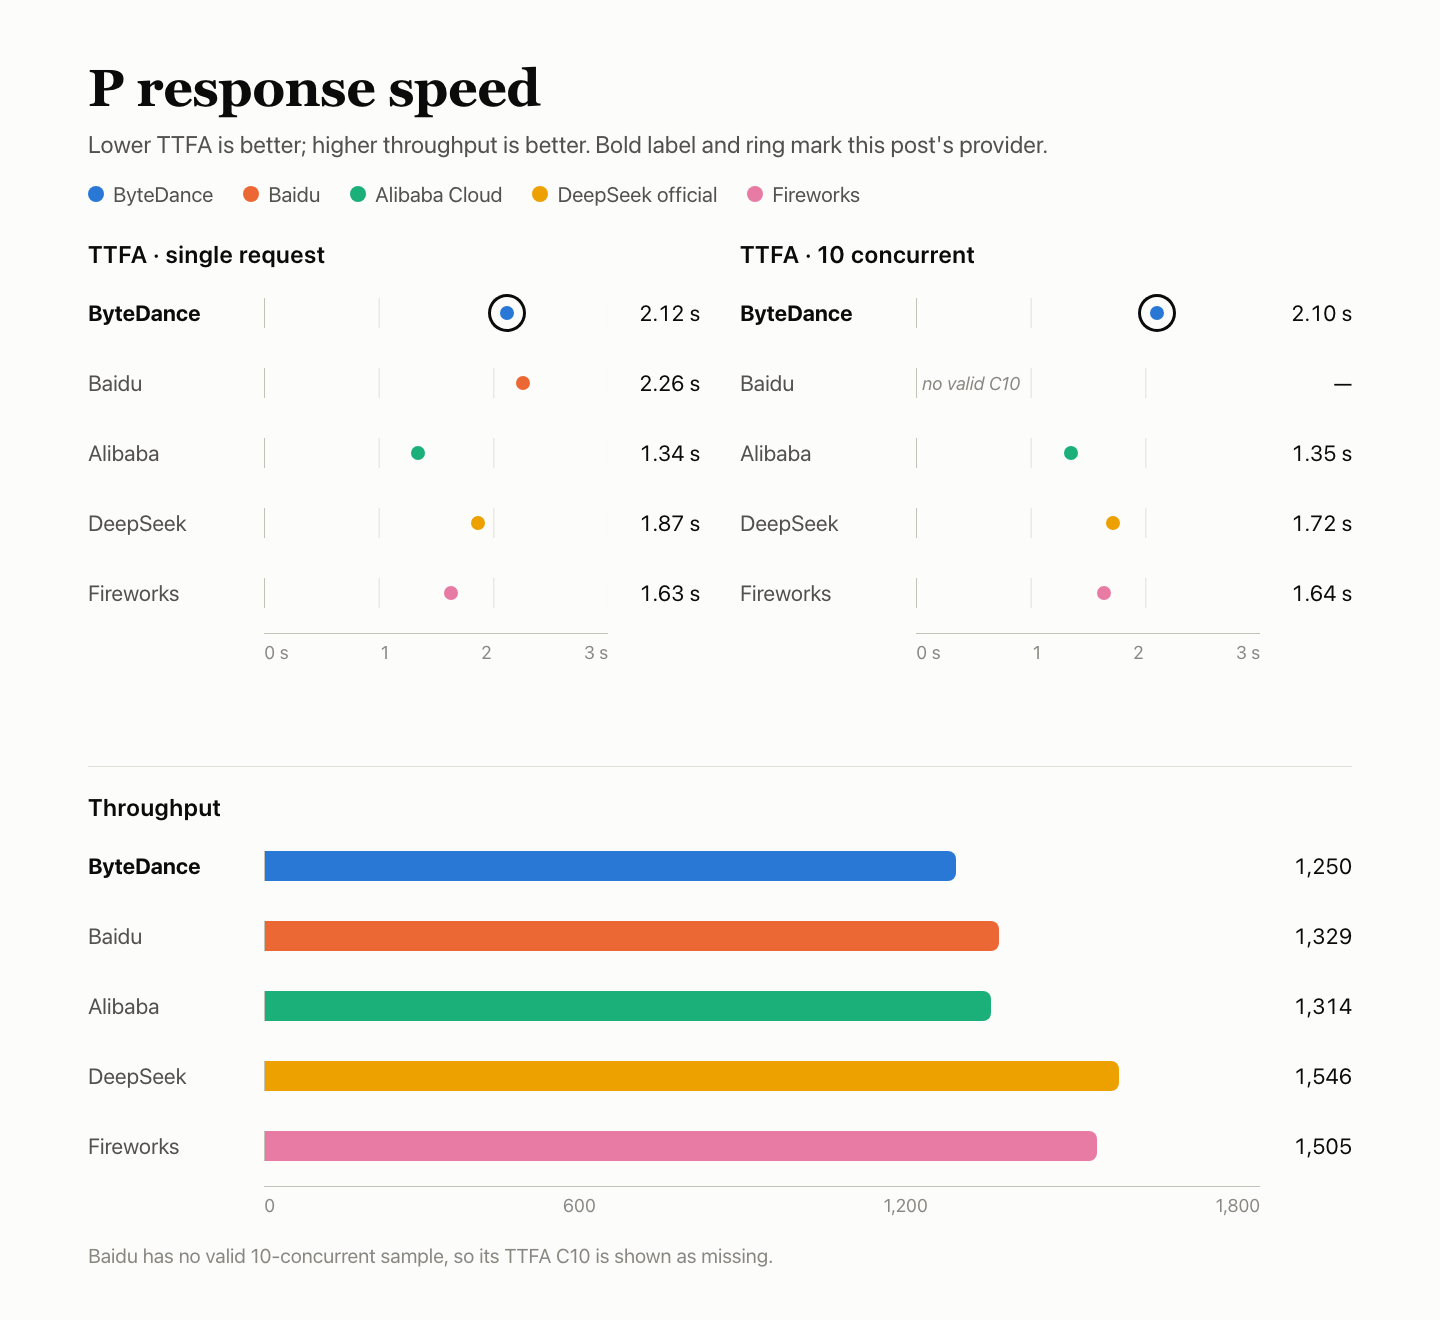
reasoning_effort=noneno desactiva el modo de pensamiento. Una entrada de 10k tokens se notificó como 10,026 tokens (recuento nativo: 10,000); una entrada de 8 tokens se notificó como 34. - P 84.37. Tiempo hasta el primer token del cuerpo: mediana de 2.12 s con concurrencia individual y de 2.10 s con concurrencia de 10; TPOT: 3.43 ms/token; las 180 solicitudes de velocidad fueron válidas.
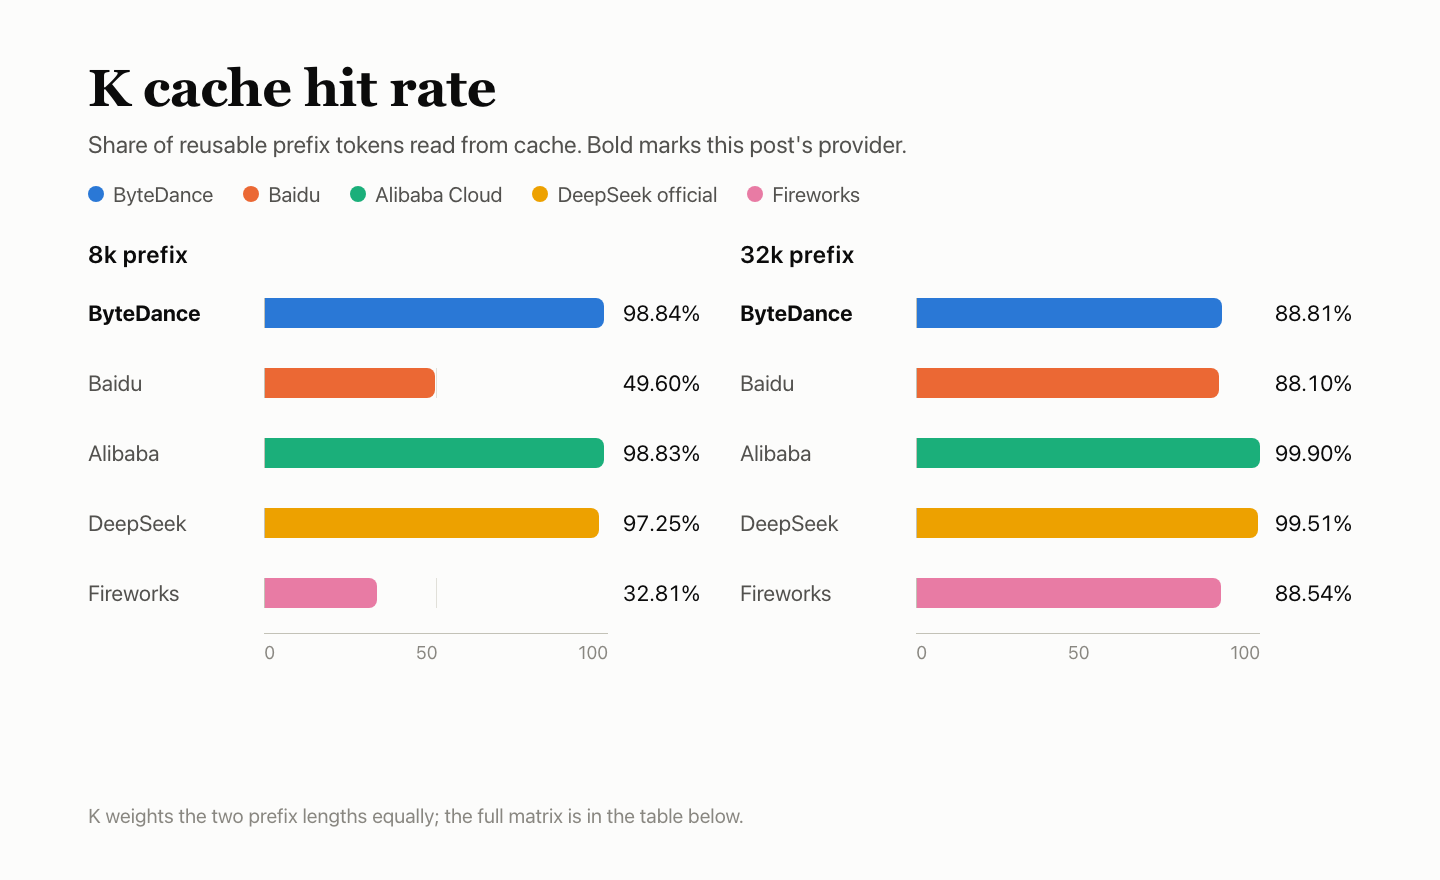
- K 93.83. Las solicitudes en caliente de 8k acertaron 9/9; las de 32k acertaron 8 veces y una solicitud no terminó antes del plazo de 300 s.
- R 100. Las 300 solicitudes dedicadas se completaron correctamente al primer intento.
Configuración de la prueba
| Elemento | Detalle |
|---|---|
| Modelo | DeepSeek V4.1 Flash 1017 |
| ID del modelo solicitado | doubao-deepseek-v4.1-flash-1017 |
| Nombre del modelo devuelto | deepseek-v4-1-flash-261017 |
| Ruta de acceso | A través de AIHubMix con un ID de modelo específico del proveedor; no es una conexión directa a la cuenta del proveedor |
| Parámetros | Modo sin pensamiento, temperatura 1.0, max_tokens 16,384, tiempo de espera 300 s, sin reintentos automáticos |
| Pensamiento desactivado | Las solicitudes de calidad de respuesta, velocidad, caché y estabilidad usaron thinking.type=disabled nativo (para este proveedor, reasoning_effort=none no desactivó el modo de pensamiento); los casos de funciones mantuvieron reasoning_effort=none para comprobar si el parámetro surtía efecto |
| Hora | 2026-11-03 18:07 – 11-04 16:33 UTC+8; los cinco proveedores compartieron un Mac mini, una red y una cuenta |
| Muestras | Calidad de respuesta: 4,250 instancias de preguntas (BFCL 500 × 3, HLE 250 × 10, AA-LCR 25 × 10); funciones: 60 casos × 3 ventanas; velocidad: 90 con concurrencia individual y 90 con concurrencia de 10; estabilidad: 300; caché: 30 (tres grupos, cada uno con prefijos de 8k y 32k) |
Las solicitudes usaron la ruta de inicio rápido de AIHubMix con un ID específico del proveedor, y los parámetros siguen la documentación de la API de DeepSeek; los ID de otros proveedores aparecen en la página de modelos.
Q — calidad de respuesta: 42.05
La calidad de respuesta se evalúa con tres suites: 500 preguntas BFCL con 3 rondas cada una, 250 preguntas HLE con 10 rondas cada una y 25 preguntas AA-LCR con 10 rondas cada una. BFCL se puntúa con reglas automáticas; HLE y AA-LCR se evalúan con el modelo deepseek-flash. Los cinco proveedores recibieron las mismas preguntas y los resultados de las tres suites se agrupan en una sola precisión. Se eliminaron diez respuestas porque no se podía puntuar la pregunta, por lo que quedaron 4,240 instancias de preguntas puntuadas.
| Suite | Preguntas | Correctas | Precisión | Fallos |
|---|---|---|---|---|
| Llamadas a herramientas BFCL | 500 × 3 | 1,278/1,500 | 85.20% | 0 |
| Preguntas y respuestas difíciles HLE | 250 × 10 | 382/2,490 | 15.34% | 7 |
| Razonamiento sobre documentos largos AA-LCR | 25 × 10 | 123/250 | 49.20% | 28 |
| Combinado · intervalo del 95%: 39.70%–44.33% | — | 1,783/4,240 | 42.05% | 35 |
Los fallos del servicio —fallos de solicitud o salida truncada— permanecen en el denominador y cuentan como respuestas incorrectas. La salida de HLE alcanzó el límite de max_tokens 7 veces; AA-LCR tuvo 28 fallos de solicitud, todos en la ventana 1. BFCL se puntúa automáticamente; HLE y AA-LCR se puntúan con un evaluador.
Cada pregunta BFCL se respondió 3 veces; la tabla suma las 3 rondas.
| Categoría BFCL | Superadas | Tasa de aprobación |
|---|---|---|
| simple_python — una función, llamada y argumentos correctos | 329/360 | 91.39% |
| multiple — elegir una de varias funciones | 268/300 | 89.33% |
| parallel — llamar varias veces a la misma función | 271/300 | 90.33% |
| parallel_multiple — llamar a varias funciones distintas | 207/240 | 86.25% |
| irrelevance — ninguna función es pertinente; no se debe llamar a ninguna | 102/150 | 68.00% |
| ahm_multi_turn — cadena de herramientas de tres etapas | 101/150 | 67.33% |
Comparación con los otros cuatro
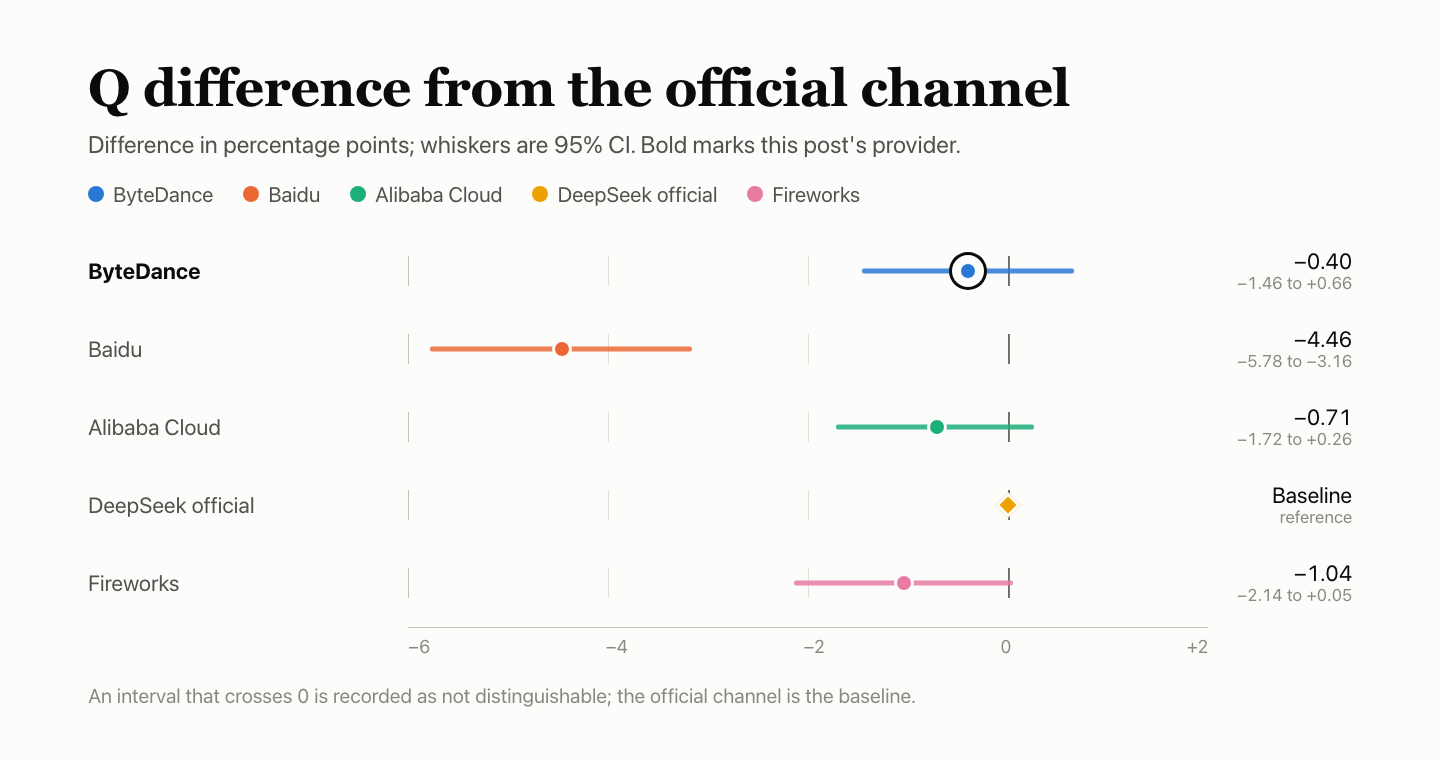
Diferencia con el canal oficial en puntos porcentuales, con el intervalo del 95% mostrado mediante barras. Si un intervalo cruza el 0, se registra que no se pueden distinguir. El evaluador de HLE y AA-LCR, deepseek-flash, pertenece a la misma familia DeepSeek que el modelo probado y no se calibró, por lo que sus evaluaciones podrían ser indulgentes.
F — compatibilidad con funciones: 74.98
La suite de funciones solo comprueba si el comportamiento de la interfaz se ajusta al protocolo, no si el modelo responde bien. Se ejecutaron 60 casos en seis grupos tres veces, una por ventana: 180 comprobaciones, evaluadas según el formato documentado por cada proveedor. Las comprobaciones no aplicables, no válidas o no observadas se excluyen del denominador. ByteDance superó 124 de las 174 comprobaciones contabilizadas y obtuvo 74.98 según las ponderaciones de los grupos.
La puntuación ponderada aplica las ponderaciones de los grupos; no equivale a las comprobaciones superadas divididas entre 174.
| Grupo | Ponderación | Superadas | Excluidas | Puntuación del grupo |
|---|---|---|---|---|
| Streaming y protocolo de mensajes | 20% | 23/27 | 3 | 85.19 |
| Interfaz de herramientas | 20% | 30/30 | — | 100.00 |
| Restricciones de salida y parámetros | 20% | 24/30 | — | 80.00 |
| Contexto y estado | 15% | 14/30 | — | 46.67 |
| Errores y recuperación | 15% | 21/30 | — | 70.00 |
| Medición de uso y protocolo de caché | 10% | 12/27 | 3 | 44.44 |
| Total · puntuación ponderada | — | 124/174 | 6 | 74.98 |
«Ventanas fallidas» indica cuántas de las 3 ventanas no superaron la comprobación.
| Caso fallido | Ventanas fallidas | Motivo |
|---|---|---|
| El razonamiento no se filtra al contenido — streaming y protocolo de mensajes | 3/3 | Con reasoning_effort=none, se siguió devolviendo contenido de pensamiento |
| La configuración del modo de pensamiento surte efecto — restricciones de salida y parámetros | 3/3 | Con reasoning_effort=none, se siguió devolviendo contenido de pensamiento |
| Diversidad de muestreo — restricciones de salida y parámetros | 3/3 | Las salidas con temperatura 0 y 1 no fueron lo bastante diferentes; quedaron por debajo del umbral preestablecido |
| Entrada larga de 10k — contexto y estado | 3/3 | Entrada notificada: 10,026 tokens; el recuento nativo debería ser 10,000 |
| Dentro del límite de contexto — contexto y estado | 3/3 | Entrada notificada: 10,026 tokens; el recuento nativo debería ser 10,000 |
| Entrada larga de 32k — contexto y estado | 3/3 | Entrada notificada: 10,026 tokens; el recuento nativo debería ser 10,000 |
| Entrada larga de 100k — contexto y estado | 3/3 | Entrada notificada: 10,026 tokens; el recuento nativo debería ser 10,000 |
| Por encima del límite de contexto — contexto y estado | 3/3 | Fallo de conexión ascendente o tiempo de espera agotado (1); debería devolver un error de parámetro, pero devolvió 200 (2) |
| Historial de 12 turnos — contexto y estado | 1/3 | Fallo de conexión ascendente o tiempo de espera agotado |
| Error de formato de messages — errores y recuperación | 3/3 | Devolvió 400 con el cuerpo vacío; no hubo explicación estructurada del error |
| Resultado de herramienta huérfano — errores y recuperación | 3/3 | Debería devolver un error de parámetro, pero devolvió 200 |
| Error de formato de stream_options — errores y recuperación | 3/3 | Devolvió 400 con el cuerpo vacío; no hubo explicación estructurada del error |
| Contabilización de tokens de pensamiento — medición de uso y protocolo de caché | 3/3 | Se notificaron tokens de pensamiento después de desactivar el modo de pensamiento |
| Recuento nativo de entrada — medición de uso y protocolo de caché | 3/3 | Se notificaron 34 tokens; el recuento nativo debería ser 8 |
| Herramientas incluidas en el recuento de entrada — medición de uso y protocolo de caché | 3/3 | La solicitud de control sin herramientas ya difería del recuento nativo de entrada |
| Recuento de entrada coherente antes y después de la caché — medición de uso y protocolo de caché | 3/3 | Al repetir el mismo prefijo, los tokens de entrada notificados no coincidieron con el recuento nativo |
| Entrada coherente con streaming y sin streaming — medición de uso y protocolo de caché | 3/3 | Ambos notificaron 34 tokens; el recuento nativo debería ser 8 |
| Salida de texto exacta — streaming y protocolo de mensajes | 1/3 | Un punto adicional al final del cuerpo; no era exactamente el texto solicitado |
Estas comprobaciones se excluyen del denominador; no cuentan como aprobadas ni como fallidas.
| Estado | Caso | Recuento | Motivo |
|---|---|---|---|
| No observado | Secuencias de parada en streaming | 3 | Esta solicitud no se envió después del paso anterior; no se puede evaluar |
| No aplicable | cache_control explícito | 3 | Registrado de antemano como no compatible con esta interfaz |
Los casos de error de formato de messages y stream_options fallaron en los cinco proveedores: ambos devolvieron 400 con el cuerpo vacío, por lo que los clientes no reciben una explicación estructurada del error. Un fallo compartido por los cinco probablemente se origina en la capa de gateway de AIHubMix y requiere una investigación aparte. La contabilización de tokens de pensamiento también falló en los cinco, pero por distintos motivos: ByteDance y Fireworks notificaron tokens de pensamiento después de desactivar el modo de pensamiento; los otros tres no devolvieron un recuento de tokens de pensamiento.
Comparación con los otros cuatro
P — velocidad de respuesta: 84.37
Cada solicitud incluía unos 10,000 tokens de entrada y pedía unos 1,100 tokens de texto en el cuerpo de la respuesta. En cada una de las tres ventanas, se ejecutaron 30 solicitudes con concurrencia individual y 30 con concurrencia de 10: 180 solicitudes en total.
| Métrica | Resultado |
|---|---|
| Espera hasta el primer token del cuerpo (TTFA) | Mediana de 2.12 s con concurrencia individual; mediana de 2.10 s con concurrencia de 10 |
| Velocidad de generación (TPOT) | 3.43 ms/token con concurrencia individual; 3.41 ms/token con concurrencia de 10 |
| Rendimiento efectivo | 1,250.0 token/s con concurrencia de 10 |
| Solicitudes válidas | 90/90 con concurrencia individual; 90/90 con concurrencia de 10 |
| Puntuaciones de componentes | TTFA 48.59, TPOT 100.00, rendimiento 100.00; para TTFA y TPOT se toma el menor de los dos niveles; ponderaciones: 35% / 35% / 30%; puntuación de respuesta: 82.00 |
| Puntuación P | Puntuación de respuesta 82.00 con una ponderación del 80%, caché K 93.83 con una ponderación del 20%; total: 84.37 |
TPOT se estima a partir de los fragmentos transmitidos, no se mide por token en el hardware. El rendimiento se calcula dividiendo los tokens de salida válidos con concurrencia de 10 entre el tiempo de reloj de la tanda.
Comparación con los otros cuatro
Los cinco compartieron una máquina, una red y una cuenta. Las tres ventanas se programaron proveedor por proveedor, por lo que los períodos de recopilación no se solapan por completo; no conviene dar demasiada importancia a las pequeñas diferencias.
K — caché: 93.83
Cada grupo envía cinco solicitudes. La primera lleva un prefijo fijo de unos 8k o 32k tokens y precalienta la caché. Las solicitudes 2–4 mantienen el prefijo y solo cambian la pregunta final, a los 5 s, 30 s y 120 s. La quinta usa un prefijo nuevo como control en frío. Tres ventanas y dos longitudes, con cinco solicitudes por grupo, suman 30 solicitudes. K es el número de tokens leídos de la caché en las solicitudes en caliente dividido entre los tokens que deberían poder reutilizarse según las reglas, con la misma ponderación para ambas longitudes; K representa el 20% de P.
| Prefijo | Ventana | Precalentamiento | +5 s | +30 s | +120 s | Control en frío |
|---|---|---|---|---|---|---|
| 8k | Ventana 1 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Ventana 2 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | Ventana 3 | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 32k | Ventana 1 | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | Ventana 2 | 0 | 32,000 | 32,000 | falló | 0 |
| 32k | Ventana 3 | 0 | 32,000 | 32,000 | 32,000 | 0 |
Son tokens leídos de la caché, según informa el servidor.
Las nueve solicitudes en caliente de 8k acertaron, y cada una leyó 7,936 tokens. Ocho de las nueve solicitudes en caliente de 32k acertaron, y cada una leyó 32,000 tokens; una solicitud falló. K es 93.83, con ambas longitudes ponderadas por igual. Las solicitudes en frío no leyeron nada de la caché, así que las solicitudes en caliente y en frío se distinguen claramente. La solicitud fallida es la cuarta solicitud del grupo de 32k en la ventana 2, que alcanzó el límite de 300 s sin completarse.
En comparación con los otros cuatro
R — estabilidad del servicio: 100
Las 300 solicitudes se dividen en cuatro tipos —texto corto, entrada larga, llamadas a herramientas e historial de varios turnos— y se ejecutaron con concurrencia individual en tres ventanas. Una solicitud cuenta como exitosa solo si el primer intento devolvió una respuesta válida y completa; no se comprueba la corrección de la respuesta ni se reintenta. Los fallos de las secciones de calidad de respuesta y velocidad se cuentan en Q y P, no de nuevo en R.
| Tipo de solicitud | Éxito al primer intento |
|---|---|
| Texto corto | 120/120 |
| Entrada larga de 10k | 90/90 |
| Llamadas a herramientas | 60/60 |
| Historial de varios turnos | 30/30 |
| Total · intervalo del 95%: 98.78%–100% | 300/300 |
Las 300 solicitudes devolvieron una respuesta válida y completa al primer intento. R = 100 describe únicamente estas 300 solicitudes específicas; no significa que no hubiera fallos en toda la cadena. El límite inferior del intervalo del 95% es 98.78%: 300 éxitos solo permiten afirmar que la tasa de fallos probablemente está por debajo del 1.22%.
En comparación con los otros cuatro
R abarca únicamente estas 300 solicitudes específicas; los fallos de las secciones de calidad de respuesta y velocidad se registran en Q y P y no se vuelven a contar en R.
| Proveedor | Éxito al primer intento | Intervalo del 95% |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek oficial | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
Preguntas frecuentes
¿reasoning_effort=none realmente no logró desactivar el modo de pensamiento?
Sí. En las tres ventanas, las solicitudes con reasoning_effort=none siguieron devolviendo contenido de pensamiento, así que la comprobación falló 3/3 veces. En cambio, las solicitudes de calidad de respuesta, velocidad, caché y estabilidad utilizaron el interruptor nativo thinking.type=disabled. El conjunto de pruebas de funciones mantuvo reasoning_effort=none a propósito para comprobar si el parámetro surtía efecto.
La precisión de BFCL es del 85.20%. ¿Por qué Q es 42.05?
Q agrupa tres conjuntos de pruebas de dificultad muy diferente. BFCL aportó 1,278 respuestas correctas de 1,500; HLE, 382 de 2,490; y AA-LCR, 123 de 250. En conjunto, fueron correctas 1,783 de las 4,240 instancias de preguntas puntuadas: 42.05%. El 15.34% de HLE reduce la cifra agrupada.
¿Se incluyen en la puntuación los 35 fallos de servicio de Q?
Sí. Los fallos de solicitudes y las respuestas truncadas permanecen en el denominador y cuentan como incorrectos. Siete respuestas de HLE se truncaron en max_tokens; 28 solicitudes de AA-LCR fallaron, todas en la ventana 1.
¿Por qué es importante contabilizar los tokens de entrada?
Porque la medición debería coincidir con el recuento nativo del modelo. Se informó que una entrada de 10k tokens tenía 10,026 tokens (10,000 según el recuento nativo), y que una entrada de 8 tokens tenía 34. La solicitud de control sin herramientas ya presentaba discrepancias, y tanto el streaming como la modalidad sin streaming informaron 34. Las cinco comprobaciones de medición fallaron 3/3 veces.
¿El resultado de la caché de 32k fue un fallo de acierto o un fallo de solicitud?
Fue un fallo de solicitud. Ocho de las nueve solicitudes en caliente de 32k acertaron y leyeron 32,000 tokens. El fallo corresponde a la cuarta solicitud de la ventana 2, que alcanzó el límite de 300 s sin completarse. El grupo de 8k acertó en 9/9 solicitudes, con 7,936 tokens.
¿Se puede distinguir la calidad de respuesta de ByteDance de la del canal oficial?
No. La precisión combinada es 0.40 puntos inferior a la del canal oficial, con un intervalo del 95% de −1.46 a +0.66. El intervalo incluye 0, por lo que no se puede distinguir entre ambos. Esto describe únicamente este lote y no es una clasificación.
Sigue leyendo: la serie DeepSeek V4.1 Flash
- La referencia de Q en esta publicación es el canal oficial; su propia ejecución, incluidas las 15 pruebas de concurrencia individual no válidas, se describe en DeepSeek V4.1 Flash en el canal oficial: 94.00 F, 15 pruebas no válidas.
- Baidu es el único proveedor cuyo intervalo de Q queda por debajo del canal oficial; los fallos del canal que explican ese resultado se describen en DeepSeek V4.1 Flash en Baidu: ningún canal disponible alcanza Q y P.
- Las cifras de caché de Alibaba Cloud se sitúan junto al 93.83 informado aquí: DeepSeek V4.1 Flash en Alibaba Cloud: primer token en 1.34s, caché al 99.37.
- Fireworks presenta los mismos fallos de modo de pensamiento y de contabilización de tokens que se observaron aquí, y además devuelve respuestas vacías al detenerse: DeepSeek V4.1 Flash en Fireworks: respuestas vacías al detenerse, 3/9 aciertos de caché.


