

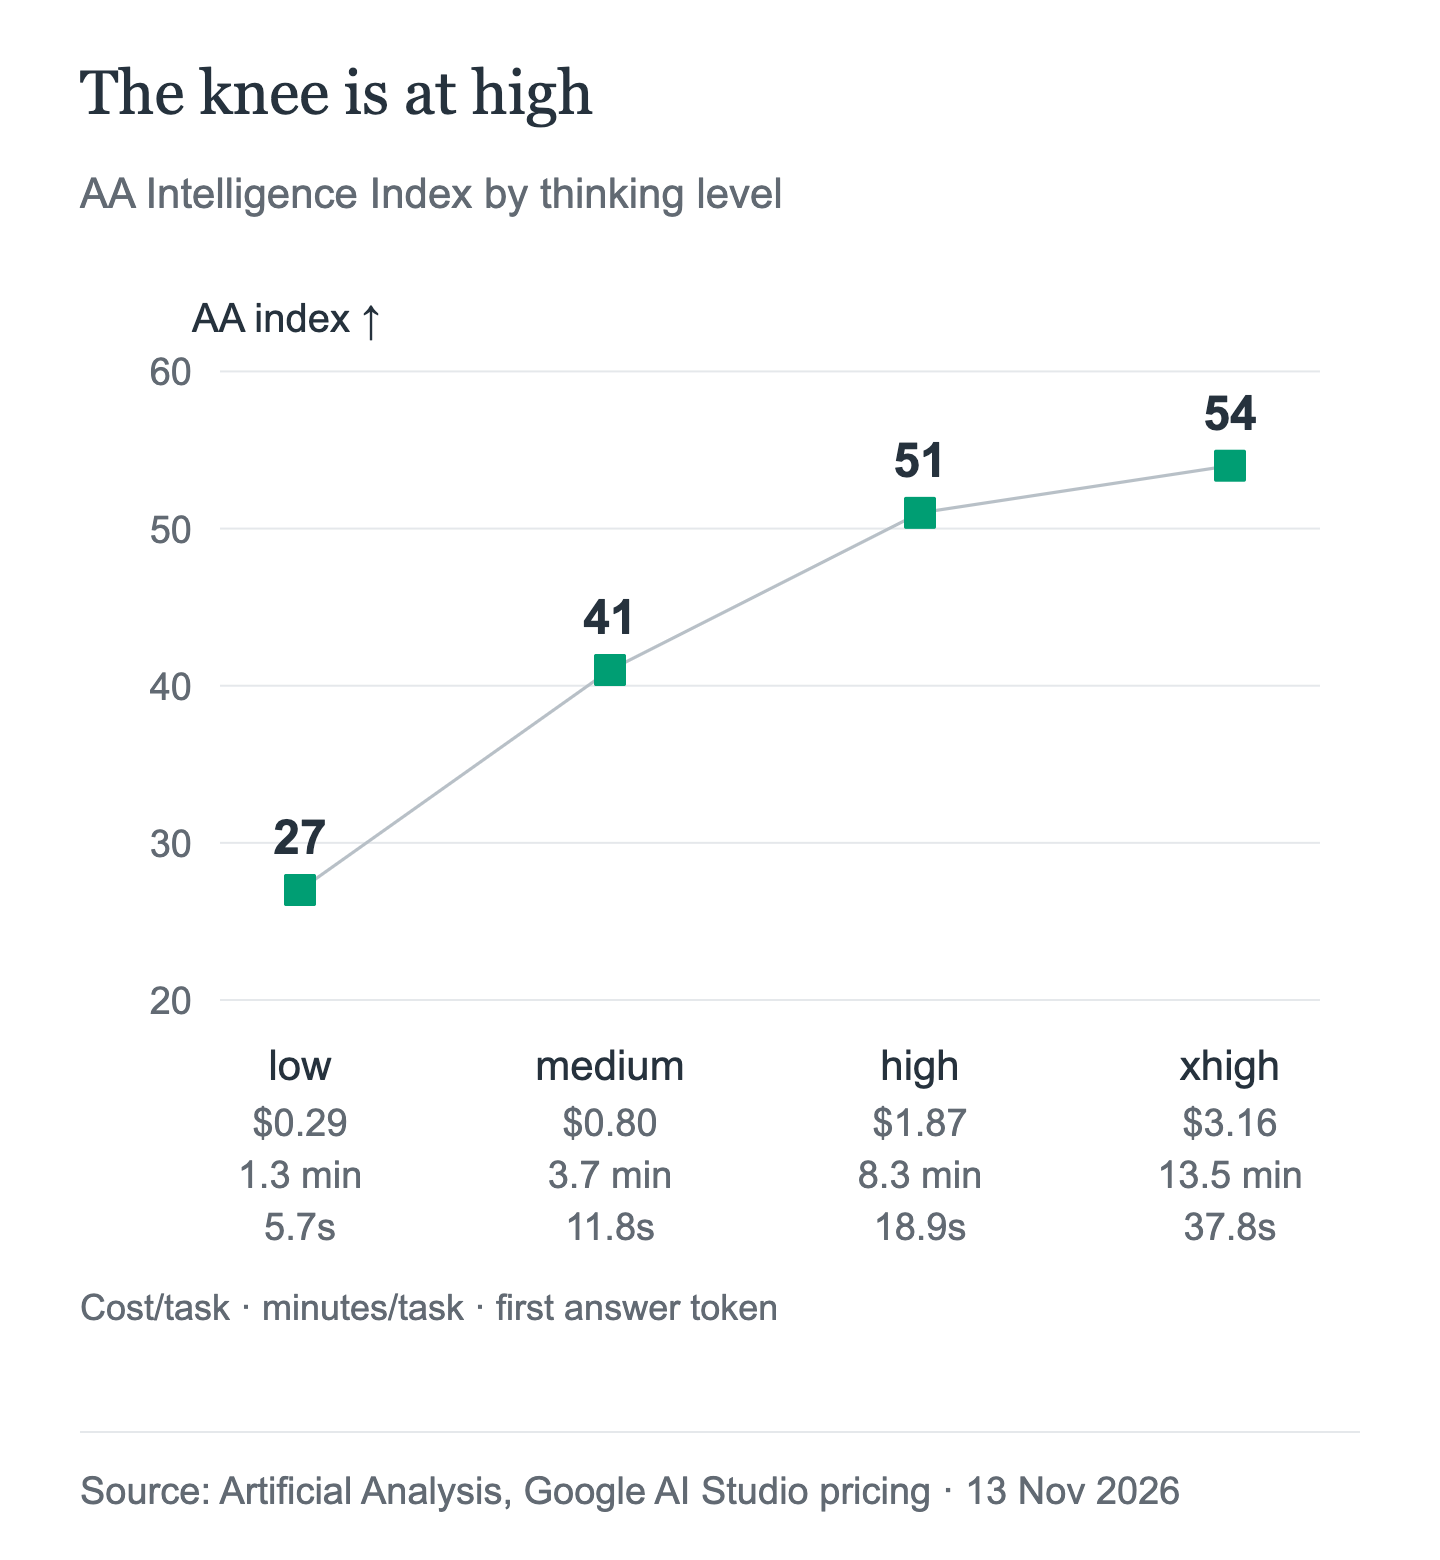
Gemini 4 Hydrogen 有四種思考層級,表現起來就像四個不同的模型。根據Artificial Analysis 的即時測量,同一個模型在low時得分為 27、medium時為 41、high時為 51,而xhigh時為 54。預設值是high;xhigh則是 Gemini 4 系列的新選項:Carbon 和 Argon 的最高層級都是high。
差距相當大:同一個模型從low到xhigh,指數相差 27 點。從medium升到high,每項任務多花約 $1.07,可提升 10 個指數點。從high升到xhigh,多花 $1.29 只提升 3 點,而且等待第一個回答 token 的時間幾乎加倍。實務上,建議從high開始,只在困難的多步驟任務中使用xhigh,並將low和medium視為需要另外檢查品質的低延遲設定。
以下將說明各層級的用途、成本、API 變更,以及 AIHubMix 有哪些資訊尚未說明。
四種層級與變更內容
Gemini 4 Hydrogen支援low、medium、high和xhigh。Google 的版本資訊說得很清楚:「模型預設為high,並新增xhigh。」相較於預設為medium、最高支援至high的Gemini 3.8 Flash,這是兩項變更。
系列中的其他模型則沒有變動。Carbon和 Argon 支援low、medium與high,預設值為medium。Hydrogen 是唯一支援高於high設定的 Gemini 4 模型。
| 模型 | 層級 | 預設值 |
|---|---|---|
| Gemini 4 Hydrogen | low、medium、high、xhigh | high |
| Gemini 4 Carbon | low、medium、high | medium |
| Gemini 4 Argon | low、medium、high | medium |
MINIMAL不屬於支援的層級。Gemini 4 思考模式文件指出,Gemini 4 模型「不支援 MINIMAL」,而 Google 的 Hydrogen 版本資訊則說,模型「遇到minimal會回傳錯誤」。此模型沒有文件記載的思考模式關閉選項。
Google 的建議
Google 的建議可作為合理的初步參考,但發布時間早於以下的測量結果。尤其是medium適用於互動式程式設計的建議,預設了 Artificial Analysis 在medium層級實際測不到的品質水準。
| 層級 | Google 的描述與建議用途 |
|---|---|
| low | 「token 用量最少、延遲最低」——快速聊天、高用量情境 |
| medium | 「token 用量較低、回應更快」——互動式程式設計、UI 原型 |
| high | 「智慧程度與速度兼具」——大多數任務的預設值 |
| xhigh | 「token 用量最多、推理最深入」——困難的多步驟程式設計 |
這份表格有兩點需要注意。Google 表示:「使用xhigh會增加延遲和 token 用量,簡單的提示詞也可能因此想得太多。」此外,評估建議也很明確:「請在四種層級下進行評估,並將max_output_tokens設得足夠高。」
實測結果一覽
Artificial Analysis 測量了全部四種層級。測試採用 Intelligence Index v5.0.1,涵蓋 78 個排名模型,資料擷取時間為 2026-11-13T02:40Z,價格採用標準牌價。這些是 AA 的任務成本,不是 AIHubMix 的帳單金額。
| 層級 | AA 排名 | AA 指數 | $/任務 | 分鐘/任務 | 第一個回答 token |
|---|---|---|---|---|---|
| low | 60 | 27 | 0.29 | 1.3 | 5.71 s |
| medium | 39 | 41 | 0.80 | 3.7 | 11.80 s |
| high | 21 | 51 | 1.87 | 8.3 | 18.89 s |
| xhigh | 16 | 54 | 3.16 | 13.5 | 37.77 s |
各層級之間的差距才是重點:
low升至medium:指數增加 14 點,每項任務多花 $0.51,多耗時 2.4 分鐘,第一個 token 多等 6.1 秒。medium升至high:指數增加 10 點,每項任務多花 $1.07,多耗時 4.6 分鐘,第一個 token 多等 7.1 秒。high升至xhigh:指數增加 3 點,每項任務多花 $1.29,多耗時 5.2 分鐘,第一個 token 多等 18.9 秒。
high是效益轉折點。這是最後一個品質提升幅度相對於額外費用仍然很大的層級;升到xhigh時,指數只小幅增加,等待第一個 token 的時間卻幾乎加倍。但這不代表xhigh不好用,而是應該留給high無法勝任的任務,這也正是 Google 對它的描述。
作為參考,同一份快照中,Carbon high 得分為 60,每項任務 $5.48、耗時 28.1 分鐘;Carbon medium 得分為 58,每項任務 $4.68;Carbon low 得分為 54,每項任務 $5.22;Argon high 得分為 50,每項任務 $4.97、耗時 30.6 分鐘。Hydrogen 的xhigh得分 54,與 Carbon low 相同,每項任務成本低 39.5%($3.16,相較於 $5.22),但第一個 token 需要等 37.77 秒,相較之下 Carbon low 為 13.61 秒。Hydrogen 的high比 Argon high 多 1 個指數點,每項任務成本則低 62.4%。
效益曲線的落差
low並非只是稍微降級。得分 27,比high低 24 個指數點。若工作負載從high降到low,每項任務省下 $1.58,買到的並非思考較少、但其他方面相同的產品,而是能力弱得多的模型。分類、路由或簡短擷取任務或許適合使用;但程式設計或 Agent 任務若未針對任務本身進行評估,就不適合採用。
medium is a latency setting, not a quality setting. It scores 41, 10 points below high, for $0.80 against $1.87. The saving is real — 57% per task — but the quality gap is larger than the price gap suggests. Google recommends medium for interactive coding; the AA number says to test that recommendation on your own tasks before adopting it.
xhigh可能會想得太多。Google 對此有明確警告。AA 的成本與時間數據也反映出這點:每項任務 $3.16,耗時 13.5 分鐘,等待第一個 token 則需 37.77 秒。對簡單的提示詞來說,為了小幅提升而付出這麼多延遲,並不划算。但如果是high無法勝任的困難多步驟程式設計任務,這就是唯一能再往上提升的層級。
輸出冗長程度也會影響費用。Artificial Analysis 將 Hydrogen 描述為「非常冗長」:完成指數測試時,xhigh執行產生了 304 million 個輸出 token,在 77 個模型中排名第 76;中位數則為 72.8 million。輸出 token 包含思考 token,而輸出費用為每百萬個 $7.50。更高的層級不只代表思考時間更長,也會產生更多需計費的 token。
費用:思考如何轉化為 token
價格表很簡單。Hydrogen 的費用為每百萬個輸入 token $1.50、每百萬個輸出 token $7.50,以及每百萬個快取輸入 token $0.075。輸出 token 包含思考 token。因此,層級比單價更重要:模型是按寫出的推理內容計費,而不是按層級名稱計費。
有三項計費規則很容易被忽略。
預設值變了。Gemini 3.8 Flash 的預設值是medium;Hydrogen 的預設值則是high。遷移後,即使每個 token 的單價相同,從未設定層級的工作負載,每一輪也會消耗更多輸出 token。這是以模型更換之名包裝的預算變更。
只有隱式快取。Hydrogen 支援隱式快取,最低門檻為 4,096 個 token,快取命中可享 95% 折扣;不支援明確快取。Google 的企業版頁面也指出:「快取寫入預設按標準輸入 token 價格的 1.25 倍計費。」這是 Google 的計費說明;AIHubMix 尚未說明此模型的快取計費方式。
長輸出有單次處理上限。無論是否使用串流,同步請求每次處理最多會產生 65,536 個 token。要產生更長的輸出,必須使用背景執行或延續 token;而max_output_tokens會同時限制思考內容與輸出。如果設定background=true卻未設定max_output_tokens,伺服器會在 65,536 個 token 後停止。Google 建議長解碼預算設為 131,072 或 262,144;上限為 1,048,576 減去輸入 token 數。
API 的行為與拒絕的設定
參數名稱是thinking_level(蛇形命名法)。Google 的 Python 範例會在thinking_config中設定此參數;Node 範例則將它放在thinkingConfig(駝峰命名法)下。模型頁面列出的值為LOW、MEDIUM、HIGH和XHIGH;版本資訊則以小寫拼寫。請使用 SDK 的列舉值或文件記載的字串,不要自行輸入大小寫不同的變體。
以下三種請求格式會失敗:
- 在任何 Gemini 4 模型上使用
thinking_budget都會回傳400: INVALID_ARGUMENT。同時設定thinking_level和thinking_budget也會回傳錯誤。 thinking_level="MINIMAL"不受支援;Hydrogen 會拒絕此設定。- 自訂的
temperature、top_p和top_k都會被忽略。固定預設值為 temperature 1.0、topP 0.95 和 topK 64。
在 Google 平台上,Hydrogen 也支援函式呼叫、程式碼執行、URL 上下文和電腦操作。在 Interactions API 中,多輪對話和工具呼叫工作階段請使用previous_interaction_id。
AIHubMix 有哪些文件說明,哪些沒有
AIHubMix 文件記載的 Hydrogen 路由為POST https://aihubmix.com/v1/chat/completions,並使用model="gemini-4-hydrogen"。模型頁面列出文字、圖片、音訊、影片和 PDF 輸入,以及文字輸出;llms.txt仍保留較舊的純文字說明,因此請以較新的模型頁面為準。工具使用、結構化輸出和推理等功能旗標「尚未公布」。此模型未列入 2026-11-11 產生的模型索引,也沒有公布通訊協定結構描述。
這點與本文相關,因為 AIHubMix 並未說明如何為任何 Gemini 4 模型設定思考層級。其Gemini 指南介紹的是 Gemini 2.5 時代模型的reasoning_effort,並未說明 Gemini 4 的thinking_level或xhigh。不要假設這兩個參數能透過閘道傳遞,也不要假設在 Google API 上觀察到的預設值,就是你在 AIHubMix 上會得到的預設值。
最安全的請求格式,就是 AIHubMix 文件記載的格式:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "List the failure modes in this retry design."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
如果必須能控制層級,請直接呼叫 Google API,或先用一個小型請求確認閘道的實際行為,再將正式流量導入。決定期間,AIHubMix 比較頁面可用來參考成本。本文未進行即時測試。
依工作負載選擇起點
| 工作負載 | 建議起點與原因 |
|---|---|
| 快速聊天、路由、分類 | medium,並測試 low;low 的分數是 27 |
| 互動式程式設計、UI 原型製作 | high;AA 的 medium 分數是 41 |
| Agent 執行、工具迴圈 | high;只有卡住時才用 xhigh |
| 困難的除錯、架構設計、規劃 | xhigh 或 Carbon;多 3 分,但成本高 69% |
| 評估後的大量批次處理 | low 或 medium;成本最低,但指數分數為 27/41 |
| 嚴格要求 15 秒內的延遲預算 | medium 或 low;high 需要等待 18.89 秒 |
這些只是建議起點,不是路由規則。合適的等級是能通過你自行評估的最低等級,而 Google 的建議是,四個等級都要進行這項評估。
常見問題
Gemini 4 Hydrogen 有哪些思考等級?
共有四種:low、medium、high 和 xhigh。預設值為 high。
相較於 Gemini 3.8 Flash 有哪些變更?
預設值從 medium 改為 high,並新增了高於 high 的 xhigh。Carbon 和 Argon 的預設值仍為 medium,最高則是 high。
xhigh 值得使用嗎?
對於 high 無法完成的困難多步驟任務,值得:它可提升 3 個指數分數。不過,每項任務的成本比 high 高 69%,首 token 的等待時間也幾乎加倍,因此不適合作為簡單提示詞的預設選項。
Why is low so far behind?
Artificial Analysis measures it at 27 on the index, 24 points below high. The price is $0.29 per task against $1.87, but the quality gap is much larger than the price gap. Use it only where a task-specific evaluation says it is enough.
AIHubMix 支援 thinking_level 或 xhigh 嗎?
文件中沒有相關資訊。AIHubMix 未公開 Hydrogen 的推理能力旗標,也沒有 Gemini 4 思考等級指南。依賴這兩項功能前,請先確認。
如果我傳送 thinking_budget,會發生什麼事?
Gemini 4 會傳回 400: INVALID_ARGUMENT。同時設定 thinking_budget 和 thinking_level 也會傳回錯誤。
可以關閉思考模式嗎?
目前沒有文件記載可關閉思考模式的方法。Gemini 4 不支援 MINIMAL,而 Hydrogen 會拒絕此設定並傳回錯誤。
繼續閱讀:Gemini 4 Hydrogen 系列文章
- 如果你還在考慮 Hydrogen 是否值得取代 Gemini 3.8 Flash,第一篇文章介紹了發布資訊、價格變動及基準測試的取捨:Gemini 4 Hydrogen 與 Gemini 3.8 Flash:值得升級嗎?。
- 如果你想了解 Hydrogen 與 Carbon、Argon 執行相同工作時的表現,第三篇文章將三者並列比較價格、延遲,並提供工作負載表格:Gemini 4 Carbon、Hydrogen 與 Argon:不同工作該選哪個模型?。
資料來源
- Google AI Studio,Gemini 4 Hydrogen:新功能介紹
- Google,Gemini 4 思考模式
- Google,Gemini 4 Hydrogen 模型頁面
- Google AI Studio,Gemini API 定價
- Artificial Analysis,Gemini 4 Hydrogen — 即時快照 2026-11-13T02:40Z,Intelligence Index v5.0.1


