Gemini 4 Carbon 在請求結構層級可直接替代 Gemini 4 Argon。相同的 Chat Completions 請求本文可以使用:只需更改模型 ID,部分參數值則不會保留下來。真正重要的錯誤發生在下一層——參數錯誤會回傳 400、輸出限制會無聲截斷內容,以及為長時間思考設計的逾時與計費模式。
第一週的成敗取決於四個預設值:
- 在 AIHubMix 上,將
max_tokens維持在 65,536 以下或等於此值;閘道僅記載 Chat Completions,沒有公布更大的輸出途徑。 - 使用 Google 原生 Interactions/背景執行時,設定
store=true,並明確指定max_output_tokens;AIHubMix 沒有記載 Carbon 支援這些欄位。 - 使用供應商原生長解碼途徑時,將 HTTP 讀取逾時提高至每個串流 15–20 分鐘。
- 移除會被忽略的
temperature、top_p和top_k,以及懲罰參數;在 Google 的 Carbon 指南中,candidate_count大於 1 也會回傳 400。
存取、安全拒絕回應、每項工作的成本等不變的基本資訊,請參閱Argon 遷移文章。本文介紹 Carbon 特有的行為。
哪些會明確失敗,哪些會悄悄失敗
失敗可清楚分成兩類:400 錯誤會立即告訴你,無聲的上限則會在帳單上才顯現。
| 你看到的狀況 | 類型 | 第一步 |
|---|---|---|
| 參數發生 HTTP 400 | 明確 | 移除不支援的欄位 |
| 背景請求發生 400 | 明確 | 新增 store=true |
| 回答在 65,536 tokens 處停止 | 無聲 | 提高 max_tokens,上限為 65,536 |
| 文字為空,狀態為 incomplete | 無聲 | 提高上限後重試 |
| 背景執行在接近 64K 時結束 | 無聲 | 設定 max_output_tokens |
| 回答看起來較淺 | 無聲 | 明確設定思考強度 |
| 帳單高於預估 | 無聲 | 計入思考與解碼跳次 |
AIHubMix 以 Chat Completions 提供gemini-4-carbon,價格為每百萬 tokens 輸入 $2、輸出 $10、快取 $0.10——這是 Google 的入門價格。價格為暫時性方案;請參閱計費資訊。
明確失敗:文件記載的 400 錯誤
許多文件記載的 400 錯誤源於參數驗證;歷史紀錄與預先填入的模型回合則屬於請求狀態錯誤。除非另有說明,以下規則均出自 Google 原生 Carbon 指南;AIHubMix 目前只記載 Carbon 支援 Chat Completions。AIHubMix 的 Carbon 頁面以一句話描述這類錯誤:「400 — 參數錯誤;大多數是由上游供應商傳回。」這是對閘道的描述,不是測試結果。詳細資訊請參閱 Google 的Carbon 指南與新功能頁面。
| 觸發條件 | 你看到的狀況 | 修正方式 |
|---|---|---|
| max_output_tokens > 1M* | 400;超出上限 | 原生 ≤1M;閘道 ≤65K* |
| frequency/presence penalty | 400;不支援 | 移除欄位 |
| candidate_count > 1 | 400;多候選輸出 | 省略或設為 1 |
| 背景執行未設定 store* | 400;必須設定 store* | 新增 store=true |
| 歷史紀錄以 model 結尾 | 遭拒;不支援 | 以 user 回合結尾 |
| 兩項控制欄位 | 400;無法併用 | 只傳送一項 |
| thinking_budget 或 MINIMAL | 400;Carbon 指南 | 使用 low/medium/high |
Google 顯示的錯誤訊息原文為:「store=true is required for background interactions.」* 僅適用 Google 原生服務:max_output_tokens 上限為 1M,背景執行必須設定 store=true;AIHubMix 尚未記載此途徑。使用其 Chat Completions 途徑時,請維持在 ≤65K。
minimal 這一列有兩種含義。在 Google 原生 Carbon 欄位中,thinking_budget 和 thinking_level=MINIMAL 會回傳 HTTP 400;請改用 low、medium 或 high。在 Google 的 OpenAI 相容層中,reasoning_effort=minimal 會對應到 low;AIHubMix 尚未公布是否會將這項對應套用至 Carbon。
工具處理是另一個相關陷阱。Google 的 Carbon 指南建議優先採用依序執行工具的回合,而AIHubMix 的 Gemini 指南記載了 tool_choice="auto";閘道是否支援 Carbon 專用工具功能仍未確認。
在 /v1/chat/completions 上,最精簡的安全請求會移除 Carbon 忽略的項目:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Reply with OK."}],
    max_tokens=32768,  # room for thinking plus answer
)
print(response.choices[0].message.content)
若收到 200,傳輸層就沒有問題。接下來要處理的是不會回報錯誤的回答。
無聲失敗:沒有錯誤、輸出錯誤、帳單也錯
標準輸出上限為 65,536;供應商長解碼是另一回事
Carbon 的標準輸出上限為 65,536 tokens。在 Chat Completions 中,上限欄位是 max_tokens;Google 原生指南則稱之為 max_output_tokens。Google 原生長解碼途徑最多可達 1,048,576 tokens 減去輸入量;131,072 與 262,144 是兩個範例。Google 的新功能頁面說明了這項規則:「若設定 background: true 卻未指定 max_output_tokens,伺服器會在 64K tokens 後停止。」AIHubMix 尚未記載 Carbon 的背景執行或延續功能。
供應商原生長解碼會分段執行:使用背景執行或串流時,每次跳次 64K;非串流時,每次跳次 32K;單一非串流 REST 請求會在 32,768 處停止。Google 指南指出:「較早版本的 SDK 與 OpenAI 相容層無法使用延續 token 取回長篇完成結果。」對 AIHubMix 而言,請將 max_tokens 維持在 65,536 以下或等於此值,視為保守但尚未驗證的閘道上限;在模型頁面記載此功能之前,請勿規劃串接更長的回答。
上限太低會截斷思考,而且空白輸出仍會計費
上限涵蓋思考,不只是文字。Google 的長解碼指南指出:「像 8,192 這麼低的值,會在模型完成思考前就停止生成。」狀態會變成 incomplete,而且「如果模型仍在思考,文字可能會是空白。」無論如何都會收費。請將思考與回答所需的 tokens 一併納入預算,並將空白的 incomplete 回應視為上限問題:提高上限、重試,並預期第一次嘗試仍會列入帳單。
思考預設值為 medium
Carbon 的預設值為 medium,與 Argon 相同。從預設為 high 的 Gemini 3.1 Pro Preview 遷移過來的團隊,不改程式碼就會少一級,可能把較淺的回答誤認為效能退步。Google 建議大多數程式編寫與 Agent 工作使用 medium。請在測試環境明確設定強度,並且只傳送一個控制欄位:reasoning_effort 和 thinking_level 不能併用。
取樣參數會被忽略
temperature、top_p 和 top_k 都會被忽略——不會報錯,取樣結果也不會改變。請移除這些參數。懲罰參數以及大於 1 的 candidate_count 值會回傳 400。
無法再使用明確快取
cachedContents 和 caches.create 均不支援。輸入達 4,096 tokens 以上時會套用隱式快取,並享有 95% 折扣。請刪除明確快取的程式碼,將穩定的提示詞前綴放在最前面,並在計算折扣前確認快取 token 的用量。
對話狀態有一項規則
Google 建議使用 previous_interaction_id 延續對話。Chat Completions 沒有這個欄位,因此請保留歷史紀錄,但以 user 回合結尾;以 model 角色結尾或預先填入 model 回合都不支援。
逾時:15 到 20 分鐘,不是 60 秒
Google 的長解碼指南建議每個串流的 HTTP 讀取逾時設為 15 到 20 分鐘;其遷移檢查清單也再次要求至少 15 分鐘。這項建議適用於長解碼請求。另一份 AA 測量則呈現等候第一個回答 token 的時間:Carbon High 為 67.1 秒、Medium 為 23.2 秒、Low 為 12.9 秒,而 Argon High 為 40.1 秒。若設為 60 秒就切斷,第一個 token 還來得及抵達嗎?
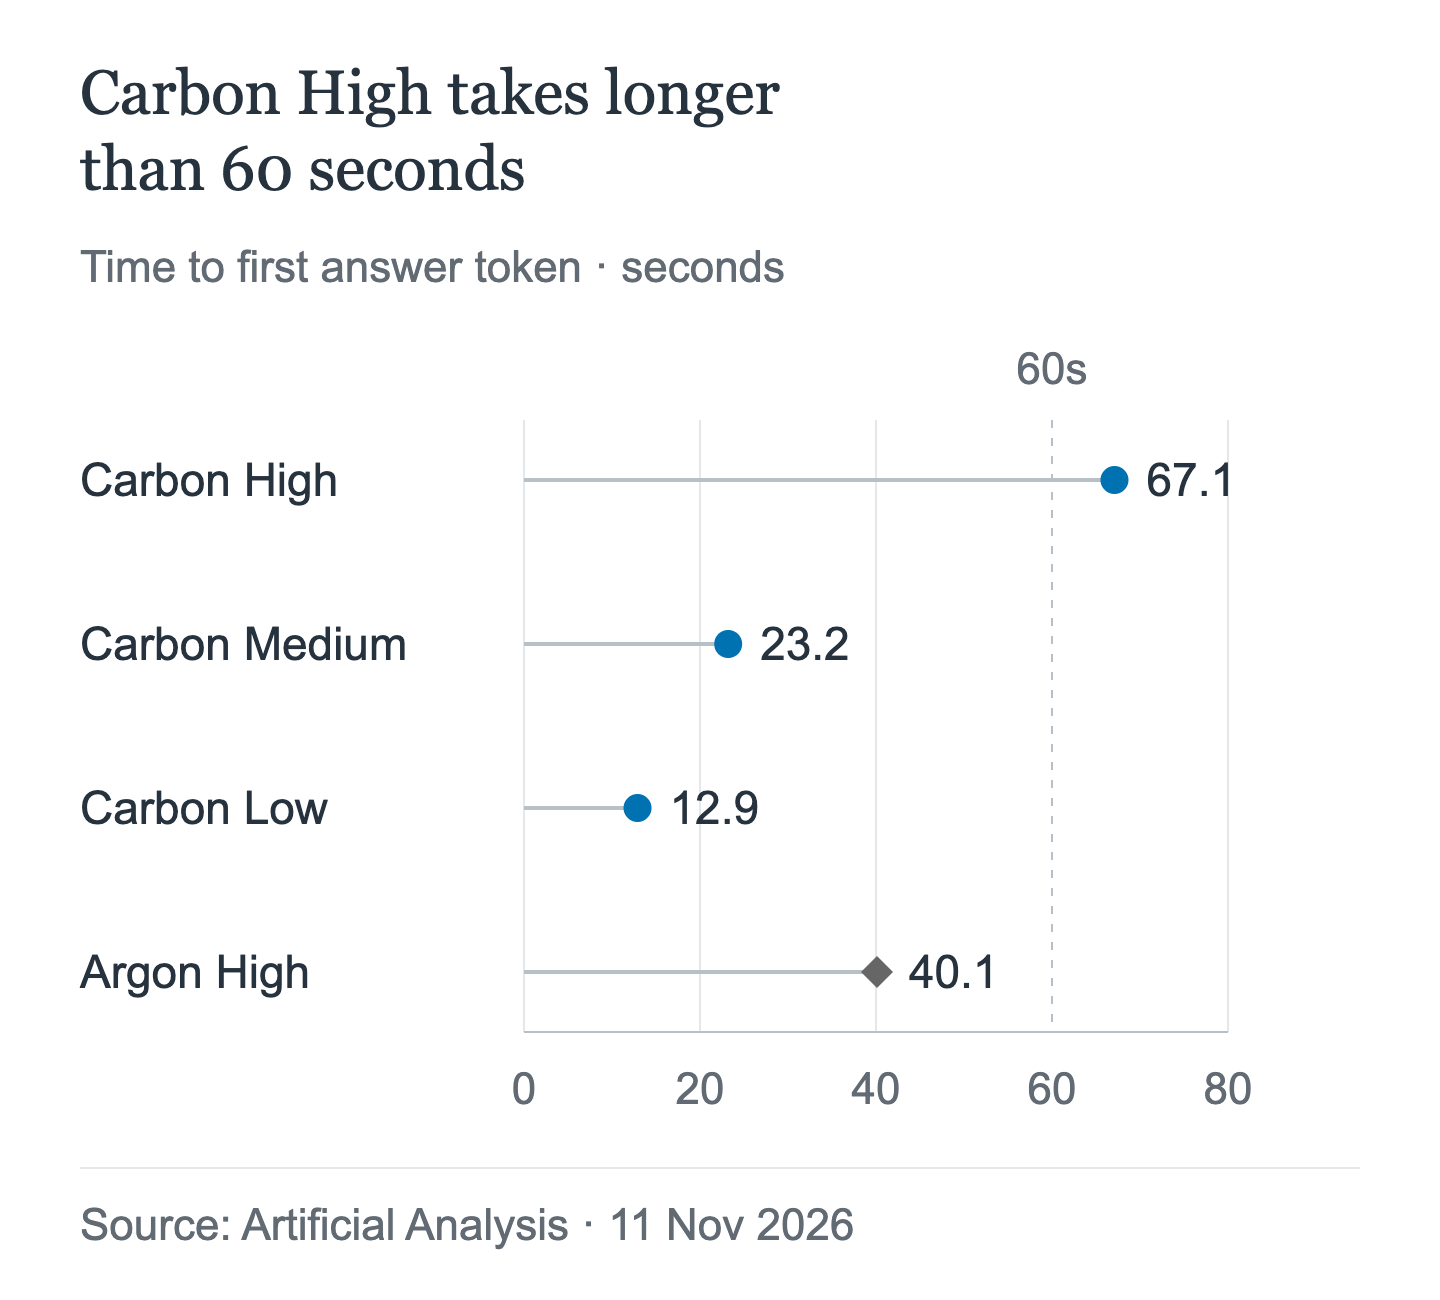
在這項測量中,Carbon High 超過了 60 秒的參考值。第一個 token 的時間無法據此判定整個請求的安全逾時值:上文建議的 15–20 分鐘來自 Google 的長解碼指南。這些只是單次測量結果,不代表延遲保證,也不是 AIHubMix 的測試結果。
Google 原生用戶端的跳次時間限制比背景執行更短:串流為 20 分鐘,非串流呼叫為 10 分鐘,背景執行則為 24 小時。AIHubMix 未記載這些背景執行限制。
長解碼所需的原生 SDK 最低版本:Python 2.34.0、JS 2.32.0、Go 1.77.0、Java 1.80.0、.NET 1.28.0。Claude Code 的 API_TIMEOUT_MS 預設為 10 分鐘;如果日後確認 Claude Code 可用於 Carbon,請在首次執行前調高此值。
計費陷阱
Carbon 的每 token 價格很簡單,帳單卻不然。有幾種機制會推高帳單,還有一項排定的價格變更會讓所有費率翻倍。
思考會按輸出計費
思考 token 會按輸出計費。Carbon 目前的輸出費率為每百萬 tokens $10,12 月 1 日起則為 $20。
每次長解碼跳次都會計費
Google 提供的計算範例:1,000-token 提示詞產生 200,000 個輸出 tokens,跨跳次的 total_input_tokens 為 397,216,各跳次分別為 1,000、66,536、132,072 和 197,608。「每個跳次中的每個 token 都要付費,包括只包含思考的跳次。」隱式快取可讓大部分輸入享有 95% 折扣,但跳次仍會計入用量。執行失敗或取消時,已完成的工作也會計費:「即使後續跳次失敗或遭取消,每個已完成的區段仍會在該區段結束時計費」,而且「互動結束前已完成的所有工作都要付費。」
聯網搜尋有獨立計量方式
在 Google 原生服務上,使用 Google Search 進行 grounding,每月包含 5,000 次免費請求,由 Gemini 3 與更新版本共用;超出後每 1,000 次收費 $14,每日上限為 1,500 次。AIHubMix 尚未記載 Carbon 支援 grounding。
Vertex 的註記僅適用供應商服務
Google 的 Vertex 定價頁面另有一項規則:超過 32K tokens 的完成結果,即使請求因用戶端或伺服器逾時而失敗,仍會按可取回的 token 用量收費,於 2026 年 11 月 13 日生效。這是供應商規則;VertexAI 供應商是否會在 AIHubMix 上套用此規則,目前尚未公布。請先詢問,不要自行假設。
12 月 1 日起所有費率翻倍
| 費率 | 截至 11 月 30 日 | 自 12 月 1 日起 |
|---|---|---|
| 輸入 | 每 1M $2 | 每 1M $4 |
| 輸出 | 每 1M $10 | 每 1M $20 |
| 快取讀取 | 每 1M $0.10 | 每 1M $0.20 |
Carbon 和 Argon 共用入門價格;所有費率都會在 12 月 1 日翻倍。AIHubMix 目前列出的是入門價格,尚未公布 12 月之後的價格。請將費率翻倍視為確定事項,閘道價格則視為未知;在確定預算前,兩者都要再次確認。
具備實際權限的 Agent
對於 Google 原生呼叫,Carbon 指南建議優先採用循序工具執行回合。使用這種方式時,一次建立一個呼叫。AIHubMix 的 Gemini 指南有說明 tool_choice="auto",但 Carbon 在閘道上的專屬工具支援與強制工具行為尚未確認。
對話歷史不能以模型回合結尾,也不支援預先填入的模型回合。如果缺少工具結果,請傳送一個使用者回合,詢問下一步該怎麼做。
模型卡指出,偶爾會出現速度緩慢或逾時的情況,而且較高等級會使用更多 token;知識截止日期為 2026 年 3 月。若有寫入權限,逾時才是真正的風險:執行時間超過用戶端限制時,可能留下部分未完成的工作,而已完成的部分仍會計費。
程式碼工具:設定任何項目之前,先查看模型頁面
AIHubMix 的 Carbon 頁面只記載 Chat Completions,而且 Carbon 目前尚未列入公開模型索引。Claude Code 需要 Anthropic Messages;Codex 需要 Responses。兩者是否適用於 AIHubMix 上的 Carbon 都尚未確認。不要假設其中任何一種可用:請開啟上方連結的 Carbon 模型頁面,查看協定清單。如果只列出 Chat Completions,請使用相容 OpenAI 的用戶端,或等待支援。
請求格式與 Argon 相同,但協定可用性不同:目前 AIHubMix 僅記載 Carbon 支援 Chat Completions。Claude Code 文章說明了 ANTHROPIC_BASE_URL、ANTHROPIC_AUTH_TOKEN 和 API_TIMEOUT_MS;Codex 文章則說明了供應商區塊、wire_api 和 model_reasoning_effort。差別在於該協定是否存在。
| 用戶端 | 所需協定 | AIHubMix 上的 Carbon |
|---|---|---|
| Claude Code | Anthropic Messages | 未記載 |
| Codex | Responses API | 未記載 |
| OpenAI SDK | Chat Completions | 已記載 |
設定:
- 模型 ID:
gemini-4-carbon。 - 思考模式:low、medium、high;預設為 medium。
- 推理強度對應:原生欄位
thinking_level、相容欄位reasoning_effort;Google 會對應推理強度值,但 AIHubMix 尚未公布 Carbon 的對應方式。請送出一個值。 - 上下文:Google 標示為 1,048,576;AIHubMix 尚未公布 Carbon 的限制,因此不要以供應商標示的數值作為建置依據。
- 已知問題:high 等級的首 token 速度較慢;供應商建議使用循序工具回合;AIHubMix 尚未驗證的保守上限為 65,536 個輸出 token;知識截止日期為 2026 年 3 月。
冒煙測試,10–15 分鐘:
- 選擇一個小型程式碼儲存庫,其中有一個未通過的單元測試,且測試指令可在一分鐘內完成。
- 將模型設為
gemini-4-carbon,將max_tokens設為 65,536 或更低,並將 HTTP 逾時設為至少 15 分鐘。 - 要求工具做出能讓測試通過的最小修改,接著執行測試指令並檢查差異。
- 通過:修改幅度小,且測試在 10–15 分鐘內通過。失敗:記錄回應屬於 400 錯誤、答案不完整、逾時或修改不當;這些情況各有不同的解法,請參考上文。
- 如果工具可讓你選擇等級,請測試 medium 和 high,並保留能在時間限制內完成的等級。
首次發出正式環境請求前的檢查清單
- 模型 ID 設為
gemini-4-carbon。 - 不使用
temperature、top_p或top_k。 - 不使用
frequency_penalty或presence_penalty;將candidate_count設為 1,或省略此參數。 max_tokens設為 65,536 或更低。- Google 原生背景請求需傳送
store=true,並明確設定max_output_tokens;AIHubMix 尚未記載此路徑。 - HTTP 逾時設為 15 分鐘或更長;建議使用串流。
- 只使用
reasoning_effort和thinking_level其中之一。 - 使用 Google 原生介面時,優先採用循序工具回合;AIHubMix 有記載
tool_choice="auto",但尚未確認是否支援 Carbon。 - 不要明確呼叫快取;先放入穩定的提示詞前綴。
- 預算須納入思考 token,以及每一段長解碼的成本。
- 請與預算負責人確認 12 月 1 日的價格。
- 設定前先確認程式碼工具是否列於模型頁面。
常見問題
從 Argon 遷移至 Carbon 時,需要變更請求本文嗎?
不需要。結構描述沒有變更。請更改模型 ID、檢查參數值,並移除現在會回傳 400 錯誤的欄位。
為什麼 max_output_tokens 會回傳 400 錯誤?
Google 的原生 Carbon API 會拒絕高於 1,048,576 的值。AIHubMix 的 Chat Completions 路徑另有較保守的建議:在有文件說明更高上限的路徑之前,請將 max_tokens 維持在 65,536 以下或等於此值。值太低會導致思考過程遭到截斷,反而更糟:答案可能不完整,而且仍會計費。
為什麼回應是空的?
如果狀態顯示未完成,可能是因為模型仍在思考,所以文字內容為空。這段處理仍會計費。請提高上限後重試。
為什麼背景請求會在 64K 停止?
使用 Google 原生背景路徑時,若未設定 max_output_tokens,伺服器會在 64K 停止。請明確設定上限;原生長解碼最高可達 1,048,576 減去輸入 token 數。AIHubMix 尚未記載背景模式。
temperature 會生效嗎?
不會。temperature、top_p 和 top_k 都會遭到忽略。使用懲罰參數或將 candidate_count 設為大於 1,則會回傳 400 錯誤。
12 月 1 日起,Carbon 的費用會變成兩倍嗎?
Google 的價格會翻倍:輸入從 $2 漲至 $4、輸出從 $10 漲至 $20、快取讀取從 $0.10 漲至 $0.20。AIHubMix 尚未公布 12 月之後的價格,因此在編列預算前請先確認。
可以搭配 Carbon 使用 Claude Code 或 Codex 嗎?
尚未確認。AIHubMix 有記載 Carbon 支援 Chat Completions;Claude Code 需要 Anthropic Messages,而 Codex 需要 Responses。請先查看模型頁面。
繼續閱讀:Gemini 4 Carbon 系列
- 如果遷移已經開始進行,而你想確認 Carbon 是否值得這個價格,這篇比較文章整理了兩者相同的入門價格。
Gemini 4 Carbon 與 Argon 比較:價格相同,何時值得選 Carbon? - 如果你要選的是程式設計 Agent,而不是遷移端點,這篇正面比較涵蓋工具使用和每項任務的成本。
Gemini 4 Carbon 與 Fable 5.2 比較:哪個更適合 Agentic Coding?