

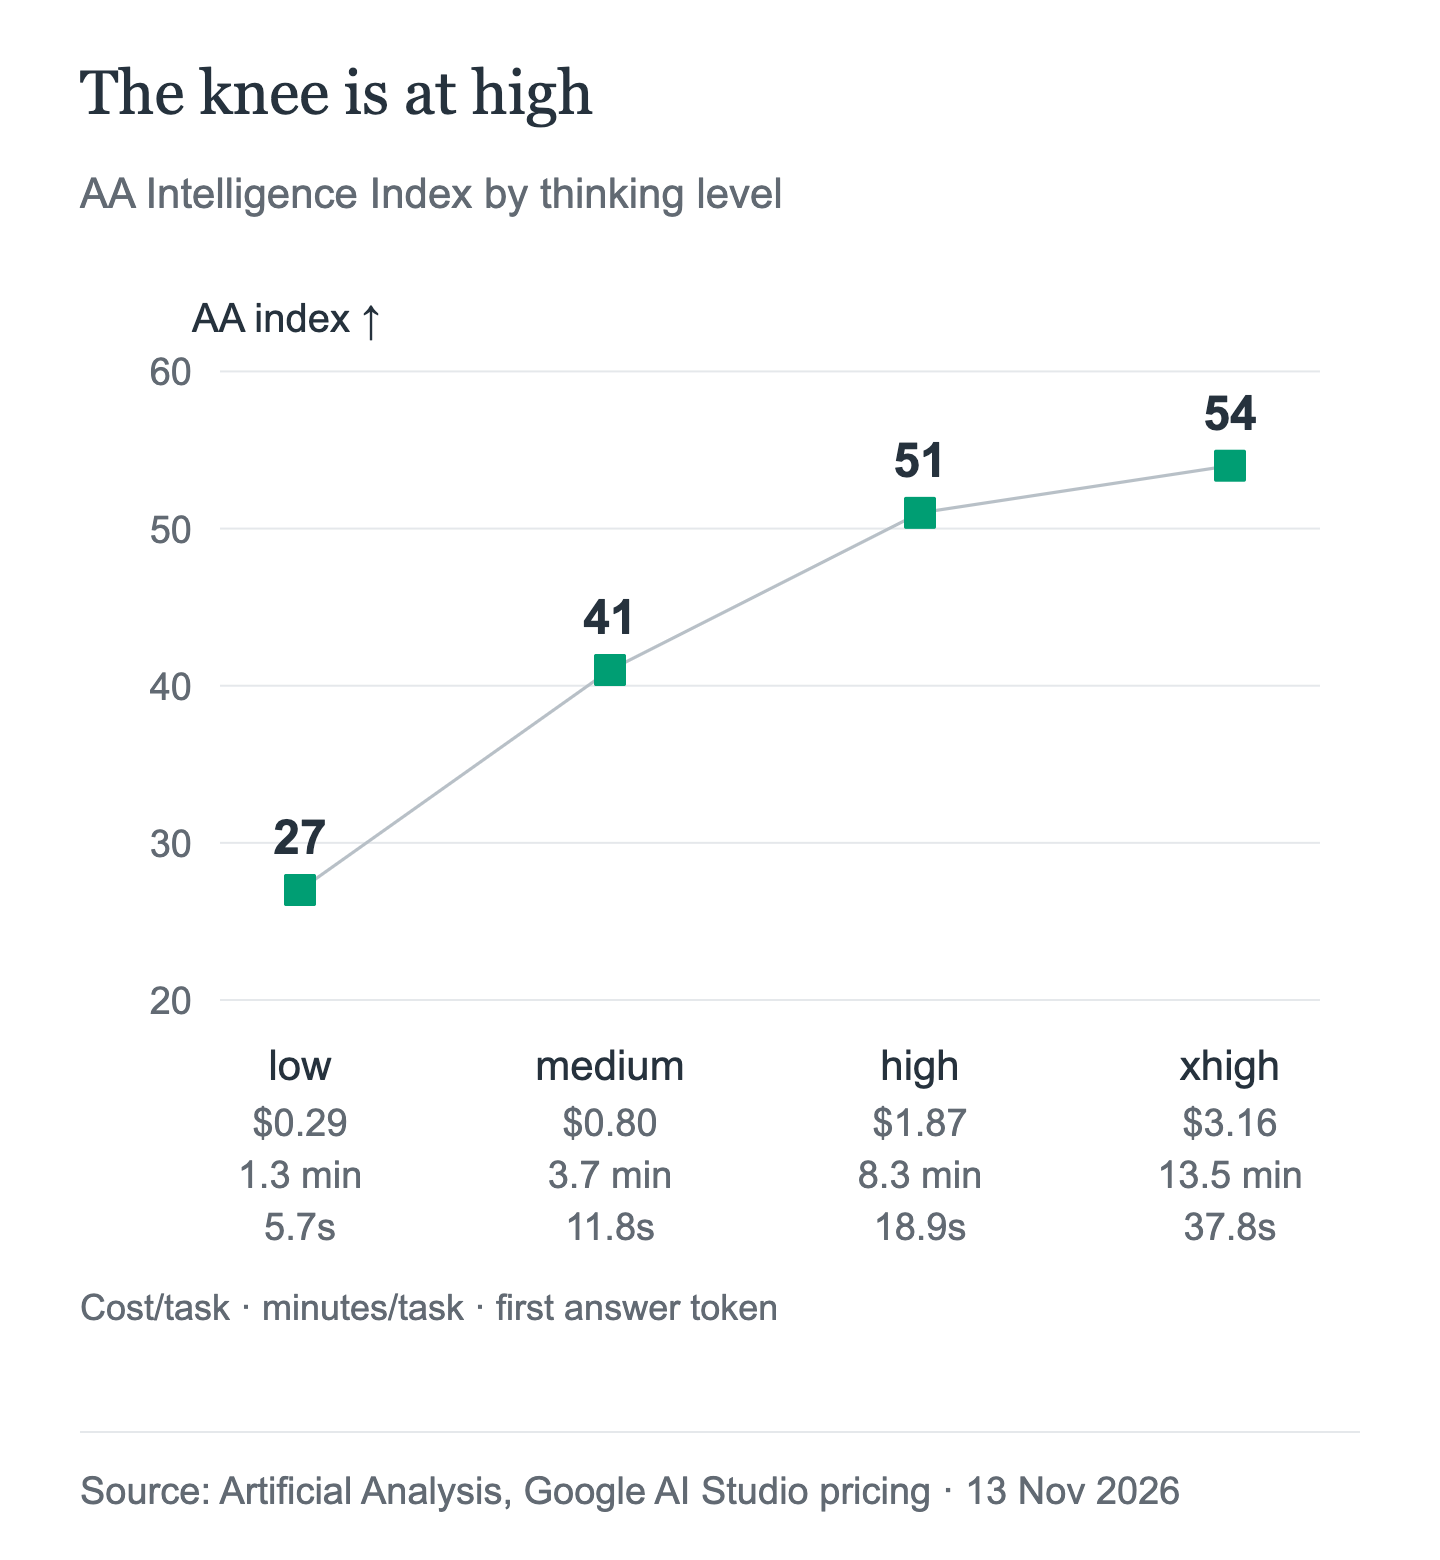
Gemini 4 Hydrogen có bốn cấp độ tư duy, và chúng hoạt động như bốn mô hình khác nhau. Theo các phép đo trực tiếp của Artificial Analysis, cùng một mô hình đạt điểm 27 ở low, 41 ở medium, 51 ở high và 54 ở xhigh. Mặc định là high, còn xhigh là cấp độ mới trong dòng Gemini 4: Carbon và Argon chỉ có đến high.
Mức chênh lệch khá lớn: cùng một mô hình trải rộng 27 điểm chỉ số từ low đến xhigh. Chuyển từ medium lên high giúp tăng 10 điểm chỉ số với chi phí cao hơn khoảng $1.07 cho mỗi tác vụ. Chuyển từ high lên xhigh tăng 3 điểm với thêm $1.29, đồng thời thời gian chờ token phản hồi đầu tiên gần như tăng gấp đôi. Lời khuyên thực tế là bắt đầu với high, dành xhigh cho các tác vụ khó, nhiều bước, và xem low cùng medium là các mức ưu tiên độ trễ cần được kiểm tra chất lượng riêng.
Dưới đây là công dụng của từng cấp độ, chi phí, những thay đổi trong API, cũng như những gì AIHubMix có và không có tài liệu.
Bốn cấp độ và những thay đổi
Gemini 4 Hydrogen hỗ trợ low, medium, high và xhigh. Ghi chú phát hành của Google nêu rõ: “Mô hình mặc định là high và giới thiệu xhigh.” Đây là hai thay đổi so với Gemini 3.8 Flash, vốn mặc định là medium và chỉ có đến high.
Các mô hình còn lại trong dòng không thay đổi. Carbon và Argon hỗ trợ low, medium và high, với medium làm mặc định. Hydrogen là mô hình Gemini 4 duy nhất có cấp độ cao hơn high.
| Mô hình | Các cấp độ | Mặc định |
|---|---|---|
| Gemini 4 Hydrogen | low, medium, high, xhigh | high |
| Gemini 4 Carbon | low, medium, high | medium |
| Gemini 4 Argon | low, medium, high | medium |
MINIMAL không thuộc danh sách này. Tài liệu về khả năng tư duy của Gemini 4 cho biết MINIMAL “không được hỗ trợ trên các mô hình Gemini 4”, còn ghi chú phát hành Hydrogen của Google nói mô hình “từ chối minimal và trả về lỗi”. Không có công tắc tắt tư duy nào được tài liệu ghi nhận cho mô hình này.
Google khuyến nghị gì
Hướng dẫn của Google là điểm khởi đầu hợp lý, nhưng được đưa ra trước các số liệu bên dưới. Đặc biệt, khuyến nghị dùng medium để lập trình tương tác giả định một mức chất lượng mà Artificial Analysis không ghi nhận ở medium.
| Cấp độ | Mô tả và cách dùng được Google đề xuất |
|---|---|
| low | “Ít token nhất, độ trễ thấp nhất” — trò chuyện nhanh, khối lượng lớn |
| medium | “Dùng ít token hơn, phản hồi nhanh hơn” — lập trình tương tác, tạo mẫu giao diện người dùng |
| high | “Cân bằng giữa trí tuệ và tốc độ” — mặc định cho hầu hết tác vụ |
| xhigh | “Dùng nhiều token nhất, suy luận sâu nhất” — lập trình khó, nhiều bước |
Bảng này đi kèm hai lưu ý. Google cho biết: “Dùng xhigh làm tăng độ trễ và lượng token, đồng thời có thể khiến mô hình suy nghĩ quá mức với các prompt đơn giản.” Khuyến nghị đánh giá cũng rất rõ ràng: “Chạy đánh giá ở cả bốn cấp độ với max_output_tokens cao.”
Thang đo qua các cấp độ
Artificial Analysis đã đo cả bốn cấp độ. Lần chạy sử dụng Intelligence Index v5.0.1, gồm 78 mô hình được xếp hạng, truy cập lúc 2026-11-13T02:40Z, theo giá niêm yết tiêu chuẩn. Đây là chi phí mỗi tác vụ của AA, không phải hóa đơn AIHubMix.
| Cấp độ | Xếp hạng AA | Chỉ số AA | $/tác vụ | Phút/tác vụ | Token phản hồi đầu tiên |
|---|---|---|---|---|---|
| low | 60 | 27 | 0.29 | 1.3 | 5.71 s |
| medium | 39 | 41 | 0.80 | 3.7 | 11.80 s |
| high | 21 | 51 | 1.87 | 8.3 | 18.89 s |
| xhigh | 16 | 54 | 3.16 | 13.5 | 37.77 s |
Điều hữu ích là mức chênh lệch giữa các bước:
lowlênmedium: +14 điểm chỉ số, +$0.51 mỗi tác vụ, +2.4 phút, +6.1 giây chờ token đầu tiên.mediumlênhigh: +10 điểm chỉ số, +$1.07 mỗi tác vụ, +4.6 phút, +7.1 giây chờ token đầu tiên.highlênxhigh: +3 điểm chỉ số, +$1.29 mỗi tác vụ, +5.2 phút, +18.9 giây chờ token đầu tiên.
high là điểm cân bằng. Đây là cấp độ cuối cùng mà mức tăng chất lượng vẫn lớn so với khoản chi phí tăng thêm; lên xhigh, thời gian chờ token đầu tiên gần như tăng gấp đôi nhưng chỉ được thêm một ít điểm chỉ số. Điều đó không có nghĩa xhigh là lựa chọn tệ. Nó phù hợp với những tác vụ mà high không xử lý được — đúng như cách Google mô tả cấp độ này.
Để tham khảo, trong cùng bộ dữ liệu, Carbon high đạt 60 điểm với chi phí $5.48 mỗi tác vụ và thời gian 28.1 phút; Carbon medium đạt 58 điểm với $4.68; Carbon low đạt 54 điểm với $5.22; Argon high đạt 50 điểm với $4.97 và thời gian 30.6 phút. Hydrogen xhigh đạt ngang Carbon low với 54 điểm, nhưng chi phí mỗi tác vụ thấp hơn 39.5% ($3.16 so với $5.22), dù token đầu tiên mất 37.77 giây so với 13.61 giây. Hydrogen high hơn Argon high một điểm chỉ số, với chi phí mỗi tác vụ thấp hơn 62.4%.
Khi thang đo không còn hiệu quả
low không chỉ là một bước giảm nhẹ. Với 27 điểm, cấp độ này thấp hơn high 24 điểm chỉ số. Chuyển một khối lượng công việc từ high xuống low để tiết kiệm $1.58 mỗi tác vụ không phải là dùng cùng một sản phẩm nhưng ít suy nghĩ hơn; mà là chuyển sang một mô hình yếu hơn nhiều. Điều này có thể phù hợp với phân loại, định tuyến hoặc trích xuất ngắn. Nhưng sẽ không phù hợp với lập trình hay các tác vụ agent nếu chưa đánh giá riêng theo từng tác vụ.
medium là cấp độ ưu tiên độ trễ, không phải chất lượng. Cấp độ này đạt 41 điểm, thấp hơn high 10 điểm, với chi phí $0.80 so với $1.87. Mức tiết kiệm là đáng kể — 57% cho mỗi tác vụ — nhưng khoảng cách chất lượng lớn hơn mức chênh lệch giá gợi ra. Google khuyến nghị medium cho lập trình tương tác; số liệu AA cho thấy bạn nên thử nghiệm khuyến nghị đó trên các tác vụ của mình trước khi áp dụng.
xhigh có thể suy nghĩ quá mức. Google cảnh báo trực tiếp về điều này. Số liệu chi phí và thời gian của AA cho thấy tác động: $3.16 mỗi tác vụ, 13.5 phút và thời gian chờ token đầu tiên 37.77 giây. Với prompt đơn giản, phải chờ lâu như vậy chỉ để đạt được mức cải thiện nhỏ là không đáng. Nhưng với tác vụ lập trình khó, nhiều bước mà high không xử lý được, đây là cấp độ duy nhất có thể đi xa hơn.
Độ dài câu trả lời cũng ảnh hưởng đến hóa đơn. Artificial Analysis mô tả Hydrogen là “rất dài dòng”: lần chạy xhigh tạo ra 304 triệu token đầu ra để hoàn tất chỉ số, xếp hạng #76 trên 77, trong khi mức trung vị là 72.8 triệu. Token đầu ra bao gồm token tư duy, và đầu ra được tính phí $7.50 mỗi triệu token. Cấp độ cao hơn không chỉ suy nghĩ lâu hơn mà còn tạo ra nhiều token tính phí hơn.
Chi phí: tư duy biến thành token như thế nào
Bảng giá rất đơn giản. Hydrogen có giá $1.50 mỗi triệu token đầu vào, $7.50 mỗi triệu token đầu ra và $0.075 mỗi triệu token đầu vào được lưu trong bộ nhớ đệm. Token đầu ra bao gồm token tư duy. Vì vậy, cấp độ quan trọng hơn mức giá: mô hình tính phí dựa trên lượng suy luận được tạo ra, chứ không phải tên cấp độ.
Có ba quy tắc tính phí dễ bị bỏ sót.
Cấp độ mặc định đã thay đổi. Gemini 3.8 Flash mặc định là medium; Hydrogen mặc định là high. Sau khi di chuyển, một khối lượng công việc chưa từng đặt cấp độ sẽ tiêu tốn nhiều token đầu ra hơn trong mỗi lượt, dù giá mỗi token không đổi. Đây là thay đổi ngân sách được ngụy trang thành việc đổi mô hình.
Chỉ có bộ nhớ đệm ngầm định. Hydrogen hỗ trợ bộ nhớ đệm ngầm định với mức tối thiểu 4,096 token và giảm giá 95% khi trúng bộ nhớ đệm; bộ nhớ đệm tường minh không được hỗ trợ. Trang dành cho doanh nghiệp của Google cũng cho biết: “Theo mặc định, thao tác ghi bộ nhớ đệm được tính phí bằng 1.25x giá token đầu vào tiêu chuẩn.” Đây là cách Google diễn đạt chính sách tính phí; tài liệu về phí bộ nhớ đệm của AIHubMix cho mô hình này chưa được công bố.
Đầu ra dài bị giới hạn số token mỗi lượt. Một yêu cầu đồng bộ tạo tối đa 65,536 token mỗi lượt, bất kể có truyền phát hay không. Đầu ra dài hơn cần chạy nền hoặc dùng token tiếp nối, còn max_output_tokens giới hạn tổng số token tư duy và đầu ra. Nếu đặt background=true mà không đặt max_output_tokens, máy chủ sẽ dừng sau 65,536 token. Ngân sách giải mã dài mà Google đề xuất là 131,072 hoặc 262,144, tối đa 1,048,576 trừ đi phần đầu vào.
API hỗ trợ gì và từ chối gì
Tham số là thinking_level (snake_case). Ví dụ Python của Google đặt tham số này bên trong thinking_config; ví dụ Node đặt nó bên dưới thinkingConfig (camelCase). Trang mô hình liệt kê các giá trị là LOW, MEDIUM, HIGH và XHIGH; ghi chú phát hành viết chúng bằng chữ thường. Hãy dùng enum hoặc chuỗi được tài liệu SDK của bạn hướng dẫn, thay vì tự nhập biến thể chữ hoa chữ thường.
Ba dạng yêu cầu sẽ thất bại:
thinking_budgettrên bất kỳ mô hình Gemini 4 nào đều trả về400: INVALID_ARGUMENT. Đặt đồng thờithinking_levelvàthinking_budgetcũng sẽ trả về lỗi.thinking_level="MINIMAL"không được hỗ trợ; Hydrogen sẽ từ chối tham số này.- Các giá trị tùy chỉnh của
temperature,top_pvàtop_ksẽ bị bỏ qua. Giá trị mặc định cố định là temperature 1.0, topP 0.95 và topK 64.
Trên nền tảng của Google, Hydrogen cũng hỗ trợ gọi hàm, thực thi mã, ngữ cảnh URL và sử dụng máy tính. Trong Interactions API, hãy dùng previous_interaction_id cho các phiên nhiều lượt và gọi công cụ.
AIHubMix có tài liệu gì và chưa có tài liệu gì
Endpoint được AIHubMix ghi nhận cho Hydrogen là POST https://aihubmix.com/v1/chat/completions với model="gemini-4-hydrogen". Trang mô hình liệt kê đầu vào văn bản, hình ảnh, âm thanh, video và PDF, cùng đầu ra văn bản; llms.txt vẫn có một dòng cũ chỉ đề cập văn bản, vì vậy hãy xem trang mô hình là nguồn cập nhật hơn. Các khả năng dùng công cụ, đầu ra có cấu trúc và suy luận được ghi là “chưa công bố”. Mô hình không có trong danh mục mô hình được tạo vào 2026-11-11 và không có lược đồ giao thức nào được công bố.
Điều này quan trọng với bài viết này vì AIHubMix không có tài liệu về cách đặt cấp độ tư duy cho bất kỳ mô hình Gemini 4 nào. Hướng dẫn Gemini của họ đề cập đến reasoning_effort cho các mô hình đời Gemini 2.5, chứ không phải thinking_level hay xhigh trên Gemini 4. Đừng cho rằng một trong hai tham số sẽ được chuyển tiếp qua cổng trung gian, và cũng đừng cho rằng cấp độ mặc định quan sát được trên API của Google sẽ là cấp độ mặc định bạn nhận được trên AIHubMix.
Dạng yêu cầu an toàn là dạng được AIHubMix ghi nhận:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",
    messages=[{"role": "user", "content": "List the failure modes in this retry design."}],
    max_tokens=16384,
)

print(response.choices[0].message.content)
Nếu bắt buộc phải kiểm soát cấp độ, hãy gọi API của Google trực tiếp hoặc xác minh cách hoạt động của cổng trung gian bằng một yêu cầu nhỏ trước khi chuyển lưu lượng thực tế qua đó. Trang so sánh của AIHubMix là công cụ hữu ích để kiểm tra chi phí trong lúc bạn cân nhắc. Bài viết này không thực hiện thử nghiệm trực tiếp.
Nên bắt đầu từ đâu theo khối lượng công việc
| Khối lượng công việc | Nên bắt đầu ở mức nào và lý do |
|---|---|
| Trò chuyện nhanh, định tuyến, phân loại | medium; thử low; low đạt 27 điểm |
| Lập trình tương tác, tạo mẫu giao diện người dùng | high; medium của AA đạt 41 |
| Thực thi agent, vòng lặp gọi công cụ | high; chỉ dùng xhigh nếu bị mắc kẹt |
| Gỡ lỗi khó, kiến trúc, lập kế hoạch | xhigh hoặc Carbon; thêm 3 điểm với chi phí cao hơn 69% |
| Xử lý hàng loạt khối lượng lớn sau khi đánh giá | low hoặc medium; rẻ nhất, nhưng chỉ đạt chỉ số 27/41 |
| Ngân sách độ trễ nghiêm ngặt dưới 15 giây | medium hoặc low; high mất 18.89 s để phản hồi |
Đây là những điểm khởi đầu, không phải quy tắc định tuyến. Mức phù hợp là mức thấp nhất vượt qua được đánh giá của riêng bạn; Google cũng khuyên nên thực hiện đánh giá đó ở cả bốn mức.
Câu hỏi thường gặp
Gemini 4 Hydrogen có những mức tư duy nào?
Có bốn mức: low, medium, high và xhigh. Mặc định là high.
Gemini 3.8 Flash có gì thay đổi?
Mức mặc định được đổi từ medium sang high, đồng thời bổ sung xhigh cao hơn high. Carbon và Argon vẫn mặc định ở medium và có mức cao nhất là high.
xhigh có đáng dùng không?
Có, với những tác vụ nhiều bước khó mà high không xử lý được: mức này tăng thêm 3 điểm chỉ số. Tuy nhiên, chi phí mỗi tác vụ cũng cao hơn high 69% và thời gian chờ token đầu tiên gần gấp đôi, nên đây không phải lựa chọn mặc định phù hợp cho các prompt đơn giản.
Tại sao low lại kém xa như vậy?
Artificial Analysis chấm mức này 27 điểm theo chỉ số, thấp hơn high 24 điểm. Chi phí là $0.29 mỗi tác vụ, so với $1.87, nhưng khoảng cách chất lượng lớn hơn nhiều so với chênh lệch giá. Chỉ dùng mức này khi đánh giá riêng cho tác vụ cho thấy như vậy là đủ.
AIHubMix có hỗ trợ thinking_level hoặc xhigh không?
Tài liệu hiện không cho thấy điều đó. AIHubMix không công bố cờ năng lực suy luận cho Hydrogen cũng như hướng dẫn về các mức tư duy của Gemini 4. Hãy xác minh trước khi dựa vào một trong hai.
Điều gì xảy ra nếu tôi gửi thinking_budget?
Gemini 4 trả về 400: INVALID_ARGUMENT. Thiết lập đồng thời cả thinking_budget và thinking_level cũng trả về lỗi.
Tôi có thể tắt tính năng tư duy không?
Không có công tắc tắt nào được ghi lại trong tài liệu. Gemini 4 không hỗ trợ MINIMAL, và Hydrogen sẽ báo lỗi nếu dùng tùy chọn này.
Đọc tiếp: loạt bài về Gemini 4 Hydrogen
- Nếu bạn vẫn đang cân nhắc Hydrogen có phải là bản nâng cấp phù hợp từ Gemini 3.8 Flash hay không, bài viết đầu tiên đề cập đến thời điểm ra mắt, thay đổi giá và sự đánh đổi giữa các điểm chuẩn: Gemini 4 Hydrogen và Gemini 3.8 Flash: Nâng cấp có đáng không?.
- Nếu bạn muốn biết Hydrogen so sánh với Carbon và Argon như thế nào khi xử lý cùng một công việc, bài viết thứ ba đặt cả ba cạnh nhau để so sánh giá, độ trễ và bảng khối lượng công việc: Gemini 4 Carbon, Hydrogen và Argon: Mô hình nào phù hợp với công việc nào?.
Nguồn
- Google AI Studio, Gemini 4 Hydrogen: có gì mới
- Google, Gemini 4 thinking
- Google, trang mô hình Gemini 4 Hydrogen
- Google AI Studio, giá Gemini API
- Artificial Analysis, Gemini 4 Hydrogen — ảnh chụp dữ liệu trực tiếp lúc 2026-11-13T02:40Z, Intelligence Index v5.0.1


