Ở cấp độ schema yêu cầu, Gemini 4 Carbon có thể thay thế trực tiếp Gemini 4 Argon. Nội dung yêu cầu chat-completions vẫn dùng được: chỉ cần đổi ID model, còn một vài giá trị tham số sẽ không được giữ nguyên. Các lỗi đáng chú ý xảy ra ở lớp thấp hơn — lỗi tham số trả về 400, giới hạn đầu ra âm thầm cắt ngắn nội dung, cùng thời gian chờ và cách tính phí được thiết kế cho quá trình suy nghĩ dài.
Bốn thiết lập mặc định quyết định tuần đầu tiên:
- Trên AIHubMix, giữ
max_tokensở mức 65,536 trở xuống; gateway chỉ ghi rõ hỗ trợ Chat Completions và không công bố đường dẫn đầu ra lớn hơn. - Với các lượt chạy nền bằng Interactions gốc của Google, đặt
store=truevà chỉ định rõmax_output_tokens; các trường này chưa được tài liệu AIHubMix công bố cho Carbon. - Khi dùng đường dẫn giải mã dài gốc của nhà cung cấp, hãy tăng thời gian chờ đọc HTTP lên 15–20 phút cho mỗi luồng.
- Xóa
temperature,top_pvàtop_kvì chúng bị bỏ qua, cùng các tham số penalty và giá trịcandidate_countlớn hơn 1 vì chúng sẽ trả về lỗi 400 theo hướng dẫn Carbon của Google.
Các điểm cơ bản không đổi — quyền truy cập, từ chối vì lý do bảo mật, chi phí cho mỗi tác vụ — đã có trong bài viết di chuyển Argon. Bài viết này đề cập đến hành vi riêng của Carbon.
Lỗi nào báo rõ, lỗi nào âm thầm
Các lỗi chia thành hai loại rõ rệt: lỗi 400 báo cho bạn ngay lập tức, còn giới hạn âm thầm chỉ lộ ra trên hóa đơn.
| Biểu hiện | Loại | Hành động đầu tiên |
|---|---|---|
| HTTP 400 do tham số | Rõ | Xóa trường không được hỗ trợ |
| 400 khi gửi yêu cầu nền | Rõ | Thêm store=true |
| Câu trả lời dừng ở 65,536 token | Âm thầm | Tăng max_tokens, tối đa 65,536 |
| Văn bản trống, trạng thái incomplete | Âm thầm | Tăng giới hạn rồi thử lại |
| Lượt chạy nền kết thúc gần 64K | Âm thầm | Đặt max_output_tokens |
| Câu trả lời có vẻ nông hơn | Âm thầm | Chỉ định rõ mức suy nghĩ |
| Hóa đơn cao hơn ước tính | Âm thầm | Tính cả các lượt suy nghĩ và giải mã |
AIHubMix niêm yết gemini-4-carbon với giá $2 cho đầu vào, $10 cho đầu ra và $0.10 cho token được lưu trong bộ nhớ đệm trên mỗi triệu token — mức giá ưu đãi mở bán của Google — qua Chat Completions. Đây là giá tạm thời; xem phần tính phí.
Lỗi báo rõ: các trường hợp 400 được tài liệu ghi nhận
Nhiều lỗi 400 được ghi nhận là do xác thực tham số; lịch sử hội thoại và các lượt model được điền sẵn là lỗi trạng thái yêu cầu. Trừ khi có ghi chú khác, các quy tắc dưới đây lấy từ hướng dẫn Carbon gốc của Google; hiện tại, AIHubMix chỉ ghi rõ hỗ trợ Chat Completions cho Carbon. Mục Carbon của AIHubMix mô tả nhóm lỗi này bằng một dòng: "400 — lỗi tham số; phần lớn được chuyển tiếp từ nhà cung cấp thượng nguồn." Đây là mô tả về gateway, không phải kết quả kiểm thử. Chi tiết được lấy từ hướng dẫn Carbon và trang tin tức mới của Google.
| Nguyên nhân | Biểu hiện | Cách khắc phục |
|---|---|---|
| max_output_tokens > 1M* | 400; vượt giới hạn | Gốc ≤1M; gateway ≤65K* |
| frequency/presence penalty | 400; không được hỗ trợ | Xóa các trường |
| candidate_count > 1 | 400; nhiều ứng viên | Bỏ qua hoặc đặt thành 1 |
| background không có store* | 400; bắt buộc có store* | Thêm store=true |
| Lịch sử kết thúc bằng lượt model | Bị từ chối; không được hỗ trợ | Kết thúc bằng lượt người dùng |
| cả hai điều khiển | 400; không thể kết hợp | Chỉ gửi một |
| thinking_budget hoặc MINIMAL | 400; theo hướng dẫn Carbon | Dùng low/medium/high |
Google hiển thị chính xác thông báo: "store=true is required for background interactions." * Chỉ áp dụng cho Google gốc: max_output_tokens bị giới hạn ở 1M và tác vụ nền yêu cầu store=true; AIHubMix chưa công bố đường dẫn này. Trên đường dẫn Chat Completions của AIHubMix, hãy dùng ≤65K.
Mục minimal có hai ý nghĩa. Trong các trường Carbon gốc của Google, thinking_budget và thinking_level=MINIMAL trả về HTTP 400; hãy dùng low, medium hoặc high. Trong lớp tương thích OpenAI của Google, reasoning_effort=minimal được ánh xạ thành low; AIHubMix chưa công bố liệu có áp dụng ánh xạ đó cho Carbon hay không.
Cách xử lý công cụ là một cạm bẫy liên quan. Hướng dẫn Carbon của Google khuyên ưu tiên các lượt thực thi công cụ tuần tự, còn hướng dẫn Gemini của AIHubMix có ghi rõ tool_choice="auto"; khả năng hỗ trợ công cụ riêng cho Carbon trên gateway vẫn chưa được xác nhận.
Yêu cầu an toàn tối giản trên /v1/chat/completions loại bỏ những gì Carbon bỏ qua:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Reply with OK."}],
    max_tokens=32768,  # room for thinking plus answer
)
print(response.choices[0].message.content)
Nếu yêu cầu trả về 200, lớp truyền tải đã hoàn tất. Phần còn lại liên quan đến các câu trả lời không gây lỗi.
Lỗi âm thầm: không báo lỗi, đầu ra sai, hóa đơn sai
Giới hạn đầu ra tiêu chuẩn là 65,536; giải mã dài của nhà cung cấp là một đường dẫn riêng
Giới hạn đầu ra tiêu chuẩn của Carbon là 65,536 token. Trong Chat Completions, trường giới hạn là max_tokens; hướng dẫn gốc của Google gọi trường này là max_output_tokens. Đường dẫn giải mã dài gốc của Google có thể đạt tối đa 1,048,576 token trừ đi phần đầu vào; 131,072 và 262,144 là các ví dụ. Trang tin tức mới của Google nêu quy tắc này: "Nếu bạn đặt background: true mà không định nghĩa max_output_tokens, máy chủ sẽ dừng sau 64K token." AIHubMix chưa công bố tính năng chạy nền hoặc tiếp tục cho Carbon.
Quá trình giải mã dài gốc của nhà cung cấp chạy theo từng đoạn: 64K mỗi lượt khi dùng background hoặc truyền phát, 32K mỗi lượt khi không truyền phát; một yêu cầu REST không truyền phát sẽ dừng sau 32,768. Hướng dẫn của Google lưu ý rằng "Các phiên bản SDK trước đây và lớp tương thích OpenAI không thể truy xuất các phần hoàn tất dài bằng token tiếp tục." Với AIHubMix, hãy giữ max_tokens ở mức 65,536 trở xuống như một giới hạn gateway thận trọng nhưng chưa được xác minh; đừng lên kế hoạch ghép các câu trả lời dài hơn cho đến khi trang model công bố hỗ trợ.
Giới hạn thấp cắt ngắn phần suy nghĩ, và đầu ra trống vẫn bị tính phí
Giới hạn áp dụng cho cả phần suy nghĩ, không chỉ văn bản. Hướng dẫn giải mã dài của Google cho biết: "Giá trị thấp, chẳng hạn 8,192, sẽ dừng model trước khi model suy nghĩ xong." Trạng thái chuyển thành incomplete và "Văn bản có thể trống nếu model vẫn đang suy nghĩ." Dù thế nào bạn vẫn phải trả phí. Hãy dự trù token cho cả phần suy nghĩ lẫn câu trả lời, đồng thời xem phản hồi incomplete trống là vấn đề về giới hạn: tăng giới hạn, thử lại và tính cả lần thử đầu tiên vào hóa đơn.
Mức suy nghĩ mặc định là medium
Carbon mặc định ở mức medium, giống Argon. Các nhóm chuyển từ Gemini 3.1 Pro Preview, vốn mặc định ở mức high, sẽ giảm một mức dù không thay đổi mã và có thể nhầm câu trả lời nông hơn là hồi quy. Google khuyến nghị dùng medium cho phần lớn tác vụ lập trình và agent. Hãy chỉ định rõ mức này trong môi trường staging và chỉ gửi một trường điều khiển: không thể kết hợp reasoning_effort với thinking_level.
Các tham số lấy mẫu bị bỏ qua
temperature, top_p và top_k bị bỏ qua — không có lỗi, mẫu cũng không thay đổi. Hãy xóa chúng. Các tham số penalty và giá trị candidate_count lớn hơn 1 sẽ trả về lỗi 400.
Không còn bộ nhớ đệm tường minh
cachedContents và caches.create không được hỗ trợ. Cơ chế lưu vào bộ nhớ đệm ngầm áp dụng từ 4,096 token trở lên với mức giảm giá 95%. Xóa mã bộ nhớ đệm tường minh, đặt tiền tố prompt ổn định lên trước và kiểm tra mức sử dụng token được lưu trong bộ nhớ đệm trước khi dự trù khoản giảm giá.
Trạng thái hội thoại có quy tắc riêng
Google khuyến nghị dùng previous_interaction_id để tiếp tục. Chat Completions không có trường này, vì vậy hãy giữ lịch sử nhưng kết thúc bằng lượt người dùng; lượt kết thúc bằng vai trò model hoặc lượt model được điền sẵn đều không được hỗ trợ.
Thời gian chờ: 15–20 phút, không phải 60 giây
Hướng dẫn giải mã dài của Google khuyến nghị thời gian chờ đọc HTTP từ 15 đến 20 phút cho mỗi luồng; danh sách kiểm tra di chuyển của Google cũng nhắc lại mức tối thiểu 15 phút. Khuyến nghị đó dành cho các yêu cầu giải mã dài. Một phép đo riêng của AA cho biết thời gian chờ token đầu tiên của câu trả lời: Carbon High mất 67.1 giây, Medium 23.2, Low 12.9 và Argon High 40.1. Giới hạn 60 giây liệu có đủ để token đầu tiên xuất hiện không?
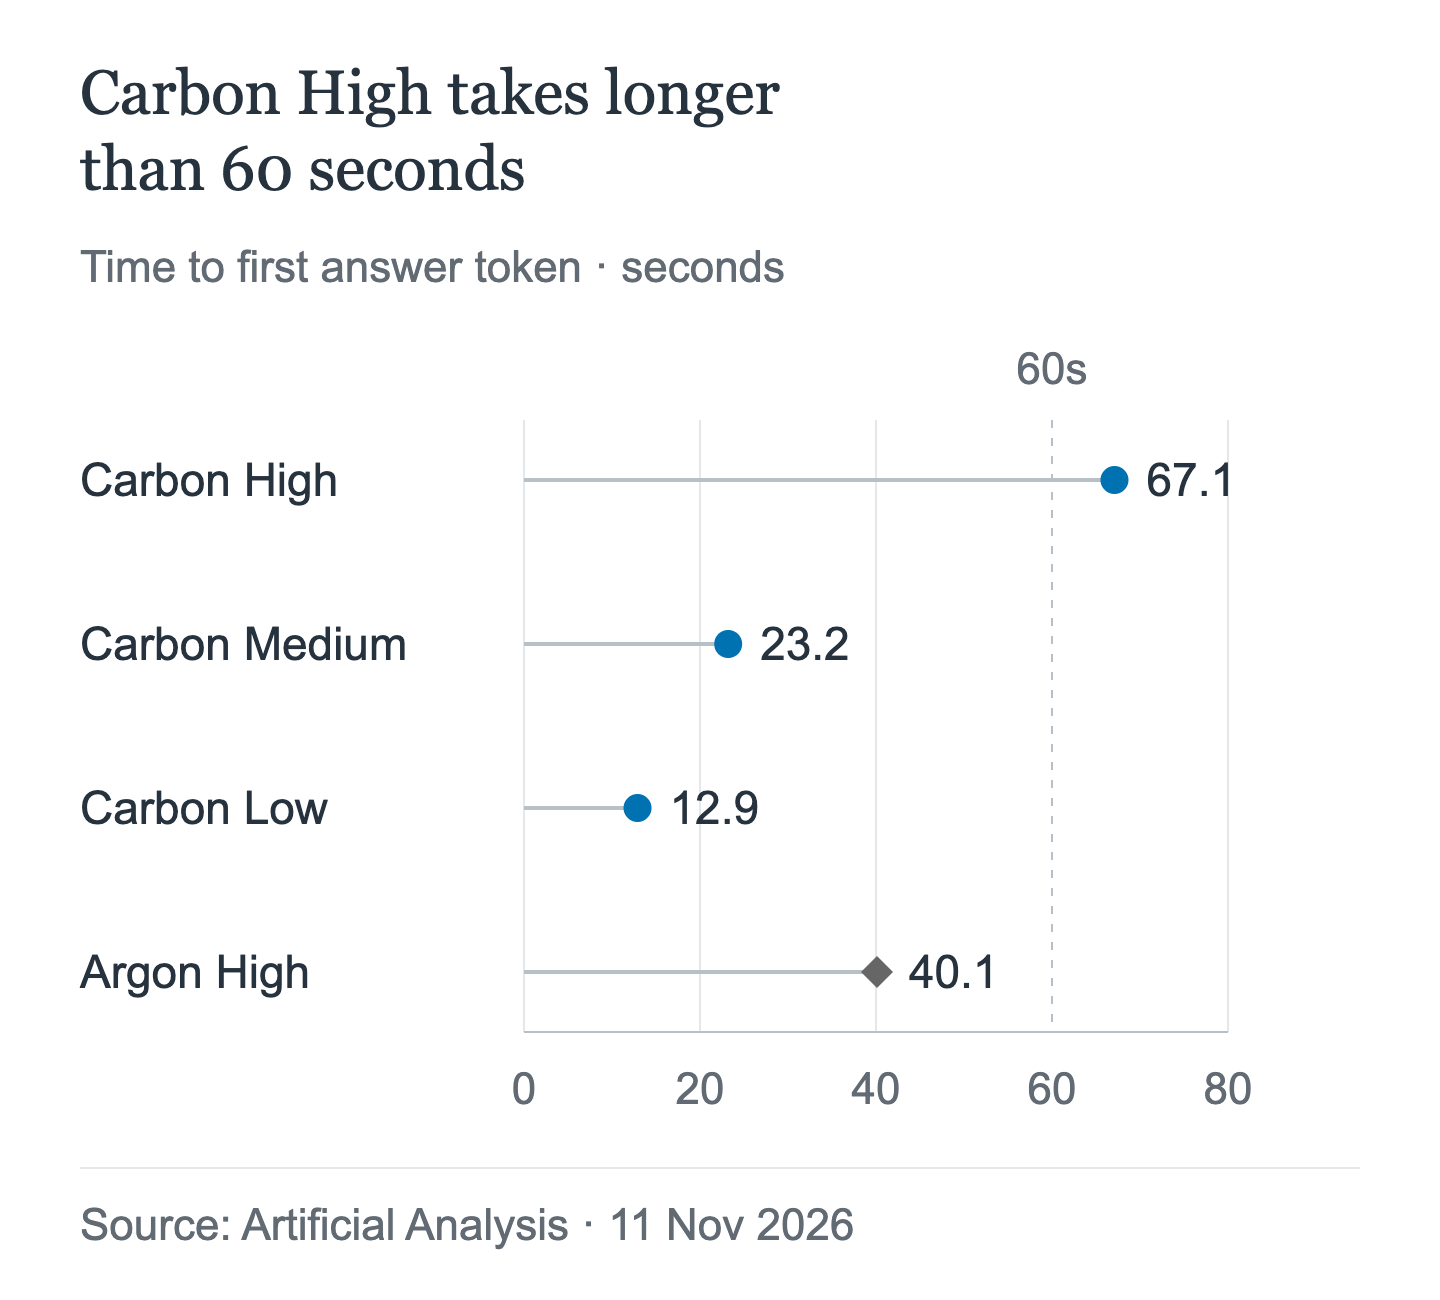
Trong phép đo này, Carbon High vượt mốc tham chiếu 60 giây. Thời gian chờ token đầu tiên không xác định được thời gian chờ an toàn cho toàn bộ yêu cầu: khuyến nghị 15–20 phút ở trên lấy từ hướng dẫn giải mã dài của Google. Đây là kết quả của một lần đo, không phải cam kết về độ trễ hay kết quả kiểm thử của AIHubMix.
Giới hạn thời gian cho mỗi lượt gọi client gốc của Google chặt hơn giới hạn chạy nền: 20 phút cho luồng truyền phát, 10 phút cho cuộc gọi không truyền phát, trong khi chạy nền có giới hạn 24 giờ. AIHubMix không công bố các giới hạn chạy nền này.
Phiên bản SDK gốc tối thiểu cho giải mã dài: Python 2.34.0, JS 2.32.0, Go 1.77.0, Java 1.80.0, .NET 1.28.0. API_TIMEOUT_MS của Claude Code mặc định là 10 phút; nếu sau này xác nhận có đường dẫn Claude Code cho Carbon, hãy tăng giá trị này trước lần chạy đầu tiên.
Cạm bẫy tính phí
Giá mỗi token của Carbon rất đơn giản; hóa đơn thì không. Một số cơ chế làm hóa đơn tăng lên, và một thay đổi đã lên lịch sẽ tăng gấp đôi mọi mức giá.
Token suy nghĩ được tính phí như đầu ra
Token suy nghĩ được tính phí như token đầu ra. Hiện tại, giá đầu ra của Carbon là $10 cho mỗi triệu token và sẽ là $20 từ ngày 1 tháng 12.
Tính phí cho mọi lượt giải mã dài
Ví dụ minh họa của Google: một prompt 1,000 token tạo ra 200,000 token đầu ra có total_input_tokens là 397,216 qua các lượt gồm 1,000, 66,536, 132,072 và 197,608 token. "Bạn phải trả phí cho mọi token ở mọi lượt, kể cả những lượt chỉ chứa phần suy nghĩ." Cơ chế lưu vào bộ nhớ đệm ngầm giảm giá 95% cho phần lớn token đầu vào, nhưng các lượt vẫn được tính vào mức sử dụng. Công việc đã hoàn tất cũng bị tính phí nếu lượt chạy thất bại hoặc bị hủy: "Các đoạn đã hoàn tất được tính phí vào cuối mỗi đoạn, kể cả khi một đoạn sau đó thất bại hoặc bị hủy," và "Bạn phải trả phí cho toàn bộ công việc đã hoàn tất trước khi lượt tương tác kết thúc."
Grounding có cách tính phí riêng
Trên dịch vụ gốc của Google, grounding bằng Google Search có 5,000 yêu cầu miễn phí mỗi tháng, dùng chung cho Gemini 3 trở lên; sau đó là $14 cho mỗi 1,000 yêu cầu, giới hạn 1,500 yêu cầu mỗi ngày. AIHubMix chưa công bố tính năng grounding cho Carbon.
Chú thích về Vertex chỉ áp dụng cho nhà cung cấp
Trang giá Vertex của Google bổ sung một quy tắc: các phản hồi hoàn tất dài hơn 32K token bị tính phí theo mức sử dụng token có thể truy xuất, kể cả khi yêu cầu thất bại do hết thời gian chờ ở client hoặc máy chủ; quy tắc có hiệu lực từ ngày 13 tháng 11 năm 2026. Đây là quy tắc của nhà cung cấp; chưa có thông tin công bố liệu nhà cung cấp VertexAI của AIHubMix có áp dụng hay không. Hãy hỏi trước khi mặc định là có.
Từ ngày 1 tháng 12, mọi mức giá sẽ tăng gấp đôi
| Mức giá | Đến hết ngày 30 tháng 11 | Từ ngày 1 tháng 12 |
|---|---|---|
| Đầu vào | $2 mỗi 1M | $4 mỗi 1M |
| Đầu ra | $10 mỗi 1M | $20 mỗi 1M |
| Đọc từ bộ nhớ đệm | $0.10 mỗi 1M | $0.20 mỗi 1M |
Carbon và Argon có cùng mức giá ưu đãi mở bán; mọi mức giá sẽ tăng gấp đôi vào ngày 1 tháng 12. Hiện AIHubMix niêm yết mức giá ưu đãi mở bán và chưa công bố giá sau tháng 12. Hãy xem việc giá tăng gấp đôi là chắc chắn còn mức giá trên gateway vẫn chưa rõ, đồng thời kiểm tra cả hai trước khi chốt ngân sách.
Agent có quyền hạn thực tế
Với các lệnh gọi gốc của Google, tài liệu hướng dẫn Carbon khuyên nên ưu tiên các lượt thực thi công cụ tuần tự. Khi sử dụng cách này, hãy thực hiện từng lệnh gọi một. Hướng dẫn Gemini của AIHubMix có ghi tool_choice="auto", nhưng hỗ trợ công cụ riêng cho Carbon và cách hoạt động của chế độ ép buộc dùng công cụ trên gateway hiện chưa được xác nhận.
Lịch sử hội thoại không được kết thúc bằng lượt của model và không hỗ trợ lượt model được điền sẵn. Nếu thiếu kết quả công cụ, hãy gửi một lượt của người dùng để hỏi bước tiếp theo.
Thẻ model ghi nhận đôi khi model chạy chậm hoặc bị hết thời gian chờ, đồng thời tiêu thụ thêm token ở các cấp cao hơn; mốc kiến thức là tháng 3 năm 2026. Khi có quyền ghi, timeout là rủi ro thực sự: một lần chạy vượt quá giới hạn của client có thể để lại công việc dang dở, trong khi các phần đã hoàn tất vẫn bị tính phí.
Công cụ lập trình: kiểm tra trang model trước khi kết nối
Danh sách Carbon của AIHubMix chỉ ghi nhận Chat Completions và Carbon hiện chưa có trong danh mục model công khai. Claude Code cần Anthropic Messages; Codex cần Responses. Chưa bên nào được xác nhận là hoạt động với Carbon trên AIHubMix. Đừng cho rằng một trong hai sẽ dùng được: mở trang model Carbon được liên kết ở trên và kiểm tra danh sách giao thức. Nếu chỉ thấy Chat Completions, hãy dùng client tương thích OpenAI hoặc chờ thêm.
Cấu trúc yêu cầu giống Argon, nhưng giao thức khả dụng thì khác: hiện AIHubMix chỉ ghi nhận Carbon hỗ trợ Chat Completions. Bài viết về Claude Code đề cập đến ANTHROPIC_BASE_URL, ANTHROPIC_AUTH_TOKEN và API_TIMEOUT_MS; bài viết về Codex đề cập đến khối provider, wire_api và model_reasoning_effort. Điểm khác biệt nằm ở việc giao thức đó có tồn tại hay không.
| Client | Giao thức cần dùng | Carbon trên AIHubMix |
|---|---|---|
| Claude Code | Anthropic Messages | Chưa có tài liệu |
| Codex | Responses API | Chưa có tài liệu |
| OpenAI SDK | Chat Completions | Đã có tài liệu |
Cài đặt:
- ID model:
gemini-4-carbon. - Thinking: low, medium, high; mặc định là medium.
- Ánh xạ mức độ: trường gốc
thinking_level, trường tương thíchreasoning_effort; Google ánh xạ các giá trị mức độ, nhưng AIHubMix chưa công bố cách ánh xạ cho Carbon. Hãy gửi một giá trị. - Ngữ cảnh: 1,048,576 theo Google; AIHubMix chưa công bố giới hạn cho Carbon, vì vậy đừng xây dựng dựa trên con số của nhà cung cấp.
- Các vấn đề đã biết: token đầu tiên có thể xuất hiện chậm ở mức high, nhà cung cấp khuyên ưu tiên các lượt gọi công cụ tuần tự, giới hạn thận trọng chưa được xác minh của AIHubMix là 65,536 token đầu ra, và mốc kiến thức tháng 3 năm 2026.
Kiểm thử nhanh trong 10–15 phút:
- Chọn một kho mã nhỏ có một bài kiểm thử đơn vị đang lỗi và lệnh kiểm thử chạy xong trong chưa đầy một phút.
- Đặt model thành
gemini-4-carbon, đặtmax_tokensở mức 65,536 trở xuống và đặt timeout HTTP ít nhất 15 phút. - Yêu cầu công cụ thực hiện thay đổi nhỏ nhất để bài kiểm thử chạy thành công, sau đó chạy lệnh kiểm thử và kiểm tra diff.
- Đạt: chỉnh sửa tối thiểu và bài kiểm thử chạy thành công trong vòng 10–15 phút. Không đạt: ghi lại phản hồi là lỗi 400, câu trả lời chưa hoàn chỉnh, timeout hay chỉnh sửa sai; mỗi trường hợp cần cách khắc phục khác nhau như trên.
- Nếu công cụ cho phép chọn mức độ, hãy kiểm thử medium và high, rồi giữ lại mức hoàn tất trong khoảng thời gian cho phép.
Danh sách kiểm tra trước yêu cầu đầu tiên trên production
- Đặt ID model thành
gemini-4-carbon. - Không dùng
temperature,top_phoặctop_k. - Không dùng
frequency_penaltyhoặcpresence_penalty; giữcandidate_countở mức 1 hoặc bỏ qua tham số này. - Đặt
max_tokensở mức 65,536 trở xuống. - Với các yêu cầu chạy nền gốc của Google, hãy gửi
store=truevà chỉ định rõmax_output_tokens; AIHubMix chưa có tài liệu về đường xử lý này. - Đặt timeout HTTP từ 15 phút trở lên; nên dùng truyền phát.
- Chỉ dùng một trong hai:
reasoning_efforthoặcthinking_level. - Ưu tiên các lượt gọi công cụ tuần tự trên giao thức gốc của Google; AIHubMix có tài liệu ghi
tool_choice="auto", nhưng hỗ trợ Carbon chưa được xác nhận. - Không gọi bộ nhớ đệm một cách tường minh; đặt tiền tố prompt ổn định ở đầu.
- Ngân sách phải tính cả token suy luận và mọi chặng giải mã dài.
- Kiểm tra mức giá ngày 1 tháng 12 với người phụ trách ngân sách.
- Kiểm tra công cụ lập trình trên trang model trước khi cấu hình.
Câu hỏi thường gặp
Cần thay đổi nội dung yêu cầu khi chuyển từ Argon sang Carbon không?
Không. Lược đồ không đổi. Hãy thay ID model, xem lại các giá trị và bỏ các trường hiện trả về lỗi 400.
Tại sao max_output_tokens lại trả về lỗi 400?
API Carbon gốc của Google từ chối các giá trị lớn hơn 1,048,576. Đường Chat Completions của AIHubMix có khuyến nghị thận trọng riêng: giữ max_tokens ở mức 65,536 trở xuống cho đến khi có tài liệu về đường xử lý cho phép mức cao hơn. Đặt giá trị thấp sẽ khiến phần suy luận bị cắt thay thế, còn tệ hơn: câu trả lời có thể không hoàn chỉnh nhưng vẫn bị tính phí.
Tại sao phản hồi lại trống?
Nếu trạng thái là chưa hoàn tất, phần văn bản có thể trống vì model vẫn đang suy luận. Bạn vẫn phải trả phí cho phần xử lý đó. Hãy tăng giới hạn rồi thử lại.
Tại sao yêu cầu chạy nền lại dừng ở 64K?
Trên đường xử lý chạy nền gốc của Google, nếu không chỉ định max_output_tokens, máy chủ sẽ dừng ở 64K. Hãy đặt giới hạn một cách tường minh; giải mã dài trên giao thức gốc có thể đạt tối đa 1,048,576 trừ đi phần đầu vào. AIHubMix chưa có tài liệu về chế độ chạy nền.
temperature có được áp dụng không?
Không. temperature, top_p và top_k sẽ bị bỏ qua. Thay vào đó, các giá trị penalties và candidate_count lớn hơn 1 sẽ trả về lỗi 400.
Chi phí Carbon có tăng gấp đôi vào ngày 1 tháng 12 không?
Mức giá của Google tăng gấp đôi: đầu vào từ $2 lên $4, đầu ra từ $10 lên $20, lượt đọc đã lưu vào bộ nhớ đệm từ $0.10 lên $0.20. AIHubMix chưa công bố giá sau tháng 12, vì vậy hãy xác nhận trước khi chốt ngân sách.
Có thể dùng Claude Code hoặc Codex với Carbon không?
Chưa được xác nhận. AIHubMix ghi nhận Carbon hỗ trợ Chat Completions; Claude Code cần Anthropic Messages còn Codex cần Responses. Trước tiên, hãy kiểm tra trang model.
Đọc tiếp: loạt bài Gemini 4 Carbon
- Nếu quá trình di chuyển đang diễn ra và câu hỏi còn lại là liệu Carbon có xứng đáng với mức giá hay không, bài so sánh sẽ đặt các mức giá giới thiệu giống nhau cạnh nhau.
Gemini 4 Carbon và Argon: Cùng giá, khi nào nên chọn Carbon? - Nếu bạn đang chọn agent lập trình thay vì di chuyển endpoint, bài so sánh trực tiếp sẽ đề cập đến việc sử dụng công cụ và chi phí cho mỗi tác vụ.
Gemini 4 Carbon và Fable 5.2: Model nào phù hợp để lập trình theo hướng agent?