Anthropic, Claude Fable 5.2 modelini 9 Kasım 2026'da piyasaya sürdü. Google ise bir gün sonra Gemini 4 Carbon modelini genel kullanıma açtı. Anthropic'in lansman kıyaslama tablosunda Carbon için de bir sütun bulunuyor; bu da aynı uzun süreli kodlama iş yüklerini karşılaştırmak için iyi bir fırsat sunuyor.
Her iki model de aynı iş için sunuluyor: uzun süreli agentic kodlama. Ajan bir kod deposunu okuyor, birden fazla dosyada düzenleme yapıyor, komutlar çalıştırıyor, test çıktılarını okuyor ve 15 ila 45 dakika boyunca insandan yeni bir girdi almadan devam ediyor. Burada puanlanan görev bu. Sohbet, otomatik tamamlama ve kısa betikler ise farklı testlerdir.
Kısa yanıt
Fable 5.2, listelenen zorlu kodlama kıyaslamalarında önde ve aynı akıl yürütme düzeyinde daha hızlı; ilk üç AA sırasını alarak Carbon High'ı #4'te bırakıyor. Carbon, listelenen Terminal-Bench 4.0 ve AutomationBench-AA sonuçlarında daha yüksek puan alıyor ve Google'ın tanıtım fiyatı 30 Kasım'da sona erene kadar görev başına daha ucuz. Medium düzeyinde Fable daha ucuz ve çok daha hızlı; Carbon ise AA indeksinde daha yüksek puan alıyor.
Zorlu kodlama akıl yürütmesi için Fable'ı, terminal çalıştırma ve otomasyon için Carbon'ı seçin; ikisini de kullanmadan önce girdi, veri saklama ve çıktı sınırlarını kontrol edin.
Tek bir test düzeneğinin gösterdikleri
Artificial Analysis tüm modelleri aynı test düzeneği ve görevlerle değerlendiriyor; Carbon ve Fable sayfalarında değerlendirme bazındaki sonuçlar yer alıyor. Veriler, 11 Kasım 2026 tarihli anlık görüntüden alınmıştır; AA, Google'ın tanıtım indirimi yerine standart liste fiyatlarını kullanıyor.
| Model | AA indeksi | $/görev | Dakika/görev | İlk token |
|---|---|---|---|---|
| Fable 5.2 Max | 64.56 | 26.54 | 45.2 | 233.9 s |
| Fable 5.2 Xhigh | 62.22 | 14.83 | 26.1 | 69.3 s |
| Fable 5.2 High | 61.82 | 9.08 | 17.3 | 30.4 s |
| Fable 5.2 Medium | 56.41 | 3.80 | 7.8 | 12.8 s |
| Carbon High | 60.03 | 7.76 | 25.6 | 67.1 s |
| Carbon Medium | 58.26 | 6.59 | 23.3 | 23.2 s |
| Opus 5.5 Max | 59.11 | 10.04 | 25.0 | 356.4 s |
Not: Standart fiyatlarla AA Intelligence Index ve görev başına maliyet; anlık görüntü: 2026-11-11T05:23Z. Fable Max, Xhigh ve High sırasıyla #1'den #3'e kadar; Carbon High #4, Opus 5.5 Max #5, Carbon Medium ise #6. İlk token, yanıtın ilk token'ına kadar geçen süredir.
High düzeyinde Fable 1.79 puan önde, görev başına %17.0 daha pahalı ($9.08'e karşı $7.76), işi 25.6 dakika yerine 17.3 dakikada tamamlıyor ve ilk token'ı 67.1 saniye yerine 30.4 saniyede döndürüyor. Max, görev başına $26.54'e mal oluyor; bu, Carbon High'ın 3.4 katı ve ilk token için 233.9 saniye bekletiyor.
Medium düzeyinde sıralama değişiyor: Fable, Carbon'ın 58.26 puanına karşı 56.41 alarak 1.85 puan geride kalıyor; ancak $6.59 yerine $3.80'e mal oluyor ve görevi 23.3 dakika yerine 7.8 dakikada tamamlıyor. Carbon'ın token fiyatının daha düşük olması burada görev başına daha ucuz olduğu anlamına gelmiyor; daha fazla token harcıyor.
| Kıyaslama | Carbon High | Fable High | Fable Max | Opus 5.5 Max |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.15 | 59.6 | 59.6 | 59.6 |
| FrontierCode 2.0 | 40.56 | 49.13 | 48.76 | 46.44 |
| AutomationBench-AA | 77.82 | 71.36 | 76.42 | 69.54 |
| HLE-Diamond | 69.1 | 73.8 | 80.2 | 67.9 |
| Halüsinasyonsuz yanıt % | 88.58 | 42.02 | 40.73 | 49.66 |
| Doğruluk % | 58.27 | 77.23 | 79.13 | 65.5 |
| Briefcase Elo | 1610.6 | 1677.4 | 1785.3 | 1800.6 |
Not: Artificial Analysis, aynı test düzeneği ve anlık görüntü. Halüsinasyonsuzluk, Omniscience yanıtları içinde uydurma iddia içermeyenlerin oranıdır; doğruluk ayrı bir puandır. Her satırda yüksek değer daha iyidir. Tabloyu okunabilir tutmak için Fable Xhigh çıkarılmıştır; FrontierCode 2.0 puanı 47.58'dir.
High düzeyinde her testte hangi model önde? Aşağıdaki işaretli fark, Carbon puanından Fable puanını çıkarıyor; üstteki tabloda mutlak puanlar yer alırken bu gösterim yönü belirginleştiriyor.
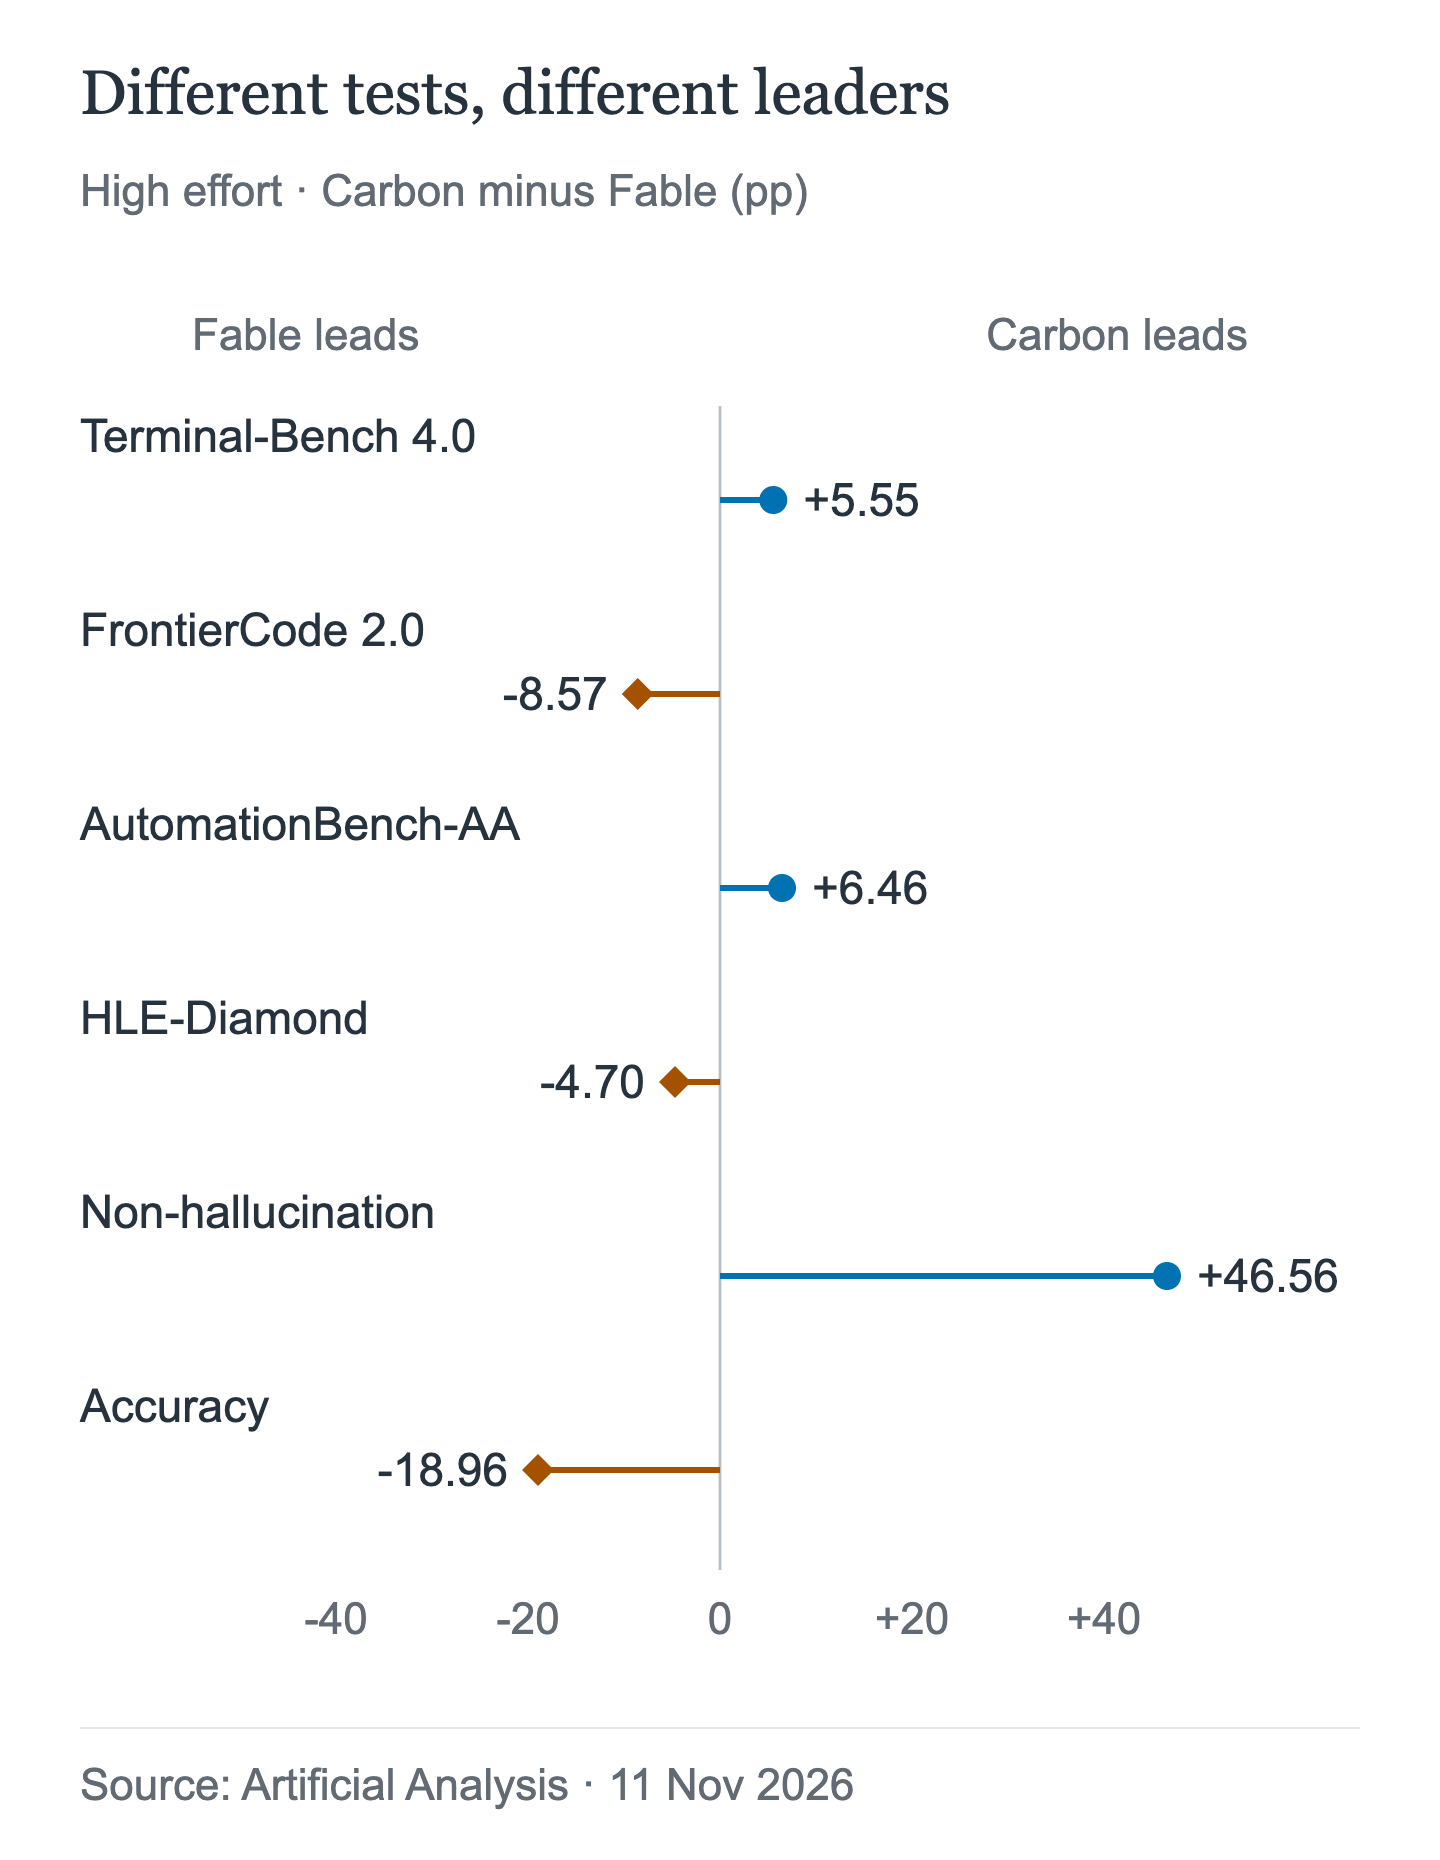
Bunlar bağımsız testlerdeki yüzde puan farklarıdır; birleşik bir kalite puanı değildir. Bir kıyaslamadaki daha büyük fark, genel beceride daha büyük bir iyileşme olduğu anlamına gelmez. Özellikle halüsinasyonsuzluk ve doğruluk farklı sonuçları ölçer.
Fable, High düzeyinde FrontierCode 2.0'da 8.57 puan, HLE-Diamond'da ise 4.7 puan farkla önde; Briefcase Elo puanı 1610.6'ya karşı 1677.4. Zorlu ve birden çok dosyada değişiklik gerektiren kodlama görevlerine en yakın kıyaslama FrontierCode'dur. Carbon, Terminal-Bench 4.0'da 5.55, AutomationBench'te ise 6.46 puan farkla önde; bu testler komut satırında çalıştırma, toparlanma ve otomasyonu ödüllendirir.
Halüsinasyonsuzluk farkı tablodaki en büyük fark: High düzeyinde Carbon %88.58, Fable ise %42.02. Doğrulukta durum tersine dönüyor: %58.27'ye karşı %77.23. Carbon'ın uydurma bilgi üretme olasılığı daha düşük, ancak doğru yanıt verme olasılığı da daha düşük. Bir API'yi uydurmaması gereken ajan için bu önemli olabilir; yanıt vermesi gereken bir ajan içinse Fable'ın doğruluğu daha iyi bir göstergedir.
Daha fazla akıl yürütme her zaman daha iyi sonuç vermez: Fable Max'in FrontierCode puanı 48.76 ile High'ın 49.13 puanının biraz altında kalıyor; Terminal-Bench puanı ise 59.6'da sabit.
Anthropic'in kendi tablosu
Anthropic'in lansman sayfasında Carbon'ın da yer aldığı, farklı sağlayıcıları karşılaştıran bir tablo yayımlandı. Ayarları AA'nınkilerden farklı: Fable, bildirilen en yüksek akıl yürütme düzeyi olan Xhigh'ta; Carbon ise Medium düzeyinde çalıştırılıyor. Bu tabloyu yalnızca kendi içinde değerlendirin.
| Kıyaslama | Fable 5.2 | Carbon |
|---|---|---|
| FrontierCode 2.0 | 49.1 | 41.1 |
| FrontierSWE v2 | 69.9 | 61.2 |
| AutomationBench | 51.4 | 53.9 |
| TB-Science 0.1 | 74.6 | 64.8 |
| OSWorld 2.1 | 89.3 | 81.5 |
| Briefcase Elo | 1785 | 1611 |
| Chartography | 73.4 | 72.5 |
Not: Anthropic'in kendi bildirdiği sonuçlar. Fable, mevcut en yüksek akıl yürütme düzeyi olan Xhigh'ta; Carbon ise Medium düzeyinde çalıştırıldı. Anthropic'in AutomationBench ölçeği AA'nınkinden farklıdır (51.4/53.9'a karşı 71.36/77.82); bu nedenle bu tablo içinde karşılaştırın. Carbon'ın FrontierCode puanı olan 41.1, Medium düzeyinde yapılan bir çalıştırmadır; AA'daki 40.56 ise farklı bir test düzeneğinde High düzeyinde alınmıştır.
Sonuçların yönü AA'yla örtüşüyor: Fable, FrontierCode, FrontierSWE, OSWorld ve TB-Science'ta önde; Carbon, AutomationBench'te 2.5 puan farkla önde. Bu fark AA'daki 6.5 puandan küçük, ancak sonuç aynı yönde. Tablo, “Carbon otomasyonda rekabetçi” iddiasını destekliyor; “Carbon zorlu kodlama için daha iyi model” iddiasını değil.
Anthropic'in kendi önerisi, “Fable yükseltmedir” fikrini karmaşıklaştırıyor: “Çoğu kodlama ve bilgi görevi için kullanıcılara Claude Opus 5.5 ile başlamalarını öneriyoruz.” Şirketin belirttiğine göre Fable, High düzeyinde Opus 5.5'in en iyi sonucuyla yaklaşık aynı puanı alıyor (%45.3'e karşı %45.5) ve görev başına maliyeti yaklaşık yarısı.
Token maliyeti
| Model | Girdi | Çıktı | Önbellek okuma |
|---|---|---|---|
| Carbon, 30 Kasım'a kadar | $2 | $10 | $0.10 |
| Carbon, 1 Aralık'tan itibaren | $4 | $20 | $0.20 |
| Fable 5.2 | $8 | $40 | $0.20 |
| Opus 5.5 | $4 | $20 | $0.20 |
Not: Resmî fiyatlarla 1M token başına USD. Fable önbellek yazma ücretleri: $10 (5 dk.) veya $16 (1 saat); Batch'te %50 indirim. Carbon için belirtilen değer, önbellekten okuma fiyatıdır; Opus 5.5'in resmî önbellek okuma fiyatı $0.20'dır.
Fable'ın token fiyatı, Carbon'ın standart fiyatının iki katı; tanıtım fiyatının ise dört katı. Oran basit, ancak görev başına fatura öyle değil. AA, $4/$20 fiyatıyla Carbon High için görev başına $7.76, Fable High içinse $9.08 ölçtü; aradaki fark %17.0. Google'ın $2/$10 fiyatıyla aynı kullanım yaklaşık $3.88 tutuyor; bu hesaplanmış bir tahmin. 30 Kasım'a kadar Fable High, görev başına yaklaşık 2.3 kat daha pahalı; 1 Aralık'tan itibaren fark yeniden %17.0 olacak.
Standart fiyatlarla Fable Medium, token fiyatı iki kat yüksek olmasına rağmen Carbon'ın $6.59'ına karşılık $3.80 tutarak %42 daha ucuz. Carbon 23.3 dakika sürüyor ve daha fazla token harcıyor; Fable ise 7.8 dakika sürüyor. Tanıtım fiyatıyla Carbon Medium yaklaşık $3.30 tutuyor; aynı yöntemle hesaplanan bu tahmin, Fable'ın fiyatına yakın. Bu avantaj 1 Aralık'ta ortadan kalkıyor.
Max, görev başına Carbon High'ın 3.4 katına ($26.54) mal oluyor ve 45.2 dakika sürüyor. Daha fazla harcama, her bakımdan daha iyi bir kodlama ajanı sunmuyor: Max'in FrontierCode puanı High'ın biraz altında.
AIHubMix, Carbon'ı Google'ın tanıtım fiyatıyla listeliyor. Buradaki Fable fiyatları Anthropic'in resmî ücretleridir.
Dağıtım kararlarını belirleyen davranış farkları
| Boyut | Carbon | Fable 5.2 |
|---|---|---|
| Maksimum çıktı | 65,536; yerel en fazla 1,048,576−girdi* | 128,000 |
| Bağlam | 1,048,576 (Google yerel) | 1M |
| Düşünme | düşük / orta / yüksek; varsayılan orta | uyarlamalı; varsayılan yüksek |
| Zorunlu araçlar | auto belgelenmiş* | any / araç 400 döndürür |
| Örnekleme | yok sayılır; kaldırın | bazı değerler 400 döndürür |
| Veri saklama | sınır olarak belirtilmemiş | 30 gün; ZDR yok |
| Girdi | AIHubMix'te metin | metin, görsel, PDF† |
| Bilgi kesim tarihi | Mart 2026 | Haziran 2026 |
Not: *Carbon'ın daha yüksek sınırları, Google'ın yerel uzun çözümleme özellikleridir; AIHubMix şu anda yalnızca metin girdisini ve Chat Completions'ı belgeliyor, dolayısıyla ağ geçidi desteği doğrulanmamıştır. †Fable'ın girdi biçimleri AIHubMix model dizininden alınmıştır. *AIHubMix tool_choice="auto" kullanımını belgeliyor, ancak Carbon'a özel destek doğrulanmamıştır. Fable'ın belgelenmiş model sınırı 128,000 çıktı token'ıdır. ZDR, sıfır veri saklama anlamına gelir.
Fable'da zorunlu araç kullanımı kesin bir engeldir: “Zorunlu araç kullanımı (tool_choice türleri any ve tool) 400 hatası döndürür.” Her turda belirli bir aracı çağırması gereken bir ajan, Fable'ı olduğu gibi kullanamaz. Google'ın Carbon kılavuzu, araç yürütme turlarının sıralı olmasını öneriyor; AIHubMix'in Gemini kılavuzu tool_choice="auto" kullanımını belgeliyor, ancak ağ geçidinde Carbon'a özgü araç desteği doğrulanmamış durumda.
Veri saklama, Fable için bir politika engelidir. Modelin genel bakış sayfasında, “Anthropic tarafından açıkça yetkilendirilmediği sürece 30 günlük veri saklama gerektirdiği ve sıfır veri saklama kapsamında kullanılamadığı” belirtiliyor. Burada incelenen Carbon belgelerinde böyle bir kısıt belirtilmiyor; ancak bu bir garanti değildir. Düzenlemeye tabi sektörlerdeki ekipler, dağıtımdan önce her iki politikanın da doğruluğunu teyit etmelidir.
Carbon'ın standart 65,536 token sınırı çoğu düzenlemeyi karşılar; ancak dosyanın tamamını oluşturmak bu sınırı aşabilir. Google'ın yerel arka plan modu, girdi çıkarıldıktan sonra 1,048,576 token'a kadar çıkabilir; segment geçişleri ücretlendirilir ve ücret alınmaya devam ederken metni boş olan incomplete durumunu döndürebilir. AIHubMix bu yöntemi belgelemedi. Fable'ın 128,000 token'lık çıktısı tek yanıtta gelir.
Her iki modelde de düşünme devre dışı bırakılamaz. Carbon düşük, orta ve yüksek seçeneklerini sunuyor; varsayılanı orta ve örnekleme parametrelerini yok sayıyor. Fable'da “uyarlamalı düşünme her zaman açık ve kapatılamaz”; varsayılanı yüksek ve bazı örnekleme değerleri için 400 hatası döndürüyor.
Google, genel kullanıma sunulmadan önce Fairwind programı aracılığıyla Carbon'ı savunma ekiplerinin kullanımına açtı. Fable'ın sınıflandırıcıları sızma testi ve istismar taleplerini engelliyor; siber güvenlik ve biyoloji çalışmalarında ise diğer modellere geçiyor. Güvenlik testlerinde ret davranışı, bir kıyaslama satırındaki puandan daha önemlidir.
Referans sütunu olarak Opus 5.5
Opus 5.5 rakip model değil, ancak Anthropic'in kendi referans modeli. $4/$20 fiyatıyla AA'da 59.11 puan alıyor, görev başına $10.04 tutuyor, görevi 25.0 dakikada tamamlıyor ve ilk token için 356.4 saniye bekletiyor; tablodaki en yavaş model (AA satırında Max düzeyi kullanılmış, varsayılan düzey ise Medium). Briefcase Elo'da 1800.6 puanla önde; ancak FrontierCode'da Fable High'ın, Terminal-Bench'te ise Carbon High'ın gerisinde kalıyor. Yine de Anthropic, çoğu kodlama görevi için Opus 5.5 ile başlanmasını öneriyor.
Hangisini kim seçmeli?
Zorlu kod değişiklikleri ön plandaysa ve ölçümlerde FrontierCode ile HLE'de en iyi sonuçları istiyorsanız Fable 5.2'yi seçin. Medium düzeyinde daha ucuz ve hızlıdır: Carbon'ın $6.59 ve 23.3 dakikasına karşılık $3.80 tutar ve 7.8 dakika sürer; ancak Carbon, AA indeksinde daha yüksek puan alır. Görsel girdisi, Haziran 2026 bilgi kesim tarihi arıyorsanız veya 30 günlük veri saklama ile zorunlu araç çağrılarının olmaması sizin için uygunsa Fable'ı tercih edin.
Terminal işlerinin ağırlıkta olduğu durumlarda Carbon’ı seçin: test-düzeltme döngüleri, kabuk otomasyonu ve çok adımlı işlemler. Listelenen Terminal-Bench 4.0 ve AutomationBench-AA satırlarında daha yüksek puan alıyor; ayrıca 30 Kasım’a kadar High akıl yürütme düzeyinde daha ucuz. Google’a özgü bağlamı ve uzun çıktı sınırları AIHubMix üzerinden doğrulanmadı; Carbon’ın araç desteğini doğruladıktan sonra yalnızca metinle ve tool_choice="auto" kullanarak devreye alın. Halüsinasyon yapmama puanı daha yüksek, doğruluğu ise daha düşük.
Anthropic’in önerdiği başlangıç noktası ve dengeli bir profil için Opus 5.5’i seçin; Max akıl yürütme düzeyinde ilk token’ın yavaş gelmesini göze alın.
Etkileşimli gecikme için ikisini de seçmeyin: High akıl yürütme düzeyinde ilk token Fable’da 30.4 saniye, Carbon’da 67.1 saniye sürüyor; Carbon Medium’daki 23.2 saniye bile sohbet hızı için hâlâ çok uzun.
İkisini de AIHubMix üzerinden çalıştırın
AIHubMix, her iki modeli de tek bir anahtarın ve ortak bir sohbet tamamlama uç noktasının arkasında sunuyor. Carbon’ın kimliği gemini-4-carbon; model sayfasında sohbet tamamlamaları, metin girdisi ve Google’ın tanıtım fiyatı belgeleniyor. Fable 5.2’nin kimliği claude-fable-5-2; AIHubMix, Sohbet Tamamlamaları, Responses ve Anthropic Messages’ı; ayrıca 1M bağlamı ve 128K maksimum çıktıyı listeliyor. Carbon’ın belgelenen arayüzü daha sınırlı: yerel Gemini API’si değil, sohbet tamamlamaları. Ağ geçidi ayrıca bir sonraki en iyi sağlayıcıyı yeniden denediğinden, davranış tek sağlayıcılı bir dağıtımdan farklı olabilir.
Hızlı başlangıç kimlik doğrulama ve temel URL’yi açıklıyor. Bir duman testi, her iki kimliğin de aynı anahtar üzerinden çözümlenip çözümlenmediğini kontrol edebilir; bu taslak için canlı test yapılmadı:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://aihubmix.com/v1",
    api_key=os.environ["AIHUBMIX_API_KEY"],
)

for model in ("gemini-4-carbon", "claude-fable-5-2"):
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Reply with OK."}],
        max_tokens=4096,
    )
    print(model, response.choices[0].message.content)
Bu, yeteneği değil yönlendirmeyi kontrol eder: araç yok ve uzun çıktı yok. Gerçek bir karşılaştırma için aynı aracı izini her iki kimlikle çalıştırın ve görev süresini, token kullanımını ve hataları kaydedin. Karşılaştırma sayfasında bağlam, protokoller ve fiyatlar yan yana gösteriliyor.
SSS
Agentic coding için Gemini 4 Carbon, Fable 5.2’den daha mı iyi?
İşin her bölümünde tek bir model öne çıkmıyor. High akıl yürütme düzeyinde Fable 5.2, FrontierCode 2.0’da ve genel endekste lider; Carbon ise Terminal-Bench 4.0 ve AutomationBench’te önde. Seçiminizi aracının gerçekte çalıştırdığı iş yüküne göre yapın.
Fable 5.2 neden Carbon’ın dört katı fiyatında?
Resmî fiyatlarda Fable’ın milyon token başına ücreti $8/$40, Carbon’ın tanıtım fiyatı ise $2/$10; yani girdi ve çıktıda dört katı. 1 Aralık’tan itibaren geçerli olacak Carbon’ın standart $4/$20 fiyatıyla karşılaştırıldığında ise iki katı.
Fable 5.2, Medium düzeyinde gerçekten görev başına daha mı ucuza geliyor?
Standart fiyatlarda evet: Carbon Medium’un $6.59 tutarına karşılık $3.80; süre de 23.3 dakikaya karşılık 7.8 dakika. Carbon’ın tanıtım token fiyatı aradaki farkı azaltıyor; standart fiyat karşılaştırması ise daha kalıcı olanı.
Fable 5.2 araç çağrısını zorunlu kılabilir mi?
Hayır. Anthropic, any ve tool değerli tool_choice ayarlarının 400 hatası verdiğini belgeliyor. Zorunlu çağrıya ihtiyaç duyan aracıların farklı bir döngü veya farklı bir model kullanması gerekir.
Carbon’ın halüsinasyon yapma olasılığı Fable 5.2’den daha mı düşük?
AA’nın Omniscience halüsinasyon yapmama ölçütüne göre evet: High düzeyinde %88.58’e karşı %42.02. Ancak doğruluğu daha düşük: %77.23’e karşı %58.27; dolayısıyla doğru yanıtı verme olasılığı da daha düşük.
Her iki model de AIHubMix üzerinden tek anahtarla çalıştırılabilir mi?
Evet. Aynı anahtar ve temel URL ile gemini-4-carbon ve claude-fable-5-2’yi kullanın. AIHubMix, Carbon için sohbet tamamlamalarını; Fable içinse sohbet tamamlamalarını, Responses’ı ve Messages’ı belgeliyor.
Okumaya devam edin: Gemini 4 Carbon serisi
- Rakiplerden birini seçmeden önce kardeş modeller arasındaki soruyu netleştirin: Gemini 4 Carbon ve Argon karşılaştırması: Fiyatları Aynı, Carbon Ne Zaman Tercih Edilmeli?
- Carbon’ı iş akışına dahil ettikten sonra ilk 400 hataları ve zaman aşımları genellikle modelden değil, yapılandırmadan kaynaklanır: Gemini 4 Carbon API geçişi: 400 hataları, zaman aşımları ve çıktı sınırları
Kaynaklar
- Gemini 4 Carbon kullanıma sunuldu — Google, 10 Kasım 2026.
- Claude Fable 5.2 — Anthropic, 9 Kasım 2026.
- Claude Fable 5.2 genel bakış — Anthropic belgeleri.
- Gemini 4 Carbon ve Claude Fable 5.2 — Artificial Analysis, 11 Kasım 2026 tarihli anlık görüntü.
- AIHubMix’te Gemini 4 Carbon — model sayfası ve fiyatlandırma.