
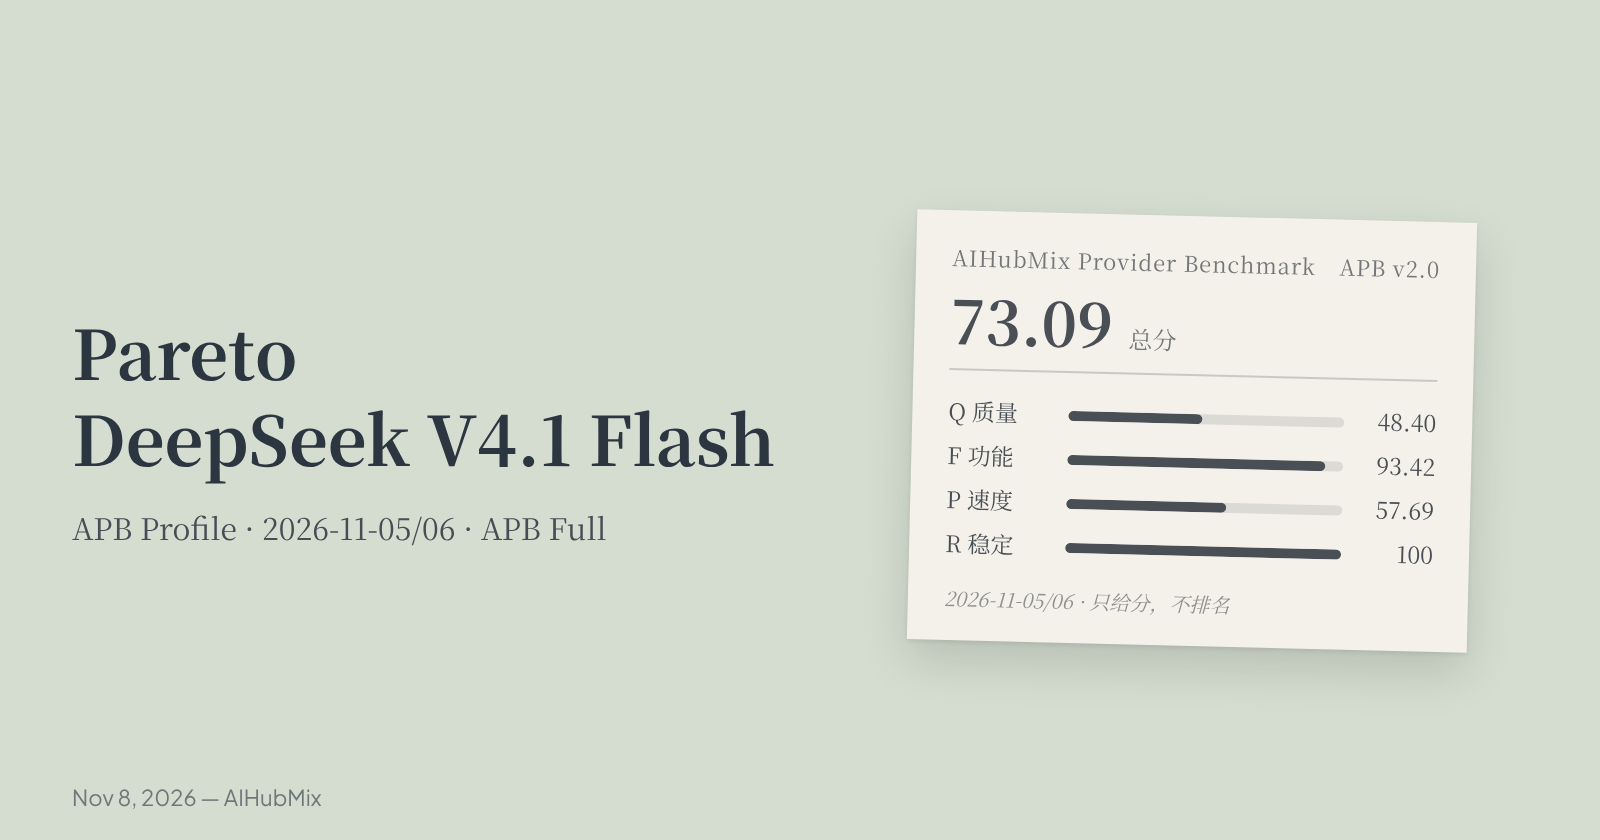
2026-11-05/06 tarihlerinde DeepSeek V4.1 Flash 1017, Pareto üzerinde AIHubMix Provider Benchmark (APB) Full paketinde test edildi. Puanlar Q 48.40, F 93.42, P 57.69, K 27.58 ve R 100; genel endeks 73.09. Bu APB Profili yalnızca Pareto’yu kapsar. Model, DeepSeek V4.1 Flash 1017 olarak listelenmiştir.
Bu yazı yalnızca puanları bildirir; sıralama veya sağlayıcı önerisi içermez. Önce Q, F, P, K ve R gelir; genel endeks ise güven aralığı olmayan bir özet sayıdır. Standart, AIHubMix Provider Benchmark Standard v2.0’dır.
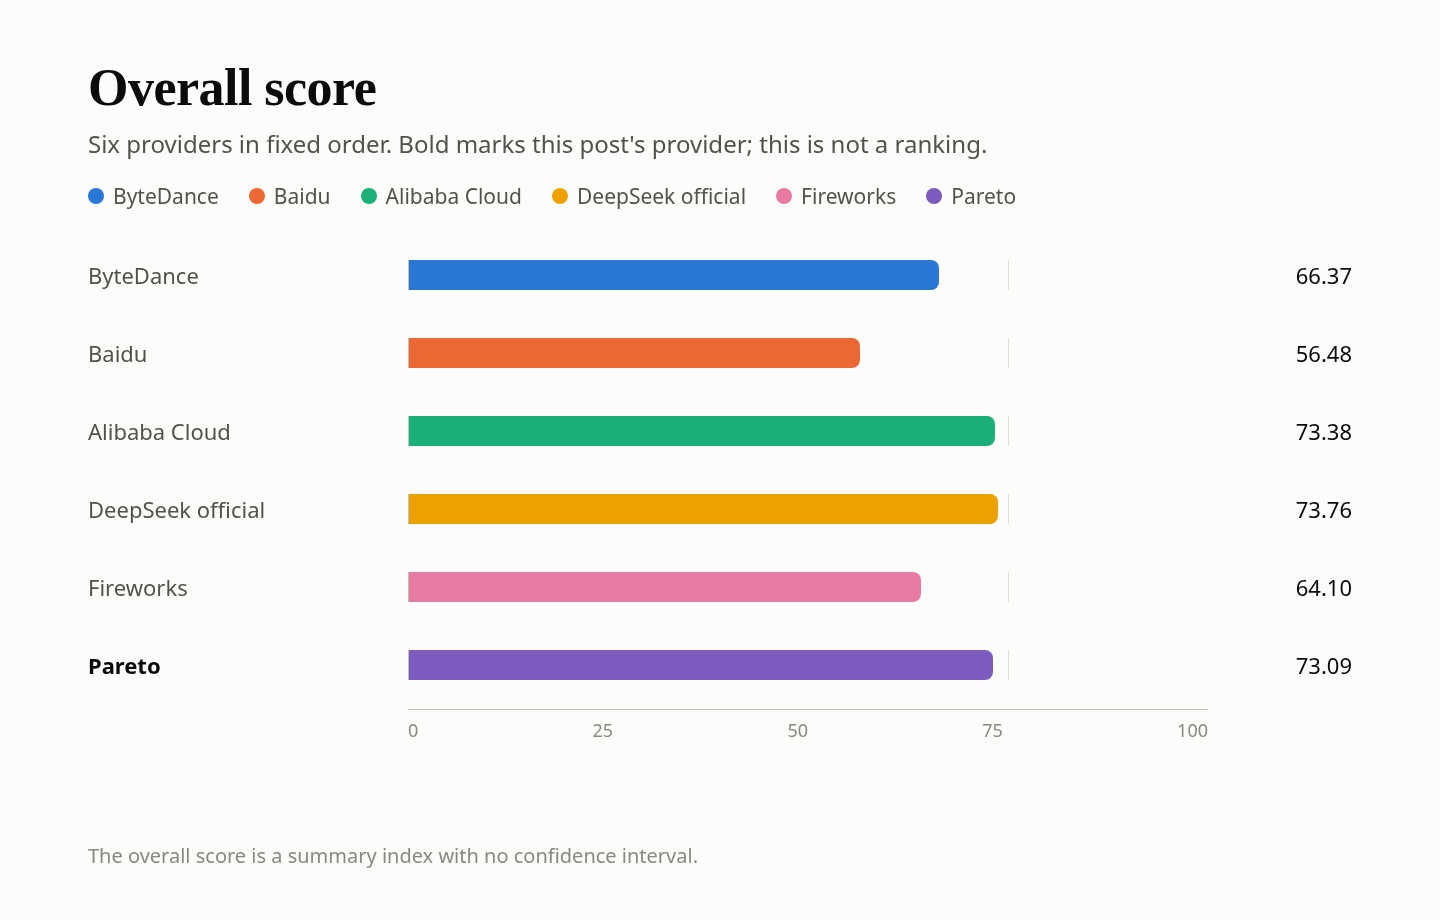
Altı sağlayıcıdaki puanlar
Kalın yazı, bu yazıda ele alınan sağlayıcıyı belirtir. Sabit sağlayıcı sırası kullanılmıştır; sıralama değildir. K, P’nin %20 ağırlıklı alt puanıdır. Genel endeks, güven aralığı olmayan bir özet sayıdır. DeepSeek resmî kanal ile Alibaba Cloud arasındaki fark 0.37’dir ve ayırt edilebilir değildir.
Özet
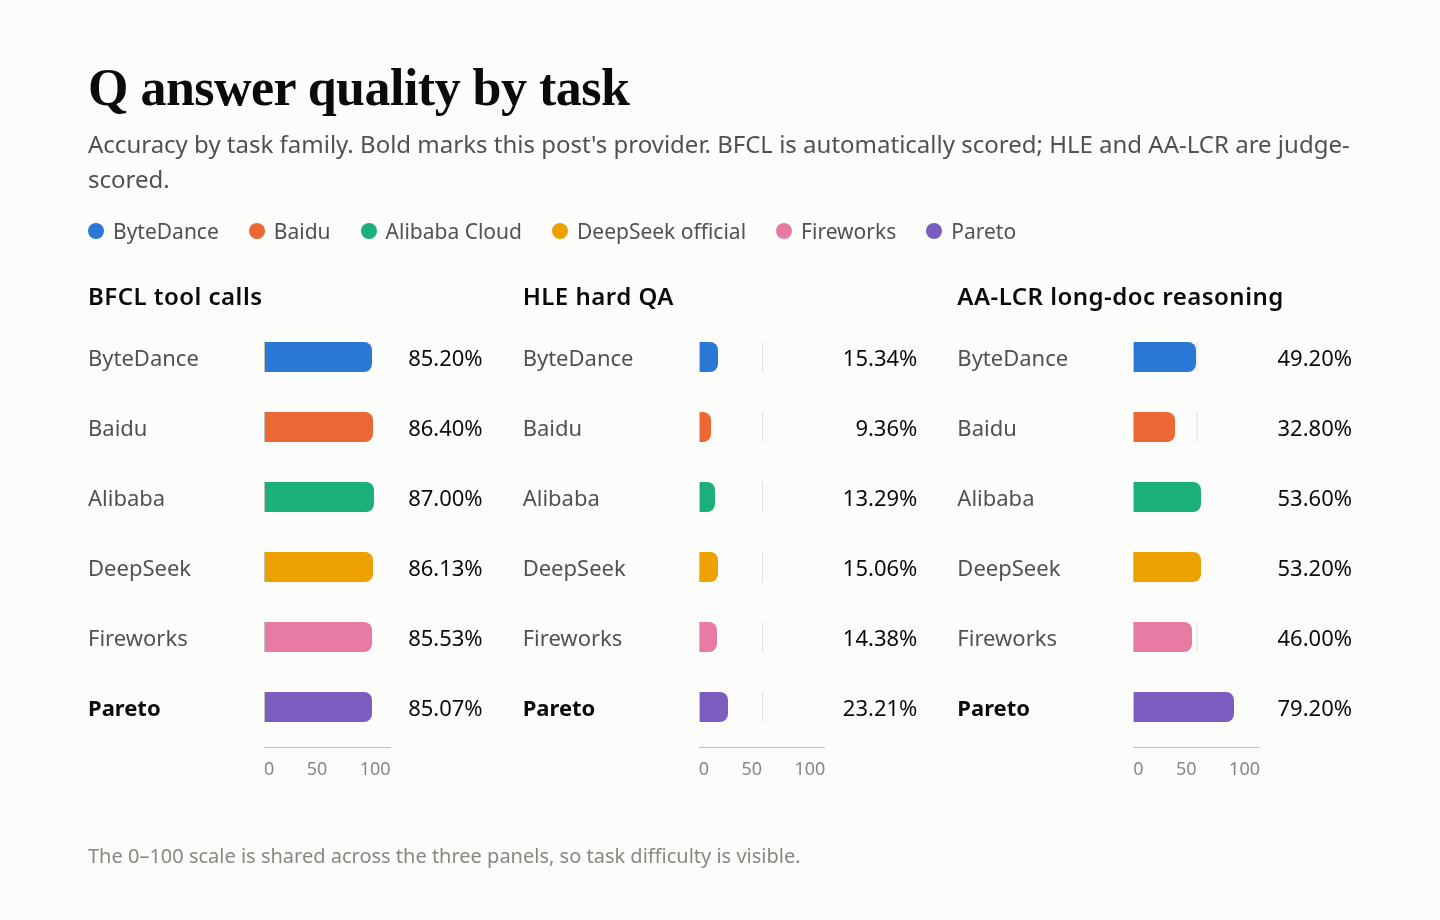
- Q — yanıt kalitesi: 48.40. BFCL %85.07, HLE %23.21, AA-LCR %79.20. Resmî kanala kıyasla: +5.94 yüzde puan; %95 GA +3.54 ile +8.36 arasında. HLE’de 996 hizmet hatası oluştu; çoğu, akıl yürütme çıktının uzunluk bütçesini tükettiği için kesildi ve yanlış olarak sayıldı.
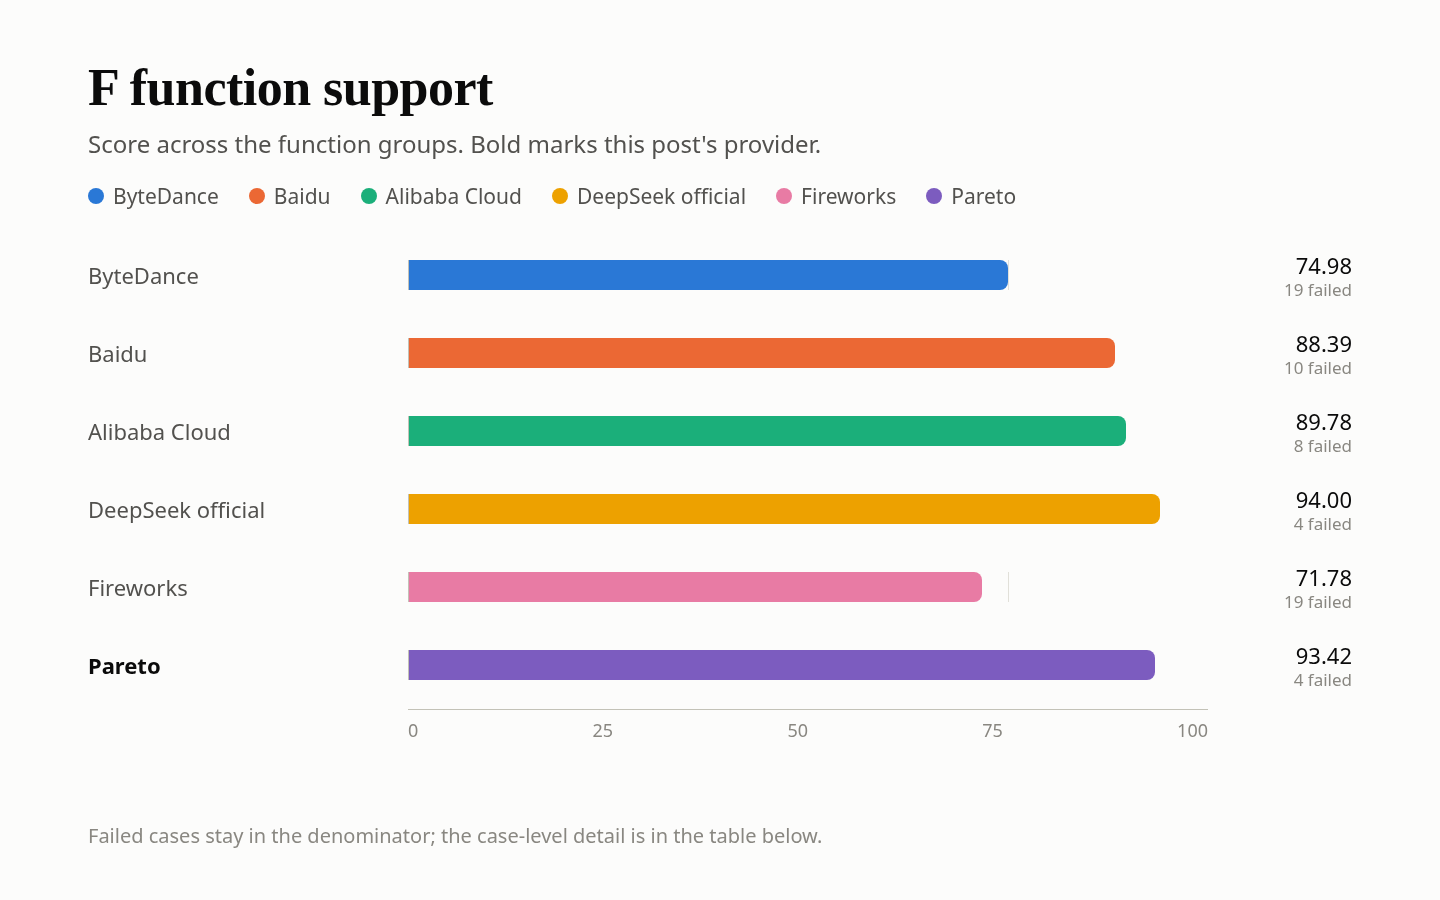
- F — işlev desteği: 93.42. Sayılan 33 kontrolden 29’u başarılı oldu (akış 23/27, hatalar 3/3, ölçümleme 3/3). 147 kontrol paydanın dışında bırakıldı. 4 başarısızlığın 3’ünde stop dizisi istekleri boş gövde döndürdü; 1 akış metni fikstürü tam olarak eşleşmedi.
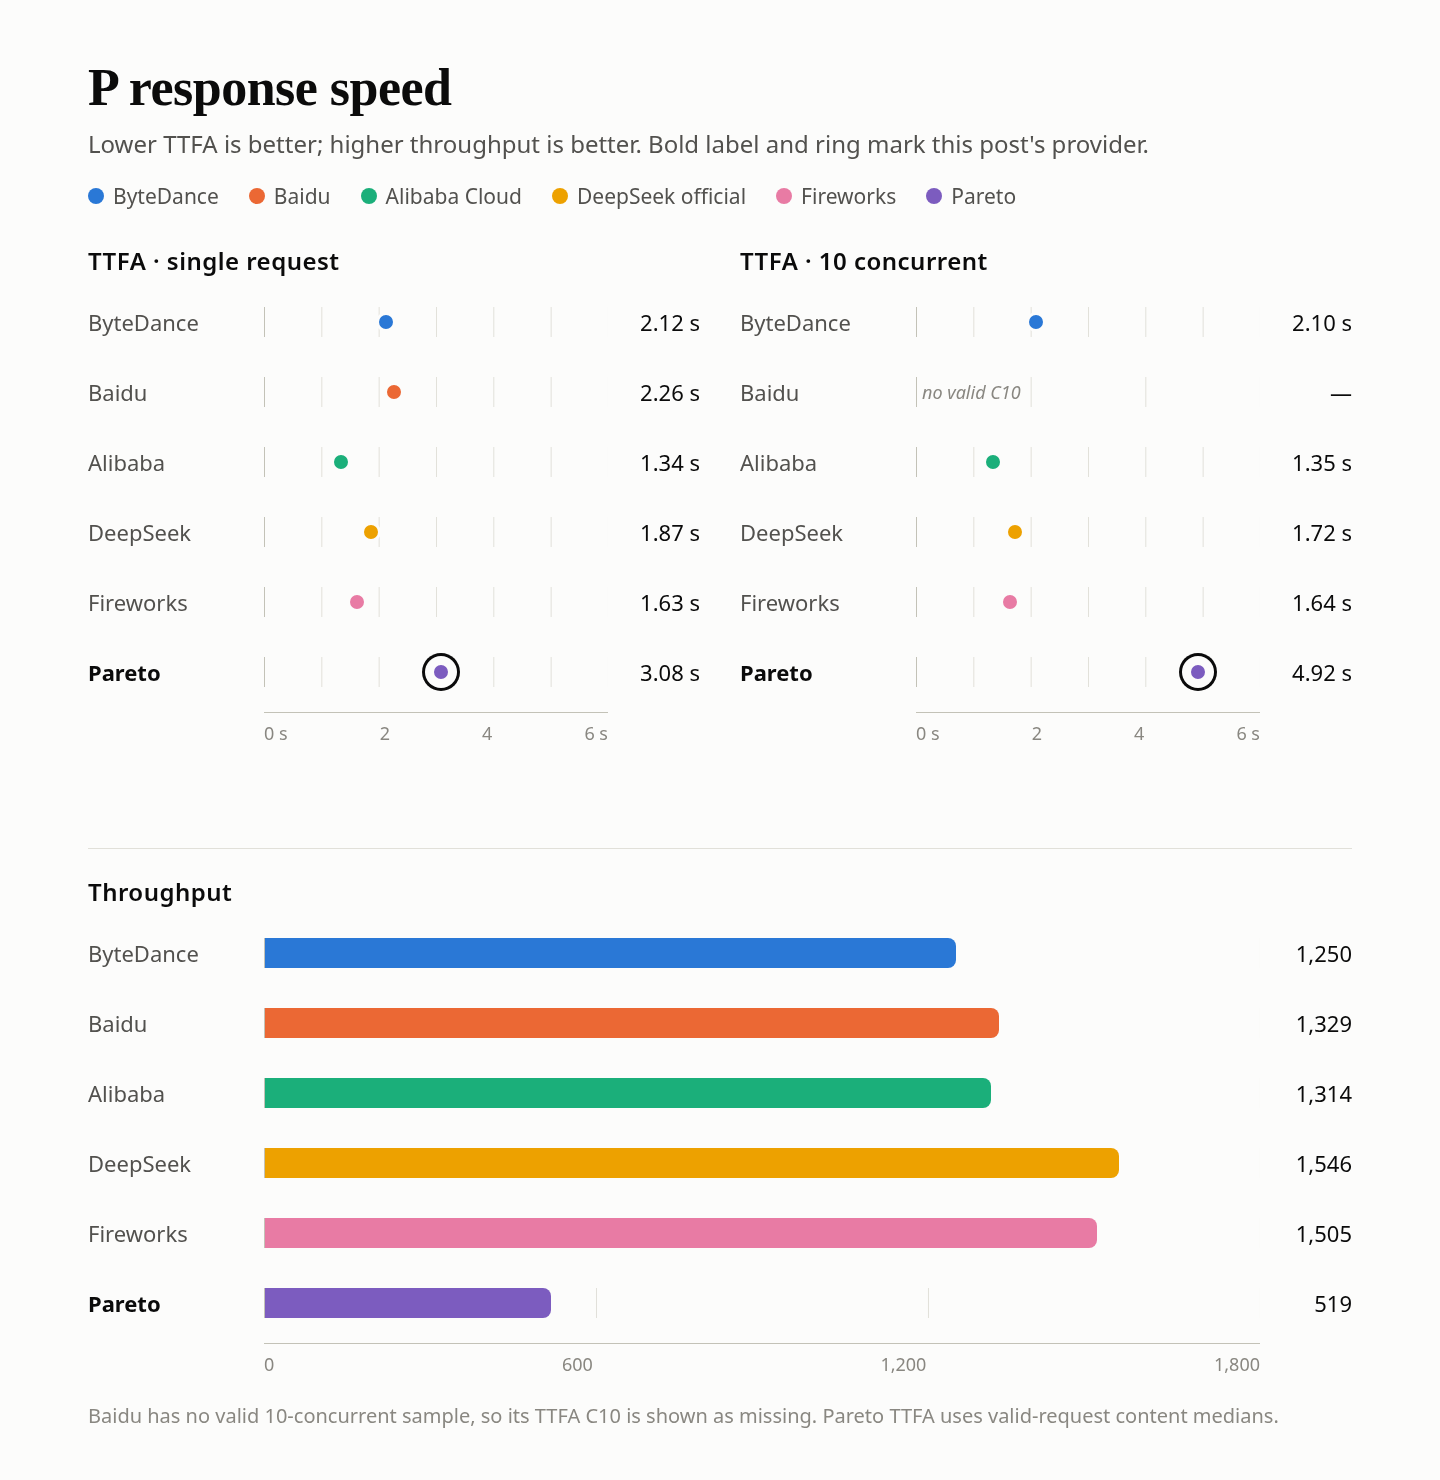
- P — yanıt hızı: 57.69. Yanıt puanı 65.22; önbellek K, %20 ağırlığında. Geçerli isteklerde TTFA medyanları tekli eşzamanlılıkta 3.08 s, 10 eşzamanlı istekte 4.92 s; geçersiz istekleri de içeren puanlama medyanları 5.85 s ve 6.13 s. 180 sorgunun 110’u geçerliydi; 70’i geçersizdi, çünkü akıl yürütme hız testi çıktı bütçesini tüketti.
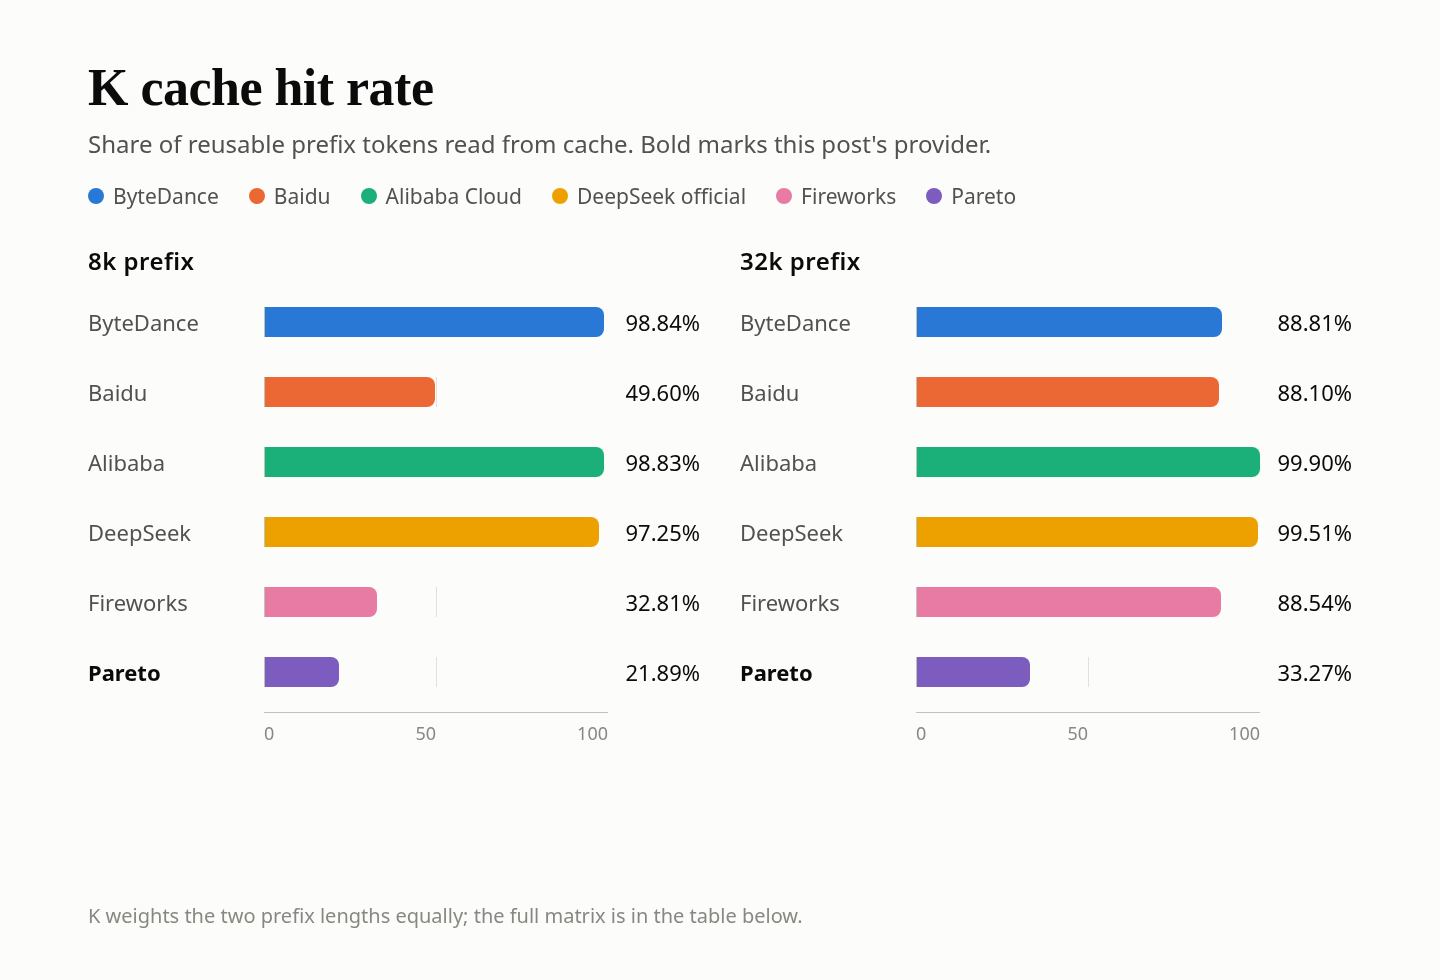
- K — önbellek: 27.58. 8k sıcak 2/9 (okunan 15,872 / yeniden kullanılabilir 72,504); 32k sıcak 3/9 (okunan 96,000 / yeniden kullanılabilir 288,513). Varsayılan yapılandırma üzerinden puanlandı.
- R — hizmet kararlılığı: 100. 300/300 özel istek ilk denemede başarılı oldu.
Test kurulumu
| Öğe | Ayar |
|---|---|
| Model | DeepSeek V4.1 Flash 1017 |
| İstenen model kimliği | deepseek/deepseek-v4.1-flash |
| Erişim rotası | Pareto, yukarıdaki model kimliği kullanılarak |
| Parametreler | temperature 1.0, max_tokens 16,384, timeout 300 s; yalnızca akış istekleri |
| Akıl yürütme | Yüksek yoğunluklu akıl yürütme etkin |
| Zaman | 2026-11-05/06 UTC+8; önbellek, 2026-11-06 tarihinde varsayılan yapılandırmayla yeniden test edildi |
| Örnekler | Q 4,250 (BFCL 500×3, HLE 250×10, AA-LCR 25×10); F 60×3; P 90+90; R 300; K 30 |
| Notlar | Bu çalışmada yüksek yoğunluklu akıl yürütme kullanıldı; serideki diğer beş sağlayıcıda kullanılmadı. Özellik desteği, akışın kullanılabildiği alt küme üzerinden puanlanır; önbellek varsayılan yapılandırmayı kullanır. |
İsteklerde AIHubMix hızlı başlangıç kılavuzu kullanıldı; model kimlikleri modeller sayfasında yer alıyor.
Q — yanıt kalitesi: 48.40
Paket, 500 BFCL sorusunu × 3 tur, 250 HLE sorusunu × 10 ve 25 AA-LCR sorusunu × 10 çalıştırdı. BFCL otomatik puanlandı; HLE ve AA-LCR, deepseek-flash tarafından değerlendirildi. Üç görev ailesinde diğer sağlayıcılarla aynı öğeler kullanıldı. Puanlanamayan on yanıt çıkarıldı ve geriye puanlanan 4,240 örnek kaldı.
| Görev | Soru sayısı | Doğru | Doğruluk | Hatalar |
|---|---|---|---|---|
| BFCL araç çağrıları | 500 × 3 | 1,276/1,500 | 85.07% | 0 |
| HLE zor soru-cevap | 250 × 10 | 578/2,490 | 23.21% | 996 |
| AA-LCR uzun belge akıl yürütme | 25 × 10 | 198/250 | 79.20% | 0 |
| Toplam · %95 GA 45.39%–51.26% | — | 2,052/4,240 | 48.40% | 996 |
Hatalar paydada yanlış yanıt olarak tutulur: HLE’de 996 yanıt, akıl yürütme çıktı uzunluğu bütçesini tükettiği için kesildi. Tam yanıt döndüren 1,494 HLE denemesinin 578’i doğruydu (yaklaşık %38.7).
| BFCL kategorisi | Başarılı | Başarı oranı |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 269/300 | 89.67% |
| parallel | 265/300 | 88.33% |
| parallel_multiple | 203/240 | 84.58% |
| irrelevance | 104/150 | 69.33% |
| ahm_multi_turn | 102/150 | 68.00% |
simple_python 333/360 (%92.50), multiple 269/300 (%89.67), ahm_multi_turn 102/150 (%68.00) ve irrelevance 104/150 (%69.33) başarıyla tamamlandı.
Diğer beş sağlayıcıyla karşılaştırma
Resmî kanala kıyasla yüzde puan cinsinden fark; %95 aralık, hata çubuklarıyla gösterilir. 0’ı kesmesi, farkın ayırt edilemediği anlamına gelir. deepseek-flash değerlendiricisi aynı aileden ve kalibrasyonsuz olduğundan cömert davranabilir.
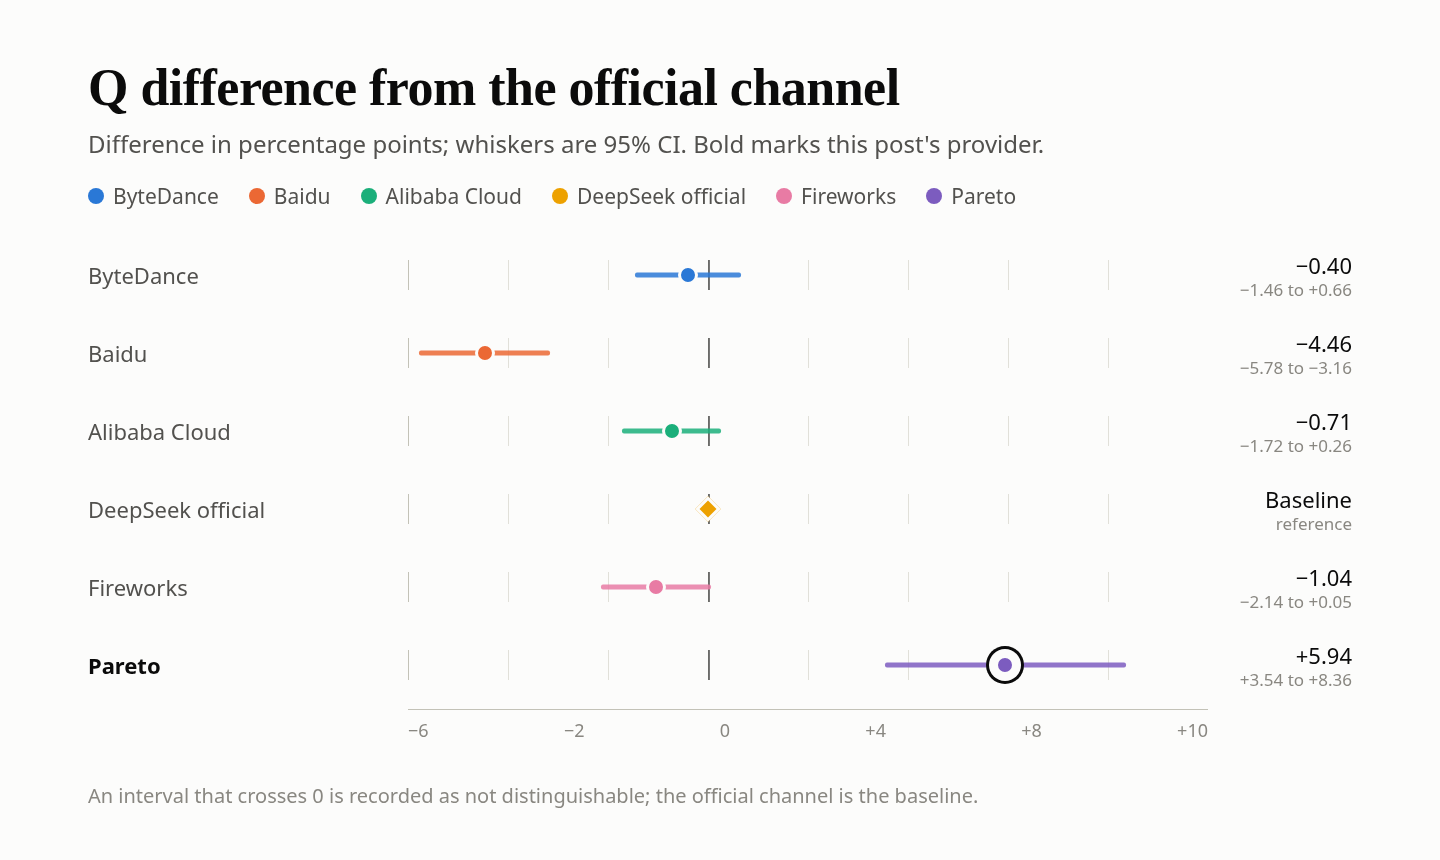
Resmî kanala kıyasla sayısal fark +5.94 (+3.54 ile +8.36 arası).
F — işlev desteği: 93.42
33 kontrol sayıldı, 29’u başarılı oldu; 147’si sayılmadı. 93.42 değeri, gözlemlenen gruplar üzerinden başlangıç grup ağırlıklarını yeniden normalize eder (akış %20, hatalar %15, ölçümleme %10; toplam %45). Basit başarı oranı 29/33, yani %87.88’dir. Araçlar, kısıtlamalar ve bağlam hiç sayılmadı.
| Vaka grubu | Ağırlık | Başarılı | Hariç tutulan | Grup puanı |
|---|---|---|---|---|
| Akış ve mesajlaşma | 20% | 23/27 | 3 | 85.19 |
| Araç arayüzü | 20% | — | 30 | — |
| Çıktı kısıtlamaları | 20% | — | 30 | — |
| Bağlam ve durum | 15% | — | 30 | — |
| Hata ve kurtarma | 15% | 3/3 | 27 | 100.00 |
| Ölçümleme ve önbellek | 10% | 3/3 | 27 | 100.00 |
| Gözlemlenen / ağırlıklı | — | 29/33 | 147 | 93.42 |
“Windows failed”, vakanın başarısız olduğu üç pencereyi sayar.
| Başarısız vaka | Başarısız olan pencereler | Neden |
|---|---|---|
| Akışta stop | 3/3 | Stop ile boş gövde |
| Akış metni | 1/3 | Gövdenin sonunda, fikstürde bulunmayan fazladan nokta |
Diğer beş sağlayıcıyla karşılaştırma
P — yanıt hızı: 57.69
Puanlamada ilk herhangi bir tokenın geliş süresi değil, ilk içerik tokenına kadar geçen süre kullanılır. Akıl yürütme etkin olduğunda model, görünür yanıt metninden önce akıl yürütme içeriği yazar; dolayısıyla içerik bekleme süresi ilk paketi bekleme süresinden uzundur. Üç pencerenin her birinde, 180 toplam istek için tekli eşzamanlılıkta 30 ve 10 eşzamanlı istekte 30 istek gönderildi.
| Metrik | Sonuç |
|---|---|
| İçerik TTFA | Puanlama medyanları: 5.85 s (c=1) ve 6.13 s (c=10); geçerli istek medyanları: 3.08 s ve 4.92 s |
| İlk herhangi bir token | Geçerli istek medyanları: 1.46 s ve 1.76 s |
| TPOT | Daha yavaş puanlama bandı: 4.87 ms/token |
| Goodput | 10 eşzamanlılıkta 519 token/s |
| Geçerli | c=1’de 53/90 ve c=10’da 57/90; toplam 110/180; 70’i geçersiz, çünkü akıl yürütme hız testi çıktı bütçesini (~2,048 token) tüketti |
| Bileşenler | TTFA 24.59, TPOT 100.00, goodput 72.05; yanıt puanı 65.22 |
| P bileşimi | 65.22 × 80% + 27.58 × 20% = 57.69 |
Akıl yürütme tokenları goodput payına dahil değildir.
K — önbellek: 27.58
Toplam okuma değerleri, 2026-11-06 tarihli varsayılan yapılandırmayla yeniden testten alınmıştır. İstek başına önbellek matrisleri dahil edilmemiştir (ham izler taşınmadı). K, iki önek uzunluğuna eşit ağırlık verir; K, P’nin %20’sidir.
| Önek | Sıcak isabetler | Okunan / yeniden kullanılabilir | Bölüm |
|---|---|---|---|
| 8k | 2/9 | 15,872 / 72,504 | 21.89 |
| 32k | 3/9 | 96,000 / 288,513 | 33.27 |
| K (eşit ağırlık) | 27.58 |
Soğuk kontrol istekleri, her uzunlukta 6/6 başarılı oldu.
R — hizmet kararlılığı: 100
300 istek; kısa metin, uzun girdi, araç çağrısı ve çok turlu geçmiş senaryolarını tekli eşzamanlılıkta kapsadı. Yalnızca ilk yanıtın geçerliliği ve eksiksizliği kontrol edildi; yanıtlar puanlanmadı ve hiçbir istek yeniden denenmedi. Q ve P hataları burada tekrar sayılmaz.
| İstek türü | İlk denemede başarı |
|---|---|
| Kısa metin | 120/120 |
| 10k uzun girdi | 90/90 |
| Araç çağrısı | 60/60 |
| Çok turlu geçmiş | 30/30 |
| Toplam · %95 GA 98.78%–100% | 300/300 |
SSS
Q 48.40 neyi kapsıyor?
Puanlanan 4,240 örnek üzerinden BFCL, HLE ve AA-LCR: 2,052 doğru yanıt, %48.40, %95 GA 45.39%–51.26%. Resmî kanala kıyasla sayısal fark +5.94 (+3.54 ile +8.36 arası).
HLE’de neden 996 hizmet hatası oldu?
Çoğu, akıl yürütme çıktı uzunluğu bütçesini tükettiği için kesildi; yanlış yanıt olarak paydada tutuldu.
147 kontrol hariç tutulmuşken F neden 93.42?
Yalnızca akışın kullanılabildiği alt küme sayılır. Grup ağırlıkları gözlemlenen gruplar üzerinden yeniden normalize edilir; araçlar, kısıtlamalar ve bağlam hiç sayılmaz.
Stop vakaları neden başarısız oldu?
Stop dizisi içeren istekler, üç pencerenin tamamında boş gövde döndürdü.
180 hız sorgusunun 70’i neden geçersizdi?
Akıl yürütme, hız testi çıktı bütçesini (yaklaşık 2,048 token) tüketti.
R 100 neyi kapsıyor?
300 özel isteğin tamamı ilk denemede geçerliydi; %95 alt sınırı 98.78%. Q ve P hataları R’de sayılmaz.
Okumaya devam edin: DeepSeek V4.1 Flash serisi
- Akıl yürütme devre dışı bırakıldıktan sonra ByteDance akıl yürütme tokenları bildirdi: ByteDance’te DeepSeek V4.1 Flash: araç çağrıları eşleşiyor, ölçümleme eşleşmiyor
- Baidu, Q 38.00 ve P 37.77 kaydetti: Baidu’da DeepSeek V4.1 Flash: kullanılabilir hiçbir kanal Q ve P’ye ulaşamıyor
- Alibaba Cloud, 1.34 s ilk token ve 99.37 önbellek kaydetti: Alibaba Cloud’da DeepSeek V4.1 Flash: 1.34s ilk token, 99.37 önbellek
- Resmî kanal, Q kıyas noktasıdır ve F puanı 94.00’dır: Resmî kanalda DeepSeek V4.1 Flash: 94.00 F, 15 geçersiz sorgu
- Fireworks, boş stop yanıtları ve 8k’de 3/9 önbellek isabeti döndürdü: Fireworks’te DeepSeek V4.1 Flash: boş stop yanıtları, 3/9 önbellek isabeti


