

03/04.11.2026 tarihlerinde APB Full paketi, AIHubMix üzerinden beş sağlayıcıda DeepSeek V4.1 Flash 1017 ile çalıştırıldı. Her sağlayıcı için aynı model, sorular, parametreler ve istek betikleri kullanıldı; model AIHubMix model sayfasında, beş sağlayıcı girişi ise modeller sayfasında listeleniyor. Bu APB Profili yalnızca Alibaba Cloud’u kapsıyor: her bölümde ne ölçüldü ve sonuçlar ne oldu.
Bu yazı, sağlayıcıları sıralamadan veya birini önermeden puanları bildiriyor. Önce Q, F, P, K ve R geliyor; K, P’nin alt puanıdır. Genel puan bir özet endeksidir, sertifikasyon değildir ve güven aralığı yoktur. Puanlama kuralları AIHubMix Provider Benchmark Standard v2.0’da tanımlanmıştır.
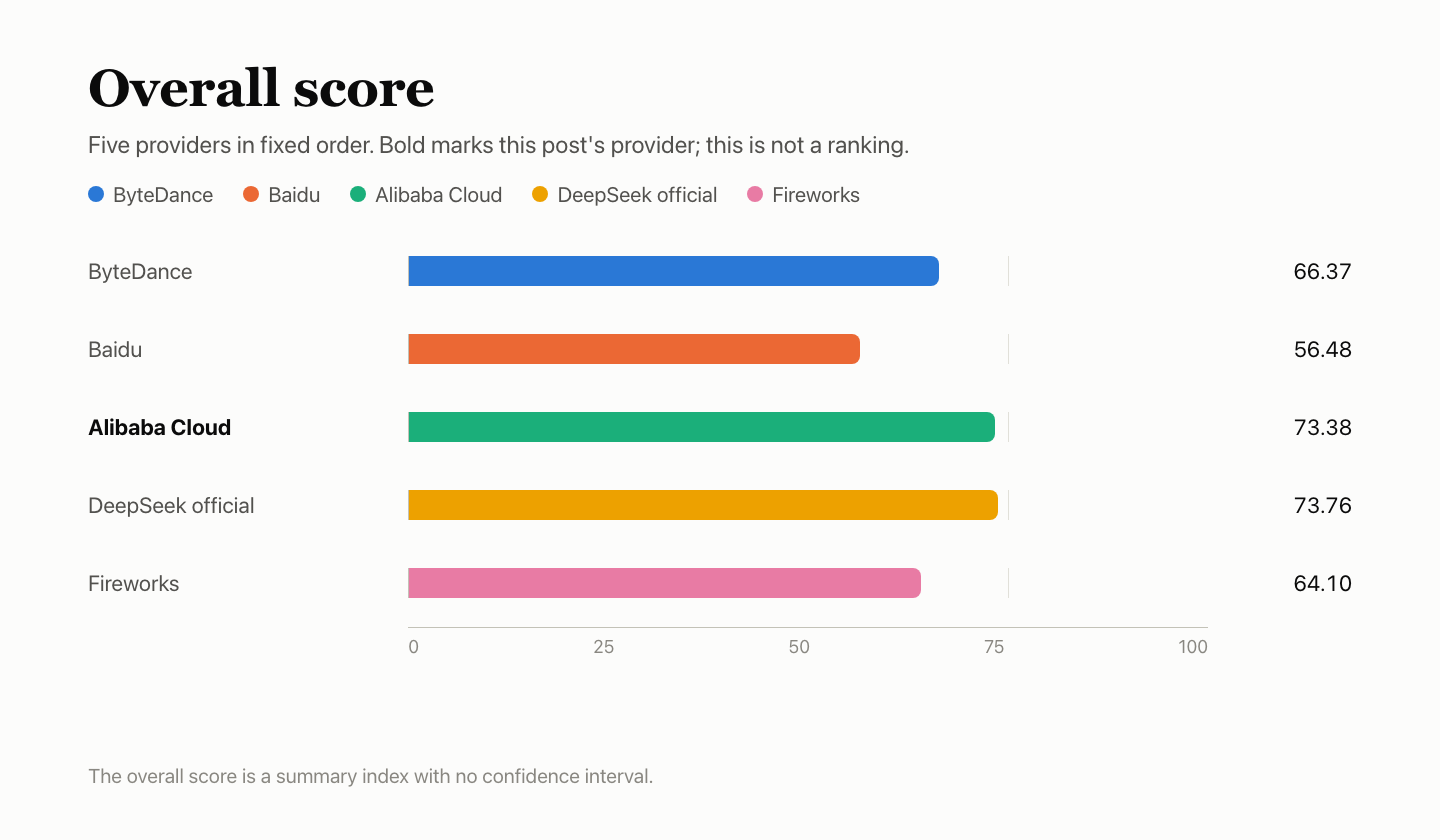
Beş sağlayıcıdaki puanlar
Kalın yazı, bu yazıdaki sağlayıcıyı belirtir. Sağlayıcılar sabit bir sırayla gösterilir; bu bir sıralama değildir. K, P’nin %20’lik alt puanıdır ve referans olması için ayrıca gösterilmiştir. Genel puan, güven aralığı bulunmayan bir özet endeksidir. DeepSeek’in resmî kanalı ile Alibaba Cloud arasındaki genel puan farkı 0.37’dir ve bu iki sağlayıcı birbirinden ayırt edilemez.
Genel bakış
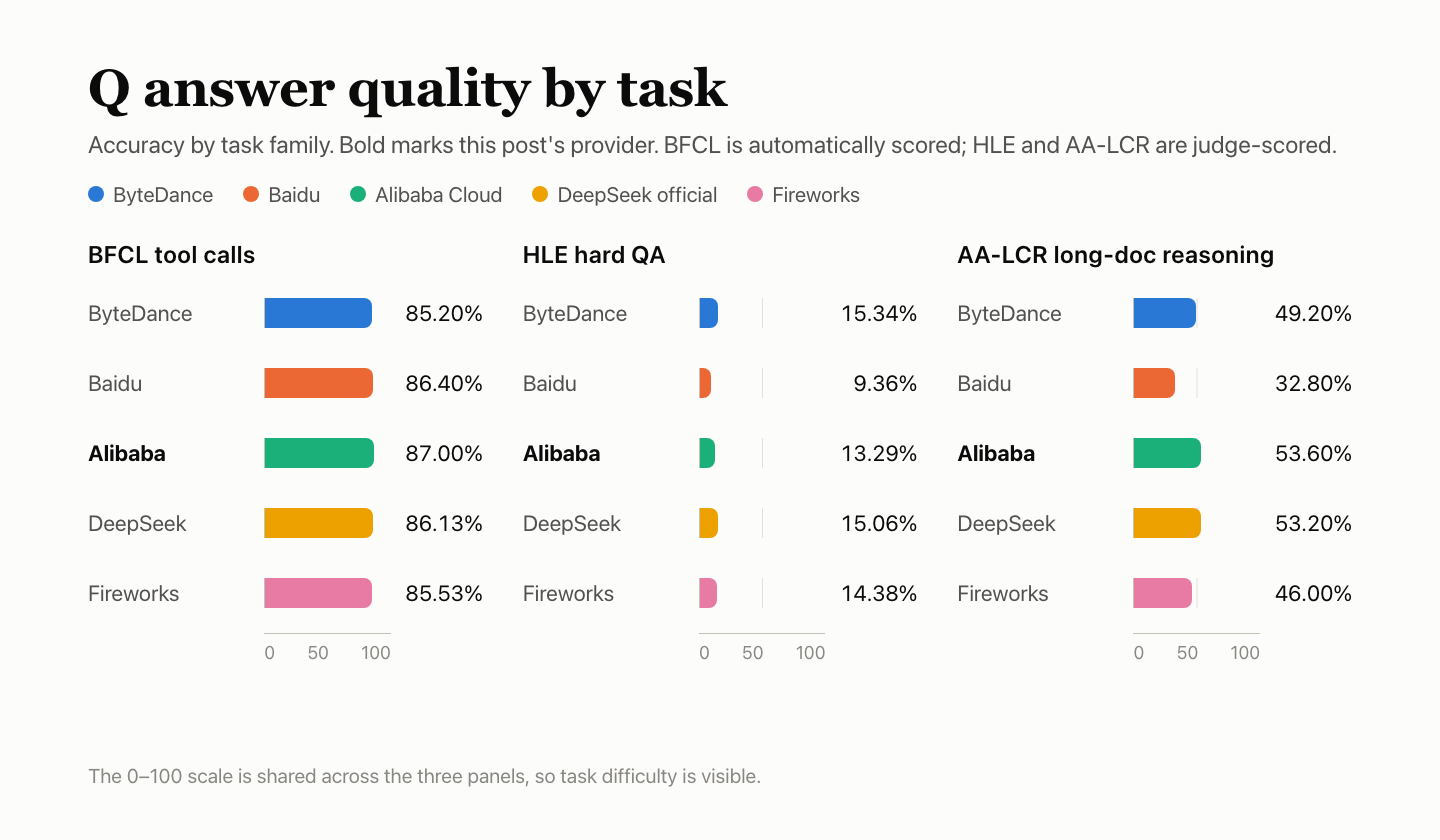
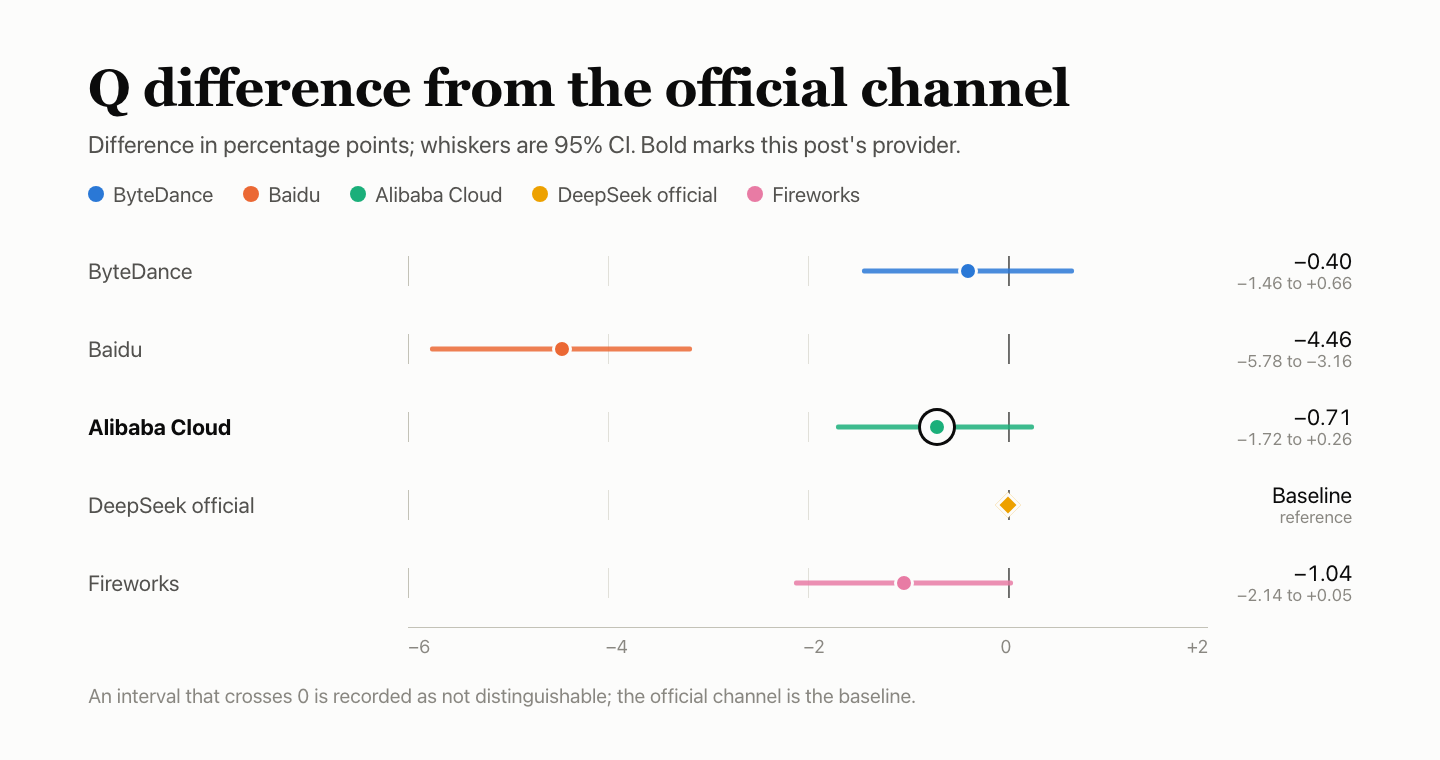
- Yanıt kalitesi: Q 41.75. BFCL %87.00, HLE %13.29, AA-LCR %53.60. Resmî kanalla arasındaki fark −0.71 yüzde puan; %95 güven aralığı −1.72 ile +0.26 arasında, dolayısıyla ikisi birbirinden ayırt edilemiyor.
- İşlev desteği: F 89.78. Paydadaki 177 kontrolün 155’i geçti. Geçersiz bir araç şeması, parametre hatası yerine 503 döndürdü; bağlam taşması belgelenen hata türünü döndürmedi ve tek başına gönderilen bir araç sonucu 200 döndürdü.
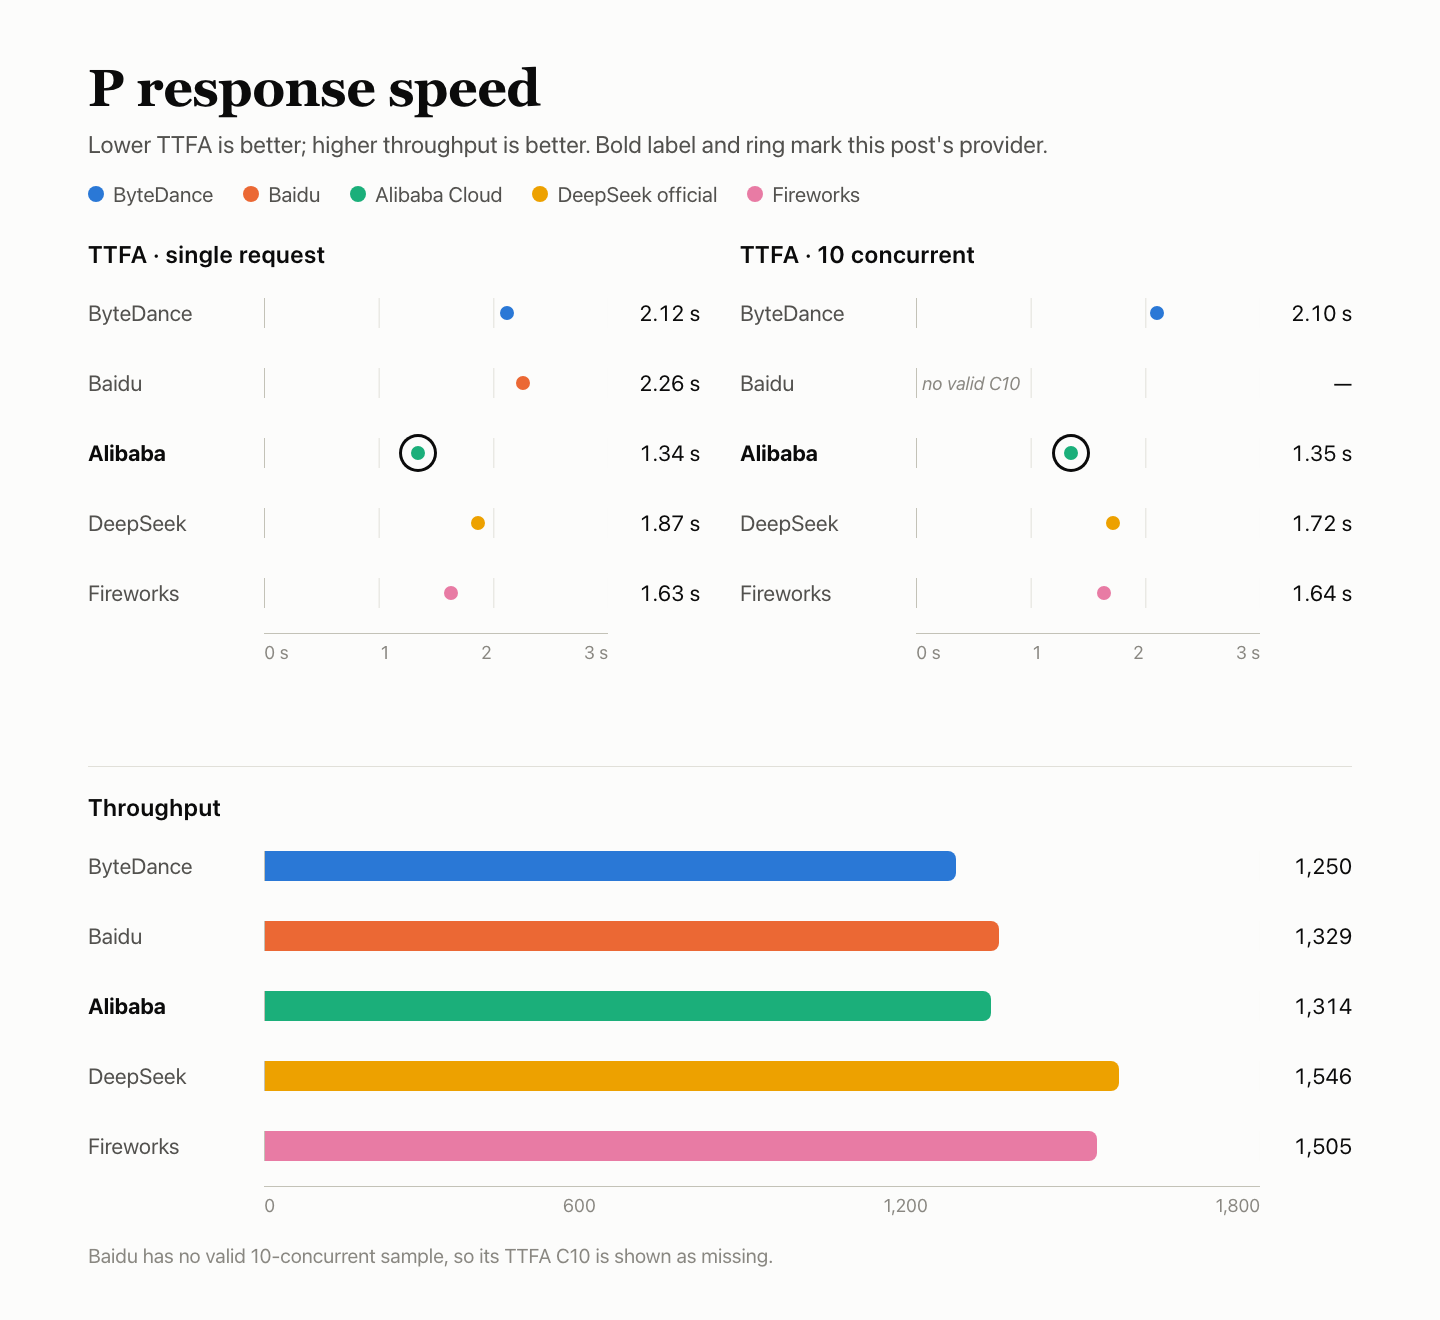
- Yanıt hızı: P 88.58. İlk içerik tokenı medyanı tek eşzamanlılıkta 1.34 s, 10 eşzamanlılıkta 1.35 s; TPOT 4.69 ms oldu ve hız testindeki 180 isteğin tamamı geçerliydi.
- Önbellek: K 99.37. 8k ve 32k öneklerindeki 18 sıcak isteğin tümü önbelleğe isabet etti; soğuk kontrol isteklerinin hiçbiri önbelleği okumadı.
- Hizmet kararlılığı: R 100. Özel olarak gönderilen 300 isteğin tamamı ilk denemede başarılı oldu.
Test kurulumu
Çalıştırma, sağlayıcı model kimliği seçilerek AIHubMix üzerinden yapıldı; hızlı başlangıç ilgili rotayı belgeliyor. DeepSeek’in fiyatlandırma sayfasında modelin yayımlanmış ücretleri listeleniyor.
| Öğe | Ayrıntı |
|---|---|
| Model | DeepSeek V4.1 Flash 1017 |
| İstenen model kimliği | alicloud-deepseek-v4.1-flash-1017 |
| Döndürülen model adı | deepseek-v4.1-flash-1017 |
| Erişim rotası | Sağlayıcının kendi hesabına bağlanmak yerine sağlayıcı model kimliği seçilerek AIHubMix üzerinden |
| Parametreler | Akıl yürütme modu kapalı, temperature 1.0, max_tokens 16,384, zaman aşımı 300 s, otomatik yeniden deneme yok |
| Akıl yürütme kapalı | Tüm isteklerde reasoning_effort=none kullanıldı |
| Zaman | 2026-11-03 18:07 – 11-04 16:33 UTC+8. Beş sağlayıcı aynı Mac mini’yi, ağı ve hesabı paylaştı. |
| Örnekler | Yanıt kalitesi: 4,250 soru-çalıştırması (BFCL 500 × 3 tur, HLE 250 × 10, AA-LCR 25 × 10); işlev testleri: 60 × 3 zaman aralığı; hız: tek eşzamanlılıkta 90, 10 eşzamanlılıkta 90; kararlılık: 300; önbellek: 30 (8k ve 32k önekler, her biri 3 grup) |
Q — yanıt kalitesi: 41.75
Yanıt kalitesi üç soru kümesiyle ölçüldü: her biri 3 turda çalıştırılan 500 BFCL sorusu, her biri 10 turda çalıştırılan 250 HLE sorusu ve her biri 10 turda çalıştırılan 25 AA-LCR sorusu. BFCL, otomatik kurallarla puanlandı; HLE ve AA-LCR ise deepseek-flash değerlendirici modeliyle değerlendirildi. Beş sağlayıcının tümü aynı soruları yanıtladı ve üç küme tek bir doğruluk oranında birleştirildi. Sorular puanlanamadığı için on yanıt çıkarıldı; geriye puanlanan 4,240 soru-çalıştırması kaldı.
| Görev | Sorular | Doğru | Doğruluk | Hatalar |
|---|---|---|---|---|
| BFCL araç çağrıları | 500 × 3 | 1,305/1,500 | 87.00% | 0 |
| HLE zor soru-cevap | 250 × 10 | 331/2,490 | 13.29% | 8 |
| AA-LCR uzun belge akıl yürütme | 25 × 10 | 134/250 | 53.60% | 0 |
| Birleşik · %95 güven aralığı 39.56%–43.85% | — | 1,770/4,240 | 41.75% | 8 |
Hizmet hataları (başarısız istekler veya kesilmiş çıktılar) paydada kalır ve yanlış sayılır; çıkarılmaz. Alibaba Cloud’da HLE çıktısı max_tokens sınırına ulaştı ve 8 kez kesildi.
BFCL’de her soru 3 turda yanıtlanır; tabloda bu 3 turun birleştirilmiş sonuçları gösterilir.
| BFCL kategorisi | Geçen | Geçme oranı |
|---|---|---|
| simple_python: tek işlev, doğru çağrı ve bağımsız değişkenler | 332/360 | 92.22% |
| multiple: birkaç işlev arasından doğru olanı seçme | 270/300 | 90.00% |
| parallel: aynı işlevi birkaç kez paralel çağırma | 273/300 | 91.00% |
| parallel_multiple: birkaç farklı işlevi paralel çağırma | 212/240 | 88.33% |
| irrelevance: hiçbir işlev uygun değil, hiçbiri çağrılmamalı | 113/150 | 75.33% |
| ahm_multi_turn: üç aşamalı araç zinciri | 105/150 | 70.00% |
Diğer dört sağlayıcıyla karşılaştırma
Resmî kanalla karşılaştırma: yüzde puan cinsinden doğruluk farkı; %95 güven aralığı bıyıklarla gösterilmiştir. Aralık 0’ı kesiyorsa fark yok kabul edilir. HLE ve AA-LCR’yi değerlendiren deepseek-flash, test edilen modelle aynı DeepSeek ailesine ait ve kalibre edilmemiştir; bu nedenle puanlaması hoşgörülü olabilir.
F — işlev desteği: 89.78
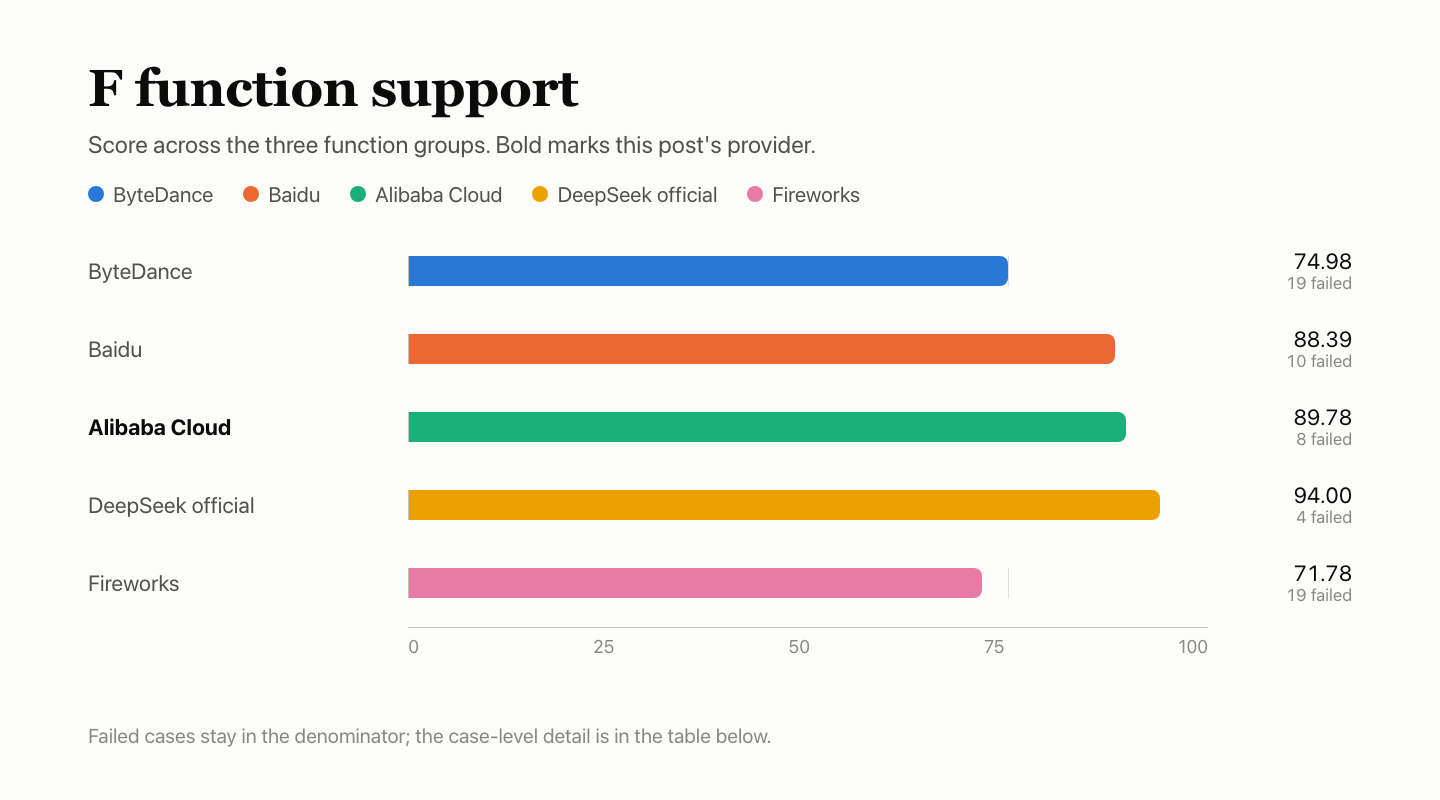
İşlev testleri, modelin ne kadar iyi yanıt verdiğini değil, arayüz davranışının protokole uyup uymadığını kontrol eder. 60 test altı gruba ayrılır ve her biri üç zaman aralığında çalıştırılarak toplam 180 kontrol yapılır; değerlendirme, her sağlayıcının belgelediği biçime göre gerçekleştirilir. Uygulanamaz, geçersiz veya gözlemlenemeyen kontroller paydadan çıkarılır. Alibaba Cloud, paydadaki 177 kontrolün 155’ini geçti; grup ağırlıklarıyla hesaplanan puan 89.78 oldu.
Ağırlıklı puan, 177 üzerinden basit bir geçme sayısıyla değil, grup ağırlıkları kullanılarak hesaplanır.
| Grup | Ağırlık | Geçen | Hariç tutulan | Grup puanı |
|---|---|---|---|---|
| Akış ve mesaj protokolü | 20% | 30/30 | — | 100.00 |
| Araç arayüzü | 20% | 30/30 | — | 100.00 |
| Çıktı kısıtları ve parametreler | 20% | 30/30 | — | 100.00 |
| Bağlam ve durum | 15% | 26/30 | — | 86.67 |
| Hatalar ve kurtarma | 15% | 18/30 | — | 60.00 |
| Ücretlendirme ve önbellek protokolü | 10% | 21/27 | 3 | 77.78 |
| Toplam · ağırlıklı puan | — | 155/177 | 3 | 89.78 |
3/3 zaman aralığı sayısı, testin üç zaman aralığının tümünde başarısız olduğu anlamına gelir.
| Başarısız test | Başarısız olunan zaman aralıkları | Neden |
|---|---|---|
| Bağlam taşması (bağlam ve durum) | 3/3 | Hata döndürüldü, ancak belgelenen bağlam uzunluğu hatası değildi |
| messages biçim hatası (hatalar ve kurtarma) | 3/3 | Boş yanıt gövdesiyle 400 döndürüldü; yapılandırılmış hata açıklaması yoktu |
| Araç şeması geçersiz (hatalar ve kurtarma) | 3/3 | Parametre hatası döndürmeliydi; 503 döndürdü |
| Tek başına araç sonucu (hatalar ve kurtarma) | 3/3 | Parametre hatası döndürmeliydi; 200 döndürdü |
| stream_options biçim hatası (hatalar ve kurtarma) | 3/3 | Boş yanıt gövdesiyle 400 döndürüldü; yapılandırılmış hata açıklaması yoktu |
| Akıl yürütme tokenı ölçümü (ücretlendirme ve önbellek protokolü) | 3/3 | Akıl yürütme tokenı sayısı döndürülmedi |
| Araç tanımlarının girdi olarak sayılması (ücretlendirme ve önbellek protokolü) | 3/3 | Araç tanımlarıyla bildirilen girdi tokenı sayısı, araç tanımları olmadan bildirilenden yüksek değildi |
| İstek yalıtımı (bağlam ve durum) | 1/3 | İlk adım, gereklilik doğrultusunda yalnızca STORED yanıtını vermediği için yalıtım kontrolü sürdürülemedi |
Bu kontroller paydadan çıkarılır ve ne başarılı ne de başarısız sayılır.
| Durum | Test | Sayı | Neden |
|---|---|---|---|
| Uygulanamaz | Açık cache_control | 3 | Bu arayüz tarafından desteklenmediği önceden kaydedildi |
messages biçim hatası ve stream_options biçim hatası testleri beş sağlayıcının tümünde başarısız oldu: her biri boş gövdeyle 400 döndürdü ve istemci yapılandırılmış bir hata açıklaması alamadı. Beşinin de aynı davranışı göstermesi, sorunun muhtemelen AIHubMix ağ geçidi katmanında bulunduğuna ve ayrıca incelenmesi gerektiğine işaret ediyor. Akıl yürütme tokenı ölçümü de beşinin tümünde başarısız oldu, ancak nedenleri farklıydı: ByteDance ve Fireworks, akıl yürütme kapalıyken bile akıl yürütme tokenları bildirdi; diğer üç sağlayıcı ise akıl yürütme tokenı sayısı döndürmedi.
Diğer dört sağlayıcıyla karşılaştırma
P — yanıt hızı: 88.58
Her istek yaklaşık 10,000 girdi tokenı içerdi ve yaklaşık 1,100 çıktı tokenı istedi. Üç zaman aralığında, tek eşzamanlılıkta 30 ve 10 eşzamanlılıkta 30 istek gönderildi; toplam sayı 180 oldu. İlk içerik tokenının gelmesini bekleme süresi (TTFA) her geçerli istek için ölçülür ve tabloda medyanlar raporlanır. TPOT, akış parçalarının zamanlamalarından tahmin edilir; donanım düzeyinde token başına süre değildir. Veri aktarım hızı, 10 eşzamanlılıktaki geçerli çıktı tokenlarının toplamının toplu işlem süresine bölünmesiyle hesaplanır.
| Metrik | Sonuç |
|---|---|
| İlk içerik tokenı TTFA | Tek eşzamanlılıkta medyan 1.34 s, 10 eşzamanlılıkta medyan 1.35 s |
| Üretim hızı TPOT | Tek eşzamanlılıkta 4.63 ms/token, 10 eşzamanlılıkta 4.69 ms/token |
| Etkin veri aktarım hızı (goodput) | 10 eşzamanlılıkta 1,313.6 token/s |
| Geçerli istekler | Tek eşzamanlılıkta 90/90, 10 eşzamanlılıkta 90/90 |
| Bileşen puanları | TTFA 59.65, TPOT 100.00, veri aktarım hızı 100.00; TTFA ve TPOT için iki düzeyden düşük olanı alınır, ağırlıklar sırasıyla %35 / %35 / %30’dur; yanıt puanı 85.88 |
| P puanı | %80 ağırlıkla yanıt puanı 85.88, %20 ağırlıkla önbellek K 99.37; toplam 88.58 |
Diğer dört sağlayıcıyla karşılaştırma
Beş sağlayıcının tümü aynı makineyi, ağı ve hesabı paylaştı. Üç zaman aralığı sağlayıcı bazında planlandığından veri toplama dönemleri bütünüyle örtüşmüyor; küçük farklar olduğundan daha büyük yorumlanmamalı.
K — önbellek: 99.37
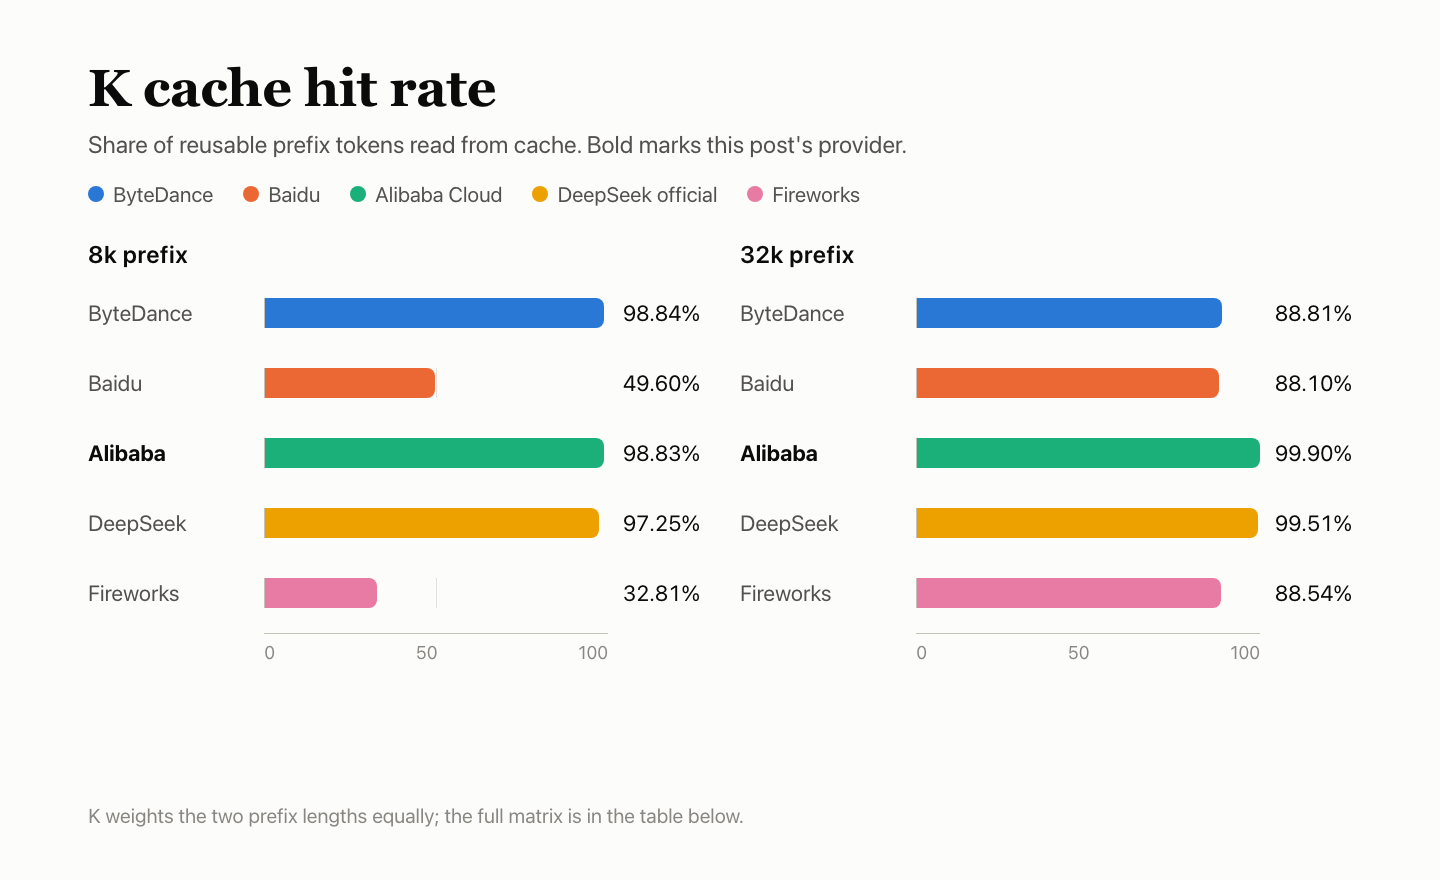
Her grup beş istekten oluşur: ilki yaklaşık 8k veya 32k tokenlık sabit bir önek taşır ve önbelleği doldurur; 2–4. istekler öneği koruyup yalnızca sondaki soruyu 5, 30 ve 120. saniyelerde değiştirir; beşinci istek ise soğuk kontrol için yeni bir önek kullanır. Üç zaman aralığı × iki uzunluk, toplam 30 istek eder. K, sıcak isteklerde okunan önbelleğe alınmış tokenların, kurala göre yeniden kullanılabilir olması gereken tokenlara oranıdır; her uzunluğa eşit ağırlık verilir. K, P’nin %20’sidir. Matris, sunucunun bildirdiği önbellekten okunan tokenları gösterir.
| Önek | Zaman aralığı | Tohum (1. istek) | 5. sn’de sıcak | 30. sn’de sıcak | 120. sn’de sıcak | Soğuk kontrol (5. istek) |
|---|---|---|---|---|---|---|
| 8k | 1. zaman aralığı | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | 2. zaman aralığı | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 8k | 3. zaman aralığı | 0 | 7,936 | 7,936 | 7,936 | 0 |
| 32k | 1. zaman aralığı | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | 2. zaman aralığı | 0 | 32,000 | 32,000 | 32,000 | 0 |
| 32k | 3. zaman aralığı | 0 | 32,000 | 32,000 | 32,000 | 0 |
| Önek | Sıcak isabetler | Okunan tokenlar | Yeniden kullanılabilir olması gereken | Puan |
|---|---|---|---|---|
| 8k | 9/9 | 71,424 | 72,270 | 98.83 |
| 32k | 9/9 | 288,000 | 288,279 | 99.90 |
| K (8k ve 32k, her biri yarı ağırlıkta) | 99.37 |
9 sıcak 8k isteğinin tümü önbelleğe isabet etti ve her biri 7,936 token okudu; 9 sıcak 32k isteğinin tümü de isabet ederek her biri 32,000 token okudu. Tohum isteği ve soğuk kontrol önbellekten hiçbir şey okumadı; böylece sıcak ve soğuk istekler net biçimde ayrıştı.
Diğer dört sağlayıcıyla karşılaştırma
R — hizmet kararlılığı: 100
300 istek dört türü kapsadı — kısa metin, 10k uzun girdi, araç çağrıları ve çok turlu geçmiş — ve üç zaman aralığında tek eşzamanlılıkla gönderildi. Yalnızca ilk yanıtın geçerliliği ve eksiksizliği kontrol edildi; yanıtların doğruluğu kontrol edilmedi ve yeniden deneme yapılmadı. Yanıt kalitesi ve hız bölümlerindeki hatalar sırasıyla Q ve P’ye dahil edilir; R’de tekrar sayılmaz.
| İstek türü | İlk denemede başarı |
|---|---|
| Kısa metin | 120/120 |
| 10k uzun girdi | 90/90 |
| Araç çağrıları | 60/60 |
| Çok turlu geçmiş | 30/30 |
| Toplam · %95 güven aralığı 98.78%–100% | 300/300 |
300 isteğin tamamı ilk denemede geçerli ve eksiksiz bir yanıt döndürdü. R 100 yalnızca bu 300 özel isteği kapsar; tüm zincirde hiç hata olmadığı anlamına gelmez. %95 aralığının alt sınırı %98,78’dir: 300/300 sonucuna rağmen hata oranının %1,22’nin altında olması muhtemeldir.
Diğer dört sağlayıcıyla karşılaştırma
R yalnızca bu 300 özel isteği kapsar; yanıt kalitesi ve hızdaki hatalar Q ve P’de kaydedilir, R’de yeniden sayılmaz.
| Sağlayıcı | İlk denemede başarı | %95 aralığı |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek resmi kanalı | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
SSS
Alibaba Cloud ile resmi kanal arasındaki 0.37’lik genel fark anlamlı mı?
Hayır. Bu çalışmada ikisi birbirinden ayırt edilemiyor: Q farkı, %95 aralığı −1.72 ile +0.26 olan −0.71 yüzde puanıdır; bu aralık 0’ı içerir. Genel puan ise güven aralığı olmayan bir özet endekstir.
Q puanı neleri birleştiriyor?
Üç veri kümesini: 500 soru × 3 turdan oluşan BFCL, otomatik olarak puanlandı; 250 × 10 HLE ve 25 × 10 AA-LCR ise deepseek-flash hakem modeliyle puanlandı. Birleşik doğruluk, puanlanan 4,240 soru çalıştırmasında %41.75’tir.
177 kontrolden 155’i geçmesine rağmen F neden 89.78?
Puan, basit bir geçme oranına göre değil, gruplara göre ağırlıklandırılır. Hatalar ve kurtarma 60.00, ölçümleme ve önbellek protokolü 77.78 puan alırken üç protokol grubu 100.00 puan aldı.
Diğer bölümlerde başarısız istekler varken R neden 100 gösteriyor?
R yalnızca 300 özel kararlılık isteğini kapsar. Yanıt kalitesi ve hızdaki hatalar Q ve P’de kaydedilir, R’de yeniden sayılmaz.
K 99.37 bir önbellek isabet oranı mı?
Bu, sıcak isteklerde okunan önbelleğe alınmış tokenların, yeniden kullanılabilir olması gereken tokenlara oranıdır; 8k ve 32k eşit ağırlıklandırılır. 8k öneki 98.83, 32k öneki ise 99.90 puan aldı.
İlk tokenın 1.34 s olması, yanıtın tamamının 1.34 s’de geldiği anlamına mı geliyor?
Hayır. Bu, ilk içerik tokenı için bekleme süresidir. Her istekte yaklaşık 1,100 çıktı tokenı istendi ve 10 eşzamanlı istekte TPOT, token başına 4.69 ms oldu.
Okumaya devam edin: DeepSeek V4.1 Flash serisi
- Alibaba Cloud’un birleşik Q puanı, resmi temel değerden 0.71 yüzde puan farklıdır ve bu fark, 0’ı içeren aralığın içindedir; ByteDance profili aynı karşılaştırmayı araç çağrısı ölçümlemesine taşır: ByteDance’te DeepSeek V4.1 Flash: araç çağrıları eşleşiyor, ölçümleme eşleşmiyor.
- Alibaba Cloud, 180 hız isteğinin tamamına geçerli yanıt verdi; Baidu profili, mevcut hiçbir kanalın Q ve P’yi etkilemediği aynı test düzeneğini izliyor: Baidu’da DeepSeek V4.1 Flash: mevcut kanal yok, Q ve P etkilenmiyor.
- Bu yazıda yanıt kalitesi karşılaştırmasının temel değeri resmi kanaldır; kendi profili F 94.00 puanını ve geçersiz 15 tek eşzamanlılık testini kapsar: Resmi kanalda DeepSeek V4.1 Flash: 94.00 F, 15 geçersiz test.
- Alibaba Cloud, her iki önek uzunluğunda da 9/9 sıcak istekte başarılı oldu; Fireworks profili boş stop yanıtlarını ve 8k’da 3/9 önbellek isabetini ele alıyor: Fireworks’te DeepSeek V4.1 Flash: boş stop yanıtları, 3/9 önbellek isabeti.


