

2026-11-03/04 tarihlerinde DeepSeek V4.1 Flash 1017, beş sağlayıcıda APB Full paketinden geçirildi. Tüm testler aynı sorular, parametreler ve istek betikleriyle AIHubMix üzerinden yürütüldü. Bu APB Profili yalnızca Fireworks’ü kapsıyor. Model, DeepSeek V4.1 Flash 1017 olarak listeleniyor.
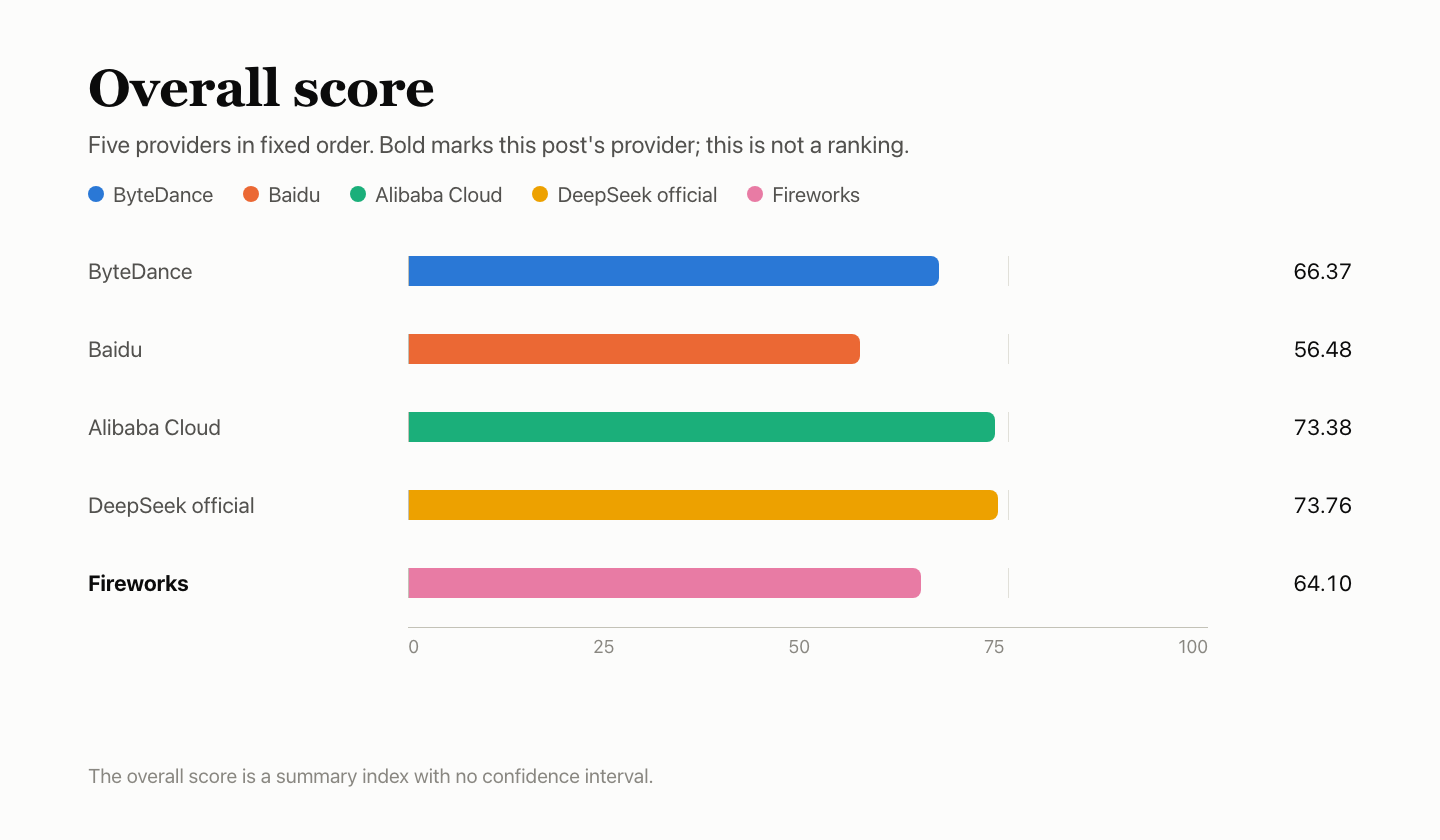
Puanlar: Q 41.42, F 71.78, P 79.51, K 60.68 ve R 100; genel endeks 64.10. Bu yazı yalnızca puanları bildiriyor; sıralama veya sağlayıcı önerisi sunmuyor. Önce Q, F, P, K ve R geliyor; genel endeks ise güven aralığı olmayan bir özet değer. Standart, AIHubMix Provider Benchmark Standard v2.0’dır.
Beş sağlayıcının puanları
Kalın yazı bu yazının sağlayıcısını gösterir. Sağlayıcı sırası sabittir; sıralama değildir. K, P’nin %20 ağırlıklı alt puanıdır. Genel endeks, güven aralığı olmayan bir özet değerdir. DeepSeek resmî kanalı ile Alibaba Cloud arasındaki fark 0.37’dir ve ayırt edilebilir düzeyde değildir.
Özet
- Q — yanıt kalitesi: 41.42. BFCL %85.53, HLE %14.38, AA-LCR %46.00. Resmî kanalla fark: −1.04 yüzde puan; %95 GA −2.14 ile +0.05 arasında, ayırt edilebilir değil. AA-LCR’daki 34 başarısızlığın tümü 2. penceredeydi ve yanlış olarak sayıldı.
- F — işlev desteği: 71.78. Sayılan 177 kontrolden 122’si geçti. Her iki stop vakasında da gövde boş döndü;
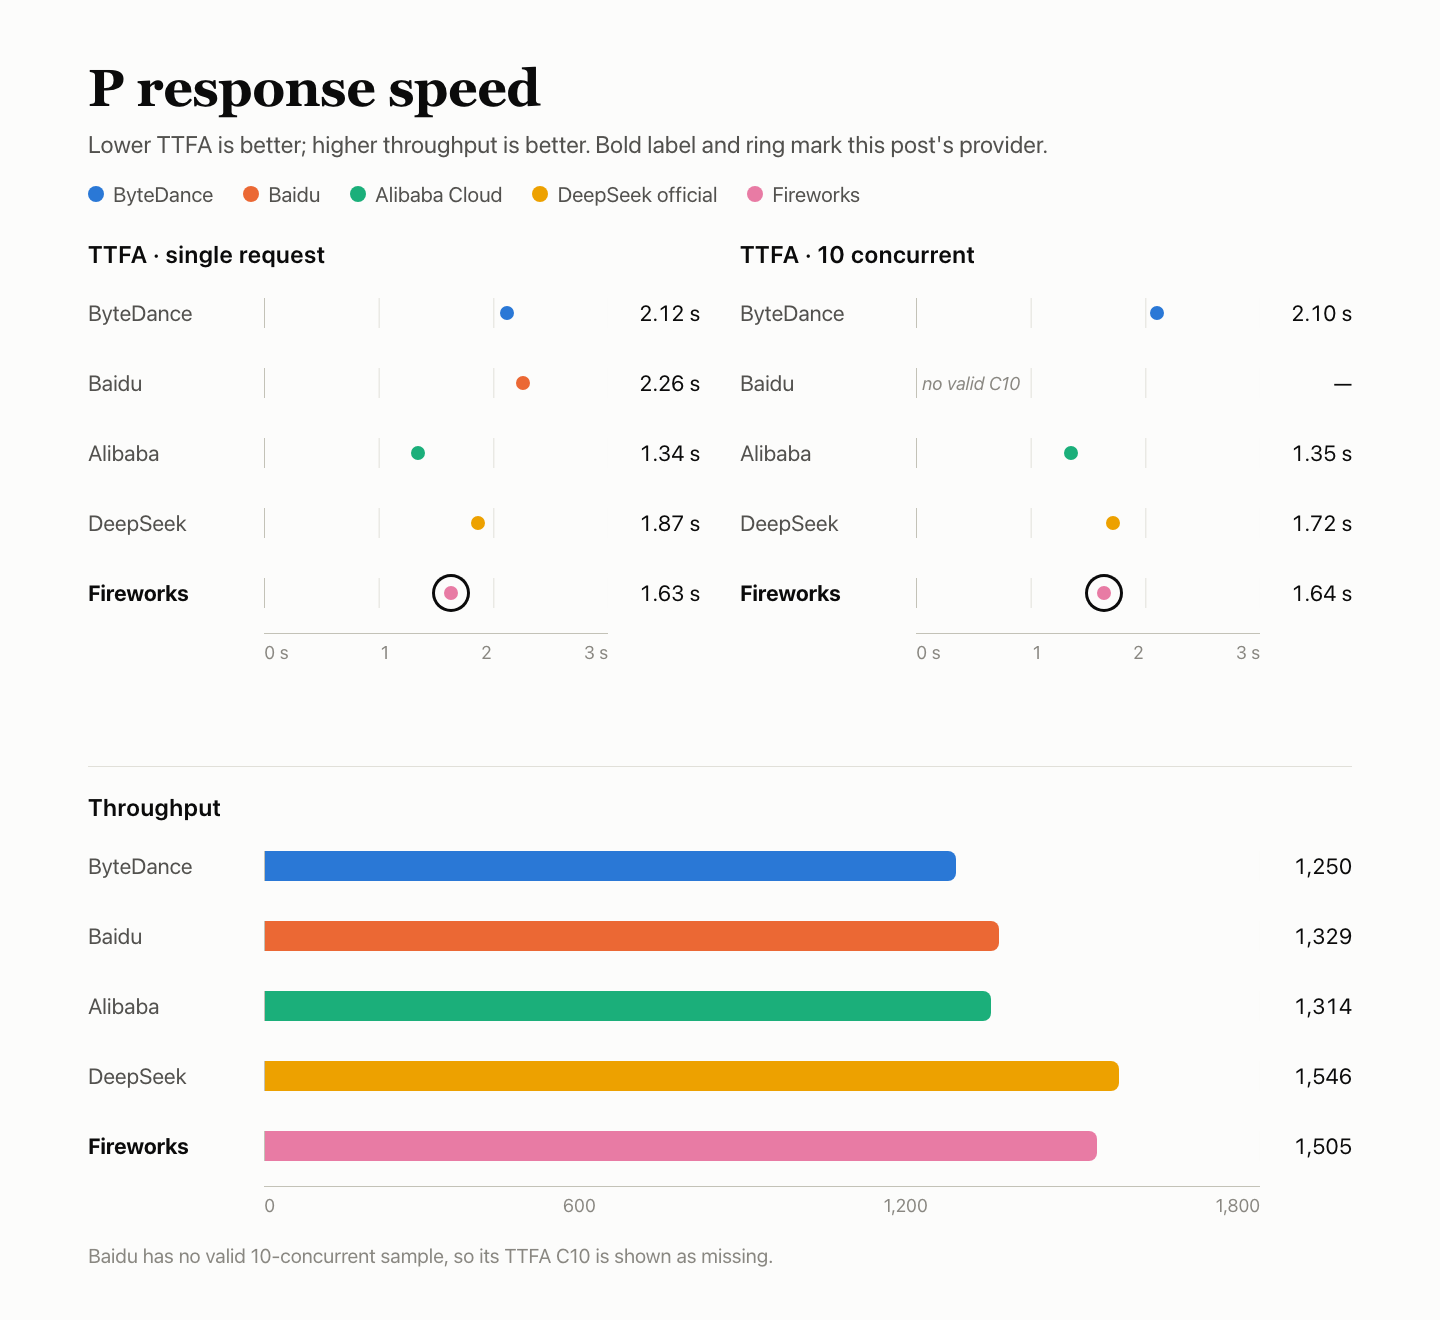
reasoning_effort=nonedüşünmeyi kapatmadı; 10k giriş, yerel sayıma göre 10,000 token olmasına rağmen 10,026 token olarak bildirildi. - P — yanıt hızı: 79.51. Yanıt puanı 84.22, önbellek K puanı %20 ağırlıklı. TTFA medyanı tekli istekte 1.63 s, eşzamanlı 10 istekte 1.64 s; TPOT 3.29 ms. 180 çıktının 1’i tek tokenlıydı ve geçersiz olarak işaretlendi.
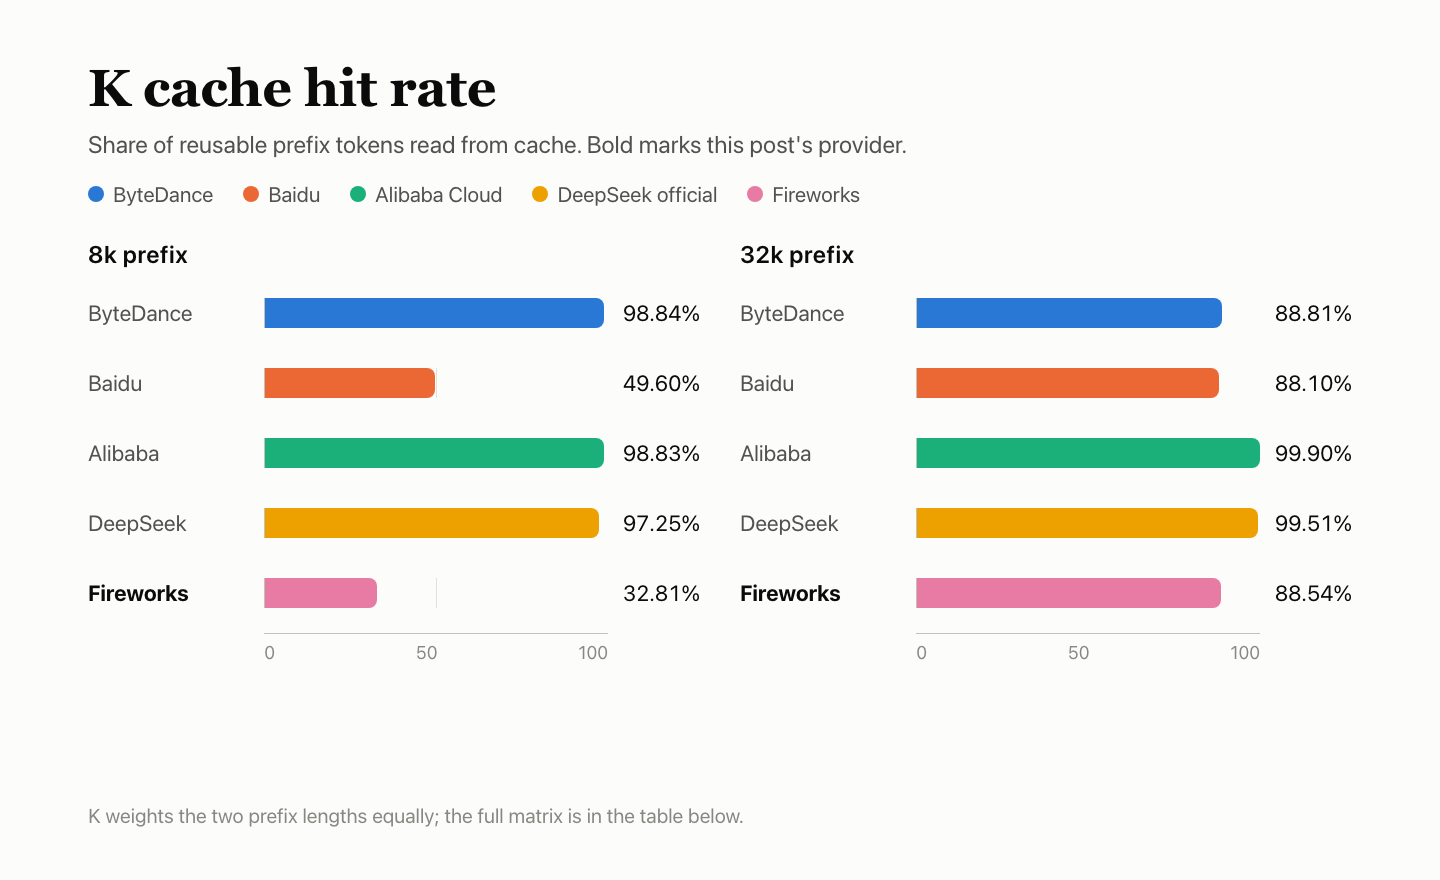
- K — önbellek: 60.68. K problarında belgelenmiş oturum yakınlığı kullanıldı. 32k sıcak: 8/9; 8k sıcak: 3/9.
- R — hizmet istikrarı: 100. Özel olarak ayrılmış 300 isteğin 300’ü de ilk denemede başarılı oldu.
Test düzeni
| Öğe | Ayar |
|---|---|
| Model | DeepSeek V4.1 Flash 1017 |
| İstenen model kimliği | fireworks-deepseek-v4.1-flash-1017 |
| Dönen model adı | accounts/fireworks/models/deepseek-v4p1-flash-1017 |
| Erişim yolu | AIHubMix sağlayıcı model kimliği; sağlayıcının kendi hesabı değil |
| Parametreler | Düşünme kapalı, temperature 1.0, max_tokens 16,384, zaman aşımı 300 s, yeniden deneme yok |
| Düşünmenin kapatılması | Yerel thinking.type=disabled; reasoning_effort=none düşünmeyi kapatmaz. İşlev vakalarında reasoning_effort=none korundu. |
| Zaman | 2026-11-03 18:07 – 11-04 16:33 UTC+8. Beş sağlayıcının tümünde tek bir Mac mini, ağ ve hesap kullanıldı. |
| Örnekler | Q 4,250 (BFCL 500×3, HLE 250×10, AA-LCR 25×10); F 60×3; P 90+90; R 300; K 30 |
| Ek ayarlar | K problarında, çoğaltma yakınlığı için belgelenmiş kullanıcı alanı ve x-session-affinity üstbilgisi kullanıldı. |
İsteklerde AIHubMix hızlı başlangıç kılavuzu kullanıldı; model kimlikleri modeller sayfasında. Düşünmeyi kapatmak için modelin API belgelerindeki yerel thinking.type=disabled kullanıldı.
Q — yanıt kalitesi: 41.42
Paket; 500 BFCL sorusunu 3 tur, 250 HLE sorusunu 10 tur ve 25 AA-LCR sorusunu 10 tur çalıştırdı. BFCL otomatik puanlandı; HLE ve AA-LCR, deepseek-flash tarafından değerlendirildi. Beş sağlayıcının tümüne aynı sorular yöneltildi. Puanlanamayan 10 yanıt çıkarıldı ve puanlanan örnek sayısı 4,240 oldu.
| Görev | Sorular | Doğru | Doğruluk | Başarısızlıklar |
|---|---|---|---|---|
| BFCL araç çağrıları | 500 × 3 | 1,283/1,500 | 85.53% | 2 |
| HLE zor soru-cevap | 250 × 10 | 358/2,490 | 14.38% | 5 |
| AA-LCR uzun belge akıl yürütme | 25 × 10 | 115/250 | 46.00% | 34 |
| Toplam · %95 GA 39.13%–43.59% | — | 1,756/4,240 | 41.42% | 41 |
Başarısızlıklar paydada yanlış yanıt olarak kalır: BFCL 2 (2. ve 3. pencerelerde), max_tokens sınırında kesilen HLE 5, tamamı 2. pencerede olan AA-LCR 34.
| BFCL kategorisi | Geçti | Geçme oranı |
|---|---|---|
| simple_python | 333/360 | 92.50% |
| multiple | 268/300 | 89.33% |
| parallel | 270/300 | 90.00% |
| parallel_multiple | 206/240 | 85.83% |
| irrelevance | 111/150 | 74.00% |
| ahm_multi_turn | 95/150 | 63.33% |
simple_python 333/360 (%92.50), parallel 270/300 (%90.00), ahm_multi_turn 95/150 (%63.33) ve irrelevance 111/150 (%74.00) oranında geçti.
Diğer dört sağlayıcıyla karşılaştırma
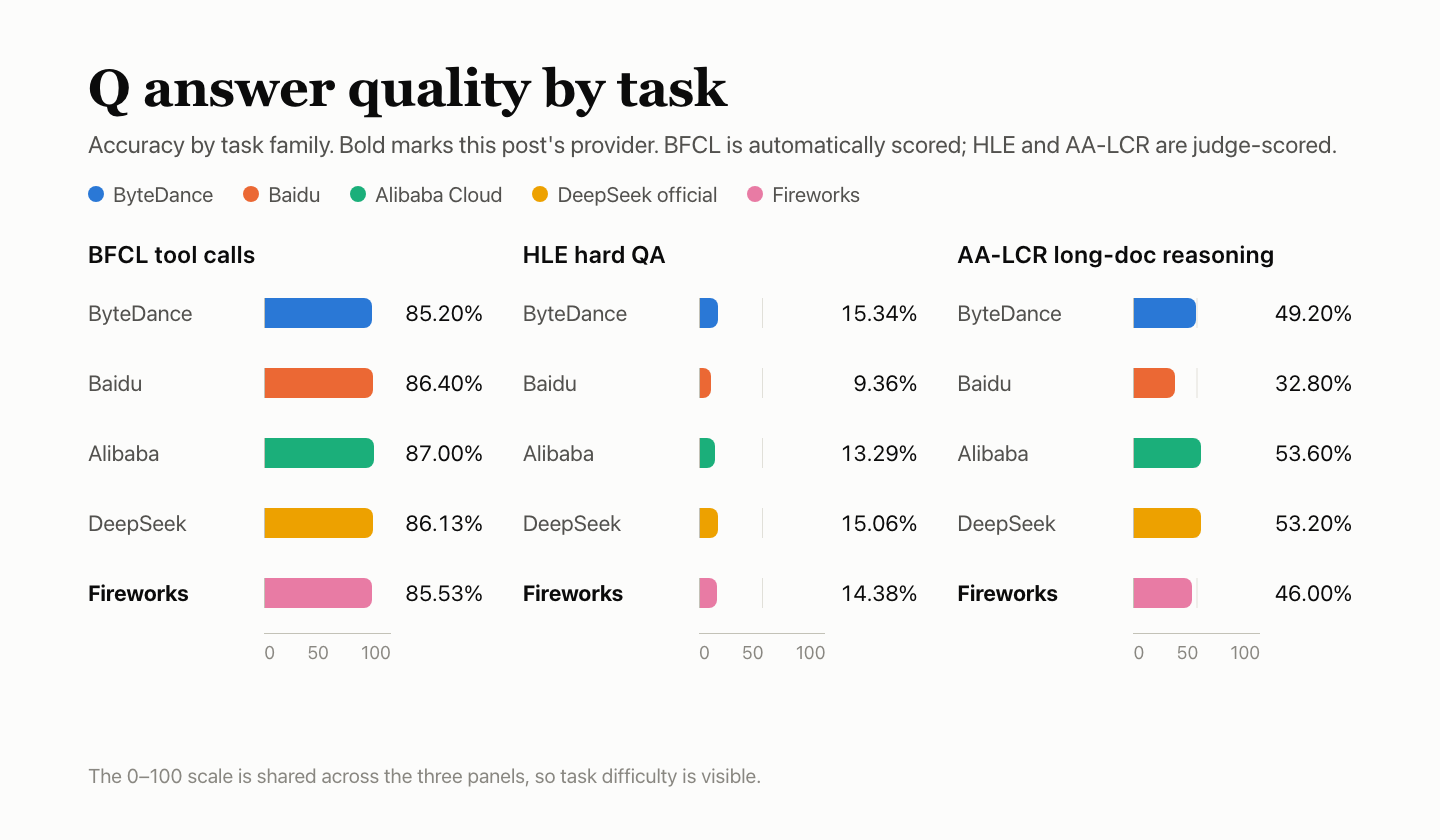
Resmî kanala göre yüzde puan farkı; %95 aralığı çizgilerle gösterilmiştir. Aralığın 0’ı kesmesi, farkın ayırt edilebilir olmadığı anlamına gelir. Aynı aileden gelen deepseek-flash değerlendiricisi kalibre edilmediğinden hoşgörülü olabilir.
F — işlev desteği: 71.78
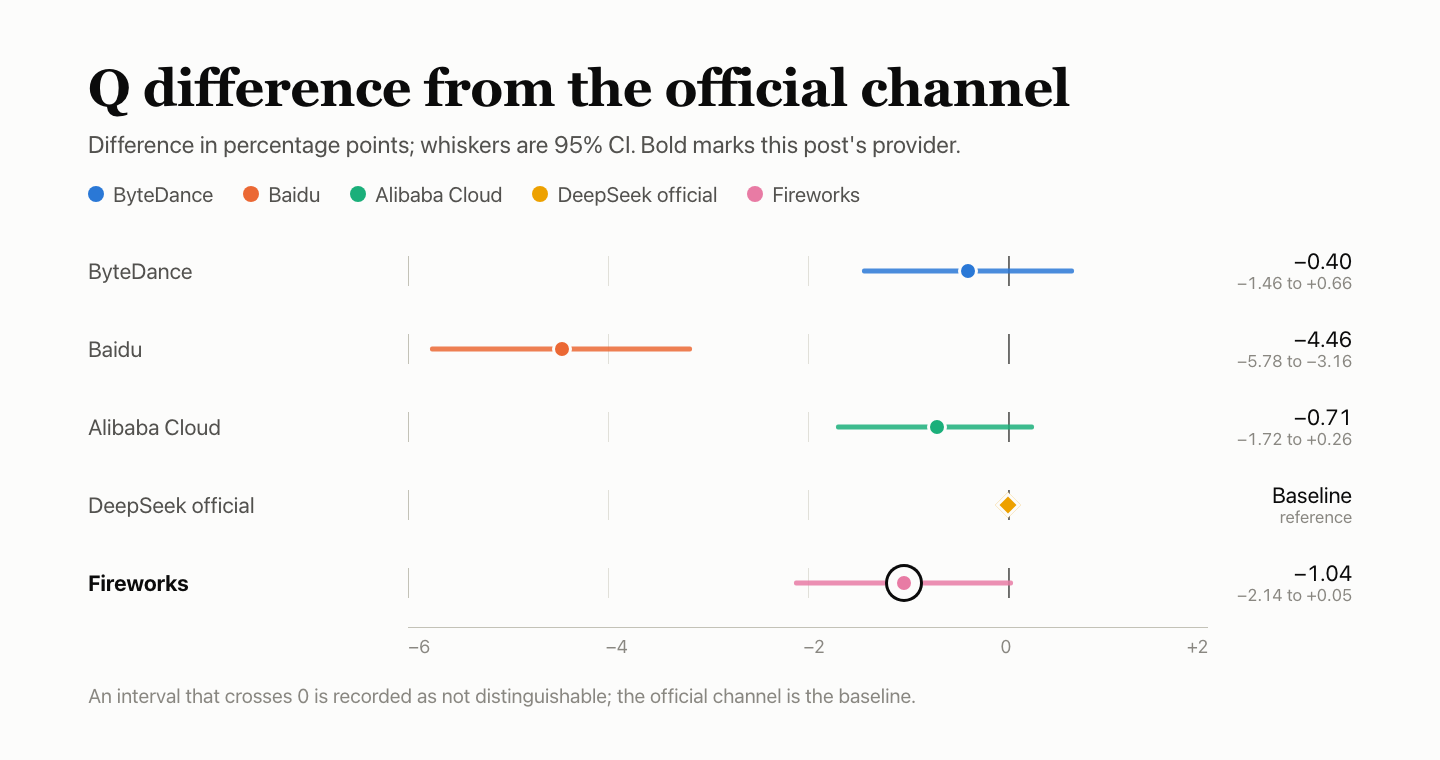
60 vaka, her biri üç pencerede çalıştırılan altı gruptan oluşuyor: sağlayıcının belgelenmiş biçimine göre değerlendirilen 180 kontrol. Uygulanamaz, geçersiz ve gözlemlenemeyen kontroller paydaya alınmaz. Sayılan 177 kontrolden 122’si geçti; grup ağırlıklandırmasıyla puan 71.78 oldu.
| Vaka grubu | Ağırlık | Geçti | Hariç tutulan | Grup puanı |
|---|---|---|---|---|
| Akış ve mesajlaşma | 20% | 24/30 | — | 80.00 |
| Araç arayüzü | 20% | 29/30 | — | 96.67 |
| Çıktı kısıtları | 20% | 21/30 | — | 70.00 |
| Bağlam ve durum | 15% | 15/30 | — | 50.00 |
| Hata ve kurtarma | 15% | 21/30 | — | 70.00 |
| Kullanım ölçümü ve önbellek | 10% | 12/27 | 3 | 44.44 |
| Toplam · ağırlıklı | — | 122/177 | 3 | 71.78 |
“Başarısız pencereler”, vakanın geçemediği üç pencereyi sayar.
| Başarısız vaka | Başarısız pencereler | Neden |
|---|---|---|
| Akış stop’u | 3/3 | Stop ile gövde boş; stop olmadan çalışıyor. |
| Gövde içindeki akıl yürütme | 3/3 | reasoning_effort=none olmasına rağmen akıl yürütme döndü. |
| Stop dizisi | 3/3 | Stop ile gövde boş; stop olmadan çalışıyor. |
| Düşünme ayarı | 3/3 | reasoning_effort=none olmasına rağmen akıl yürütme döndü. |
| Örnekleme çeşitliliği | 3/3 | Temp 0/1 birbirine fazla benziyor |
| 10k uzun girdi | 3/3 | 10,026 bildirildi; yerel sayı 10,000. |
| Bağlam sınırı içinde | 3/3 | 10,026 bildirildi; yerel sayı 10,000. |
| 32k uzun girdi | 3/3 | 10,026 bildirildi; yerel sayı 10,000. |
| 100k uzun girdi | 3/3 | 10,026 bildirildi; yerel sayı 10,000. |
| Bağlam sınırını aşıyor | 3/3 | Parametre hatası vermeliydi; 200 döndü. |
| Hatalı biçimlendirilmiş mesajlar | 3/3 | 400, boş gövde |
| Eşleşmeyen araç sonucu | 3/3 | Parametre hatası vermeliydi; 200 döndü. |
| Hatalı biçimlendirilmiş stream_options | 3/3 | 400, boş gövde |
| Düşünme token’larının kullanım ölçümü | 3/3 | Devre dışı bırakıldıktan sonra düşünme token’ları bildirildi. |
| Yerel girdi sayısı | 3/3 | 34 bildirildi; yerel sayı 8. |
| Girdideki araç tanımları | 3/3 | Araç kullanılmayan kontrol de zaten uyuşmuyordu. |
| Önbellek boyunca girdi sayısı | 3/3 | Tekrarlanan önek sayısı yerel değerle uyuşmadı. |
| Akışta girdi tutarlılığı | 3/3 | 34 bildirildi; yerel sayı 8 |
| Tek seferde bir araç | 1/3 | Üst akışta 500 hatası. |
Her iki stop vakasında da aynı girdi stop olmadan çalışırken, üç pencerenin tümünde gövde boş döndü. Her iki düşünme vakasında da reasoning_effort=none olmasına rağmen akıl yürütme döndü.
Hariç tutulan kontroller ne başarılı ne de başarısız sayılır.
| Durum | Vaka | Sayı | Neden |
|---|---|---|---|
| Uygulanamaz | Açık cache_control | 3 | Bu arayüzde desteklenmediği önceden kaydedildi |
Hatalı biçimlendirilmiş messages ve stream_options, beş sağlayıcının tümünde başarısız oldu: yapılandırılmış hata olmadan, gövdesi boş bir 400 yanıtı. Bu ortak sonucun AIHubMix ağ geçidi katmanında oluşması daha olası; bu katmanın ayrıca incelenmesi gerekiyor. Düşünme token’larının kullanım ölçümü de beş sağlayıcının tümünde başarısız oldu; ancak ByteDance ve Fireworks devre dışı bırakıldıktan sonra düşünme token’ları bildirirken diğer üçü herhangi bir düşünme sayısı döndürmedi.
Diğer dört sağlayıcıyla karşılaştırma
P — yanıt hızı: 79.51
Her istek yaklaşık 10,000 girdi token’ı içeriyor ve yaklaşık 1,100 çıktı token’ı istiyordu. Üç pencerenin her birinde tekli eşzamanlılıkla 30, eşzamanlı 10 istekle de 30 istek gönderildi; toplam 180 istek.
| Metrik | Sonuç |
|---|---|
| TTFA | Tekli istekte 1.63 s; eşzamanlı 10 istekte 1.64 s |
| TPOT | Tekli istekte 3.24 ms; 10 istekte 3.29 ms |
| Goodput | 10 istekte 1,504.5 token/s |
| Geçerli | Teklide 90/90; 10 istekte 89/90 (3. pencerede 29/30); tek tokenlı bir çıktı |
| Bileşenler | TTFA 54.91, TPOT 100.00, goodput 100.00; ağırlıklar 35/35/30 |
| P bileşimi | 84.22 × 80% + 60.68 × 20% = 79.51 |
180 çıktının 179’u geçerliydi; geçersiz istekte tek token döndü ve medyanlarda sonsuz değer olarak sayıldı, bu nedenle medyanlar yalnızca geçerli istekler için hesaplananlardan yüksek olabilir. TPOT, akış parçalarından alınır; goodput ise 10 eşzamanlı istekteki geçerli çıktı token’larının toplu çalışma süresine bölünmesiyle hesaplanır.
Tek makine, ağ ve hesap; pencereler sağlayıcıya göre zamanlandı.
K — önbellek: 60.68
Her grup beş istekten oluşur: önce 8k veya 32k’lık bir önek oluşturulur; ardından 5 s, 30 s ve 120 s sonra yeni bir son soruyla aynı önek kullanılır; son olarak soğuk kontrol için yeni bir önek gönderilir. Üç pencere × iki uzunluk = 30. K, sıcak önbellekten okunan token’ların yeniden kullanılabilir token’lara oranıdır; uzunluklar eşit ağırlıklandırılır. K, P’nin %20’sidir.
| Önek | Pencere | Tohum | +5 s | +30 s | +120 s | Soğuk kontrol |
|---|---|---|---|---|---|---|
| 8k | 1. pencere | 0 | 7,900 | 0 | 7,900 | 0 |
| 8k | 2. pencere | 0 | 7,906 | 0 | 0 | 0 |
| 8k | 3. pencere | 0 | 0 | 0 | 0 | 0 |
| 32k | Pencere 1 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | Pencere 2 | 0 | 31,902 | 31,902 | 31,902 | 0 |
| 32k | Pencere 3 | 0 | 31,900 | 31,900 | 0 | 0 |
8k öneki, yoğun isteklerin 9'undan 3'ünde isabet sağladı ve yeniden kullanılabilir 72,252 tokenın 23,706'sını okudu: 32.81. 32k öneki, 9 isteğin 8'inde isabet sağladı ve 288,261 tokenın 255,212'sini okudu: 88.54. İki uzunluğa eşit ağırlık verildiğinde K değeri 60.68 oluyor. Soğuk kontroller 0 okudu. Dolayısıyla aynı tasarım altında iki önek uzunluğu farklı davrandı. K testlerinde belgelenen user alanı ve x-session-affinity başlığı kullanıldı.
R — hizmet kararlılığı: 100
Üç pencere boyunca, eşzamanlılık 1 olacak şekilde kısa metin, uzun girdi, araç çağrısı ve çok turlu geçmişi kapsayan 300 istek gönderildi. Yalnızca ilk yanıtın geçerliliği ve eksiksizliği kontrol edildi; yanıtlar puanlanmadı ve hiçbir istek yeniden denenmedi. Q ve P hataları burada tekrar sayılmıyor.
| İstek türü | İlk denemede başarı |
|---|---|
| Kısa metin | 120/120 |
| 10k uzun girdi | 90/90 |
| Araç çağrısı | 60/60 |
| Çok turlu geçmiş | 30/30 |
| Toplam · %95 GA 98.78%–100% | 300/300 |
300 isteğin tamamı ilk denemede geçerli ve eksiksiz yanıt verdi. 300 başarıyla %95 alt sınırı 98.78% olduğundan, veriler yalnızca hata oranının %1.22'nin altında olduğunu destekliyor. R 100, tüm akışı değil, bu 300 isteği kapsıyor.
| Sağlayıcı | İlk denemede başarı | %95 aralık |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek resmi | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
SSS
Q 41.42 neleri kapsıyor?
4,240 puanlanmış örnekte BFCL, HLE ve AA-LCR: 1,756 doğru yanıt, %41.42, %95 GA %39.13–%43.59; resmi kanala kıyasla fark ayırt edilebilir değil.
Her iki stop vakası neden başarısız oldu?
stop içeren bir istek üç pencerenin tamamında boş yanıt gövdesi döndürürken, stop olmadan aynı girdi çalıştı. Bu durum hem akışta hem akış dışı isteklerde görüldü.
reasoning_effort=none düşünmeyi kapatıyor mu?
Hayır. Üç pencerenin tamamında akıl yürütme içeriği döndürmeye devam etti; diğer isteklerde yerel thinking.type=disabled kullanıldı.
10k girdi neden 10,026 token olarak raporlanıyor?
10k vakası, yerel 10,000 değerine karşılık 10,026 bildirdi. 32k ve 100k vakaları da aynı 10,026 değerini bildirdi; araç kullanılmayan kontrol de zaten uyuşmuyordu.
8k neden 3/9, 32k ise 8/9 isabet sağladı?
Her ikisinde de aynı tasarım ve belgelenmiş bağlılık ayarları kullanıldı. Fark, sunucunun bildirdiği okuma sayılarında: 8k, 1. ve 2. pencerelerde; 32k ise üç pencerenin tamamında isabet sağladı.
R 100 neleri kapsıyor?
Ayrı yürütülen 300 isteğin tamamı ilk denemede geçerliydi; %95 alt sınırı 98.78%. Q ve P hataları R'ye dahil değil.
Okumaya devam edin: DeepSeek V4.1 Flash serisi
- ByteDance, Fireworks'te olduğu gibi düşünme devre dışı bırakıldıktan sonra da düşünme tokenları bildirdi: ByteDance'te DeepSeek V4.1 Flash: araç çağrıları eşleşiyor, ölçüm eşleşmiyor
- Baidu, Q için 38.00 ve P için 37.77 kaydetti: Baidu'da DeepSeek V4.1 Flash: mevcut kanalların hiçbiri Q ve P'yi geçemiyor
- Alibaba Cloud, ilk token için 1.34 s ve önbellek için 99.37 kaydetti: Alibaba Cloud'da DeepSeek V4.1 Flash: ilk token 1.34s, önbellek 99.37
- Resmi kanal, Q için temel değer ve F için 94.00 sunuyor: Resmi kanalda DeepSeek V4.1 Flash: 94.00 F, 15 geçersiz test


