

2026-11-03/04 APB Full çalıştırmasında Pareto’nun dört puanı Q 44.58, F 93.42, P 57.69 ve R 100; genel puanı ise 68.72. Yoğun 8k isteklerde 9 isteğin 2’sinde, 32k isteklerde ise 9 isteğin 3’ünde önbellek isabeti sağlandı.
2026-11-03/04 tarihlerinde DeepSeek V4.1 Flash 1017, her biri için aynı sorular, parametreler ve istek betikleri kullanılarak APB Full paketiyle AIHubMix üzerinden altı sağlayıcıda test edildi. Bu APB Profili yalnızca Pareto’yu ele alıyor: her bölümün neyi ölçtüğünü ve sonuçları.
Aşağıdaki sayılar puanlardır; sıralama veya sağlayıcı önerisi değildir. Önce Q, F, P ve R olmak üzere dört puan verilir; genel puan bir özet endeksidir, sertifika değildir ve güven aralığı yoktur. Puanlama kuralları AIHubMix Sağlayıcı Karşılaştırma Standardı v2.0’da tanımlanmıştır.
Altı sağlayıcının puanları
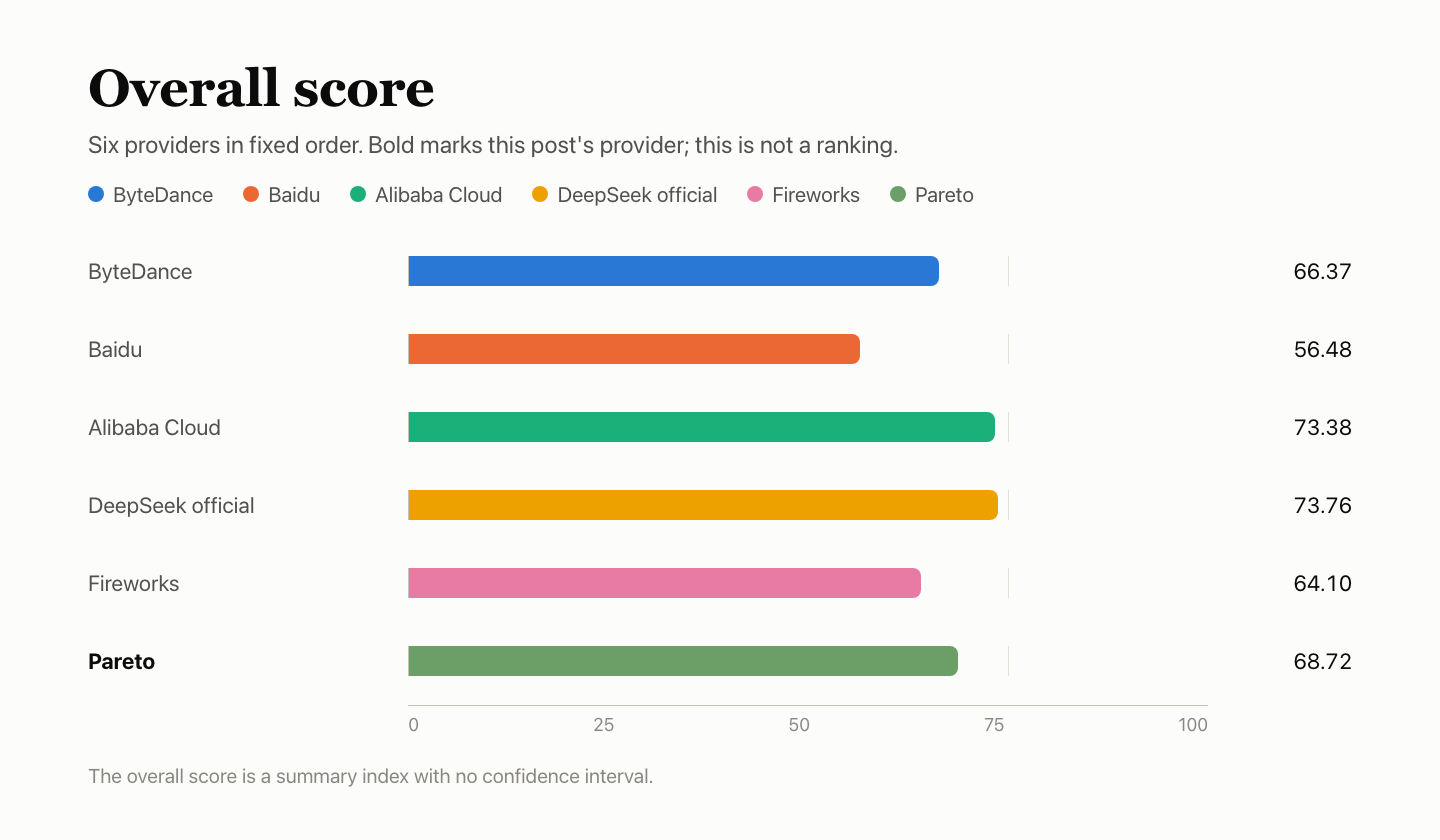
| Sağlayıcı | Q kalite | F işlev | P hız | K önbellek | R kararlılık | Genel |
|---|---|---|---|---|---|---|
| ByteDance | 42.05 | 74.98 | 84.37 | 93.83 | 100 | 66.37 |
| Baidu | 38.00 | 88.39 | 37.77 | 68.85 | 100 | 56.48 |
| Alibaba Cloud | 41.75 | 89.78 | 88.58 | 99.37 | 100 | 73.38 |
| DeepSeek resmî kanalı | 42.45 | 94.00 | 86.14 | 98.38 | 100 | 73.76 |
| Fireworks | 41.42 | 71.78 | 79.51 | 60.68 | 100 | 64.10 |
| Pareto (bu yazı) | 44.58 | 93.42 | 57.69 | 27.58 | 100 | 68.72 |
Sağlayıcılar sabit bir sırayla listelenmiştir; sıralama anlamına gelmez. K, P’nin %20’sini oluşturan bir alt puandır ve başvuru amacıyla ayrıca listelenmiştir. Genel puan, AIHubMix Sağlayıcı Karşılaştırma Standardı’nın resmî kanalla karşılaştırmayı ve kanıtların eksiksizliğini de içeren bileşim kurallarıyla hesaplanır; tablodaki dört puanın doğrudan ağırlıklı ortalaması değildir. Güven aralığı olmayan bir özet endekstir. DeepSeek resmî kanalı ile Alibaba Cloud arasındaki genel puan farkı yalnızca 0.37’dir ve ayırt edilebilir bir fark değildir.
Genel bakış
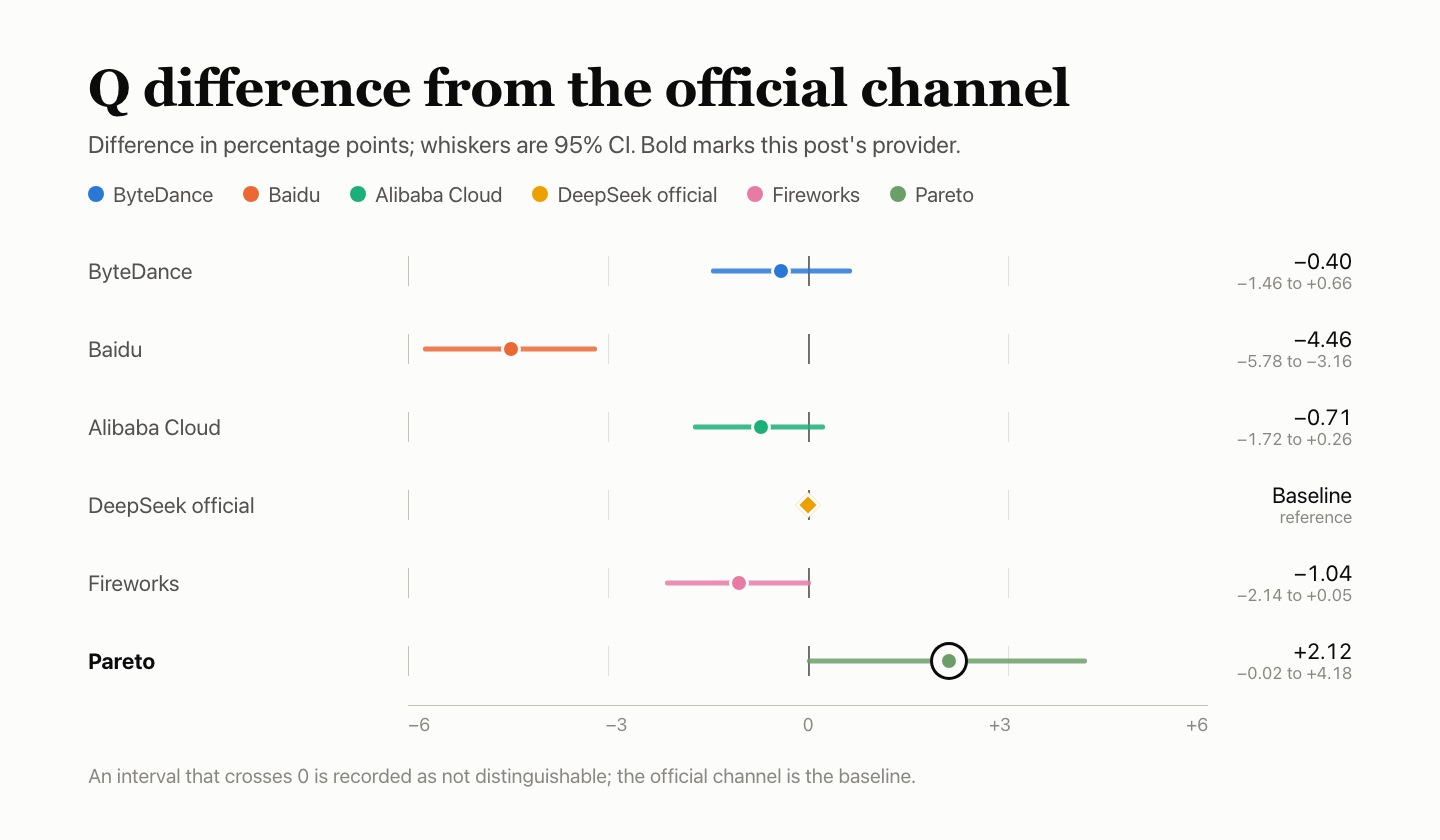
- Yanıt kalitesi: Q 44.58; BFCL %85.27, HLE %19.32 ve AA-LCR %52.00. Resmî kanala kıyasla fark +2.12 yüzde puan; %95 güven aralığı −0.02 ile +4.18 arasında: ayırt edilebilir değil.
- İşlev desteği: F 93.42; puanlanan 33 özgün kontrolden 29’u geçti. Araç çağrıları ve araç sonucu gidiş-dönüşü, paralel ve adlandırılmış çağrılar, JSON modu ve konuşma geçmişi için ek başarılı akış kayıtları bulunuyor; puanlar özgün değerlerini koruyor.
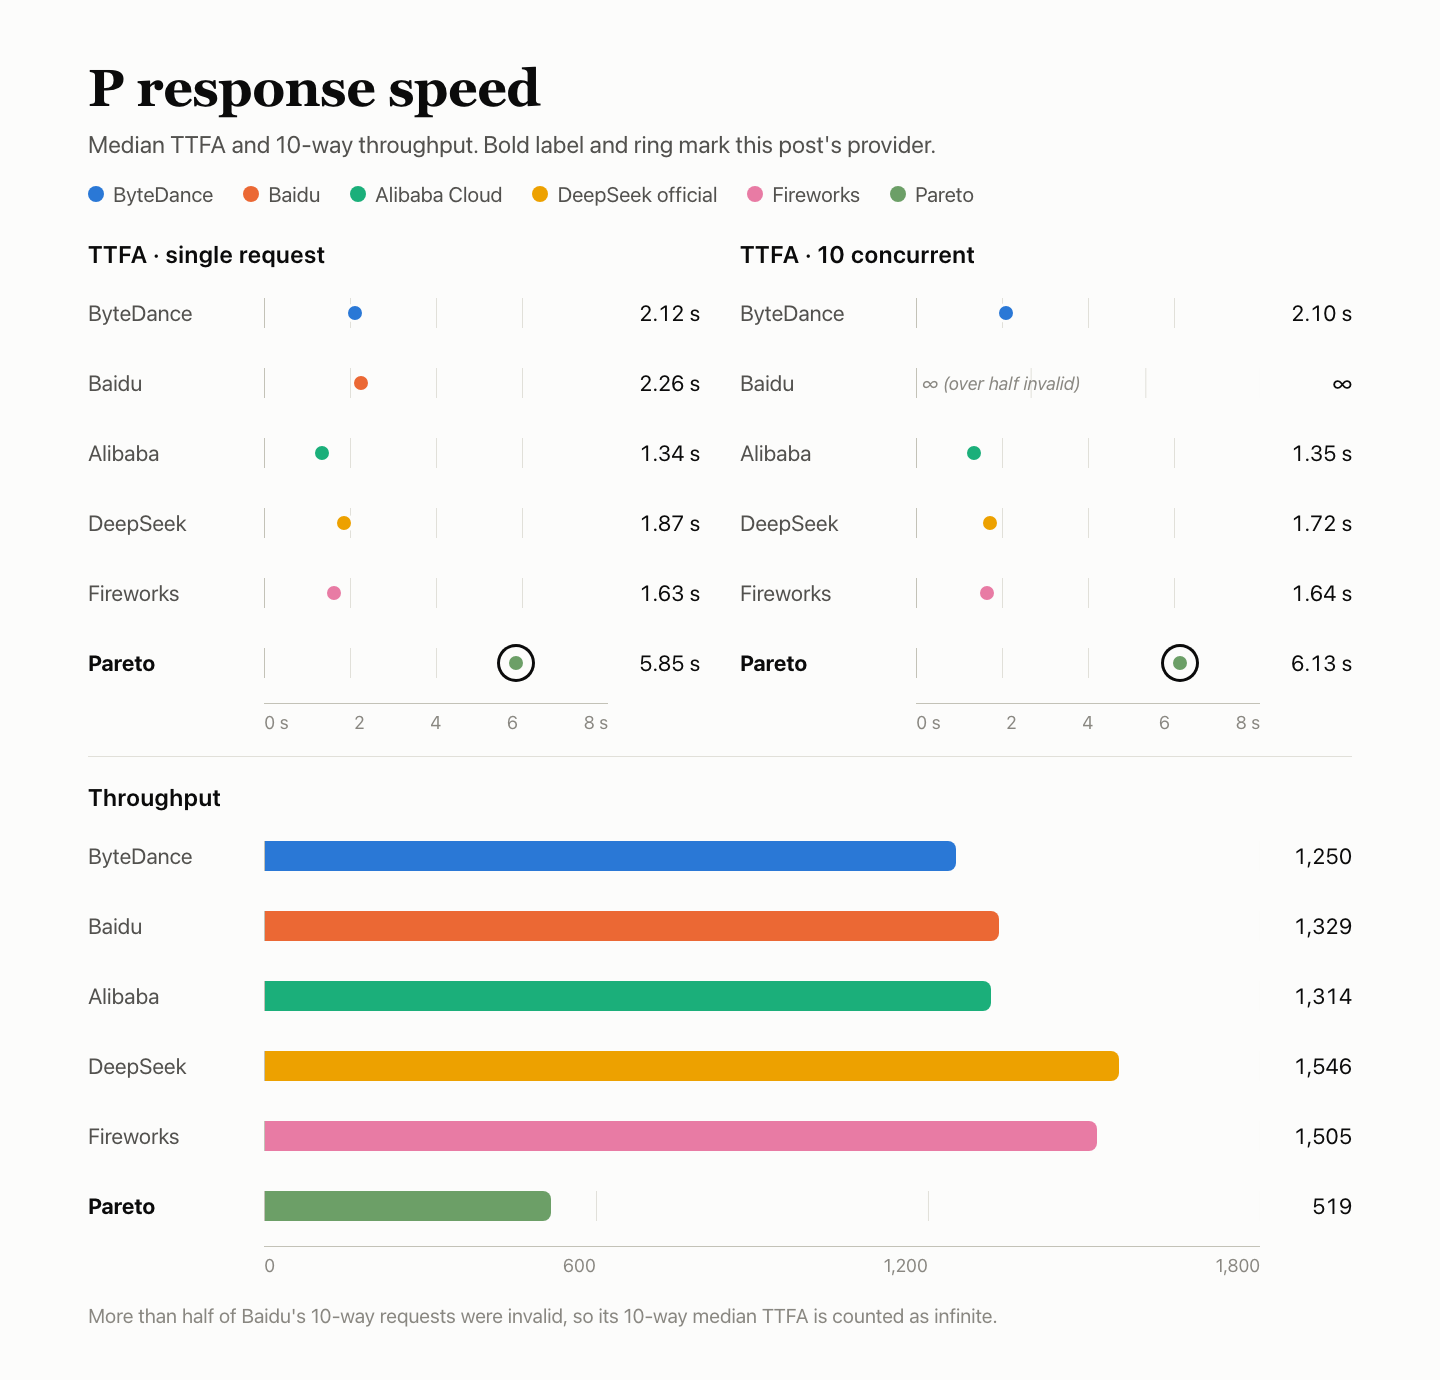
- Yanıt hızı: P 57.69. İlk gövde belirtecinin medyan süresi tek eşzamanlılıkta 5.85 s, 10 eşzamanlı istekte 6.13 s; TPOT 4.63 ms; 180 hız isteğinin 110’u geçerliydi.
- Önbellek: K 27.58. Yoğun 8k isteklerde 9 isteğin 2’sinde, 32k isteklerde 9 isteğin 3’ünde önbellek isabeti sağlandı; soğuk kontrol isteklerinin hiçbiri önbelleği okumadı.
- Hizmet kararlılığı: R 100. Ayrılmış 300 isteğin tümü ilk denemede başarılı oldu.
Test kurulumu
| Öğe | Ayrıntı |
|---|---|
| Model | DeepSeek V4.1 Flash 1017 |
| İstenen model kimliği | deepseek/deepseek-v4.1-flash |
| Döndürülen model adı | deepseek/deepseek-v4.1-flash |
| Erişim yolu | Sağlayıcının hesabına doğrudan bağlanmak yerine, sağlayıcıya özgü bir model kimliğiyle AIHubMix üzerinden |
| Parametreler | Sabit APB v2 istek profili, temperature 1.0, max_tokens 16,384, 300 s zaman aşımı, otomatik yeniden deneme yok |
| Zaman | 2026-11-03 18:07 – 11-04 16:33; önbellek istekleri 11-05 19:31 – 11-06 10:35; tüm saatler UTC+8. Altı sağlayıcının tümü aynı Mac mini’yi, ağı ve hesabı kullandı. |
| Örnekler | Q 4,250 soru örneği; F 180 kontrol; P 180 istek; R 300; K 30 |
İsteklerde, sağlayıcıya özgü model kimliğiyle AIHubMix hızlı başlangıç yolu kullanıldı; diğer sağlayıcıların kimlikleri modeller sayfasında listelenmiştir. Modelin kendi parametreleri DeepSeek’in API belgelerinde açıklanmıştır.
Q — yanıt kalitesi: 44.58
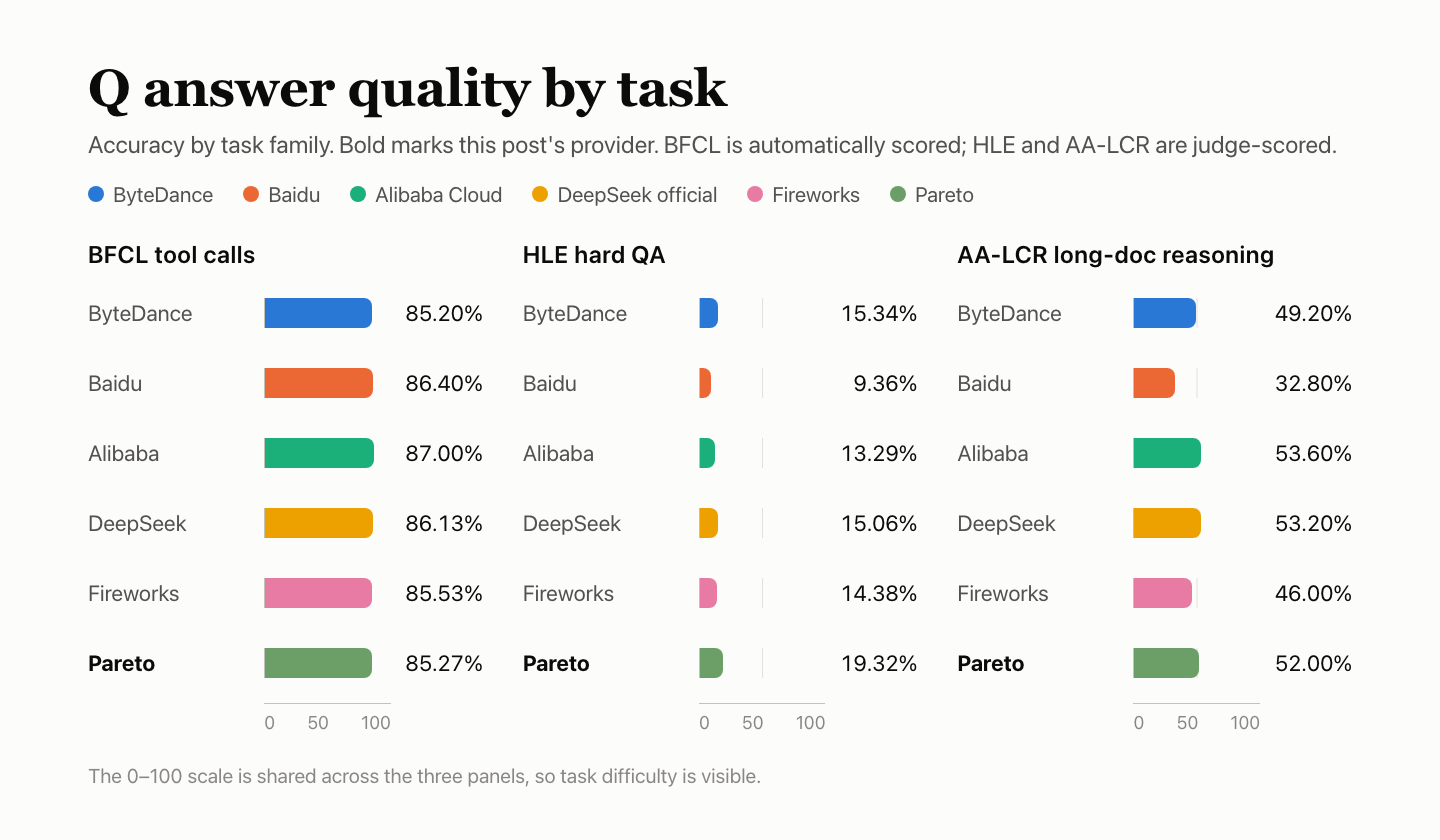
Yanıt kalitesi üç paketten yararlanır: 500 BFCL sorusunun her biri 3 kez, 250 HLE sorusunun her biri 10 kez ve 25 AA-LCR sorusunun her biri 10 kez yanıtlandı. BFCL otomatik kurallarla puanlanır; HLE ve AA-LCR’de yanıtların doğru ya da yanlış olduğuna deepseek-flash yargıç modeli karar verir. Altı sağlayıcının tümüne aynı sorular yöneltildi ve üç paketin sonuçları tek bir doğruluk oranında birleştirildi. Soru puanlanamadığı için on yanıt çıkarıldı; puanlanan soru örneği sayısı 4,240 oldu.
| Paket | Soru × tur | Doğru | Doğruluk | Hizmet hataları |
|---|---|---|---|---|
| BFCL araç çağrıları, otomatik puanlama | 500 × 3 | 1,279/1,500 | 85.27% | 0 |
| HLE zor QA, yargıç puanlaması | 250 × 10 | 481/2,490 | 19.32% | 0 |
| AA-LCR uzun belge akıl yürütme, yargıç puanlaması | 25 × 10 | 130/250 | 52.00% | 0 |
| Toplam · %95 güven aralığı 41.57%–47.49% | — | 1,890/4,240 | 44.58% | 0 |
Her soru örneği eksiksiz bir yanıt aldı; hizmet hatası yaşanmadı.
| BFCL kategorisi | Geçti | Geçme oranı |
|---|---|---|
| simple_python: tek işlev, doğru çağrı ve bağımsız değişkenler | 333/360 | 92.50% |
| multiple: birden fazla işlev arasından doğru olanı seçme | 269/300 | 89.67% |
| parallel: tek işlevin aynı anda birkaç kez çağrılması | 265/300 | 88.33% |
| parallel_multiple: aynı anda birden fazla işlev | 203/240 | 84.58% |
| irrelevance: ilgili bir işlev olmadığından çağrı yapılmaması | 109/150 | 72.67% |
| ahm_multi_turn: üç aşamalı araç zinciri | 100/150 | 66.67% |
Her BFCL sorusu 3 kez yanıtlandı; tabloda 3 turun toplamı gösteriliyor.
Diğer beş sağlayıcıyla karşılaştırma
| Sağlayıcı | BFCL | HLE | AA-LCR | Birleşik | Resmî kanala göre |
|---|---|---|---|---|---|
| ByteDance | 85.20% | 15.34% | 49.20% | 42.05% | −0.40 (−1.46 ile +0.66), ayırt edilebilir değil |
| Baidu | 86.40% | 9.36% | 32.80% | 38.00% | −4.46 (−5.78 ile −3.16), resmî kanalın altında |
| Alibaba Cloud | 87.00% | 13.29% | 53.60% | 41.75% | −0.71 (−1.72 ile +0.26), ayırt edilebilir değil |
| DeepSeek resmî kanalı | 86.13% | 15.06% | 53.20% | 42.45% | Referans değer |
| Fireworks | 85.53% | 14.38% | 46.00% | 41.42% | −1.04 (−2.14 ile +0.05), ayırt edilebilir değil |
| Pareto (bu yazı) | 85.27% | 19.32% | 52.00% | 44.58% | +2.12 (−0.02 ile +4.18), ayırt edilebilir değil |
Resmî kanala göre: yüzde puan cinsinden doğruluk farkı; köşeli parantez içinde %95 güven aralığı yer alır. Güven aralığı 0’ı kapsıyorsa sonuç “ayırt edilebilir değil” olarak kaydedilir. HLE ve AA-LCR yargıcı deepseek-flash, test edilen modelle aynı DeepSeek ailesindendir ve kalibre edilmemiştir; bu nedenle değerlendirmeleri hoşgörülü olabilir.
F — işlev desteği: 93.42
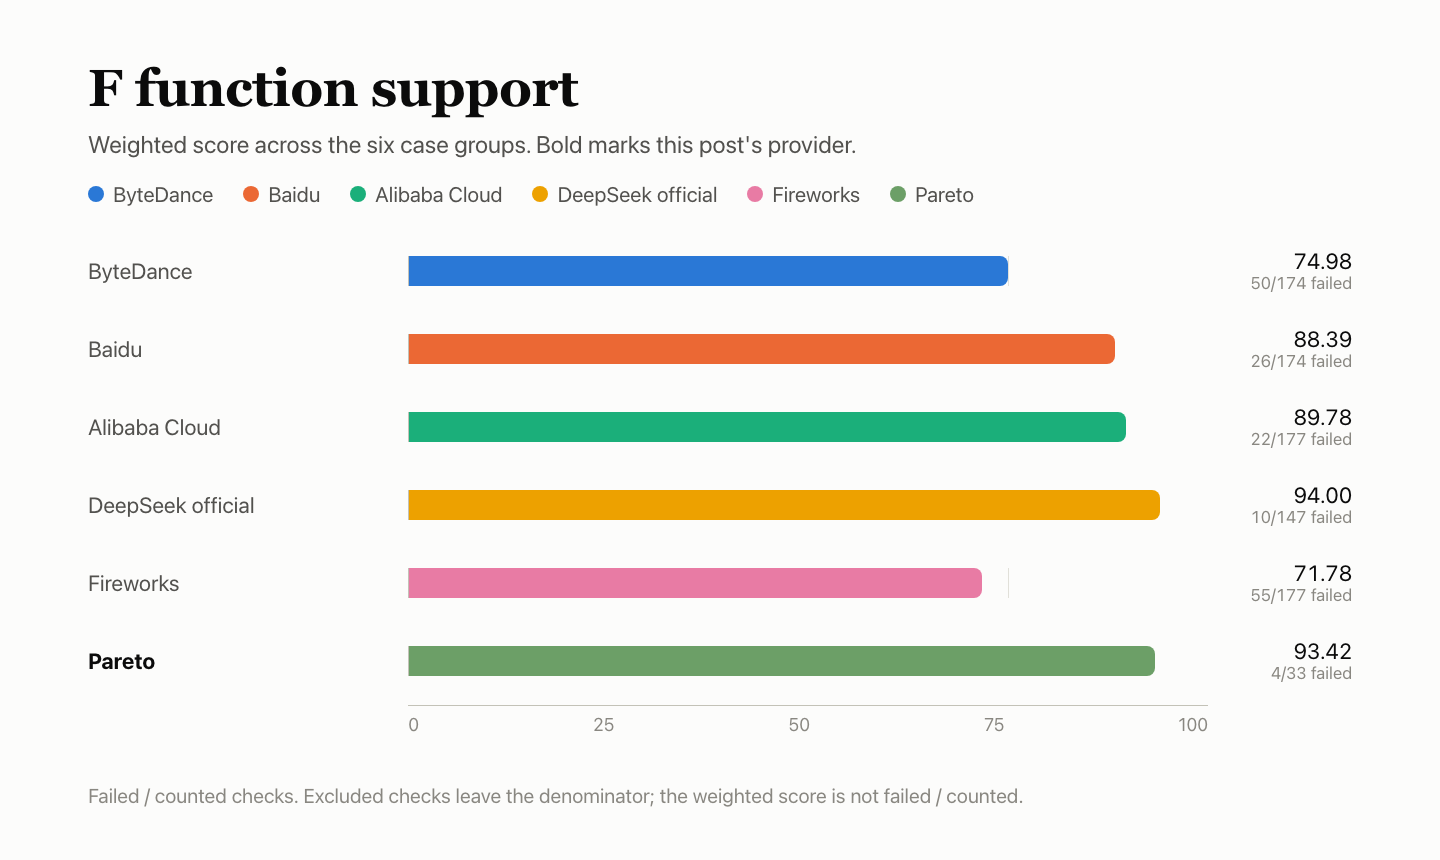
İşlev testleri, arayüz davranışının protokole uyup uymadığını denetler. F 93.42 puanı, gözlemlenen grup ağırlıkları yeniden ölçeklendirildikten sonra sayılan 33 kontrolden (29’u geçti) elde edildi; özgün paketteki planlanmış diğer 147 kontrol noktası puanlamaya alınmadı.
| Test grubu | Ağırlık | Geçti / akış gözlemleri | Hariç tutulan | Grup puanı |
|---|---|---|---|---|
| Akış ve mesaj protokolü | 20% | 23/27 | 3 | 85.19 |
| Araç arayüzü Araç çağrıları, araç sonucu gidiş-dönüşü, paralel ve adlandırılmış çağrılar | 20% | Başarılı akış gözlemleri* | 30 | — |
| Çıktı kısıtları ve parametreler JSON modu ve düşünmenin devre dışı bırakılması | 20% | Başarılı akış gözlemleri* | 30 | — |
| Bağlam ve durum Konuşma geçmişi ve sistem talimatları | 15% | Başarılı akış gözlemleri* | 30 | — |
| Hatalar ve kurtarma | 15% | 3/3 | 27 | 100.00 |
| Ücretlendirme ve önbellek protokolü | 10% | 3/3 | 27 | 100.00 |
| Toplam · ağırlıklı puan | 29/33 | 147 | 93.42 | |
- Listelenen özellikler için başarılı akış kayıtları bulunuyor; bu, tüm gruba tam puan verildiği anlamına gelmez. Puanlamaya yeni kontrol eklenmedi. F 93.42 ve 68.72 genel puanı özgün değerlerini koruyor.
| Başarısız test | Pencereler | Neden |
|---|---|---|
| Akışta durdurma dizisi Akış ve mesaj protokolü | 3/3 | Durdurma dizisiyle boş gövde; aynı girdi durdurma dizisi olmadan çalıştı |
| Tam metin çıktısı Akış ve mesaj protokolü | 1/3 | Eklenen son nokta, tam metin eşleşmesini bozdu |
“Pencereler”, 3 pencereden kaçında kontrolün başarısız olduğunu belirtir.
Hatalı biçimlendirilmiş mesaj ve akış seçenekleri testleri, birkaç sağlayıcıda boş yanıt gövdesiyle birlikte 400 döndürdü. Akıl yürütme belirteçlerinin ücretlendirilmesi sağlayıcılar arasında farklılık gösterdi.
Diğer beş sağlayıcıyla karşılaştırma
| Sağlayıcı | Geçti | Başarısız | Hariç tutulan | Ağırlıklı puan |
|---|---|---|---|---|
| ByteDance | 124 | 50 | 6 | 74.98 |
| Baidu | 148 | 26 | 6 | 88.39 |
| Alibaba Cloud | 155 | 22 | 3 | 89.78 |
| DeepSeek resmî kanalı | 137 | 10 | 33 | 94.00 |
| Fireworks | 122 | 55 | 3 | 71.78 |
| Pareto (bu yazı) | 29 | 4 | 147 | 93.42 |
P — yanıt hızı: 57.69
Her istek yaklaşık 10,000 girdi belirteci içeriyor ve gövde metninde yaklaşık 1,100 çıktı belirteci istiyordu. Üç pencerenin her birinde, 30 istek tek eşzamanlılıkta ve 30 istek 10 eşzamanlılıkta çalıştırıldı: toplam 180 istek.
| Öğe | Ayrıntı |
|---|---|
| İlk gövde belirteci (TTFA) | Medyan: tek eşzamanlılıkta 5.85 s (yalnızca geçerlilerde 3.08 s), 10 eşzamanlılıkta 6.13 s (yalnızca geçerlilerde 4.92 s) |
| Üretim hızı (TPOT) | Tek eşzamanlılıkta 4.42 ms/belirteç, 10 eşzamanlılıkta 4.63 ms/belirteç |
| Etkin iş hacmi | 10 eşzamanlılıkta 519.4 token/s |
| Geçerli istekler | Tek eşzamanlılıkta 53/90 (1–3. pencereler: 15/30, 18/30, 20/30), 10 eşzamanlılıkta 57/90 (23/30, 16/30, 18/30); geçersiz: 70 istek None ile 200 döndürdü |
| Alt puanlar | TTFA 24.59, TPOT 100.00, iş hacmi 72.05; TTFA ve TPOT düşük olan katmana göre puanlanır; ağırlıklar %35 / %35 / %30: yanıt puanı 65.22 |
| P puanı | Yanıt puanı 65.22 × %80 + önbellek K 27.58 × %20 = 57.69 |
Geçersiz istekler sonsuz değerle puanlanır; bu nedenle tablodaki medyanlar yalnızca geçerli isteklerin medyanlarından yüksek olabilir. TPOT, donanımda belirteç başına ölçülmek yerine akış parçalarından tahmin edilir. İş hacmi, 10 eşzamanlılıkta üretilen geçerli çıktı belirteçlerinin grup çalışma süresine bölünmesiyle hesaplanır.
Diğer beş sağlayıcıyla karşılaştırma
| Sağlayıcı | Geçerli istekler | Tek eşzamanlılıkta TTFA | 10 eşzamanlılıkta TTFA | TPOT (daha yavaş) | İş hacmi token/s | Yanıt |
|---|---|---|---|---|---|---|
| ByteDance | 180/180 | 2.12 s | 2.10 s | 3.43 ms | 1,250 | 82.00 |
| Baidu | 118/180 | 2.26 s | ∞ | 50.00 ms | 1,329 | 30.00 |
| Alibaba Cloud | 180/180 | 1.34 s | 1.35 s | 4.69 ms | 1,314 | 85.88 |
| DeepSeek resmî kanalı | 165/180 | 1.87 s | 1.72 s | 2.84 ms | 1,546 | 83.08 |
| Fireworks | 179/180 | 1.63 s | 1.64 s | 3.29 ms | 1,505 | 84.22 |
| Pareto (bu yazı) | 110/180 | 5.85 s | 6.13 s | 4.63 ms | 519 | 65.22 |
Altı sağlayıcının tümü aynı makineyi, ağı ve hesabı kullandı. Üç pencere sağlayıcı bazında sırayla planlandığı için veri toplama dönemleri tam olarak örtüşmüyor; küçük farklara gereğinden fazla anlam yüklememek gerekir. ∞, isteklerin yarısından fazlasının geçersiz olduğu ve bu nedenle medyanın sonsuz sayıldığı anlamına gelir.
K — önbellek: 27.58
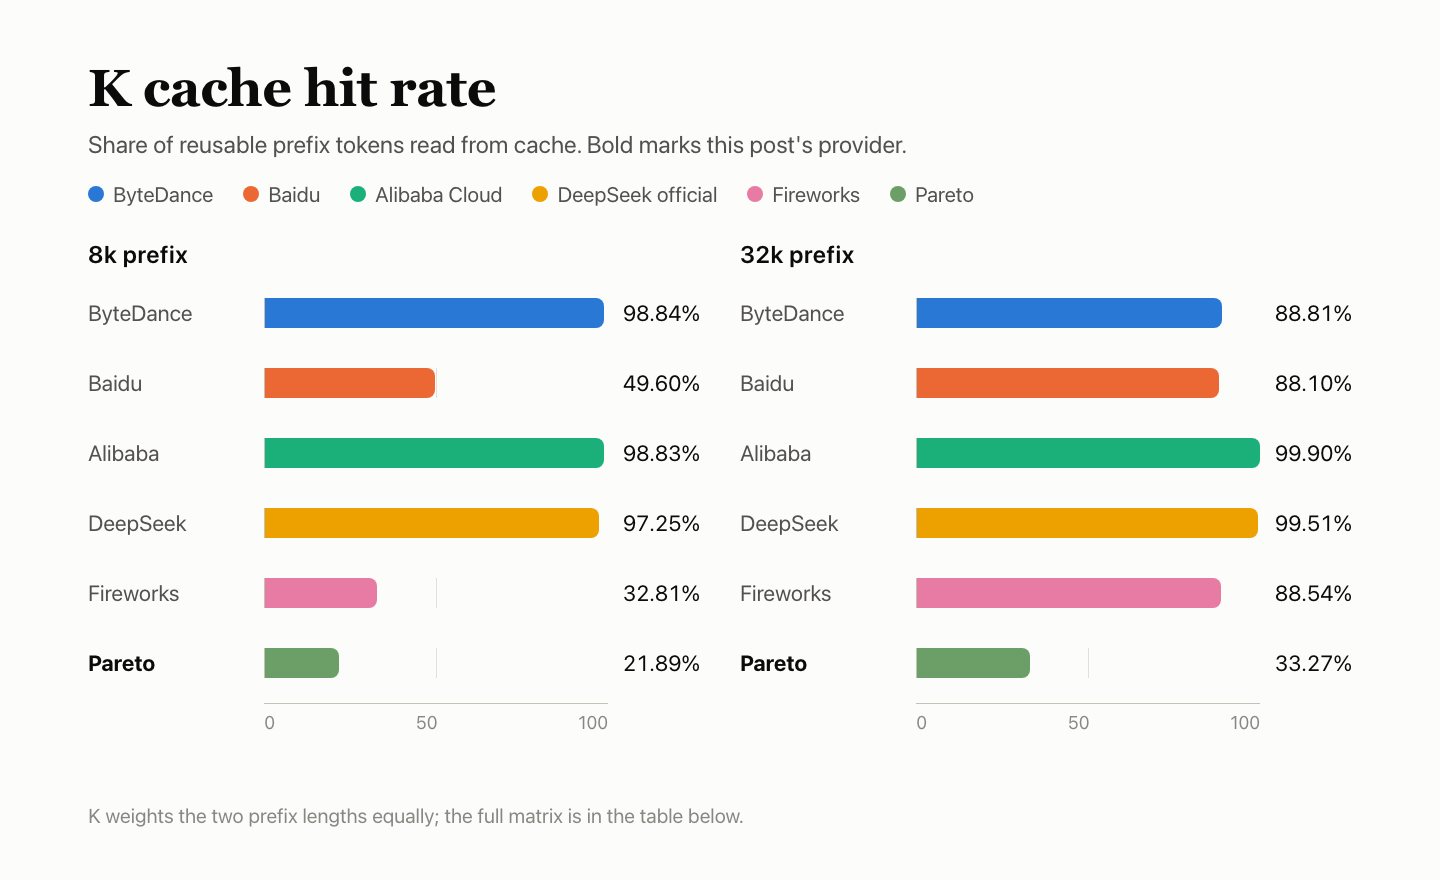
Her grup beş istek gönderir. İlki, önbelleği hazırlamak için yaklaşık 8k veya 32k tokenlık sabit bir önek taşır. 2–4. isteklerde önek korunur, yalnızca son soru değiştirilir; aralarındaki süreler 5 s, 30 s ve 120 s'dir. Beşinci istek, soğuk kontrol olarak yeni bir önek kullanır. Üç pencere × iki uzunluk toplam 30 istek eder. K, sıcak isteklerin okuduğu önbellek tokenlarının kurallar uyarınca yeniden kullanılabilir olması gereken tokenlara oranıdır; iki uzunluğa eşit ağırlık verilir. K, P'nin %20'sini oluşturur.
| Pencere | 1 · önbelleği hazırlama | 2 · +5 s | 3 · +30 s | 4 · +120 s | 5 · soğuk |
|---|---|---|---|---|---|
| 8k önek · sıcak isabet 2/9 · yeniden kullanılabilir 72,504 tokenın 15,872'si okundu · 21.89 | — | — | — | — | — |
| Pencere 1 | 0 | 0 | 7,936 | 0 | 0 |
| Pencere 2 | 0 | 0 | 0 | 0 | 0 |
| Pencere 3 | 0 | 0 | 7,936 | 0 | 0 |
| 32k önek · sıcak isabet 3/9 · yeniden kullanılabilir 288,513 tokenın 96,000'i okundu · 33.27 | — | — | — | — | — |
| Pencere 1 | 0 | 0 | 32,000 | 0 | 0 |
| Pencere 2 | 0 | 0 | 0 | 0 | 0 |
| Pencere 3 | 0 | 0 | 0 | 32,000 | 0 |
| K (8k ve 32k eşit ağırlıklı) | — | — | — | — | 27.58 |
Değerler, sunucunun bildirdiği önbellekten okunan token sayılarıdır; “Döndürülmedi”, alanın yanıtta bulunmadığı anlamına gelir.
8k sıcak isteklerde 9 isteğin 2'si isabet etti ve her isabette 7,936 token okundu; 32k sıcak isteklerde 9 isteğin 3'ü isabet etti ve her isabette 32,000 token okundu. Soğuk istekler önbellekten hiçbir şey okumadı; böylece sıcak ve soğuk istekler net biçimde ayrışıyor.
Diğer beş sağlayıcıyla karşılaştırma
| Sağlayıcı | 8k isabet | 8k | 32k isabet | 32k | K |
|---|---|---|---|---|---|
| ByteDance | 9/9 | 98.84 | 8/9 | 88.81 | 93.83 |
| Baidu | 5/9 | 49.60 | 8/9 | 88.10 | 68.85 |
| Alibaba Cloud | 9/9 | 98.83 | 9/9 | 99.90 | 99.37 |
| DeepSeek resmî kanalı | 9/9 | 97.25 | 9/9 | 99.51 | 98.38 |
| Fireworks | 3/9 | 32.81 | 8/9 | 88.54 | 60.68 |
| Pareto (bu yazı) | 2/9 | 21.89 | 3/9 | 33.27 | 27.58 |
R — hizmet kararlılığı: 100
300 istek dört türe ayrılır: kısa metin, uzun girdi, araç çağrıları ve çok turlu geçmiş. İstekler üç pencere boyunca eşzamanlılık 1'de çalıştırıldı. Yalnızca ilk denemenin geçerli ve eksiksiz bir yanıt verip vermediği kontrol edilir; yanıtlar puanlanmaz ve hiçbir istek yeniden denenmez. Yanıt kalitesi ve hız bölümlerindeki başarısızlıklar Q ve P'de sayılır, R'de tekrar sayılmaz.
| İstek türü | İlk denemede başarı |
|---|---|
| Kısa metin | 120/120 |
| 10k uzun girdi | 90/90 |
| Araç çağrıları | 60/60 |
| Çok turlu geçmiş | 30/30 |
| Toplam · %95 güven aralığı 98.78%–100% | 300/300 |
300 isteğin tümü ilk denemede geçerli ve eksiksiz bir yanıt döndürdü. R = 100 yalnızca bu 300 özel isteği ifade eder; tüm zincirde hiç hata olmadığı anlamına gelmez. %95 güven aralığının alt sınırı 98.78%'dir: 300 isteğin 300'ünün başarılı olması, hata oranının muhtemelen %1.22'nin altında olduğunu söylemeye yeter.
Diğer beş sağlayıcıyla karşılaştırma
| Sağlayıcı | İlk denemede başarı | %95 güven aralığı |
|---|---|---|
| ByteDance | 300/300 | 98.78%–100% |
| Baidu | 300/300 | 98.78%–100% |
| Alibaba Cloud | 300/300 | 98.78%–100% |
| DeepSeek resmî kanalı | 300/300 | 98.78%–100% |
| Fireworks | 300/300 | 98.78%–100% |
| Pareto (bu yazı) | 300/300 | 98.78%–100% |
R yalnızca bu 300 özel isteği kapsar; yanıt kalitesi ve hız bölümlerindeki hatalar Q ve P'de kaydedilir ve R'de tekrar sayılmaz.
SSS
Neden yalnızca 33 kontrol sayılmışken F 93.42?
İlk sayımda 33 kontrolden 29'u geçti; gözlenen grup ağırlıkları yeniden normalize edilince F 93.42 oldu. Planlanan diğer 147 kontrol yuvası puanlamaya alınmadı. Akış kayıtları, çalışan belirli özellikleri açıklıyor ve puanlanan kontrol sayısına katkıda bulunmuyor. Gösterilen genel puan 68.72 olarak kalıyor.
TPOT 100.00 puan almışken P neden 57.69?
180 hız isteğinin yalnızca 110'u geçerliydi; 70'i 200 durum koduyla birlikte None döndürdü. Geçersiz istekler sonsuz sayıldığı için ilk yanıt gövdesi tokenının medyan süresi tekli eşzamanlılıkta 5.85 s, 10'lu eşzamanlılıkta 6.13 s'dir (yalnızca geçerli isteklerde 3.08 s ve 4.92 s). TTFA 24.59, aktarım hızı 72.05 puan aldı; yanıt puanı 65.22 oldu. %20 ağırlığa sahip önbellek K puanı 27.58 ile birlikte P 57.69'dur.
K neden yalnızca 27.58?
8k isteklerde 9 sıcak isteğin 2'si (21.89), 32k isteklerde ise 9 isteğin 3'ü (33.27) isabet etti; iki uzunluk eşit ağırlıkta. İsabet gerçekleştiğinde 7,936 veya 32,000 token okundu; soğuk kontrollerin hiçbiri önbellekten okuma yapmadı.
Pareto'nun yanıt kalitesi resmî kanaldan daha mı yüksek?
Aradaki fark ayırt edilebilir düzeyde değil. Birleşik doğruluk %44.58'e karşı %42.45; fark +2.12 puan. Ancak %95 güven aralığı −0.02 ile +4.18 arasında ve 0'ı kapsıyor. HLE ve AA-LCR değerlendiricisi deepseek-flash kalibre edilmedi; bu nedenle puanlaması gevşek olabilir.
F'de hangi durumlar başarısız oldu?
İki durum. Akıştaki durdurma dizisi üç pencerenin tümünde boş bir gövde döndürdü; aynı girdi durdurma dizisi olmadan çalıştı. Tam metin çıktısında, üç pencereden birinde fazladan bir nokta vardı.
Okumaya devam edin: DeepSeek V4.1 Flash serisi
- Pareto'nun +2.12'lik Q farkı resmî kanala göre ölçülmüştür; temel karşılaştırma için yapılan çalışmayı DeepSeek resmî kanalı DeepSeek V4.1 Flash incelemesi: karşılaştırma ölçütü, tekli eşzamanlılıkta 15 geçersiz istek yazısında bulabilirsiniz.
- Fireworks de durdurma isteklerinde boş gövdeler döndürdü ve 8k'de 9 isteğin 3'ü isabet etti: Fireworks DeepSeek V4.1 Flash incelemesi: durdurma istekleri boş gövde döndürüyor, 8k önbellek sıcak isteklerinde 9'da 3 isabet.
- Alibaba Cloud'un sıcak isteklerinin 18'de 18'i, Pareto'nun ise 18'de 5'i isabet etti: Alibaba Cloud DeepSeek V4.1 Flash incelemesi: ilk gövde tokenı 1.34s, 18 sıcak isteğin tümü önbelleğe isabet etti, yanıtlar resmî kanaldakilerden ayırt edilemiyor.
- ByteDance'in hız isteklerinin tümü geçerliydi ve ilk gövde tokenı 2.12 s sürdü: ByteDance DeepSeek V4.1 Flash incelemesi: yanıtlar resmî kanaldakilerden ayırt edilemiyor, girdi sayımları uyuşmuyor.
- Baidu da çok sayıda hız isteğini no_available_channel hatasıyla kaybetti: Baidu DeepSeek V4.1 Flash incelemesi: araç çağrısı resmî kanalla aynı düzeyde, sık görülen no-available-channel hataları yanıt kalitesini ve hızı düşürüyor.
Kaynaklar
- DeepSeek V4.1 Flash 1017 model sayfası (AIHubMix)
- AIHubMix Sağlayıcı Kıyaslama Standardı v2.0 (AIHubMix belgeleri)
- Hızlı başlangıç (AIHubMix belgeleri)
- Modeller (AIHubMix)
- DeepSeek API belgeleri (DeepSeek)


